在分布式系统与微服务架构的日常演进中,几乎每一个工程团队都曾面临过这样一个两难抉择:
下周运营后台要上线一个跨业务线的对账看板,需要关联订单中心、履约系统和结算账户。上游核心服务的排期已经排到了下个双周迭代,根本无暇为你专门封装一套带过滤、带分页的定制 API。此时,最诱人也最直接的捷径摆在眼前:
"给我开个数据库账号吧,我只做
SELECT,绝不修改任何数据,跑完报表就断开。"
在 Martin Fowler 的经典理论与各类微服务设计规范中,这种跨越服务边界直接读取底层数据库的做法,被公认为极具破坏性的典型反模式 ------ "数据库即接口"(Database-as-an-API Anti-Pattern)。
然而在真实的工程现场,从初创公司的敏捷迭代到中大型企业的内部数据分析,这种"反模式"却像杂草一样随处可见、屡禁不止。
这究竟是纯粹技术负债带来的架构堕落,还是一种在现实商业约束下完全可以理解的"工程妥协"(Pragmatic Compromise)?如果业务现状逼得我们不得不妥协,怎样才能避免系统滑向不可控的崩溃深渊?
一、 理论审判:为什么直查数据库被定性为"反模式"?
要理解架构学界对"跨库直查"的严厉警惕,不能停留在教条式的口号上,而必须看清它在分布式协作中造成的四大系统性击穿:
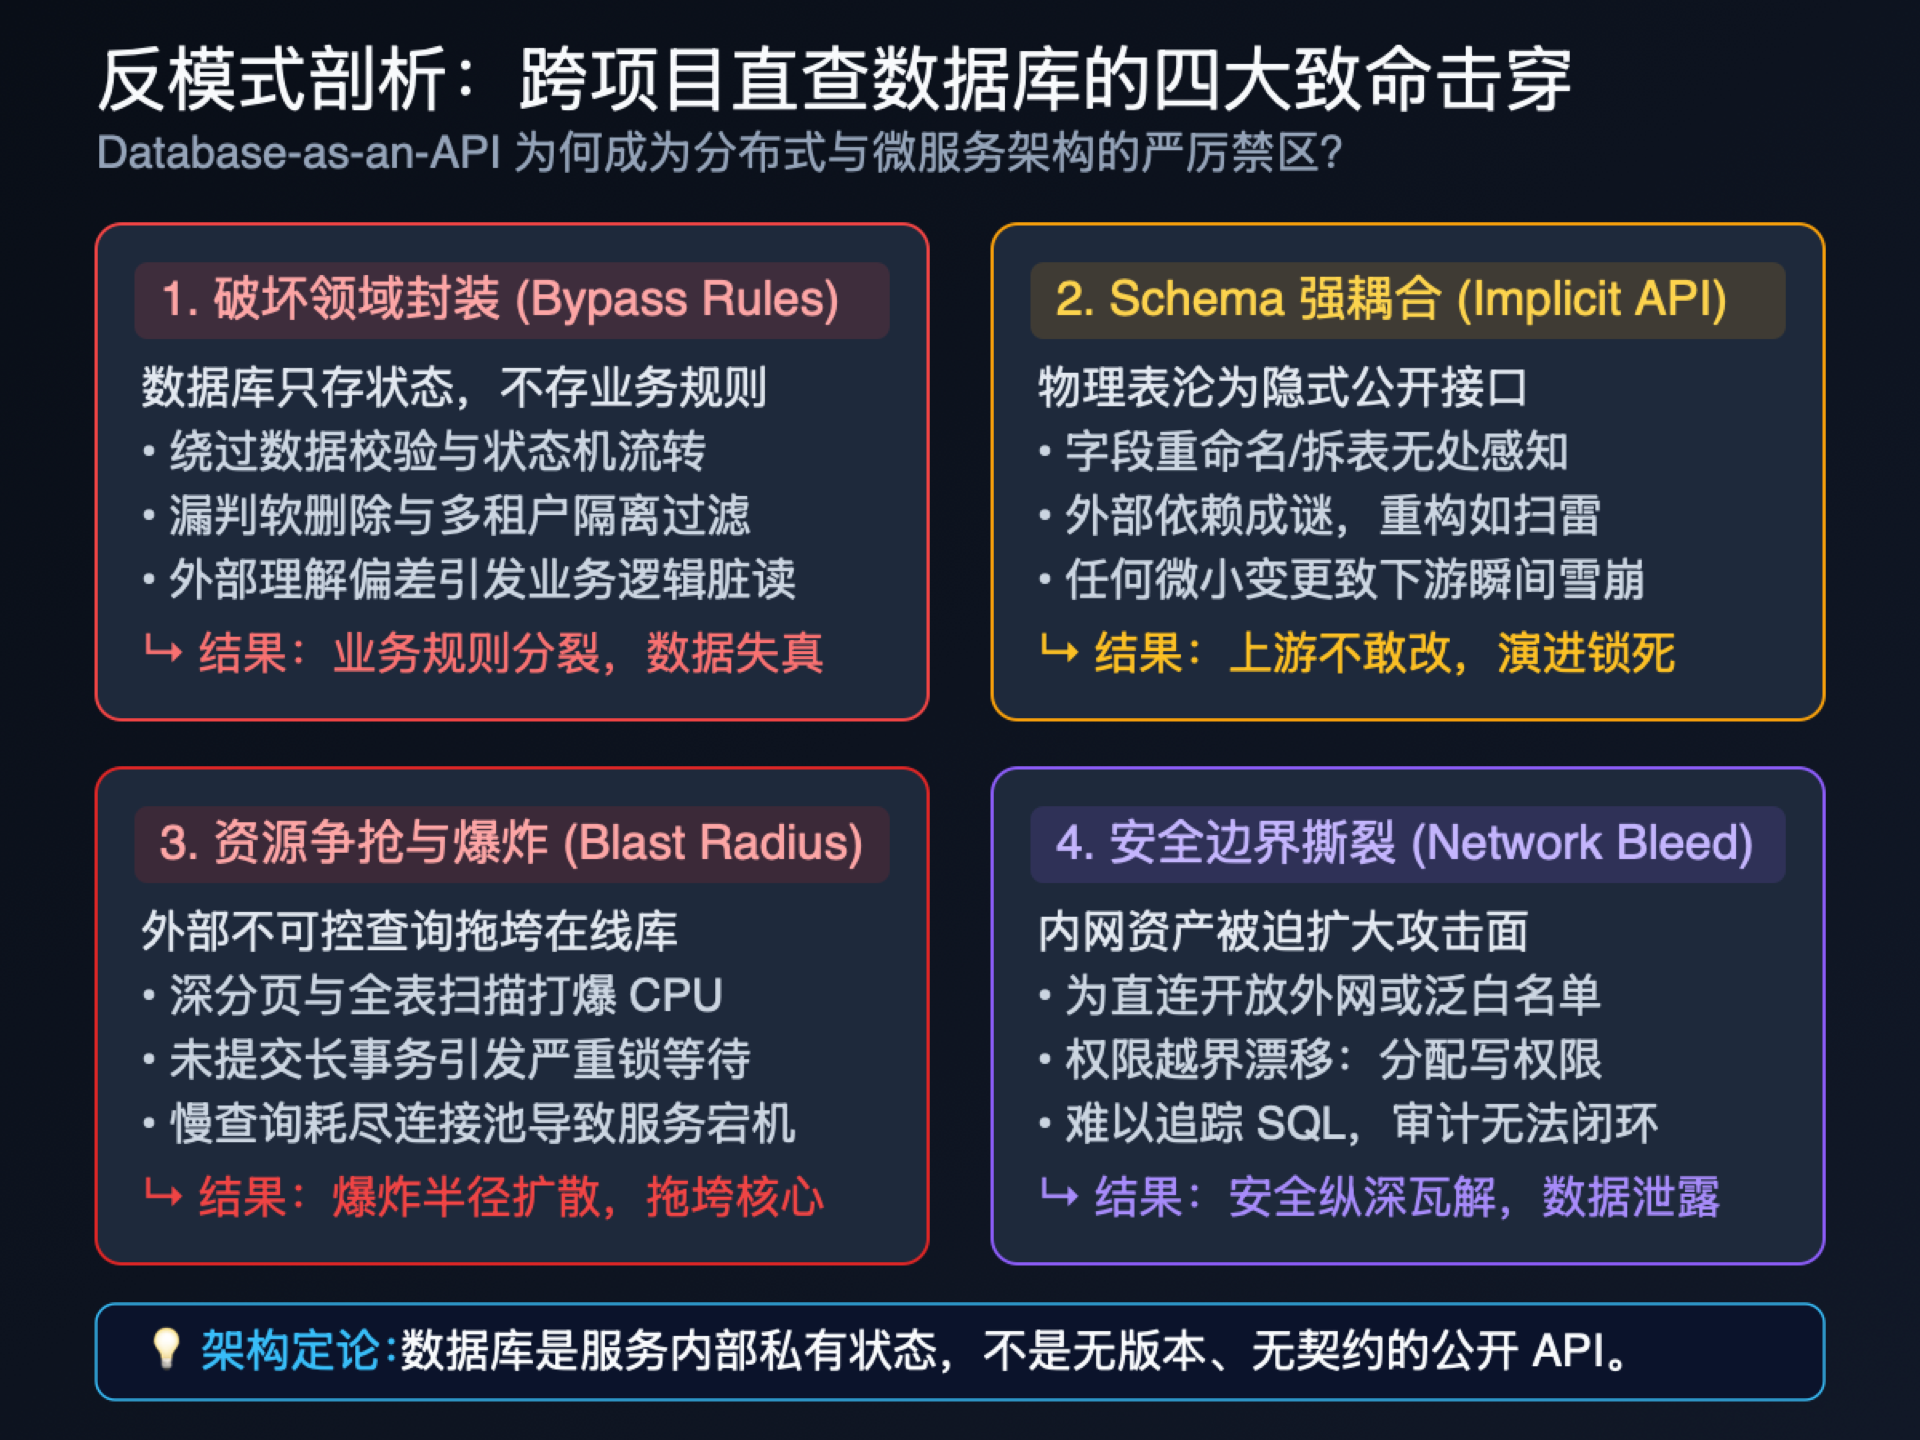
1. 破坏领域封装(Bypassing Domain Invariants)
在整洁架构与领域驱动设计(DDD)中,有一条根本底线:数据库存储的只是物理"状态",而不是"业务规则"。
- 数据表里的每一行记录,其合法性依赖于上游服务在应用层内置的状态机、校验逻辑、多租户隔离与软删除规则;
- 当外部服务绕过上游的领域服务层,直接用 SQL 查库时,上游辛苦构建的所有业务规则守护瞬间形同虚设。
以电商系统的订单表为例,上游服务在读取有效订单时,逻辑往往极其复杂:
sql
-- 上游应用层封装的真实有效订单判定:
WHERE status = 'PAID'
  AND refund_status = 'NONE'
  AND is_deleted = 0
  AND tenant_id = 'tenant_east_01'
  AND (expire_time IS NULL OR expire_time > NOW())
如果外部项目仅仅执行了一条 SELECT * FROM orders WHERE status = 'PAID',就会将已申请退款、已被软删除或属于其他租户的幽灵订单全量计入报表。这种由于理解偏差导致的业务逻辑脏读,往往排查极难,会直接污染下游决策。
2. Schema 强耦合(Tight Coupling & The Implicit API Trap)
一旦允许外部项目直接查询数据表,数据表的物理 Schema 就被迫沦为无版本控制的隐式公开 API。
- 缺乏演进自决权:上游团队对表结构的每一次重构,包括重命名字段、调整数据类型、合并字段或拆表分库,都会变成一场提心吊胆的"扫雷游戏";
- 调用方暗影密布:由于没有统一网关与契约登记,上游根本不知道公司内到底有几个脚本、几台后台服务在直查自己的表;
- 下游瞬间雪崩 :上游以为只是顺手把
user_id改名为account_id,结果半小时后两个关键下游服务因找不到列名而在生产环境全面报错。
3. OLTP 资源争抢与爆炸半径扩散(Blast Radius on Primary)
这是对在线核心交易(OLTP)最具毁灭性的物理威胁。外部团队的查询模式是源团队完全无法控制的:
- 外部开发人员为了赶进度,写出了未加索引的跨表
JOIN、包含了LIKE '%keyword%'的全表扫描,或者深达数万页的OFFSET分页; - 更有甚者,在查询中开启了未显式提交的长事务,引发底层元数据锁(MDL)或长行锁等待;
- 这些不可控的慢查询瞬间占满数据库连接池,将 CPU 打满至 100%,导致上游正常用户的在线登录、支付与下单接口全部超时熔断。
4. 安全与网络边界撕裂(Network & Security Bleed)
数据库本应部署在 VPC 中安全层级最严密的私有子网内,绝不暴露公网。
但为了让跨部门、跨云甚至外部协作项目的机器能够查到数据,很多团队被迫做出危险的让步:打通宽松的跨 VPC 规则、开放白名单,更有甚者直接给数据库挂上公网 IP。权限分配上也往往存在"权限漂移"------本应只给单表读取权限,运维或开发图省事直接分配了读写账号甚至超级管理员权限,导致越权误修改的重大事故风险直线上升。
二、 现实权衡:为什么它又是一种"可以理解"的设计?
尽管理论上的缺陷触目惊心,但在真实的软件工程世界中,脱离发展阶段、资源禀赋与交付周期去空谈架构纯洁性,往往是最大的工程内耗。
跨项目直查之所以屡禁不止,正是因为它在特定场景下具备极高的"性价比":
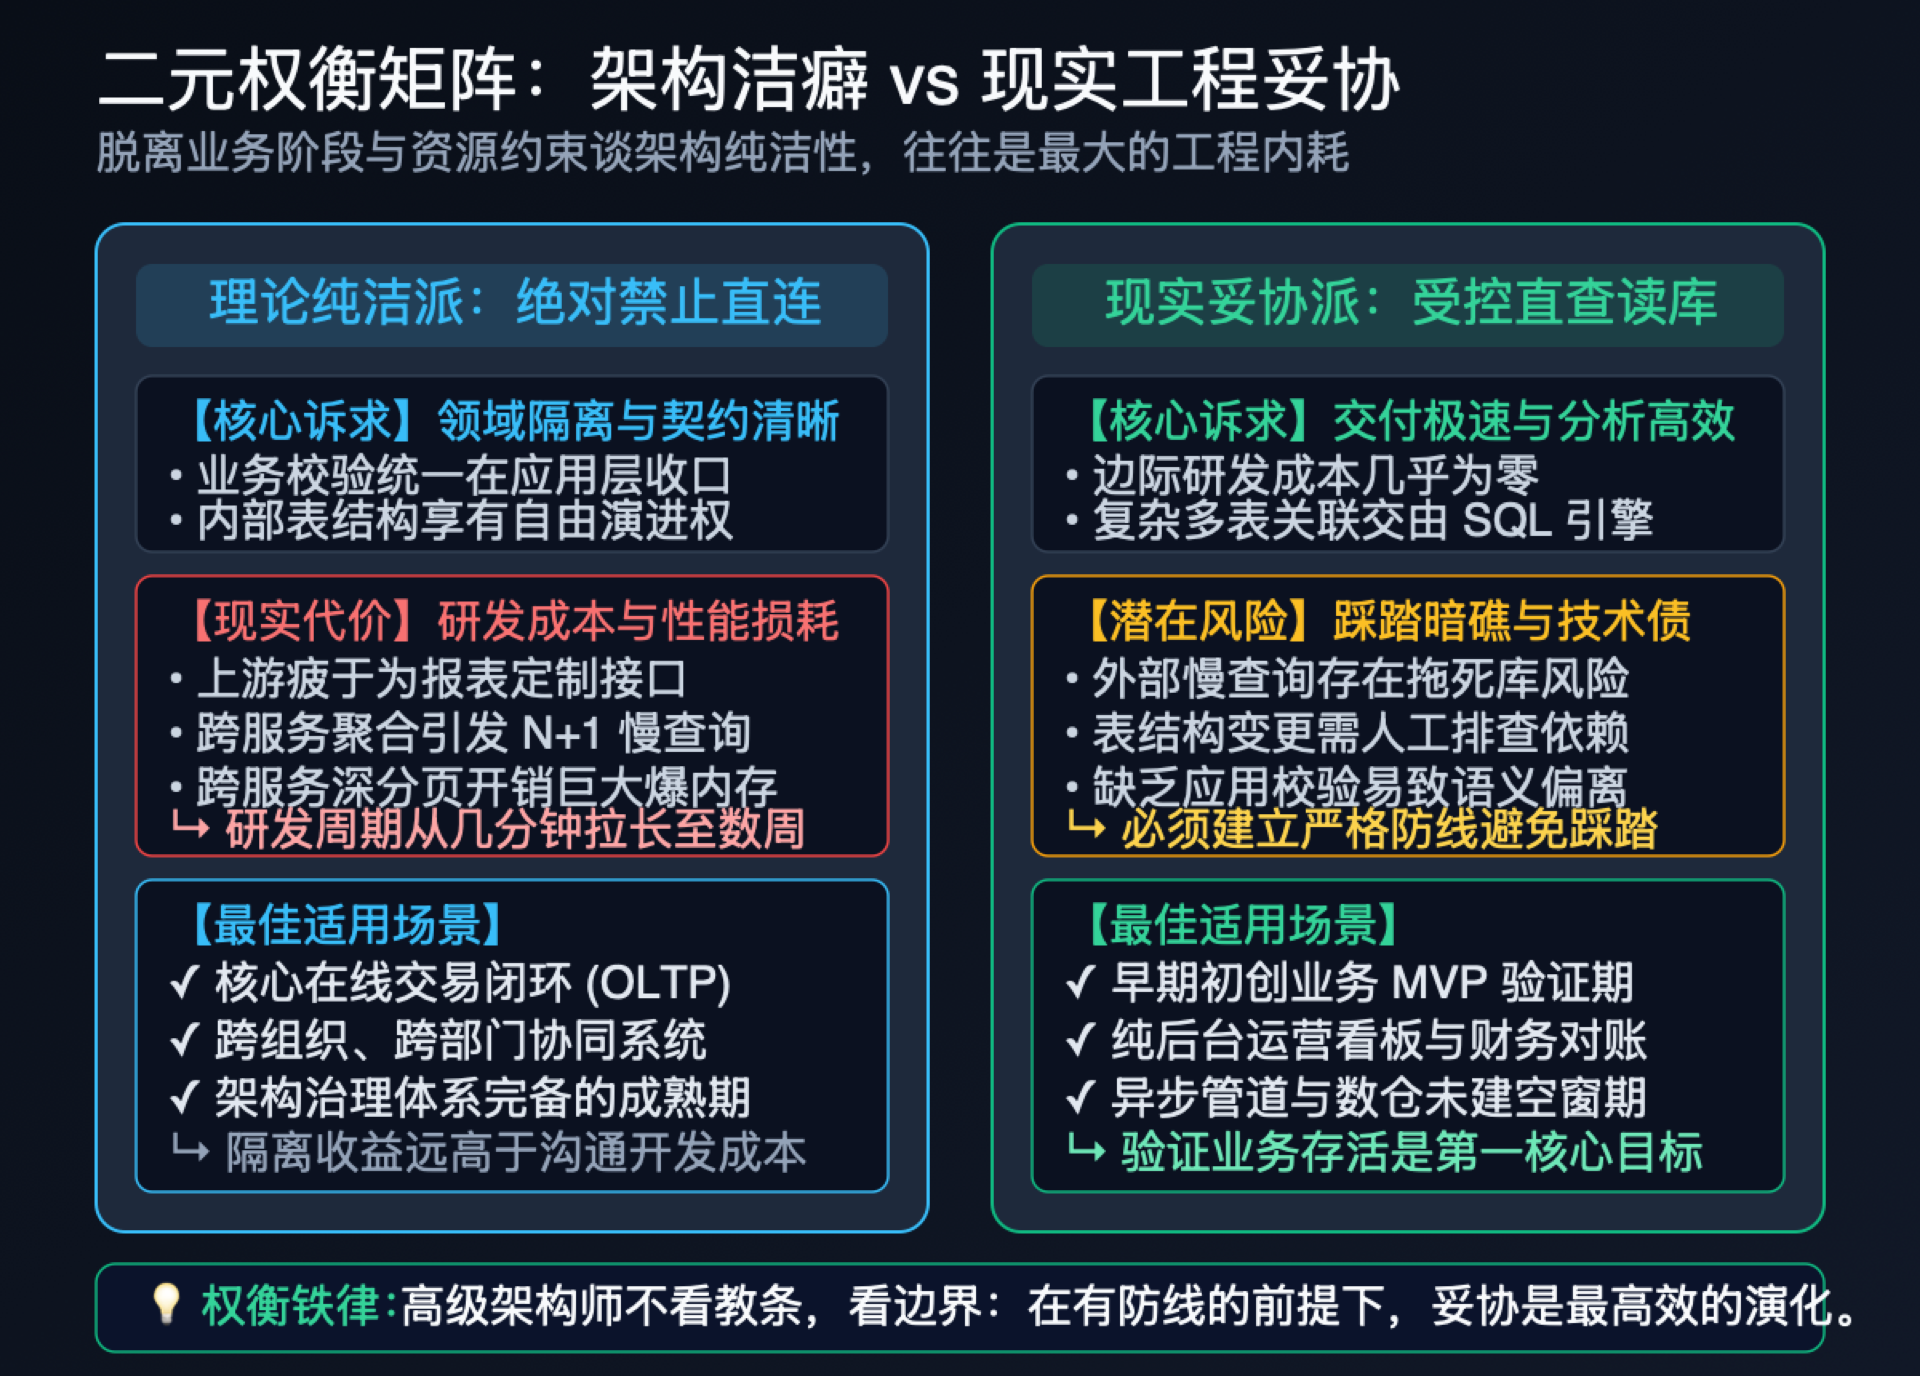
1. 交付速度与商业生存期权(Time-to-Market)
在业务早期的探索阶段或初创团队的 MVP 验证期,系统最重要的指标是生存与验证速度,而不是优雅的解耦。
- 上游核心交易团队可能总共只有 2 到 3 名开发人员,每日都在应付主线业务的急速变更;
- 如果下游仅仅需要查询几组辅助数据,却强行要求上游召开接口评审会、定义 Protobuf/OpenAPI 契约、编写 Controller/Service/DAO、补充单元测试并在发布流水线走一遍灰度发布,研发周期会从几分钟被动拉长至两周以上;
- 在很多快节奏的商业场景中,两周的等待足以让市场机会流失殆尽。
2. 报表分析场景下的"N+1 API 查询崩塌"
在运营看板、财务对账、数据 BI 等重度依赖多维关联的场景中,强推 REST/gRPC 往往会带来性能灾难:
- 假设需要统计 10,000 个用户的近期交易汇总,如果通过微服务 API 获取数据,下游必须先调用户接口拉取列表,再并发调用 10,000 次订单接口拉取详情;
- 这不仅带来灾难性的网络往返开销(RTT),更会导致下游服务在应用内存中执行极为低效的关联拼装,极易触发 OOM;
- 而底层的关系型数据库 SQL 引擎(如 PostgreSQL、MySQL),历经数十年演进,其查询优化器处理
JOIN、GROUP BY与流式聚合的性能,比应用层手动拼接高出几个数量级。
3. 企业数据基建的"空窗期"
在理论上,跨系统数据分析的最佳实践是通过 CDC(变更数据捕获)同步至数据仓库(如 ClickHouse、StarRocks)或构建 CQRS 物化视图。
然而,维护一套高可用的 Kafka、Debezium 和 OLAP 数仓集群,需要极高的运维成本与专门的大数据工程人力。在企业尚未跨过这一技术门槛的"基建空窗期",直连只读库是唯一现实可落地的低成本选择。
三、 防御堡垒:如何将直查做成"合格的工程妥协"?
既然妥协有时不可避免,那么高级工程师与初级工程师的分水岭,就在于能否为妥协筑牢防线。
妥协不等于放任自流。如果你在权衡后决定允许跨项目直连,必须强制筑起以下四道不可逾越的架构防火墙:
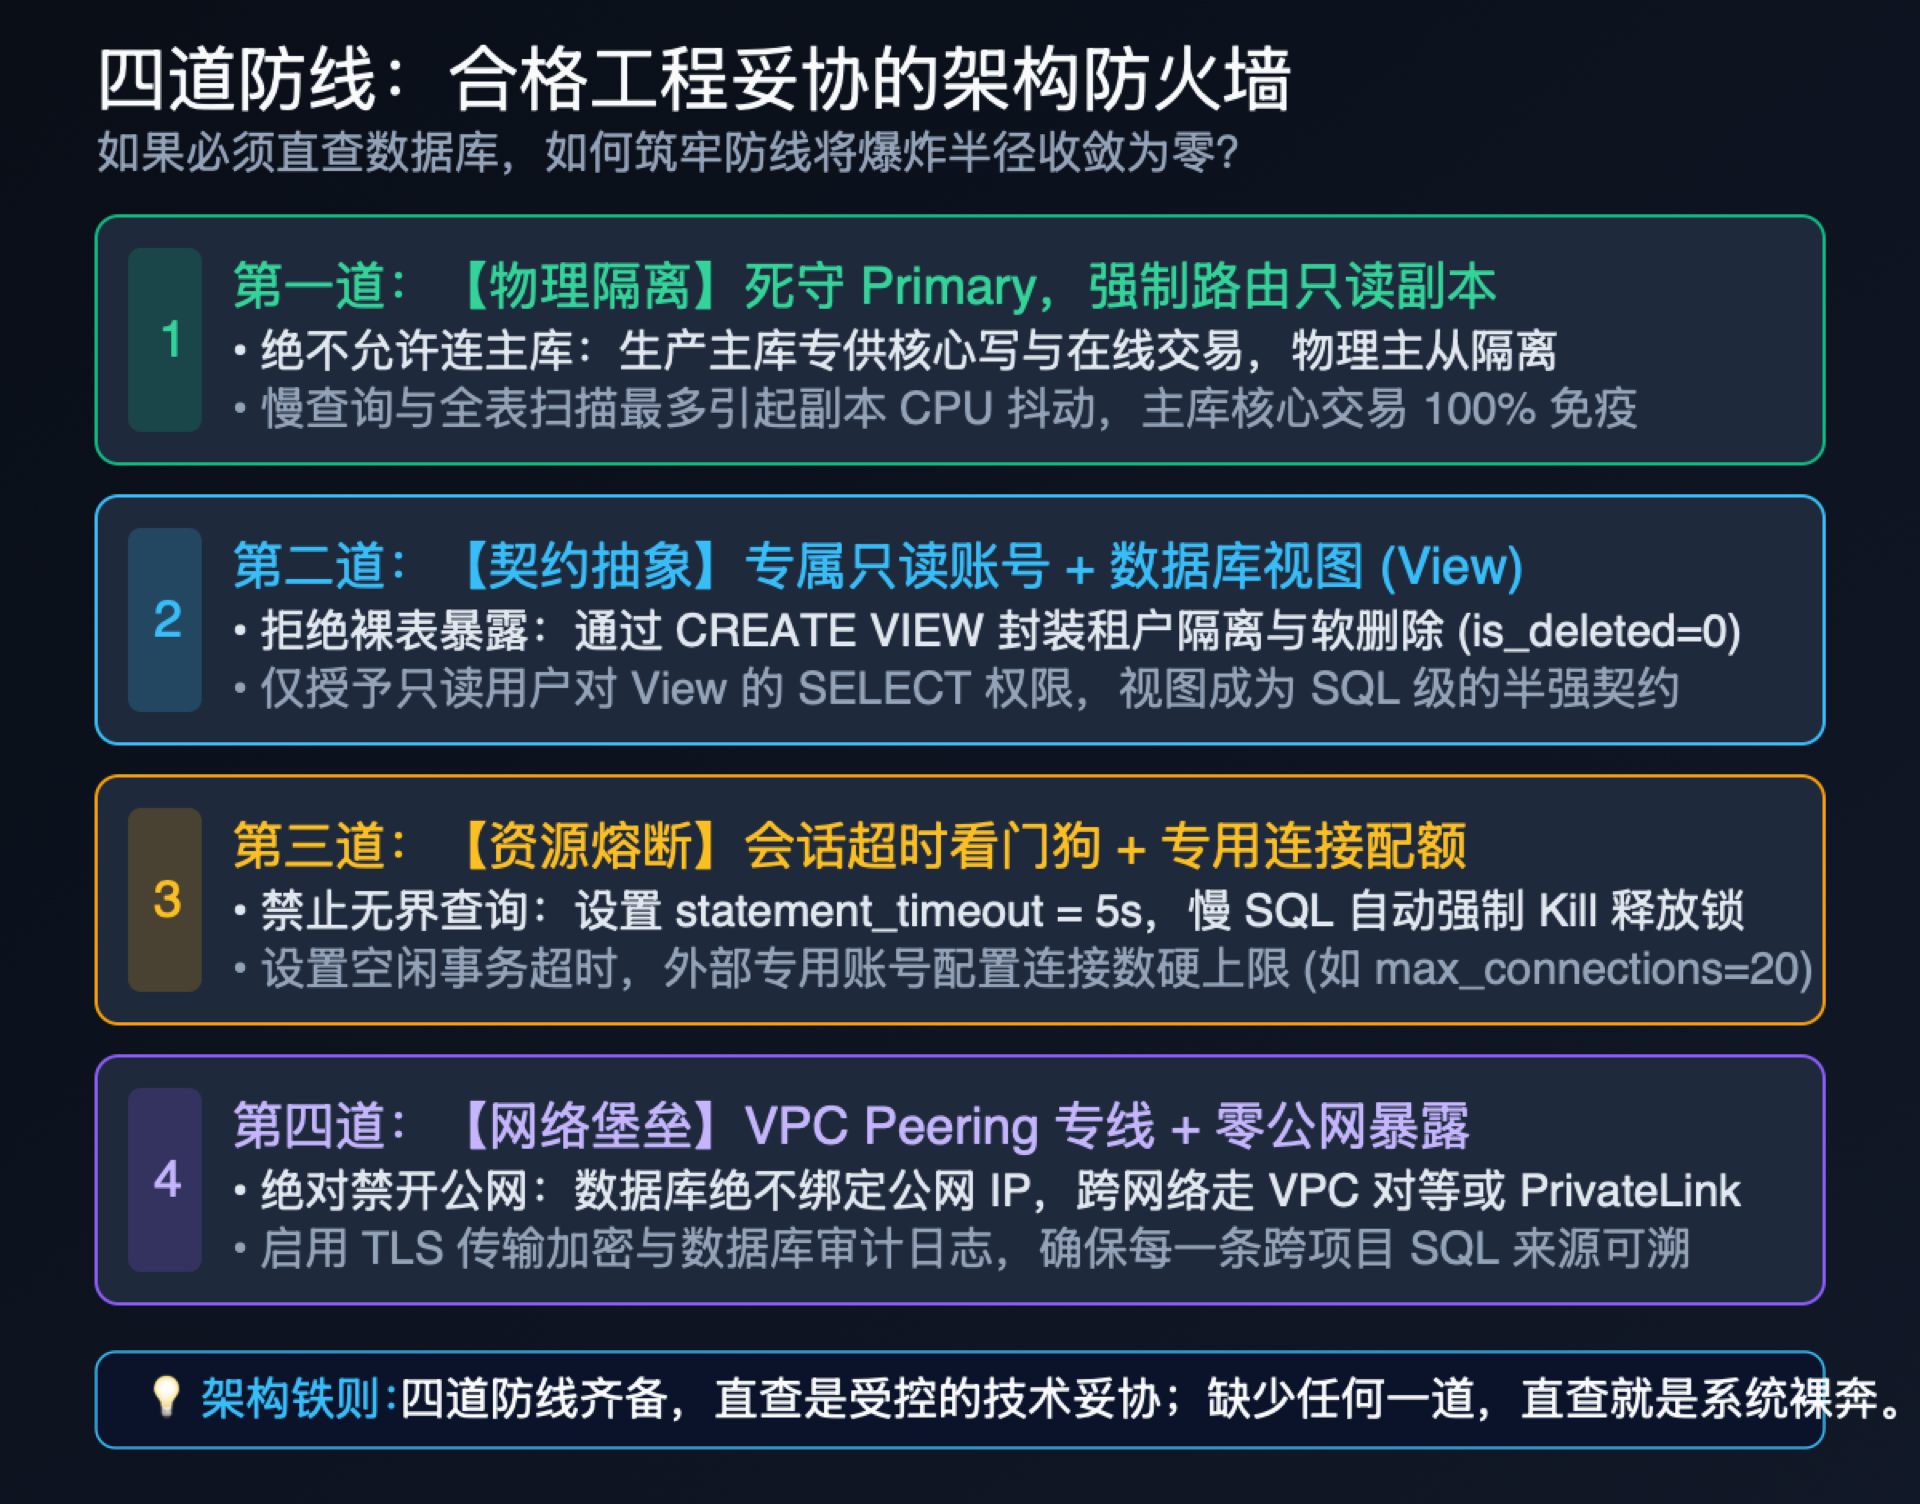
防线 1:【物理隔离】死守 Primary,强制路由只读副本(Read Replica)
这是最重要、最不可妥协的底线:严禁任何外部项目直接连接生产写主库(Primary OLTP)!
- 为数据库实例配置独立的只读从库(Read Replica),所有跨项目查询只给从库只读连接串;
- 物理实例完全隔离后,外部项目无论执行多么低效的慢 SQL、深分页或无索引全表扫描,最多引起从库的 CPU 飙高或主从复制延迟,生产主库的核心交易写入与在线服务点查将受到 100% 的物理级保护。
防线 2:【契约抽象】专属只读账号 + 数据库视图(View)
直接将物理裸表(Raw Tables)全量暴露给外部,是未来维护灾难的策源地。我们可以在 SQL 层构建一层轻量级的"防腐层":
1. 使用视图(View)封装业务规则
源项目团队对外不提供表,只提供专门构建的视图。在视图内部预先固化软删除条件与租户过滤:
sql
-- 为外部项目定制的专属视图:
CREATE VIEW v_external_order_report AS
SELECT
    order_id,
    user_id,
    amount,
    status,
    created_at
FROM t_orders
WHERE is_deleted = 0
  AND status IN ('PAID', 'COMPLETED');
2. 权限最小化与敏感数据脱敏
- 为外部项目建立专用的数据库用户,严格执行只读权限收口:
REVOKE ALL PRIVILEGES,仅GRANT SELECT ON v_external_order_report; - 在视图中直接剔除银行卡号、手机号明文、密码哈希等敏感字段,杜绝数据泄露隐患。物理表后续进行非破坏性重构时,只需更新视图映射,下游调用方完全无感知。
防线 3:【资源熔断】会话超时看门狗 + 专用连接配额
不可控的查询必须有强制熔断机制:
1. 会话级执行超时(Statement Timeout)
在数据库层面,为外部只读角色显式配置强制执行上限。以 PostgreSQL 为例:
sql
-- 为外部查询账号设置强限制:任何查询超过 5 秒直接自动终止释放锁
ALTER ROLE external_bi_user SET statement_timeout = '5000';
ALTER ROLE external_bi_user SET idle_in_transaction_session_timeout = '10000';
2. 连接数硬上限(Connection Limits)
- 为外部账号设定严格的最大连接配额(如限制最多 20 个活跃连接),防止外部服务配置错误或连接泄露瞬间耗尽整库的最大连接数。
防线 4:【网络堡垒】VPC Peering 专线与零公网暴露
任何涉及数据库跨项目通信的网络链路,必须保持企业内网私有化:
- 严禁给数据库开放公网弹性 IP,严禁使用基于互联网的白名单通信;
- 跨 AWS/阿里云账号或跨 VPC 访问时,必须通过 VPC Peering(对等连接) 或 PrivateLink 搭建内网专线隧道;
- 启用 TLS/SSL 传输加密,并配合数据库的慢日志与审计日志(Audit Log),确保每一条跨库查询均可精准审计、责任到人。
四、 演进之路:业界的标准架构迁移梯阶
受控的直查妥协能够解决当下的生存与交付问题,但随着系统体量与团队规模的壮大,架构必须制定明确的演进路径,逐步将技术债务解耦收敛:
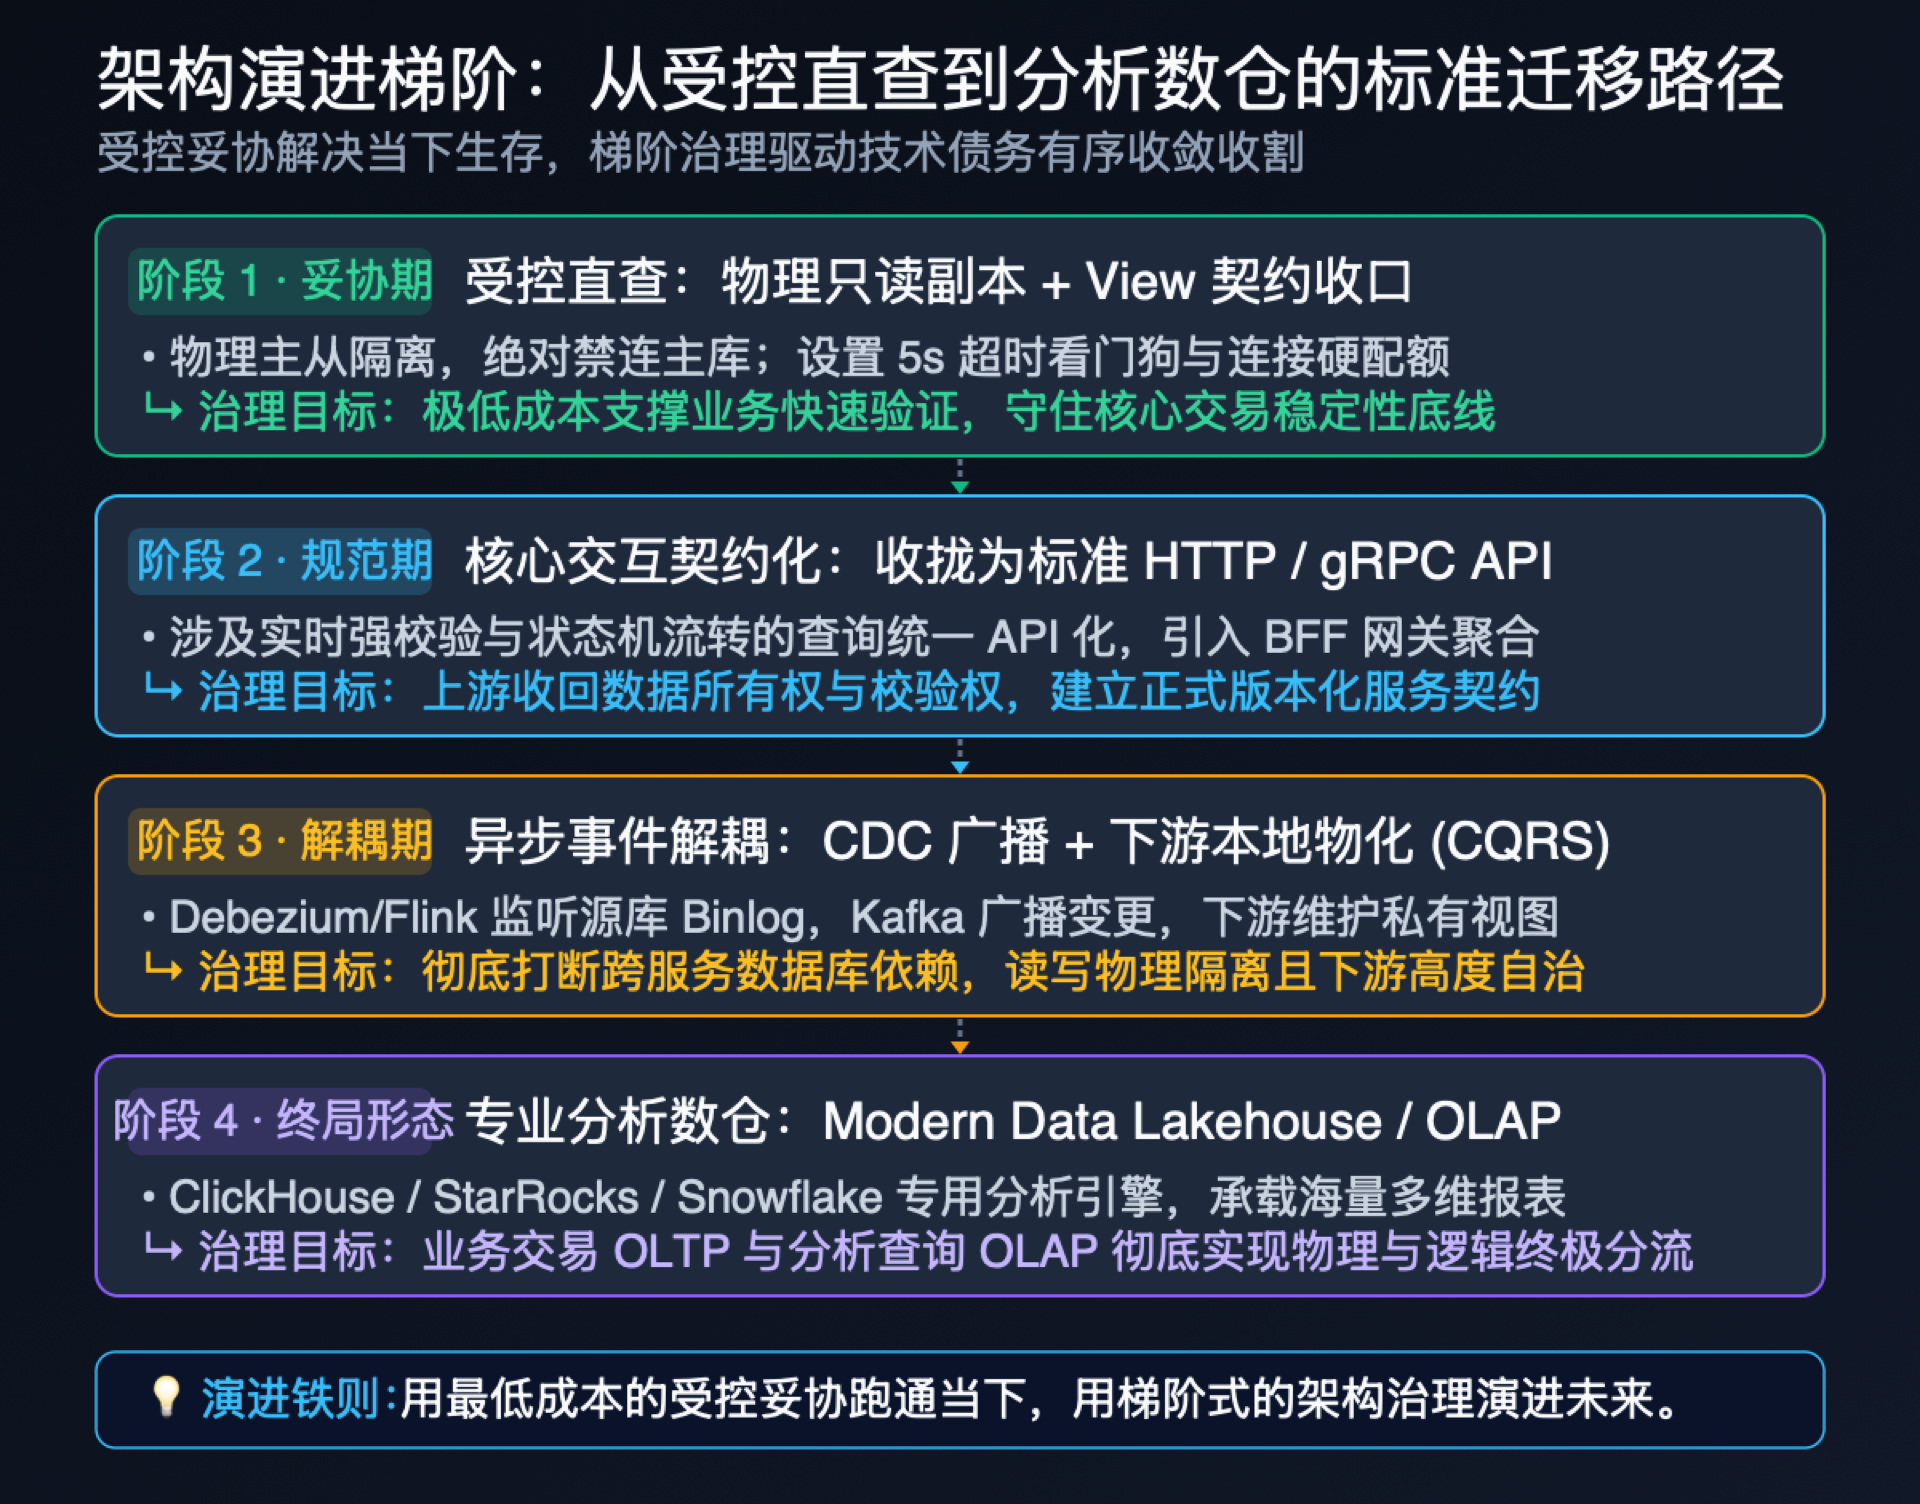
- 阶段 1:受控直查(Pragmatic Compromise)
- 采用上述四道防线(只读副本 + View 抽象 + 超时熔断 + VPC 专线),以最低成本跑通业务,守住稳定性底线。
- 阶段 2:核心在线交互 API 契约化(Contract-First APIs)
- 随着业务成熟,凡涉及在线业务逻辑触发、实时强校验与状态流转的跨项目查询,逐步重构为标准的 HTTP / gRPC 接口,上游收回数据所有权。
- 阶段 3:异步状态解耦与 CQRS(CDC & Event Streaming)
- 对于高频读取与近实时数据消费需求,引入基于 CDC(Debezium / Flink CDC)监听源库 Binlog/WAL 的方案;
- 通过 Kafka 等消息总线将变更事件广播给下游,下游服务在自己的私有数据库中维护局部物化视图,彻底打破跨库依赖。
- 阶段 4:专业分析型数仓(Modern Data Lakehouse / OLAP)
- 海量报表、深度分析与跨域聚合需求统一迁移至 ClickHouse、StarRocks 或 Snowflake 等专业分析型引擎;
- 业务生产数据库与分析查询彻底实现物理与逻辑上的终极分流。
五、 结语:架构的成熟度在于掌控技术债
优秀的系统架构师从来不是只会背诵教科书教条的"洁癖患者",也不是毫无原则拆毁系统底线的"救火队长"。
真正的工程成熟度,是在明确知晓"为什么它是反模式"的前提下,敏锐判断当前业务阶段的 ROI(投入产出比)。当业务约束逼迫你必须踩下反模式的油门时,你能够冷醒、沉着地为系统装上坚不可摧的刹车片。
反模式本身不是罪名,毫无防备的裸奔与失控才是。 守住物理隔离、封装视图契约、配置毫秒熔断,让妥协成为系统可控演化的一部分,这才是现代软件工程中最具实战价值的技术底蕴。