作者:来自 Elastic JD Armada
在每个镜头边界处剪切每个片段,并将每个场景嵌入为向量,然后通过一个纯文本查询返回文件以及可以放置到时间线上的精确秒数。
亲自体验 Search AI 的向量搜索,试试这个自主进度式实践学习。你现在可以开始免费云试用,或者立即在你的本地机器上试用 Elastic。
输入 warm sunset light over a mountain ,就可以获得与之匹配的视频素材的精确秒数。Omnishot 是一个 AI 视频搜索应用,它会监视一个文件夹,并在每个场景边界处剪切每个片段。它使用 jina-embeddings-v5-omni-small 将每个场景嵌入为一个 1,024 维向量。同一个模型同时处理文本和视频,因此输入的查询和视频素材会进入同一个向量空间,而在 Elasticsearch 中进行最近邻搜索,就可以找到与描述相匹配的视频片段。一小时的视频素材大约会生成 1,200 个可搜索向量,而以前需要数小时才能完成数据摄取的文件夹,现在几分钟内就可以处理完成。
这个想法来自 Elastic 的一位视频编辑。她以前需要花费整个下午在 B-roll 文件夹中反复拖动播放进度条,只为了找到某个特定的画面。
通过描述搜索视频素材库
这个应用的工作方式如下:
-
选择一个视频素材文件夹。
-
使用视觉查询搜索片段(drone shot over a coastline)。
-
使用已存储的向量搜索相似片段。
-
在同一个视频片段中查找相似的视频片段。
-
在文件浏览器中显示该视频片段,可以直接放到时间线上。
AI 视频搜索管道的工作方式
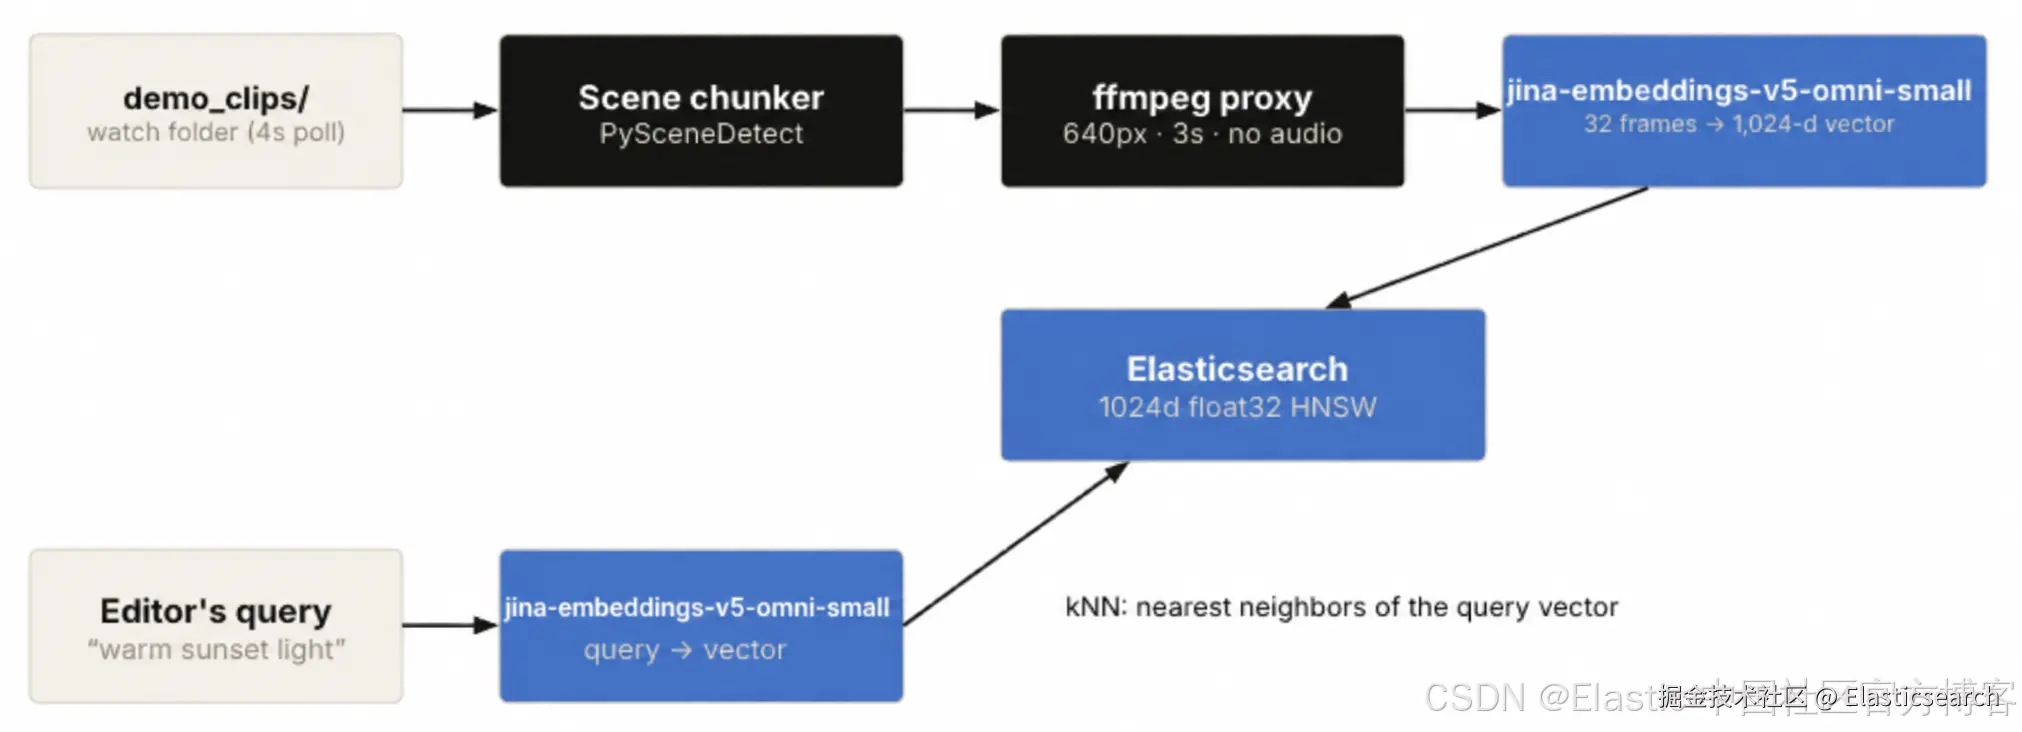
管道流程如下:
-
一个监视器每四秒轮询一次关联的视频素材文件夹(默认为
clips/),检查是否有新的视频素材。 -
PySceneDetect 检测每个视频片段中的场景边界。
-
FFmpeg 在这些边界处剪切视频片段,并使用无损流复制,然后将每个场景片段转码为一个较小的代理文件。
-
代理文件通过 Jina API 发送给 jina-embeddings-v5-omni-small,该模型采样 32 帧并返回一个 1,024 维向量。
-
该向量被摄取到 Elasticsearch 中的
dense_vector字段,并使用分层可导航小世界(HNSW)索引(一种近似最近邻图)。在查询时,编辑器输入的文本会通过同一个模型处理,然后针对已存储的视频片段向量执行 k 近邻(kNN)搜索。
同一个模型同时对文本和视频进行嵌入,这正是 Jina 的 omni 模型如此灵活的原因。视频片段和文本查询会被嵌入到同一个向量空间中,因此最近邻搜索实际上意味着:找到看起来与我用文本描述的内容相符的视频素材。
构建 AI 视频搜索所需的组件
-
Elasticsearch(Serverless 或支持 dense vector 的 8.x 及更高版本)
-
Jina API 密钥
-
PySceneDetect
-
FFmpeg
-
Python 3.9+
下载用于搜索的示例视频素材
如果你手头没有可以用来搜索的视频素材,该代码仓库包含两个下载脚本:其中一个用于从 Pexels API 下载较短的库存视频片段,涵盖自然、城市、动物等类别。另一个使用 yt-dlp 直接从 YouTube 下载较长的纪录片风格视频。
bash
`

1.  python scripts/download_pexels.py --out ./clips --total 50
2.  python scripts/download_youtube.py --out ./clips --total 20

`AI写代码
我们的目标是让短视频和长视频保持良好的组合,以展示分块策略变得多么重要。我们将在下一部分讨论这一点。
如何为嵌入对视频进行分块
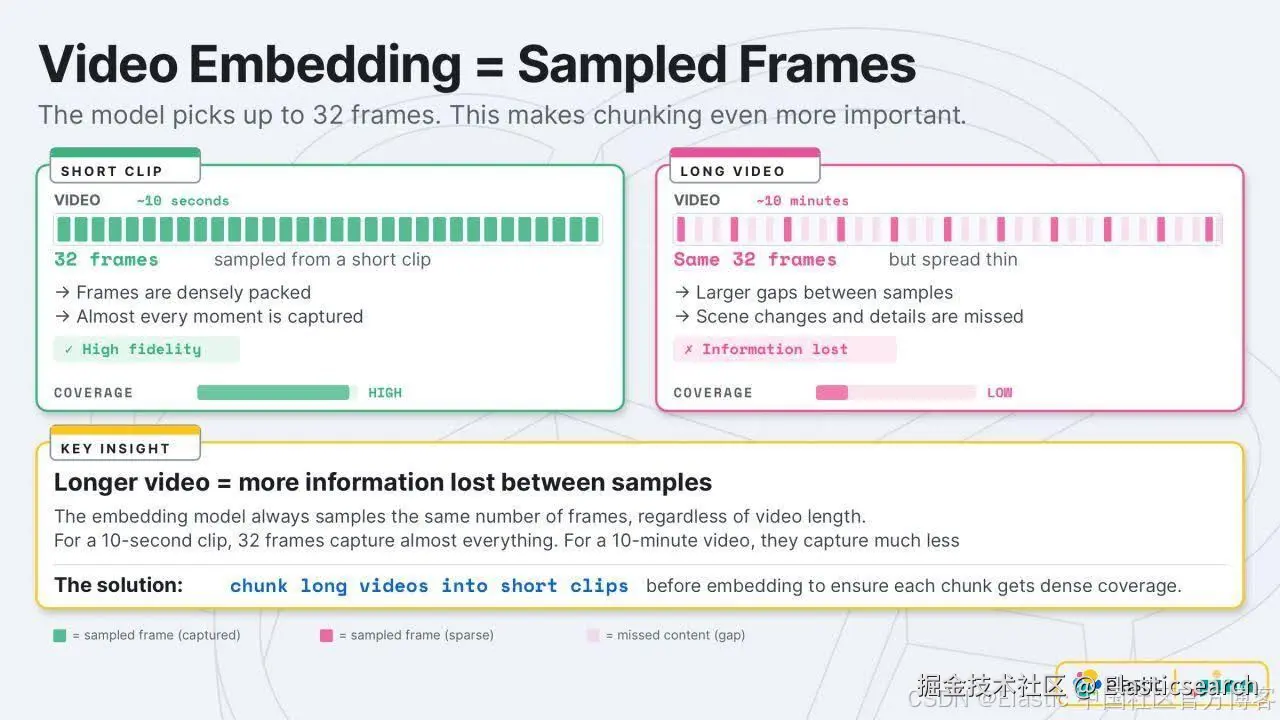
jina-embeddings-v5-omni-small 会从你发送给它的任何视频中均匀采样 32 帧。对于一个 10 秒的视频片段来说,32 帧可以实现密集覆盖;几乎每个时刻都能被捕捉到。对于一部 10 分钟的纪录片,同样的 32 帧会被分散得非常稀疏,以至于整个镜头都可能被遗漏。下面的图示说明了 Jina 模型如何对每个视频片段进行采样,以及较长视频片段存在的局限性:
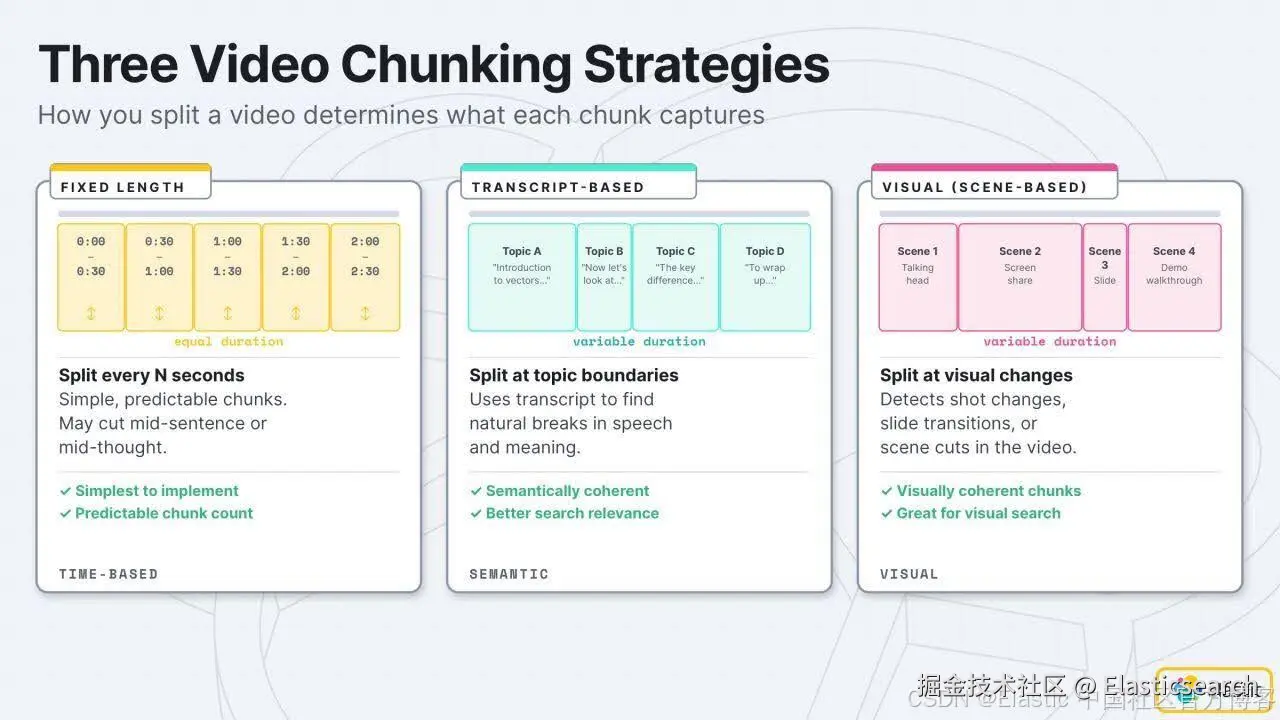
所以,在进行任何嵌入之前,我们首先要进行分块。问题在于应该在哪里进行切分。下面的图示对比了三种策略:
-
固定长度分块:每隔 N 秒进行一次切分。这种方式简单且可预测,但切分点可能落在镜头中间。你最终可能得到一个一半是无人机航拍、一半是人物正面镜头的分块,这会导致搜索结果无法使用。对于这个使用场景来说,这并不是合适的选择。
-
基于转录文本的分块:首先对视频片段进行语音转文本,生成转录文本,然后对其应用文本分块技术,在主题边界处进行切分,并将这些边界映射回视频中的时间戳。这种策略非常适合播客、演讲和教育类内容,但不适合 B-roll,因为 B-roll 通常没有对白。
-
基于场景的分块:在视觉发生变化的位置进行切分,例如镜头切换、转场和剪切。每个分块都是一个特定的画面,这正是视频编辑需要搜索的内容。对于我们的使用场景,这是最合适的方式。
三种策略并列对比:
| 策略 | 如何切分 | 最适合 | 缺点 |
|---|---|---|---|
| 固定长度 | 每隔 N 秒 | 内容均匀、成本可预测 | 切分点可能落在镜头中间,产生混合分块 |
| 基于转录文本 | 在语音转文本结果的主题边界处 | 播客、演讲、教育视频 | 对没有对白的 B-roll 无效 |
| 基于场景 | 在视觉切换和转场处 | B-roll 和视频素材库 | 依赖可靠的镜头检测 |
使用 PySceneDetect 检测场景边界
为了实现这一点,我们使用 PySceneDetect 查找剪切点:
ini
`

1.  from scenedetect import AdaptiveDetector, detect

3.  scenes = detect(
4.  str(video_path),
5.      AdaptiveDetector(
6.          adaptive_threshold=3.0,
7.          min_scene_len=int(min_scene_len_sec * 24),
8.      ),
9.  )

`AI写代码
AdaptiveDetector 会将每一帧的变化与滚动平均值进行比较,从而避免摄像机平移和手持拍摄产生的运动被误判为镜头切换。最小场景长度默认为 1.5 秒,假设每秒 24 帧(FPS),也就是 36 帧,因此快速切换不会产生不到一秒的碎片。如果完全没有检测到边界,则整个视频片段会成为一个分块。随后,每个检测到的场景都会被剪切成独立的分块文件,并使用无损的 FFmpeg 流复制(-c copy),因此在代理文件处理步骤之前不会进行重新编码。
现在,这 32 个采样帧覆盖的是几秒钟内的特定视觉场景,而不是在不同视频片段中粗略地进行采样。
为什么发送 640px 的代理文件,而不是原始文件?
我们不会将原始的完整尺寸文件发送到嵌入 API。一个 4K ProRes 分块可能达到数百 MB,而模型本身也无法利用这种分辨率。它的视觉编码器大约每个 28x28 像素的区块生成一个 token ,而模型的默认配置将每帧限制为 1,280 个视觉 token,相当于大约 1 百万像素。任何更大的图像都会在编码之前缩小以符合这一限制,因此一个 4K 帧进入模型时,大约只有原始像素的八分之一。上传完整分辨率的视频素材,只会在从未使用的分辨率上浪费带宽和时间。如果想深入了解模型如何将帧转换为 patch token,请参阅我们关于 jina-embeddings-v5-omni 架构的深度解析。
因此,我们使用 FFmpeg 将每个场景分块转码为轻量级代理文件:宽度为 640 px、移除音频,并采用高强度压缩。
python
`
1. import base64
2. import subprocess
3. import tempfile
4. from pathlib import Path
6. def make_video_input(
7. chunk_path: Path,
8. max_width: int = 640,
9. crf: int = 28,
10. max_seconds: float = 3.0,
11. ) -> dict:
12. """Return a Jina video input dict with a short 640px proxy as base64."""
13. with tempfile.NamedTemporaryFile(suffix=".mp4", delete=False) as tmp:
14. proxy_path = tmp.name
15. try:
16. subprocess.run(
17. [
18. "ffmpeg", "-y", "-loglevel", "error",
19. "-i", str(chunk_path),
20. "-t", str(max_seconds),
21. "-vf",
22. f"scale='if(gt(iw,ih),{max_width},-2)':'if(gt(iw,ih),-2,{max_width})'",
23. "-c:v", "libx264", "-crf", str(crf), "-preset", "veryfast",
24. "-an", # drop audio, the model never hears it
25. "-movflags", "+faststart",
26. proxy_path,
27. ],
28. check=True,
29. )
30. data = base64.b64encode(Path(proxy_path).read_bytes()).decode("ascii")
31. finally:
32. Path(proxy_path).unlink(missing_ok=True)
33. return {"video": data}
`AI写代码我们来看一下这个函数中两个容易被忽略的部分。scale 滤镜会检查方向 gt(iw,ih),因此横向视频片段的宽度最多为 640 px,而纵向视频片段的高度最多为 640 px,而不会被强行拉伸变形。max_seconds 则将每个代理文件的时长限制为 3 秒。之所以可行,是因为每个分块都是一个独立的视觉内容,所以前几秒已经能够很好地代表整个分块,而在 3 秒内采样 32 帧已经可以实现密集覆盖。该函数返回 {"video": <base64>},这正是 Jina API 所要求的输入格式。
在一定范围内,画质损失并不重要。嵌入关注的是帧中包含什么内容,而不是视频素材的质量是否足以用于最终交付。但是,如果压缩得过于激进,视觉细节开始消失,模型可能就无法再可靠地判断每一帧中包含什么内容。目标是在不丢失重要视觉信息的情况下缩小文件。代理文件的大小从数百 MB 降到了几百 KB,因此摄取一个视频素材文件夹只需要几分钟,而不是几个小时。
随后,每个代理文件都会以 base64 字符串的形式发送到 Jina API,而 API 会返回该分块对应的 1,024 维向量:
css
`
1. resp = requests.post(
2. "https://api.jina.ai/v1/embeddings",
3. headers={"Authorization": f"Bearer {JINA_API_KEY}"},
4. json={
5. "model": "jina-embeddings-v5-omni-small",
6. "task": "retrieval.passage",
7. "dimensions": 1024,
8. "embedding_type": "float",
9. "normalized": True,
10. "input": [make_video_input(chunk_path)], # {"video": "<base64>"}
11. },
12. )
13. embedding = resp.json()["data"][0]["embedding"] # 1024 floats
`AI写代码task 参数在这里非常重要。分块会使用 task="retrieval.passage" 进行索引,而在搜索时,查询文本会使用 task="retrieval.query" 进行嵌入。该模型会生成针对检索进行调优的非对称嵌入,一侧用于文档,另一侧用于查询。
我们还将 dimensions 固定为 1024,并将 normalized 设置为 true。对于余弦相似度来说,并不要求进行归一化,因为余弦相似度衡量的是向量之间的夹角,而向量长度不会影响得分。归一化的作用是让每个向量都具有单位长度,而对于单位向量,点积就等于余弦相似度,因此引擎可以跳过向量长度的计算,直接使用普通点积来比较向量。
使用 Elasticsearch 时,你可以利用归一化向量,将字段的 similarity 映射为 "dot_product",而不是 cosine,从而跳过查询时的归一化开销。代码仓库为了安全起见仍然使用 cosine,因为即使某个未归一化的向量意外混入其中,它也仍然可以正常工作。
在代码仓库中,这个请求位于一个小型客户端类(backend/lib/embed_jina.py)中,该类还会在遇到速率限制和临时服务器错误时使用指数退避进行重试。获取向量后,我们就可以将这些向量摄取到 Elasticsearch 中。
将视频嵌入摄取到 Elasticsearch
首先,我们定义一个显式的映射。Elasticsearch 可以动态推断字段类型,这意味着在索引时,第一个写入的文档就可能决定字段的映射方式。在这里,我们希望明确指定:ID 应该使用 keywords;视频内时间戳,例如 start_sec 和 end_sec,应该使用 floats;最重要的是,嵌入字段需要配置为 1,024 维的 dense_vector,使用 cosine 相似度和 HNSW 索引。
下面是该索引的映射:
bash
`
1. mappings = {
2. "properties": {
3. "chunk_id": {"type": "keyword"},
4. "clip_id": {"type": "keyword"},
5. "path": {"type": "keyword", "index": False},
6. "start_sec": {"type": "float"},
7. "end_sec": {"type": "float"},
8. "duration": {"type": "float"},
9. "strategy": {"type": "keyword"},
10. "uploaded_at": {"type": "date"},
11. "uploader": {"type": "keyword"},
12. "tags": {"type": "keyword"},
13. "transcript": {"type": "text", "analyzer": "english"},
14. "embedding": {
15. "type": "dense_vector",
16. "dims": 1024,
17. "index": True,
18. "similarity": "cosine",
19. "index_options": {"type": "hnsw"},
20. },
21. }
22. }
`AI写代码有几个值得注意的地方:
-
dims为 1024,以匹配模型的输出。 -
similarity使用 cosine,因为 Jina 嵌入是针对余弦距离进行训练的。正如前面提到的,对于归一化向量,dot_product得分完全相同,而且速度会稍快一些,但为了安全起见,我们仍然使用 cosine。 -
使用 HNSW 和
index: True会在索引时构建近似最近邻图,因此查询时不需要对每个向量进行暴力搜索。 -
start_sec/end_sec让我们能够直接将编辑器跳转到视频片段中的正确时间点,而不仅仅是找到正确的文件。 -
其余字段都是普通元数据:
path会被存储,但不可搜索("index": False),这样应用就可以播放对应的分块文件;duration和strategy描述分块的生成方式;tags/transcript则为以后进行关键词和转录文本搜索预留空间。
这意味着每个场景分块对应一个文档,而不是每个视频片段对应一个文档。一部 10 分钟的纪录片可能会变成 80 个文档。关键在于每个文档都可以被独立找到。需要注意的是,视频本身不会被放入 Elasticsearch。一个文档只是向量加上几个元数据字段,其中包括一个 path,指向磁盘上的分块文件。视频素材仍然保留在原来的位置,而 Elasticsearch 纯粹充当索引,用来告诉我们哪个文件以及其中的哪几秒与查询匹配。
这个应用针对本地文件夹运行,因此path是文件系统路径。如果你要将其构建为托管服务,那么视频片段会存储在对象存储中,例如 Amazon S3 或 Google Cloud Storage,而该字段则会保存指向存储对象的指针,但整体架构保持不变。
对视频分块执行向量搜索
在查询时,编辑器中的文本会经过相同的模型。Warm sunset light 会变成一个 1,024 维的向量,与视频分块位于相同的向量空间中,然后我们让 Elasticsearch 查找它的最近邻:
ini
`
1. res = es.search(
2. index="broll",
3. knn={
4. "field": "embedding",
5. "query_vector": query_vector,
6. "k": 50,
7. "num_candidates": 100,
8. },
9. size=50,
10. source_excludes=["embedding"],
11. )
12. hits = [{**h["_source"], "_score": h["_score"]} for h in res["hits"]["hits"]]
`AI写代码k 表示返回多少个邻居;num_candidates 表示每个分片在排序之前会考虑多少个候选结果。更高的候选数量意味着更好的召回率,但会带来略高的 latency 。我们还会从响应中排除 embedding 字段,因为每个命中结果包含 1,000 个浮点数,而对于 UI 从不读取的值来说,这会产生大量 payload。我们获取的结果数量会多于实际显示的数量(对于九张卡片的网格会获取 50 个),这是因为接下来还需要进行进一步处理。
_查找相似视频片段_的工作方式相同,只不过查询向量不再来自嵌入后的文本,而是来自一个已存储的视频分块嵌入。不需要调用第二次模型;该向量已经存在于索引中。
对来自同一视频片段的结果进行去重
我遇到的一个问题是,同一个视频片段中的分块太多,以至于占满了整个结果网格。搜索 mountains 时,一部 10 分钟的自然纪录片可能有十几个分块与查询匹配,从而把其他所有视频片段都挤出了顶部结果。这在技术上是正确的,但对于希望获得更多选择的编辑来说,实际上并没有什么用。
解决方法是保留每个视频片段中得分最高的分块,作为每张结果卡片的代表,同时允许用户展开卡片,查看来自同一视频片段的其他匹配分块:
python
`
1. def _hits_payload(hits, exclude_id: str | None = None, k: int = 9):
2. """One card per clip (best chunk first), counting matched sibling scenes."""
3. out = []
4. cards_by_clip = {}
5. for h in hits: # hits arrive sorted by score
6. if h["chunk_id"] == exclude_id:
7. continue
8. clip_id = h["clip_id"]
9. card = cards_by_clip.get(clip_id)
10. if card is None:
11. card = {**_chunk_payload(h), "more_matches": 0}
12. cards_by_clip[clip_id] = card
13. out.append(card)
14. else:
15. # A lower-ranked scene from a clip we already show.
16. card["more_matches"] += 1
17. return out[:k]
`AI写代码这就是为什么我们会在查询时过量获取结果。先获取 50 个命中结果,将其折叠为每个视频片段一张卡片,然后显示 9 张。exclude_id 用于处理_查找相似视频片段_的情况,否则作为种子的视频分块本身可能会再次出现在顶部结果中;而 _chunk_payload 则简单地将每个命中结果裁剪为 UI 所需的字段。more_matches 数量会在 UI 中显示为"来自此视频片段的另外 +4 个结果"徽章。展开该徽章不会再次调用嵌入 API;应用会缓存最近的查询向量,并通过针对该视频片段进行过滤的 kNN 搜索重新执行查询,同时对 clip_id 使用 term 过滤器。
结论:场景分块在规模化场景下的成本
以上就是完整的设置流程;它从监视一个文件夹开始,在场景边界处进行切分,为代理文件生成嵌入,对向量建立索引,最后使用自然语言进行搜索。编辑器输入他们需要的视频画面,系统就会返回相应的视频素材以及时间戳,并提供一种快速获取实际视频片段的方式。
该索引中的每个向量都是 1,024 个 float32 值,大约为 4 KB。即使对于演示来说,这个大小也不算多。我们的 70 个视频片段的文件夹会生成几百个分块,对应几 MB 的向量。但场景分块的规模增长非常快。按照每个场景大约 3 秒计算,1 小时的视频素材已经会产生约 1,200 个向量,因此一个规模适中的 1,000 小时视频档案就会超过 100 万个向量,对应数 GB 的浮点数;而一个拥有数亿个向量的大型视频素材库,其索引规模则会达到 TB 级别。由于 HNSW 希望将这些向量保存在内存中,以便快速搜索,因此成本可能会迅速增加。在本系列的第 2 部分中,我们将比较量化与降维这两种非常不同的缩减索引大小的方法,以及每种方法在召回率方面需要付出的代价。