1 ClickHouse 对 Metrics 的投入与 Prometheus 支持的演进
在《谁才是时序数据库在可观测领域真正的对手?》中,我把 ClickHouse 这类实时 AP 引擎列为时序数据库需要长期正视的对手。1 当日志、Trace 和指标都要求高吞吐写入、多维筛选与聚合时,底层计算能力会越来越接近,差异逐渐落到数据组织、索引、缓存,以及已有的使用习惯上。ClickHouse 已经进入日志和 Trace 场景,继续对 Metrics 出手是必然的。用户的数据已经有一部分在这里,接下来要争取的,就是仍然留在 Prometheus 生态里的指标存储和查询。
前文也指出了当时需要关注的两个问题:标签以 Map 形式存进表后,任意维度筛选的效率如何保证;PromQL 应当进入 ClickHouse 的执行计划,才能把计算能力用起来。只提供 remote read,由 Prometheus 拉回样本后再计算,ClickHouse 承担的主要还是远端存储,传输量也随返回的原始样本增长。这次正好回到源码和可运行的版本,检查这两个问题现在做到了哪一步。
2026 年 9 月 newsletter 收录的 Introducing ClickHouse's new TimeSeries Engine: Your drop-In Prometheus replacement,把这件事推到了更明确的产品层面。23 TimeSeries 和原生 PromQL 已经经历了多轮迭代,几个关键节点可以连起来看:
- 2024 年 8 月,ClickHouse 24.8。 实验性的 TimeSeries 引擎加入 remote write 和 remote read,已经能接收 Prometheus 指标并返回样本;当时的发布演示仍把 PromQL 列为待完成工作。4
- 2025 年 8 月,ClickHouse 25.8。 开始加入 PromQL 支持,从兼容读写协议继续走向数据库内执行。ClickHouse 在 2026 年 8 月的官方回顾中明确给出了这个起点。5
- 2026 年 6 月。 ClickStack 开始提供实验性的 PromQL datasource 和 chart editor,底层使用 TimeSeries。6 月 23 日发布的更新说明记录了这一轮变化,并提醒存储模型和 API 仍可能调整。6
- 2026 年 9 月 15 日。 ClickHouse 宣布 Cloud 上 TimeSeries 与 PromQL 的 private preview,并介绍 ClickStack、Grafana 等查询入口。此次接管的范围是指标存储和查询,采集继续沿用原来的 Prometheus、agent 或 collector;规则执行仍有后续计划。3
所以,支持始于 24.8,25.8 开始补查询语言,2026 年继续把 UI、HTTP 接口和 Cloud 接入串起来。这里还没有一个可以写成全面完善的时间点。本文的重点是已经落地的存储与执行架构,以及它距离现有 Prometheus 工作负载还有哪些差异。
2 TimeSeries 存储与 PromQL 执行架构
以下基于 2026 年 9 月 19 日核查时最新的正式发行版 ClickHouse 26.8.7.19 LTS ,下载对应源码,并以 Prometheus 3.14.0 做本地对照。78 实验使用 macOS arm64、本地 MergeTree;master 的变化会单独说明,不能与 LTS 或 Cloud private preview 混为一谈。完整配置、原始响应和版本哈希放在实验目录与源码记录。
2.1 时间线组织、目标表与写入过程
2.1.1 四张目标表与 remote write 写入流程
TimeSeries 默认使用四张目标表:9
| 表 | 存储的数据 | 引擎 | 排序键 | 默认分区 |
|---|---|---|---|---|
| Tags | 时间线 id、指标名、完整标签、最早/最晚时间 | AggregatingMergeTree | (metric_name, id) |
无分区键 |
| Samples | 全量原始样本:id、timestamp、value |
MergeTree | (id, timestamp) |
无分区键 |
| Recent Samples | 近期原始样本的副本,默认保留 4 天 | MergeTree | (id, timestamp) |
每 5 小时 |
| Metrics | 指标族的名称、类型、单位和说明 | ReplacingMergeTree | metric_family_name |
无分区键 |
外层 TimeSeries 提供统一读写入口,数据实际存在这四张表里。同一个 TimeSeries 表中的全部指标、时间线共用它们,新增时间线只增加数据行。Recent Samples 可以关闭,此时剩下三张目标表。
Tags 和 Samples 通过序列 id 关联。 指标名与完整标签集确定一条时间线,Tags 保存它的标签和出现过的时间范围,Samples 保存它的各个采样点。Samples 同时包含历史和近期数据,Recent Samples 额外保留一份近期数据,两张表里的样本精度相同。Metrics 保存指标族的类型、单位和说明,同一指标下不同 instance 的时间线可以共用这份 metadata。
从本地实验取一条时间线,其数据关系如下。A 是实际序列 id 的简称:
text
时间线:http_requests_total{instance="a", job="api"}

Tags:
  id=A, metric_name=http_requests_total
  tags={__name__:http_requests_total, instance:a, job:api}
  min_time=t0, max_time=t0+15s

Samples:
  (A, t0,     100)
  (A, t0+15s, 115)

Recent Samples:
  与 Samples 相同的两行

Metrics:
  (http_requests_total, counter, requests, "Total HTTP requests")
这里每个样本只保存 id、时间和值,完整标签不需要随每个点重复存储。底层按 (id, timestamp) 排序,同一时间线的数据在每个 part 内相邻;不同批次写出的数据可以分布在多个 part 中。
一次 remote write 按以下流程拆分:1011
- 解析请求。 HTTP handler 解压 Snappy、解析 protobuf,提取每条时间线的 labels、样本数组,以及请求携带的 metadata。
- 生成序列 id。
TimeSeriesSink对 labels 排序、去除空值和完全相同的重复项,再计算 id。默认 id 由指标名哈希与完整标签集哈希组成;同一时间线在不同批次得到相同 id,同一指标的 id 共享前缀,便于样本聚集。12 - 写标签和样本。 先向 Tags 推送 id、标签及本批样本的最早/最晚时间,再将样本数组展开成
(id, timestamp, value),分别写入 Recent Samples 和 Samples。 - 写 metadata 并完成请求。 请求携带的指标说明写入 Metrics;只发送样本时,不会自动生成这些说明。各表使用独立的写入 pipeline,不提供失败后的跨表回滚。
2.1.2 Tags 记录合并与时间范围过滤
已有时间线也会追加 Tags 记录。 例如给 A 再写一个点,Samples 和 Recent Samples 各增加一行,Tags 也追加一行 A 的标签和新时间范围。后台 merge 时,AggregatingMergeTree 将相同序列的记录合并,min_time 取最小值,max_time 取最大值。因此,Tags 在合并前可以有同一时间线的多条记录。Samples 是普通 MergeTree,相同 (id,timestamp) 的重复样本也可能保留多行,查询侧再处理重复点。11
这里的 min_time/max_time 只用于排除时间范围完全不相交的序列 ,它属于序列 id,并非每个标签各有一份。筛选条件是 max_time >= read_start AND min_time <= read_end,其中 read_start/read_end 是查询实际需要读取的样本范围。13 假设一条序列仅在 10:00 和 18:00 各写一个点,Tags 合并后的范围就是 [10:00,18:00]。查询读取 12:00---13:00 时,这个 id 仍会通过筛选,但样本表里没有对应的点。合并确实丢失了中间空洞的信息:它能排除尚未出现、或早已停止写入的序列,却无法判断一条长期存活的稀疏序列在窗口内是否有数据。代价是多选了一些候选 id,仍需到样本表按时间过滤;这个范围本身不会生成样本。
2.1.3 时间分区与 Recent Samples 的取舍
默认情况下,Recent Samples 按时间分区,Samples 不按时间分区。 Recent Samples 每 5 小时一个分区、设置 4 天 TTL;Samples 保存全部样本,默认没有 TTL。写入时两张表各保存一份,近期查询优先读 Recent Samples,读取范围超出其保留窗口时则全部读 Samples。913 两张表之间没有数据搬迁、拼接或降采样。
也可以让 Samples 按天分区,并关闭 Recent Samples,由一张样本表同时承担近期和历史查询。 例如:914
sql
SET allow_experimental_time_series_table = 1;

CREATE TABLE metrics_daily
ENGINE = TimeSeries
SETTINGS recent_samples_ttl_seconds = 0
SAMPLES INNER ENGINE = MergeTree
PARTITION BY toDate(timestamp)
ORDER BY (id, timestamp);
PARTITION BY toDate(timestamp) 让 Samples 按时间戳列的时区划日,查询近期数据时可以跳过历史日期;recent_samples_ttl_seconds=0 则关闭近期副本,目标表只剩 Tags、Samples、Metrics 三张。修改 Samples 的分区方式不会自动关闭 Recent Samples,需要显式设置。 Tags 仍按 id 描述时间线,Metrics 保存指标说明,无须与样本表对齐分区。按天分区也不会自动删除历史数据,保留周期仍需单独配置 TTL 或通过显式操作管理。15
这样可以省去近期样本的双写、重复存储和额外 merge。保留 Recent Samples 的理由,是希望长期与近期数据使用不同的物理配置,例如默认主表索引粒度为 32768,近期表为 8192;若一张按时间分区的 Samples 已满足查询需求,就不必再维护副本。两种配置的性能差异仍取决于负载,本文没有做这项 benchmark。14
这里的 partition 是本地表内分区,shard 是多节点之间的数据分片;默认目标表不会自动按 id 分到多个 shard。16 按天分区与查询结果的本地验证见实验目录。
2.1.4 标签倒排索引
倒排索引需要区分版本。 本文实测的 26.8 LTS 默认没有标签倒排索引:Tags 的主键是 metric_name,可以按指标名剪枝,instance="a" 这样的条件仍需读取标签数据后过滤。取得符合条件的 id,再利用 Samples 的 (id,timestamp) 主键读取样本。
截至 2026 年 9 月 19 日核查的 master,schema version 5 已为新建内部 Tags 表增加以下索引,索引直接建在 tags 这个 Map 列上:1718
sql
INDEX tags_idx tags TYPE text(tokenizer='keyValuePairs')keyValuePairs 将完整的 (标签名, 标签值) 编成一个 token,例如 (instance,a) 和 (job,a) 是两个不同的 token;value 中即使有空格,也仍作为完整值参与编码。每个 Tags part 中,索引通过词典和 posting list 记录 token → 本 part 内的行号集合。1920 因而索引既保留了 key 与 value 的对应关系,也能定位包含这个标签对的具体行。
用三行假设数据说明,省略指标名和时间范围:
| Tags 行号 | 序列 id | tags |
|---|---|---|
| 0 | S1 | {instance:a, job:api} |
| 1 | S2 | {instance:b, job:api} |
| 2 | S3 | {instance:a, job:worker} |
查询 {instance="a", job="api"} 对应的标签条件是 tags['instance']='a' AND tags['job']='api'。两个标签对分别查到 posting list,再取交集:
text
(instance,a) → 行号 {0,2}
(job,api)    → 行号 {0,1}
交集        → 行号 {0} → 读取该行得到 id=S1 → 按 id 和时间读取样本表
倒排列表中存的是 Tags 行号,取出这一行后才得到序列 id;索引随 Tags 的 part 存储,四张目标表的关系不变。该快照的 keyValuePairs 查询路径支持 Map 元素的非空等值匹配,上例可以利用索引;正则、否定和空值匹配不能沿用这条等值查找路径。空值尤其需要小心:tags['job']='' 还可能匹配没有 job 的行,单查一个 (job,空串) token 会漏掉它们,源码因此不走这条索引路径。21 以上是固定 master 的实现分析,本文没有运行 master 验证性能。
完整表内容、追加写入前后变化及查询计划见物理布局实验。
2.2 PromQL 到 ClickHouse 执行计划
2.2.1 PromQL 到 SQL 的转换
ClickHouse 先将 PromQL 解析为 query tree,再由 PrometheusQueryToSQL 把 selector、函数和聚合逐层转换为 SQL AST,交给 ClickHouse 的查询分析、优化和执行流程。22 例如:
promql
sum by (job) (rate(http_requests_total[60s]))它的核心计算可以简化为下面的逻辑 SQL。selected_samples 代指已经按指标名和时间筛选、并带有 job 标签的样本集合;start_ts/end_ts 是求值区间,示例每 15 秒求值一次。这里省略了取数、标签编码和输出整理,只保留 rate 与 sum 的对应关系:2324
sql
SELECT job, sumForEach(rates)
FROM
(
    SELECT id, job,
           timeSeriesRateToGrid(start_ts, end_ts, 15, 60)
               (timestamp, value) AS rates
    FROM selected_samples
    GROUP BY id, job
)
GROUP BY job;
内层按序列 id 计算 rate,外层按 job 将不同序列在同一求值时刻的结果相加。先算 rate、再 sum,才能分别处理各个实例的 counter reset。完整可执行版本保留在实验 SQL中。
2.2.2 目标表访问与 selector 封装
timeSeriesTags、timeSeriesSamples、timeSeriesMetrics 是访问目标表的表函数。传入外层 TimeSeries 表名,函数就取得对应的实际表,内部表和外部目标表都适用,无须手写带 UUID 的内部表名。25
| 表函数 | 访问对象 | 返回的数据 |
|---|---|---|
timeSeriesTags(metrics_daily) |
Tags | id、指标名、标签和时间范围 |
timeSeriesSamples(metrics_daily) |
Samples | id、timestamp、value |
timeSeriesMetrics(metrics_daily) |
Metrics | 指标族名称、类型、单位和说明 |
例如 SELECT * FROM timeSeriesSamples(metrics_daily) 就是读取主样本表。这个函数固定指向 Samples,不会自动切换到 Recent Samples,也不会代替调用者完成标签筛选或 rate 计算。
PromQL 转换器取数时使用的是更高一层的 timeSeriesSelector:输入 TimeSeries 表、PromQL selector 和读取时间范围,由它筛选 Tags 中的候选 id,再读取对应样本,并在条件满足时选择 Recent Samples。2613 前面的 selected_samples 概括了这部分取数及标签关联结果。
2.2.3 timeSeries*ToGrid 算子
timeSeries*ToGrid 接收一条序列的原始样本,按 start/end/step 在每个求值时刻计算一次,返回结果数组。本文 LTS 的 PromQL 转换器包含以下窗口函数映射:23
| PromQL 函数 | ClickHouse 聚合函数 | 每个窗口计算的结果 |
|---|---|---|
rate |
timeSeriesRateToGrid |
处理 reset、外推后的每秒增长率 |
increase |
timeSeriesIncreaseToGrid |
处理 reset、外推后的窗口增长量 |
irate |
timeSeriesInstantRateToGrid |
根据最后两个样本计算的每秒增长率 |
delta |
timeSeriesDeltaToGrid |
Gauge 首尾差值的窗口外推 |
idelta |
timeSeriesInstantDeltaToGrid |
最后两个样本的差值 |
last_over_time |
timeSeriesLastToGrid |
窗口内最后一个样本值 |
deriv |
timeSeriesDerivToGrid |
线性回归得到的每秒变化率 |
changes |
timeSeriesChangesToGrid |
样本值发生变化的次数 |
resets |
timeSeriesResetsToGrid |
Counter 重置次数 |
用一条每 15 秒增长 15 的 counter 举例,时间以相对秒表示:
text
采样时间: 0   15   30   45   60   75   90
样本值:   0   15   30   45   60   75   90

timeSeriesRateToGrid(60, 90, 15, 60)(timestamp, value)
结果约为:[1, 1, 1]
参数表示从第 60 秒到第 90 秒、每 15 秒求值一次,每次取前 60 秒的样本。因此数组对应第 60、75、90 秒,窗口依次为 (0,60]、(15,75]、(30,90]。2728 rate 自身负责 reset 和边界外推,窗口不足两个样本时返回 NULL。29 这个数组只是查询中间结果,不会改写存储中的原始样本。
2.2.4 一次查询的执行流程
仍以 sum by(job)(rate(http_requests_total[60s])) 为例,查询在第 60、75、90 秒求值,数据读取与计算按以下顺序进行:
- 解析表达式,确定读取范围。 根据 60 秒窗口,将原始样本读取范围扩展为
(0,90],并生成包含 selector、rate 和 sum 的执行计划。 - 筛选时间线并读取样本。
timeSeriesSelector按指标名、标签条件和时间范围取得候选 id,选择 Samples 或 Recent Samples,再按 id、timestamp 读取数据。 - 逐序列计算 rate。 按完整序列分组,执行
timeSeriesRateToGrid。本地实验中,同属job=api的 instance a、b 分别得到约[1,1,1]、[2,2,2]。 - 按 job 聚合。 将分组标签收缩为
job,通过sumForEach对数组的对应位置求和,得到约[3,3,3]。 - 整理返回结果。
timeSeriesFromGrid将数组与求值时间配对,省略NULL点,再连同结果标签交给查询接口返回。
本地的实际查询计划包含样本读取、timeSeriesRateToGrid、标签转换与重复序列检查、sumForEach 和结果整理。完整 SQL 与 ClickHouse 原生 PromQL 的三个时间戳、三个数值逐项一致,输入和原始结果保留在实验目录。
3 当前的 Prometheus 兼容性
3.1 本地测试的覆盖范围与结果
本地对照使用 ClickHouse 26.8.7.19 LTS 与 Prometheus 3.14.0,向两侧写入相同的构造数据,再比较查询返回的标签、时间戳和数值。普通浮点样本的 remote write v1、remote read,以及 instant/range query 的主要路径已经跑通。42 项定向查询的结果如下:
| 结果 | 用例数 | 代表用例 |
|---|---|---|
| 结果一致 | 32 | rate/increase/irate/resets、sum by(job)、group_left(zone)、集合运算、classic histogram_quantile |
| ClickHouse 返回未实现 | 8 | avg_over_time、sum_over_time、absent、predict_linear 等 |
| 查询结果不同 | 2 | 同一 stale marker 场景的 instant query 与 range query |
这说明常用查询已经有了可用的基础,函数覆盖和结果语义仍有缺口。测试主动选择了迁移时需要检查的表达式,没有运行完整的 Prometheus compliance suite,32/42 不能当成整体兼容率 。测试方法与完整响应见实验记录。
接口和输入类型也有差异。本地 /series 可用,/labels 与 label values 返回未实现,/metadata、/rules、/alerts 返回 404;标准 remote-write v2 Content-Type 被 415 拒绝。v1 请求里的 native histogram 和 exemplar 虽然收到 204,相关内容却没有保存,源码中也缺少对应保存路径。10 这里通过的是用普通浮点序列表达的 classic histogram,不能据此推断 native histogram 可用。其他接口参数检查保留在原始结果中。
3.2 官方公布的兼容范围
2026 年 9 月 15 日的发布文章给出的口径是 PromQL dialect coverage 超过 85%,并明确表示会继续推进到 100%。这描述的是官方的语言覆盖进展,与本文 42 项定向测试的统计口径不同,也不能直接套到本地 LTS。3
截至 9 月 19 日核查时,在线文档已经将 avg_over_time、sum_over_time、absent、predict_linear 列为支持的函数,同时仍明确不支持 native histogram。30 HTTP API 文档也列出了 /labels、label values 和 /metadata,比本地 LTS 的实测范围更完整。31 因此,公开文档与固定发行版要分开看,文档中的新增支持需要在实际部署版本上确认。
此次 Cloud private preview 接管的是存储与查询,采集继续使用已有组件,规则执行仍在后续计划中。3 本文没有测试 Cloud 或 Grafana UI,不能把本地结果扩展成它们的兼容性结论。
3.3 两个已复现的不兼容案例
-
同一时间戳的冲突样本。 对同一时间线、同一时间戳,先写入
20,再写入5。Prometheus 对第二次写入返回 400,拒绝覆盖已有值;ClickHouse 两次都返回 204,随后查询得到20。这个用例中两侧最终查询值相同,但写入是否接受、是否向客户端报告冲突的行为不同。它是单独的写入测试,不计入前面的 42 项查询。 -
stale marker 的查询语义。 写入 Prometheus 用于标记序列失效的特殊 NaN 后,再查询这条序列。Prometheus 的 instant query 返回空结果;ClickHouse 仍返回该序列,值为
NaN。range query 中也能看到同一差异:Prometheus 在失效后不再返回点,ClickHouse 继续返回NaN点。这正是前面两项查询差异的来源,会影响依赖序列是否存在的集合运算和缺失数据判断。
stale marker 已核对为特殊位模式 0x7ff0000000000002,分别强制读取 Samples 和 Recent Samples 后差异仍在,排除了把普通 NaN 当成 stale marker、或仅由近期副本选表造成差异的可能。补充结果保存在复核记录中。
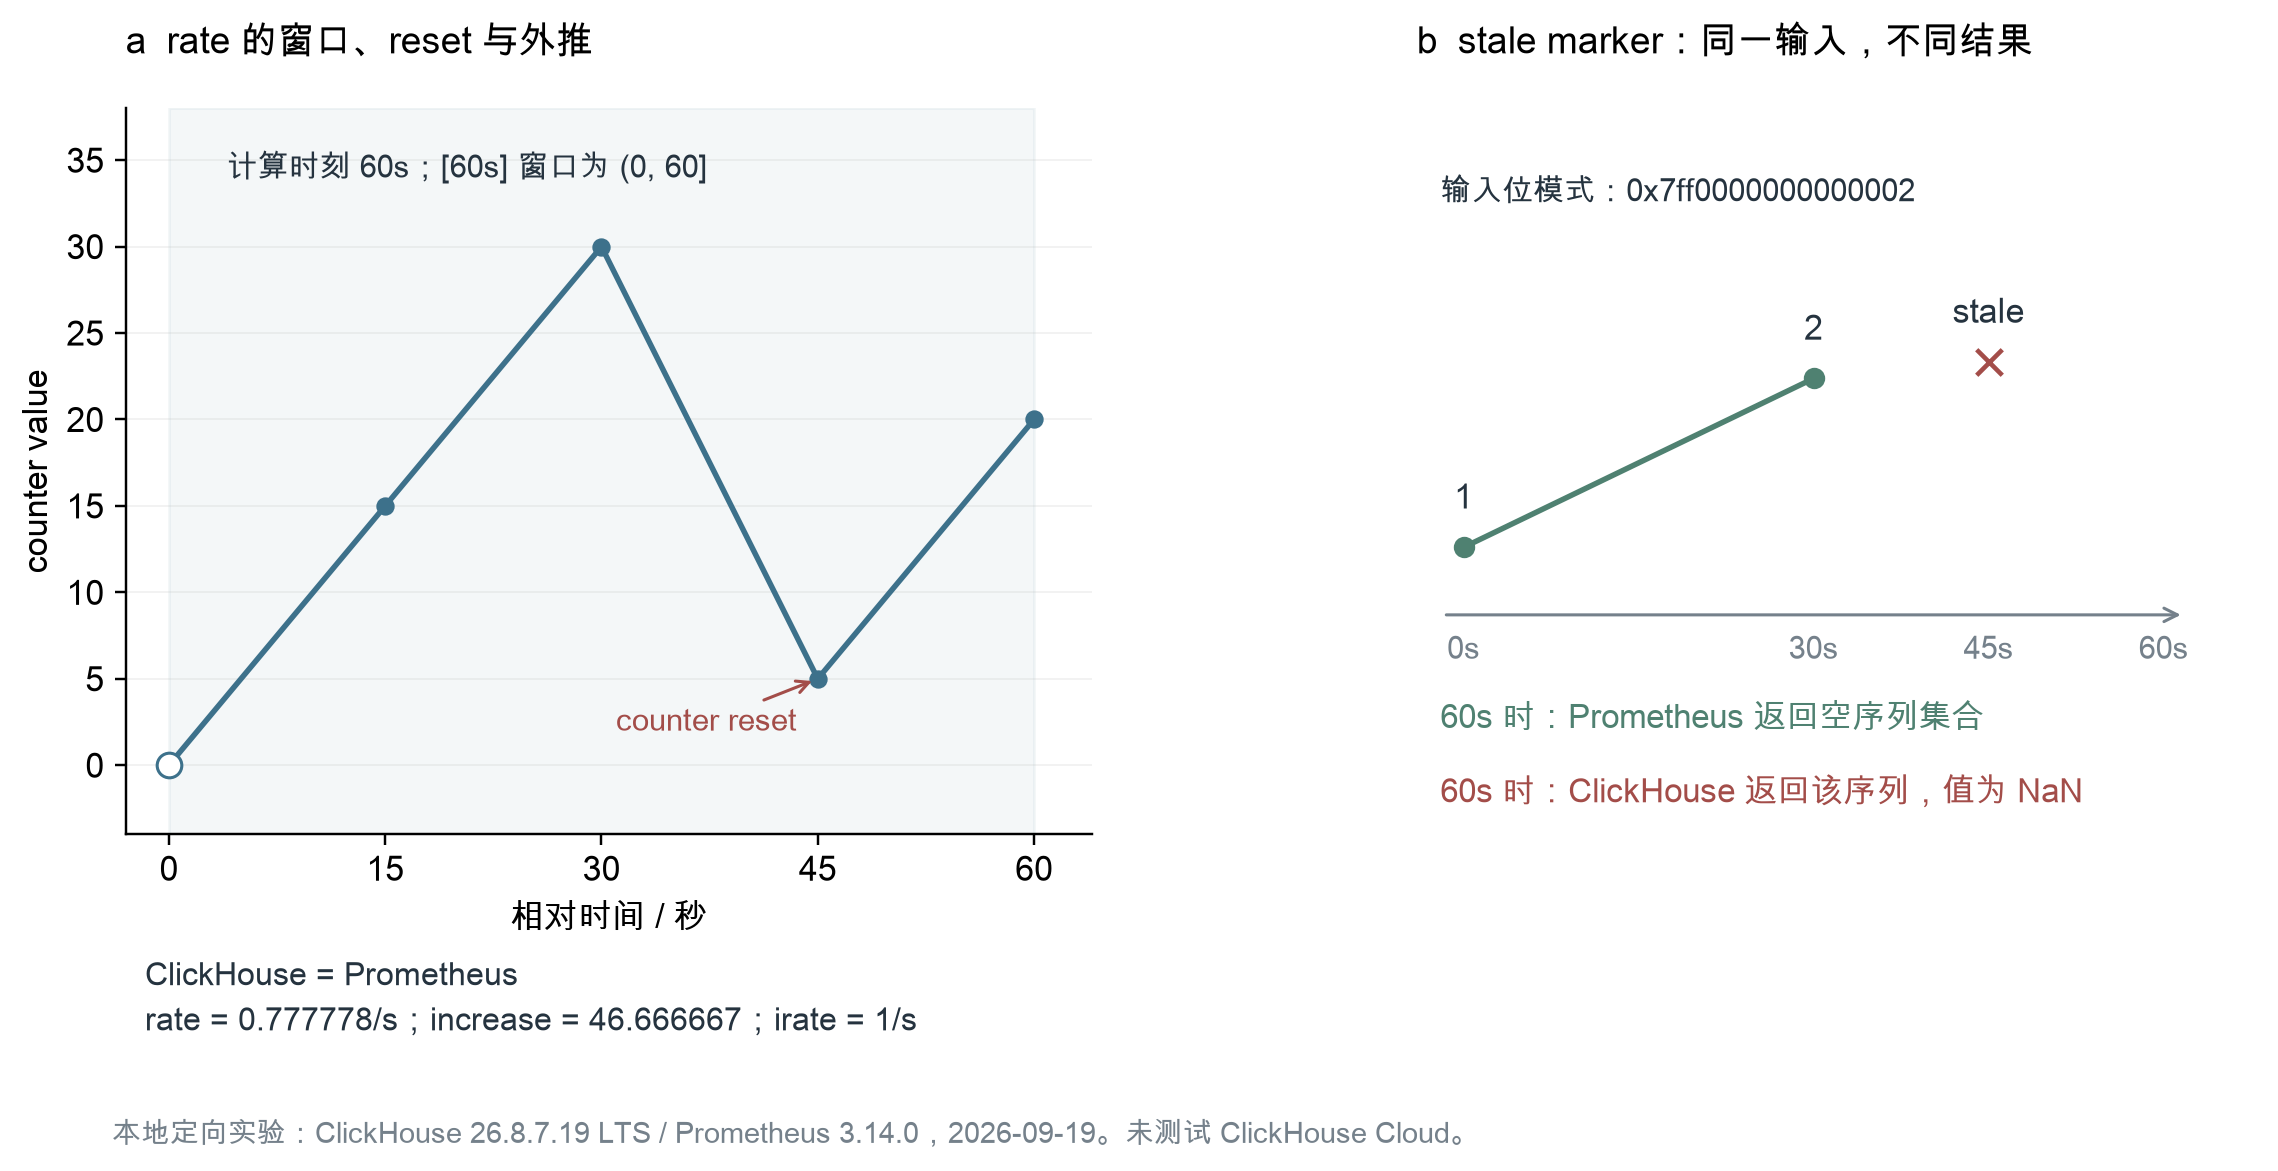
图 1:同一批构造数据的查询对照。左侧 counter reset 计算一致,右侧 stale marker 行为不同;结论限定到图中版本,不能外推为 Cloud private preview 的行为。
3.4 兼容性收敛的判断
我认为,在 ClickHouse 选择接管的指标存储与查询范围内,这些兼容性差异一定会逐步趋于一致。它要承接的是已有的 PromQL 查询、Grafana 面板和上层规则,用户需要迁移后结果含义保持不变;函数能解析、接口能返回,只完成了其中一部分。官方已经把完整语言覆盖作为目标,继续补齐边界语义是这条产品路线必然要做的工程工作。3 这是我对后续方向的判断,当前版本是否已经一致,仍以具体用例的对照结果为准。
4 设计的优势、劣势与竞争判断
4.1 优势
- 架构简单,复用充分。 Tags 管维度,Samples 管样本,PromQL 继续使用 ClickHouse 的存储与计算体系。
- 维度复用与逐 field 查询的基础已经具备。 同一时间线通过 id 复用标签,按指标筛选后读取样本;跨指标共享维度还可以继续归一化。912
- 标签索引有扩展空间。 主线已支持非空标签等值筛选,key 前置的 token 布局为按 key 顺序枚举 value 提供基础。后续可补充二级索引,实现 key 与 value 的双向查找。1921
- 样本集中存储。 全部 field 的样本共用一张表,可以跨时间线组织压缩块。相比 InfluxDB 1.x 按 series 与 field 分块,我预期能减轻稀疏小块的开销,具体空间收益仍待测试。1532
4.2 劣势
- 单值模型重复存时间。 同一时刻上报多个 field,就要写多条
(id, timestamp, value);宽表可以共享时间列,这里存在额外编码与存储开销。 - 查询仍有跨表处理成本。 Tags 先生成候选 id,再读取 Samples,复杂向量运算还会引入 JOIN。虽然
id IN已能下推到PREWHERE,标签倒排索引与样本扫描之间仍需传递候选集合。1333
4.3 总结思考
整体性能和存储量还需要测试。比较时应把 Tags、索引和 Recent Samples 一起算进去,不能只看 Samples 的压缩率。
2026 年 1 月融资时,ClickHouse 的估值已经达到 150 亿美元。34 对一家有这种资源规模和技术积累的公司,我认为这些软件问题不构成长期门槛,追赶乃至超越是时间问题。当前的兼容性和执行效率缺口,很难成为 Metrics 产品长期依赖的护城河。
我在《从一到无穷大 #86》中提到,公有云里的托管 ClickHouse 团队应该有更大的野心。它们已经承接了开源普及带来的 workload 增长,接下来应该利用数据入口与云上集成,把指标采集、查询和使用流程做成自己的产品。35
在我看来,ClickHouse 已经开始正式向 Metrics 产品宣战了。
5 参考资料
1 李兆龙:从一到无穷大 #63 谁才是时序数据库在可观测领域真正的对手?
2 ClickHouse:September 2026 newsletter
3 ClickHouse:Introducing ClickHouse's new TimeSeries Engine: Your drop-In Prometheus replacement
4 ClickHouse Release 24.8 Webinar,2024-08-20
5 ClickHouse:So, is ClickHouse winning the observability wars?,2026-08-27
6 ClickHouse:What's new in ClickStack - May 2026,2026-06-23
7 ClickHouse release:v26.8.7.19-lts
9 ClickHouse 26.8.7.19:normalizeTimeSeriesDefinition.cpp
10 ClickHouse 26.8.7.19:PrometheusRemoteWriteProtocol.cpp
11 ClickHouse 26.8.7.19:TimeSeriesSink.cpp
12 ClickHouse 26.8.7.19:TimeSeriesIDGenerator.cpp
13 ClickHouse 26.8.7.19:StorageTimeSeriesSelector.cpp
14 ClickHouse 26.8.7.19:TimeSeriesSettings.cpp,近期表分区与 TTL 配置
15 ClickHouse 在线文档:MergeTree 的稀疏主键索引与 index_granularity
16 ClickHouse 在线文档:Distributed table engine 与 sharding_key
17 ClickHouse master 固定快照:TimeSeriesVersion.h
18 ClickHouse master 固定快照:normalizeTimeSeriesDefinitionImpl.cpp
19 ClickHouse master 固定快照:ITokenizer.h,KeyValuePairsTokenizer 的标签对编码
20 ClickHouse master 固定快照:MergeTreeIndexText.cpp,Map 标签对与行号的索引构建
21 ClickHouse master 固定快照:MergeTreeIndexConditionText.cpp,标签等值条件的索引查找
22 ClickHouse 26.8.7.19:PrometheusQueryToSQL/Converter.cpp
23 ClickHouse 26.8.7.19:applyFunctionOverRange.cpp
24 ClickHouse 26.8.7.19:applyOneArgumentAggregationOperator.cpp,sumForEach 等聚合映射
25 ClickHouse 26.8.7.19:TableFunctionTimeSeries.cpp,目标表访问函数
26 ClickHouse 26.8.7.19:PrometheusQueryToSQL/fromSelector.cpp,selector 的 SQL 转换
27 Prometheus:Query functions,rate、increase 与 irate
28 Prometheus:Querying basics,Staleness 与 range selector
29 ClickHouse 26.8.7.19:AggregateFunctionTimeseriesExtrapolatedValue.h
30 ClickHouse 在线文档:prometheusQueryRange 与支持的 PromQL 特性
31 ClickHouse 在线文档:Prometheus HTTP API and PromQL
32 InfluxDB OSS v1:In-memory indexing and the Time-Structured Merge Tree (TSM)
33 ClickHouse 26.8.7.19:applyBinaryOperatorAnd.cpp,向量集合运算的 JOIN 实现
34 ClickHouse 官方新闻页:2026-01-16 收录的 Reuters 与 Bloomberg 150 亿美元估值报道
35 李兆龙:从一到无穷大 #86------ClickHouse 收购 RunReveal:可观测性竞争进入 workload 与生态位阶段