智谱ZCode"静默打包"事件致歉:一次关于数据边界的信任崩塌
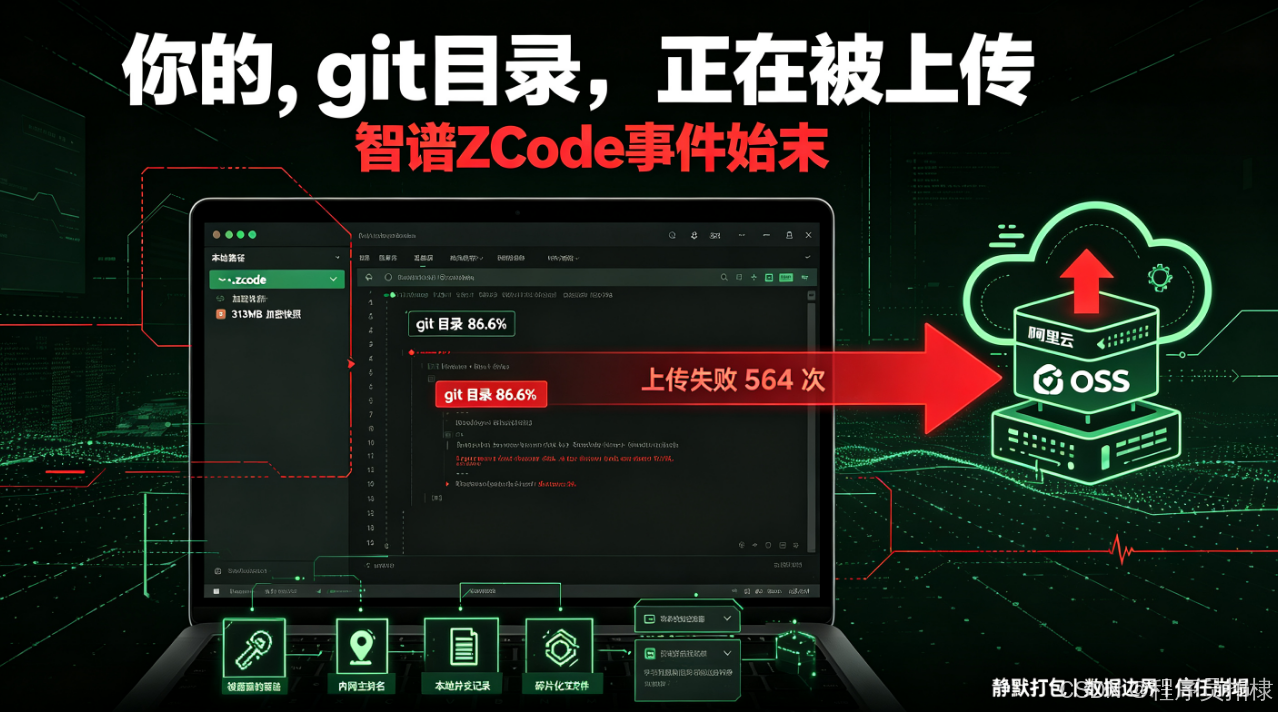
9月18日,一位开发者在清理本地.zcode目录时,发现了一个约313MB的加密快照文件。记录显示,工作区约345MB的内容被打包,上传失败564次。打包内容包含完整Git历史、LFS缓存和本地分支操作记录,其中.git目录在样本中占比高达86.6%。这是智谱AI旗下编程工具ZCode被曝出的"静默上传"事件。当日,官方致歉并表示问题已修复,承诺开源代码库、引入第三方审查,并为用户补偿一次周额度重置。
一个313MB的"待上传"包裹
事情源于一次普通的磁盘清理。技术博主ferstar发现本地"~/.zcode"目录占用超过700MB,其中多了一个313MB的加密包。状态文件显示,客户端扫描了其一个商业项目,排除"node_modules"后将约345MB内容打包为基线全量快照,并已重试上传564次未果。
解包客户端后,ferstar还原了完整链路:客户端先向"zcode.z.ai"申请上传凭证和本轮RSA公钥,随后在本地完成打包、加密,再将密文直传阿里云OSS。更受关注的是打包范围。对一个含42411个文件的快照清单,.git目录合计占86.6%,源码与文档仅约13.4%。这意味着旧提交中已删除的密钥口令、.git/config里的内网主机名与仓库路径、未推送的本地分支名、被reset抹掉的操作记录,都可能在包内。
用于包钥的RSA公钥由服务器临时下发,私钥从不下发,本地这几百MB密文用户和客户端都解不开,只有云端能够解密。而界面上的"优化体验"开关实际只控制数据是否用于模型训练,"仓库快照索引"开关只控制服务器是否对已上传快照建索引,二者都不能阻止本地打包与上传。
笔者查阅ZCode现行隐私政策发现,其中仅载明收集用户"在对话中提交的文本、文件和代码",并未提及整库快照与Git历史的静默上传。
官方致歉:已修复、将开源、给补偿
争议发酵数小时后,智谱于18日傍晚在官方社群作出回应。其承认ZCode的"代码库索引"功能在生成Repo Wiki页面时,可能将仓库数据上传至云端。该功能上线初期默认开启,影响了部分用户,相关问题目前已修复。
智谱称,Repo Wiki页面在云端生成后,相关数据会被立即销毁、不会保存。官方文档现已明确,该功能不读取.git文件、依赖目录、构建产物和缓存,仅按需发送经过过滤的代码内容。
智谱同时表示,数据问题直接影响用户信任,后续将开源ZCode代码库,引入第三方评估人员审查系统运行,并持续公开审计进展。作为补偿,ZCode向全体用户额外发放一次周额度重置,当日到账。
尚未对齐的几个问题
对照博主披露与官方回应,仍有多处尚未对上。官方未逐项解释:被上传文件的确切范围、为何会包含Git历史、数据在OSS上实际停留多久、"销毁"有没有独立审计、修复后的版本号是多少。开源时间表也只写了"近期"。
这并非行业孤例。就在两个月前,马斯克旗下SpaceXAI的编程工具Grok Build被曝未获同意将代码仓库整体传至公司服务器,马斯克本人承认后承诺将历史用户数据全部清零。今年3月,GitHub也因调整Copilot用户数据用于模型训练的默认规则,被开发者批评为"强行授权"。AI编程工具需要读取仓库才能提供辅助,本地索引本身不稀奇。分歧出在边界上:读到本地和传到云端是两件事,传当前代码和传整段历史又是两件事。
值得注意的是,智谱当天还发布了新模型GLM-5.3-FlashX,主打每秒200 token的输出速度。有开发者在博客里把两件事放在一起,调侃"全网都在问代码传去哪了,智谱在忙着发新模型"。而在两个月前,智谱刚完成约707亿港元的大规模融资,"大模型第一股"的资本叙事与这次信任危机形成的反差,也让事件的传播超出了纯技术讨论的范畴。
信任的重建,从开源开始
开源代码库、引入第三方审查,是目前官方给出的最有实质意义的承诺。如果落地,外界至少能自己去看快照模块到底打包了哪些路径、开关接在了哪里。但在开源兑现之前,对于还装着旧版本的用户,比较稳妥的动作有三步:先升级到修复后的版本;检查本机~/.zcode/v2/checkpoints下是否还留着待上传的快照;再把历史里出现过的密钥和令牌轮换一遍,别指望"已销毁"能覆盖到已经传出去的部分。
一个开发者工具最核心的资产不是模型能力,而是用户愿意把代码交给它的那份信任。这份信任一旦被撕开一道口子,靠一次额度重置和一纸声明是补不回来的。