从Props透传到自定义Hook:系统梳理React跨层级通信与逻辑复用
很多同学初学React时,都会从父子组件props传参开始入门------父组件往下传数据,子组件通过自定义事件往回传,这是最直觉、最好理解的通信方式,也是每个React学习者必经的第一课。但随着业务迭代、组件嵌套越来越深,你会慢慢发现:层层传递数据的写法开始变得臃肿,中间层组件被迫接收并转发大量自己根本用不到的数据,改一处要动一串,维护成本直线上升。
这时候,你就需要往上走一个台阶了。本文从组件通信的核心痛点出发,带你系统吃透 React Context + useContext 的跨层级通信方案,再通过自定义Hook实现逻辑复用与工程化分层,最后结合可落地的实战案例,帮你建立从基础API到架构思维的完整知识体系------无论你是刚学完props的新手,还是已经能写组件、但一遇到深层嵌套就头疼的进阶者,都能沿着这条路线找到自己的下一个台阶。
一、先搞懂:React组件通信的四大场景与痛点
在React的组件化开发模式中,不同组件之间的数据传递是最基础也最核心的需求。按照组件关系的远近,我们可以把它们排成一张「由易到难」的地图:
| 通信场景 | 典型方案 | 学习难度 |
|---|---|---|
| 父子组件通信 | 父组件通过props向下传数据,子组件通过自定义事件向上回调 |
⭐ 入门第一课 |
| 兄弟组件通信 | 把状态提升到共同的父组件,由父组件统一管理分发 | ⭐⭐ 稍加思考 |
| 祖先后代组件通信 | 数据需要经过多层中间组件层层接力传递 | ⭐⭐⭐ 开始难受 |
| 陌生人组件通信 | 组件树中几乎没有交集,无公共近层级父组件 | ⭐⭐⭐⭐ 进阶必备 |
把这张表再往深看一层,每个场景其实都有明确的方案边界,而不是笼统地一句「用 Context 就行」:
- 父子、兄弟:props + 状态提升就够了,不需要上 Context。当兄弟组件的公共祖先层级很深时,单纯「状态提升」会让父组件变得臃肿,这时候自然演进出**「状态提升到公共祖先 + Context 跨层级消费」**的组合方案------这也是 props 和 Context 在真实项目里最常见的混用姿势。
- 祖先后代 :如果公共祖先层级不深,优先用组件组合(见下文补充);层级深、组合不好使时,才上 Context。
- 陌生人组件 :如果两个组件存在公共祖先 ,把 Provider 放在公共祖先层级,Context 依然能覆盖;如果是完全跨组件树的场景(比如 Portal 渲染的全局弹窗、独立悬浮面板),原生 Context 够不到,这时才需要 Zustand、Redux 这类全局状态管理库。
前两种场景,用props都能优雅解决------这也是你入门时最先掌握的能力。问题出在第三行:组件层次比较深的时候。
假设有这样一个结构:
App → Parent → Child → GrandChild如果 GrandChild 需要 App 里的一个 theme 数据,那么 Parent 和 Child 这两个「中间商」明明用不到这个数据,却被迫接收并继续往下传。
这就是臭名昭著的 Prop Drilling(属性穿透):数据像接力棒一样一层层往下传,中间的组件哪怕根本用不到这份数据,也必须接收并继续向下传递。层级浅的时候还能接受,一旦组件树达到三四层以上,数据搬运的工作量就会非常大,后续修改数据结构还要改动所有中间层。
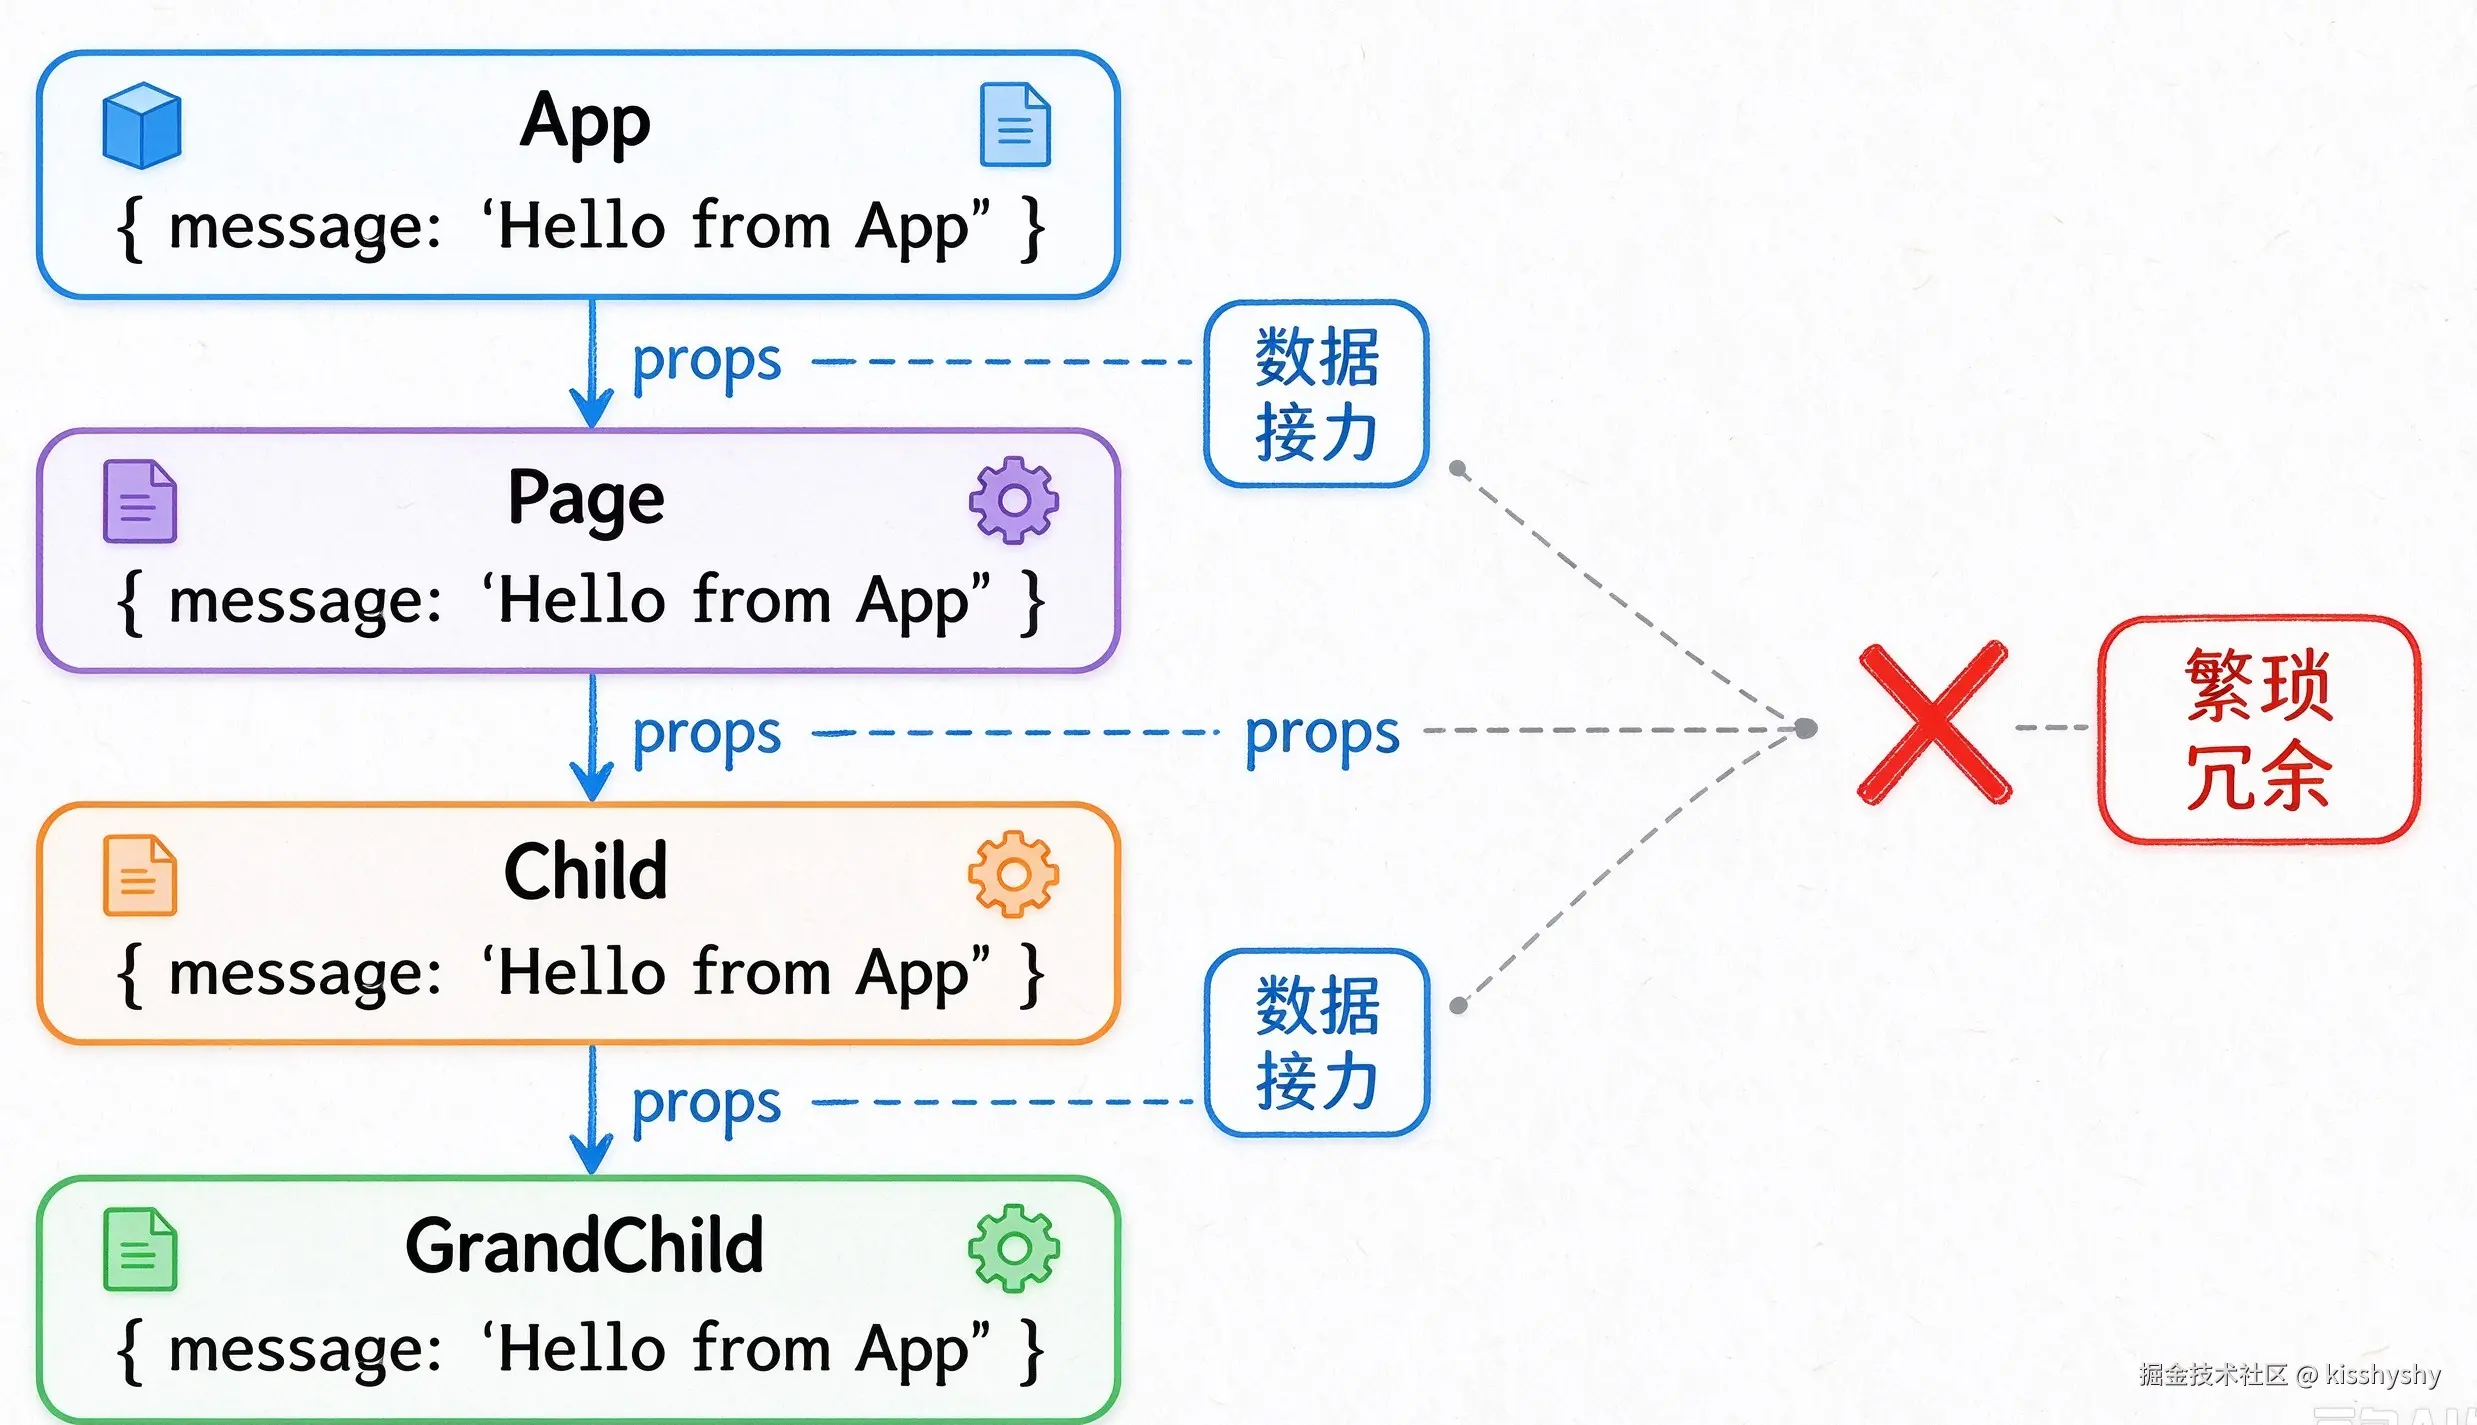
我的学习笔记里,就保留了这段「反面教材」:
jsx
// function App() {
//   return (
//    <>
//     <parent>
//      <child>
//       <grandchild>
//       </grandchild>
//      </child>
//     </parent>
//    </>
//   )
// }
// 这段代码是在演示 Prop Drilling:数据像接力棒一样一层层传,
// 中间的组件被迫接收和传递不需要的数据,也就是为什么需要 Context核心矛盾:组件之间需要共享数据,但数据传递的路径和组件的层级结构被强行绑定了。
补充:掏 Context 之前,先试试 React 官方的「第一道防线」------组件组合
很多人一遇到 Prop Drilling,第一反应就是「上 Context」。但 React 官方其实更希望你先看看能不能用组件组合(Component Composition)绕过中间层。
什么意思?看代码:
jsx
// 中间的 Parent、Child 只负责渲染 children,完全不用接收和转发 theme
function App() {
  const [theme, setTheme] = useState('light')
  return (
    <Parent>
      <Child>
        <GrandChild theme={theme} />
      </Child>
    </Parent>
  )
}
theme 数据从 App 直接以 JSX 的形式传给了 GrandChild,Parent 和 Child 只负责渲染 children,完全不需要感知 theme 的存在。数据传递路径没变,但中间层的「搬运负担」被彻底消除了。
这就是 React 官方推荐的心智模型:
能组合解决,就别上 Context;能 Context 解决,就别上状态管理库。
组合解决不了的时候(比如中间层需要根据数据做条件渲染、或者数据要被多个不同分支消费),再掏 Context 出来。这不是 Context 不好用,而是工具箱里每把工具都有它最合适的位置。
而 useContext 正是为了解决组合解决不了的那部分问题而生的------它提供了一套跨层级直接共享数据的机制,让数据跳过中间层,直接从提供者到达消费者。
二、useContext:跨层级读取上下文的利器
1. 核心概念与作用
Context(上下文)是React内置的一套全局数据共享方案,你可以把它理解成组件树范围内的「数据广播站」:
- 顶层通过
Provider提供数据 - 任意层级的后代组件都可以直接「订阅」这份数据
- 完全不需要经过中间组件层层传递
useContext 则是React专门用来消费Context的Hook,它的核心作用就是:跨层级直接读取组件上下文数据,省去逐层向下传递props的麻烦。
2. useContext 标准三步使用法
使用Context实现跨层级通信,固定遵循三个步骤:
| 步骤 | API | 作用 |
|---|---|---|
| ① 创建上下文 | createContext(默认值) |
创建一个上下文对象,默认值作为兜底 |
| ② 提供上下文 | <Context.Provider value={数据}> |
包裹组件树,通过 value 注入共享数据 |
| ③ 消费上下文 | useContext(Context) |
在任意深层组件中直接读取共享数据 |
3. 实战案例:主题切换功能
我们以全局主题切换为例,完整走一遍Context的落地流程。
第一步:创建Theme上下文
新建 ThemeContext.js 文件,创建并导出上下文对象,同时设置默认兜底值:
jsx
import { createContext } from 'react'

// 创建主题上下文,为深层组件树提供主题数据
// 默认值仅作为未匹配到Provider时的降级兜底
export const ThemeContext = createContext({
    theme:'light',
    setTheme:()=>{}
});

export default ThemeContext;
💡 亮点解读 :默认值里放一个空函数
setTheme: () => {},是为了保证消费方拿到的对象「形状完整」,而不是undefined。在JS里这是防崩,在TS里这直接决定了类型推断是否顺畅。
第二步:顶层Provider提供数据
在 App.jsx 中用Provider包裹组件树,把主题状态和切换方法注入上下文:
jsx
import Page from './components/Page'
import { ThemeContext } from './ThemeContext'
import { useState } from 'react'

function App() {
  const [theme, setTheme] = useState('light')

  return (
    // 上下文提供者容器
    // Provider不一定非要放在全局根组件,可以放在任何需要的层级作为容器
    // 默认值light可以通过value属性覆盖为真正的响应式数据
    <ThemeContext.Provider value={theme}>
      <Page />
      <button onClick={() => setTheme(theme === 'light' ? 'dark' : 'light')}>
        切换主题
      </button>
    </ThemeContext.Provider>
  )
}

export default App;
💡 亮点解读 :很多人一听Context就以为「必须包在最外层」,其实不然。Provider可以放在组件树的任意位置 ,它影响的范围就是它的子树。这意味着你可以做局部作用域Context ------比如只给某个复杂表单区域包一个
FormContext.Provider,表单外的组件根本感知不到它,天然做了隔离。
第三步:深层组件直接消费
在 Page 组件和更深层的 Child 组件中,不需要接收任何props,直接通过 useContext 就能拿到主题数据:
jsx
// Page组件
import Child from "../components/Child";
import { useContext } from "react";
import { ThemeContext } from "../ThemeContext";

const Page = () => {
    const theme = useContext(ThemeContext)
    return (
      <>
        <h1>Page {theme}</h1>
        <br />
        <Child />
      </>
    )
}

export default Page;
jsx
// Child组件(更深层级)
import { useContext } from "react";
import { ThemeContext } from "../ThemeContext";

function Child() {
  const theme = useContext(ThemeContext)
  return (
    <>
      <h1>Child</h1>
      <button className="theme">按钮{theme}</button>
    </>
  )
}

export default Child;
🖼️ 配图提示词:手绘风格React Context数据流示意图,顶部是ThemeContext.Provider数据提供者,向下发散箭头直接指向深层的Page组件和Child组件,跳过中间层级,标注「跨层级直接共享」,16:9比例,卡通技术插画风格。
4. 进阶优化:把Context消费封装成自定义Hook
上面的写法虽然能用,但每个消费组件都要同时引入 useContext 和 ThemeContext,重复代码多、耦合度高。我们可以把消费逻辑进一步封装成一个自定义Hook------useTheme:
jsx
// hooks/useTheme.js
import { ThemeContext } from "../ThemeContext";
import { useContext } from "react";

// 约定以use开头,是自定义Hook的标识
export const useTheme = () => {
    return useContext(ThemeContext)
}
封装之后,组件里使用就变得极其简洁:
jsx
const theme = useTheme()这一步封装的好处远不止少写两行代码:
- 屏蔽底层实现:组件不需要知道Context的存在,只需要调用Hook拿数据
- 统一维护:后续如果Context改名、拆分,只需要修改这一个Hook
- 扩展能力:后续可以在Hook里加入计算属性、参数校验等逻辑
💡 亮点解读 :如果哪天你想把Context换成Zustand,只需要改
useTheme这一个文件,所有组件一行都不用动。这就是架构层面的收口------把变化点集中到一处。
5. Context的重要注意事项(拓展)
Context虽好用,但不能滥用,有几个关键特性需要注意:
-
重新渲染机制 :当Provider的
value发生变化时,所有消费该Context的后代组件都会强制重新渲染,不管它们真正用到的是不是变化的那部分。如果共享数据变化频繁,可能会带来性能问题。💡 优化技巧 :如果
value是每次渲染都新建的对象(如value={{ theme, setTheme }}),所有消费者都会重渲染。可以用useMemo包一下:jsxconst value = useMemo(() => ({ theme, setTheme }), [theme]);更进阶的做法是拆分Context,把「读」和「写」分成两个Context,减少不必要的更新传播。
-
默认值的作用 :
createContext的默认值不是「初始值」,只有当组件找不到对应的Provider时才会生效,属于降级兜底方案。 -
滥用边界:不是所有数据都适合塞进Context。很多新手会陷入「万物皆可 Context」的误区,这里给你两条清晰的判断标准:
适合放进 Context ✅ 不建议放进 Context ❌ 主题、用户信息、语言包 表单的临时输入值 路由、全局配置 列表的滚动位置、分页数据 登录态、权限信息 高频变化的业务状态(如拖拽坐标) 判断标准就一句话:全局且低频变化的数据 → Context;局部且高频变化的数据 → 组件内部 state。把高频变化的数据塞进 Context,等于让全树消费者陪着你一起重渲染,性能直接崩。
-
适用场景 :适合存放全局且不频繁变化的数据;如果是复杂高频变化的业务状态,更推荐使用Zustand、Redux等专门的状态管理库。
三、自定义Hook:React逻辑复用的终极方案
1. 什么是自定义Hook?
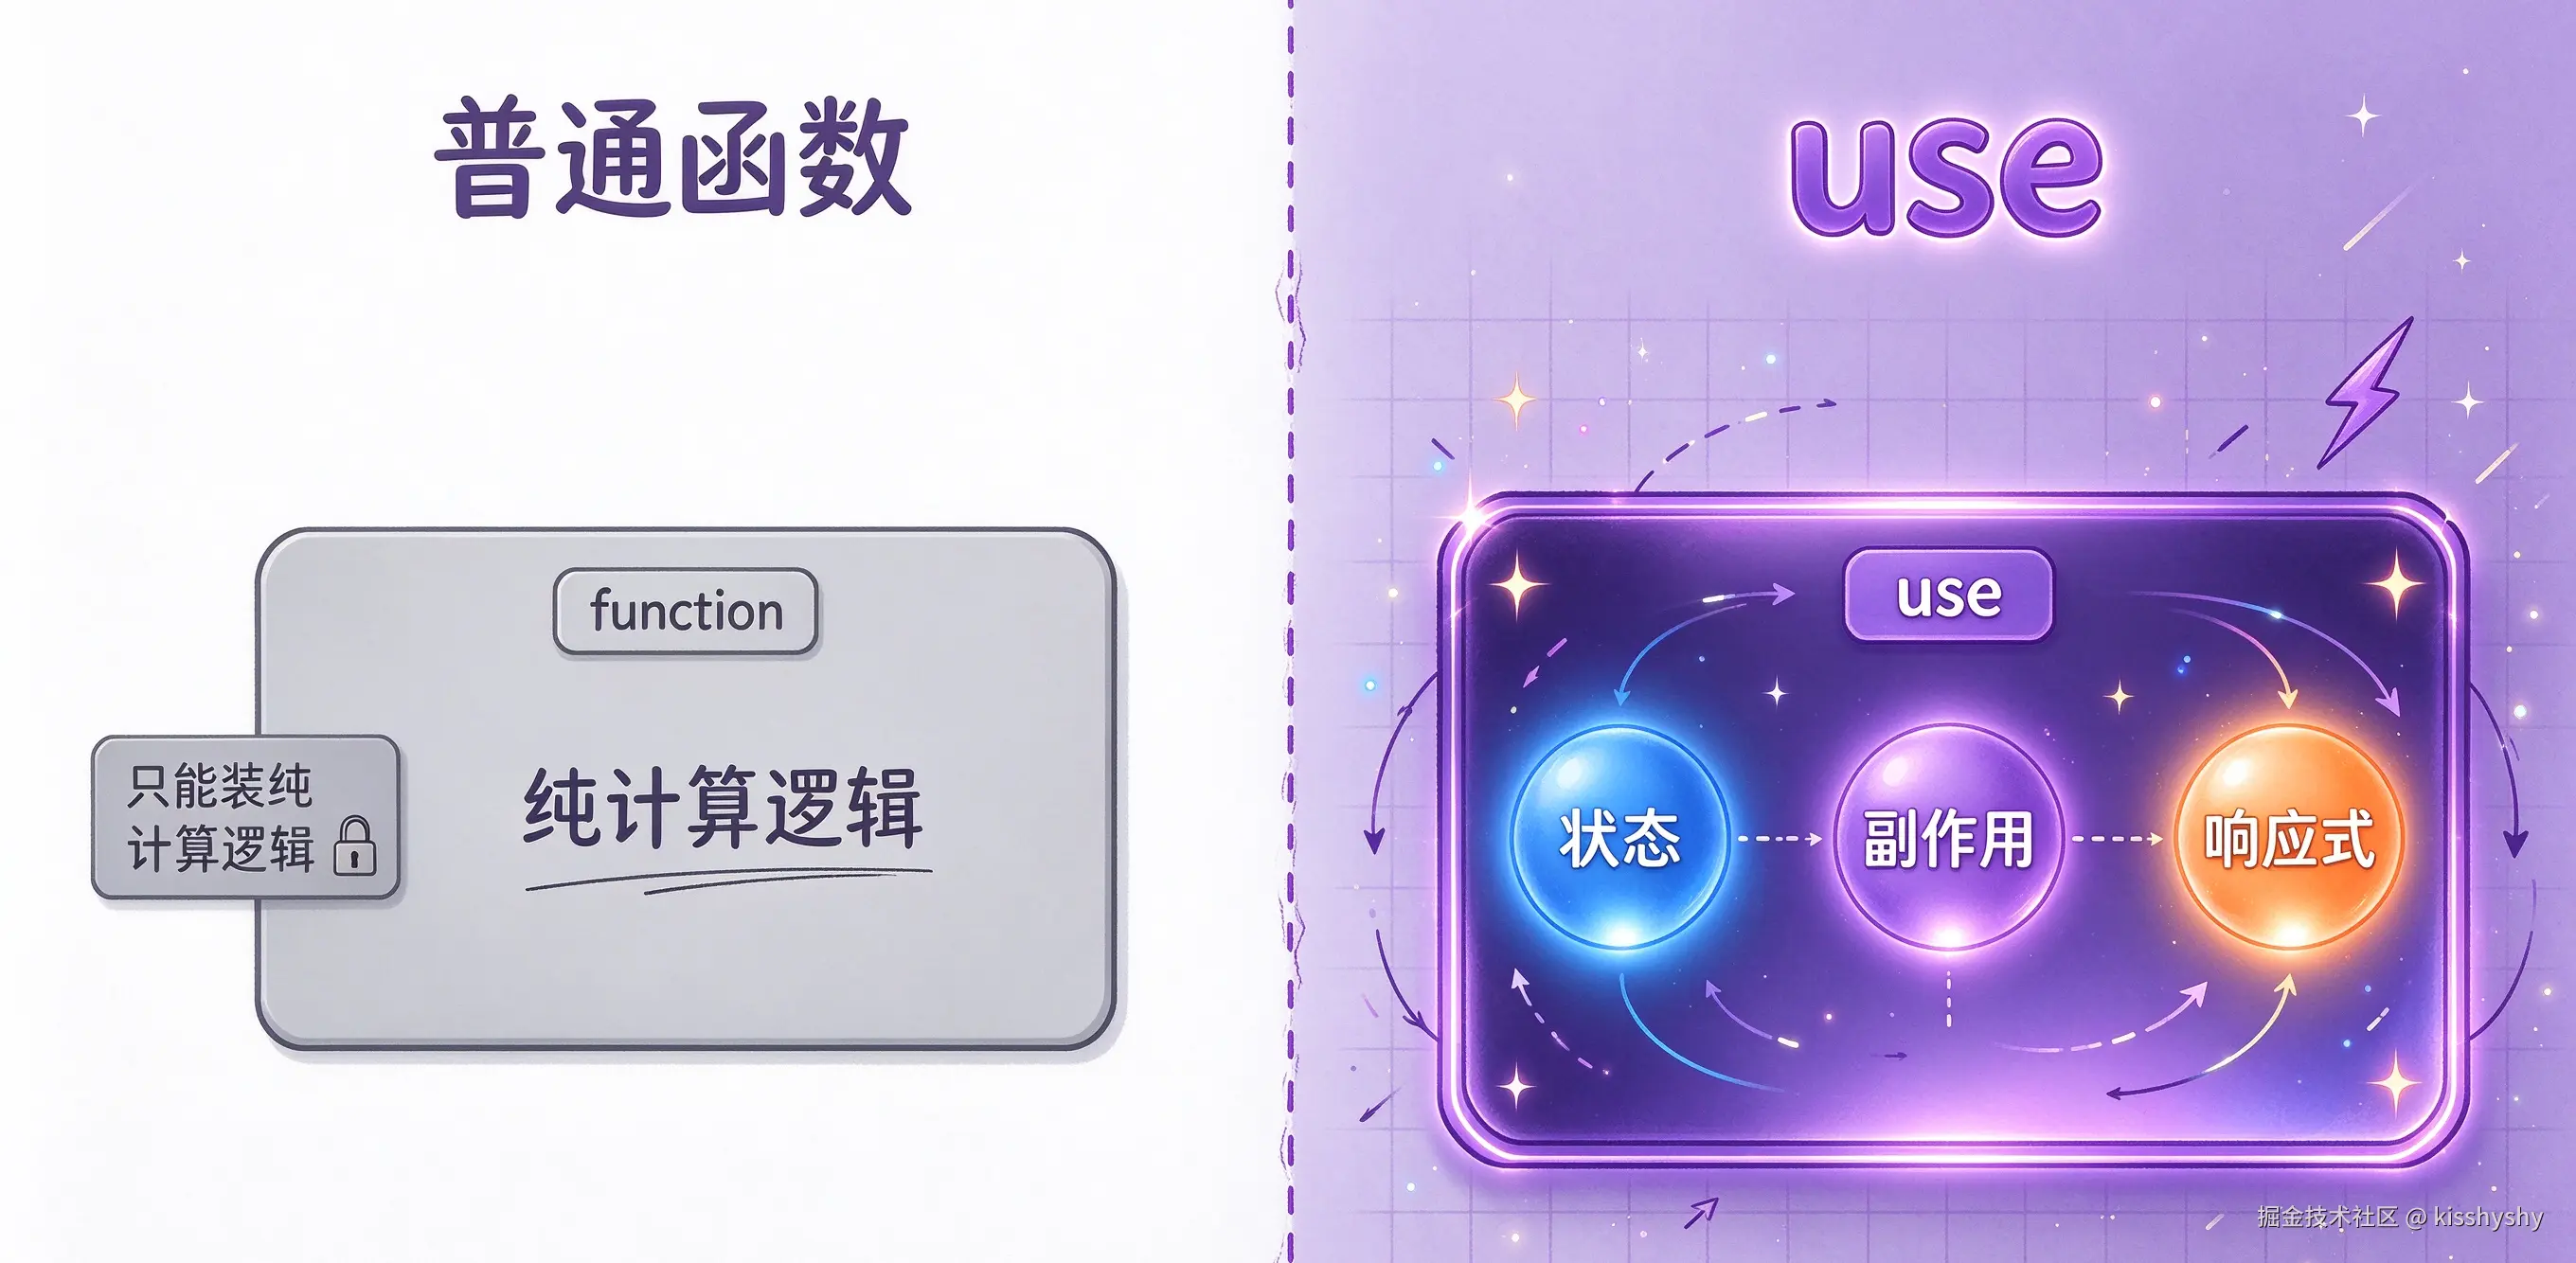
自定义Hook本质上就是一个以 use 开头命名的函数,但它和普通函数最大的区别在于:它可以使用React的所有Hook能力(useState、useEffect等),能够持有响应式状态、处理副作用。
简单来说:自定义Hook = 响应式状态 + 副作用逻辑 + 业务逻辑 的封装单元。
2. 自定义Hook的三类划分
在往后看案例之前,先建立一个分类心智------自定义Hook按职责通常分为三类,对应不同的复用层级:
| 类型 | 代表案例 | 封装内容 | 复用范围 |
|---|---|---|---|
| 上下文消费 Hook | useTheme |
封装 Context 消费逻辑,屏蔽底层实现 | 项目内复用 |
| 通用副作用 Hook | useMouse、useDebounce、useLocalStorage |
封装浏览器 API、DOM 操作、副作用与清理 | 可跨项目复用 |
| 业务状态 Hook | useTodos |
封装特定业务的完整状态逻辑 | 业务模块内复用 |
有了这张表,你以后遇到一段可复用的逻辑,第一反应就是:「它属于哪一类?」------能抽象,还要知道抽象成哪一种,才是真正的封装能力。
3. 为什么需要自定义Hook?
自定义Hook是React中逻辑复用的核心手段,它解决了两个核心问题:
- 逻辑复用:相同的状态和副作用逻辑,不需要在每个组件里重复编写,一处封装多处使用。
- 关注点分离:把业务逻辑、副作用逻辑从UI组件中抽离出来,组件只专注于视图渲染,代码结构更清晰。
和普通的工具函数相比,自定义Hook能完整保留React的响应式特性,是真正的「逻辑级复用」。
4. 自定义Hook的两条核心规则
- 命名约定 :必须以
use开头,这是React官方约定,也是语法检查工具判断Hook的依据。 - 调用规则 :只能在React函数组件的顶层,或者其他自定义Hook中调用,不能在循环、条件判断、普通函数里调用。
💡 为什么有这条规则? React内部是用链表 按调用顺序来存储每个Hook状态的。如果你在
if里调用Hook,两次渲染的调用顺序不一致,React就会「张冠李戴」,把A的状态给到B。这也是为什么use前缀如此重要------ESLint插件靠它来帮你检查调用位置是否合法。
💡 还有一个容易误解的点 :自定义Hook复用的是逻辑,不是状态 。两个组件各自调用useMouse(),它们会各自持有一份独立的x/y状态,互不干扰。想共享状态,那该用Context或状态管理库。
5. 实战案例1:useMouse 封装副作用与清理
最经典的自定义Hook场景,就是封装带副作用的DOM事件监听。
比如实现「页面实时显示鼠标坐标」的功能,如果直接写在组件里,是这样的:
jsx
const [x, setX] = useState(null);
const [y, setY] = useState(null);

useEffect(() => {
  function handle(e){
    setX(e.clientX);
    setY(e.clientY);
  }
  document.addEventListener('mousemove', handle)

  // 重点:事件监听、定时器等副作用,组件卸载后不会主动回收
  // 必须在清理函数中手动移除,否则会造成内存泄漏
  return () => {
    document.removeEventListener('mousemove', handle)
  }
}, [])
把这段逻辑封装到 hooks/useMouse.js 中:
jsx
import { useState, useEffect } from 'react'

export const useMouse = () => {
    const [x, setX] = useState(null);
    const [y, setY] = useState(null);

    function handle(e){
      setX(e.clientX);
      setY(e.clientY);
    }

    useEffect(() => {
      document.addEventListener('mousemove', handle)
      return () => {
        document.removeEventListener('mousemove', handle)
      }
    }, [])

    return { x, y }
}

export default useMouse;
封装完成后,组件中使用只需要一行代码:
jsx
const { x, y } = useMouse();使用方完全不需要关心事件绑定、清理这些细节,Hook内部已经全部处理好了。
💡 亮点解读:
- 清理函数绝不能省 :函数组件卸载后,React不会主动回收你手动绑定的东西------定时器、Worker、事件监听都是如此。如果不写清理,组件卸载后
handle仍然挂在document上,setX会被反复调用,轻则内存泄漏,重则报「更新已卸载组件的state」警告。这是自定义Hook最有价值的地方之一:把「副作用 + 清理」这套固定套路一次性封装好,调用方永远不用担心忘记清理。- 返回对象
{ x, y }而不是数组 :返回对象的好处是调用方可以按需解构,顺序无关。数组形式(像useState那样)适合「顺序有意义」的场景。
6. 实战案例2:useTodos 封装业务状态逻辑
自定义Hook不仅能封装副作用,更能封装完整的业务逻辑。我们以Todo待办列表为例,结合TypeScript实现一个完整的业务Hook。
第一步:先定义类型
在 types/todo.ts 中定义数据结构,用TypeScript做类型约束:
ts
// interface 适合定义对象结构
export interface Todo {
  id: number;
  title: string;
  completed: boolean;
}

// type 适合定义简单类型、联合类型
export type FilterType = 'all' | 'completed' | 'uncompleted';
💡 亮点解读:
- interface 与 type 的分工 :
interface描述对象结构 ,可以被继承、声明合并;type更灵活,可以描述联合类型、简单类型别名。- 联合类型替代枚举 :用
type FilterType = 'all' | 'completed' | 'uncompleted',你在任何地方写setFilter('complete')都会直接报错。字符串字面量联合类型是TS里非常好用的一个技巧,比enum更轻、更容易序列化。
第二步:封装useTodos业务Hook
在 hooks/useTodos.ts 中,把待办事项的增、删、切换、清空等所有状态操作全部封装起来:
ts
import { useState, useMemo } from 'react'
import type { Todo, FilterType } from '../types/todo'

export function useTodos() {
    const [todos, setTodos] = useState<Todo[]>([]);
    const [filter, setFilter] = useState<FilterType>('all');

    // 新增待办
    const addTodo = (text: string) => {
        if(!text.trim()) return;
        const newTodo: Todo = {
            id: Date.now(),
            title: text.trim(),
            completed: false
        }
        // 函数式更新,基于前一个状态生成新状态
        setTodos(prev => [...prev, newTodo]);
    }

    // 切换完成状态
    const toggleTodo = (id: number) => {
        setTodos(prev => prev.map(item =>
            item.id === id
                ? { ...item, completed: !item.completed }
                : item
        ));
    }

    // 删除待办
    const deleteTodo = (id: number) => {
        setTodos(prev => prev.filter(item => item.id !== id));
    }

    // 清空已完成
    const clearCompleted = () => {
        setTodos(prev => prev.filter(item => !item.completed));
    }

    // 衍生计算:根据 filter 过滤出最终展示的列表
    // 用 useMemo 缓存,只有 todos 或 filter 变化时才重新计算
    const filteredTodos = useMemo(() => {
        switch (filter) {
            case 'completed':   return todos.filter(t => t.completed);
            case 'uncompleted': return todos.filter(t => !t.completed);
            default:            return todos;
        }
    }, [todos, filter]);

    return {
        todos: filteredTodos,  // 直接暴露过滤后的列表,UI 层无脑渲染
        filter,
        setFilter,
        addTodo,
        toggleTodo,
        deleteTodo,
        clearCompleted
    }
}
这样封装之后,UI组件只需要调用 useTodos() 就能拿到所有数据和方法,完全不用关心内部的状态管理细节,组件代码会变得非常干净。
💡 亮点解读(这个文件信息量很大,逐个拆):
import type与普通 import 分开 :import type是TS 3.8+的语法,明确表示「只导入类型,不导入运行时代码」。打包时这些导入会被完全擦除,不会产生无用的模块依赖,也避免了循环引用的一些坑。- 函数式更新
setTodos(prev => ...):为什么不直接setTodos([...todos, newTodo])?因为todos是当前渲染时闭包里的旧值 。如果你在一次事件里连续调用两次addTodo,两次读到的todos可能是同一个旧值,第二次就会覆盖第一次。只要新状态依赖旧状态,就用函数式更新------这是铁律。- 不可变更新
{ ...item, completed: !item.completed }:React的更新判断依赖引用比较 。直接改item.completed = true数组和对象引用都没变,React可能不会重新渲染。展开运算符创建一个新对象,才是正确姿势。useMemo缓存衍生数据 :filteredTodos依赖todos和filter,用useMemo包起来后,只有这两个值变化时才重新计算,避免了每次渲染都跑一遍filter。注意不要过早优化 ------列表很小的时候,直接filter也没问题;当列表变大、渲染频繁时,useMemo的价值才体现出来。- 输入防御
if (!text.trim()) return;:trim()去空格,既防止空内容,也把text.trim()作为最终写入的title,避免用户输入一堆空格。这是「入口处做校验」的工程习惯。- 返回的是
filteredTodos而不是原始todos:这是一个封装决策------把「过滤」这层逻辑藏在 Hook 内部,UI 层只负责渲染最终结果。如果哪天过滤规则要改(比如加个搜索框),只需要改这个 Hook,视图层一行不动。这就是**「逻辑与视图分离」**的极致体现。
🖼️ 配图提示词:手绘风格自定义Hook封装示意图,左侧是分散在组件里的useState、useEffect、业务逻辑,箭头指向右侧的一个自定义Hook函数盒子,标注「逻辑抽离、复用、封装」,16:9比例,卡通技术插画风格。
7. 自定义Hook 的组合性:Hook 调用 Hook
到这里,你可能已经觉得自定义Hook挺好用了。但它真正甩开 HOC(高阶组件)和 mixin 的地方,其实在组合性 ------自定义Hook 可以调用其他自定义Hook,实现逻辑层层叠加。
举个例子。我们希望 useTodos 的数据能持久化到 localStorage,刷新页面不丢。直觉做法是在 useTodos 里写 localStorage.setItem,但这会让「业务逻辑」和「存储逻辑」耦合在一起。
更优雅的做法是:先把「读写 localStorage」封装成一个通用副作用 Hook,然后在 useTodos 里直接调用它。
ts
// hooks/useLocalStorage.ts
// 通用副作用 Hook:封装 localStorage 的读写 + 副作用同步
import { useState, useEffect } from 'react'

export function useLocalStorage<T>(key: string, initialValue: T) {
    const [value, setValue] = useState<T>(() => {
        // 初始化时尝试从 localStorage 读取
        const raw = localStorage.getItem(key)
        return raw ? JSON.parse(raw) as T : initialValue
    })

    // value 变化时同步写回 localStorage
    useEffect(() => {
        localStorage.setItem(key, JSON.stringify(value))
    }, [key, value])

    return [value, setValue] as const
}
然后在 useTodos 里组合它:
ts
// hooks/useTodos.ts
import { useState, useMemo } from 'react'
import { useLocalStorage } from './useLocalStorage'
import type { Todo, FilterType } from '../types/todo'

export function useTodos() {
    // 🔑 关键:把 useState 换成 useLocalStorage
    const [todos, setTodos] = useLocalStorage<Todo[]>('todos', [])
    const [filter, setFilter] = useState<FilterType>('all')

    // 后续增删改查逻辑完全不变
    const addTodo = (text: string) => { /* ... */ }
    // ...

    return { todos: filteredTodos, filter, setFilter, addTodo, /* ... */ }
}
一行代码的改动 ,useTodos 就拥有了本地持久化能力。业务逻辑完全没动,因为「存储」这件事已经被 useLocalStorage 接管了。
这就是组合性的威力:
- HOC / mixin 的老问题:多层嵌套、来源不明、props 污染、生命周期互相打架。
- 自定义Hook 的解法 :逻辑是函数调用,不产生新的组件层级,也不污染 props,来源清清楚楚,调用顺序也一目了然。
💡 心法总结 :写自定义Hook 时,遇到任何「可以独立复用的逻辑」,第一反应都应该是------把它抽成另一个 Hook,然后组合进来 。你的
useTodos可以组合useLocalStorage、useDebounce、useRequest;你的useForm可以组合useValidation、useDirtyCheck。Hook 生态就是这么一层一层长出来的。
四、从Demo到工程化:前端项目的分层架构
当我们把Context、自定义Hook这些知识点落地到真实项目中时,就不能再是文件随意堆放的Demo模式,而是需要清晰的架构分层。
标准的React+TS项目分层
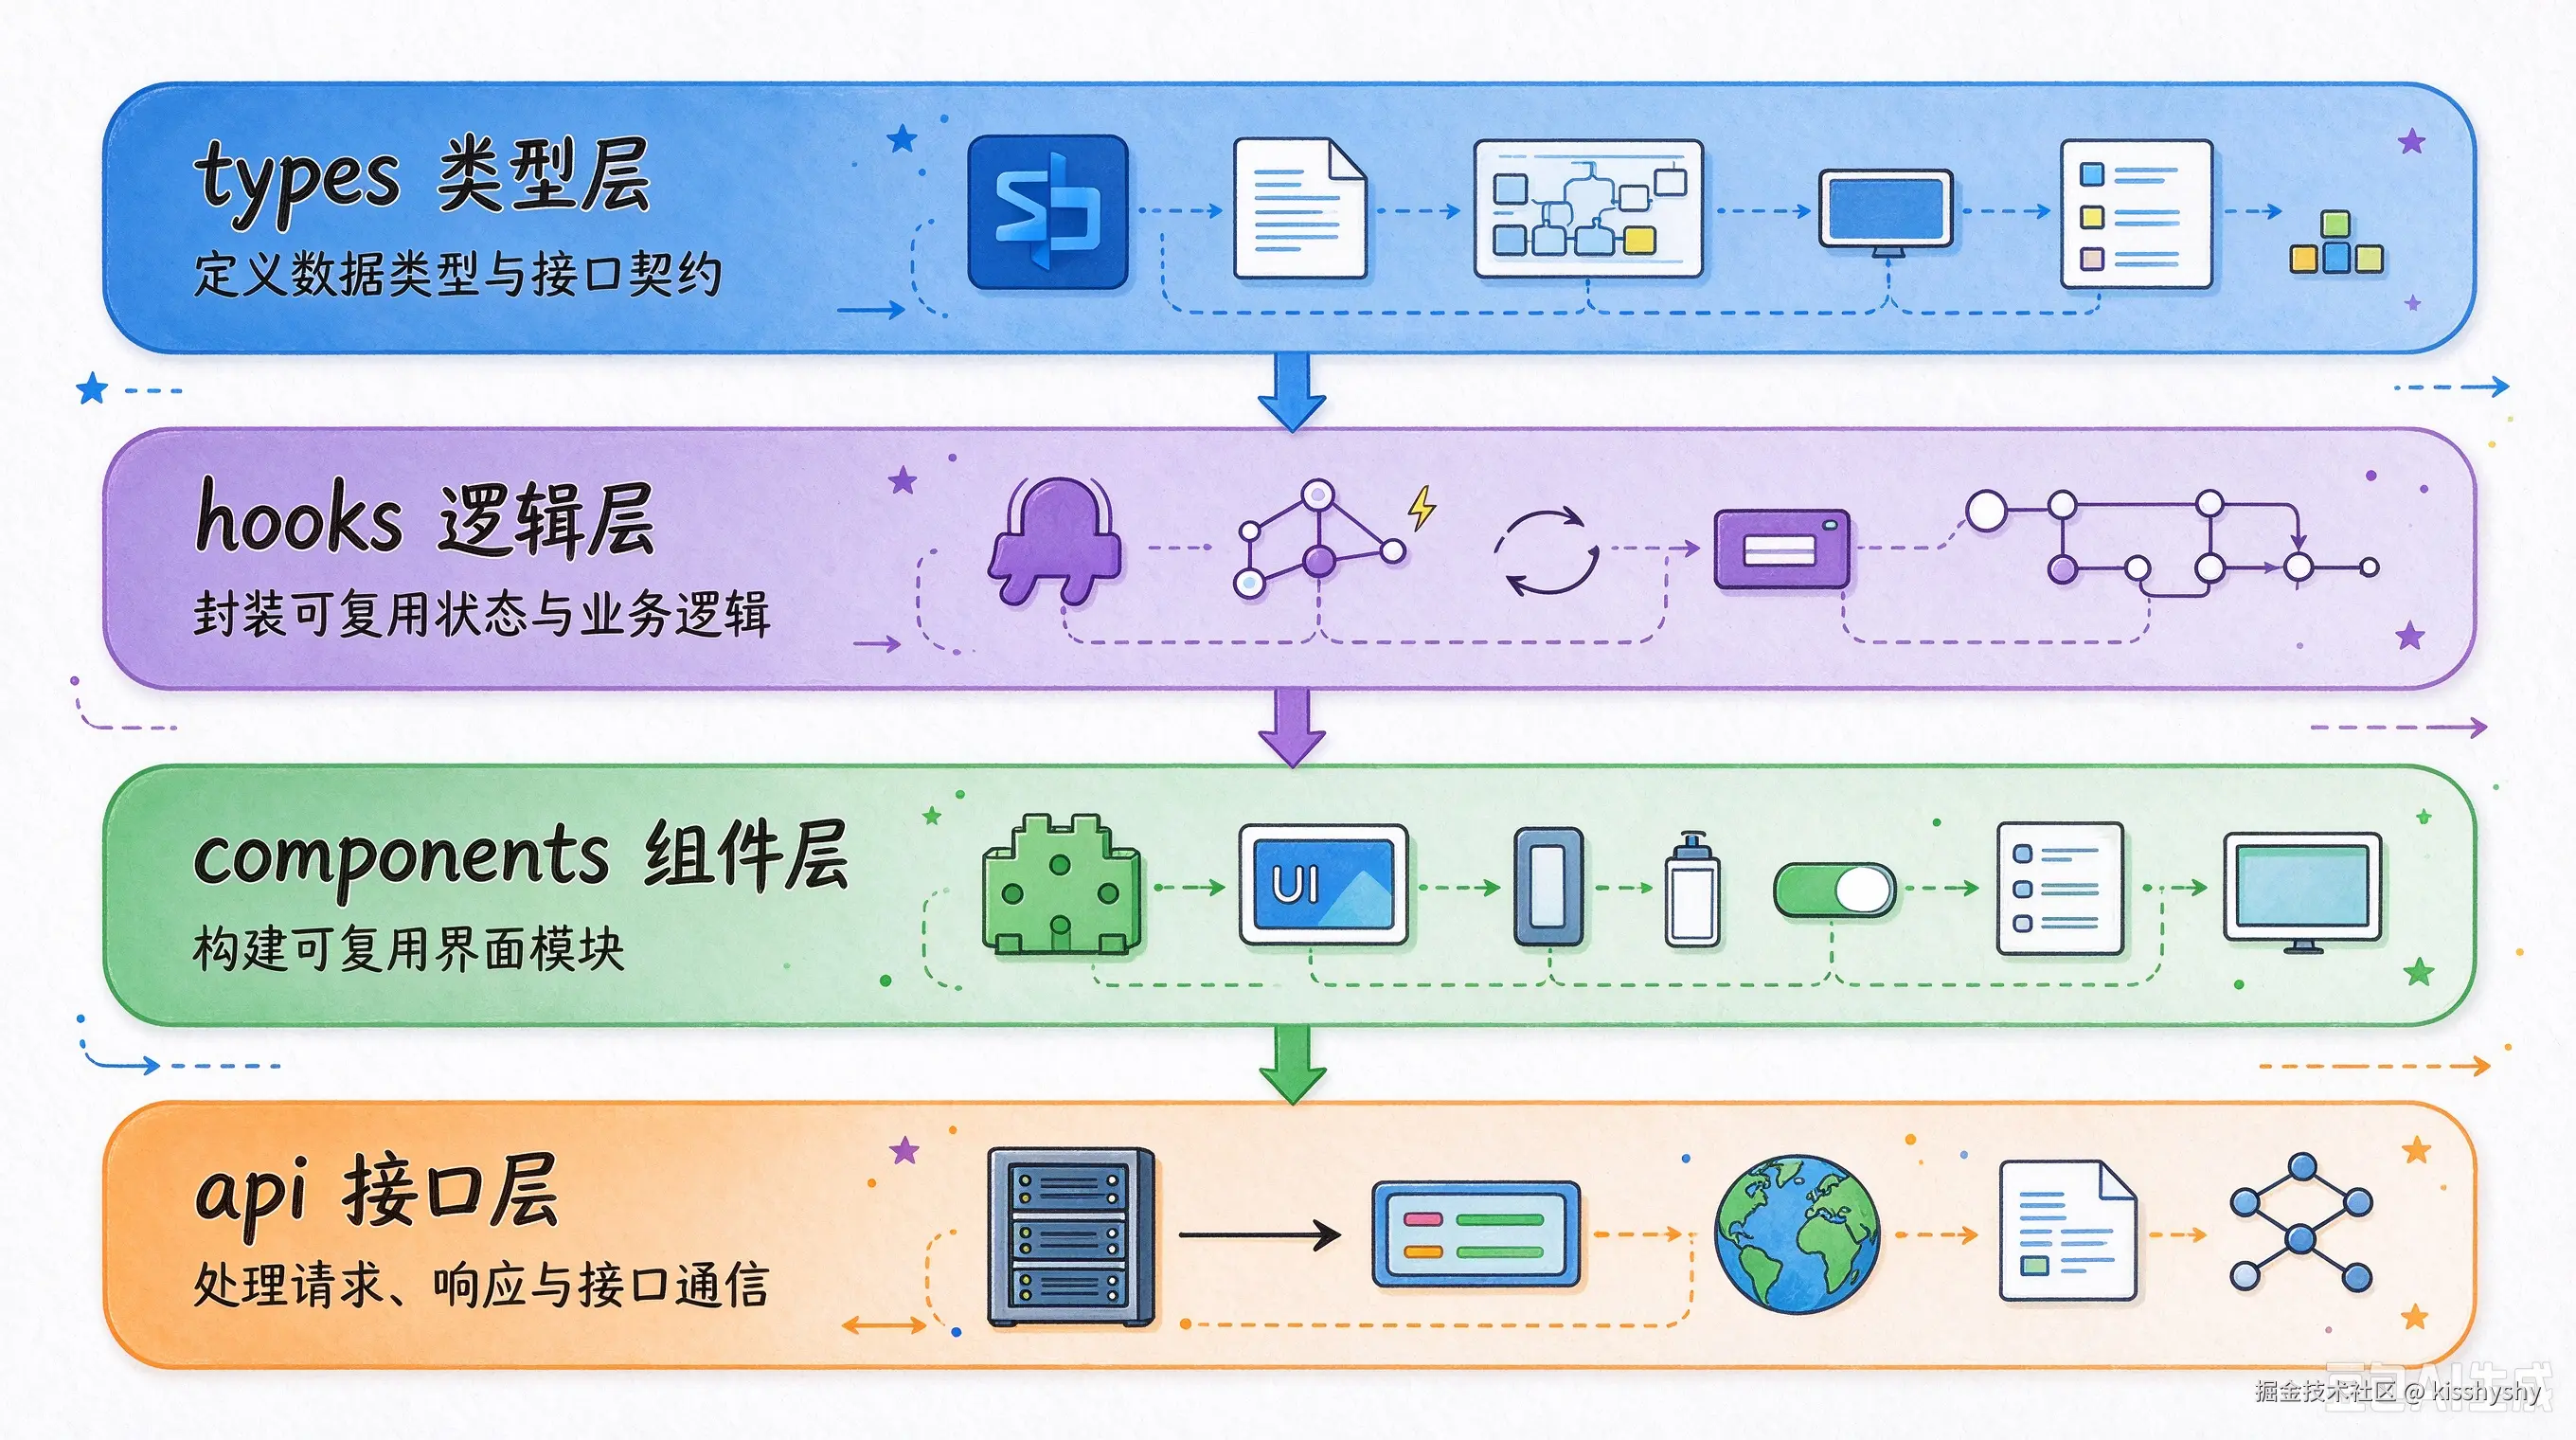
一个工程化的React项目,src目录下通常会按职责拆分为以下目录:
| 目录 | 职责 | 存放内容 |
|---|---|---|
types/ |
类型层 | 全局类型定义、interface、type别名,统一数据契约 |
hooks/ |
逻辑层 | 自定义Hook,按功能拆分,封装状态、副作用、业务逻辑 |
components/ |
视图层 | UI组件,只负责视图渲染和交互触发,不包含复杂业务逻辑 |
api/ |
接口层 | 后端接口请求封装,统一管理请求、响应拦截、错误处理 |
对应到我们的Todo项目中:
types/todo.ts定义了Todo数据结构和筛选类型hooks/useTodos.ts封装了待办的全部业务逻辑components/下的TodoInput、TodoItem、TodoList、TodoFilter只负责UI渲染api/存放后续对接后端的增删改查接口
这样分层的核心价值
- 职责单一:每个目录只负责一类事情,改类型不会碰组件,改逻辑不会动UI,符合「高内聚、低耦合」原则。
- 可维护性强:新人接手项目,通过目录结构就能快速定位代码,降低理解成本。
- 可复用性高:hooks和types可以跨组件、跨项目复用,UI组件也可以快速替换。
- 可测试性好:业务逻辑都在Hook里,可以单独编写单元测试,不依赖UI渲染。
分层的灵魂:单向依赖原则
上面列的都是「目录怎么分」,但真正让分层从「文件夹分类」升级为「架构」的,是依赖方向 ------所有依赖必须是单向的,只能从上层流向下层,绝不能反向。
markdown
components  →  hooks  →  types
     ↓            ↓
    api  ────────┘
具体的规则是:
| 层级 | 可以依赖 | 不可以依赖 |
|---|---|---|
types/ |
什么都不依赖(最纯净) | hooks、components、api |
hooks/ |
types、其他 hooks | components、api |
api/ |
types | hooks、components |
components/ |
hooks、types、api | --- |
为什么这条原则这么重要?
- 避免循环依赖 :
hooks引用components、components又引用hooks,打包时就会陷入循环,运行时会出现各种诡异 bug。 - 保护底层稳定 :
types是最底层,一旦它去依赖hooks,整个架构就失去了「契约先行」的意义------契约应该稳定,业务逻辑才应该灵活。 - 便于替换和测试 :底层不依赖上层,意味着底层可以被单独测试、单独替换,你的
types和hooks才能被真正复用。
💡 一句话记住它 :依赖只能从上往下,不能从下往上。 违反这条原则的架构,再怎么分类都只是「好看的文件柜」。
五、知识串联与总结
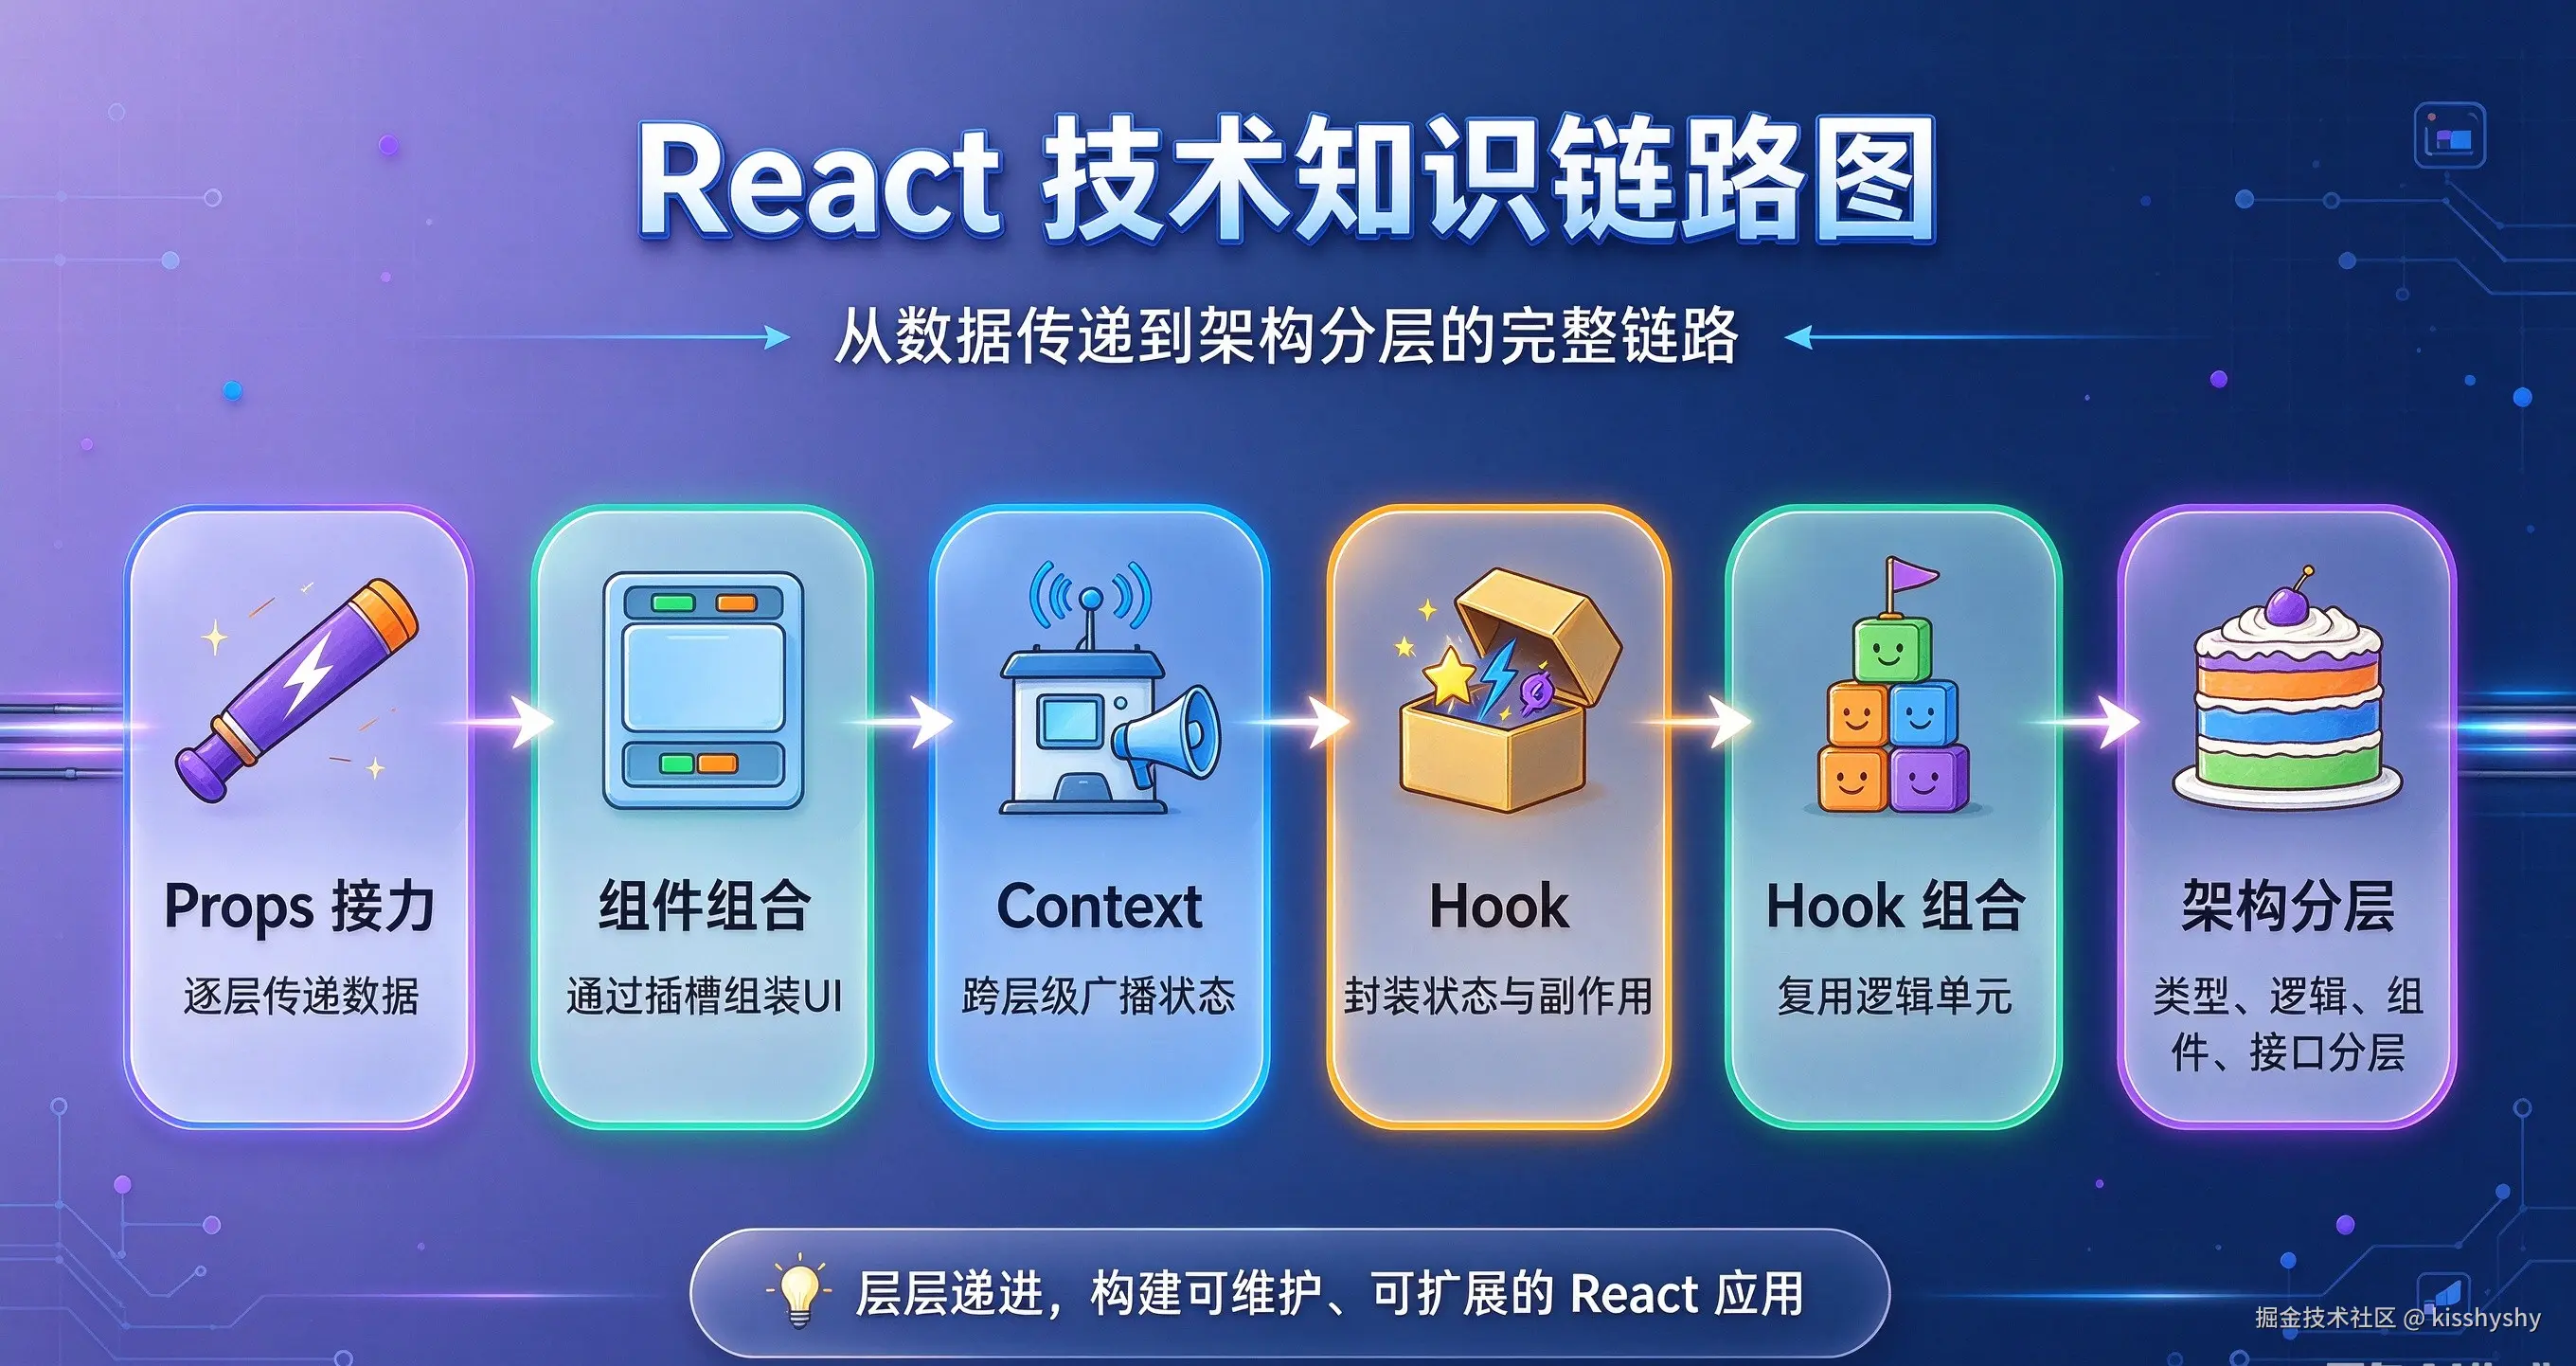
最后我们把整条知识链串起来,形成完整的逻辑闭环:
- 我们从最基础的父子组件props传参 起步,遇到了深层嵌套下的 Props Drilling 属性穿透痛点。
- 第一道防线是组件组合 ------用
children插槽绕过中间层,让中间组件完全不用感知数据。组合解决不了,再上 Context。 - 为了解决组合覆盖不到的场景,我们引入了 Context + useContext,实现了跨层级直接共享数据,免去了层层传递的麻烦。
- 为了让Context消费更简洁、更易维护,我们把它封装成了自定义Hook,这是我们第一次尝到逻辑封装的甜头。
- 进而我们发现,不仅是Context,DOM副作用、业务状态逻辑 都可以封装成自定义Hook,而自定义Hook本身还能互相组合,实现逻辑层层叠加。
- 最后当项目规模变大,我们按照类型层、逻辑层、视图层、接口层 的思路进行架构分层,并遵守单向依赖原则,让代码结构从「能跑」升级为「好维护」。
学习React从来不是死记硬背API,而是要理解每一个API背后解决的痛点,以及如何通过封装、抽象、分层,让代码变得更优雅、更有工程价值。
回顾一下你走过的路:从props传参 → 遇到prop drilling → 先用组件组合绕过中间层 → 组合不行再用Context跨越层级 → 用自定义Hook封装消费逻辑 → 用自定义Hook封装副作用和业务逻辑 → 用Hook组合叠加能力 → 用TS分层架构和单向依赖组织项目。每一步都不是凭空来的,都是被上一步的痛点推着走的。这就是React学习最自然的路线。
🎉 最后的最后
看到这里的你,已经比99%「收藏了就等于学会了」的同学强太多了 👏
如果这篇文章帮你理清了Context和自定义Hook的那点事儿,或者让你对「为什么要这么写」突然有了「啊哈」的时刻------那这篇文章就没白写。
求你三连! 🙏
- 点个赞 👍 ------ 让更多正在被Prop Drilling折磨的同学看到这篇
- 收个藏 ⭐ ------ 下次写Context的时候翻出来抄作业
- 关个注 🔔 ------ 后续还会更新更多React实战踩坑笔记
当然,如果你觉得哪里写得不对、或者你有更骚的封装姿势,评论区狠狠拍我,咱们一起把这个知识点聊透 💬
毕竟------学React最好的方式,从来不是一个人闷头看文档,而是一群人互相卷。 😎
我们下篇文章见!🚀
如果这篇文章对你有帮助,欢迎点赞收藏。有任何疑问或者更好的写法,也欢迎在评论区一起讨论 👇