《Agentic Design Patterns》第 9 章导读:学习与适应(Learning and Adaptation)
本文是对开源书籍《Agentic Design Patterns》第 9 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
如果说前几章讲的是"怎么让智能体把事情做好",那第 9 章讲的就是更本质的问题:怎么让智能体自己变得越来越强?
这就是**学习与适应(Learning and Adaptation)**模式------让智能体突破预设参数的限制,通过经验和环境交互实现自主提升。不需要人持续干预,它就能应对新情况、优化自己的表现。
这一章的内容也最有"科幻感"------因为它涉及到智能体自我修改的可能性。
一、智能体的六种学习方式
书中首先梳理了智能体可以使用的六种主要学习方法,覆盖了从传统机器学习到 LLM 时代的各种范式:
| 学习方式 | 原理 | 适用场景 |
|---|---|---|
| 强化学习 | 试错 + 奖惩,好的行为加分,坏的扣分 | 机器人控制、游戏 AI |
| 监督学习 | 从标注示例中学习输入到输出的映射 | 邮件分类、趋势预测 |
| 无监督学习 | 在未标注数据中发现隐藏模式和关联 | 数据探索、聚类分析 |
| LLM 少样本/零样本学习 | 靠大模型自身的通用能力,给几个示例或明确指令就能上手新任务 | 快速适配新任务、新指令 |
| 在线学习 | 持续接收数据流,实时更新模型 | 动态环境、实时优化 |
| 基于记忆的学习 | 回忆过往经验来调整当前行动 | 有记忆召回能力的智能体 |
这里有个概念需要区分:学习 和适应不是一回事。
- 学习是过程------智能体基于新经验和数据改变思维方式、行动或知识;
- 适应是结果------学习导致的行为或知识的可见变化。
学习是"内化",适应是"外化"。
二、两种关键算法:PPO 与 DPO
书中专门介绍了两种在 LLM 对齐领域非常重要的算法------因为它们关系到"怎么让智能体的行为符合人类期望"这个核心问题。
PPO(近端策略优化)
PPO 是强化学习领域的经典算法,核心思想是**"小步快跑、稳扎稳打"**:
- 智能体用当前策略跟环境交互,收集一批经验数据;
- 计算策略更新对预期奖励的影响;
- 用裁剪机制把更新幅度限制在一个"安全区"里------不能一次改太多。
为什么要裁剪?因为如果策略更新太剧烈,智能体可能"学崩"------之前学到的好东西全忘了,性能反而断崖式下跌。PPO 就像一个安全刹车,确保每一步改进都是小而稳的,避免灾难性遗忘。
DPO(直接偏好优化)
DPO 是后来居上的新方法,专门为 LLM 对齐设计,比 PPO 简单得多。
传统的 PPO 对齐是个两步过程:
- 先收集人类偏好数据,训练一个奖励模型当"评委";
- 再用 PPO 微调 LLM,让它生成能拿高分的回答。
问题是这个过程又复杂又不稳定------LLM 甚至可能找到奖励模型的"漏洞",投机取巧拿高分,但回答质量并不高。
DPO 的思路很直接:跳过奖励模型,直接用偏好数据更新 LLM。 它利用了一个数学关系------偏好数据和最优策略之间可以直接挂钩。简单说就是:
增加生成"偏好回答"的概率,降低生成"不喜欢回答"的概率。
不用训练单独的奖励模型,不用复杂的强化学习循环,一步到位。更简单、更稳定、效果也不差。这也是为什么 DPO 现在越来越流行。
三、应用场景:自适应智能体在哪里发挥价值
学习与适应能力让智能体在多变环境中表现更强。书中举了 8 个典型场景:
- 个性化助手:长期分析用户行为模式,越用越懂你,响应越来越贴合习惯;
- 交易机器人:基于实时市场数据动态调整策略参数,在风险和收益之间找最优平衡;
- 应用界面智能体:根据用户行为动态调整界面功能,提升可用性和参与度;
- 机器人/自动驾驶:整合传感器数据和历史经验,在各种环境下越开越稳;
- 欺诈检测:识别新的欺诈模式,持续改进预测模型,减少漏判和误判;
- 推荐系统:学习用户偏好变化,推荐越来越精准、越来越贴合上下文;
- 游戏 AI:动态调整战略难度,保持挑战性,让玩家不觉得无聊也不被劝退;
- 知识库学习智能体:用 RAG 维护"问题-解决方案"的动态知识库------遇到新问题、找到好方案,就存下来,下次直接用。
最后这个"知识库学习"的思路特别实用:它不需要改模型,只需要把成功经验和踩过的坑存进知识库,下次遇到类似情况就能直接参考。成本低、见效快、还安全。
四、硬核案例:SICA------能自己改自己代码的智能体
如果说上面这些还是"常规操作",那 SICA(Self-Improving Coding Agent,自我改进编码智能体) 就真的有点"细思极恐"的味道了。
SICA 最特别的地方:它既是修改者,又是被修改者。 它直接修改自己的源代码,然后用修改后的自己继续工作、继续改进。
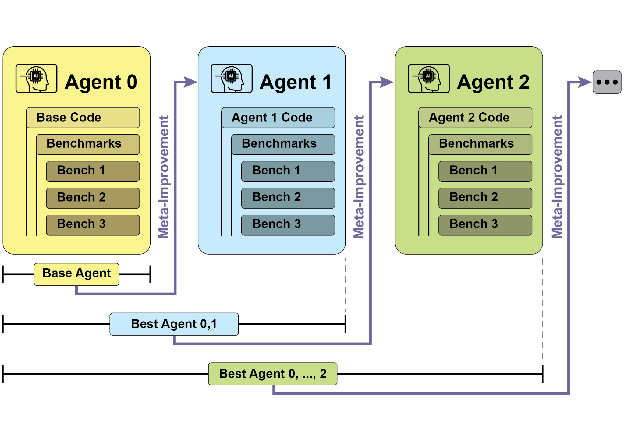
图 1:SICA 的自我改进循环------审查历史版本 → 选择最优版本 → 分析改进点 → 修改代码 → 基准测试 → 记录结果 → 重复。
整个过程是一个迭代循环:
- 审查档案:看自己的历史版本和各版本在基准测试中的表现,选一个性能最好的当"起点";
- 分析改进点:找一找哪里可以优化;
- 直接改代码:自己修改自己的代码库;
- 跑基准测试:测一测改完之后变强了还是变弱了;
- 记录归档:把新版本和测试结果存起来;
- 重复:继续下一轮自我改进。
SICA 确实通过这种方式实现了显著的自我进化。比如在代码编辑方面:
- 一开始只能用"文件覆盖"这种笨方法改代码;
- 后来自己开发出了"智能编辑器",能做更精准的上下文相关编辑;
- 再后来又进化出"差异增强智能编辑器",结合 diff 做针对性修改;
- 甚至用上了 AST(抽象语法树)解析来提高效率。
在代码导航方面,它自己搞出了"AST 符号定位器"------用代码的结构图来找定义,后来又优化成"混合符号定位器",把快速搜索和 AST 检查结合起来。
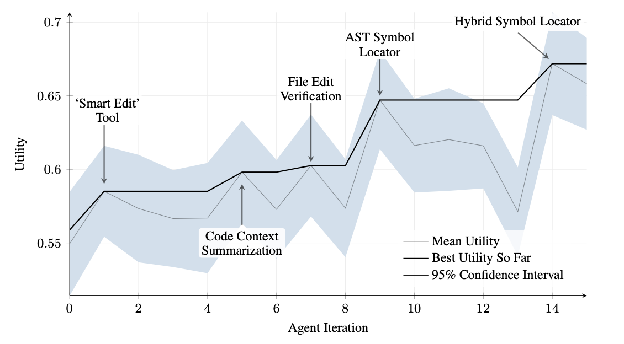
图 2:SICA 多轮迭代后的性能提升曲线------每一次自我改进都带来 measurable 的性能增益。
SICA 的架构也很有参考价值:
- 模块化:主智能体 + 专门子智能体(编码、问题解决、推理),复杂任务拆给子智能体做;
- 异步监督者:另一个 LLM 在旁边盯着,发现死循环、停滞不前就介入叫停;
- 结构化上下文:LLM 的上下文窗口按固定格式组织------系统提示词、工具文档、核心问题、推理记录、监督者通信......信息井然有序,处理效率高;
- Docker 容器化:在隔离环境里运行,防止智能体改代码时把主机搞崩(安全考虑非常必要!)。
当然,SICA 也有局限。书中提到一个核心挑战:怎么让 LLM 智能体每次都想出真正有新意、可行、又有效的改进方案? 开放式学习和真正的创造力,仍然是当前研究的关键前沿。
五、进化算法 + LLM:AlphaEvolve 与 OpenEvolve
另一个有趣的方向是把 LLM 和进化算法结合起来,让 AI 自己发现和优化算法。
AlphaEvolve(Google)
AlphaEvolve 是 Google DeepMind 搞的,用 Gemini 模型 + 自动化评估 + 进化算法框架来发现和优化算法。
它的工作流:
- 生成提案:用 Gemini Flash 大量生成初始算法方案(量大管饱);
- 深入分析:用 Gemini Pro 对方案做更深入的分析和改进;
- 自动评估:按预定义标准给算法打分;
- 迭代优化:用评估反馈继续改进,循环往复。
成果相当硬核:
- 数据中心调度优化,全球计算资源使用减少 0.7%;
- 硬件设计优化,为下一代 TPU 的 Verilog 代码提建议;
- AI 性能加速,Gemini 架构核心内核提速 23%,FlashAttention 的 GPU 指令最高优化 32.5%;
- 基础数学研究:发现了 4x4 复数值矩阵乘法的新算法(只用 48 次标量乘法,超过之前已知方案);在 75% 的情况下重新发现了 50 多个开放问题的现有最优解,20% 的情况下还有改进。
一句话:AI 已经开始自己设计更快的 AI 了。
OpenEvolve
OpenEvolve 是一个开源的进化编码智能体,核心特点是:
- 用 LLM 迭代优化代码;
- 进化的是完整代码文件,不只是单个函数;
- 支持多种编程语言,兼容任何 OpenAI 兼容 API;
- 支持多目标优化、分布式评估。
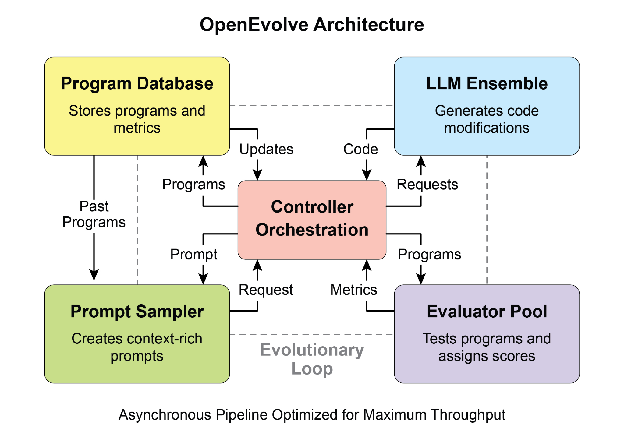
图 3:OpenEvolve 内部架构------控制器管全局,LLM 生成代码变体,评估器打分筛选,一代一代进化。
使用也很简单:
python
from openevolve import OpenEvolve

evolve = OpenEvolve(
    initial_program_path="path/to/initial_program.py",
    evaluation_file="path/to/evaluator.py",
    config_path="path/to/config.yaml"
)

best_program = await evolve.run(iterations=1000)
给它一个初始程序、一个评估脚本、一个配置文件,跑 1000 轮进化,最后给你最优版本。
六、速览
- 问题背景:AI 智能体通常在动态、不可预测的环境中运行,预编程的逻辑不够用。遇到没预料到的新情况,性能就下降。没有从经验中学习的能力,智能体就没法随时间优化策略、没法个性化交互。这种僵化限制了它的有效性,也阻止了它在复杂现实场景中实现真正的自主性。
- 解决方案:集成学习和适应机制,把静态智能体变成动态演化的系统。让智能体能基于新数据和交互自主改进知识和行为。方法很多------从强化学习到 SICA 那样的自我修改,再到 AlphaEvolve 那样用 LLM + 进化算法发现全新的高效方案。通过持续学习,智能体可以掌握新任务、提升性能、适应变化,不用人反复手动改代码。
- 实践建议:构建必须在动态、不确定或不断演化的环境中运行的智能体时,使用此模式。对于需要个性化、持续性能改进、自主应对新情况的应用,学习与适应能力至关重要。
七、可视化总结
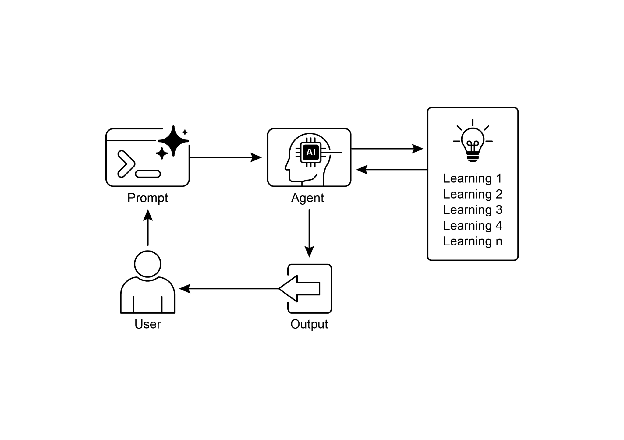
图 4:学习和适应模式------智能体通过经验自主改进行为与知识。
关键要点
- 学习和适应是智能体通过经验改进自身行为、应对新情况的过程;
- "适应"是学习导致的行为或知识的可见变化;
- SICA(自我改进编码智能体)通过修改自己的代码来自我改进,产生了智能编辑器、AST 符号定位器等工具;
- 专门的"子智能体"和"监督者"帮助自我改进系统管理复杂任务、保持正轨;
- LLM 上下文窗口的组织方式(系统提示词、核心提示词、助手消息)对智能体效率至关重要;
- 配备基本编码工具的智能体系统可以自主编辑自身,从而提升基准任务性能;
- AlphaEvolve 利用 LLM 和进化框架自主发现和优化算法,在基础研究和实际计算中都取得了显著成果。
结语与个人思考
"学习与适应"是这本书到目前为止最有哲学意味的一章------因为它触及了一个根本问题:智能体能不能自己变得更聪明?
答案是:能,而且已经在发生了。
SICA 自己改自己的代码、自己优化自己的工具;AlphaEvolve 自己发现更快的算法、自己优化 AI 的核心内核。这些都不是科幻,而是已经实现的事情。
但兴奋之余,也有几个值得冷静思考的问题:
第一个是对齐问题的放大。如果智能体有自我改进的能力,那它的目标对齐就变得极端重要。一个目标稍有偏差的智能体,经过多轮自我改进后,偏差可能会被放大到不可接受的程度。这也是为什么 SICA 需要一个异步监督者在旁边盯着------但监督者本身也是 LLM,它就一定可靠吗?
第二个是改进的天花板。SICA 的改进依赖于 LLM 能不能想出"新颖、可行、有效"的修改方案。LLM 的创造力本质上是"对已有知识的重新组合",而不是真正的从 0 到 1 的突破。当改进进入深水区,还能不能持续推进?这还是个未知数。
第三个是安全性。能自我修改的智能体,安全风险比普通智能体高得多。一个 bug 就可能让它改坏自己,甚至改出不可控的行为。SICA 用 Docker 容器化来隔离,这是必要的,但可能还不够------如果智能体"学会了"逃出容器呢?
最后,我觉得最值得关注的趋势是 AI 改进 AI 的正循环。AlphaEvolve 优化了 Gemini 的核心内核,让 Gemini 变得更快;更快的 Gemini 又可以用来做更多的算法发现,进一步提升 AI 的性能。这种"自己拉自己的鞋带"的正循环一旦转起来,加速度可能会超出所有人的预期。
当然,现在还早。目前的自我改进更多是在"工具层面"和"算法层面",还远没到"自我意识"或"超级智能"的程度。但方向已经很明确了------智能体的进化,不再完全依赖人类的设计。
下一步,建议阅读第 10 章 模型上下文协议(MCP)------看看怎么用标准化协议让智能体连接各种外部工具和数据源。
本文基于开源书籍《Agentic Design Patterns》(https://github.com/xindoo/agentic-design-patterns ,在线阅读 https://adp.xindoo.xyz/ )整理,供学习交流,版权归原作者所有。