【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
227、【AI】【模型部署】基座模型研究:RoPE 旋转位置编码
背景
上篇 blog
【AI】【模型部署】基座模型研究:RMSNorm 与残差(归一化为什么必要)
拆了每层的第一个零件:Qwen2RMSNorm 只做"算 mean(x²) → 乘 rsqrt(variance+eps) → 乘可学习权重",不减均值;手写实现与源码输出误差 0 ,与 LayerNorm 的差异(输出均值 0.0003 vs 3.4e-9)正体现"只归尺度";它放在子层之前(pre-norm)并与残差配合。归一化后的向量接着进入注意力,而注意力有个天生缺陷:它对顺序无感 ------把"猫吃鱼"和"鱼吃猫"的 token 打乱,注意力算出的结果一样。位置信息得额外注入,本篇讲 Qwen2 用的方案:RoPE(旋转位置编码)
模型部署
注意力的计算是 q 与 k 做点积:谁和谁相关,只看向量本身。要让模型知道"谁在前谁在后",就得把位置"编"进 q 和 k。RoPE(Rotary Position Embedding,旋转位置编码) 的思路很巧妙:按位置把向量旋转一个角度------位置不同,旋转角度不同;两个向量做点积时,角度差自然带出相对距离。
🧩 源码:频率是怎么算的
Qwen2RotaryEmbedding(modeling_qwen2.py:51-102)初始化时算一组"逆频率"(compute_default_rope_parameters:71-87):
python
base = config.rope_parameters["rope_theta"]
dim = getattr(config, "head_dim", None) or config.hidden_size // config.num_attention_heads
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2, dtype=torch.float) / dim))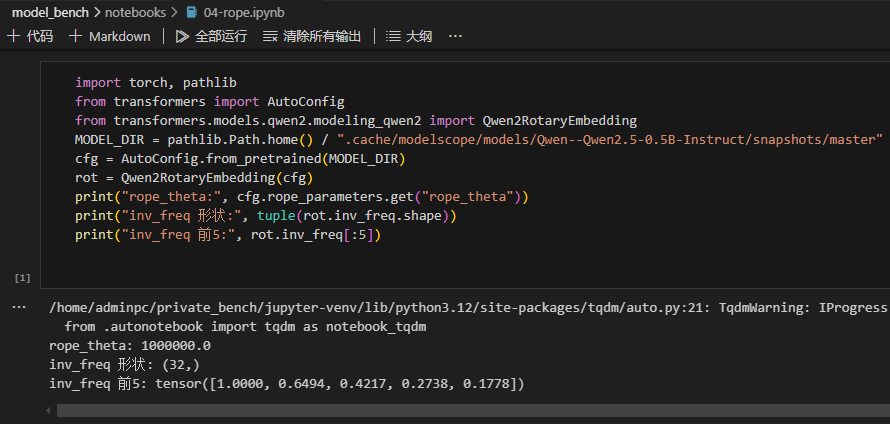
实测:rope_theta=1000000.0(config 里那个字段),head_dim=64,于是 inv_freq 长度 32 (64 的一半),前五个值约 [1.0000, 0.6494, 0.4217, 0.2738, 0.1778]------不同维度用不同频率:低维转得快、高维转得慢,像时钟的秒针与时针。
把公式手抄一遍,与模型里的值对比(实测):
python
base = cfg.rope_parameters["rope_theta"]
dim = cfg.hidden_size // cfg.num_attention_heads
inv = 1.0 / (base ** (torch.arange(0, dim, 2, dtype=torch.float) / dim))
print("手算 inv_freq == 源码:", torch.allclose(inv, rot.inv_freq))
实测 True------公式没有隐藏项:inv_freq[i] = 1 / theta^(2i/dim),i 从 0 到 31,指数 2i/dim 让相邻维度按几何级数拉开频率。
🧩 前向:位置决定旋转角
拿到逆频率后,对每个位置 pos 计算 freqs = pos × inv_freq,再取 cos/sin(实测):
python
pos = torch.arange(0, 8).unsqueeze(0)
x = torch.randn(1, 8, 64)
cos, sin = rot(x, pos)
print("cos 形状:", tuple(cos.shape))
print("位置0 cos[:4]:", cos[0, 0, :4])
print("位置1 cos[:4]:", cos[0, 1, :4])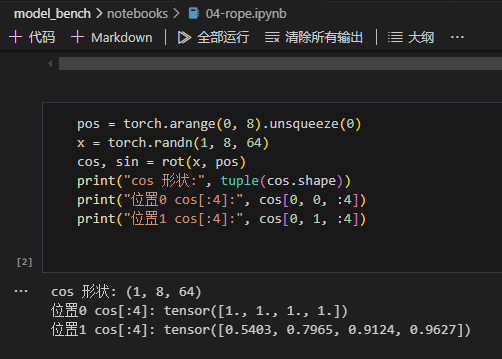
实测:cos 形状 (1, 8, 64)------每个位置一组 cos;位置 0 的 cos 全是 1 (旋转 0 度等于没转),位置 1 的 cos 变成 [0.5403, 0.7965, 0.9124, 0.9627]------位置越靠后,角度越大,各维旋转幅度不同。
🧩 rotate_half 与 apply:怎么把旋转加到向量上
真正施加旋转靠两个函数。rotate_half(modeling_qwen2.py:105-109)把向量的前后两半"交叉换位并取负":
python
def rotate_half(x):
    x1 = x[..., : x.shape[-1] // 2]
    x2 = x[..., x.shape[-1] // 2 :]
    return torch.cat((-x2, x1), dim=-1)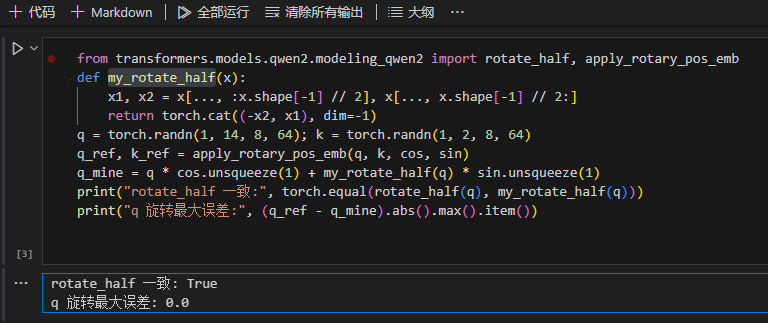
apply_rotary_pos_emb(modeling_qwen2.py:113-135)则用"乘法 + 旋转"组合完成旋转:
python
def apply_rotary_pos_emb(q, k, cos, sin, unsqueeze_dim=1):
    cos = cos.unsqueeze(unsqueeze_dim)
    sin = sin.unsqueeze(unsqueeze_dim)
    q_embed = (q * cos) + (rotate_half(q) * sin)
    k_embed = (k * cos) + (rotate_half(k) * sin)
return q_embed, k_embed手写一遍并对比(实测):rotate_half 与源码逐元素相等 ,q 旋转后与源码最大误差 0.0 。这段形式看着像"三角函数",本质就是二维旋转矩阵 [cos, -sin; sin, cos] 作用在成对的维度上。
把一对维度 (x1, x2) 看成二维向量,旋转角 θ 的旋转矩阵作用后:x1' = x1·cosθ - x2·sinθ、x2' = x1·sinθ + x2·cosθ。源码里的 (x·cos) + (rotate_half(x)·sin) 正是它的向量化写法------rotate_half 提供 (-x2, x1),乘 sin 后与 x·cos 相加即得上述结果。Qwen2 把 64 维拆成 32 对 ,每对用不同频率旋转;unsqueeze_dim=1 则把 cos/sin 插到"头"这一维,好广播到 (batch, heads, seq, dim) 的 q/k 上。
🧩 实测:点积只认相对位置
RoPE 最核心的性质可以用点积验证:同一个 q、k 放到不同位置旋转后做点积(实测):
python
print("q@pos5 · k@pos3 =", round(dot(5, 3), 5))
print("q@pos2 · k@pos0 =", round(dot(2, 0), 5))
print("q@pos0 · k@pos2 =", round(dot(0, 2), 5))实测:q@pos5 · k@pos3 与 q@pos2 · k@pos0 都等于 5.64291 ------两组位置距离都是 2,点积完全相同;而 q@pos0 · k@pos2(距离 -2)是 8.86717,方向反了结果就不同。这直接证明:旋转后 q·k 只依赖相对距离,与绝对位置无关。
🧩 为什么旋转能编码位置
把 q、k 都按各自位置旋转后做点积:位置 m 的 q 与位置 n 的 k,点积结果只取决于角度差 (即 m-n)------绝对位置被旋转"消掉",留下的是相对距离。这正是注意力想要的:判断"两个 token 离多远"比"各自在第几位"更有用。
这也是 Qwen2 支持长上下文(config 里
max_position_embeddings=32768)的基础:位置信息不是查表加进去的固定向量,而是按公式算出的旋转角,可以外推到更长位置。
🧩 rope_theta 为什么是 100 万
公式 inv_freq = 1 / theta^(2i/dim) 里,theta 越大,频率衰减越慢、可区分的位置范围越广。Qwen2 用 rope_theta=1000000(不少小模型用 10000),配合 max_position_embeddings=32768 支撑长上下文;把 theta 调大,也是把模型"外推"到更长位置时的常用手段之一。本模型能覆盖 32768 个位置,正是 theta 与那 32 个频率共同支撑的结果。
📊 RoPE 的特点小结
| 特点 | 说明 |
|---|---|
| 相对位置 | 旋转后点积只依赖 m-n(本篇实测:距离同为 2 时点积相等) |
| 无额外参数 | 靠 cos/sin 公式现算,不占权重 |
| 可外推 | 位置是算出来的角度,不是查表向量 |
| 作用对象 | 只旋转 q、k,不碰 v |
正因为不占参数、又天然表达相对距离,RoPE 成了当下开源大模型(Qwen、Llama 等)的主流位置编码。
另外注意:RoPE 只作用于 q 和 k ,v 保持原样------因为位置只影响"谁和谁相关",不影响"取什么内容"。
这也是"位置编码"与"位置嵌入"的分野:传统方案给 token 向量加一个位置向量,RoPE 则不动 token 本身,只在注意力的 q/k 上做旋转。
📌 一句话记忆
RoPE 用"按位置旋转"给注意力注入位置:
inv_freq = 1/(theta^(2i/dim))(rope_theta=1e6、head_dim=64→ 32 个频率),位置pos决定旋转角,rotate_half+apply_rotary_pos_emb把旋转作用到 q/k 上(手写与源码误差 0);旋转后 q·k 只依赖相对位置------位置 0 的 cos 全 1(没转),位置越靠后角度越大。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog