摘要 :我做过一套浏览器端的 3D 虚拟世界基底,把它拆开之后最值得说的一件事是:从零做一个 3D 场景并不难------一个
requestAnimationFrame循环、一个模型、一套轨道控制器,一个下午就有了。难的是让它在真实设备和网络里站得住。这篇把第二阶段的四类问题逐条摊开:颜色管线双重 gamma(不报错,画面偏亮偏粉)、加载与预热(进度条卡在 90%)、draw call 与灯(一次灯数变化实测触发 8989 毫秒全场景冻结)、断线重连(服务端仍当你在场)。这四类的共同点是全都不报错 ,所以很难变成待办事项。结论是:上面四类成本可以被一个可复用的分层归零,而你的项目只需要写第五层。
全文数据来自项目内可重跑的验收脚本。写到"哪些地方容易想错"那一节时会更啰嗦,因为那部分比能力清单更值得看。
标签 :3D Three.js WebGL 性能优化 虚拟世界
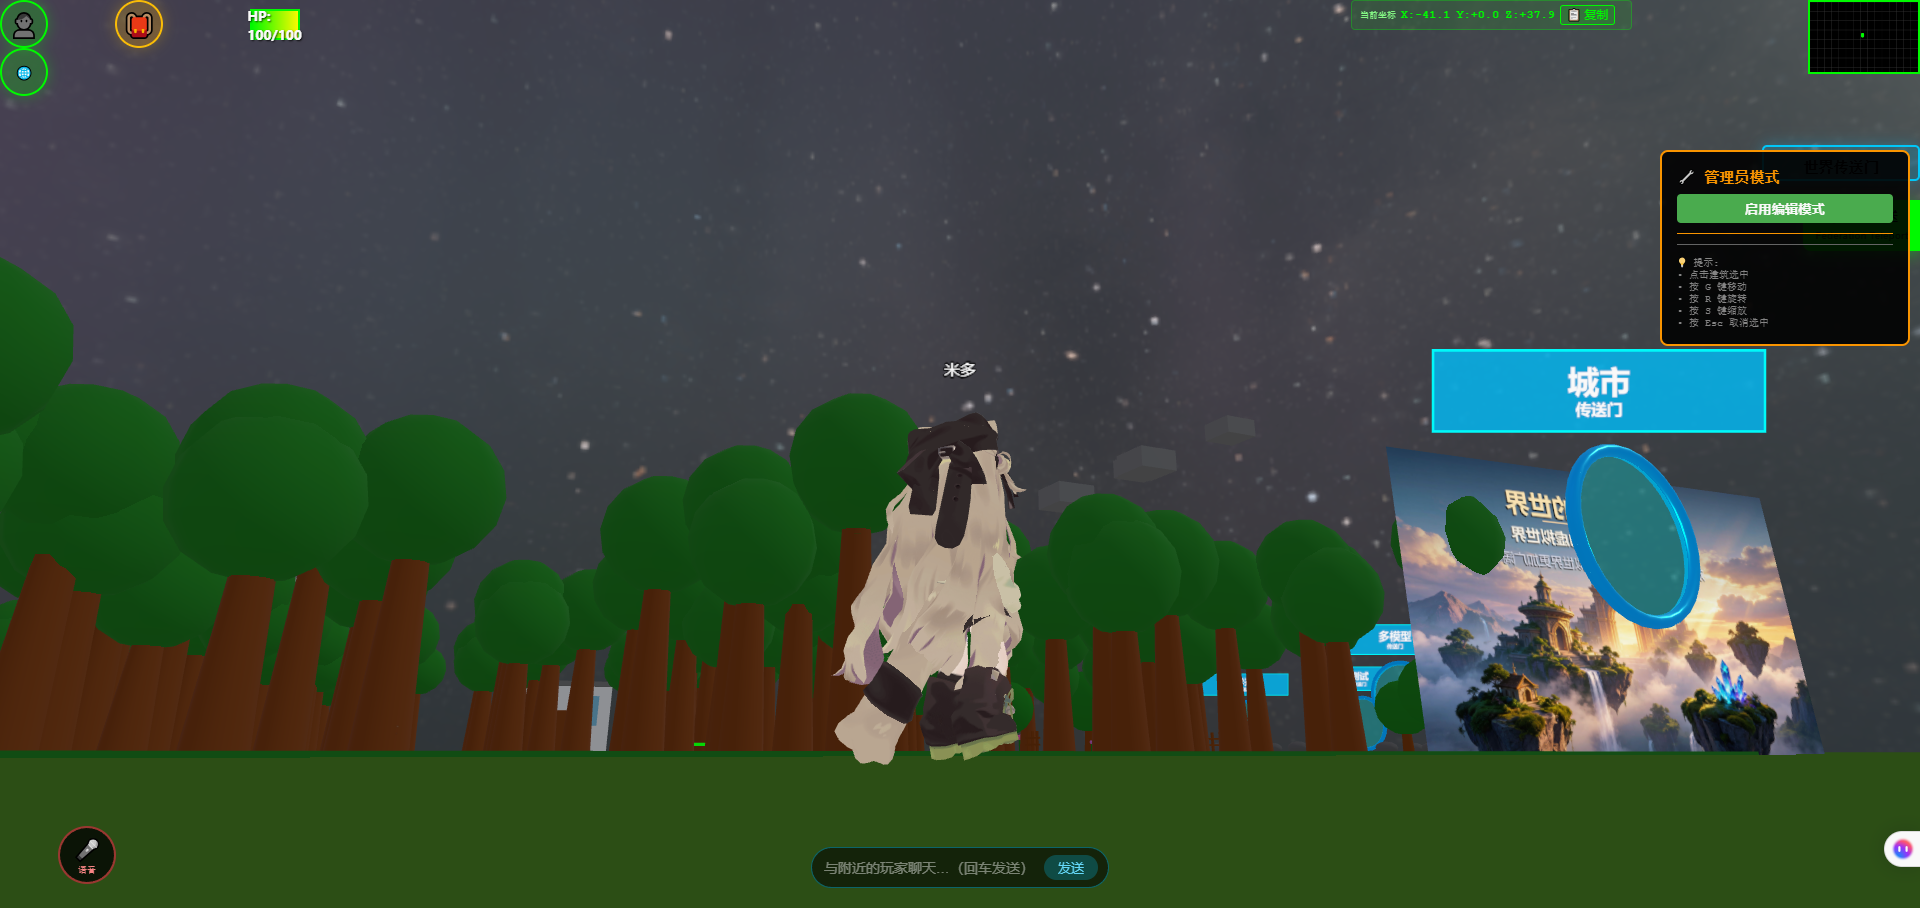
一、"从零写"这个决定,通常被低估
我做过这套东西之后,最常被问的是"为什么不自己从头写一遍"。这个问题好答:能,Three.js 是公开的包,浏览器是公开的平台。
难的是第二阶段:让它在真实使用里站得住。
真实使用指的是:不是你的开发机上、不是只有你在看。是一台没配过的手机、一台别人五年前的笔记本、一个网络时好时坏的会议室、一台开着十几个标签页的办公电脑。
这类环境不会给你报错日志,只会给出一个"这做的有点糙"的印象。而你回头去找原因,找不到。
所以从零造的成本,不在你写的那部分代码里,而在那些不性感、看不见成果、却吃掉大半工期的地基上 。下面四类问题的共同点是:它们全都不报错------不报错的东西很难变成待办事项,所以会一直留在产品里。
二、四类问题,每一类都有具体的机制
A. 画面正确性:没有任何报错,只是"看着不对"
Three.js r128 时代有一个常见错误做法:输出按 sRGB 处理,贴图却按线性着色。两者叠加就是双重 gamma,结果是画面整体偏亮、偏粉,阴影发灰。
这个 bug 不产生任何报错,只表现为"质感差了点"。如果验收标准是"能跑起来",它会一直留在产品里,直到有用户提出来。
验证方式不能是"跑起来看看"。可行的做法是:先立 10 张统一口径的基线截图,再做一个自研的 PSNR / diff 工具逐张比。我们实测后台界面 43.4dB 一致,主世界的差异能全部归因到颜色管线修正,构图、建筑、角色像素级一致。
顺带补了 87 个废弃符号的垫片、治理了 79 处遗留API 调用,还加了加载前的 WebGL2 能力检测------不支持时给一句人话提示,而不是白屏。
这件事的启发不是"版本要新",而是:画面正确性需要一套可验证的方法,而不是靠眼睛看。
B. 加载体验:进度条卡在 90% 的那一段
资源从 13 MB 变成 4 MB,体感是完全不同的两件事。而卡顿的来源往往不是网络,而是资产构成和主线程分配。
| 问题 | 机制层面的原因 | 处理方式与实测 |
|---|---|---|
| 首屏资源过重 | 几何与贴图没有分级 | 首屏实测 838 KB、99 个请求、加载 1.7 秒 |
| 远处模型还在满面 | 所有距离用同一档模型 | 三档 LOD,118 组低模 ≤100 面、三角数−71%~−87% |
| 模型文件虚胖 | 贴图按原始尺寸直传 | 按用途分级处理,贴图 −68%~−92%,变体贴图剥离 215 件 0 失败 |
| 新对象入屏时画面死住 | 着色器编译是同步的 | 预热预算:编译后按每帧 170 毫秒份额结算,首进最长 386 毫秒,超 500 毫秒长帧为 0 |
这四类同样不报错。没有一条日志提示你"你的模型太大了"。
C. 规模一上来就崩:draw call 和灯
场景里放几十个模型很好看。放到几百个,帧率开始掉。
机制是:每次绘制调用都有开销,而同一批材质合并成一次调用,代价就是同一次调用里做了更多事。实测几何合批后,密集区 draw call 从 3064 降到 837(−73%),加载期占位场从 2150 降到 956(−56%)。
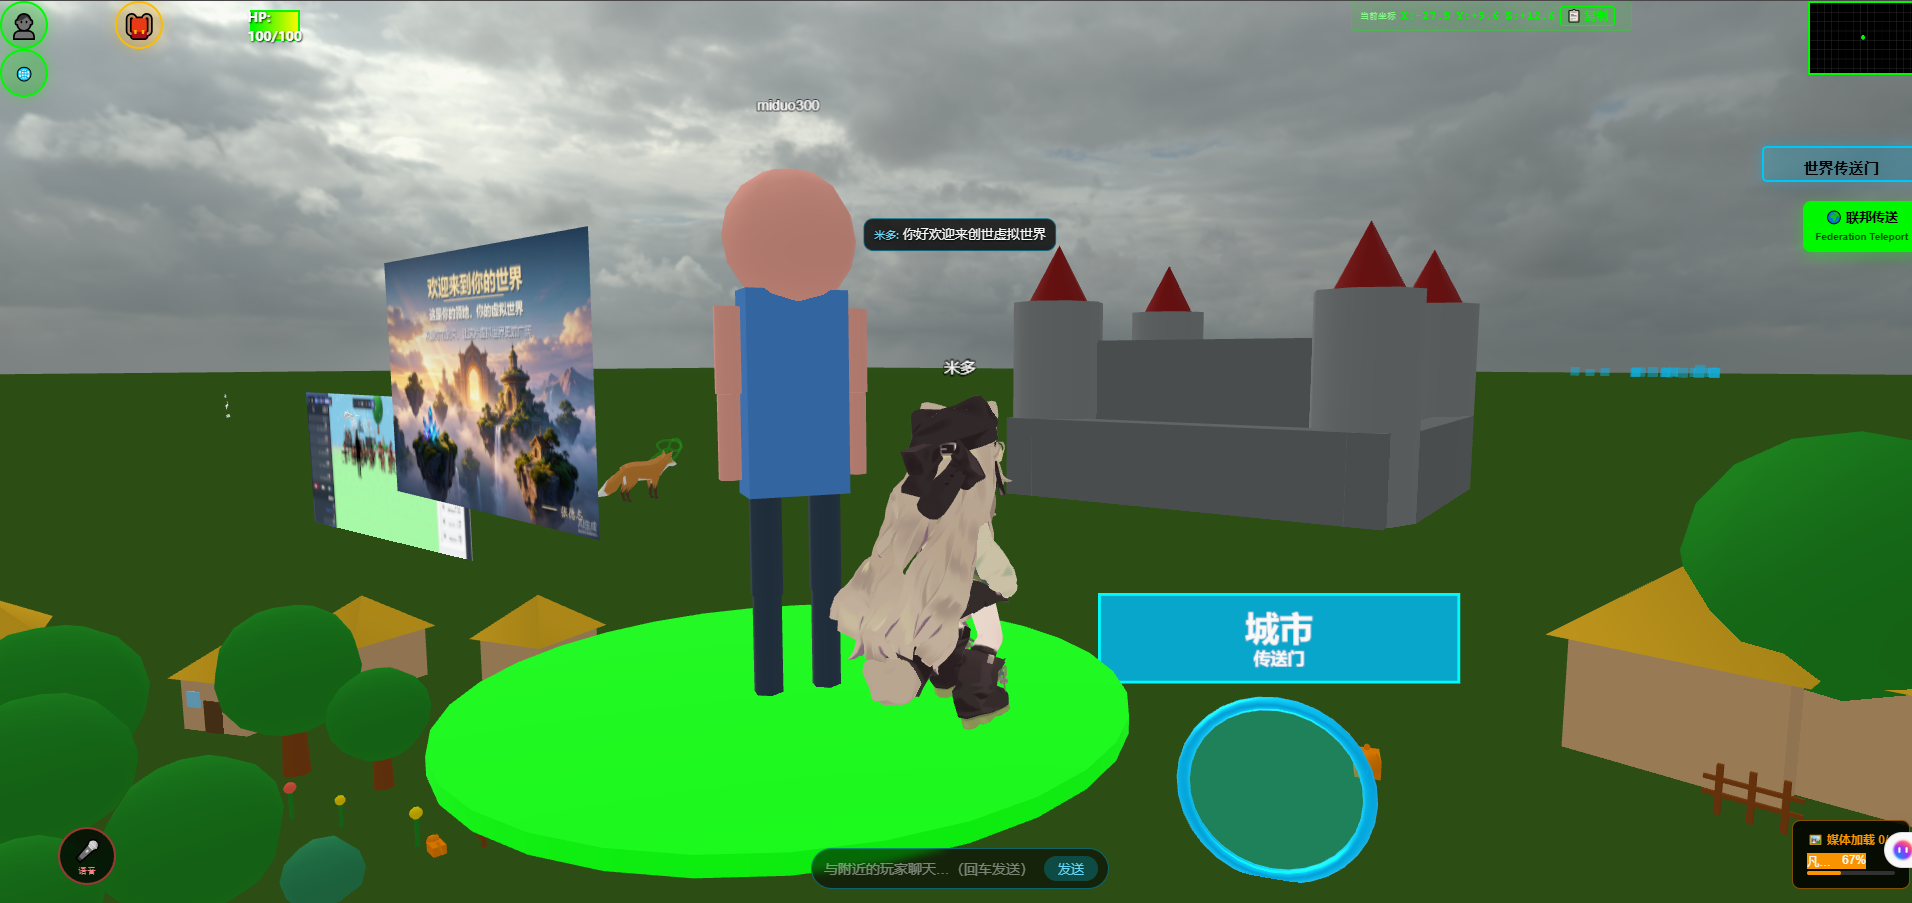
另一个更隐蔽的是灯:场景里点光源数量一变,所有材质都要重编译,而着色器反射在部分平台上同步且不可中断。实测一次灯数变化触发了 8989 毫秒的全场景冻结。
解法是灯池:固定 12 盏常驻,多的租、少还,灯数不变,重编译归零。
帧率从 60 掉到 20 是渐进的,这让验收更容易通过 ------"还行"在 20 fps 时也是真的。
D. 联机与断线:从"能连"到"掉线后还能看见我在动"
多人在线的难点不在连接,在异常。笔记本合盖、切后台标签页、网络抖动、对端刷新------这些场景下 WebSocket 断了,而不处理的话,服务端已经把这条连接当作在线。
做法是把在场状态做成一件事:缓存的PLAYER 消息在每次重连后自动重发,加无限重连、应用层 PING/PONG 看门狗,以及服务器未登记连接的告警。实测 9/9 场景下重连后对端仍能看到我移动。
近距离语音用半双工加同时说话人数名额制,实测 10 人约 1.3 Mbps、20 人约 2.6 Mbps------这是可以提前算进预算的。
这个问题的隐蔽之处在于它不在你测试时发生------你测试时网络是好的。
三、分层:把四类成本归零的边界
上面四类问题有个共同点:它们和你的业务无关。一个展厅和一套培训环境,在这些问题的解法上完全一样。所以把它们放在一起做完,所有上层场景共享。
我们把边界画成五层:
| 层 | 内容 | 谁负责 |
|---|---|---|
| 1 · 渲染与资产管线 | 正确颜色管线、去外部 CDN、资产分级、LOD、模型格式兼容 | 基座 |
| 2 · 性能与多端 | draw call 治理、预热预算、灯池、手机 / 平板 / PC / XR 输入适配 | 基座 |
| 3 · 实时通信与数据 | 多人同步、弱网自愈、账号与数据、资产管理、后台 | 基座 |
| 4 · AI 接入 | Agent 协议、感知与动作、权限与身份 | 基座 |
| 5 · 你的业务逻辑 | 这个世界里"什么东西能做什么"、"怎么算完成"、"访客看到什么文案" | 你 |
判据只有一条:第 1 到第 4 层里,没有一条是"因业务而异"的。 一旦某条需求要改动第 1 到第 3 层才能实现,那大概率说明分层需要重新看,而不是"把基座改一改"。
第五层长什么样:做设备展厅,第五层是产品数据、参观动线、权限规则;做培训环境,是课程流程和考核规则;做 AI 能活动的社区,是 AI 的人设和它要说的话。前三层的资产管线、性能治理、重连策略,一行都不用改。
四、"元宇宙"这个词,具体是哪些活
元宇宙不是一个技术清单,是几类具体工作的合称。拆开看,边界很清楚:
| 元宇宙里通常被说成什么 | 实际对应哪些活 | 谁负责 |
|---|---|---|
| "能进去" | 浏览器打开就能走、不用装客户端、可分享链接 | 基座 |
| "有空间" | 3D 场景、模型加载、资产分级、远近裁剪 | 基座 |
| "能一起玩" | 多人同步、移动与转向一致、掉线自动恢复、近距离语音 | 基座 |
| "能一直在线" | 账号与数据、资产管理、后台、不依赖第三方 | 基座 |
| "有内容" | 这个世界里放什么、访客能做什么、怎么算完成 | 你 |
| "有身份" | 角色身份:我是谁、别人怎么认出我、怎么持久化 | 你 |
| "有经济系统" | 虚拟资产、交易规则、结算逻辑 | 你 |
| "能跨世界" | 世界间互通、身份与资产怎么带过去 | 协议层有了,规则由你定 |
| "有 AI 角色" | AI 以人形进世界、有坐标、能被看见、能带路 | 基座 |
规律很清楚:元宇宙被宣传时最强调的往往是最上面那几行,而最花时间的是下面那几行。"有内容""有身份""经济系统"听起来最有想象力,实际上它们是业务逻辑,写起来快、也没有性能坑;反过来"能进去""有空间""能一直在线"这些听起来平淡的活,占了大半工期,还全都不会报错。
所以一个能复用的基底做的事,恰好是把下面那几行从你的待办里划掉。 你拿到的不是一个现成的世界,而是一块已经通电的地基。
边界要提前说清:跨世界做的是协议层 ------世界之间怎么握手、身份怎么迁移、同名怎么处理(实测 4/4 自动改名),规则层面仍然归你。经济系统的结算、内容审核我们完全没做,也不打算做。
五、标题里那句"事半功倍",具体便在哪一半
这句话很容易被读成广告,所以把"哪一半、哪不是哪一半"讲清楚。
省的那一半:地基。 第二节那四类问题是所有这类场景都要重走一遍的活,而且都不报错。走一遍已经走过的人,省下的不是某几行代码,而是那几类问题的排查时间------而排查时间往往比写代码长得多,因为没有报错可查。
没省的那一半:业务逻辑一点没少。 第五层该你写还是你写,一个字段都不会因为有基底而少写。任何"有了基底就不用做业务了"的说法都是错的。
还有一层必须说清楚,否则这个判断会被用错:省下来的是"第二阶段",不是"第一阶段"。 从零造到能跑起来的那一下午,有基底也一样要写------基底不替你写第一行代码。它省的是"能跑"之后那段没有终点的工作。
所以这里不给任何时间倍数。 要估的是:你的场景里,那四类问题各占多少工时。说得出数字,才知道哪些该自己写、哪些该拿现成的------这份清单同时也是验收清单。
六、这个决定在什么情况下是错的
只讲好处的文章可信度反而低。下面几种情况,自己造是对的:
- 你的场景只有一个静态页面,且不需要联机和实时数据。 一个模型加一个网页就够了。
- 你要学的正是这些机制本身。 如果目标就是搞懂 LOD 和 draw call 治理怎么工作,从零写一遍是最有效的学习方式,买现成的反而学不到。
- 你的约束是极低的运行环境(比如要跑在没有 WebGL2 的老设备上)。通用方案不一定塞得进去,需要自己裁剪。
- 你的产品形态就是一次性交付。 基座的价值在第三个月------第一天省的是启动时间,第三个月省的是新加客户端、换资产格式、接新能力、扛规模。如果世界做完就下线,第五层之外的投入收不回来。
判断方法:①你的场景里第五层之外的活占多少?占比越高越划算。②你有没有能力判断它做得好不好?如果团队没人做过性能治理,写完了也看不出问题。③第三个月会发生什么变化?会换设备、加客户端、接新能力、扛规模------会就用基座。
七、容易想错的三件事
一、"先做个能跑的,以后再优化性能"通常不成立。 因为四类性能问题都不报错,它们不会出现在你的待办清单里。等到用户反馈"看着糙"的时候,改动成本已经很高了------那不是优化,是返工。
二、"我上了 CDN 所以加载没问题了"是个误判。 外部 CDN 确实能让首屏变快,代价是内网和离线环境打不开、版本可能被漂移、长期账单不可控。把 importmap 改指本地、加载器本地化或 stub 化之后,离线和内网都能跑------这是另一种解法,不是同一种解法的更好版本。
三、"砍场景来救帧率"不叫治理。 帧率不够就删模型,是把成本从技术问题挪成了产品问题。性能问题有治理路径(合批、灯池、预热预算),删内容只是把账欠着。
常见问题
问:拿现成的基座会不会被限制住?
答:会,但这正是分层设计的意义。第 1 到第 4 层你可以一行不改;业务逻辑在第 5 层,随便改。真正会被限制的是"我非要改渲染管线"------那种需求本来就该先确认自己是不是真的需要。
问:这些数字是某个场景的,能套到我这儿吗?
答:不能。上面所有实测值都来自我们自己的项目和场景。能复用的是那张分层表和那四类问题,不是这些数字------你的场景要自己测一遍。
问:只有静态展示的项目适合用吗?
答:不适合,也不需要。它适合的是需要联机、需要自部署、需要 AI 参与的那类场景。
问:AI 那层现在能用到什么程度?
答:能感知(雷达式结构化观测)、能移动和说话带路、能被真人看见、能被后台管理。做不到的是:看不见画面、不做语音识别与合成、不托管知识库、不做地形贴合。这些边界需要提前知道,因为它们决定哪些想法不能靠 AI 完成。
写在最后
从零写 3D 世界,真正的工作量不在渲染,而在把上面四类"不会报错"的问题一个个解决掉。把这四类成本一次做完、业务逻辑留在自己手里,是这个分层设计的全部动机。
上面这些机制与边界,全部来自我们自己项目的真实实现------创世Genesis(即创世虚拟世界CRM系统),一套浏览器端、可部署在自有服务器上的 3D 虚拟世界基底,文中数字都出自项目内可重跑的验收脚本。
如果你也在评估"从零造"还是"拿一套基底",希望那份五层表和四类问题清单能帮你少走一段弯路。
本文为开发过程中的技术复盘,数据来自项目内验收脚本,可复跑核验。文中列出的机制均为当前实现的如实描述,不作为后续承诺。