对于这个算法,需要掌握三大核心机制:(1)快速非支配排序(Fast Non-dominated Sorting) (2)拥挤度距离(Crowding Distance) (3) 精英保留策略(Elitism)
原始论文:Deb et al., 2002, A Fast and Elitist Multiobjective Genetic Algorithm: NSGA-II
算法主要流程:
python
1. 初始化种群 P0(规模 N),随机生成
2. 对 P0 进行非支配排序和拥挤度计算
3. 选择、交叉、变异 → 生成子代 Q0
4. 循环直到满足终止条件:
   a. 合并 Rt = Pt ∪ Qt
   b. 对 Rt 快速非支配排序
   c. 逐层选择,最后一层用拥挤度筛选
   d. 得到新父代 Pt+1
   e. 对 Pt+1 选择、交叉、变异 → Qt+1
5. 输出 Pareto 前沿解集
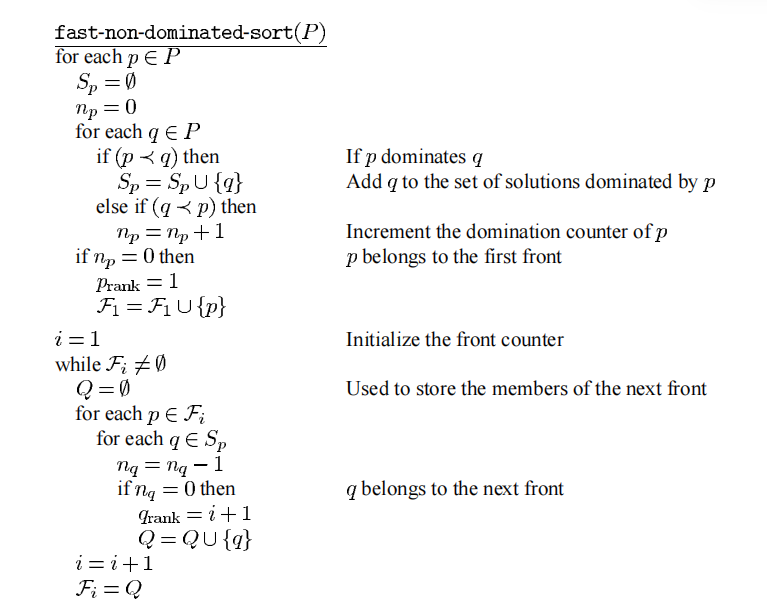
一、快速非支配解排序
将种群分层。第一层是完全不被支配的解,第二层是去掉第一层后不被支配的解,依此类推。
要点:支配判断是"所有目标不劣,且至少一个严格更优"。
这里的复杂度是O(MN^2),用空间换时间,原本的NSGA复杂度为O(MN^3),两两比较的复杂度是O(MN^2),然后每次选完一层又要重新比较一次,最坏的结果是每层只有一个,这样的话复杂度就是 O(MN^3),重复计算带来的复杂度,可以把重复计算的结果记录下来,这样能够降低复杂度。相当于是用了一个列表来维护信息。
Deb 教授引入了两个关键的"列表(空间)"来记录信息,避免重复比较:
-
列表 1:np(被支配计数)。记录个体 p 被多少个其他个体支配。
-
列表 2:Sp(支配集合)。记录个体 p 支配了哪些其他个体。
优化后的流程(只扫描一遍两两比较):
-
初始化:所有个体的 np=0,Sp=∅。
-
两两比较(仅此一次):遍历所有个体对 (p,q)。
-
如果 p 支配 q:把 q 加入 Sp(记录在列表里),并且 q 的被支配计数 nq += 1。
-
如果 q 支配 p:把 p 加入 Sq,并且 np+=1。
-
这一步只做了
次比较,每次比较 M 个目标。总复杂度:O(MN^2)。
-
-
找第 1 层:遍历所有个体,凡是 np==0 的,就是第 1 层。
-
找第 2 层(利用列表,无需重新比较!):
-
遍历第 1 层中的每个个体 p。
-
查看 p 的支配列表 Sp。对于 Sp 中的每个个体 q,执行 nq−=1(因为支配 q 的 p 已经被移除了)。
-
如果 nq 减到了 0,说明 q 现在没人支配了,把 q 放入第 2 层。
-
-
继续:重复步骤 4,直到所有层划分完毕。
python
def fast_non_dominated_sort(self, obj):
    N = obj.shape[0]
    S = [[] for _ in range(N)]      # 每个解支配的解
    n = np.zeros(N, dtype=int)      # 被支配次数
    fronts = [[]]                   # 第一层

    for p in range(N):
        for q in range(N):
            if p == q:
                continue
            # p 支配 q ?
            if np.all(obj[p] <= obj[q]) and np.any(obj[p] < obj[q]):
                S[p].append(q)
            elif np.all(obj[q] <= obj[p]) and np.any(obj[q] < obj[p]):
                n[p] += 1
        if n[p] == 0:
            fronts[0].append(p)

    # 逐层构造
    i = 0
    while fronts[i]:
        next_front = []
        for p in fronts[i]:
            for q in S[p]:
                n[q] -= 1
                if n[q] == 0:
                    next_front.append(q)
        i += 1
        fronts.append(next_front)

    fronts.pop()  # 去掉最后的空层
    return fronts
二、 拥挤度距离
易错点:归一化分母用该目标在当前层内的极差,边界解必须设为无穷大。
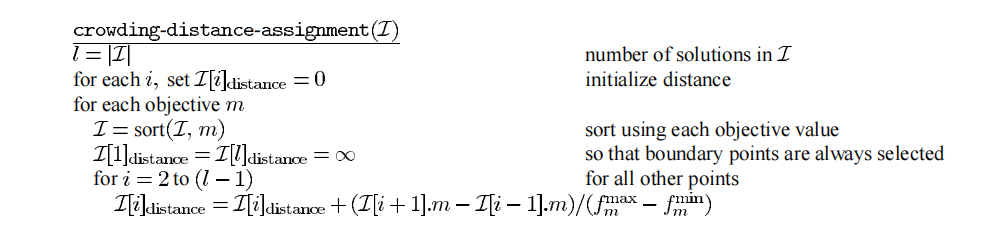
python
def crowding_distance(self, obj, front):
    l = len(front)
    distance = np.zeros(l)
    if l == 0:
        return distance
    if l <= 2:
        distance[:] = np.inf
        return distance

    obj_front = obj[front]          # (l, n_obj)
    n_obj = obj_front.shape[1]

    for m in range(n_obj):
        idx = np.argsort(obj_front[:, m])
        distance[idx[0]] = np.inf
        distance[idx[-1]] = np.inf

        f_min = obj_front[idx[0], m]
        f_max = obj_front[idx[-1], m]
        if f_max - f_min == 0:
            continue
        for k in range(1, l - 1):
            distance[idx[k]] += (
                obj_front[idx[k + 1], m] - obj_front[idx[k - 1], m]
            ) / (f_max - f_min)
    return distance
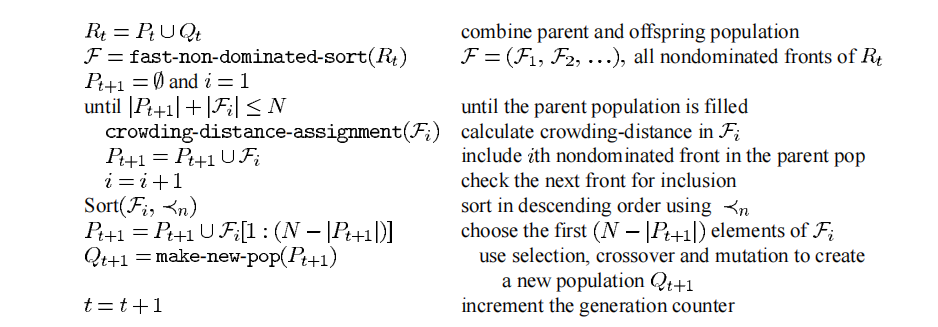
三、精英保留
合并父代子代后,逐层选入,最后一层按拥挤度排序。
python
def environmental_selection(self, merged_obj):
    fronts = self.fast_non_dominated_sort(merged_obj)
    new_pop_idx = []
    for front in fronts:
        if len(new_pop_idx) + len(front) <= self.pop_size:
            new_pop_idx.extend(front)
        else:
            # 这一层放不下,按拥挤度选
            cd = self.crowding_distance(merged_obj, front)
            sorted_idx = np.argsort(-cd)   # 降序
            remain = self.pop_size - len(new_pop_idx)
            new_pop_idx.extend([front[i] for i in sorted_idx[:remain]])
            break
    return np.array(new_pop_idx)