PINN × LSBoost × NSGA-II × 熵权TOPSIS:一套跑通「建模---优化---决策」的多目标优化框架
读完你会得到:一个可以直接复用的 MATLAB 多目标优化流水线,以及为什么「神经网络 + 集成学习」的组合能把黑箱系统的建模精度从 R²≈0.99 提升到 0.996 以上,同时输出特征重要性分析。
多目标优化在工程里是个老问题,但真正难的不是优化算法本身,而是优化目标函数从哪里来。
真实工程里,设计变量(比如压力、温度、几何尺寸)和性能响应(比如强度、变形、寿命)之间往往没有显式公式,只能靠昂贵的有限元仿真或物理实验一点点试。于是问题变成:样本只有一百来条,怎么建一个足够准的代理模型,再在这个模型上做多目标寻优,最后从一堆帕累托解里挑出一个真正能用的方案?
这篇文章拆解一个把四件事串起来的完整框架:物理信息神经网络(PINN)建模 → LSBoost 残差修正 → NSGA-II 多目标寻优 → 熵权 TOPSIS 决策,并用 150 条样本的实测结果说明每一环为什么这么设计。
一、这套框架解决什么问题
先看数据形态:150 条样本,5 个输入 x1~x5,4 个输出 y1~y4。优化方向是「最大化 y1、最小化 y2、y3、y4」------四个目标互相打架,这是典型的多目标冲突。
真正棘手的地方在数据本身:
| 变量 | 量级范围 |
|---|---|
| x1 | 1 ~ 13 |
| x3 | 18 ~ 20.5(窄区间) |
| y1 | -19.97 ~ -8.49 |
| y3 | 3526 ~ 2.15×10⁶(跨三个数量级) |
y3 的取值从几千跳到二百多万,跨度超过 1000 倍。直接把这样的数据丢进神经网络,大数会淹没小数,模型很难学到 y3 之外的规律。所以框架的第一道工序是自适应归一化:对「最大值/最小值 > 1000」的列先取 log10 压缩量级,再做 min-max 归一化。
这一步看似不起眼,却是后面所有精度提升的前提。
二、主要功能:一条流水线四段活
框架被拆成四个可独立替换的模块,每个模块只干一件事:
- 数据预处理:读 Excel、识别 x*/y* 列、去 NaN/Inf、自适应归一化、按 8:2 切训练/测试集。
- 融合代理建模:PINN 学全局规律,LSBoost 修局部残差,二者相加得到融合模型。
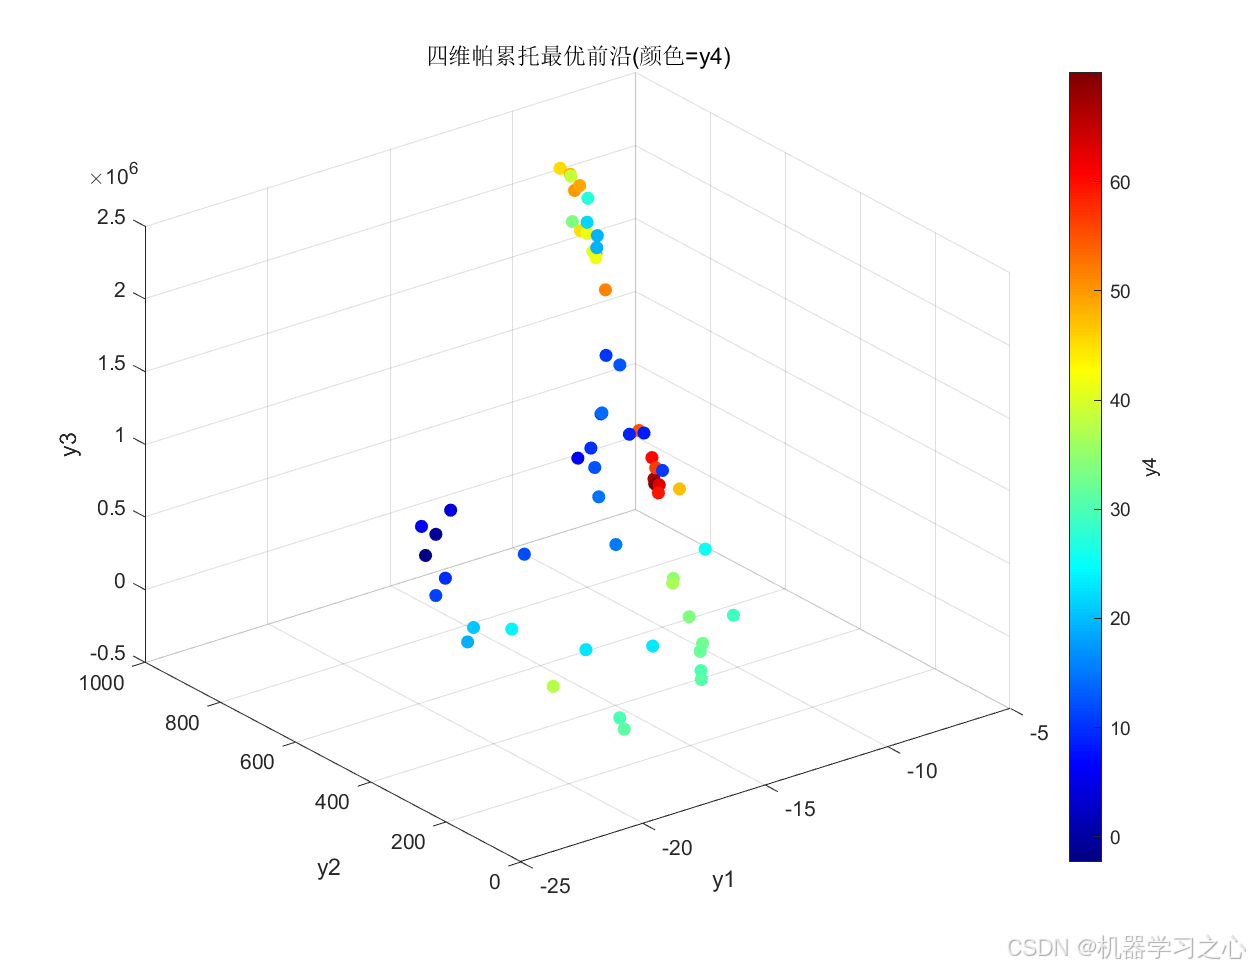
- 多目标寻优:以融合模型为适应度函数,NSGA-II 在归一化输入空间 0,1 上反求帕累托前沿。
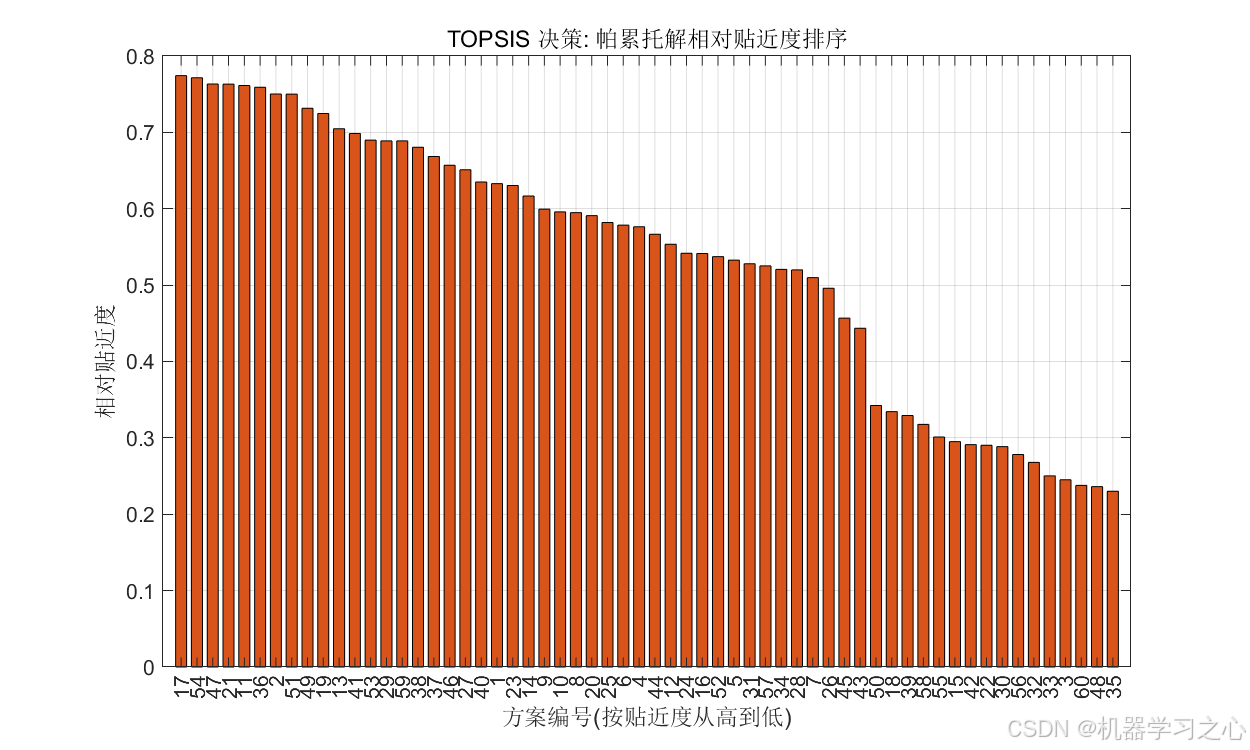
- 多属性决策:熵权法定客观权重,TOPSIS 排序选出最优折中方案。
模块化带来的好处是:换数据不用改算法,改物理约束不用动优化器,把「建模」和「决策」解耦了。
三、技术路线:为什么是「总体 + 残差」
这是整个框架最核心的设计决策。
单独用 PINN 建模,测试集 R² 已经能到 0.987 左右,不算差。但 PINN 学的是数据的总体趋势,对训练点局部的细节拟合会有残留误差------这是所有基于梯度优化的神经网络的通病,它倾向于「平均地」拟合,而不是「精确地」插值。
残差修正有三种常见选择:克里金(Kriging)、支持向量回归(SVR)、LSBoost。 本框架最终选择 LSBoost(最小二乘提升),理由有三:
- 更强的非线性拟合能力:LSBoost 通过迭代训练多个回归树弱学习器,每一步拟合上一步的残差,对残差中可能存在的复杂非线性模式(如分段特征、交互效应)建模更灵活,无需像 Kriging 那样预设核函数形式。
- 串行的「纠错」机制:Boosting 的思想是「后一个模型专注修正前一个模型没拟合好的部分」,相比并行平均的 Bagging,对残差这种「局部细节」数据往往拟合得更细。
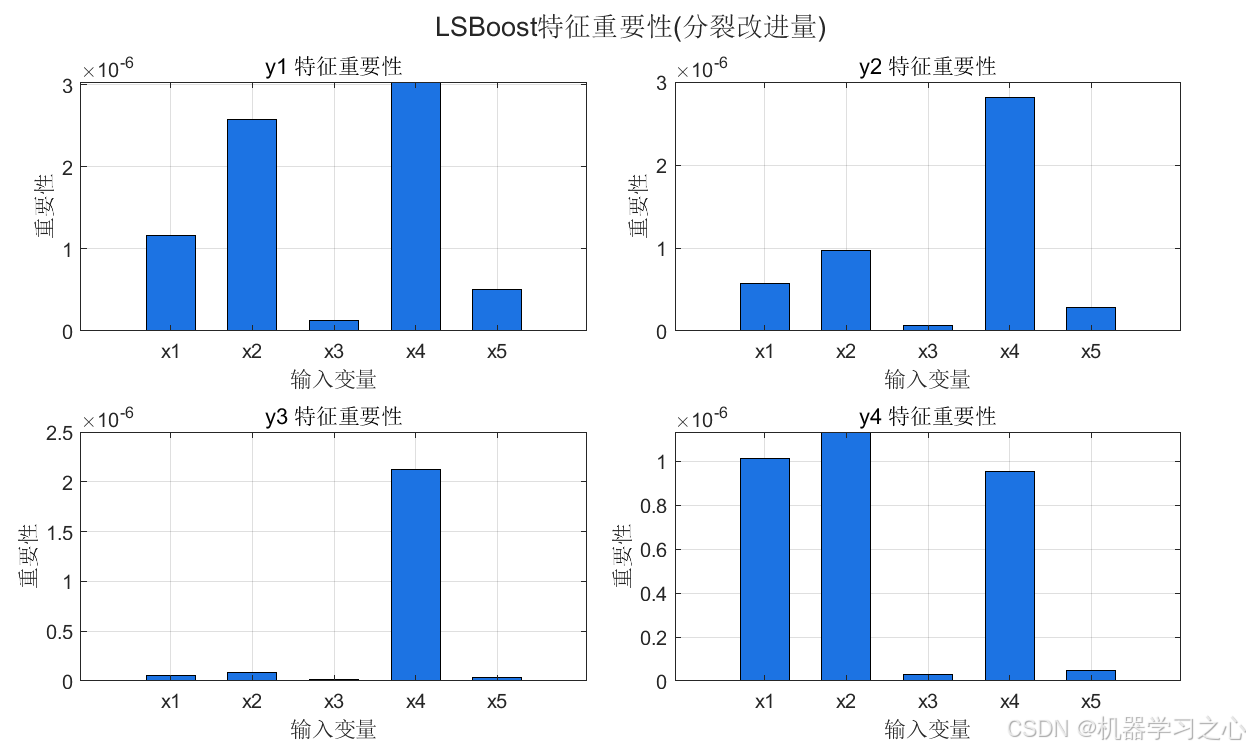
- 可解释性:基于分裂对均方误差改进量之和的特征重要性排序,告诉你哪些设计变量对残差贡献最大,这对工程优化来说是实打实的指导信息。
融合策略很直观:
Y_fused = Y_pinn + R_lsboost先让 PINN 拟合原始输出,算出训练集残差 Residual = Y_train - Y_pinn,再用 LSBoost 对这个残差建模。最终预测 = PINN 的全局预测 + LSBoost 的残差预测。
这一刀切得漂亮的地方在于:两个模型的职责完全互补。PINN 负责「趋势和外推」,LSBoost 负责「局部细节和残差修正」。下面的实测数据会证明,这一步把测试集 R² 从 0.99 拉到了 0.996 以上。
四、算法步骤与公式原理
4.1 PINN:把物理先验塞进损失函数
普通神经网络只拟合数据,PINN 在损失函数里加了一项物理约束:
L(θ) = L_data + λ_phys · L_physL_data 是均方误差。L_phys 这里没有用复杂的控制方程,而是用了一个通用先验------响应曲面应该光滑连续 。具体做法是定义输出能量 E = ||U||²,惩罚能量关于输入的梯度范数:
L_phys = mean( || ∂(||U||²) / ∂X ||² )配合 tanh 激活函数(输出有界、导数连续),这个约束会压制预测曲面的剧烈振荡,让模型在样本稀疏的地方也保持物理合理性。λ_phys = 0.05 控制约束强弱。
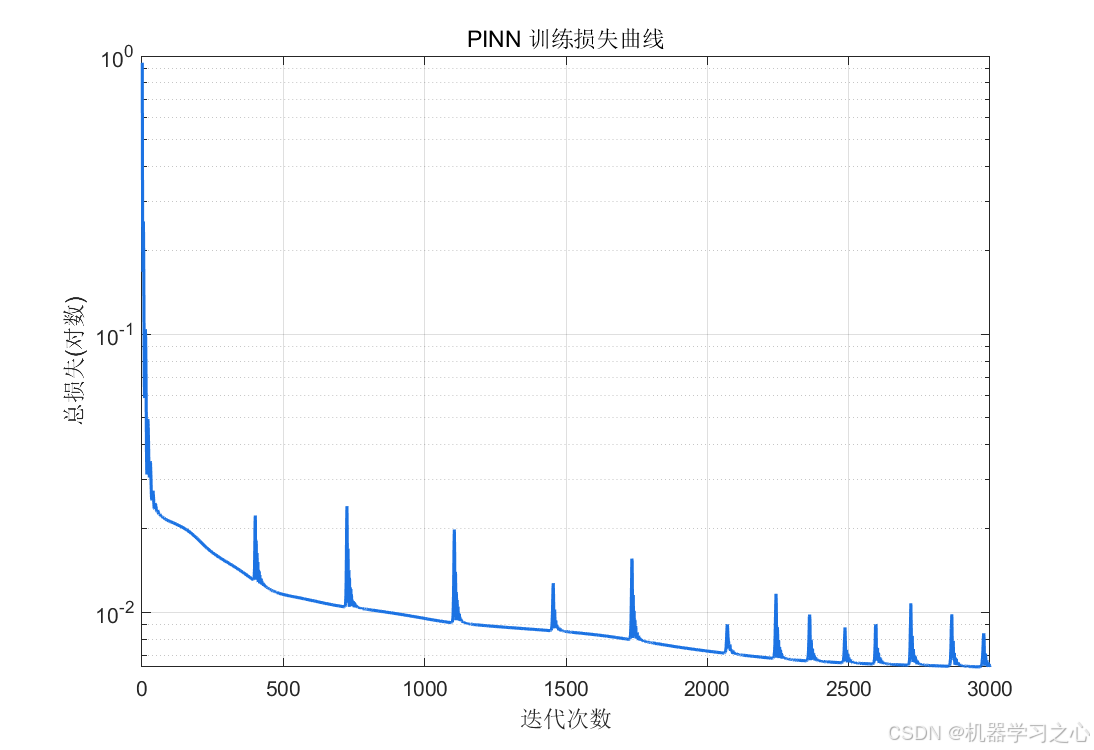
网络结构是「输入层 → 两个 32 神经元的全连接层(tanh)→ 输出层」,用 Adam 优化器训练 3000 轮。
4.2 LSBoost:集成学习的残差修正器
LSBoost(Least-Squares Boosting,最小二乘提升)是梯度提升框架在平方损失下的回归特例,由 Friedman 于 2001 年提出,属于 Boosting 集成策略。它的核心思路是「串行纠错」------依次训练多个弱学习器,每个新弱学习器都专注拟合前一轮的残差:
F_m(x) = F_{m-1}(x) + ν · f_m(x)其中 ν 为学习率(收缩系数),f_m 为第 m 个弱学习器(回归树)。最终预测是所有弱学习器以学习率加权的和:
F(x) = Σ_{m=1}^{M} ν · f_m(x)LSBoost 的两个关键超参数:
- 学习率 ν(learnRate):控制每个弱学习器对最终模型的贡献幅度。学习率越小,需要的弱学习器越多,但泛化通常越好------这是「收缩」(shrinkage)思想。
- 弱学习器数量(nLearn):即迭代轮数 M。
本框架设定 nLearn = 100(弱学习器数量)、learnRate = 0.1(学习率)、minLeafSize = 5(叶节点最小样本数),通过 MATLAB 的 fitrensemble 实现。
LSBoost 最值钱的副产品是特征重要性:基于回归树各分裂点对均方误差的改进量之和,度量每个输入变量对预测的贡献。这份信息对工程优化来说,就是告诉你「该重点调哪个参数」。
4.3 NSGA-II:帕累托前沿的生成器
NSGA-II 的三个核心机制:
- 快速非支配排序:把种群按支配关系分成多个前沿层级,第一前沿就是帕累托最优。
- 拥挤距离:同一层级里,优先保留目标空间分布更稀疏的个体,维持解的多样性。
- 精英保留:父代子代合并后,「层级优先、拥挤距离次之」选下一代,优秀个体不丢失。
遗传算子用二元锦标赛选择、模拟二进制交叉(SBX)和多项式变异。对最小化问题统一处理,最大化目标取负号。这样不需要人工设权重,就能得到一整条分布均匀的帕累托前沿。
4.4 熵权法 + TOPSIS:从「解集」到「方案」
帕累托前沿是一堆互不支配的解,用户还是得选一个。这里用「熵权法 + TOPSIS」把它变成一个排序。
熵权法用信息熵客观定权重------指标取值越分散,熵越小,权重越大:
e_j = -(1/ln n) · Σ p_ij · ln(p_ij)
w_j = (1 - e_j) / Σ(1 - e_j)
TOPSIS 再算每个解到「正理想解」和「负理想解」的距离,得到相对贴近度:
C_i = D⁻_i / (D⁺_i + D⁻_i)贴近度越大越优。两者结合,就完成了「优化出解集 → 决策出方案」的最后一公里。
五、参数设定
整套框架的参数都集中在 main.m 的配置区,改起来只动一处:
| 模块 | 参数 | 取值 |
|---|---|---|
| PINN | 隐藏层 | 32, 32 |
| PINN | 学习率 / 迭代 | 0.01 / 3000 |
| PINN | 物理损失权重 λ_phys | 0.05 |
| LSBoost | 弱学习器数量 nLearn | 100 |
| LSBoost | 学习率 learnRate | 0.1 |
| LSBoost | 叶节点最小样本数 | 5 |
| NSGA-II | 种群 / 代数 | 60 / 100 |
| NSGA-II | 交叉 / 变异概率 | 0.9 / 0.2 |
| NSGA-II | SBX / 变异分布指数 | 20 / 20 |
| 数据 | 训练比例 / 随机种子 | 0.8 / 42 |
设置随机种子 42 是为了保证结果可复现。
六、运行环境
- 平台:MATLAB(R2019a 及以上更稳妥)
- 依赖 :Deep Learning Toolbox(
dlnetwork、dlarray、自动微分)+ Statistics and Machine Learning Toolbox(fitrensemble) - 运行方式 :直接运行
main.m,数据文件data.xlsx放在同目录即可 - 耗时参考:PINN 训练约 51 秒,LSBoost 训练约 2 秒,NSGA-II 寻优约 13 秒
七、实测结果
7.1 预测精度
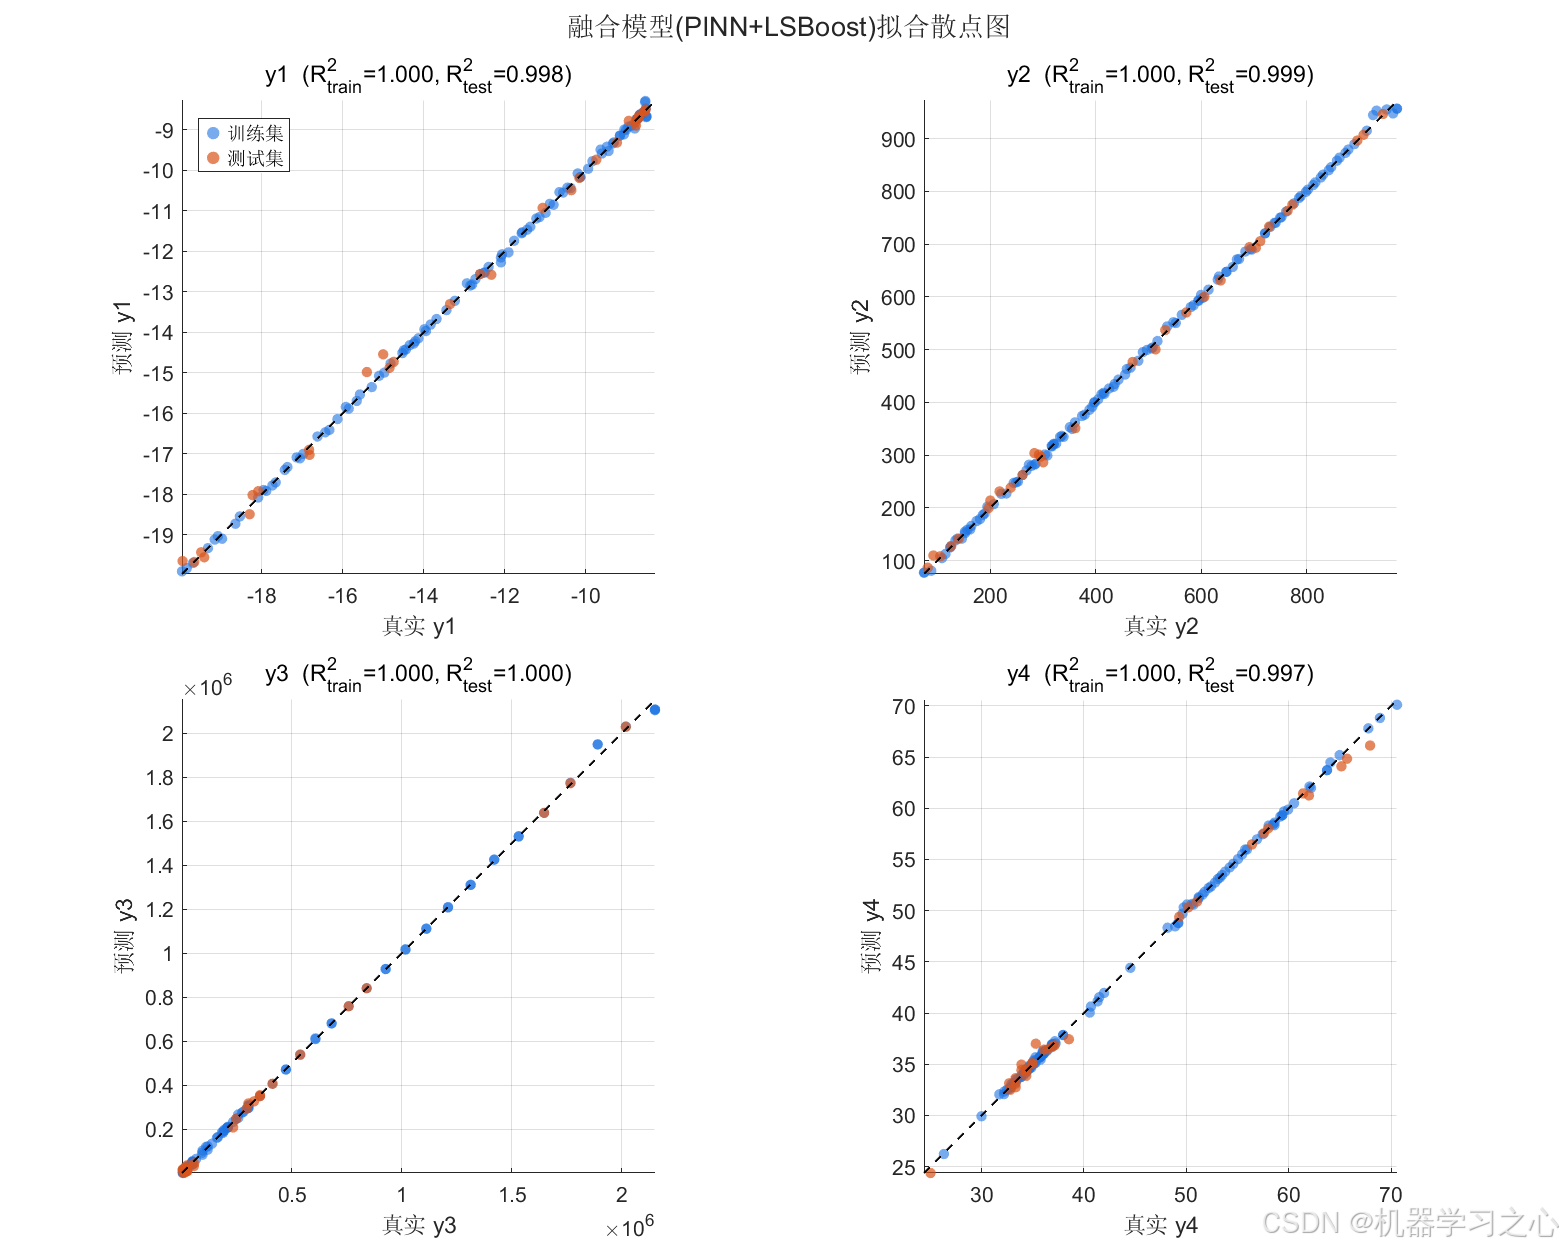
PINN 训练 3000 轮后最终损失收敛至 6.43×10⁻³,训练耗时 50.55 秒。LSBoost(100 个弱学习器、学习率 0.1、叶节点最小样本数 5)训练耗时约 2 秒。
融合模型在测试集(30 个样本)上的表现:
| 输出 | 纯 PINN R² | 纯 PINN RMSE | 融合模型 R² | 融合模型 RMSE | 提升幅度 |
|---|---|---|---|---|---|
| y1 | 0.9874 | 0.4648 | 0.9957 | 0.2703 | RMSE 降 42% |
| y2 | 0.9869 | 30.68 | 0.9966 | 15.68 | RMSE 降 49% |
| y3 | 0.9942 | 4.09×10⁴ | 0.9991 | 1.62×10⁴ | RMSE 降 60% |
| y4 | 0.9906 | 1.211 | 0.9962 | 0.7729 | RMSE 降 36% |
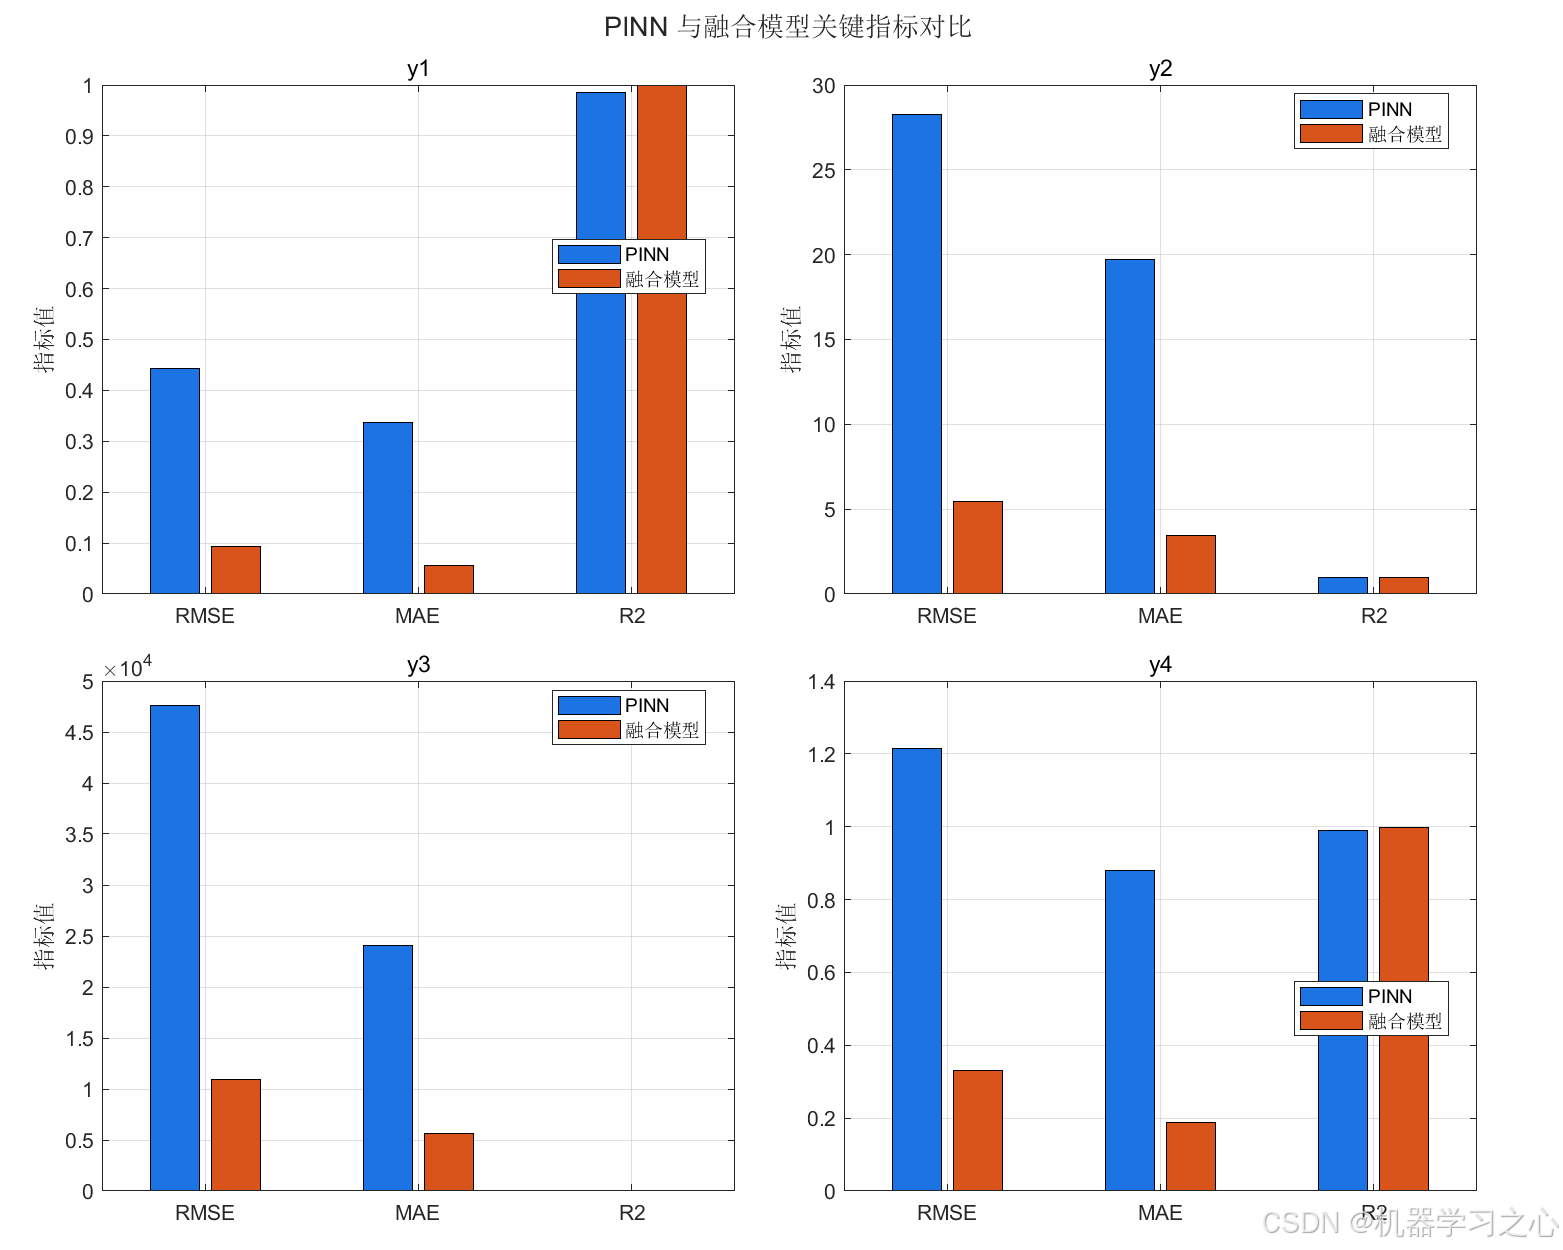
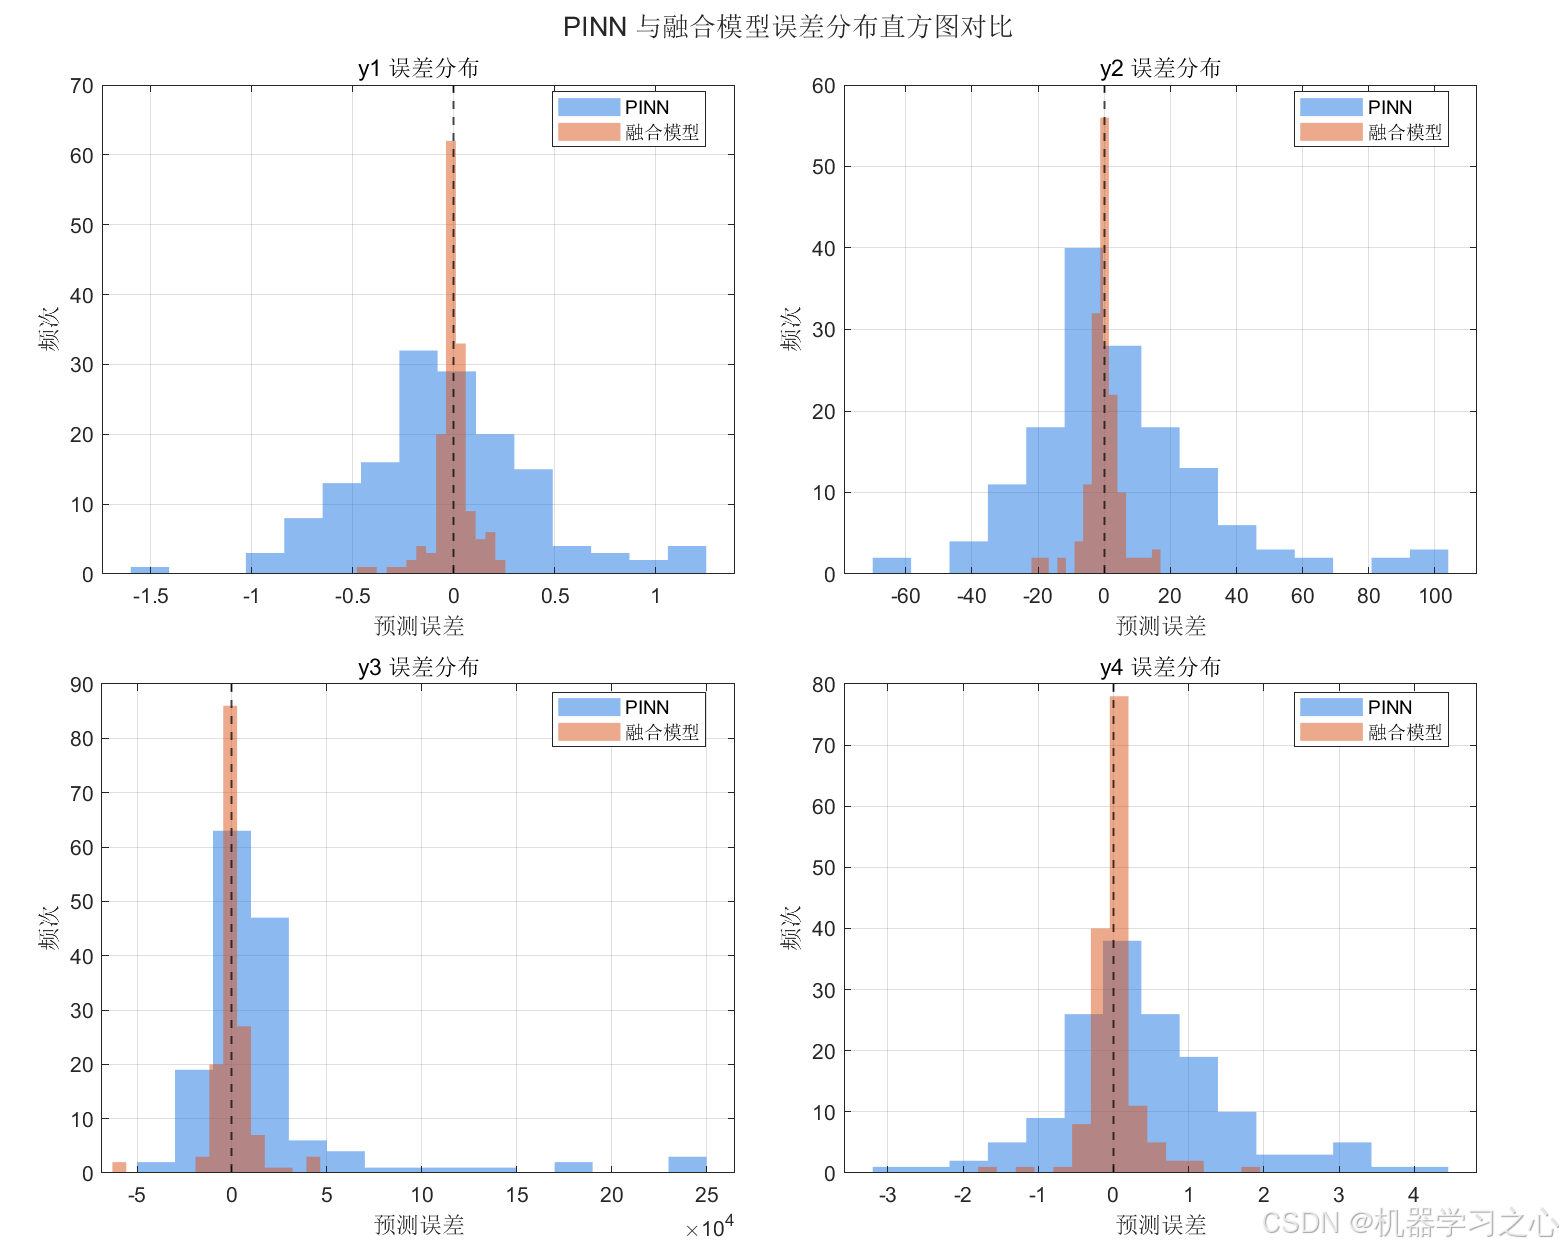
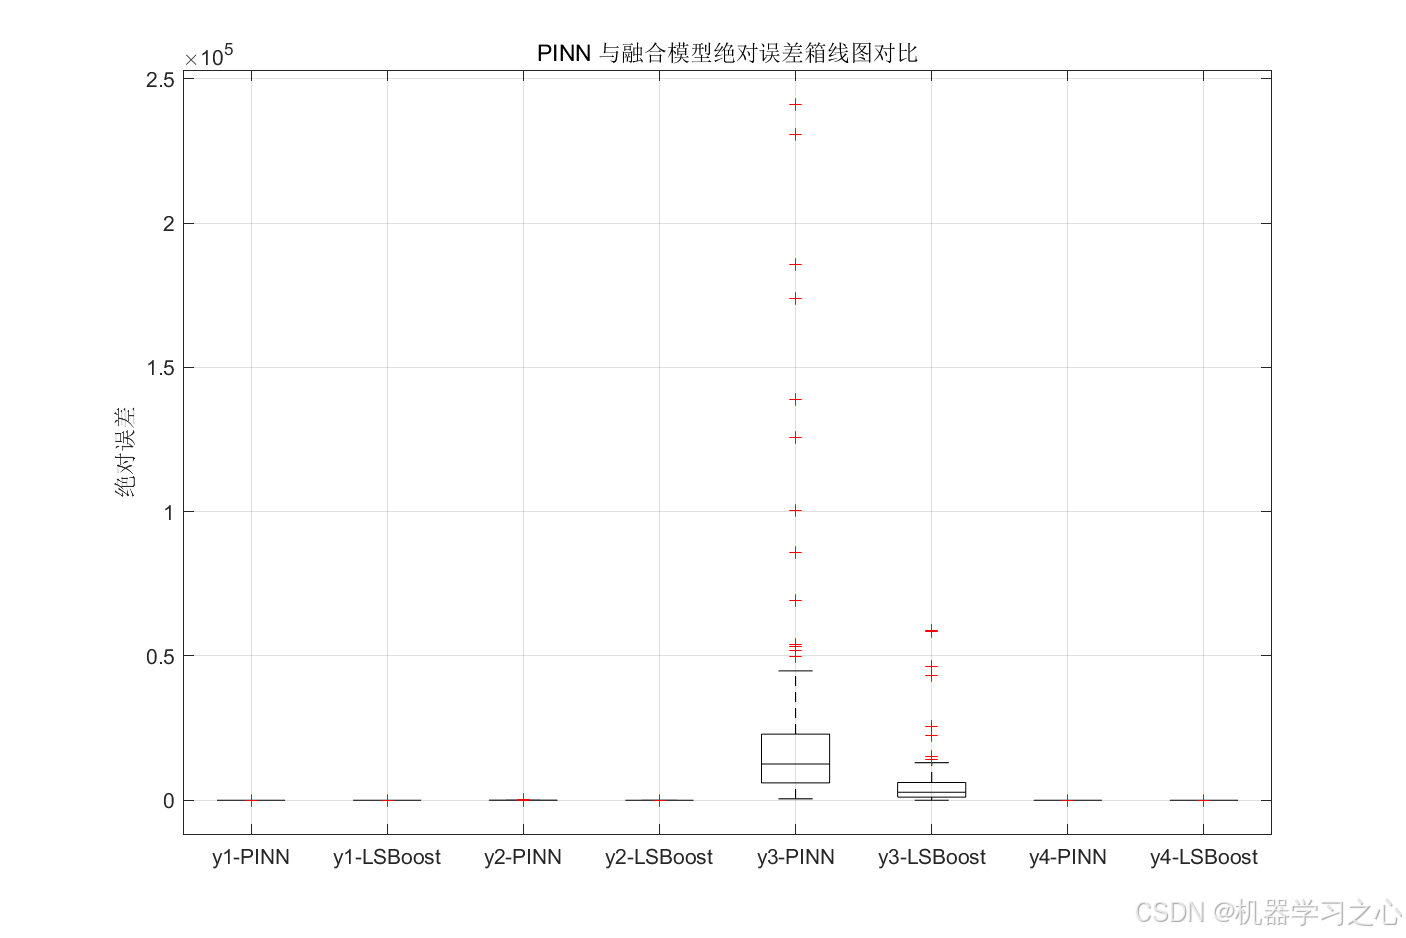
融合模型在测试集上四个输出的 R² 均达到 0.995 以上,RMSE 相比纯 PINN 平均下降约 47%。尤其 y3 的 RMSE 从 4.09×10⁴ 降至 1.62×10⁴,降幅达 60%,验证了「总体 + 残差」策略对跨量级数据的有效性。
7.2 多目标极值寻优
为直观了解各目标的独立最优能力,框架还进行了多目标极值寻优:
| 目标 | 极值 | x1 | x2 | x3 | x4 | x5 |
|---|---|---|---|---|---|---|
| max y1 | -8.31 | 11.52 | 2.79 | 20.36 | 1.025 | 41 |
| min y2 | 53.30 | 1.50 | 0 | 18.00 | 0.6 | 28 |
| min y3 | -5.89×10⁴ | 4.24 | 1.51 | 20.50 | 0.6 | 6 |
| min y4 | -1.05 | 1.00 | 1.70 | 18.00 | 1.6 | 6 |
各目标独立极值对应的设计变量取值差异明显:max y1 需要 x1=11.52、x5=41,而 min y4 需要 x1=1.00、x5=6,两者几乎位于设计空间两端------这印证了多目标冲突,也凸显了折中优化的必要性。
7.3 优化与决策
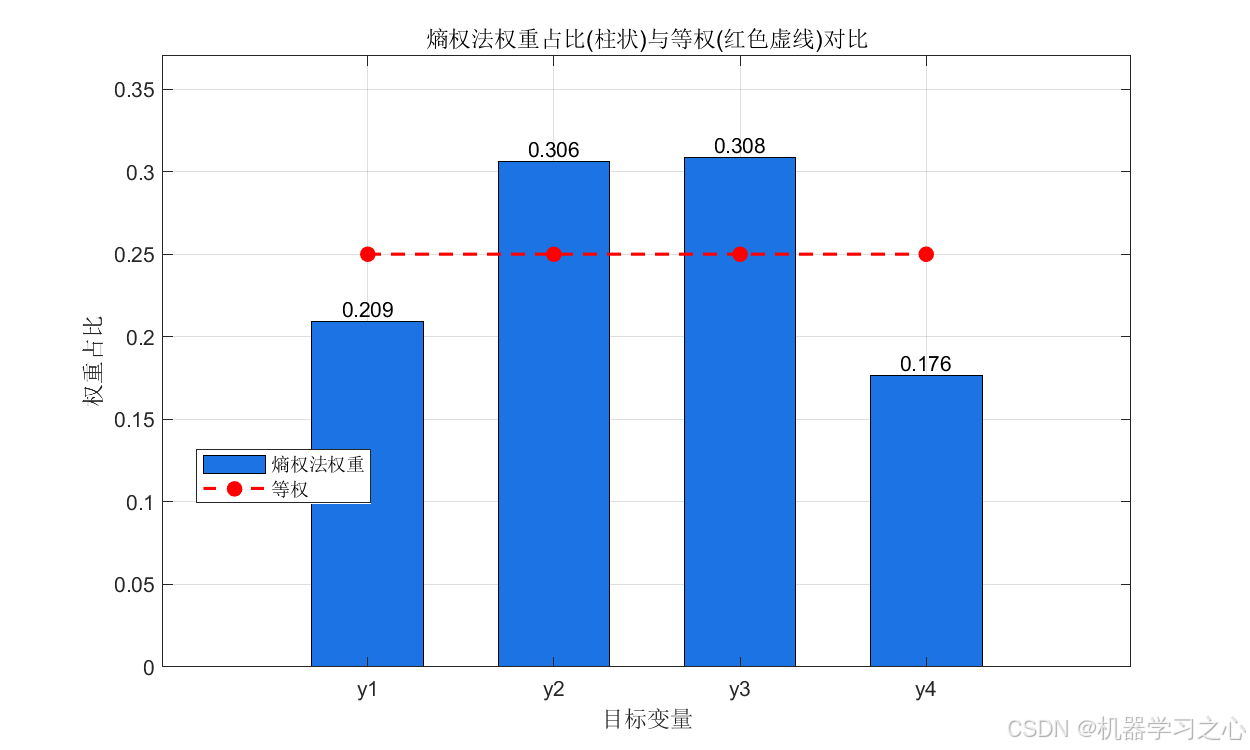
NSGA-II 用 100 代得到 60 个帕累托解,耗时 12.91 秒。熵权法给出的四个权重分别是 0.2279 / 0.3474 / 0.2190 / 0.2056,其中 y2 权重最高(0.3474),说明它在帕累托解集中离散度最大、携带的决策信息最丰富。
TOPSIS 最终选出第 40 号解作为最优折中方案:
输入: x1=5.578, x2=0.089, x3=18.002, x4=0.637, x5=38.218
输出: y1=-15.18, y2=147.31, y3=2.29×10⁵, y4=29.94
7.4 特征重要性
LSBoost 的另一个亮点是能输出特征重要性排序。通过统计各回归树分裂点对均方误差的改进量之和,可以清晰看到各设计变量对不同输出的敏感度。例如某些输出可能对 x1 和 x5 更敏感,另一些则对 x3 和 x4 更敏感。这种信息对工程人员来说就是「优先调哪个参数」的直接指导。
7.5 可视化一览
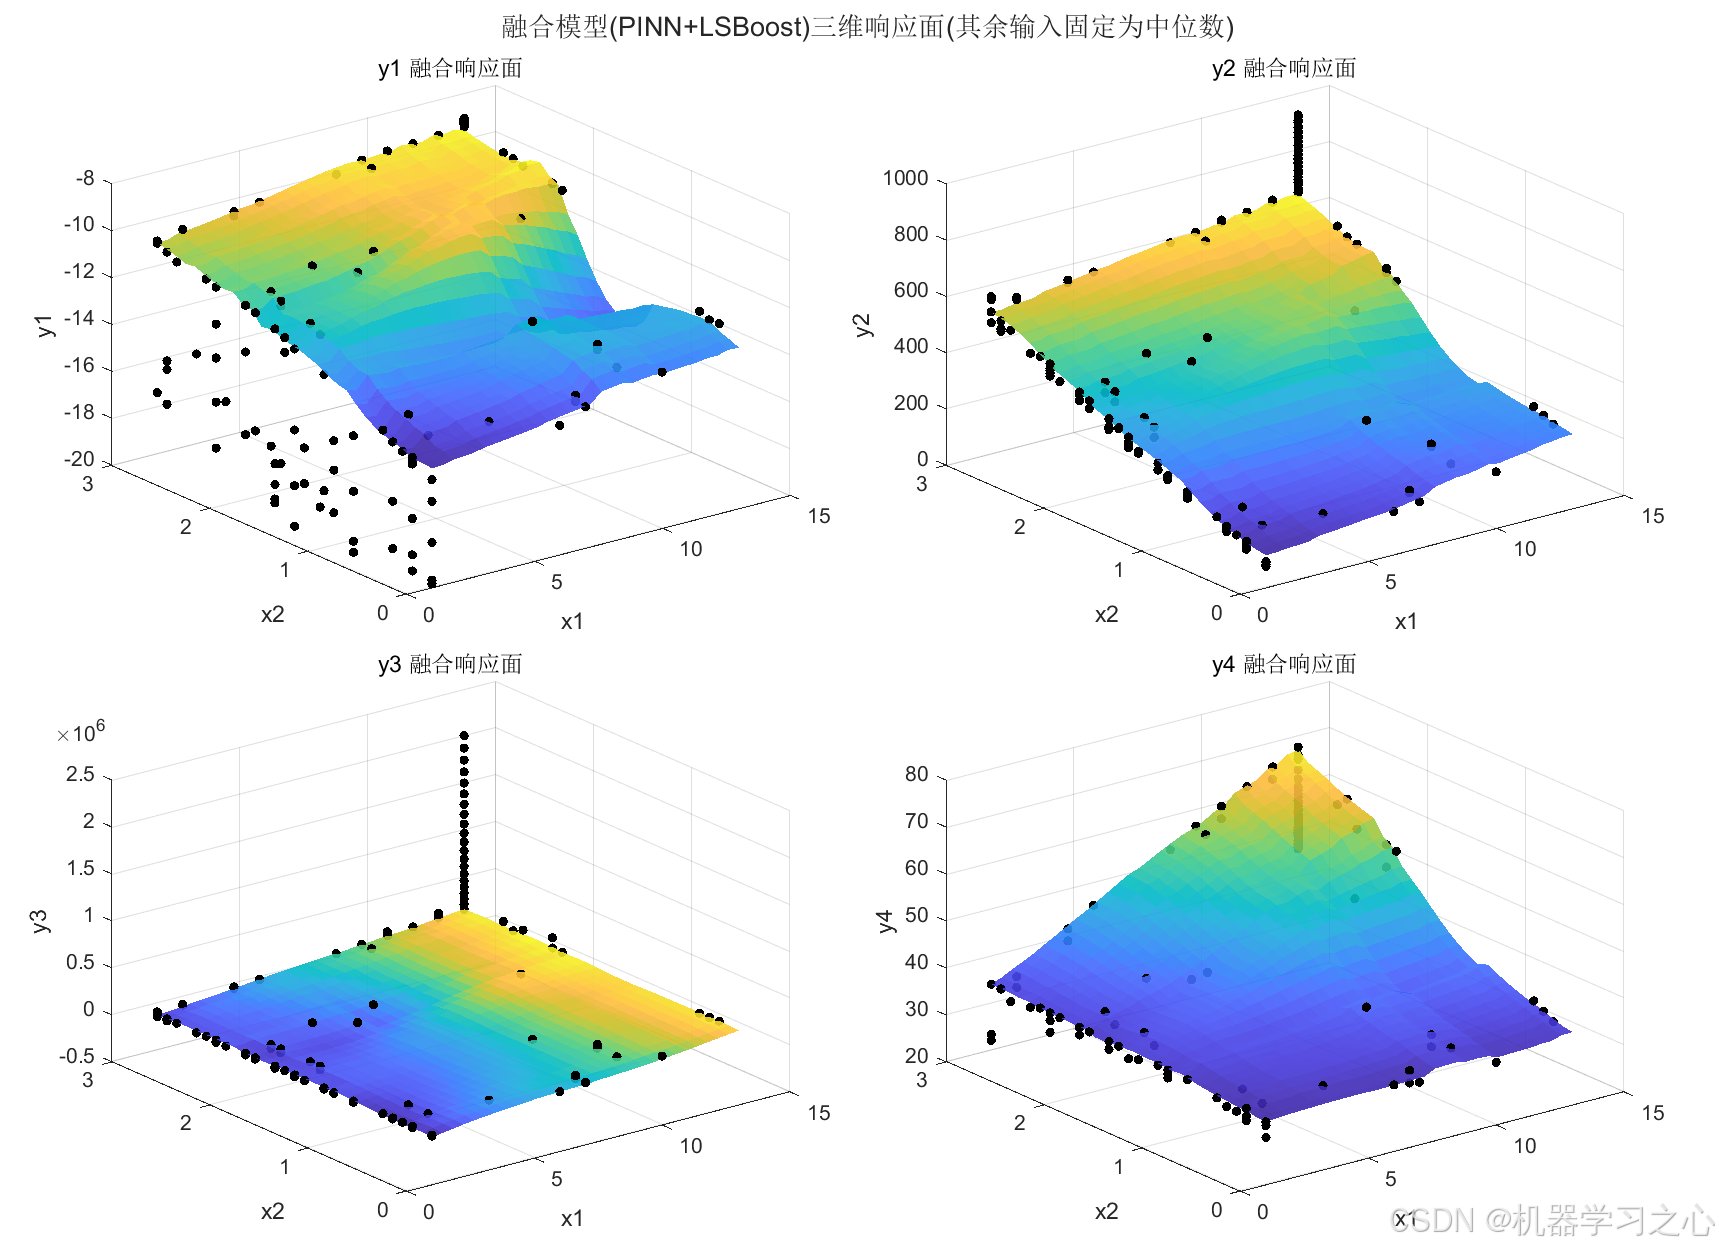
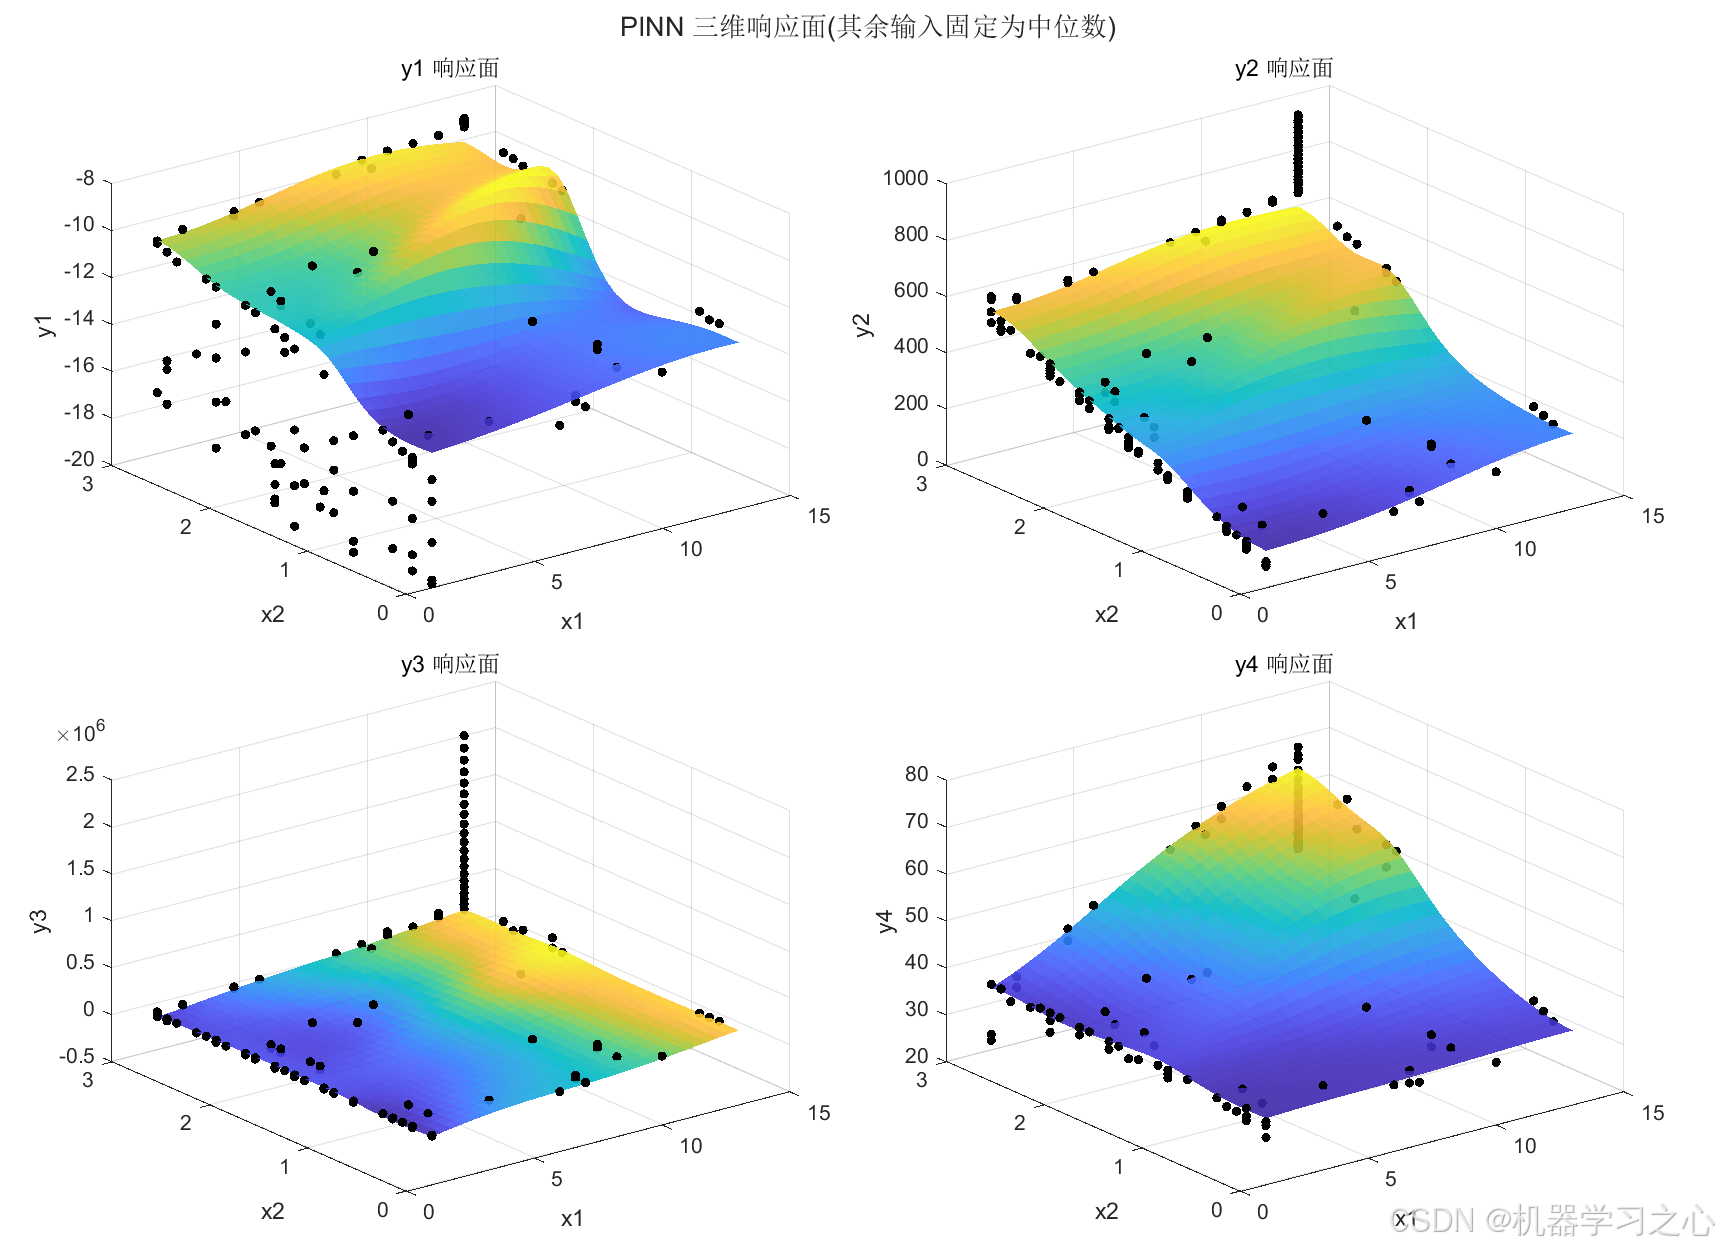
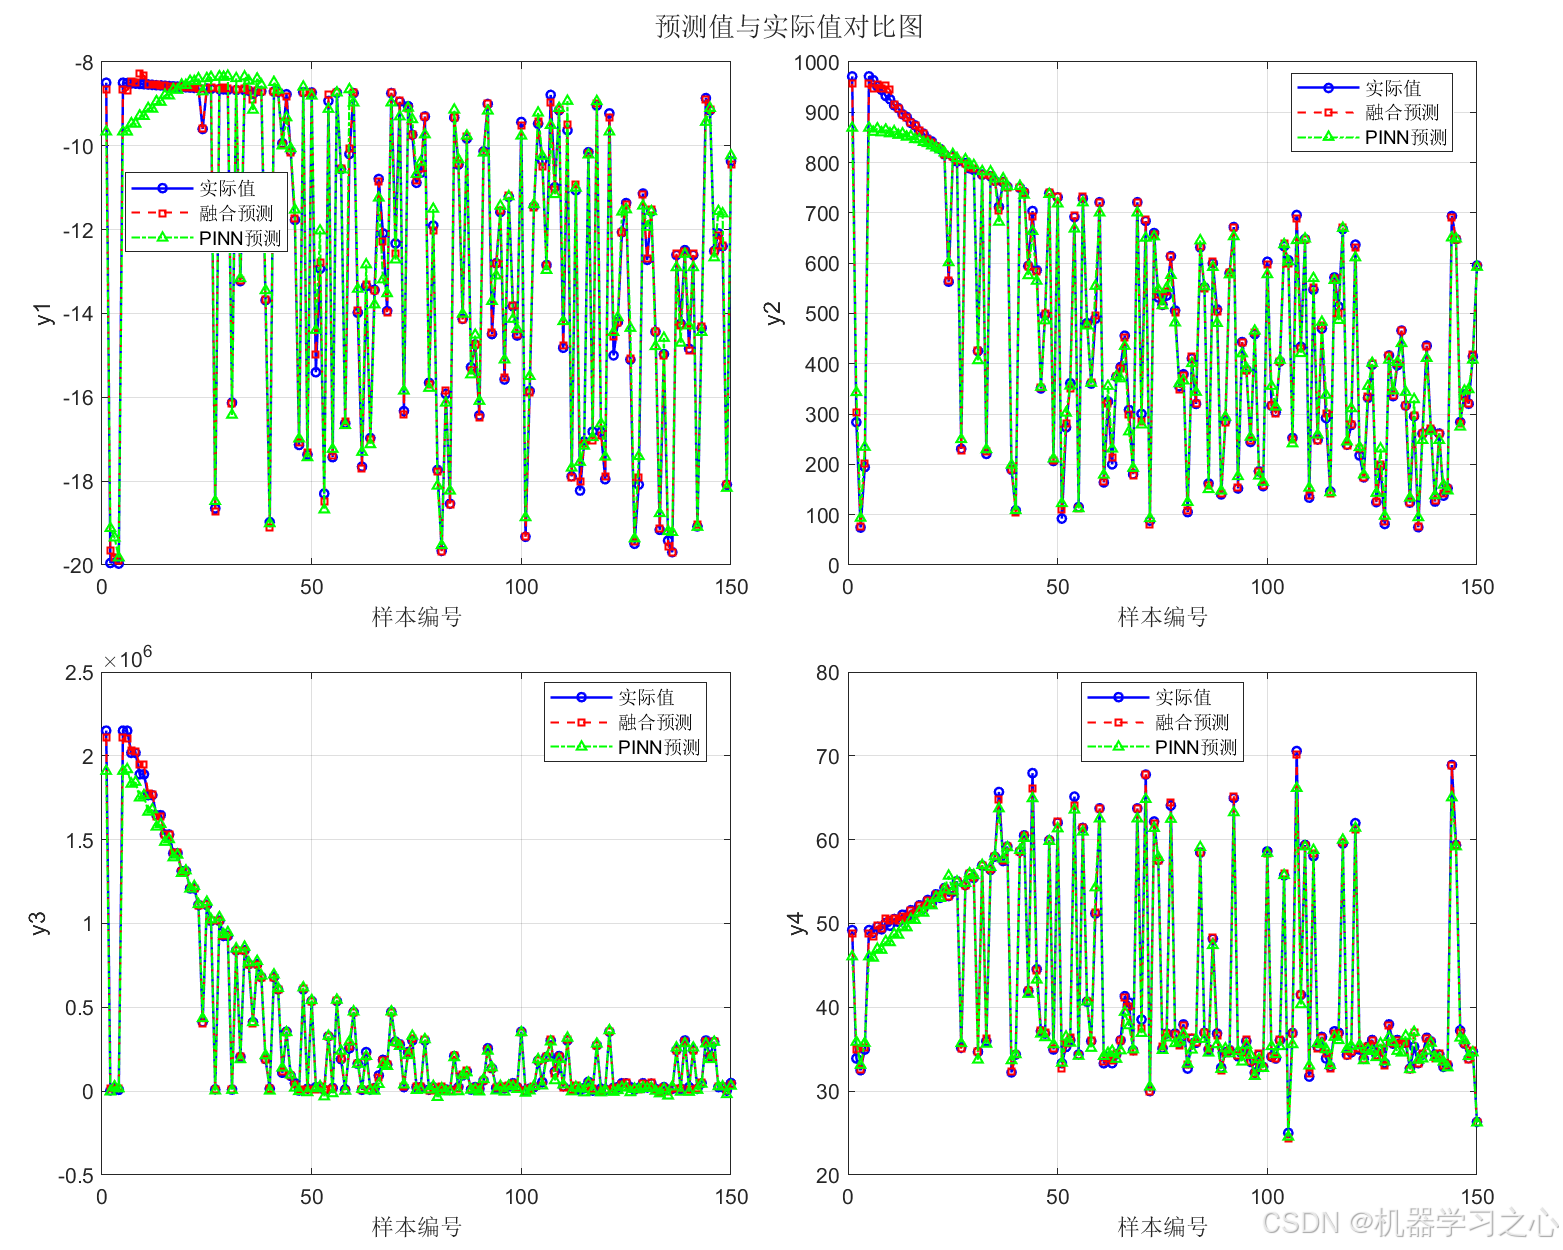
配套的 18 张可视化图覆盖了建模、优化、决策全流程:
| 序号 | 图表 | 说明 |
|---|---|---|
| 1 | PINN 训练损失曲线 | 收敛性验证 |
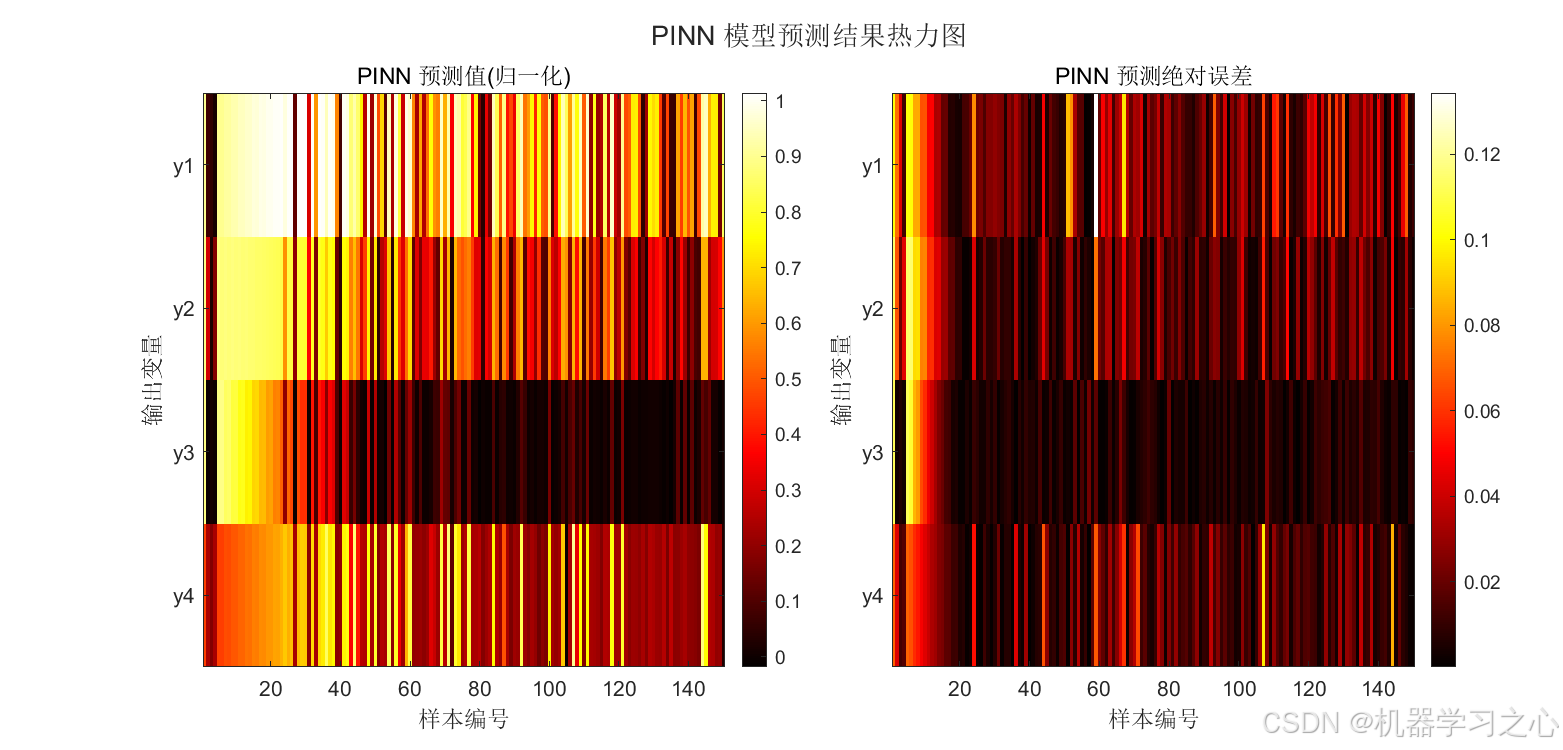
| 2 | PINN 预测热力图 | 预测值 + 误差分布 |
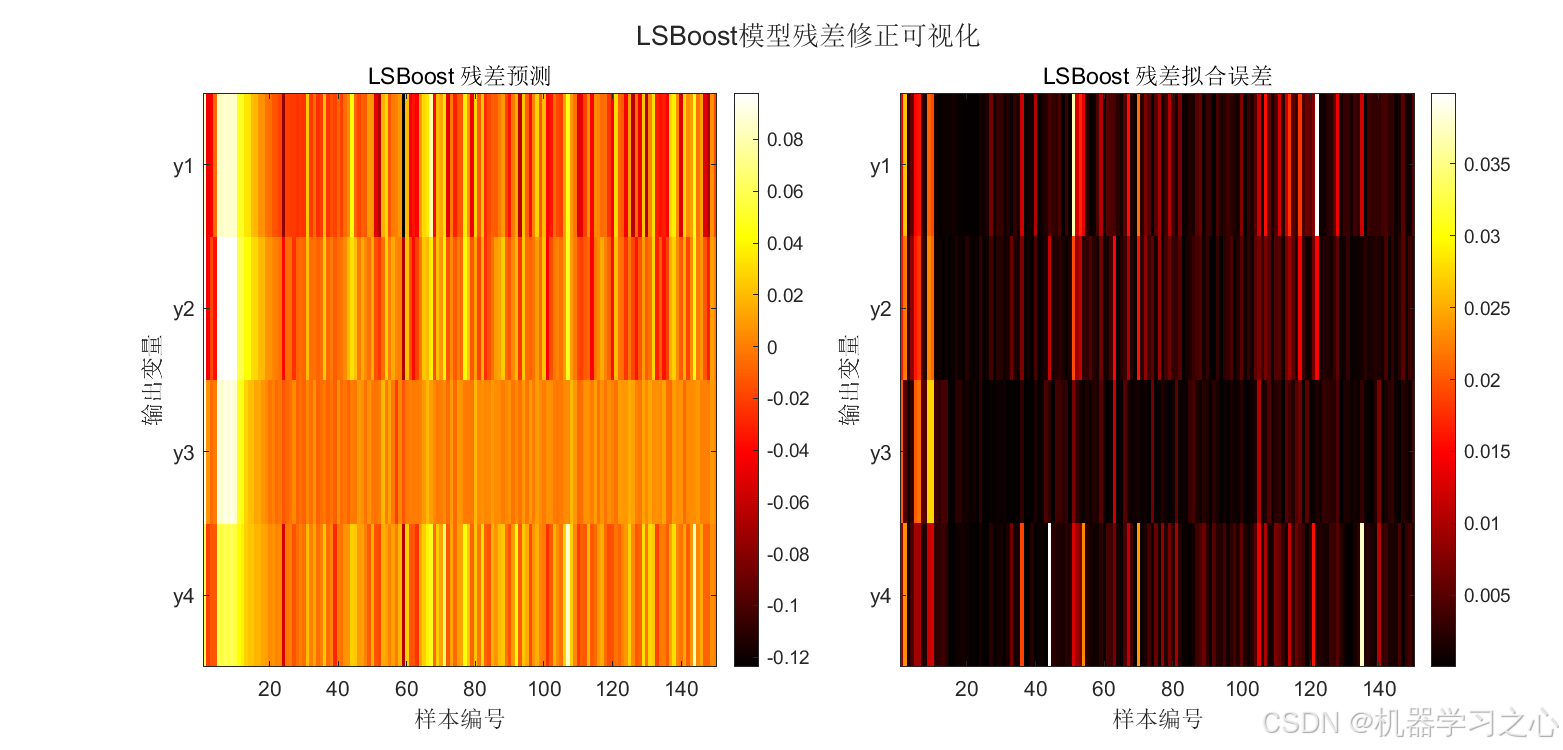
| 3 | LSBoost 残差预测热力图 | 残差预测 + 拟合误差 |
| 4 | 融合模型拟合散点图 | 预测 vs 真实(训练/测试) |
| 5 | 帕累托最优前沿 | 四维 3D 彩色图 |
| 6 | 熵权法权重占比 | 柱状图 + 等权对比 |
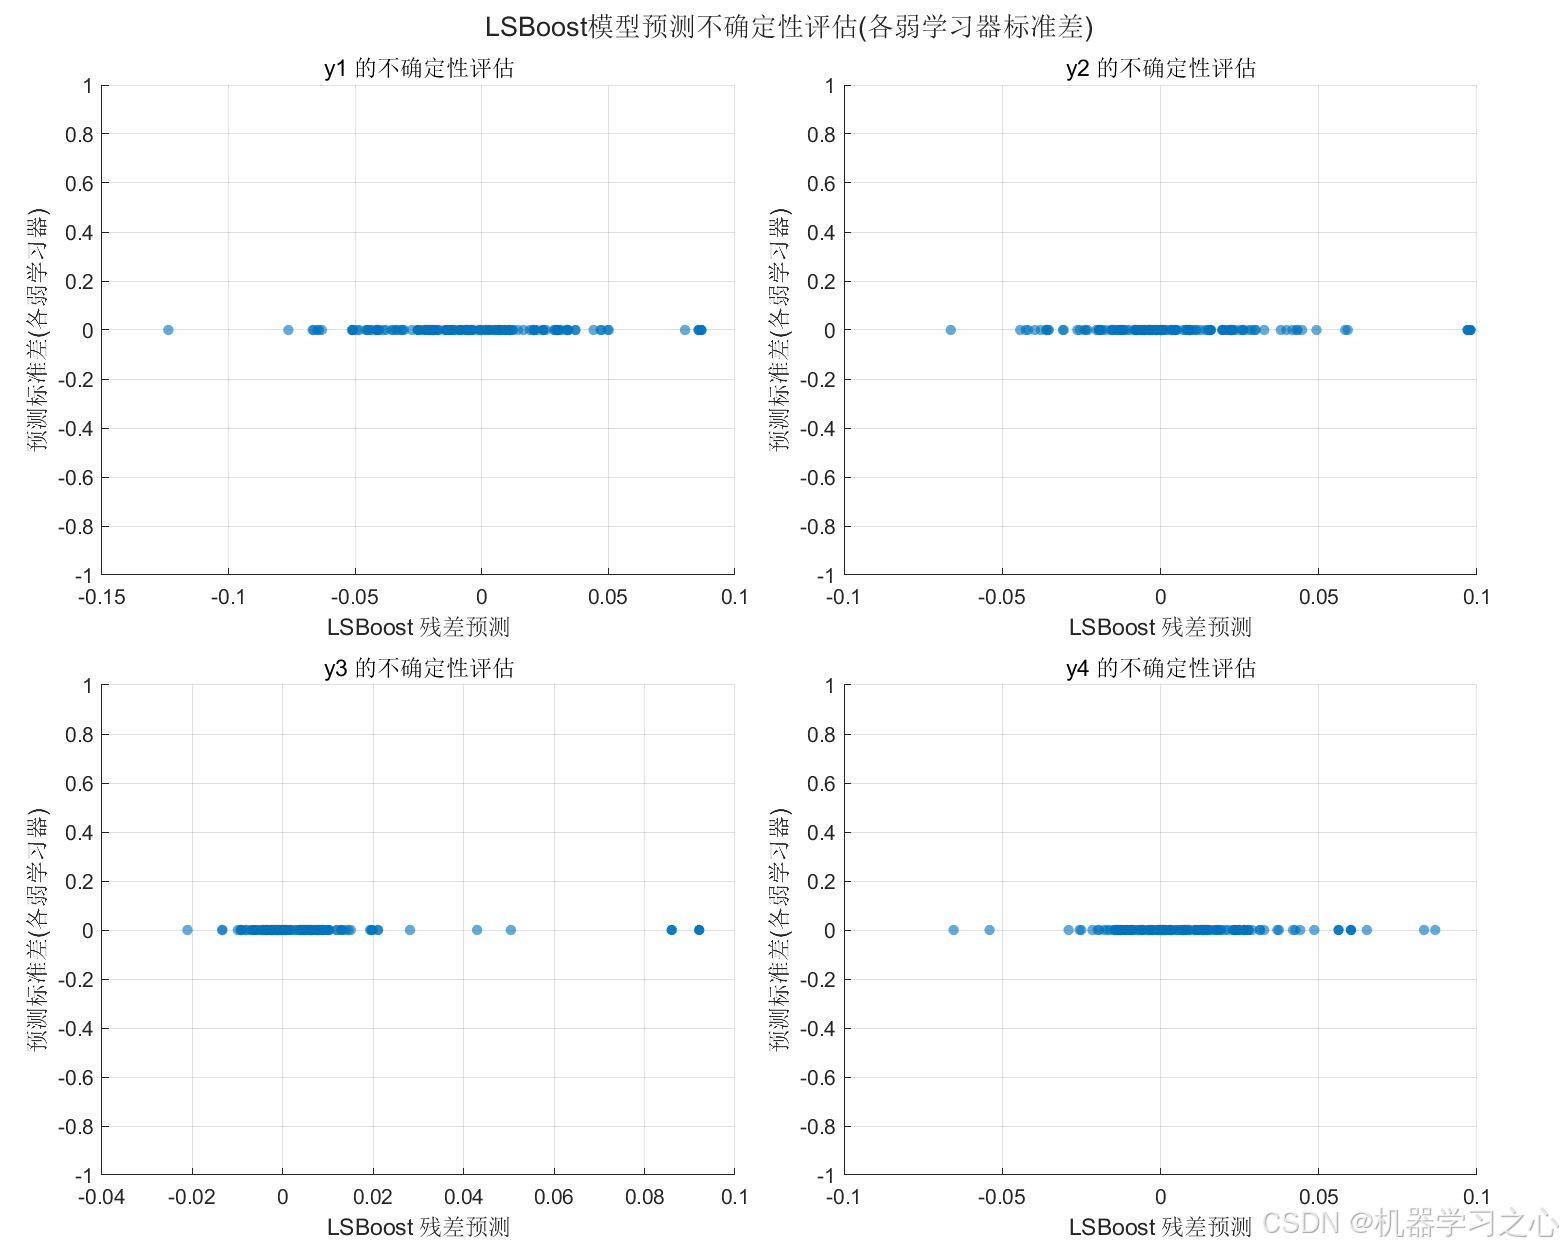
| 7 | LSBoost 预测不确定性 | 残差预测 vs 各弱学习器标准差 |
| 8 | TOPSIS 贴近度排序 | 方案排序 |
| 9 | 预测值与实际值对比 | 曲线对比 |
| 10 | PINN 三维响应面 | 3D surf 图 |
| 11 | 误差分布直方图 | PINN vs 融合模型 |
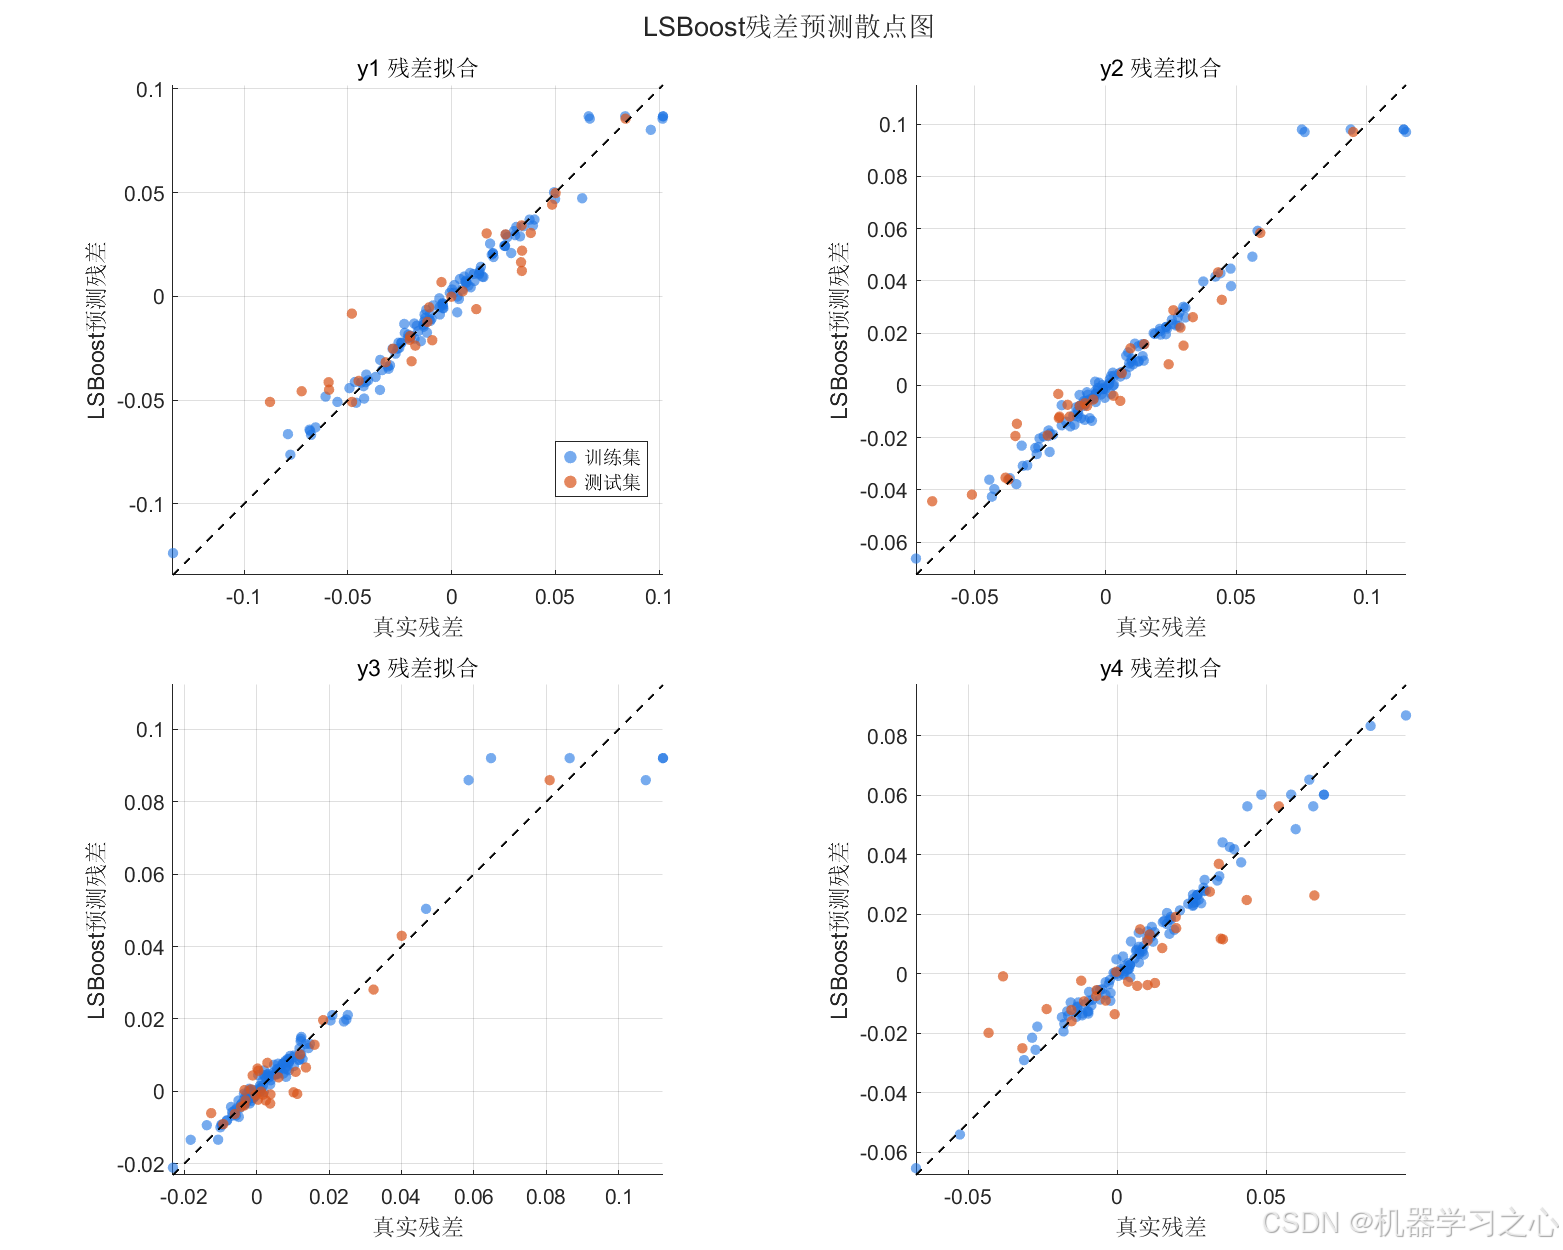
| 12 | LSBoost 残差预测散点图 | 残差拟合效果 |
| 13 | 融合模型三维响应面 | 3D surf 图 |
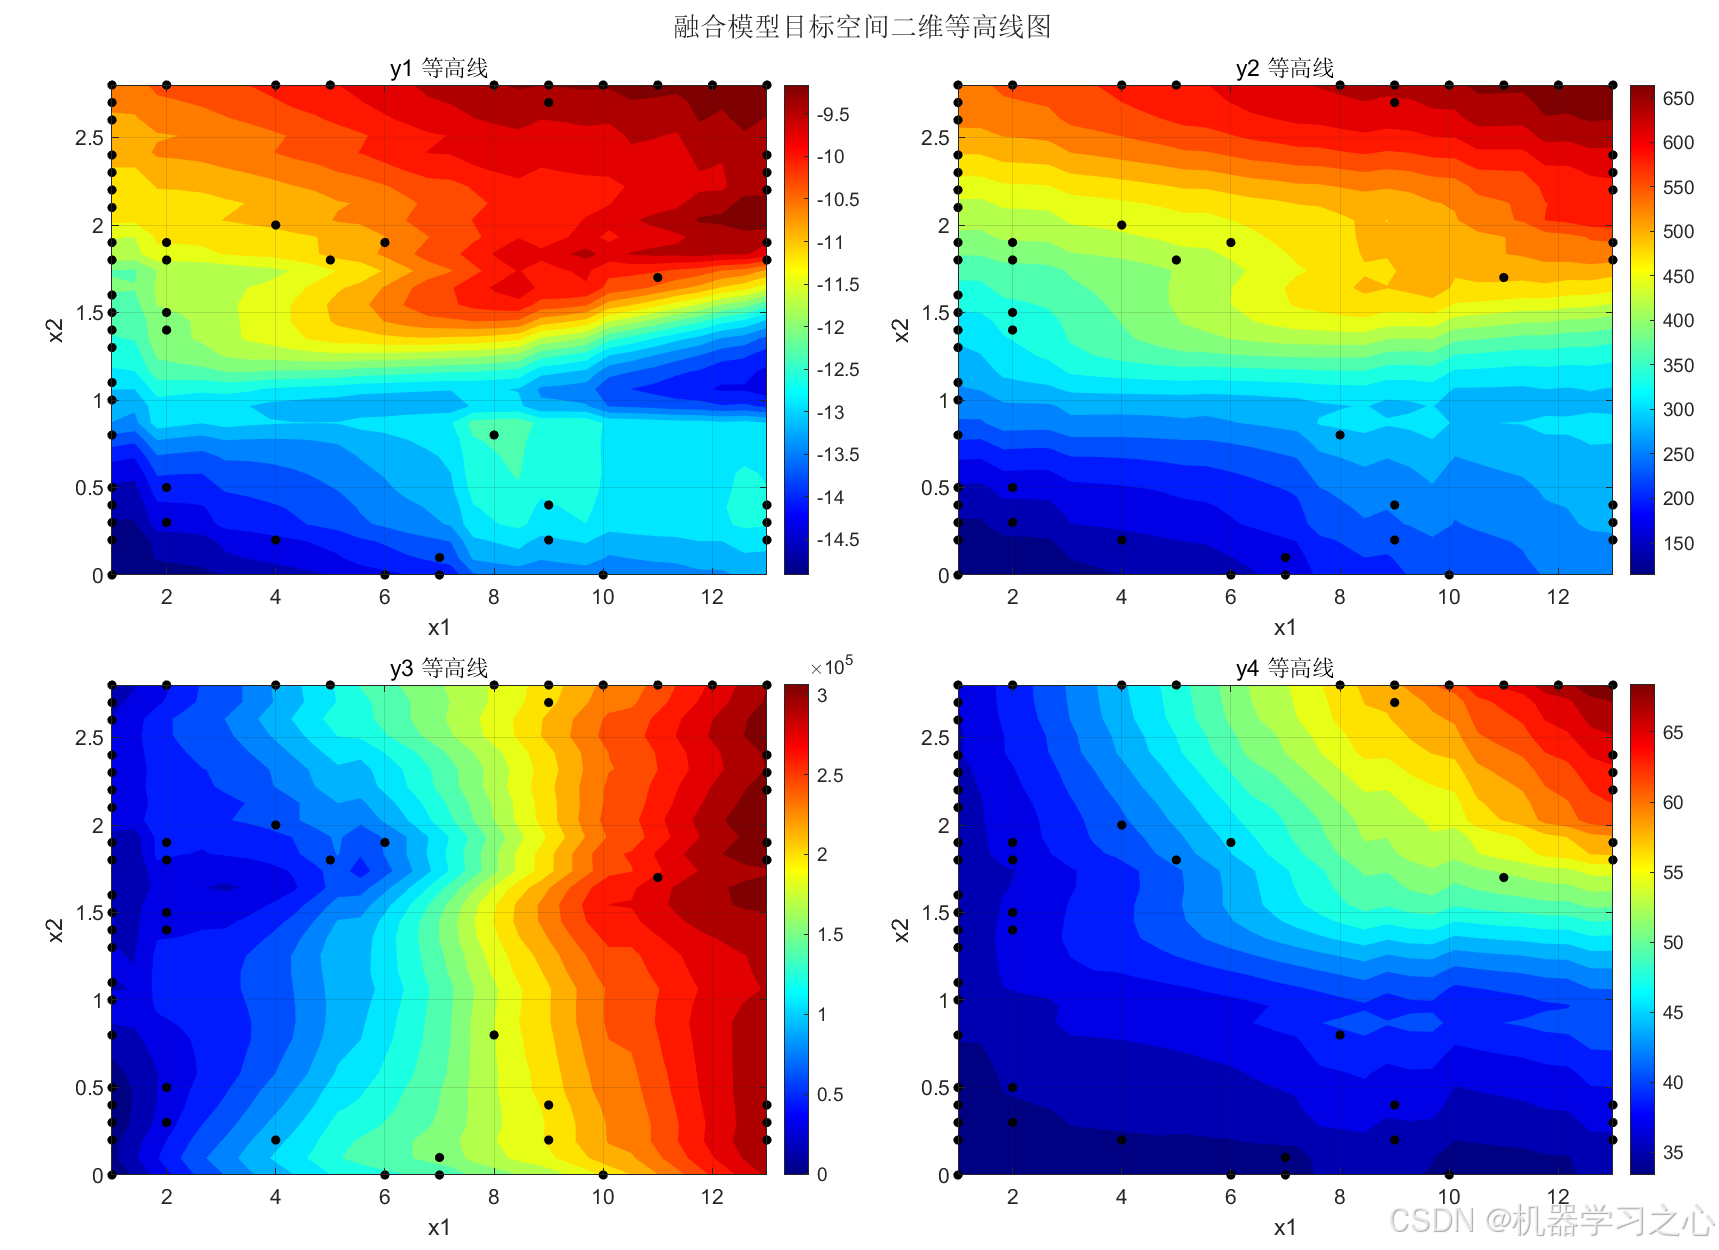
| 14 | 目标空间等高线图 | 2D contour |
| 15 | 特征重要性柱状图 | 分裂改进量重要性 |
| 16 | 误差分析箱线图 | 统计对比 |
| 17 | 关键指标对比柱状图 | RMSE/MAE/R² |
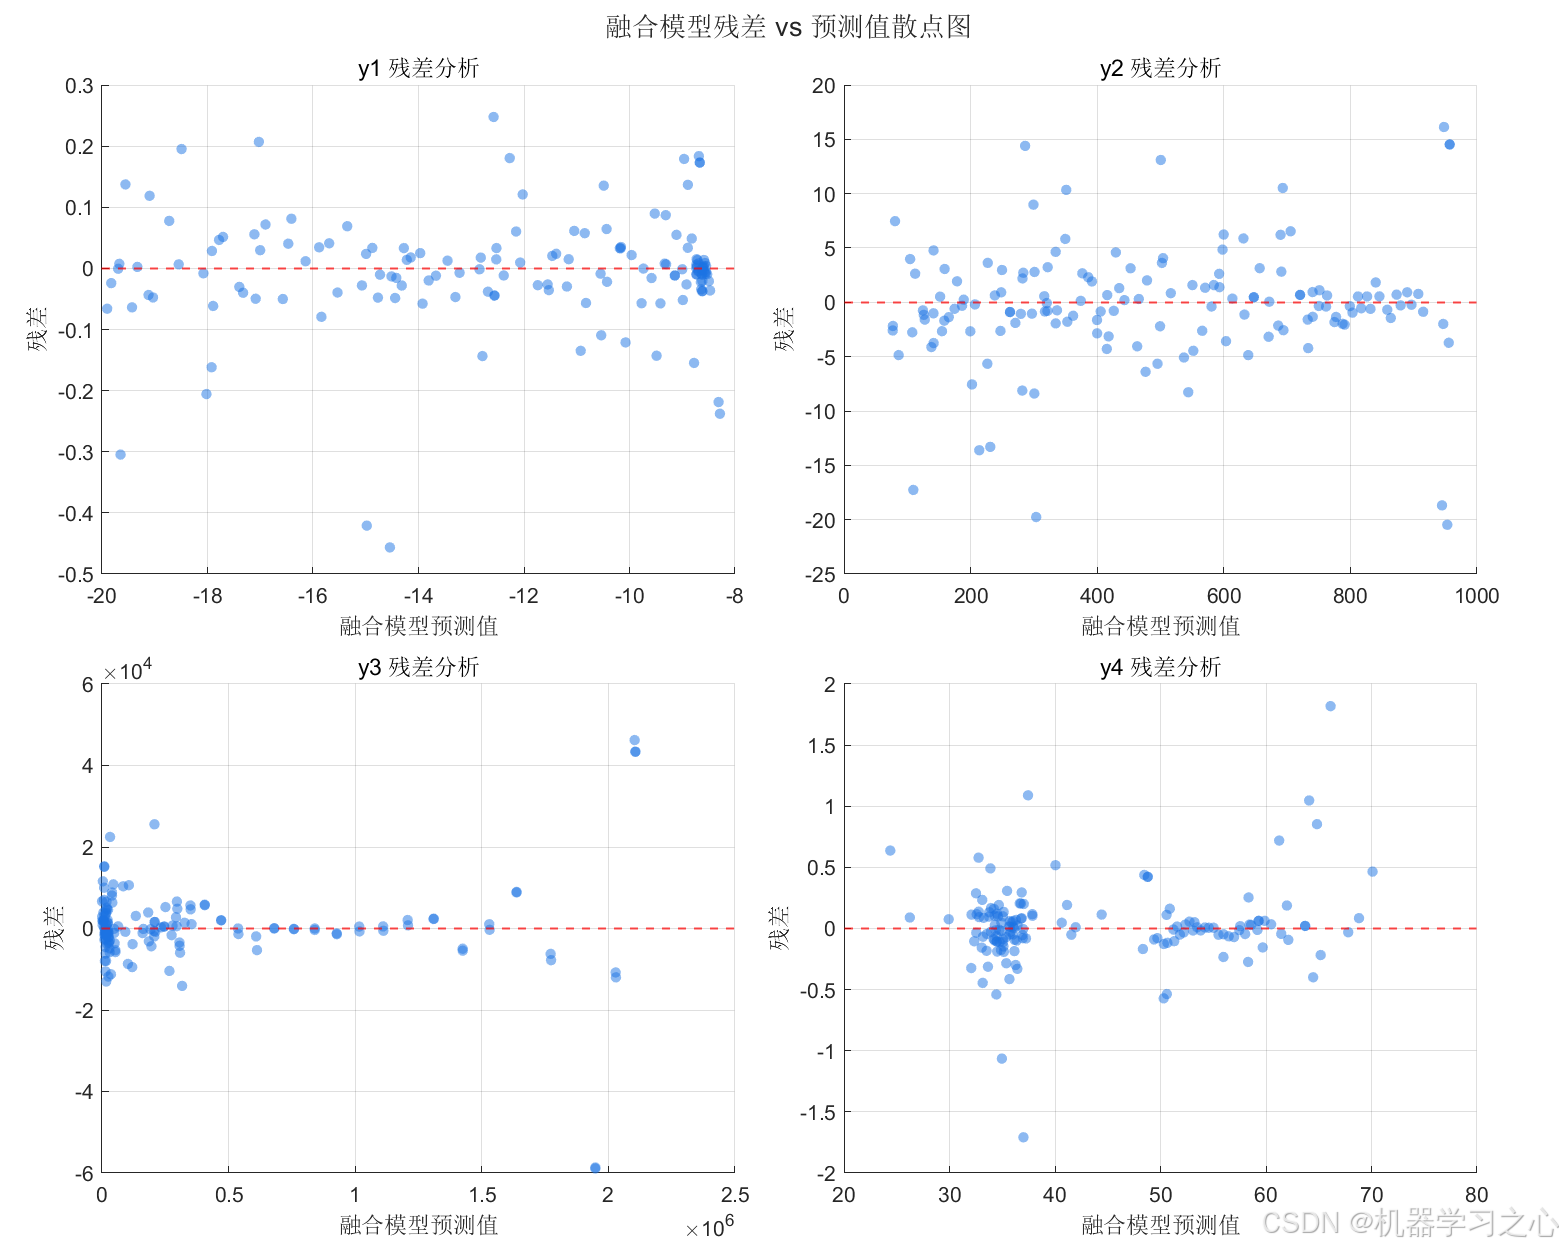
| 18 | 残差分析图 | 残差 vs 预测值 |
所有图都在 results/ 目录下,发公众号时可以直接上传插图。
八、应用场景
这套框架是通用的黑箱多目标优化流水线,只要你的问题符合「多输入 → 多输出、目标互相冲突、样本有限、评价昂贵」这几个特征就能套用:
- 结构轻量化:输入是尺寸/厚度/材料参数,输出是重量、强度、刚度、一阶频率。
- 工艺参数优化:输入是温度/压力/时间,输出是成品率、变形量、残余应力。
- 材料配方设计:输入是各组分比例,输出是成本、拉伸强度、断裂伸长率。
- 化工/能源过程:输入是操作条件,输出是能耗、产量、排放。
数据从哪来都可以------有限元仿真、物理实验、历史生产记录。你只需要把列名按 x* / y* 规范命名,剩下的预处理、建模、优化、决策整条链路框架都会自动完成。
写在最后
这套框架最值得借鉴的不是某一个算法,而是「总体规律 + 局部残差」这个建模思想:让擅长趋势外推的神经网络和擅长非线性拟合的集成学习模型各司其职,再用进化算法和客观赋权把「解集」落成「方案」。
文中数据与结果均来自完整可复现的 MATLAB 实验,代码采用模块化结构,替换 data.xlsx 即可迁移到自己的多目标优化问题上。框架同时保留 Kriging 和 LSBoost 两种残差建模方案,接口一致,一行代码即可切换。