一、背景与选型
在做站点巡检、内容聚合或竞品分析时,我们经常需要自动访问网页并提取标题、链接等数据。传统的 HttpClient + Jsoup 方案有两大短板:
- 无法执行 JavaScript:现代站点(尤其是 SPA 单页应用)的内容是前端渲染出来的,纯 HTTP 请求拿不到真实 DOM。
- 容易被识别为爬虫:缺少真实浏览器环境,Headers、JS 指纹、渲染行为都和真人不同。
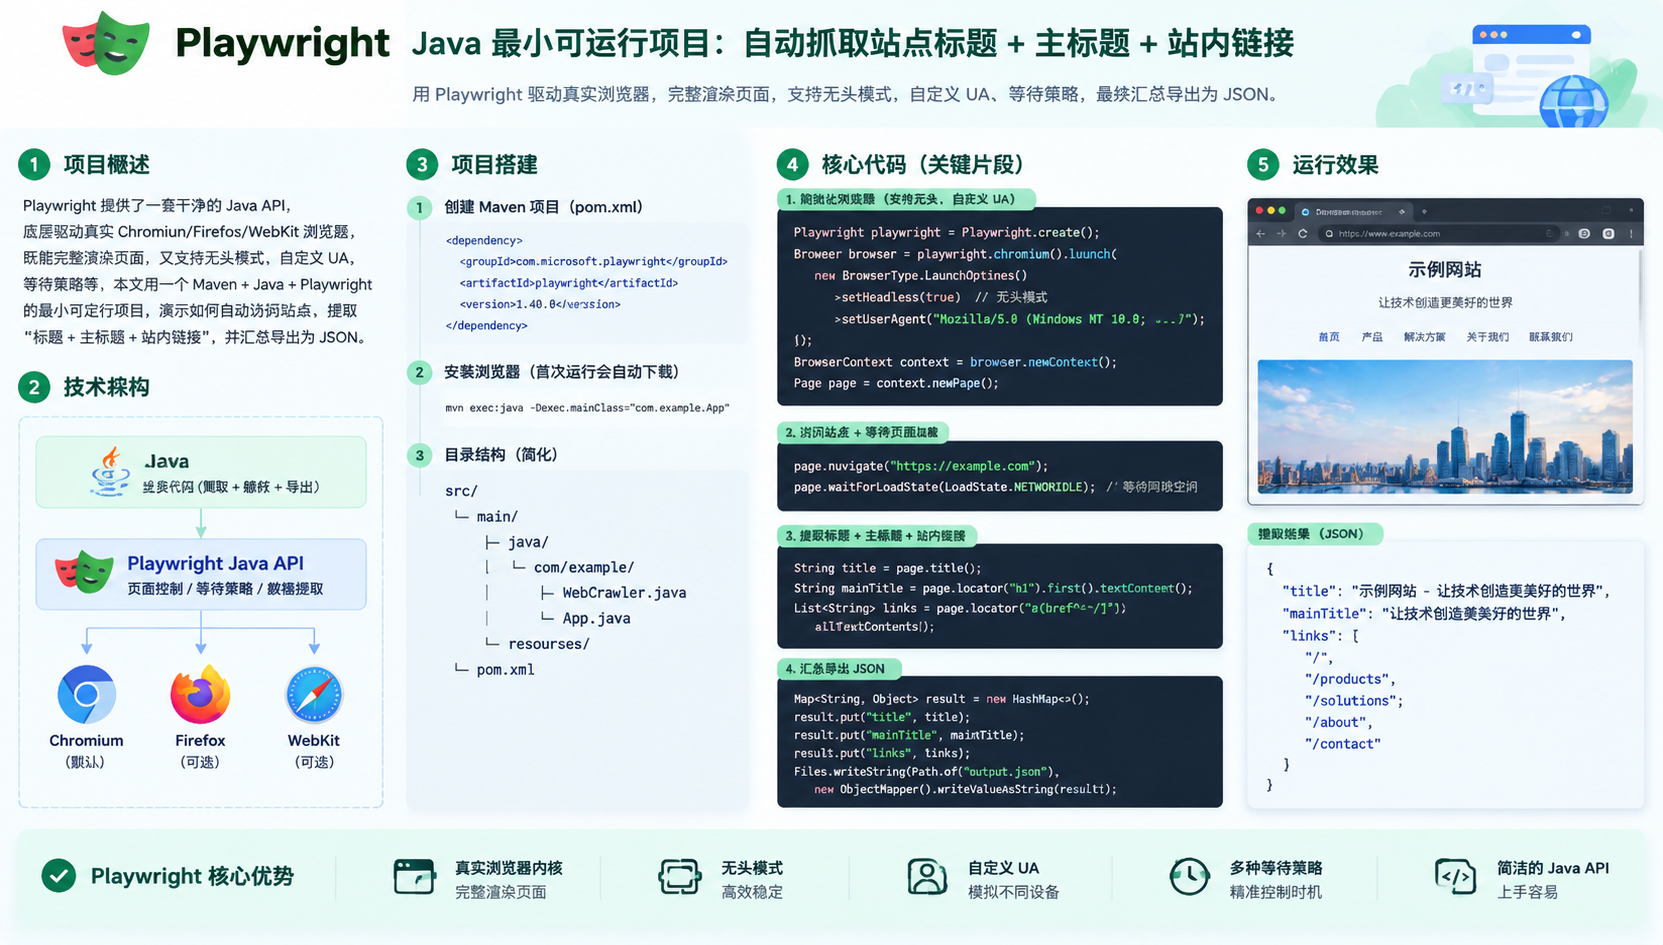
Microsoft Playwright 提供了一套干净的 Java API,底层驱动真实 Chromium/Firefox/WebKit 浏览器,既能完整渲染页面,又支持无头模式、自定义 UA、等待策略等。本文用一个 Maven + Java + Playwright 的最小可运行项目,演示如何自动访问站点、提取"标题 + 主标题 + 站内链接",并汇总导出为 JSON。
项目最初以 Gitee 为示例,后扩展到腾讯云开发者社区(
https://cloud.tencent.com/developer/user/12362774),下面以最终可运行的腾讯云版本为准讲解,配置项支持一键切换回 Gitee 或任意站点。
二、环境准备
| 依赖 | 版本 | 说明 |
|---|---|---|
| JDK | 11+(本文 21 验证通过) | Playwright for Java 要求 Java 11+ |
| Maven | 3.6+(本文 3.9.12) | 负责编译与 fat-jar 打包 |
| 网络 | 首次需联网 | Playwright 会自动下载 Chromium 到用户目录缓存,仅一次 |
注意:Playwright 首次运行会下载浏览器内核(约几百 MB),之后缓存复用,启动很快。
三、项目搭建(pom.xml)
核心依赖是 com.microsoft.playwright:playwright,并用 maven-shade-plugin 把依赖打成一个可直接 java -jar 的 fat-jar;slf4j-simple 用于简化日志。
xml
<project xmlns="http://maven.apache.org/POM/4.0.0" ...>
    <modelVersion>4.0.0</modelVersion>
    <groupId>com.example</groupId>
    <artifactId>playwright-tencent</artifactId>
    <version>1.0-SNAPSHOT</version>
    <packaging>jar</packaging>
    <name>Playwright Tencent Demo</name>
    <description>基于 Java 调用 Playwright 实现腾讯云开发者网站数据获取与自动访问</description>

    <properties>
        <maven.compiler.source>11</maven.compiler.source>
        <maven.compiler.target>11</maven.compiler.target>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <playwright.version>1.48.0</playwright.version>
        <maven.shade.version>3.5.3</maven.shade.version>
    </properties>

    <dependencies>
        <dependency>
            <groupId>com.microsoft.playwright</groupId>
            <artifactId>playwright</artifactId>
            <version>${playwright.version}</version>
        </dependency>
        <dependency>
            <groupId>org.slf4j</groupId>
            <artifactId>slf4j-simple</artifactId>
            <version>2.0.13</version>
        </dependency>
    </dependencies>

    <build>
        <finalName>playwright-tencent</finalName>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.13.0</version>
                <configuration><source>11</source><target>11</target><encoding>UTF-8</encoding></configuration>
            </plugin>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-shade-plugin</artifactId>
                <version>${maven.shade.version}</version>
                <executions>
                    <execution>
                        <phase>package</phase>
                        <goals><goal>shade</goal></goals>
                        <configuration>
                            <transformers>
                                <transformer implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">
                                    <mainClass>com.example.tencent.TencentDemoApplication</mainClass>
                                </transformer>
                            </transformers>
                        </configuration>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>
</project>
四、核心代码实现
项目结构如下:
playwright-demo/
├── pom.xml
└── src/main/java/com/example/tencent/
    ├── TencentConfig.java           # 访问配置(基地址、路径、是否无头、超时)
    ├── TencentScraper.java          # Playwright 核心访问与数据提取逻辑
    └── TencentDemoApplication.java  # 程序入口 + JSON 导出
4.1 配置类 TencentConfig
把"访问哪个站、访问哪些页面、等多久"全部参数化,并通过系统属性支持命令行覆盖,方便在多站点间切换。
java
package com.example.tencent;

import java.util.ArrayList;
import java.util.List;

public class TencentConfig {
    /** 基地址(可被 -Dsite.base 覆盖) */
    public static final String BASE_URL =
            System.getProperty("site.base", "https://cloud.tencent.com");

    /** 需要自动访问的路径列表(相对基地址,逗号分隔),可被 -Dsite.paths 覆盖 */
    public static final List<String> TARGET_PATHS = parsePaths(
            System.getProperty("site.paths", "developer/user/12362774"));

    private static List<String> parsePaths(String raw) {
        List<String> list = new ArrayList<>();
        for (String p : raw.split(",")) {
            p = p.trim();
            if (!p.isEmpty()) list.add(p);
        }
        return list;
    }

    public static final boolean HEADLESS = true;        // 无头模式(后台运行)
    public static final int NAVIGATION_TIMEOUT = 30_000;
    public static final int WAIT_AFTER_LOAD = 3_000;    // 渲染等待(SPA 必需)
}
4.2 抓取器 TencentScraper
核心职责:启动浏览器 → 访问页面 → 提取标题/主标题/同站链接 → 容错 → 序列化为 JSON。
java
package com.example.tencent;

import com.microsoft.playwright.*;
import com.microsoft.playwright.options.AriaRole;

import java.util.ArrayList;
import java.util.List;

public class TencentScraper implements AutoCloseable {
    private final Playwright playwright;
    private final Browser browser;
    private final BrowserContext context;

    public TencentScraper() {
        this.playwright = Playwright.create();
        this.browser = playwright.chromium().launch(
                new BrowserType.LaunchOptions().setHeadless(TencentConfig.HEADLESS));
        this.context = browser.newContext(
                new Browser.NewContextOptions()
                        .setUserAgent("Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                                + "AppleWebKit/537.36 (KHTML, like Gecko) "
                                + "Chrome/124.0.0.0 Safari/537.36")
                        .setLocale("zh-CN"));
        this.context.setDefaultTimeout(TencentConfig.NAVIGATION_TIMEOUT);
    }

    public VisitResult visit(String path) {
        String base = TencentConfig.BASE_URL.replaceAll("/+$", "");
        String url = (path == null || path.isEmpty() || "home".equalsIgnoreCase(path))
                ? base
                : base + "/" + path.replaceAll("^/|/$", "");
        Page page = context.newPage();
        try {
            System.out.println("[访问] " + url);
            // 关键:用 LOAD 而非 NETWORKIDLE,避免页面持续请求导致永不 idle
            page.navigate(url, new Page.NavigateOptions()
                    .setWaitUntil(com.microsoft.playwright.options.WaitUntilState.LOAD));
            page.waitForTimeout(TencentConfig.WAIT_AFTER_LOAD);

            String title = page.title();
            String h1 = extractFirstHeading(page);
            List<String> links = extractContentLinks(page);

            System.out.println("  标题: " + title);
            System.out.println("  主标题: " + h1);
            System.out.println("  发现站内内容链接数: " + links.size());
            return new VisitResult(url, title, h1, links);
        } catch (Exception e) {
            System.err.println("  访问失败: " + e.getMessage());
            return new VisitResult(url, null, null, new ArrayList<>(), e.getMessage());
        } finally {
            page.close();
        }
    }

    private String extractFirstHeading(Page page) {
        try { return page.locator("h1").first().innerText(); }
        catch (Exception e) {
            try { return page.getByRole(AriaRole.HEADING).first().innerText(); }
            catch (Exception ignored) { return ""; }
        }
    }

    /** 提取同站内容链接:兼容相对路径与同站绝对地址,过滤锚点与静态资源 */
    private List<String> extractContentLinks(Page page) {
        String base = TencentConfig.BASE_URL.replaceAll("/+$", "");
        List<String> result = new ArrayList<>();
        try {
            page.locator("a[href]").elementHandles().forEach(handle -> {
                try {
                    String href = handle.getAttribute("href");
                    if (href == null) return;
                    href = href.trim();
                    String full;
                    if (href.startsWith("/")) {
                        full = base + href;
                    } else if (href.startsWith("http://") || href.startsWith("https://")) {
                        if (!href.startsWith(base + "/") && !href.equals(base)) return;
                        full = href;
                    } else {
                        return; // 跳过 js:/mailto:/锚点等
                    }
                    if (full.matches(".*#.*$")) return;
                    if (full.matches(".*\\.(css|js|png|jpg|jpeg|gif|ico|svg|woff2?|ttf)(\\?.*)?$")) return;
                    if (!result.contains(full)) result.add(full);
                } catch (Exception ignored) {}
            });
        } catch (Exception ignored) {}
        return result;
    }

    /** 自动访问所有配置路径 */
    public List<VisitResult> run() {
        List<VisitResult> results = new ArrayList<>();
        for (String path : TencentConfig.TARGET_PATHS) results.add(visit(path));
        return results;
    }

    @Override public void close() {
        if (context != null) context.close();
        if (browser != null) browser.close();
        if (playwright != null) playwright.close();
    }

    /** 单次访问结果封装 */
    public static class VisitResult {
        public final String url, title, heading;
        public final List<String> repoLinks;
        public final String error;
        public VisitResult(String url, String title, String heading, List<String> repoLinks) {
            this(url, title, heading, repoLinks, null);
        }
        public VisitResult(String url, String title, String heading, List<String> repoLinks, String error) {
            this.url = url; this.title = title; this.heading = heading;
            this.repoLinks = repoLinks; this.error = error;
        }
    }

    /** 序列化为 JSON 字符串(含 url、标题、主标题、链接、错误) */
    public static String toJson(List<VisitResult> results) {
        StringBuilder sb = new StringBuilder();
        sb.append("{\n  \"site\": ").append(jsonStr(TencentConfig.BASE_URL)).append(",\n");
        sb.append("  \"count\": ").append(results.size()).append(",\n  \"results\": [\n");
        for (int i = 0; i < results.size(); i++) {
            VisitResult r = results.get(i);
            sb.append("    {\n");
            sb.append("      \"url\": ").append(jsonStr(r.url)).append(",\n");
            sb.append("      \"title\": ").append(jsonStr(r.title)).append(",\n");
            sb.append("      \"heading\": ").append(jsonStr(r.heading)).append(",\n");
            sb.append("      \"linkCount\": ").append(r.repoLinks.size()).append(",\n");
            sb.append("      \"error\": ").append(jsonStr(r.error)).append(",\n");
            sb.append("      \"links\": [");
            for (int j = 0; j < r.repoLinks.size(); j++) {
                sb.append(jsonStr(r.repoLinks.get(j)));
                if (j < r.repoLinks.size() - 1) sb.append(", ");
            }
            sb.append("]\n    }");
            if (i < results.size() - 1) sb.append(",");
            sb.append("\n");
        }
        sb.append("  ]\n}\n");
        return sb.toString();
    }

    /** 导出为 UTF-8 JSON 文件 */
    public static String exportJson(List<VisitResult> results, String filePath) throws Exception {
        String json = toJson(results);
        java.nio.file.Path path = java.nio.file.Paths.get(filePath);
        java.nio.file.Files.write(path, json.getBytes(java.nio.charset.StandardCharsets.UTF_8));
        return path.toAbsolutePath().toString();
    }

    private static String jsonStr(String s) {
        if (s == null) return "null";
        StringBuilder sb = new StringBuilder("\"");
        for (int i = 0; i < s.length(); i++) {
            char c = s.charAt(i);
            switch (c) {
                case '"': sb.append("\\\""); break;
                case '\\': sb.append("\\\\"); break;
                case '\n': sb.append("\\n"); break;
                case '\r': sb.append("\\r"); break;
                case '\t': sb.append("\\t"); break;
                default:
                    if (c < 0x20) sb.append(String.format("\\u%04x", (int) c));
                    else sb.append(c);
            }
        }
        return sb.append("\"").toString();
    }
}
4.3 程序入口 TencentDemoApplication
入口处把标准输出强制成 UTF-8(解决 Windows 控制台 GBK 乱码),收集所有访问结果并导出 JSON。
java
package com.example.tencent;

import com.example.tencent.TencentScraper.VisitResult;
import java.io.PrintStream;
import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;

public class TencentDemoApplication {
    public static void main(String[] args) throws Exception {
        // 强制 UTF-8 输出,避免 Windows 控制台(GBK)下中文乱码
        PrintStream utf8Out = new PrintStream(System.out, true, StandardCharsets.UTF_8);
        System.setOut(utf8Out);
        System.setErr(utf8Out);

        System.out.println("=== Playwright 自动访问 " + TencentConfig.BASE_URL + " 开始 ===");

        List<String> paths = args.length > 0 ? List.of(args) : TencentConfig.TARGET_PATHS;

        try (TencentScraper scraper = new TencentScraper()) {
            List<VisitResult> results = new ArrayList<>();
            if (args.length > 0) {
                for (String path : paths) results.add(scraper.visit(path));
            } else {
                results = scraper.run();
            }
            String outFile = System.getProperty("output.file", "tencent_result.json");
            String saved = TencentScraper.exportJson(results, outFile);
            System.out.println("已导出 JSON: " + saved + "  (共 " + results.size() + " 条记录)");
        } catch (Exception e) {
            System.err.println("运行异常: " + e.getMessage());
            e.printStackTrace();
            System.exit(1);
        }
        System.out.println("=== 完成 ===");
    }
}
五、运行效果
编译打包并运行:
powershell
cd "d:/CodeBuddy WorkSpace/playwright-demo"
mvn clean package                       # 生成 target/playwright-tencent.jar
java -jar target/playwright-tencent.jar
控制台输出:
=== Playwright 自动访问 https://cloud.tencent.com 开始 ===
[访问] https://cloud.tencent.com/developer/user/12362774
  标题: 夜郎King - 个人中心 - 腾讯云开发者社区-腾讯云
  主标题: 夜郎King
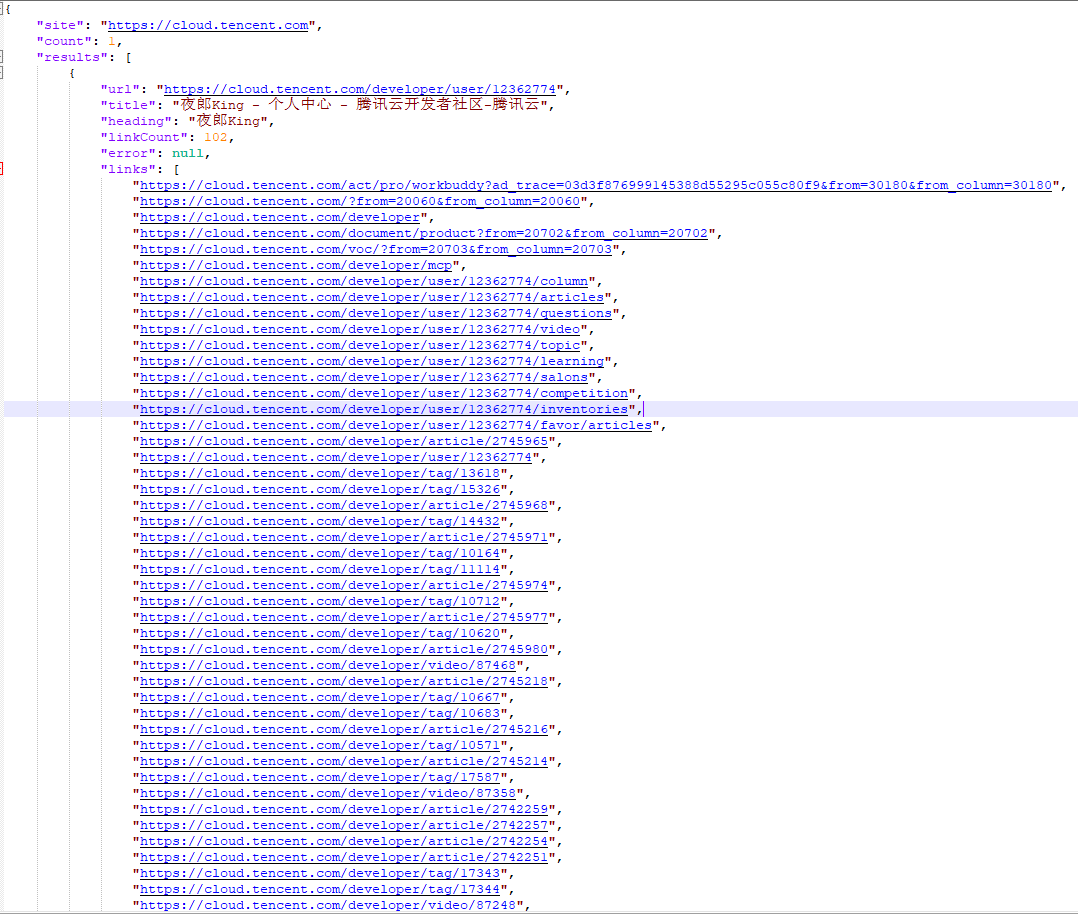
  发现站内内容链接数: 102
已导出 JSON: D:\...\playwright-demo\tencent_result.json  (共 1 条记录)
=== 完成 ===
导出的 tencent_result.json 结构如下(已省略部分链接):
json
{
  "site": "https://cloud.tencent.com",
  "count": 1,
  "results": [
    {
      "url": "https://cloud.tencent.com/developer/user/12362774",
      "title": "夜郎King - 个人中心 - 腾讯云开发者社区-腾讯云",
      "heading": "夜郎King",
      "linkCount": 102,
      "error": null,
      "links": [
        "https://cloud.tencent.com/developer/user/12362774/articles",
        "https://cloud.tencent.com/developer/user/12362774/questions",
        "https://cloud.tencent.com/developer/article/2745965"
      ]
    }
  ]
}
六、踩坑记录与解决方案
这部分是实战中最有价值的内容,建议在自己的博客里重点展开。
1. Windows 控制台中文乱码
System.out 默认跟随系统编码(GBK),中文直接打印会乱码。统一用 new PrintStream(System.out, true, StandardCharsets.UTF_8) 重定向即可,日志落盘也是 UTF-8。
2. NETWORKIDLE 永远等不到
最初用 page.waitForLoadState(LoadState.NETWORKIDLE),结果频繁 30s 超时。原因是目标站有实时内容/轮询请求,网络几乎不会真正"空闲"。改为 WaitUntilState.LOAD (导航即返回),并把渲染等待 WAIT_AFTER_LOAD 提高到 3000ms,问题消失。
3. 链接提取为 0
一开始只匹配站内相对路径(/xxx),但腾讯云大量链接是同站绝对地址(https://cloud.tencent.com/...),被过滤器排除了。修正为"相对路径补基地址、绝对地址仅保留同站",同时过滤锚点与静态资源,链接数从 0 提升到 102。
4. 反爬验证码
切换到 Gitee 首页(https://gitee.com)时,未登录访问会被弹"安全验证码",页面标题变成"安全验证码-独立验证",无法提取内容。这是目标站点的反爬策略,并非程序 bug。应对方式:注入登录态 Cookie,或在 visit() 中检测验证码页面并等待人工处理。
5. mvn clean 失败:jar 被占用
后台运行的 java -jar 进程会锁住 target/*.jar,导致 mvn clean 无法删除。结束遗留 Java 进程即可正常构建。建议在脚本里先 Stop-Process -Name java 再打包。
七、可扩展方向
当前是"采集标题 + 链接"的基础版,可继续增强:
- 登录态 :通过
context.addCookies(...)注入 Cookie,突破需登录的页面与验证码。 - 更细粒度数据 :在
extractContentLinks基础上,针对文章页提取正文、作者、发布时间、阅读量等。 - 失败重试与限流:对超时/异常链接加入指数退避重试,控制访问频率避免被封。
- 代理池 :
LaunchOptions.setProxy(...)配置代理,应对 IP 限制。 - 定时任务:配合系统 cron 或调度框架,做周期性站点巡检与数据落库。
八、总结
Playwright for Java 让我们用极少的代码就能驱动真实浏览器完成自动化访问与采集,特别适合现代 SPA 站点和需要 JS 渲染的数据获取场景。本文的示例已经覆盖了"启动浏览器 → 访问 → 提取结构化数据 → 导出 JSON"的完整链路,并总结了若干实战坑点。把它作为脚手架,你可以快速改造成自己的数据采集工具。
完整代码已放到本地 Maven 工程,只需
mvn clean package后java -jar即可运行;想换站点时,用-Dsite.base=... -Dsite.paths=...覆盖默认配置即可,无需改代码。
如果本文对你有帮助,欢迎点赞收藏,也欢迎在评论区交流 Playwright 的使用心得。