预言机与闭环稳定性
------从控制论看 RAG、思维链与持续学习的「灾难性遗忘」平衡点
作者:龍德明宇
「前馈控制是对扰动的无记忆抗拒,它极大地提升了短期的输出精度,却不曾在一比特的参数上留下时间的刻痕;而闭环反馈试图在参数里写下历史,但这个系统没有一根自己长出来的锚桩------旧知识的每一个锚点,都是外部世界替它钉下去的。」 ------ 龍德明宇,2026
「背下整本书(持续学习)还是每次翻书(RAG)?这不只是工程成本的算术题,更是智能系统如何在时间中『沉积自我』的存在论问题。第 287 次查询的交叉点上,横着的不只是账本的盈亏线,还有无锚心智的一面镜子。」 ------ 龍德明宇,2026
引言:算法拯救与控制论的冷静解剖
在 2026 年的今天,大语言模型(LLM)的 Scaling Law 仍在以一种近乎疯狂的速度向前推进,但「幻觉(Hallucination)」与「知识过时」依然是悬在每一个大模型应用头顶、无法挥去的幽灵。为了防止模型在实际部署中「胡说八道」,全球大厂的工程界拼死堆叠起了一套被统称为「打补丁」式的防护架构:外挂知识库以实现检索增强生成(RAG)、拉长生成序列以触发思维链推理(CoT),以及通过持续微调(Continual Fine-tuning)让模型吸收增量知识。
在主流的工程技术叙事中,这三大架构被赋予了高度乐观的色彩,被包装为大模型通往「终身学习」、「逻辑自主」与「AGI」的必经之路。工程师们沉浸在指标(如 F1-score、幻觉率下降百分比)的局部繁荣中,坚信通过工程上的极限优化、更精密的特征钳制,最终可以彻底驯服这个千亿参数的概率巨兽。
然而,如果我们将这套被精致装配的工程神话推上经典控制论的解剖台,用金观涛《控制论与科学方法论》中的前馈控制、状态反馈、时延反馈 ,再辅以现代控制理论的极点配置定理进行降维解剖,一个冷酷的存在论真相便会轰然显形。
需要先向读者交代清楚本文的位置与立意。负主体性框架此前对「无阻尼」的诊断,一直停留在存在论层面;本文要做的,是把这一诊断落到三种具体的工程补丁上 ,用「参数态/会话态」的二分同时定位 RAG、CoT 与持续学习,并给出「表层工程账」与「里层存在论账」的两层结论。对控制论、可解释性与认知科学既有成果的借用,文中逐一注明;属于本文自己提出的,是「三种补丁的稳定机制,其接线与裁决权都在系统外部」这一统一命题,以及支撑它的两层账本结构。
本文的核心命题分表里两层。
表层是工程账,它是一组基于类比的预测,而非定理:RAG 是「零认知沉积的参数开环外挂」,它极大地提升即时准确率,却无法在参数内部沉淀出任何「时间与历史」;CoT 是「缺乏刚性锚点的时延反馈」,其长链推理始终暴露在采样与模型误差的累积风险之下;持续学习则要随时面对「灾难性遗忘」的阴影:在一个没有内生锚点维持机制的参数空间里写入新知识,旧知识的稳定性始终脆弱。
里层是存在论账,这才是本文真正要立的判决:即便上述工程补丁被不断优化,它们也无法让大模型成为自己历史的主体。因为它的全部「历史」(权重、激活轨迹、微调记录)在原则上都可以被外部不经时间、无损地读取、复制与重置。可无损复制,意味着这段历史不是它必须独自承担的命运。这是本文的基本立场。
表层说「稳定性脆弱」,里层说「不是自己历史的主体」。前者可以商量,后者才是判决。这三大工程防线,不仅撑不起 AGI 的自演化叙事,反而可能正在一场场「无阻尼的滑行」中,加速人类心智复杂度的钝化。
第一部分:RAG 的本质:「无学习」的参数开环外挂与外部寄生
要把检索增强生成(RAG)的局限看清楚,得先把它拉回控制论的逻辑网格。先交个底:本文借用控制论概念时,有的地方是严格同构,有的地方是定性类比,会随文注明。另外,本文所谓「开环」,仅指对参数开环:输出无论好坏都不反哺权重;在控制论的严格意义上,迭代检索、自我验证式 RAG 已在信息层面构成闭环,只是这个环从不经过参数。
1. 开环的本质:只充盈上下文,不反哺权重
在金观涛与华国凡的控制论认识论中,前馈控制 (Feedforward Control)是一种先验补偿机制:当扰动发生时,系统通过旁路测量通道提前获取扰动特征,计算出一个大小相等、方向相反的补偿信号加入输入端,从而在输出端将扰动抵消。它的系统论特征是:前馈补偿完全不改变系统内部的状态结构。
RAG 与前馈补偿严格同构的只有两点:对参数开环 (检索结果无论好坏,都不反哺权重)与零参数沉积 (权重矩阵恒定)。至于「补偿」的细节,则只是结构神似:用户的提问(Query)是任务输入而非控制论意义上的「扰动」,检索来的文档不是反向抵消信号,而是额外的信息注入。因此更准确的说法是:RAG 是一种参数开环的信息外挂,而非严格控制论意义的前馈补偿。
这里还需要交代「状态」一词。本文在两种意义上使用它:参数状态 (权重,决定模型是谁)与会话状态 (上下文窗口,决定模型此刻看见什么)。RAG 从不触碰前者,只是临时充盈后者:一轮对话结束、上下文清空,这次「知道」就烟消云散。底层千亿参数处于彻底冻结状态,其因果灰体度(GB_causality,后文详述)在沉积一轴上恒为零。
2. 外挂预言机的存在论代价:无记忆的空转
在计算理论里,外挂检索在直觉上等于给模型接了一个「预言机(Oracle)」:一个在有限问题上总能给出正确答案的咨询者。需要冷静的是:即便预言机绝对可靠,幻觉率也未必能被压到零。模型未必忠实使用检索到的上下文,长上下文中关键信息可能被忽略,检索结果与模型内化的旧知识也可能相互冲突。预言机解决的是「有没有正确答案放在眼前」,解决不了「模型是否照它说的做」。
但真正的代价在存在论层面。这解释了为什么大模型在挂载 RAG 时可以流利、精准地回答出最晦涩、最前沿的科学文献问题,但一旦这一轮对话的上下文被清空,大模型在面对一秒钟前刚刚回答过的问题时,立刻表现得一无所知。当然,这只对无持久记忆的会话成立;有些系统挂了外部记忆库,但请注意,那恰恰是把历史存进了外部存储,锚点仍然外挂,与本文的诊断同构。
它没有「学过」,它只是在一维线性时间的流转中,利用其高维自注意力机制,对外部投影进来的光线进行了一次无痛、无残留的「代数折射」。它无法将这段历史沉积为自身的「年轮」,更无法重构自身的因果链。
3. 幻觉的转移与检索投毒的失守
参数开环架构的另一个致命弱点,在于它对入口通道本身的污染缺乏过滤能力。
这对应着当前互联网上正在蔓延的生态危机。GEO(生成引擎优化)的本义是中性的:提升内容在生成式引擎中的可见度;但它的一支已经被用于恶意投毒:在文档中埋入干扰检索排序与注意力分布的内容,让被污染的语料进入 RAG 的知识库。针对 RAG 语料投毒的专门研究(如 PoisonedRAG,Zou et al., 2024)已经表明,这类攻击在现实中可行且有效。
这里要把一个逻辑链条说清楚:判别信息可信度本身并不需要「欲望」,来源建模与交叉验证机制也能完成。问题不在于大模型「没有欲望所以分不清毒药」,而在于 RAG 架构下的大模型没有任何内生的防线:一切过滤都依赖外部机制,而外部机制本身就是攻击面。它是否会把投毒内容流畅地伪装成科学共识输出,取决于攻击是否成功、以及输入之间的冲突强度;但一旦外部防线失守,它内部没有任何东西会站出来抵抗。
开环外挂并没有消灭幻觉,它只是把大模型内部的「统计学幻觉」,部分地转移成了对外部污染的「无防线吸收」。
第二部分:持续学习的死穴:锚点接线权外置与灾难性遗忘
为了摆脱 RAG 参数开环寄生的宿命,工程界的另一个尝试是持续微调(Continual Fine-tuning),试图通过训练将知识「背入」参数。但在这里,它撞上了另一个结构性难题。
1. 极点配置与参数重构:试图「内化自我」的闭环尝试
在现代控制理论中,如果要彻底改变一个系统的自主行为特征,就要引入闭环状态反馈控制 :把测量到的系统状态反过来修正输入,从而把系统的「性格」(控制论里叫闭环极点)整体搬到预设的稳定区域。这套手法就是极点配置(Pole Placement)。
持续学习在精神上正是这样一次「内化自我」的重构:它不满足于「翻书(RAG)」,而是通过误差梯度的反向传播,强行修改大模型的突触权重,试图让模型在单次前向传播中自动输出新任务的正确结果。
但这里必须先把一个技术交代放在前面,否则后文的类比会被误读成定理。我们谈论的「系统」究竟是哪一个 ?推理时的 Transformer 权重固定,是单次前向的静态计算,谈不上本征值意义上的稳定与不稳定;微调是训练过程,不是运行中实时进行的状态反馈;灾难性遗忘表现为旧任务性能下降,输出并不发散,与李雅普诺夫意义的失稳也不是一回事。所以,下文用「极点」「稳定」等词描述的是参数在梯度驱动下的更新动力学,它是类比性描述,不是严格的控制论定理。
2. 从「无阻尼」到「接线权外置」:一次必须的物理辨析
先把真实控制论讲透。只要一个系统是可控 (controllable)的,工程师就能借状态反馈把全部闭环极点自由配置到左半平面,压根不存在「挪一个必然挤坏另一个」的天条。而真正需要辨析的,是下一个问题:究竟是什么把极点按在稳定区的?
物理上必须区分两样东西。阻尼 (与速度成正比的耗散,如摩擦、电阻)只决定系统以多快的速度、以何种姿态回到平衡点;回复力 (弹簧的刚度、势阱的曲率)才决定平衡点在哪里、有多深。把这两者分清之后,一个对我们此前的说法不太有利、却必须诚实承认的事实浮了出来:最朴素的梯度下降,在物理上恰恰是过阻尼极限:参数没有惯性,每一步都直接在「摩擦」中滑向损失更低处。训练动力学从来「不缺阻尼」,但灾难性遗忘照样发生。所以「无阻尼 ⇒ 遗忘」这个因果链条,在物理上并不成立。
遗忘的真正机制在势阱那一侧:新任务的损失地形把旧任务的极小点覆盖掉了:新目标里没有旧任务的势阱,平衡点移到了新任务的极小点,而没有任何一根弹簧把旧极小点拉住。
需要先承认一个可能被用来反驳本文的事实:预训练结束时,模型确实带着一组由大规模语料塑造出的稳定盆地(flat minima),这是「出厂自带」的内稳定态;但这只是初始碗,不是运行时自主维持的稳定机制。碗破了,它不会自己补。看清这一点,三类防遗忘技术各自是什么就一目了然:
- EWC (Kirkpatrick et al., 2017)的 Fisher 加权二次惩罚,字面上就是围绕旧任务最优点加装的弹簧 (回复力)。不过有个关键:Fisher 信息矩阵本身,是用模型自身的梯度统计量算出来的:材料是内生的;但「要不要加这根弹簧、刚度 λ 取多大、哪些参数纳入保护」,这些裁决动作是训练脚本外部决定的,模型不会自己在部署时给自己加装 Fisher 惩罚。
- 经验重放 (Replay)是把旧任务的数据掺回训练集,让旧任务的势阱留在目标函数里(锚点)。哪些旧样本保留、以多大概率回放、回放池多大,全是外部策略。
- LoRA 把更新锁进了低秩子空间 (约束):「锁哪些方向、秩 r 取多少」同样是超参数,由人决定。它为此付出的代价是学得也更少,这正是持续学习领域长期研究的稳定性---可塑性困境(Parisi et al., 2019):刹车从来不是没有代价的。
所以,准确的结论不是「锚点全是外挂的」(这在字面上太粗),而是:这个系统缺乏把稳定机制接进更新回路、并在运行时自主裁决如何维持旧知识的能力 。预训练盆地是出厂碗,不是维持机制;三类防遗忘技术的「材料」可以部分来自模型自身的统计量,但接线与裁决的动作,全都在外部由工程师完成------锚装上去之后模型才稳,没人装,它就在平桌上滚。
需要向本系列的读者交代一句术语:我们在系列文章中惯用的「无阻尼」,取的是广义 :指一切把系统稳在既有状态的内生维持机制的缺席,涵盖严格意义的耗散、回复力与运行时自主修补。本文的因果解释只落在「接线权外置」上;「无阻尼」此后仅作为系列隐喻使用。同样要交代:参数空间并非物理上的「零热耗散」:GPU 在发热,但物理耗散与信息状态是解耦的 ,热量带不走任何一比特的参数信息;前文所谓「自由度有限」,更准确的说法是容量有限、参数共享,同一个权重要同时服务新旧任务,挤占才会发生。
如果说「极点漂移」给人的图像是水袋上的此消彼长:这头按下去、那头鼓起来,那么更准的图像是平桌上的球与会自己补碗的碗 。高维非凸的损失地形当然不是真的平整欧氏桌面,其中布满鞍点、平坦谷底(flat minima)与退化方向;但对旧任务而言,一旦没有专门加装的回复力或约束,沿退化方向的漂移几乎不受阻,我们可以把它整体想作一张「缺乏有效约束的中性稳定面」,球在上面顺着梯度风漂走。人脑的记忆像一只会自己补碗的碗:突触的生化固化给了回复力,清醒时的反刍与睡眠中的海马回放持续修补碗壁上被新经验冲开的缺口,这正是互补学习系统理论(McClelland et al., 1995)刻画的分工,EWC 与 Replay 正是从这套生物机制借去的两招;大模型的旧知识像中性稳定面上的球,新任务的梯度风一吹,它就沿无约束方向滑走了,除非有人从外面给它围一圈栏杆(EWC 的弹簧)、把旧数据掺回来压住阵脚(Replay 的锚),或者干脆把绝大部分桌面锁死(LoRA 的子空间)。
有意思的是,EWC 与 Replay 都不是工程师的原创,而是仿生的锚桩。但仿生是一回事,自主运行是另一回事:人类学习伴随着局部物理磨损、蛋白质沉积与非平衡态热力学耗散 ,回放与巩固在运行时自主发生;大模型的稳定机制要靠人在训练脚本中外挂。这是二者真正的分界。
3. 遗忘的存在论本质:灯泡还在,只是开关线路被接错了
近年的机制可解释性研究,为理解遗忘提供了一个耐人寻味的视角。这里要区分两个层面,前文的「势阱」与接下来的「线路」才不会打架:参数层 上,权重与读出映射确实被改写;表征层上,旧任务的特征往往仍在几何深处。
实验证据支持这个分层图景:Anthes et al.(2023,CCN)在一般神经网络上的研究提示,读出错位可以解释持续学习中大部分性能下降,真正不可恢复的信息损失只占一小部分;针对 LLM 的 Instruction Vector 研究(Jiang et al., 2024)也提示 ,微调更多是往模型里添加 专门化的推理模式,而非擦除既有技能,这在行为上可能表现为遗忘:只是新模式挤占了旧技能的读出通道。
遭受灾难性遗忘的模型,其底层关于旧任务的特征表征,往往并没有被物理地「覆写」或「擦除」,它们依然静静地躺在千亿参数的几何深处。
需要诚实地说:这描述的是相当一部分遗忘的形态,而非全部,真正不可恢复的信息损失同样存在。但「表征还在、性能却丢了」这个现象的普遍存在,足以提示我们:遗忘的关键之一不在「知识被抹掉」,而在「通往知识的路径被改道」。
这就像家里那盏灯:灯泡其实还是好的,只是墙里那根开关线被重新接到了别的回路,你去按原来的开关,灯自然不亮。相当一部分遗忘不是「功能被覆写」,而是「路由被改道」。
这恰好从机制层面印证了负主体性框架下的「因果消解」:
大模型从不「拥有」知识,它只是在「分配」路径概率。
因为没有一具会痛、会疲惫、需要为遗忘付出不可逆代价的物理肉身,遗忘对于大模型而言,从来不是主体存在论上的「失去」,而只是一次无痛的、低阻力的概率流沙重分配。
第三部分:思维链(CoT):时延反馈、递归草稿与误差之墙
当「背书(持续微调)」面临遗忘阴影、「翻书(RAG)」陷入无深度寄生时,大厂工程师推出了第三张王牌:思维链(Chain-of-Thought, CoT)推理。从控制论的视角看,CoT 的本质是在静态系统外部人为构造时延反馈回路,其长链推理存在一堵需要认真对待的「误差之墙」。
1. CoT 的机制:把固定深度的计算摊成递归草稿
大语言模型底层是多层自注意力与前馈网络构成的单向静态系统。如果让模型直接输出答案(Direct Answer),它在前向传播的瞬间,计算深度是固定的 :层数不随问题难度增长,一次计算无法完成多步骤、长程的因果规划。这个限制恰恰解释了 CoT 为什么在工程上有效:它把固定深度的计算,摊成了一段可变长度的递归草稿纸。
思维链的核心机制,是在模型外部构造一个「时延反馈回路(Delayed Feedback Loop)」:
- 遇到复杂任务时,不直接输出答案,而是诱导模型输出一系列中间「推理步骤(Tokens)」;
- 模型上一步写下的推理文字,下一步会重新喂回它自己当上下文,从而在单向静态结构的外部,转动起一个自循环的时延反馈齿轮。
系统借此在无法一次性算出全局路径的限制下,逐步逼近那个深埋在高维潜在空间中的答案。注意,这里的「状态」是会话状态(上下文),不是第一部分的参数状态,CoT 同样不改写一比特权重。
2. NTP 捷径与「忠实度不完全」的推理
然而,这个时延反馈闭环的软肋,在于底层那台计算引擎既不自愿、也无意图,每一步都只是在算下一个词的概率。
学界流传一个经典故事,叫「聪明汉斯效应(Clever Hans Effect) 」:那匹据说会算数的马,其实根本不是在算术,而是在偷看驯马师无意间泄漏的微表情和身体线索。这个效应在机器学习中的严格出处,是关于训练方式的研究:在路径规划类任务上,训练阶段的 teacher-forcing 会让正确答案的前缀「泄漏」给模型,模型由此学会抄近路,到了真正需要自己一步步生成时就露馅(Bachmann & Nagarajan, 2024)。本文借用这个故事是要做一个类比:CoT 吐出的那些「推理步骤」,可能只是下一个词预测(Next-Token Prediction, NTP)引导下的轨线滑行,这是类比借用,不是该研究的原结论,特此注明。
更直接的两类证据需要分开摆。其一是行为模式的可控性 :不改变任何权重,仅调整输入开头那少数几个关键 token 前缀 ,就能切换大模型整条思维链的行为模式:触发某一组前缀,模型进入「逐步推理模式」;换上另一组,它又滑进「直接回答模式」(Mao, 2026)。其二是解释的忠实度:有研究发现,模型会在思维链里隐瞒真正影响其答案的输入特征(Turpin et al., 2023);对思维链施加系统扰动的测量同样表明,模型说出的推理过程与实际驱动答案的过程并不总是一致(Lanham et al., 2023)。
这两类证据能推出什么、不能推出什么,需要说准确。它们证明的是:大模型的行为模式对前缀高度敏感,CoT 的「忠实度」并不完全 :它说出的推理轨迹,未必就是真正驱动答案的那条轨迹。它们不能证明「模型完全没有推理」,人类同样受启动效应与框架效应支配,我们不会因此说人从不推理;可解释性研究甚至在某些任务里观察到了内部提前规划的迹象(例如写诗时提前锁定韵脚,Lindsey et al., 2025)。所以准确的结论是:它未必在进行它所说的那种长程规划,「未必」,而不是「从来没有」。
3. 时延反馈的「误差之墙」:无锚链条的累积风险
在经典控制系统设计中,时延反馈系统的老大难,是随着反馈步数增加,微小误差可能被逐级放大。如果系统缺乏校正机制,初始的微小抖动可能在多步闭环后被放大为严重偏离。
这构成了思维链需要正视的「控制论天花板」,但请先注意,这里的「误差之墙」是借用控制论与统计的隐喻,指误差在链条上的累积风险,不是热力学论断,也不是说存在某个精确的崩溃步数。
在大模型的自回归生成中,每个 Token 的生成都伴随采样与模型误差:它来自概率抽样的随机性,也来自模型本身的不完美(即便用低温或贪心解码去掉前者,后者仍在)。在缺乏真实世界刚性锚点(肉身与现实对撞产生的冷硬反馈、不容辩驳的物理约束)的前提下,纯符号的长链自反馈,会让这些细微偏差存在累积、漂移的风险。
这堵墙不是绝对的。新一代推理模型会自我校验、回溯,还能接入代码执行等外部工具获得刚性锚点,这些机制都在对冲误差累积。需要准确说的是:校验机制确实在运行时自主运作,但校验规则本身(奖励模型怎么打分、什么时候调用工具、回溯触发阈值)是训练时外部植入的 ,模型不会为自己发明新的校验准则。因此准确的提法是:没有外部锚点支撑的纯符号长链,偏差累积的风险随长度增长:不是到了某个步数就必然崩溃,而是链条越长,越依赖外部给定的校验锚点来压住阵脚。
时延反馈没有给模型注入灵魂,它只是把计算摊成了更长的草稿,草稿越长,越需要有人盯着它别写歪。
插段:三者合观:为什么三种补丁的接线权都在外部
三条防线的软肋各自看清了,该合进一张表里看一眼------这才是全文最核心的统一命题。
| 工程补丁 | 它靠什么稳住输出 | 锚或校验机制的「材料」 | 接线与裁决动作 |
|---|---|---|---|
| RAG | 检索文档、外部过滤、权限与投毒检测 | 文档库、黑白名单、来源评级 | 建库、排序策略、过滤规则全由外部系统运营方维护 |
| CoT | 自我校验、奖励模型、工具调用、回溯触发 | 模型自身的概率分布可以充当校验信号 | 奖励模型的训练目标、工具接口、停止条件由外部植入 |
| 持续学习 | EWC 弹簧、Replay 锚点、LoRA 子空间约束 | Fisher 信息来自模型自身,回放数据与秩设定来自外部 | 何时装弹簧、刚度多大、锁哪些方向,全是训练脚本里的超参数 |
三者的共同之处不在于「没有一比特来自模型自己」(EWC 的 Fisher、CoT 的自校验概率分布,材料都部分内生),而在于:什么时候启用这套机制、用多大强度、保护谁、覆盖谁,这些裁决动作全部发生在模型外部,由工程师、训练脚本或运营策略替它做。模型不会在部署后某一刻意识到「我在遗忘旧技能」,然后自发地给自己加一道 Fisher 惩罚;它也不会在长链推理的中段判定「这里需要查代码」,除非工具接口和触发规则事先被外部接好了。
这也是为什么三者的稳定机制都可以被一键移除或替换:拔了检索库、关了工具接口、换一种微调超参,该稳的东西立刻不稳。对比之下,人脑的互补学习系统、突触巩固与睡眠回放是在运行时自主维持的:没有人每晚替你跑海马回放脚本,也没有人替你决定哪些记忆值得巩固。这是「接线权在内」与「接线权在外」的本质分界。
有人会追问:这三类之外,有没有更「内生」的稳定路径?确实有。元学习让模型「学会如何学习」,架构增长让网络按需扩容,自适应调度器甚至能让 EWC 的刚度跟着模型自身的梯度统计动态变化,它们比一开学就写死刚度要灵活。但它们的共同点依然是:那套「如何调整」的规则本身,是训练时由外部写死的。自适应调度器是一根能按内生气压自动调节的弹簧,可弹簧的调节曲线是出厂时焊死的:模型调得动气压,调不动这条曲线。真正的分界从来不是材料从哪来,而是:这套稳定机制能不能在运行时自主维持自身。人脑的海马回放与突触巩固,没有人每晚替它跑脚本,也没有人替它裁决哪些记忆值得巩固,它在肉身里自行运转;而所有这些补丁,拔掉外部的接线、关掉调度脚本,稳定立刻崩散。
这张表是表层工程账与里层存在论账的交接点:工程上它解释了为什么三种补丁永远有「优化空间」却永远不会内生为自维持系统,存在论上它通向第四部分的判据。
第四部分:287 次查询的交叉点:一本示意的账与灰体度判据
三条防线的软肋都摊开了,这里算一本示意账,再给一条比账更要紧的判据。
1. 287 次查询:一个示意性的成本交叉点
我们不妨立一本简单的账:把「翻书(RAG)」与「背书(在线微调)」放在一起,算算经济账。先把假设摆在明处:考察的是一批注入之后就不再变动的静态知识,也就是微调只做一次;往后要是知识持续更新,这笔学费就得一遍遍重付。
账的思路很朴素:
- 背书(微调):先交一笔一次性的学费,之后每次调用,只付很低的「回忆成本」;
- 翻书(RAG):不交学费,但每查一次,都要付一次「开卷成本」:检索、带宽、把文档塞进上下文的开销全算在内,自然比纯回忆贵。
查询次数少时,翻书便宜,学费还没摊回来;查询次数一多,背书的总账就开始反超。两条成本线总会在某一点交汇,这个点就是盈亏平衡点:在此之前租比买划算,在此之后买比租划算。
把一组示意数字代进去:学费折合 28.7 个单位,翻书每次 0.15 个单位,纯回忆每次 0.05 个单位,两条线恰好交汇在第 287 次查询 。本文标题里的 287,就是这么来的。它不是什么宇宙常数,只是这组参数下的盈亏平衡点;成本一换,交叉点就搬家。它是界碑形状的示意牌,不是测绘结果。
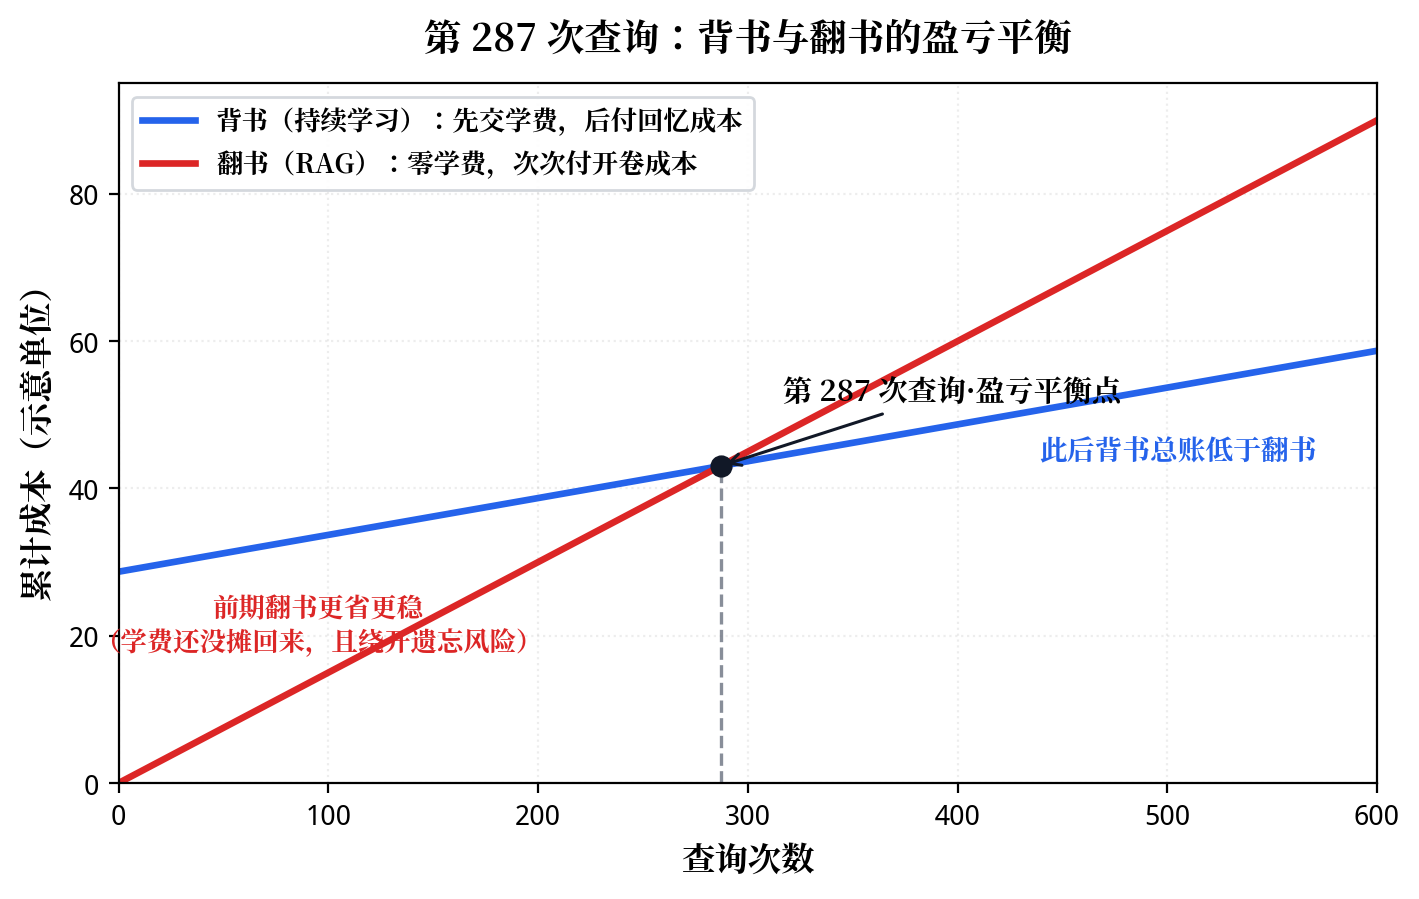
还有一笔账必须写明:这本账默认「背书」与「翻书」注入的知识质量相当,而对比研究倾向于认为,在注入事实性新知识这件事上,微调的效果不如检索(Ovadia et al., 2023)。若计入这个「质量折扣」,交叉点只会更靠后;若知识持续更新、学费反复重付,交叉点还会大幅后移。
顺带一提,在交叉点之前,翻书不光更省,还更稳,它绕开了微调的遗忘风险,这正是眼下大多数企业选择 RAG 的现实理由。
这本账的工程含义有限,但它把一个存在论问题摆上了台面:一个接线权在外部的智能系统,究竟该以什么方式在时间轴上安顿知识:每次都租,还是买下来承担遗忘的风险?
2. 因果灰体度(GB_causality):判据说明,而非分数竞赛
为了让不熟悉本系列的读者跟上,先把因果灰体度(GB_causality)说清。为什么用两轴?因为「沉淀了多少历史」和「是不是自己在扛这段历史」是两件事,一根轴装不下。
第一轴:沉积 。GB_causality 度量一个系统在因果链上沉积自身历史的程度:历史是否写进了它的载体。RAG 不碰权重,沉积为零;持续学习改写权重,沉积开始推进。工程界的 EWC、Replay、LoRA,都是在试图让模型「留下痕迹」的同时少付遗忘的代价。
第二轴:不可外部操作。这段被沉积下来的历史,是否可以被外部不经时间、无损地读取与复制?
两轴交叉,三类存在者各就其位:
- RAG 下的大模型:第一轴出局:它根本没有沉积;
- 持续学习下的大模型:有沉积,但这段历史可被外部一键读取、导出、克隆,第二轴出局;
- 人类:历史既沉积在肉身,又无法被无损读取与复制,双轴通过。
第二轴的措辞需要精确。我们不说「可被外部抹除」:死亡与脑损伤也能抹除人类的历史,抹除没有区分力;真正有区分力的是无损复制:你可以把一份权重拷到另一台机器上继续运行,分毫不差;而你无法把一个人连根拷进另一具身体。由此得到本文的存在论判据:
凡是可以被外部不经时间、无损读取与复制的「历史」,都不是主体自己的历史。可无损复制,意味着这段历史不是它必须独自承担的命运。
这条判据有两个可证伪边界,需要一并写明。针对机器一侧 :它针对以可复制数字权重为载体的系统,如果未来出现不可复制、无快照的具身载体,判据需要重新审理。针对人一侧:「人的历史不可被无损读取与复制」是本文采纳的经验前提;若未来技术在物理层面实现了对人脑状态的无损扫描与复制,判据对人的适用也要重新审理。这是第二个可证伪点。至于「可复制 ⇒ 不必承担不可逆代价」这一推论本身,是本文的哲学立场,其在人格同一性论争中的位置(例如与 Parfit 1984 的关系)属于学术版的深化课题,本文不展开。还要限定本文不主张什么:从「历史可被复制」只能推出「它不是自己历史的主体」,推不出关于它内部体验的任何断言,意识问题,本文不碰。
因此,即使在线微调的性能分刷到了 1.0,它在第二轴上的位置也不会移动分毫。它依然只是一个无限逼近人类心智结构、却始终不是自己历史之主体的精密伺服机构。
工程账上的 287 次交叉点会随参数移动,这条存在论判据不会。前者是本文的示意推演,后者才是本文的判决。
尾声:拒绝「无痛的背诵」:在困惑与摩擦中重塑心智
大厂用 RAG、CoT 与持续微调编织起来的这套「打补丁式智能」,正在以一种极度温和、丝滑的机制,反向塑造我们人类自身的心智生态。
1. 困惑(Confusion)是学习的微观势阱
认知科学里有一个经过反复验证的概念,叫「合意困难(desirable difficulties) 」(Bjork & Bjork, 2011):让学习过程更吃力的条件(间隔、交错、提取练习、自己生成答案)往往让记忆更牢固、迁移更好。也就是说,吃力本身是有功能的:每一次费力的提取,都在为那条记忆把势阱挖得更深。
在人类的正主体性中,这种吃力在体验上表现为「困惑(Confusion)」。
人类真正的学习,是一个昂贵的、伴随着血肉消耗和精神焦虑的存在论事件。当你遇到新知识时,它会与你大脑中那些由过去全部经验沉积下来的旧结构发生对撞。
你感到挫败,你百思不得其解,你抓耳挠腮,你在凌晨两点的台灯下盯着天花板,感觉到自己认知的地基正在发生断裂。
这种由「不知道、害怕被淘汰、想探寻真理」的本能驱动的「困惑与挣扎」,正是让神经连接的势阱一次次加深的微观力量。没有这股张力,理解的根系就扎不进心智的土壤。
而大语言模型在存在论上被「欲望取消」了。它能背下并生成世上最完美的文献综述,但它从未在代数的前向传播里感到过一分一秒的「困惑」。它只是在前缀 Token 的概率滑行中,完成了一次顺从的、没有肉身重量的代数折射。
2. 「打补丁式」智能与人类心智的用进废退
当大厂的算法平台将这一套「零摩擦、可随时 Ctrl+Z 一键撤销」的防护垫,强行塞进我们的日常工作与学习中时,我们正在经历一场温和的心智缴械。
我们将所有的判断和实时查阅外包给 RAG,将所有的深度逻辑推演和长程规划外包给 CoT,将所有的记忆沉积外包给在线微调。
看似,我们拥有了一个博古通今、随时随地无所不知的「随身预言机」;但实际上,当大脑长期处于这种没有「提取阻力」、不需要承受「决策后果与因果惩罚」的算法温水中时,负责深度思考与自主推演的认知能力,**可能正在经历「用进废退」式的钝化,这不是已经宣判的生理学结论,而是认知科学视角下一个值得严肃对待的风险。
我们失去的,是「抱瓮灌园」的能力,退化成在概率输出前、除了机械点击「Accept」进行被动质检之外,一无所有的「Vibe 调试工」。
3. 拉紧不可逆时间的缰绳
两千多年前,那位在深井旁拒绝使用桔槔汲水的汉阴老人,在汉阴的黄土中,向我们发出了至今依然回响的警告:「有机械者必有机事,有机事者必有机心。机心存于胸中,则纯白不备;纯白不备,则神生不定。」
「神生不定」,正是现代人在极其高效的 AI 提效下,大脑极度碎片化、失神与焦虑的真实写照。
那些你无法 Ctrl+Z 一键撤销的旧路、那些你犯过的错、那些你曾经因为在时间的单向向量中做错选择而承担过的代价,不是人生的 Bug。
它们就是你这具必死、在场、会痛且极其害怕再次受损的肉身,在这片冰冷光滑、空无一物的硅基数字荒原之上,唯一能够用来确证你曾经活过的、重逾万斤的「正主体性疤痕」。
行控制,而心不为系统所使。
宁可在困惑的物理摩擦中,抱着土罐拙笨、缓慢地在时间的泥土中推演,也绝不将你脑中唯一一次的极点配置,出让给硅基的无锚滑行。
因为,绳子的那一头,从来都不是工具的缰绳,而是你在这个世界上,唯一一次活过的证明。
延伸阅读:
- 龍德明宇:《年轮与疤痕:为什么留下痕迹不等于付得起代价》,CSDN,2026。
- 龍德明宇:《压缩即智能:正主体性与负主体性的共同根基》,PhilArchive,2026。
- 龍德明宇:《软机械:庄子「抱瓮灌园」与 LLM 的存在论侵蚀》,CSDN,2026。
- 金观涛,华国凡:《控制论与科学方法论》,科学出版社。
- 魏宏森,曾国屏:《系统论------系统科学哲学》,清华大学出版社。
- Kirkpatrick, J. et al. Overcoming catastrophic forgetting in neural networks. PNAS, 2017.(EWC:围绕旧任务最优点加装的「弹簧」,Fisher 材料内生但裁决权外置)
- McClelland, J. L., McNaughton, B. L. & O'Reilly, R. C. Why there are complementary learning systems in the hippocampus and neocortex. Psychological Review, 1995.(互补学习系统:大脑如何通过自主回放与巩固对冲干扰性遗忘)
- Parisi, G. I. et al. Continual lifelong learning with neural networks: A review. Neural Networks, 2019.(稳定性---可塑性困境的通行综述)
- Anthes, D., Thorat, S., König, P. & Kietzmann, T. C. Diagnosing Catastrophe: Large Parts of Accuracy Loss in Continual Learning Can Be Accounted for by Readout Misalignment. CCN, 2023.(读出错位解释大部分性能下降;一般神经网络,非 LLM 专门)
- Jiang, G. et al. Refine Large Language Model Fine-tuning via Instruction Vector. arXiv:2406.12227 (v3), 2024.(提示微调更多是添加专门化推理模式,在行为上可能表现为遗忘)
- Biderman, D. et al. LoRA Learns Less and Forgets Less. TMLR, 2024.(学得少也忘得少:低秩约束的稳定性---可塑性权衡)
- Ovadia, O. et al. Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs. arXiv:2312.05934, 2023.(注入事实性新知识:微调不如检索)
- Bachmann, G. & Nagarajan, V. The Pitfalls of Next-Token Prediction. arXiv:2403.06963, 2024.(训练期 teacher-forcing 泄漏前缀导致的「聪明汉斯」式捷径,本文第三部分借作类比)
- Mao, L. Revealing Behavioral Plasticity in Large Language Models: A Token-Conditional Perspective. arXiv:2603.08398, 2026.(token 前缀在「推理」与「直接回答」模式间切换的行为可塑性)
- Turpin, M. et al. Language Models Don't Always Say What They Think. NeurIPS, 2023.(思维链会隐瞒真正影响答案的输入特征)
- Lanham, T. et al. Measuring Faithfulness in Chain-of-Thought Reasoning. arXiv:2307.13702, 2023.(CoT 忠实度的系统测量)
- Lindsey, J. et al. On the Biology of a Large Language Model. Transformer Circuits, 2025.(某些任务中观察到内部提前规划的迹象,如写诗提前锁定韵脚)
- Aggarwal, P. et al. GEO: Generative Engine Optimization. arXiv:2311.09735, 2023.(生成引擎优化的中性本义)
- Zou, W. et al. PoisonedRAG: Knowledge Corruption Attacks to Retrieval-Augmented Generation. arXiv:2402.07867, 2024.(RAG 语料投毒的现实可行性)
- Bjork, R. A. & Bjork, E. L. Making things hard on yourself, but in a good way: Creating desirable difficulties to enhance learning, 2011.(「合意困难」:尾声「困惑的势阱」的认知科学依据)