作者:来自 Elastic Orestis Floros
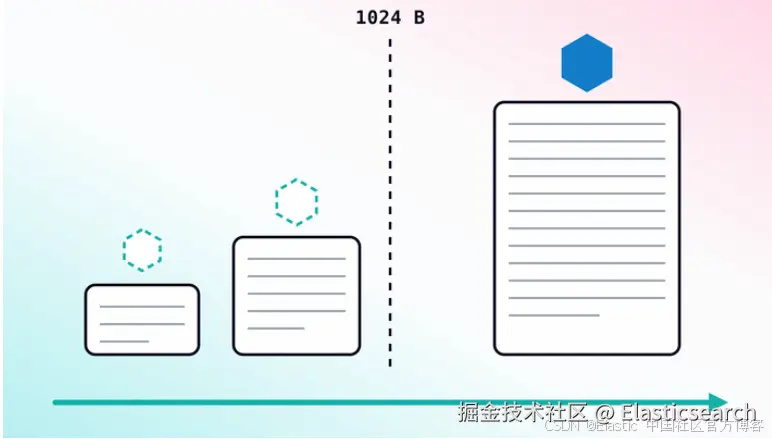
Elastic Agent 9.5 会利用已经获取的字节来构建小型日志文件的身份信息,然后随着文件增长并超过 1024 字节,将其重新关联,因此不会对其进行重复摄取。
Elasticsearch 会在摄取时将原始日志转换为结构化、可搜索的数据。按照收集和分析日志教程,可以端到端地了解整个过程。现在可以开始免费云试用,或者在你的本地机器上试用 Elastic。
Elastic Agent 9.5 会读取小于 1024 字节指纹阈值的日志文件。增长型指纹会通过对文件当前已有的字节进行哈希来识别每个文件,并且当文件超过该阈值时,读取偏移量会继续保留,因此不会重复摄取任何内容。在 9.5 之前,如此小的文件没有稳定的身份标识,因此只有在文件增长后才会被读取。
为什么小型日志文件会被跳过
Filestream 需要为它读取的每个文件提供一个稳定的标识符,以便跟踪每个文件已经读取到什么位置。在早期版本中,我们使用 inode 编号等文件系统元数据。但这还不够。例如,ext4 等文件系统可以在文件删除后重新使用 inode 编号,从而导致新文件被误认为是旧文件。这就是为什么我们引入了指纹身份标识,并在 9.0 中将其设为默认方式。
指纹识别意味着通过文件内容而不是元数据来识别文件。默认情况下,会对前 1024 个字节进行哈希,并将其用作文件的唯一身份标识。一个注册表会跟踪我们遇到的所有 ID,即使这些 ID 超出了 agent 进程的生命周期。重启机器、更换底层设备、通过网络托管文件,这些都没有关系;Elastic Agent 都会记住它们。
主要的问题在于,如果文件本身没有 1024 个字节,我们就无法对文件的前 1024 个字节进行哈希。想象一下,一个关键的 Kubernetes Pod 在启动时发生崩溃,而它输出的小型日志恰恰是导致该崩溃信息无法到达 Kibana 仪表板的原因。
到目前为止,我们主要通过配置来解决这个问题:不使用 1024 字节,而是可以将其设置为 512。或者 256。甚至更低。不过,每降低一次阈值,就意味着可用于区分不同文件的内容变少了。因此,不同文件更有可能共享相同的指纹材料,从而导致生成的文件身份标识稳定性降低。这正是新的增长型指纹可以发挥作用的地方。
增长型指纹如何将文件身份标识分成两个阶段
随着增长型指纹模式的引入,filestream 会根据文件大小将文件身份标识分成两个阶段。当文件小于 1024 字节的指纹阈值时,它处于 "增长" 模式。Filestream 会使用文件当前包含的全部 内容生成 哈希来识别它。当文件增长超过该阈值后,它会被提升为静态指纹,也就是在 9.5 之前它本来会获得的指纹。
那么文件身份标识冲突怎么办?两个内容完全相同的文件确实会共享一个增长型指纹,但这种情况只会持续到它们保持相同内容为止:一旦它们的内容出现差异,它们的指纹也会随之不同。
让我们进一步看看内部实现。先从一个简单的 13 字节文本文件开始:
bash
`

1.  mkdir -p /tmp/demo
2.  echo 'Hello world!' > /tmp/demo/file.txt

`AI写代码
然后启动 Filebeat ------ Elastic Agent 中负责收集日志文件的组件 ------ 并使用一个最小配置:
bash
`
1. cat >/tmp/demo/filebeat.yml <<YAML
2. path.home: /tmp/demo
4. filebeat.inputs:
5. - type: filestream
6. id: growing-demo
7. paths: [ "/tmp/demo/file.txt" ]
9. output.file:
10. path: /tmp/demo/out
12. logging.level: debug
13. YAML
15. filebeat -c /tmp/demo/filebeat.yml
`AI写代码阶段 1:13 字节文件的增长型指纹
几秒钟后,filestream 会发现我们的新文件。深入查看调试日志(这里为了简单起见进行了大幅缩减),可以看到:
json
`{"log.level":"debug","log.logger":"input.filestream.prospector","message":"A new file /tmp/demo/file.txt has been found"}`AI写代码我们还可以直接检查 filestream 写入 data/registry/filebeat/log.json 的注册表预写日志(WAL):
bash
`
1. {
2. "k": "filestream::growing-demo::fingerprint::f04f9d5ad8c21a115cd207488c6aaadeb4d7db581ea675f48c7f5d23e038c805",
3. "v": {
4. "cursor": {
5. "eof": false,
6. "offset": 13
7. },
8. "meta": {
9. "fingerprint_len": 13,
10. "identifier_name": "fingerprint",
11. "source": "/tmp/demo/file.txt"
12. }
13. }
14. }
`AI写代码k 字段是 filestream 用于识别该文件状态的注册表键。它的最后一部分是指纹哈希,我们可以根据文件内容重新计算得到:
bash
`

1.  $ xxd -p /tmp/demo/file.txt | tr -d '\n' | sha256sum
2.  f04f9d5ad8c21a115cd207488c6aaadeb4d7db581ea675f48c7f5d23e038c805  -

`AI写代码
仍处于阶段 1:随着文件增长,指纹也会发生变化
让我们向文件中写入更多行:
bash
`for i in {1..70}; do echo "Hello $i" >> /tmp/demo/file.txt; done`AI写代码当文件仍然小于阈值时,Filestream 会检测到写入操作:
json
`{"log.logger":"input.filestream.prospector","message":"File /tmp/demo/file.txt has been updated","operation":"write"}`AI写代码在注册表中,现在这个更大的文件拥有了新的指纹,并且 fingerprint_len 为 634 字节:
bash
`
1. {
2. "k": "filestream::growing-demo::fingerprint::cb8e361971e7ba91e343d1b5bd8e6560be0bdadbbed2b2f89a6c50099e972d63",
3. "v": {
4. "cursor": {
5. "eof": false,
6. "offset": 634
7. },
8. "meta": {
9. "fingerprint_len": 634,
10. "identifier_name": "fingerprint",
11. "source": "/tmp/demo/file.txt"
12. }
13. }
14. }
`AI写代码更新后的键以十六进制指纹材料的 SHA-256 哈希结尾:
bash
`

1.  $ xxd -p /tmp/demo/file.txt | tr -d '\n' | sha256sum
2.  cb8e361971e7ba91e343d1b5bd8e6560be0bdadbbed2b2f89a6c50099e972d63  -

`AI写代码
阶段 2:提升为静态的 1024 字节指纹
现在让我们继续增大文件,使其超过 1024 字节的阈值:
bash
`for i in {1..500}; do echo "More messages $i" >> /tmp/demo/file.txt; done`AI写代码当文件超过该阈值后,filestream 会再次报告一次写入操作:
json
`{"log.logger":"input.filestream.prospector","message":"File /tmp/demo/file.txt has been updated","operation":"write"}`AI写代码随着增长型指纹被提升为静态形式,注册表键最后一次发生变化:
bash
`
1. {
2. "k": "filestream::growing-demo::fingerprint::c8e252d76d621a02161f92e7a59d1617e3079db666cefd6cfcab106329082d1e",
3. "v": {
4. "cursor": {
5. "eof": false,
6. "offset": 9526
7. },
8. "meta": {
9. "identifier_name": "fingerprint",
10. "source": "/tmp/demo/file.txt"
11. }
12. }
13. }
`AI写代码提升后的指纹会对前 1024 个字节进行哈希。这与 9.5 之前的 Filebeat 为该文件计算出的结果完全相同:
bash
`

1.  $ head -c 1024 /tmp/demo/file.txt | sha256sum
2.  c8e252d76d621a02161f92e7a59d1617e3079db666cefd6cfcab106329082d1e

`AI写代码
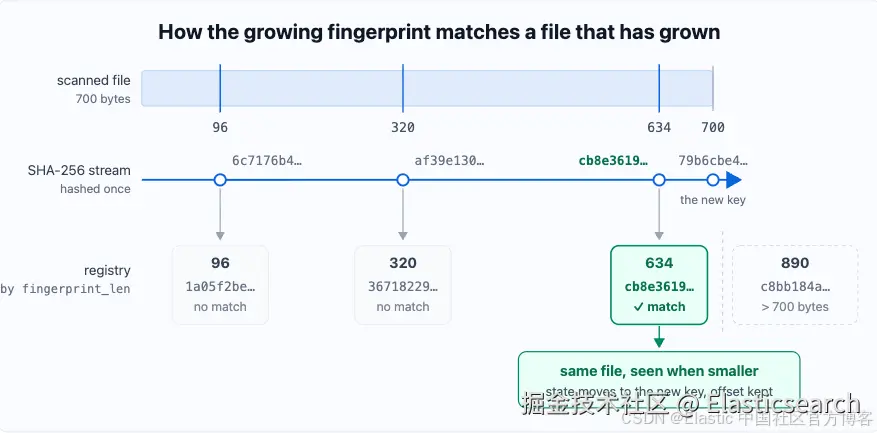
Filestream 如何将增长型指纹与现有文件进行匹配
在每次扫描期间,filestream 会按照以下顺序确定文件的身份:
-
查找与文件当前指纹完全匹配的注册表键。这部分没有发生变化。
-
如果没有找到对应的键,则在增长型条目中搜索更短的指纹,并优先尝试相同的路径。前缀匹配意味着 filestream 之前已经见过这个文件,当时文件包含的字节更少。
-
将现有的注册表状态移动到新的键,同时保留读取偏移量。
你可能已经注意到,从上面的注册表条目中可以看到,我们并不存储原始文件内容。这是我们最初采用的方法,但注册表的大小很快就会急剧膨胀。相反,我们使用 SHA-256 哈希作为注册表键,并存储 fingerprint_len,用于记录该指纹所代表的原始字节数。这样可以将每个条目所需的存储空间减少近 100 倍。
当 filestream 查找前缀匹配时,它首先按照长度对增长型指纹进行分组。然后,它将扫描文件的十六进制指纹材料通过 SHA-256 进行流式处理,并在每个分组长度处保存摘要快照。Filestream 只会将每个快照与相同长度的已存储哈希进行比较。匹配意味着已存储的指纹是扫描文件的一个前缀。
增长型指纹基准测试:10,000 个日志文件下的内存和 CPU
那么,这些额外工作究竟会带来多少成本?我们对 Elastic Agent 9.5 摄取数千个超过阈值和低于阈值的文件进行了基准测试。为了保证基准测试公平,我们将增长型指纹与将指纹大小降低到 128 字节这一变通方案进行比较。否则,我们比较的将是"做某件事"和"什么都不做",而什么都不做总是会胜出。
基准测试运行在一台 r8id.2xlarge EC2 实例上(8 个 vCPU,Ubuntu 24.04),并报告 5 次运行的中位数。内存数据是 Elastic Agent 的匿名内存,由内核通过 cgroups 报告。
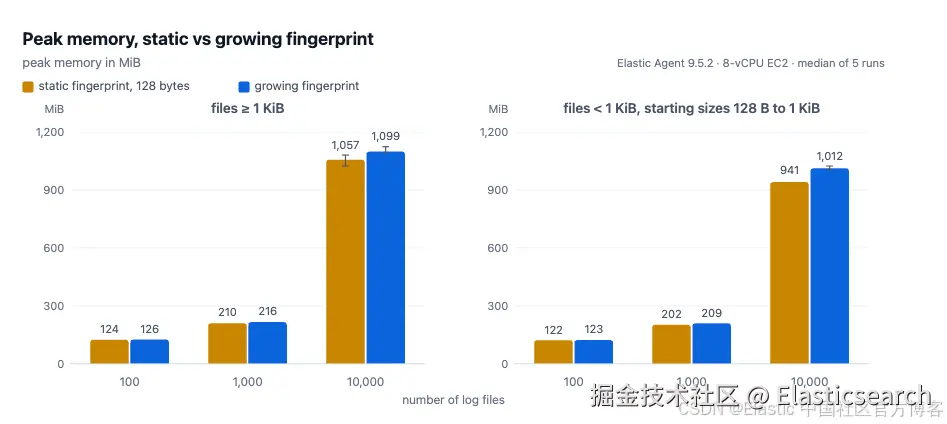
在 10,000 个文件的情况下,两种模式的对比如下。
| 指标 | 条件 | 128 字节静态 | 增长型 | 差异 |
|---|---|---|---|---|
| 峰值内存 | 文件大于 1 KiB | 1,057 MiB | 1,099 MiB | +4% |
| 峰值内存 | 文件小于 1 KiB | 941 MiB | 1,012 MiB | +8% |
| 峰值内存 | 文件跨越阈值 | 968 MiB | 1,016 MiB | +5% |
| 稳态内存 | 文件大于 1 KiB | 291 MiB | 290 MiB | 无 |
| 稳态内存 | 文件小于 1 KiB | 270 MiB | 322 MiB | +52 MiB |
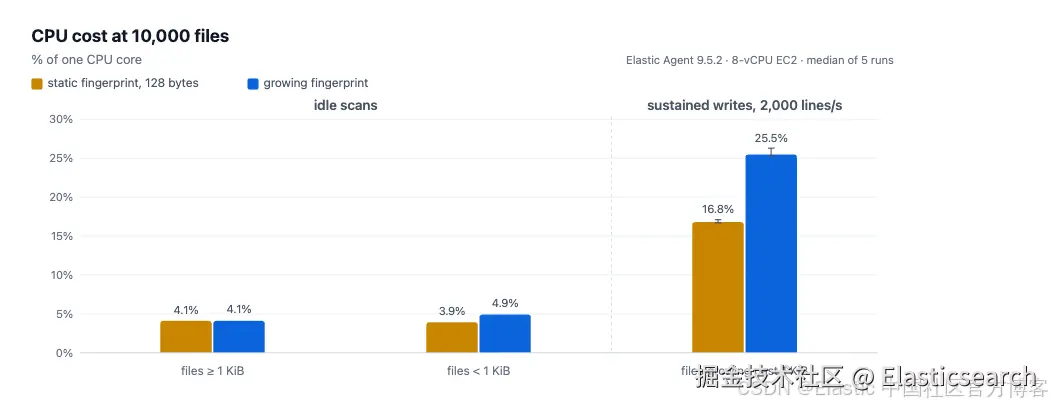
| CPU,单个核心 | 文件大于 1 KiB,空闲 | 4.1% | 4.1% | 无 |
| CPU,单个核心 | 文件小于 1 KiB,空闲 | 3.9% | 4.9% | +1.0 个百分点 |
| CPU,单个核心 | 文件跨越阈值 | 16.8% | 25.5% | +8.7 个百分点 |
| 稳态注册表大小 | 文件大于和小于 1 KiB | 8.6 MB | 8.6 MB | 无 |
100、1,000 和 10,000 个日志文件下的内存使用情况
在 100 个和 1,000 个文件的情况下,128 字节静态指纹和增长型指纹之间只有几 MiB 的差异。在 10,000 个文件时,两者的峰值相差几个百分点,但唯一持续存在的差异出现在低于阈值的文件上:超过阈值后,两种模式最终都稳定在彼此相差不到 1 MiB 的水平。
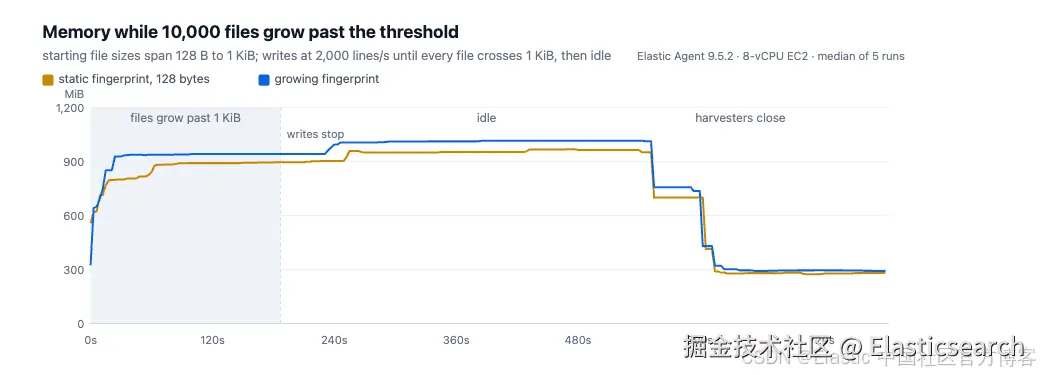
最消耗资源的情况发生在指纹仍然不断变化的时候。我们创建了 10,000 个低于阈值的文件,并以每秒 2,000 行的速度持续向这些文件追加内容,直到每个文件都超过阈值。这个过程会反复执行前缀查找路径,并将注册表状态移动到新的键。文件超过阈值并且其 harvester 关闭后,这部分额外的内存开销就会被释放:两种模式最终都稳定在 300 MiB 以下,两者之间仅相差几 MiB:
有写入和无写入情况下的 CPU 使用率
CPU 方面的影响更大:每次扫描都会重新对低于阈值的文件的全部内容进行哈希,而不是固定的 128 字节前缀。即使没有新的写入,这也会额外占用一个百分点的单个 CPU 核心;而在上面指纹不断变化的工作负载下,额外占用率接近 9 个百分点:
9.6 中的变化
我们已经在着手改进这些数据。在当前的 main(未来的 9.6 版本)中,相同基准测试的峰值内存使用量不到原来的一半,而增长型指纹在稳态下的额外开销,无论是内存还是 CPU,都大约降低了一半。
升级和回滚
增长模式在 9.5 中默认启用,通过 file_identity.fingerprint.growing 进行配置。将其设置为 false 即可恢复 9.5 之前的行为。升级时不需要进行迁移;现有的注册表条目可以继续工作,而之前太小的文件会在下一次扫描时被读取。
也可以进行回滚,但你会回到 9.5 之前的行为:小型文件会被忽略,当它们超过阈值后,会被重新摄取。
增长型指纹对你的日志文件意味着什么
Elastic Agent 9.5 默认会摄取小于 1024 字节的日志文件,无需任何配置,也无需等待文件增长。当内容相同的小型文件共享身份标识时,只要它们的内容出现差异,这些身份标识就会自行解决,而静态指纹无法做到这一点。成本仍然很小:在实际的节点规模下,增长型指纹与之前的变通方案几乎没有可感知的差异;在 10,000 个文件的工作负载下,它只会增加几个百分点的内存使用量,以及个位数百分比的单个 CPU 核心使用率。升级时请记住,之前不可见的小型文件会被视为新文件,无论它们已经存在于你的路径中多长时间。如果这种权衡不适合你,可以设置 file_identity.fingerprint.growing: false 来恢复旧行为。
参考资料
-
如何为 filestream 选择文件身份标识介绍了所有身份标识选项及其权衡。
-
增长型指纹参考介绍了相关设置以及回滚时需要注意的问题。
-
PR #50566是该功能的实现,PR #51784是注册表优化;PR #51863和PR #51914则在 9.5.2 中减少了每次扫描的内存分配以及指纹保留。
-
9.6 中即将推出的优化包括:PR #51278将空闲 harvester 暂存起来,而不是为每个打开的文件都保留一个 goroutine;PR #51694对每个文件只进行一次扫描;PR #52476在原地规范化已发布的事件。PR #52103将多行超时 goroutine 替换为读取 deadline,但该优化未在这些基准测试中进行测试。
原文:Growing fingerprint: file identity for log files under 1 KiB | Elastic Observability Labs