9 月 10 日,我在沈阳参加了一场数据库技术开放麦,我自己先讲了 Agent 时代数据库的变化,然后坐在台下听了几位数据库资深专家聊技术架构演进。茶歇的时候,我们围坐在一起讨论的其实是同一个问题:核心业务系统的数据库,下一步该往哪种架构走。
这篇文章我想来聊聊我的观点,先盘一盘集中式和分布式各自的痛点,再对比一下国内外共享集群这个路线的状况,然后看一家国产厂商的三种架构布局,最后聊聊一个更有意思的问题:在这些熟悉的面孔之外,数据库架构是不是还有另一个选项。
01. 集中式的可靠性账,共享集群的扩展性账
集中式架构的短板,首先是可靠性。这里说的集中式,指单机加主备这类形态(包括基于日志复制的传统主备,也包括用 Raft 这类共识协议做强同步的三节点集群)。传统异步主备,主库挂了切备库,切换有秒级时延,极端场景下存在数据丢失风险,RPO 做不到 0。Raft 三节点能把丢数问题解决,但本质上仍是一主多备:写流量全压在主节点上,没有对等多写,备节点平时基本闲置,花钱买来的算力在那站岗。对普通业务这也许足够用,对核心交易不行,一次丢数就是一次资损。其次是扩展性,主节点性能有物理天花板,压力上来只能换更贵的机器。还有一层隐蔽的账:主库压力过高时备库同步滞后会被放大,读写分离场景下数据不一致的风险一直都在。
共享集群(Shared-Disk)把可靠性这道题解了。多节点对等挂载共享存储,缓存融合协调并发访问,节点故障其他节点无缝接管,RPO=0、RTO 秒级,应用完全透明。这就是为什么它能成为核心交易的标配架构。但它相对分布式架构,短板同样明显:可扩展性。以某国产共享集群为例,商用版本支持 4 节点,官方口径设计上限 64 节点;存储侧企业版规格是 PB 级、不设硬性上限,实际落地案例里深圳电子证照系统约 14TB 数据平稳运行。这个量级对绝大多数企业的核心系统绰绰有余。但天花板是客观存在的:当数据规模奔着 PB 甚至 EB 级去的时候,共享存储这一条腿会先吃力。缓存融合的全局协同开销随节点数增长,节点规模有实际上限;数据全部落在共享存储上,容量越往上走,高端存储的成本曲线会先于技术上限撞墙;它终究不能像分布式那样,靠堆普通机器近乎无限地横向扩展。
分布式(Shared-Nothing)把扩展性这道题解了。这里说的分布式,不是分库分表中间件那种把难题甩给应用的土办法,而是数据按分片规则拆到多个节点、由内核用分布式事务(2PC)和共识协议保证一致性的原生架构,扩展时加机器就行,容量和吞吐接近线性增长。代价在别处:跨节点事务要付网络往返的时延成本,跨分片的关联聚合效率天然吃亏,节点多了之后运维复杂度指数级上升。还有一个隐性约束,数据分布一旦定了,业务侧就得理解它,分片键怎么选、热点怎么躲,新业务上线时老的分片策略还合不合身,都是要持续回答的问题。
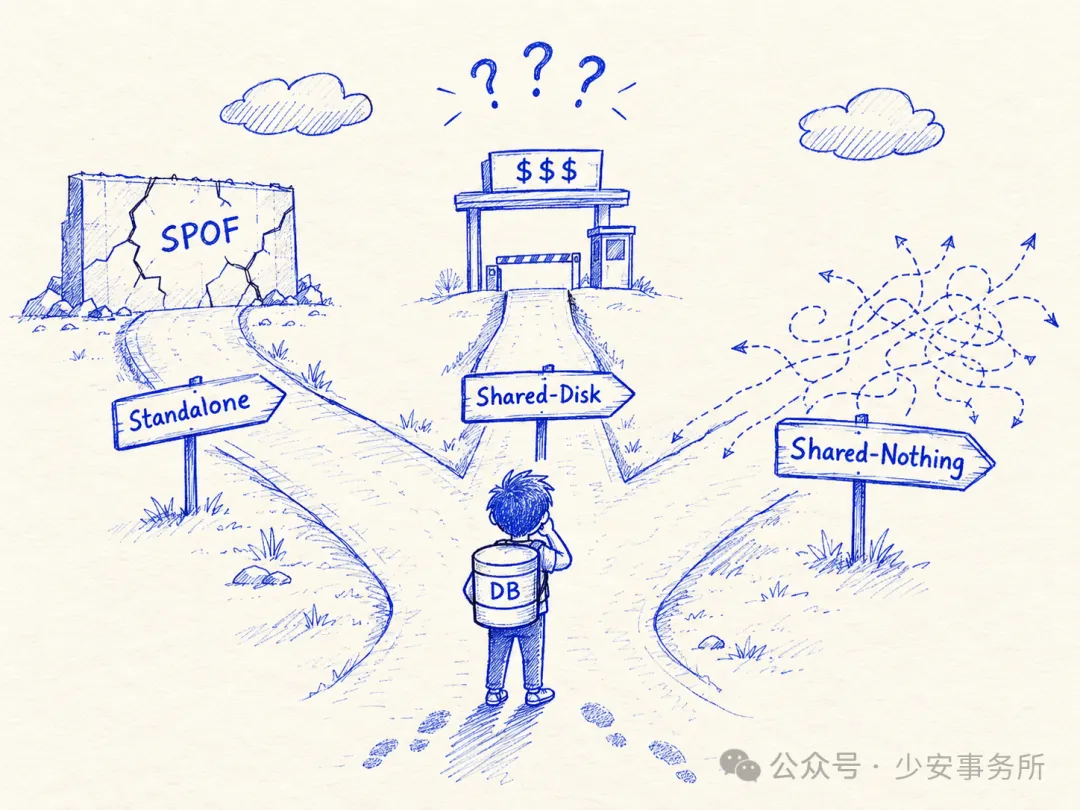
所以架构选型长期是个三选一的困局:要可靠性舍弃扩展,要扩展就要增加改造成本。那么问题来了,这个困局还有没有其他解?
02. Oracle RAC 与国产共享集群
共享集群这条路线的全球标杆是 Oracle RAC,2001 年随 Oracle 9i 推出,用 Cache Fusion 统治核心交易系统二十多年。国内这几年正面硬刚 RAC 的共享集群产品也冒了出来,一起看下:
| 维度 | Oracle RAC | 国产共享集群(以崖山共享集群 YAC 为例) |
|---|---|---|
| 架构血统 | 2001 年推出,Cache Fusion 缓存融合 | 全自研内核,自研聚合内存技术 |
| 多写一致性 | 全局缓存服务,成熟稳定 | GRC/GCS/GLS 全局协同加三层 SCN,RPO=0、RTO<10 秒 |
| 性能水平 | 行业基准 | 4 节点 TPC-C 突破 618 万 tpmC(官方披露的实验室测试数据),官方称同等硬件超国际主流 30% |
| 扩展效率 | 节点扩展存在递减 | 3000 仓实测每节点扩展率约 80%(官方测试结果) |
| 生态兼容 | 本体 | 语法、语义、PL/SQL、工具生态四层对齐 Oracle,应用迁移平均 4 到 6 周 |
| 成本结构 | 许可加高端存储,TCO 高 | 2 台服务器加 1 台存储对等替换 RAC 两节点,TCO 约为分布式方案的 1/3 到 1/6 |
| 供应链安全 | 受出口管制与商业策略影响 | 内核代码自主率 100%,通过国家级安全可靠测评 |
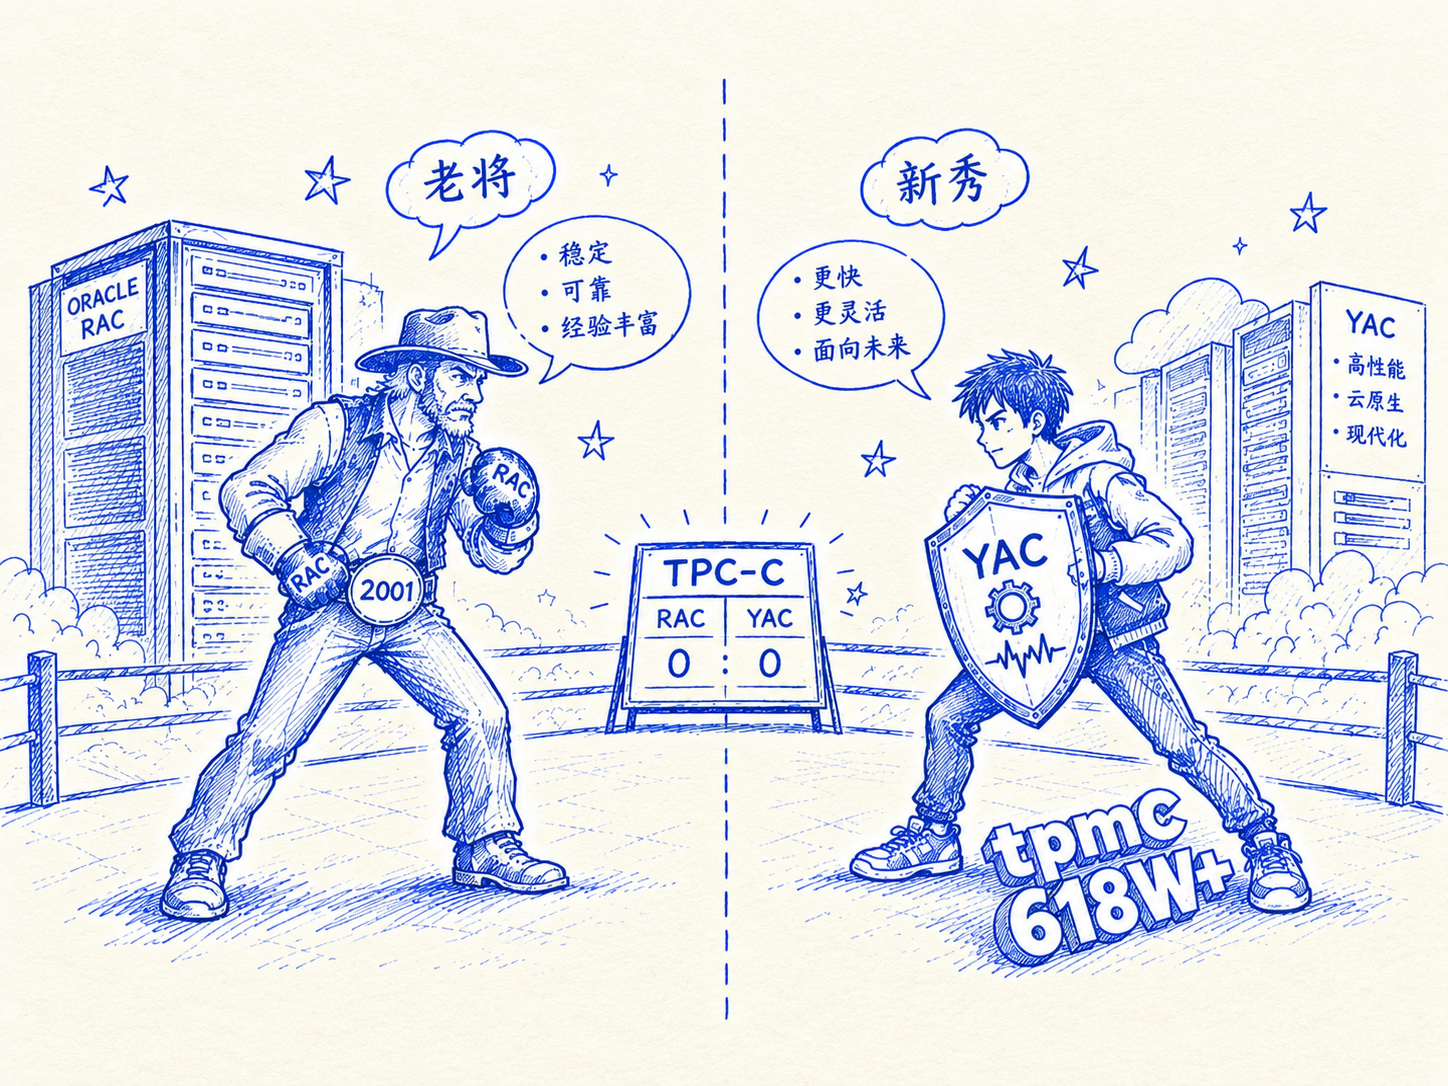
国内做共享集群的不止一家,金仓数据库 KES RAC、达梦数据 DMDSC、南大通用 GBase 8s SSC 也都在对标 RAC。但整体看,国产共享集群的打法很一致:不重新定义规则,而是把 RAC 的体验对等平移过来,再用自研内核和成本优势换替代空间。公开案例里,某银行 A 类核心系统从 Oracle RAC 迁到国产共享集群,两个核心系统只改了一行代码,两周完成全量迁移验证。这在五年前是不可想象的。
03. 崖山的集中式和分布式都过了国测
具体以崖山数据库为例,来看看国产数据库对于架构演进的选择。
崖山数据库(YashanDB)是深圳计算科学研究院研发、崖山科技商业化的产品,樊文飞院士领衔,内核 100% 自研。单机主备、共享存储集群、分布式集群三种部署形态,跑在同一套统一内核上。
2025 年 8 月 22 日,崖山数据库管理系统 V23(集中式)通过中国信息安全测评中心与国家保密科技测评中心的安全可靠测评;2026 年 5 月 26 日,崖山分布式数据库管理系统 V23 通过安可测评,拿到目前数据库品类最高等级Ⅱ级。一年内集中式和分布式双形态先后过测,这个速度在国产数据库里不多见,崖山也是同期通过最高等级测评的厂商中最年轻的面孔。此外,共享集群高可用技术等三项核心技术通过了中国电子学会的成果鉴定,被评为国际领先水平。崖山共享集群 YAC 已在金融、能源、央国企、交通等核心场景中规模验证。
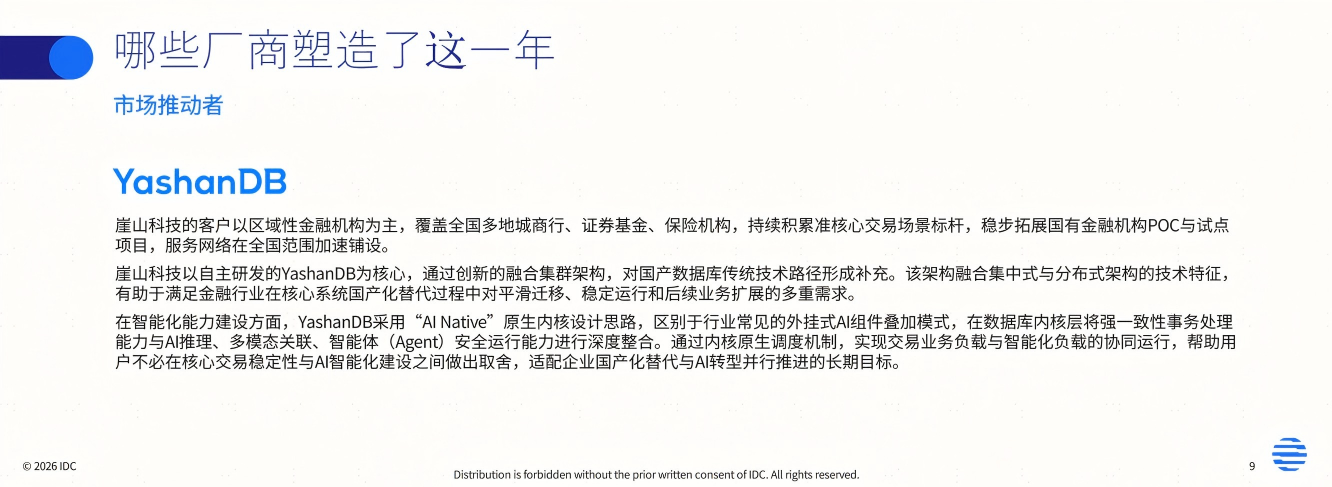
近日,IDC 发布《市场份额:中国金融行业本地部署集中式事务型数据库市场份额,2025》报告,YashanDB 成功入选 2025「市场推动者」核心代表厂商之一。
关于崖山的技术底气和路线选择,我在之前的文章 《重新认识崖山数据库:国测Ⅱ级背后的技术底气与AI野心》 中详细写过,这里不重复。一句话概括那篇文章的核心观点:比过国测本身更值得关注的,是崖山从全自研内核到融合集群架构、再到 AI 就绪数据底座的独立演进路线。
04. 又一选项浮出:融合集群
在 YashanDB 技术开放麦沈阳站的现场,我找到了这个问题的答案。崖山给共享集群规划的下一步进化架构,叫融合集群。
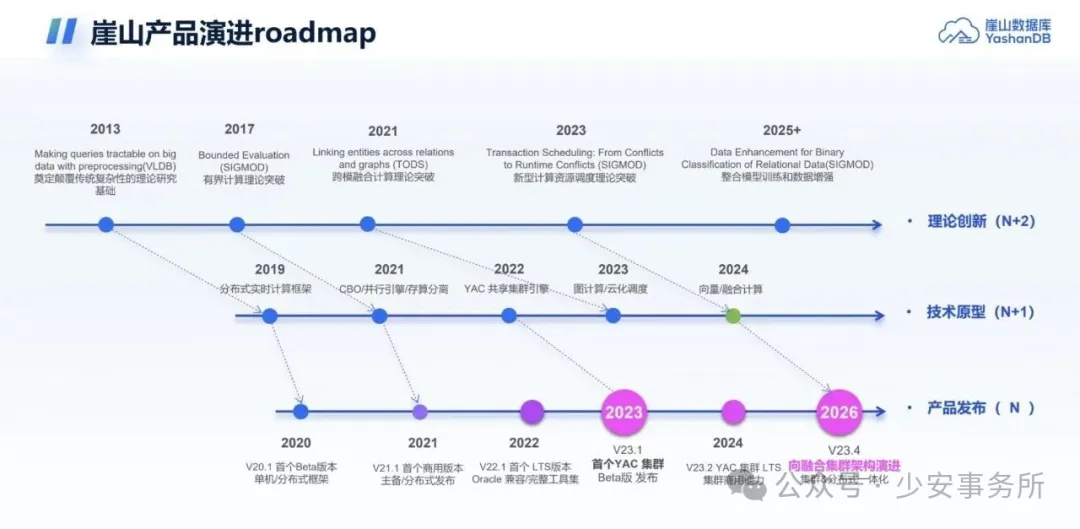
这不是临时起意。崖山的产品路线是"单机到共享集群再到融合集群",在同一套内核上逐级生长:2023 年 11 月共享集群首发,磨了近两年走向商用;2024 年 V23.4 阶段路线图明确"向融合集群架构演进、集群与分布式一体化";2025 年 11 月 V23.5 共享集群全面规模化商用,融合能力同步落地;2026 年分布式数据库产品拿下国测Ⅱ级,融合集群架构的技术路线被官方报道称为"再次得到有力验证"。
实现上看,关键在四件事。
一是双路径计算。系统以分区对象为粒度,两种模式并存:小表高频交易走聚合内存模式,多节点共享缓存、数据就近计算,不用分片键,应用零改造,拿到接近单机的事务性能;大表海量分析走逻辑分片模式,计算贴近数据,吃多节点并行扩展。一份数据,两条加速路径,优化器智能协同。
二是物理底座微秒级打通。RDMA 加 NVMe-oF 让跨节点缓存协同绕过操作系统内核栈;存算分离让计算节点秒级扩缩容,不用数据重平衡;自研 YFS 统一管理集中式、分布式、本地盘多种存储,PB 级容量在线扩容。
三是一致性不妥协。去中心化高精度逻辑时钟,计算层 Lamport SCN、事务层广播 SCN、存储层兜底,三层机制保证多节点强一致,不引入中心化协调者的单点瓶颈。
四是面向 AI 留了接口。关系、列存、向量、图、JSON、时序在同一内核原生多模,一条 SQL 做跨模关联;库内 AI 计算让数据不出库;内核级数据沙箱给 Agent 提供隔离的试错环境。
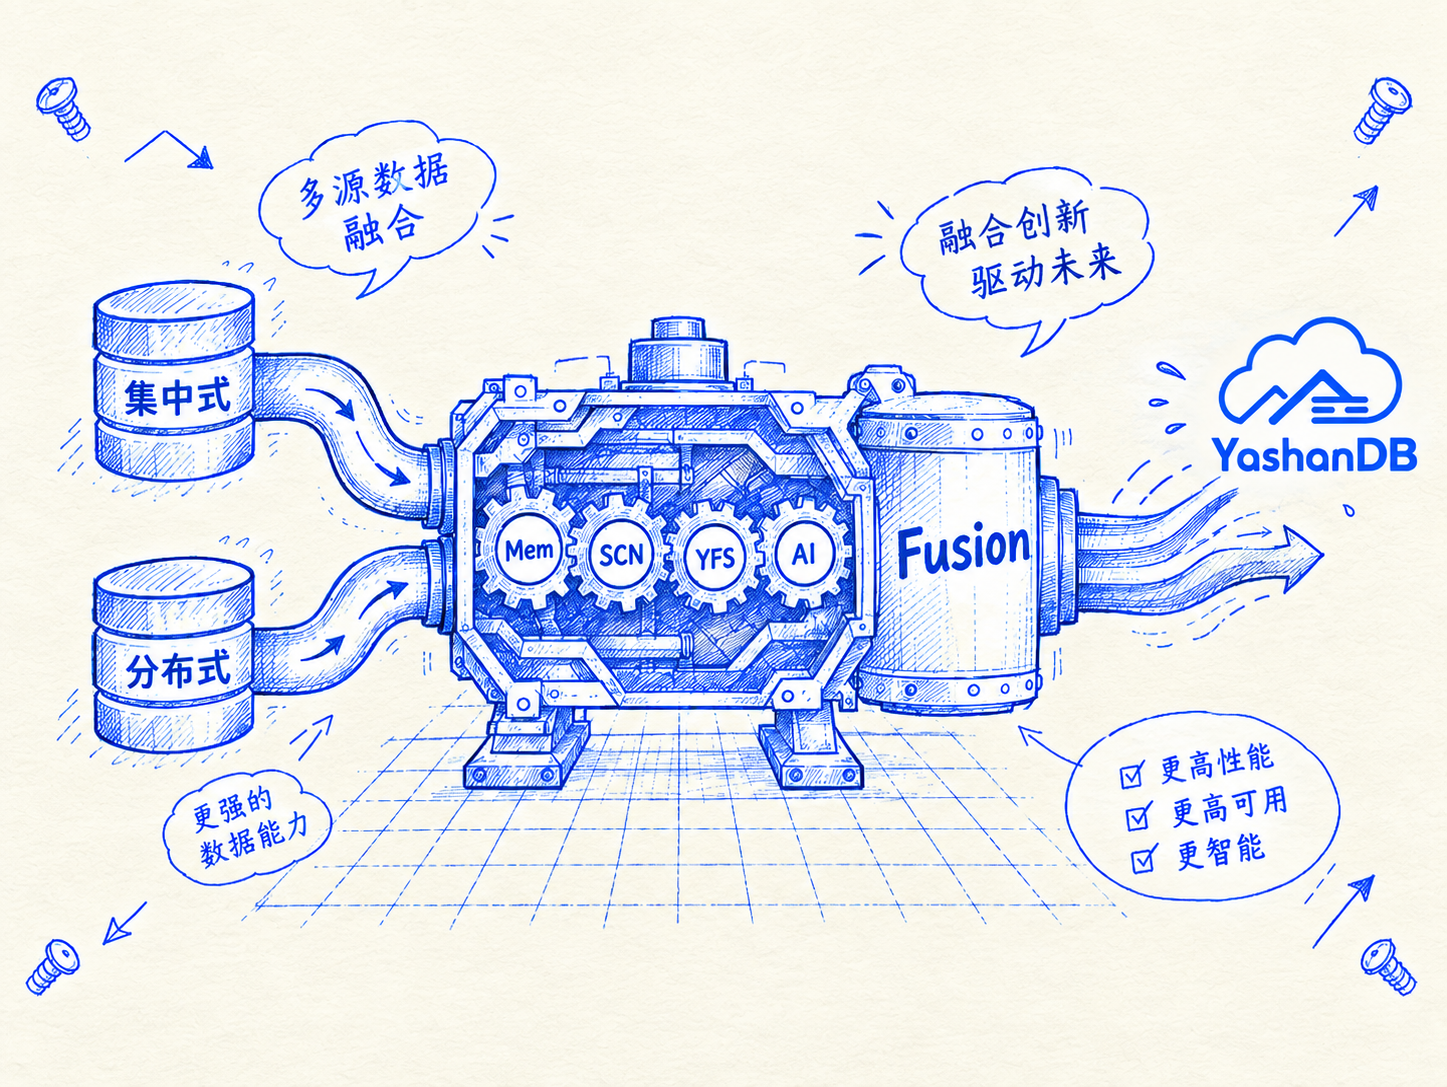
这套设计对企业具有现实且长远意义:核心替代用共享存储集群的形态做,业务爆发时用分布式的形态扩,AI 来了在同一底座上接。一次选型,长期演进,架构不用清零重来。
IDC 在《中国金融行业本地部署集中式事务型数据库市场份额,2025》里也有背书式评价:"崖山融合集群架构融合了集中式与分布式的技术特征,有助于满足金融行业在核心系统国产化替代过程中对平滑迁移、稳定运行和后续业务扩展的多重需求。"
05. 总结
放到数智时代的大背景下看,这个选项的意义还会再放大。数智化的前提,是数据作为生产要素能够被低成本地调用、关联和计算。如果企业的业务形态每变一次,底座就要换库、迁移、重构一轮,那么数智化就永远卡在搬运和改造这一步,谈不上要素流动,更谈不上智能涌现。
回头看,集中式(哪怕上了 Raft 三节点)拿不到对等多写,分布式强在扩展却苦于时延和改造成本,共享集群强在可靠性和应用透明,天花板又卡在扩展上限。每一款架构都解决了瓶颈问题,又留下自己的遗憾。融合集群的思路,是让共享集群和分布式在同一内核里能力共生,把"三选一"变成"按需取用"。
我推断,融合集群架构将成为核心业务数据库选型标配。这不只是崖山一家的方向,一些集中式起家的厂商在筹备分布式数据库产品,分布式起家的也在回补单机敏捷形态,大家都在往同一个终点走。但核心诉求是一致的,就是为了稳定承接企业不断变化的业务需求,毕竟,企业核心系统里跑出来的数字才算数。