大家好,我是孟健。
作为一个完全不输出自然语言的结构化决策模型,Jev并没有取代原有的主语言模型。我们将它接入ShipSite,仅仅用来承担流程中的辅助判断任务。
这几天 HN 和技术社区关于 Jev 的讨论很热。有人说它是 LLM 的终结者,有人说它声称解决了幻觉,还有人觉得这纯粹是换皮炒作。
我习惯用真实工程说话。这周我们把 Jev 接入了 ShipSite。主模型没有换,业务链路没有改,敏感权限全都不放给它。这篇文章不搬运新闻通稿,也不兜售技术焦虑,我就用第一手的接入代码、真实的验收测试数据,以及工程防护边界,聊聊 Jev 到底是什么、怎么用,以及它真正的价值与局限。
01 Jev 到底是什么
9 月 15 日,TypeSafe AI 正式发布了 Jev,官方给它的定位是世界上第一个"System One Model"(系统一模型)。
借用认知心理学里"快思考与慢思考"的隐喻:如果说现在的 GPT-4、Claude 这类生成式大语言模型是负责深思熟虑、一步步长推理的"系统二"(System Two),那么 Jev 想扮演的就是那个凭直觉、毫秒级响应、专门做瞬时反应的"系统一"。
在传统意义上,我们调用 LLM 时,不管是在前端做 JSON 结构化输出,还是用 Tool Calling,底层是自回归地逐字生成文本。你问它"这句话是在抱怨还是在咨询",它要在内部推理一遍,然后吐出 {"type": "complaint"}。
Jev 完全抛弃了这种交互机制:
- 不生成任何自然语言文本:它的输入是非结构化状态加上类型化问题,输出直接是严格定义的枚举、布尔或联合类型。
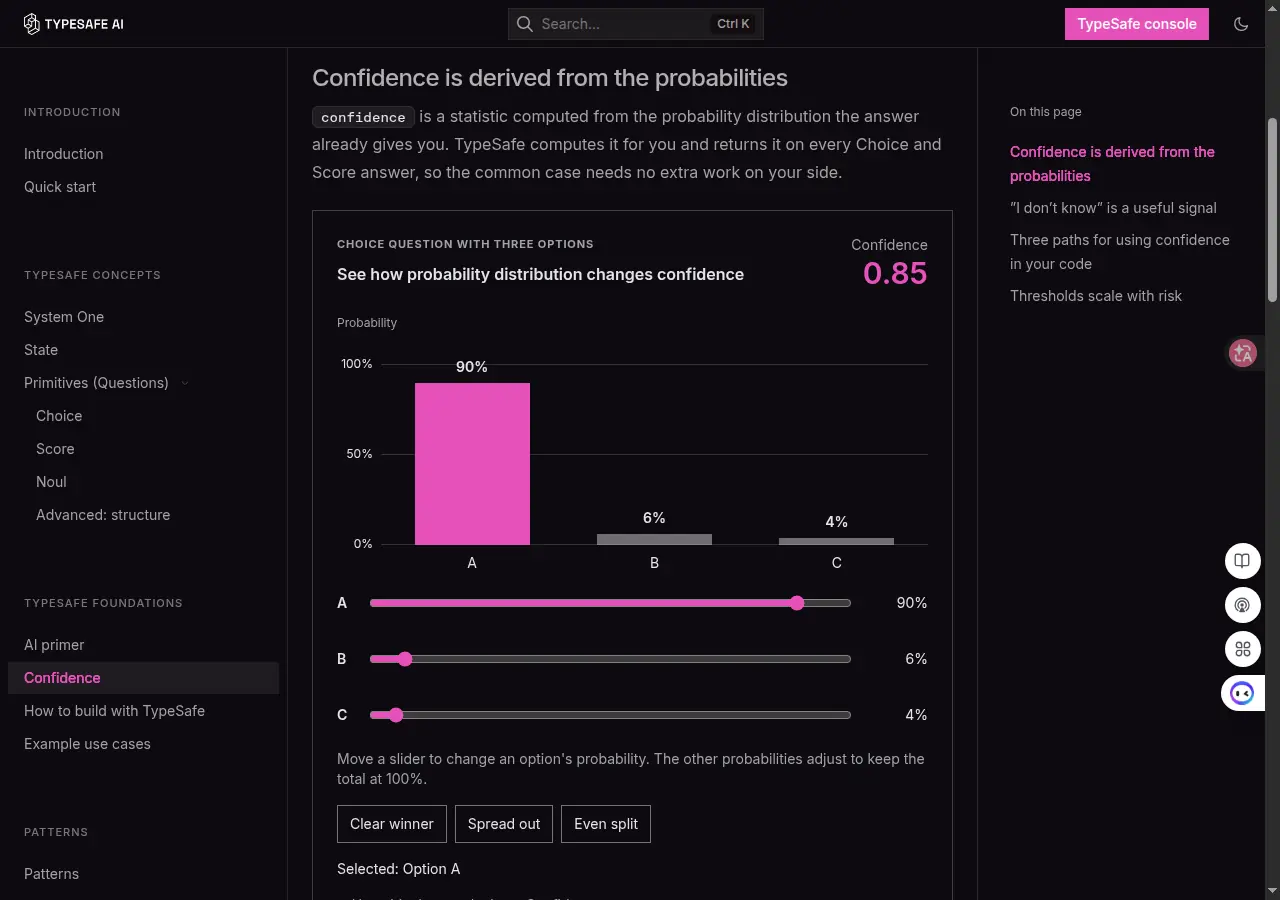
- 原生返回概率与置信度:根据官方文档,Choice与Score类型原生提供概率分布及派生的置信度指标(Confidence),但这并不等同于实际业务准确率,且Noul类型不包含该指标。
- 训练方式不同:它采用 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)训练,目标不是让文本更像人话,而是让结构化决策的选择更准确。
官方定价为 42perbillioninputtokens(也就是每百万inputtokens只要0.042),并且由于不生成长文本,输出直接免费。模型路由挂在 jev-latest,当前生产版本是 jev-1.13.0,调用接口是专门的 POST /v1/systemone。
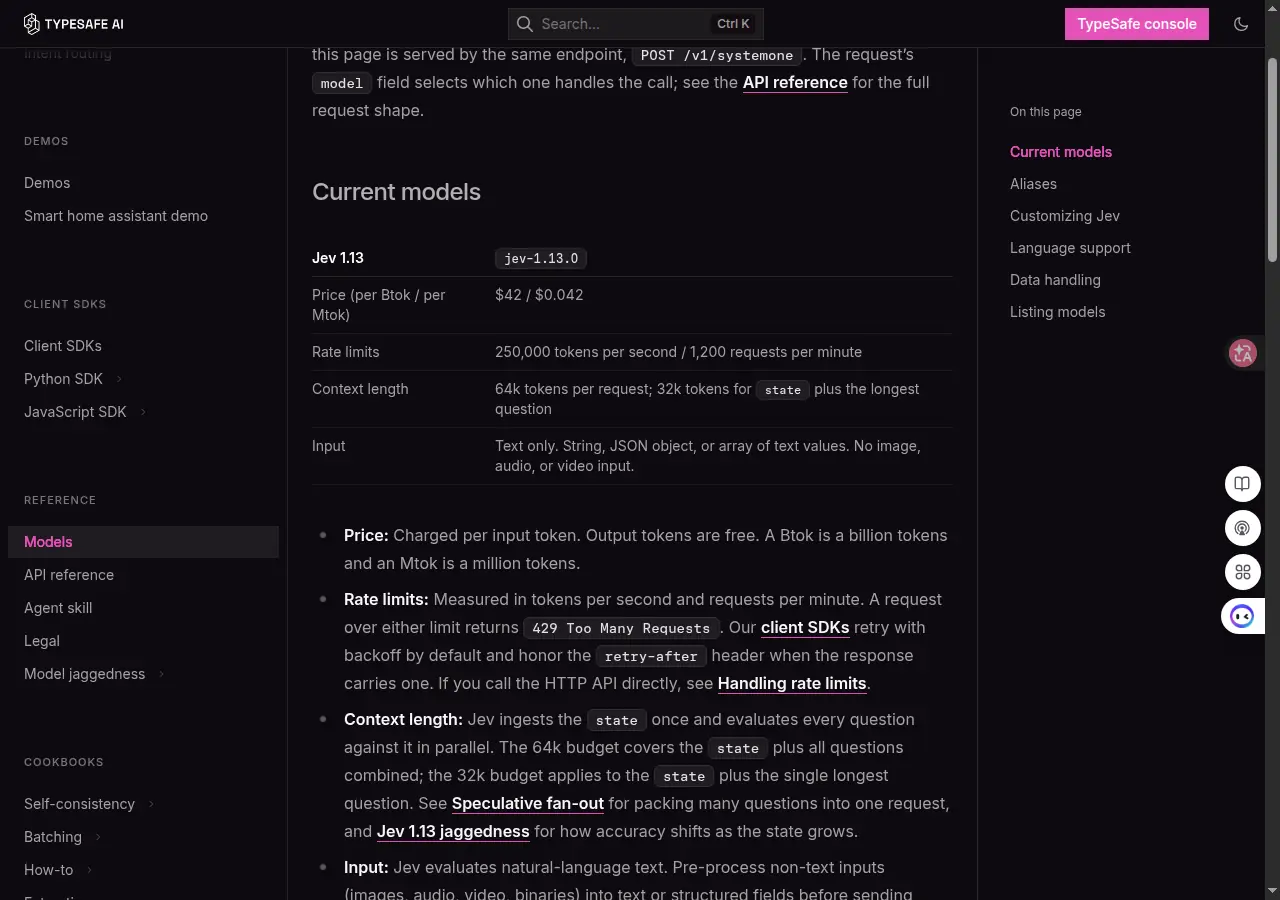
官方宣称 Jev 比传统 LLM 快两个数量级,成本大幅下降。不过需要冷静指出的是:官方宣称...可能偏向乐观,并不代表我们的实测结论。
02 为什么它最近这么热
Jev 上线后在 Hacker News 上获得了 1917 points 和超过 500 条评论,同时 LangChain 也在第一时间发布了 Jev harness 的集成指南。
它之所以能引爆讨论,核心击中了当前大模型落地应用的一大痛点:杀鸡在用牛刀,而且牛刀既贵又慢还容易卡顿。
现在大家都在做 AI Agent、自动化流水线。在整个链路中,真正需要写文案、写代码、多步规划的只是少数关键环节;大部分环节其实是高频小判断:
- "这个用户需求到底属于修 Bug 还是加功能?"
- "这个爬取的网页标题是否与电商相关?"
- "这一批搜索词里哪个更适合优先检索?"
为了做这种几选一的判断,开发者们现在不得不启动一个完整的大模型,设置温度,拼 Prompt,祈祷它乖乖输出合法 JSON,还要为它数百毫秒乃至两三秒的延迟买单。
独立技术分析师 Sean Goedecke 在分析 Jev 的技术原理时指出:Jev 之所以能做到极高速度,主要是推理策略层面的创新------通过严格受限的选择集实现单 Token 或极简解码路径,而非从底层重构了神经网络架构。但他同时也认为,专门针对"结构化决策"做软硬件端到端优化的模型,在工程上极具实际意义,他也期待看到头部大厂跟进同类形态。
而在社区的激烈交锋中,最受争议的一点是官方宣传中容易让人误解的"不会幻觉"。
必须在工程上明确:类型安全绝对不等于事实正确 。模型输出一个严格落在 ['bug', 'feature'] 枚举里的结构体,只能保证它不会在 JSON 里漏打括号,绝不代表它判断的结果一定是对的。把"结构合法"偷换成"永远正确",是很多非技术讨论中最危险的幻觉。
03 它和 LLM 的本质区别
为了让大家更清晰地建立心智模型,我们可以把 Jev 与传统 LLM 做一个直观的对照:
| 维度 | 传统生成式 LLM(System Two) | Jev(System One) |
|---|---|---|
| 主要定位 | 内容生成、复杂长推理、多步规划 | 高频判定、分支路由、类型归类 |
| 输入 | 文本 Prompt、多模态上下文 | 非结构化状态 + 强类型 Schema 定义 |
| 输出 | 文本流、逐字生成的 JSON 字符串 | 预定义数据类型、概率与置信度数值 |
| 底层消耗 | 随输出 Token 长度线性增长 | 近乎单步决断,耗时极短,输出免费(官方定价策略) |
| 幻觉表现 | 语法错误、事实编造、格式漂移 | 结构绝对合法,但仍可能选错类别 |
| 下游消费方式 | 代码通常需要正则或解析器二次反序列化 | 原生结构体,代码直接 switch-case 消费 |
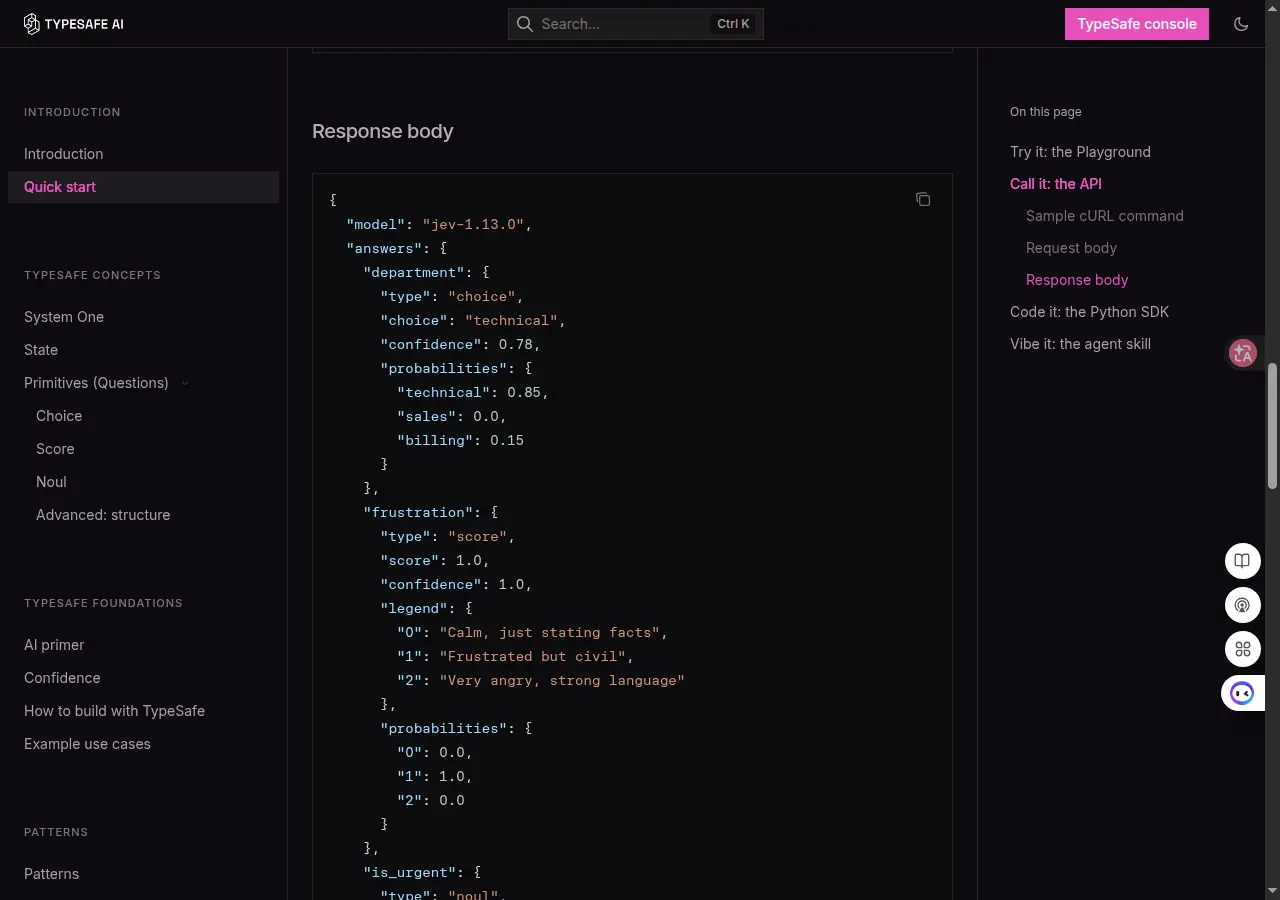
我认为 Jev 真正的价值并不单纯是速度,而是它逼你在架构设计阶段,就把代码里的决策意图给形式化地写清楚。
在过去,很多工程师偷懒,把一整段含混不清的 Prompt 丢给 LLM,"帮我看着办"。而 Jev 强制要求你给出确定性的 Schema 和有限的决策空间。很多时候,一旦你把逻辑空间整理清晰,大部分所谓的智能判断,原本就不需要大模型来猜。
04 我把它接进了 ShipSite 的哪里
在 ShipSite 中,我们并没有盲目替换掉任何成熟节点,而是把 Jev 作为一个非常收敛的"辅助判断层"接入系统。
目前上线了两个具体的边缘灰度点:
接入点 1:模糊修改需求的意图提示
在 ShipSite 的站点迭代流水线中,用户会提交各种自然语言改动需求。 大部分情况下,如果用户说了"修改背景色为白色",原有的规则匹配引擎就能完全确定意图。只有当传统规则无法确定、语义极其模糊时,才会降级调用 Jev。 Jev 此时返回的是意图建议标签(例如是否属于样式调整或文案改动)。我们明确规定:这个标签仅作为界面展示的意图提示,绝不能直接转成执行指令去跑代码。
接入点 2:调研候选搜索词的意图标签
当系统为用户网站生成竞品与市场规划时,会生成一批长尾搜索词候选(单次最多 24 条)。 我们利用本机 CLI 工具 jev-small-decisions,以高频批量的方式调用 Jev,为每个词打上分类标签(如竞品词、信息词、交易词),仅供后续搜索策略做排列权重参考。
同时,我们立下了一个死原则:确定性代码能解决的事情,坚决先用代码。 字符长度过滤、正则关键字匹配、前缀命中,通通在最前置的本地代码拦截,只有穿透了规则的残余样本才推给 Jev。
05 接入时我保留了哪些边界
引入任何实验性模型,工程安全与防御性编程必须放在第一位。这套系统能顺利合并,是因为我们给它套上了极其严格的工程边界:
- 严格账号与工作区白名单:目前仅对孟健本人的内部账号及指定测试工作区开启 assist 灰度,任何外部用户、生产租户绝对不接触该链路。
- 核心业务"三不碰":主生成模型未作替换,权限鉴权规则未作替换,涉及付款、删除、生产审批的敏感流程完全不接入 Jev。
- 敏感信息拦截与静默降级 :输入内容若检测到任何敏感凭证或隐私文本,直接跳过;若配置为
off、环境变量缺少凭据,或请求来自非白名单,对外网络发包数为零。 - 硬性超时与熔断 :API 超时阈值强行设死在 1000ms,超时即放弃,不设自动重试,不阻塞主线程。
- 置信度阈值认知 :我们将 0.9 设为本地采纳阈值。但必须警惕:0.9 是我们人为设定的采纳门槛,绝不代表模型有九成的真实准确率。 低于 0.9 的结果一律回退原逻辑。
- 一键全局熔断开关 :系统保留独立环境变量
JEV_DECISION_MODE=off,一旦云端接口抖动,瞬间回退到无 Jev 的纯规则流程。 - 财务刚性约束 :我们采购了 5 美元的测试总额度,设置了 30 天有效期(10 月 20 日到期),锁定仅允许调用
jev-1.13系列,绝对不开启自动充值。额度耗尽自动切回原有兜底,不产生意外账单。
在上线验收阶段,我们执行了完整的测试验证:新增测试 42/42 通过,上游回归测试 134/134 通过,独立 QA 探针 6/6 通过,正式发布时全量 Node 测试、类型检查、构建及生产 smoke 全部通过。
值得记录的一个发布插曲是:第一次手动执行 engine-only 发布时,被安全守卫拦截并阻断;随后排查确认无误,同一提交触发自动化正式发布成功,代码直接 fast-forward 合并到 main 分支完成部署,没有多余的 PR 流程。
关于模型识别效果,我们在离线环境下使用 48 条冻结的合成测试样例 进行了跑分:
- 45 条样本给出的类型标签符合预设;
- 2 条因为置信度低于 0.9 触发保护被安全回退;
- 1 条因为是极短词,在前置长度规则阶段就被排除,根本没进入模型。
必须强调:这 45/48 只是受限合成用例下的表现,绝不能等同于生产环境的准确率。 在紧随其后的真实 API 验收测试中,22 条需要模型处理的样例标签完全匹配,另有 2 条被确定性规则直接分流。这是发布版本的真实 API 验收,不是自然业务流量。
而在更广阔的线上真实世界里:截至目前,ShipSite 的自然业务工作流中尚未观察到任何真实命中。 我们不会为了做演示去冒充触发了自然工作流,更不会伪造生产流量。实事求是,是工程落地的应有底色。
06 什么任务适合 Jev,什么不适合
结合这次接入实践与深入测试,如果你的团队也在评估是否跟进 Jev 或类似 System One 模型,可以参考以下这个决策框架:
非常适合 Jev 的任务
- 分支路由与分流:根据用户输入特征,决定走 SQL 还是走向量检索,决定调用哪一个下游服务。
- 冷启动语义归类:输入一段非标准化的脏文本,将其归入已知的十几个枚举类型中。
- 意图提示与辅助排序:不直接参与高风险执行,但能为前端界面提供上下文高亮,或为后台流水线提供优先度标注。
- 批处理打标:对大量长尾数据(如搜索词、工单标题)进行初步意图清洗,能显著压缩延迟与成本。
坚决不要用 Jev 的任务
- 复杂推理与代码编写:需要一步步推导因果、写出完整算法的场景,它没有思考链,无法完成此类任务。
- 文本与多模态生成:写文章、拟邮件、生成富文本,它天生没有生成能力。
- 高风险核心决策:资金扣款、数据库 Drop、生产权限放行。哪怕它给出了 0.99 的置信度,没有确定性业务规则守门,也绝对不能让模型直接拍板。
- 规则能完美覆盖的逻辑:如果一个正则、一个字典匹配就能稳定搞定的判断,别为新鲜感引入任何外部网络依赖。
结语
技术圈每隔一段时间就会出现一次概念包装,把一个局部的工程改良说成范式转变。
Jev 的价值在于它提醒我们:很多高频小决策根本不需要 LLM 级别的智能。我们真的需要每次都用一个完整的大模型,去猜一个二选一的布尔值吗?把高频、结构化的小决策剥离出来,做成低成本、低延迟的专用模型,这个方向在工程上很可能成为未来 AI Agent 架构的一个基础组件。
但它不是万灵药。类型安全解决不了认知盲区,毫秒级响应也取代不了长时推理。
如果你的系统正在被数以万计的"意图分类、请求路由、小标签判断"拖慢了响应、烧干了预算,Jev 值得你开一个沙箱灰度试一试;但如果你期望它替你生成内容、或者把核心业务放心地全权托管,那么它绝不是你在找的答案。
认清边界,先写规则,大胆测试,谨慎上线------这才是面对任何新技术形态时,工程师最该保持的清醒。
👋 我是孟健,前腾讯 T11 / 前字节技术 Leader,现在全职做 AI 编程。
🔥 更多 AI 编程实战:
- GitHub:@mengjian-github
- 专栏:AI编程实战
觉得有用?点赞+收藏 就是最大支持 🙏