为什么说"写完正则不先验证一遍"是危险的
很多开发者的工作流是:在编辑器里写一段正则 → 直接跑单元测试或者上生产 → 出了问题再回头调。这个流程最大的隐患在于,正则表达式的语义和"你脑子里以为的语义"经常不是一回事。尤其是涉及元字符、字符类、分组、量词和 flags 组合的时候,肉眼读代码很容易漏掉边界情况。
举一个很典型的例子。你写了一段用来匹配"以 http 或 https 开头的 URL"的正则:
1.^https?://初看没问题,s? 表示 s 出现 0 次或 1 次。但如果你拿它去匹配一段包含多个 URL 的文本,就会发现问题:^ 只匹配字符串开头,后面即使有一万个 URL,它也只关心第一个。如果文本是"请访问 http://a.com 和 https://b.com",你拿到的结果只有最前面那一个。这时候你需要加 g(global)flag,让引擎找到所有非重叠匹配。
再比如,同样是这段正则,如果文本换成了多行,每一行开头都是一个 URL,而你希望逐行匹配,就得再加 m(multiline)flag,让 ^ 和 $ 从"整个字符串的边界"变成"每一行的边界"。这就是 flags 和正则语义之间最容易踩的坑:正则本身没写错,但少了正确的 flags,结果就完全不是你要的。
所以我的建议是:写正则的时候,旁边开一个在线正则测试工具,把正则、测试文本、flags 一起放进去,实时看高亮出来的匹配结果,确认命中范围符合预期之后,再把它写进代码。这一步花不了两分钟,但能省下后面排查"为什么匹配不到 / 为什么多匹配了"的大量时间。
一个合格的正则测试工具应该具备什么
市面上的正则测试工具很多,但真正好用的,通常会满足下面几个点:
- 实时高亮:输入正则或测试文本,结果立刻刷新,不用点"运行"按钮。这对调试特别重要,因为你会频繁微调正则,实时反馈能让你马上看到改动带来的差异。
- 支持常用 flags :至少支持
i(忽略大小写)、g(全局匹配)、m(多行模式)、s(点号匹配换行)这几个,最好还能支持u(Unicode)等。 - 能同时放多组测试样本:一段正则往往会面对多种输入,一个能放多组样本的工具,可以让你一次性把正常、边界、异常情况都覆盖到。
- 本地运行、不上传数据:这一点对很多人来说很关键。正则测试往往涉及一些业务片段、日志片段甚至是敏感数据,谁也不想把这种东西发到第三方服务器上。
我目前在用的是星点正则测试(https://www.xingdian.net/app/regex/tester/),它基本覆盖了上面这些点:粘贴正则和测试文本即可,实时高亮所有命中项,支持 i/g/m/s 等 flags,可以放多组样本,而且是在浏览器本地运行、不上传数据。
具体用法:三步走
用这类工具的步骤其实很统一,以我自己的习惯为例:
第一步,粘贴正则和测试文本。 把正在写的正则放到正则输入框,把需要匹配的文本(可以是几行日志、一段 JSON、一个用户输入样本)放到测试文本区。建议测试文本尽量接近真实数据,而不是随手打的 abc123,因为真实数据里往往藏着让你正则失效的特殊字符。
第二步,设置 flags。 这一步最容易被忽略。先想清楚几个问题:
- 我是否要匹配所有出现的位置?是的话开
g。 - 文本里大小写是否不敏感?比如要同时匹配
Error和error,开i。 - 文本是多行吗?需要
^$按行生效吗?是的话开m。 - 我的点号
.是否需要匹配换行符?如果数据里字段可能跨行,开s。
第三步,看高亮,逐个确认命中范围。 高亮出来的每一个匹配,你都要在心里问一句:"这个位置命中,是我想要的吗?有没有漏掉、有没有多出来?" 尤其是贪婪匹配的场景,很容易多吞字符,这一步要重点盯。
flags 逐个拆解:i / g / m / s 到底是什么意思
这是正则测试里最常见的疑问点,我把四个最常用的 flag 拆开讲清楚。
i(ignoreCase,忽略大小写)
默认情况下,正则里的 a 只匹配小写字母 a,A 只匹配大写字母 A。加上 i 之后,两者等价。场景:用户搜索关键词、日志级别、HTTP 方法名等,这些往往大小写不敏感。例如 /error/i 可以同时匹配 Error、ERROR、error。
g(global,全局匹配)
不带 g 的时候,正则引擎在找到第一个匹配后就停下,只返回一个结果。带上 g,引擎会继续向后扫描,返回所有非重叠匹配。场景:统计一段日志里出现了多少次某个模式、批量提取所有邮箱/URL/数字。没有 g,你就只能拿到第一个。
m(multiline,多行模式)
默认 ^ 和 $ 分别只匹配"整个字符串的开头"和"整个字符串的结尾"。开启 m 后,^ 还能匹配每一行的开头(换行符之后的位置),$ 还能匹配每一行的结尾(换行符之前的位置)。场景:逐行处理日志、配置文件,比如 /^\d{4}-/gm 可以匹配每一行开头的年份。
s(dotAll,点号匹配所有字符)
默认点号 . 匹配除换行符以外的任意字符。开启 s 后,. 也能匹配换行符。场景:要匹配的内容可能跨越多行,比如 HTML 里两个标签之间隔了换行、多行注释块 <!-- ... --> 等。需要提醒的是,很多测试工具(包括一些老文档)也把 s 称作"单行模式",但含义其实是"让 . 匹配换行",别和 m 搞混。
这四个 flag 可以自由组合,比如 /pattern/gim 就是全局 + 忽略大小写 + 多行。组合之后的行为是叠加的,这也是为什么要用测试工具先验证一遍------你脑子里想的组合效果,和引擎实际执行的效果,偶尔会有出入。
两个最经典的踩坑场景
坑一:贪婪匹配吞过头
假设你想匹配一段文本里用引号包起来的内容,写了:
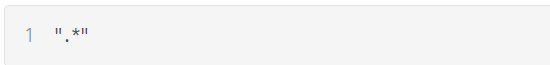
测试文本是:
1.他说:"你好",然后又说:"再见"
你会以为匹配结果是 "你好" 和 "再见" 两个,但实际上贪婪的 .* 会从第一个引号一路吞到最后一个引号,得到一整串 "你好",然后又说:"再见"。正确做法是把 .* 换成非贪婪的 .*?,也就是:
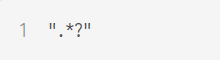
这样就能分别匹配到两个引号包裹的内容。贪婪 vs 非贪婪是新手和熟手都容易栽的坑,一定要在测试工具里用"多组样本"验证,尤其是有多对定界符的时候。
坑二:^ 和 $ 在多行文本里的"意外"
你写了一个用来校验单行输入的正则:
1.^\d{11}$
本意是校验手机号(11 位数字),但如果测试文本是多行的(比如从文件里读出来的内容末尾带换行符),或者你需要逐行校验,行为就会不一样。不带 m 的时候,$ 在一些实现里匹配"字符串结尾或结尾换行符之前",带 m 后逐行生效。手机号这种"整段匹配"的校验,和"从长文本里提取"的匹配,思路完全不同,用测试工具分别验证一下能省很多事。
测试器 vs 调试器:为什么实时高亮比事后打断点更高效
很多人习惯把正则调试放在代码里打断点做,但这样效率其实不高。打断点看的是"运行时某一瞬间的状态",而正则的很多问题(贪婪、回溯、边界)是"整段文本里哪里命中、命中多少"这种全局视角的问题,实时高亮天然更适合呈现。测试器的价值在于即时反馈闭环:改一个字符 → 立刻看高亮变化 → 再改。这个循环在编辑器或调试器里都做不到这么顺滑。
把测试用例沉淀成"样本集"的思路
我建议你在测试工具里把一组样本固定下来反复用,而不是每次随手换。比如你负责的某个正则,长期准备这几组样本:
- 正常命中样本(应该匹配,且匹配得刚刚好)
- 边界样本(刚好在规则的边缘,比如长度上限、空字符串、首尾字符)
- 反例样本(不应该匹配,用来验证不会误伤)
- 特殊字符样本(换行、制表符、Unicode、emoji、引号、反斜杠)
每次改动正则,都跑一遍这套样本集,确认"该中的中、不该中的不中"。这比临时抓一段文本要靠谱得多。
正则表达式是"写起来快、错起来也快"的东西,语义和预期之间的偏差往往藏在 flags、贪婪和边界里。我的经验是:写完先不急着上代码,拿到在线测试工具里,把正则、真实样本、正确的 flags 放进去,实时看一遍高亮,确认无误再落地。工具不用太花哨,满足"实时高亮 + flags 支持 + 多组样本 + 本地运行"就够用了。