文章目录
- 一、环境准备
- [二、仿射变换:OpenCV 图像处理入门](#二、仿射变换:OpenCV 图像处理入门)
-
- [2.1 图像在计算机里是什么](#2.1 图像在计算机里是什么)
- [2.2 什么是仿射变换](#2.2 什么是仿射变换)
- [2.3 完整代码](#2.3 完整代码)
- [2.4 代码讲解](#2.4 代码讲解)
- 三、人脸关键点检测与换脸(dlib)
-
- [3.1 68 个关键点分布](#3.1 68 个关键点分布)
- [3.2 换脸的整体流程](#3.2 换脸的整体流程)
- [3.3 完整代码](#3.3 完整代码)
- [3.4 注意事项](#3.4 注意事项)
- 四、手部关键点检测(MediaPipe)
-
- [4.1 MediaPipe 是什么](#4.1 MediaPipe 是什么)
- [4.2 Hands 参数详解](#4.2 Hands 参数详解)
- [4.3 21 个关键点编号](#4.3 21 个关键点编号)
- [4.4 完整代码](#4.4 完整代码)
- [4.5 关键细节](#4.5 关键细节)
- [五、 手势识别:基于距离的启发式方法](#五、 手势识别:基于距离的启发式方法)
-
- [5.1 核心思路](#5.1 核心思路)
- [5.2 完整代码](#5.2 完整代码)
- [5.3 启发式方法的优缺点](#5.3 启发式方法的优缺点)
- [六、人体姿态检测(MediaPipe Pose)](#六、人体姿态检测(MediaPipe Pose))
-
- [6.1 Pose 参数详解](#6.1 Pose 参数详解)
- [6.2 完整代码](#6.2 完整代码)
- 七、人脸网格重建(FaceMesh)
-
- [7.1 参数与原理](#7.1 参数与原理)
- [7.2 完整代码](#7.2 完整代码)
- [7.3 代码解析](#7.3 代码解析)
-
- [7.3.1 初始化 FaceMesh](#7.3.1 初始化 FaceMesh)
- [7.3.2 归一化坐标 → 像素坐标](#7.3.2 归一化坐标 → 像素坐标)
- [7.3.3 绘制三角网格](#7.3.3 绘制三角网格)
一、环境准备
建议使用 Python 3.8+,安装以下依赖:
bash
pip install opencv-python numpy mediapipe==0.10.21 dlib scikit-learn matplotlib seaborn joblib说明:
- MediaPipe 版本 :手部/姿态/人脸网格脚本基于代码注释中指定的
mediapipe==0.10.21,使用的是其solutions传统接口。官方目前推荐迁移到新的 Tasks API(如HandLandmarker),但 0.10.x 版本下本文代码仍可正常运行。 - dlib 模型文件 :' 换脸 ' 需要 68 点人脸关键点模型
shape_predictor_68_face_landmarks.dat,需自行下载(可在 dlib 官网或官方 dlib-models 仓库获取),并放在与脚本相同的目录下。 - 摄像头 :所有实时示例均使用
cv2.VideoCapture(0),其中0表示系统默认摄像头。 - 图片素材:各脚本运行前需要准备图片。
二、仿射变换:OpenCV 图像处理入门
2.1 图像在计算机里是什么
在计算机视觉里,图像的本质就是数字矩阵:
- 灰度图:一个
H × W的二维矩阵,每个元素表示该像素的亮度(0 为黑,255 为白); - 彩色图:一个
H × W × 3的三维矩阵,每个像素由 3 个通道组成。
OpenCV 默认使用 BGR 通道顺序(蓝、绿、红),而很多其他库(如 matplotlib、MediaPipe)使用 RGB 顺序,混用时需用 cv2.cvtColor 转换。
2.2 什么是仿射变换
仿射变换(Affine Transformation)是图像处理中基础的几何变换之一。从一个二维坐标系变换到另一个二维坐标系,属于线性变换。通过已知3对坐标点可以求得变换矩阵。仿射变换有两个重要性质:
- 直线变换后仍是直线;
- 平行线变换后仍然平行。
2.3 完整代码
python
"""仿射变换"""
import cv2
import numpy as np

# 读取图片
img = cv2.imread('01.jpg')
# 获取图像的高度和宽度
height, width = img.shape[:2]

# 原图上选取3个参考点,仿射变换至少需要3个不共线点
mat_src = np.float32([[0, 0],[0, height-1],[width-1, 0]])
# 目标图像对应的3个映射点
mat_dst = np.float32([[0, 0],[100, height-100],[width-100, 100]])

# 根据两组对应点,求解仿射变换矩阵
M = cv2.getAffineTransform(mat_src, mat_dst)

# 执行仿射变换,输出图像尺寸和原图保持一致
dst = cv2.warpAffine(img, M, dsize=(width,height))

# 水平拼接原图和变换后的图像,方便对比
imgs = np.hstack([img,dst])

# 创建窗口,设置窗口可缩放
cv2.namedWindow('imgs', cv2.WINDOW_NORMAL)
# 显示拼接好的图像
cv2.imshow("imgs",imgs)
# 等待按键,0表示无限等待,按下任意键继续
cv2.waitKey(0)
# 销毁所有opencv窗口,防止程序卡死
cv2.destroyAllWindows()
效果演示:
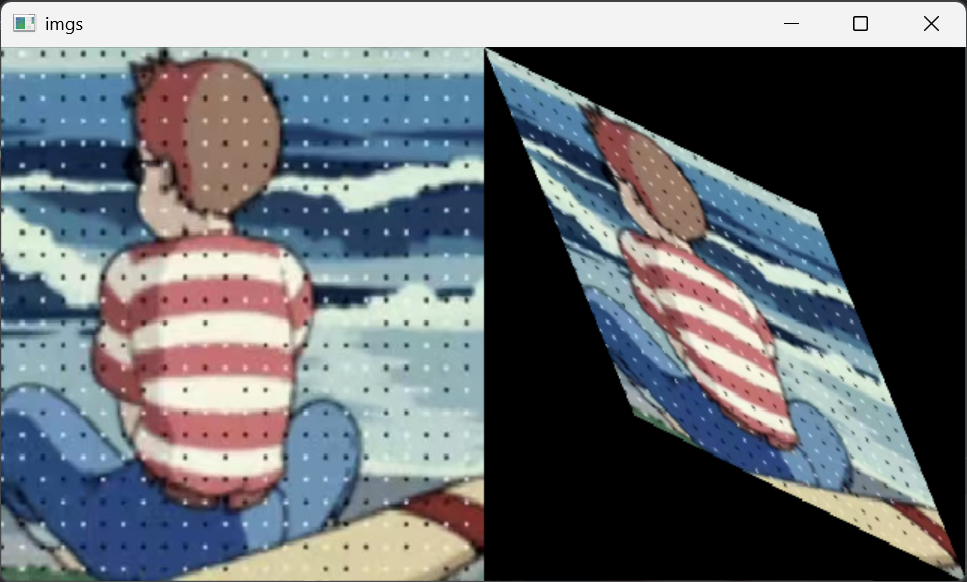
2.4 代码讲解
cv2.imread()读取图片,返回 BGR 格式的ndarray。np.float32(...)将点坐标转为float32类型,这是cv2.getAffineTransform的输入要求。cv2.getAffineTransform(src, dst):根据 3 组对应点计算 2×3 的仿射矩阵 M。cv2.warpAffine(src, M, dsize):按矩阵 M 对图像执行重映射。注意 dsize 是输出尺寸,顺序是 (宽, 高) ,与img.shape[:2]返回的 (高, 宽) 相反。np.hstack/np.vstack:水平 / 垂直拼接图像(要求高度 / 宽度一致),常用于把"处理前 vs 处理后"放在同一张图里对比。cv2.namedWindow('imgs', cv2.WINDOW_NORMAL):创建可缩放的窗口;cv2.imshow显示窗口,cv2.waitKey(0)等待按键(0 表示无限等待),cv2.destroyAllWindows()释放窗口资源,避免程序卡死。
三、人脸关键点检测与换脸(dlib)
3.1 68 个关键点分布
dlib 的人脸关键点模型会在每个人脸上标出 68 个关键点,分布如下:
| 编号区间 | 部位 | 点数 |
|---|---|---|
| 0--16 | 下颌轮廓 | 17 |
| 17--21 | 右眉 | 5 |
| 22--26 | 左眉 | 5 |
| 27--30 | 鼻梁 | 4 |
| 31--35 | 鼻底 / 鼻翼 | 5 |
| 36--41 | 右眼 | 6 |
| 42--47 | 左眼 | 6 |
| 48--67 | 嘴部(48--59 外唇、60--67 内唇) | 20 |
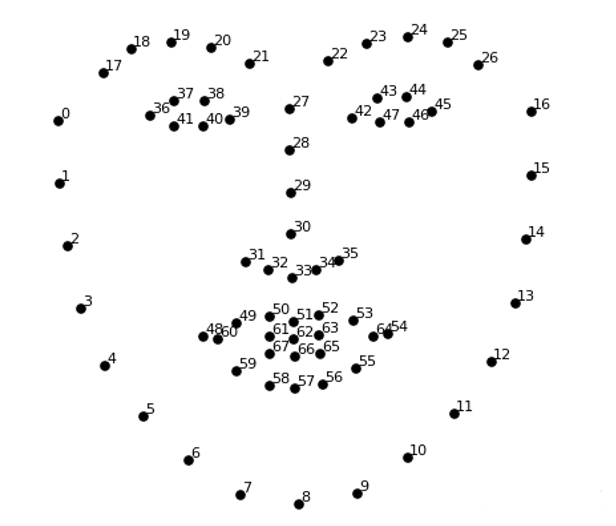
人脸关键点检测是很多任务的基础:人脸对齐(Face Alignment)、表情识别、美颜、AR 贴纸、换脸等。
为了对齐换脸,选取了眉毛、眼睛、鼻子、嘴等五官区域 的关键点(LEFT_BROW_POINTS + RIGHT_EYE_POINTS + LEFT_EYE_POINTS + RIGHT_BROW_POINTS + NOSE_POINTS + MOUTH_POINTS),而刻意排除了下颌轮廓点------因为不同人脸的下颌形状差异太大,用它做对齐会使人脸变形。
3.2 换脸的整体流程
- 人脸检测 + 关键点提取:dlib 检测人脸框,再用形状预测器得到 68 个关键点;
- 生成人脸掩膜(Mask):对五官关键点取凸包并填充,再高斯模糊得到平滑的软掩膜;
- 求解相似变换矩阵 M:将 B 脸的五官关键点对齐到 A 脸(用 SVD 求解旋转 + 缩放 + 平移);
- 仿射变换:把 B 脸图像和 B 脸掩膜按 M 变换到 A 脸坐标系;
- 颜色归一化:把 B 脸的肤色、光照调整到与 A 脸一致;
- 掩膜融合:掩膜区域内取 B 脸颜色,掩膜区域外用 A 脸,叠加输出。
3.3 完整代码
python
"""-----------换脸术的实现-----------"""
import cv2
import dlib
import numpy as np

JAW_POINTS = list(range(0, 17))
RIGHT_BROW_POINTS = list(range(17, 22))
LEFT_BROW_POINTS = list(range(22, 27))
NOSE_POINTS = list(range(27, 35))
RIGHT_EYE_POINTS = list(range(36, 42))
LEFT_EYE_POINTS = list(range(42, 48))
MOUTH_POINTS = list(range(48, 61))
FACE_POINTS = list(range(17, 68))

# 关键点集
POINTS = [LEFT_BROW_POINTS + RIGHT_EYE_POINTS +
          LEFT_EYE_POINTS + RIGHT_BROW_POINTS + NOSE_POINTS + MOUTH_POINTS]
# 处理为元组,后续使用方便
POINTSuple=tuple(POINTS)

def getFaceMask(im, keyPoints):#根据关键点获取脸部掩膜
    im = np.zeros(im.shape[:2], dtype=np.float64)
    for p in POINTS:
        points = cv2.convexHull(keyPoints[p])  #获取凸包
        cv2.fillConvexPoly(im, points, color=1) #填充凸包,数字在0~1之间
        # cv2.drawContours(im,[points],-1,1,-1)
    # 单通道im构成3通道im(3,行,列),改变形状(行、列、3)适应OpenCV
    im = np.array([im, im, im]).transpose((1, 2, 0))
    im = cv2.GaussianBlur(im, (55,55), 0)#这个参数比较重要,需要调整!!!!!!!!!!
    return im

"""求出b脸仿射变换到a脸的变换矩阵M"""
def getM(points1, points2):
    points1 = points1.astype(np.float64) #int8转换为浮点数类型
    points2 = points2.astype(np.float64) #转换为浮点数类型

    c1 = np.mean(points1, axis=0) #归一化:(数值-均值)/标准差
    c2 = np.mean(points2, axis=0) #归一化:(数值-均值)/标准差,均值不同,主要是脸五官位置大小不同
    points1 -= c1  # 减去均值
    points2 -= c2  # 减去均值

    s1 = np.std(points1)  # 方差计算标准差
    s2 = np.std(points2)  # 方差计算标准差

    points1 /= s1  # 除标准差,计算出归一化的结果
    points2 /= s2  # 除标准差,计算出归一化的结果

    # 奇异值分解,Singular Value Decomposition
    U, S, Vt = np.linalg.svd(points1.T * points2)
    R = (U * Vt).T#通过U和Vt找到R
    return np.hstack(((s2 / s1)*R, c2.T-(s2/s1)*R*c1.T))


def getKeyPoints(im):#获取关键点
    rects = detector(im, 1) #获取人脸方框位置
    shape = predictor(im, rects[0])  # 获取关键点
    s= np.matrix([[p.x, p.y] for p in shape.parts()])
    return s

"""修改b图的颜色值,与a图相同"""
def normalColor(a, b):
    ksize=(111,111)  #非常大的核,去噪等运算时为11就比较大了    #!!!!!!!!!!!!
    aGauss = cv2.GaussianBlur(a, ksize, 0) #对a进行高斯滤波
    bGauss = cv2.GaussianBlur(b, ksize, 0) #对b进行高斯滤波
    weight= aGauss/ bGauss  # 计算目标图像调整颜色的权重值,存在0除警告,可忽略。
    where_are_inf = np.isinf(weight)
    weight[where_are_inf] = 0
    return b * weight

a=cv2.imread("img_1.png")   #换脸A图片
b=cv2.imread("img_2.png") #换脸B图片

detector = dlib.get_frontal_face_detector() #构造脸部位置检测器
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")#读取人脸关键点定位模型

aKeyPoints = getKeyPoints(a)  #获取A图片的68关键点
bKeyPoints = getKeyPoints(b)  #获取B图片的68关键点

aMask = getFaceMask(a, aKeyPoints)#获取图片A的人脸掩膜
cv2.imshow( "aMask", aMask)
cv2.waitKey()

bMask = getFaceMask(b, bKeyPoints)#获取图片B的人脸掩膜
cv2.imshow( "bMask", bMask)
cv2.waitKey()

"""求出b脸仿射变换到a脸的变换矩阵M"""
M = getM(aKeyPoints[POINTSuple],bKeyPoints[POINTSuple])

"""将b的脸部(bmask)根据M仿射变换到a上"""
dsize=a.shape[:2][::-1]

bMaskWarp=cv2.warpAffine(bMask, M, dsize,
                         borderMode=cv2.BORDER_TRANSPARENT,
                         flags=cv2.WARP_INVERSE_MAP)
cv2.imshow( "bMaskWarp",bMaskWarp)
cv2.waitKey()

"""获取脸部最大值(两个脸模板叠加)"""
mask = np.max( [aMask, bMaskWarp],axis=0)
cv2.imshow( "mask",mask)
cv2.waitKey()

""" 使用仿射矩阵M,将b映射到a """
bWrap =cv2.warpAffine(b, M, dsize,
                      borderMode=cv2.BORDER_TRANSPARENT,
                      flags=cv2.WARP_INVERSE_MAP)
cv2.imshow( "bWrap",bWrap)
cv2.waitKey()

#求b图片的仿射到图片a的颜色值,b的颜色值改为a的颜色
bcolor = normalColor(a, bWrap)
cv2.imshow("bcolor",bcolor)
cv2.waitKey()

# ========step8: 换脸(mask区域用bcolor,非mask区域用a)==========
out = a * (1.0 - mask) + bcolor * mask

# ========输出原始人脸、换脸结果========
cv2.imshow( "a",a)
cv2.imshow( "b",b)
cv2.imshow( "out",out/255)  #数值为浮点数,以为你是归一化后的数据,超过1的全是白色,手动实现归一化。
cv2.waitKey()
cv2.destroyAllWindows()
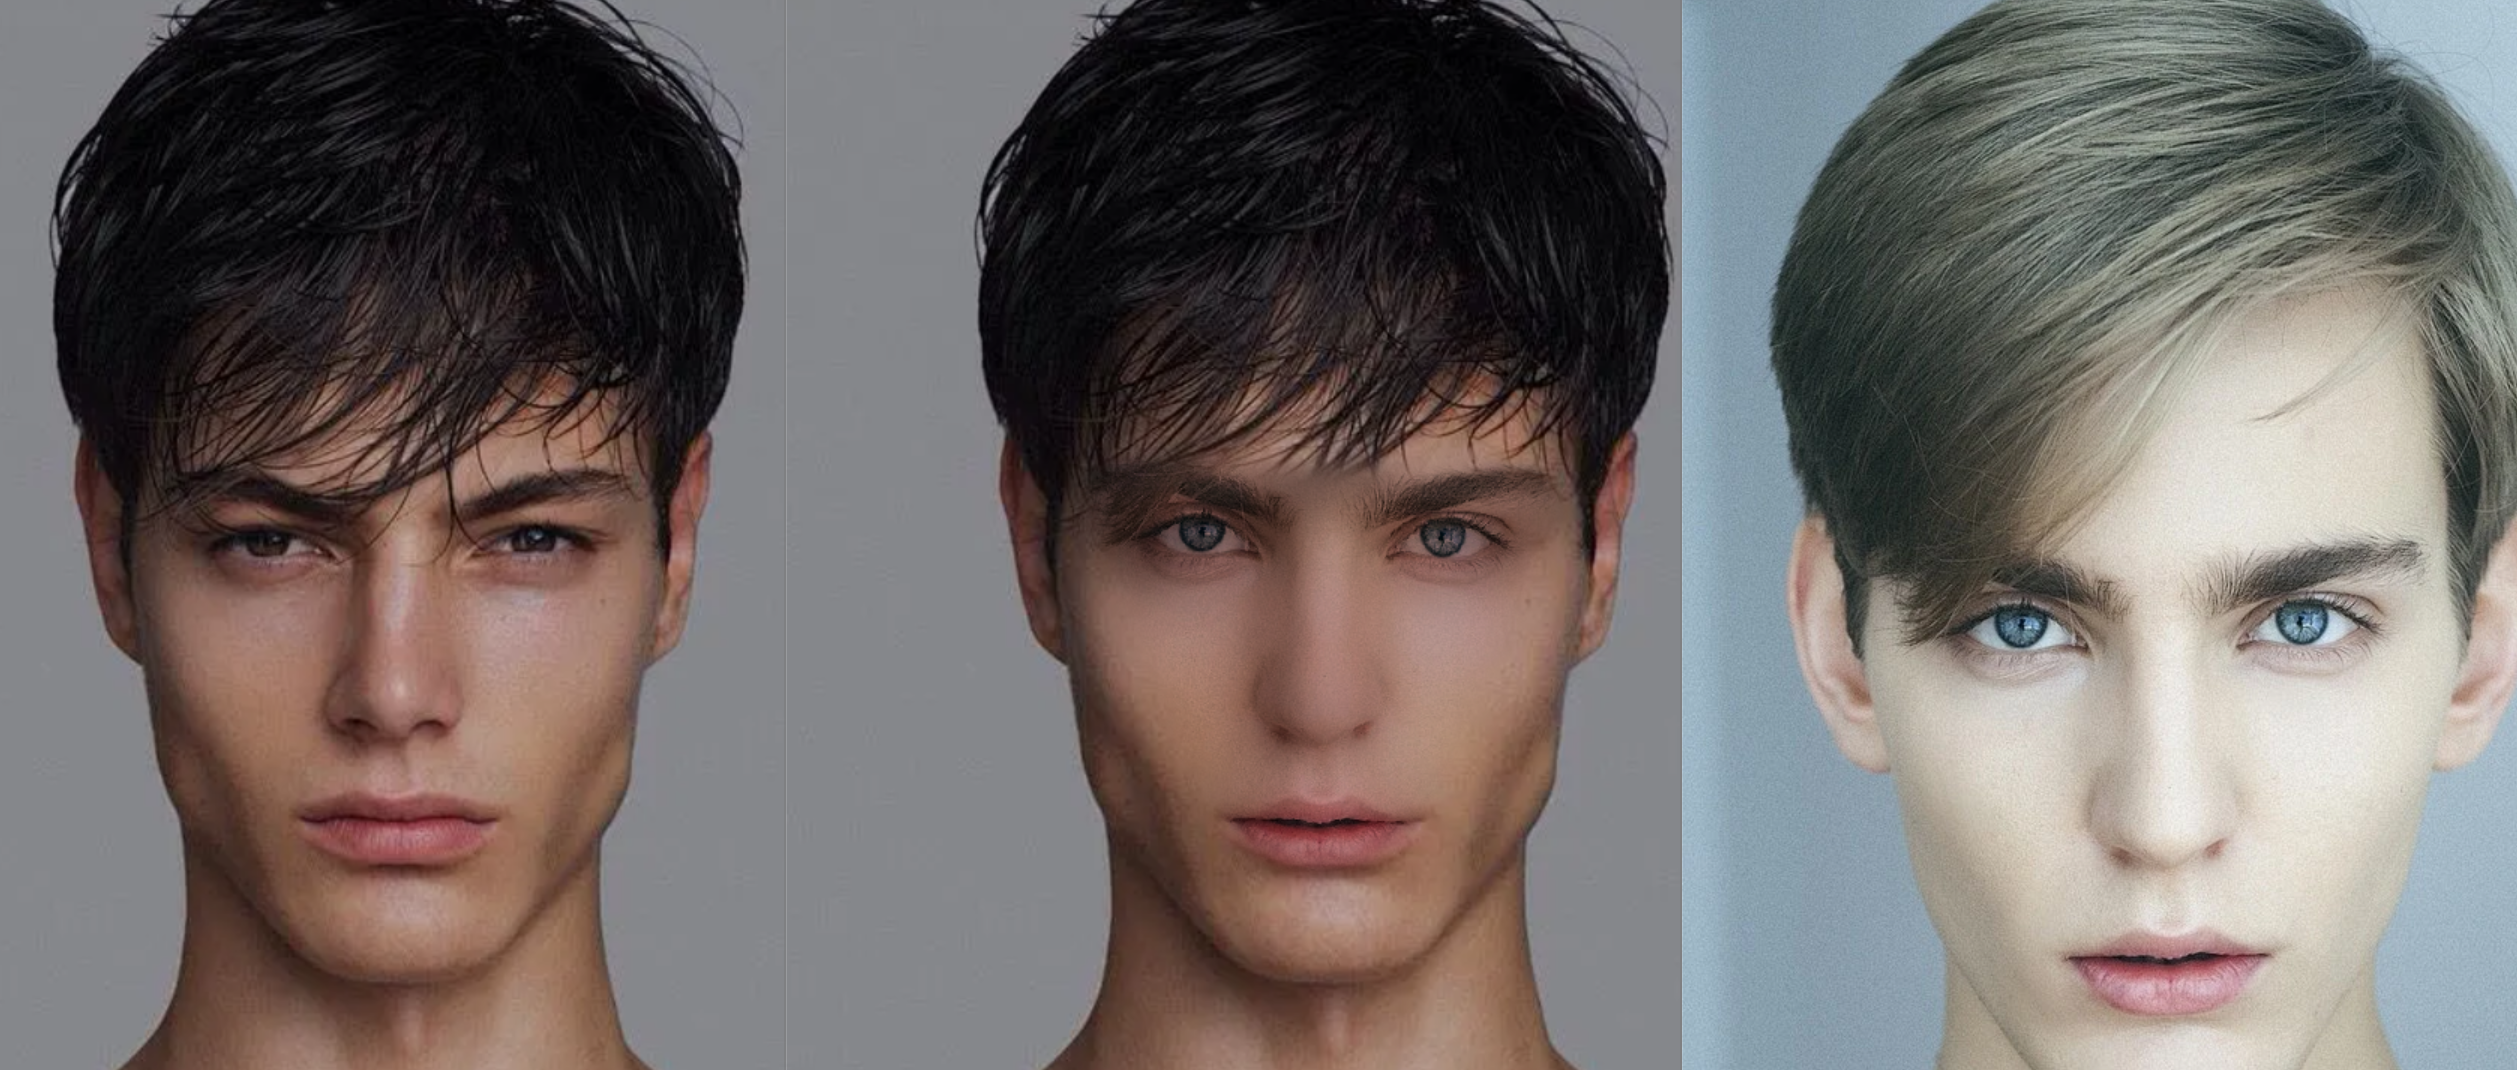
效果演示: 中间为换脸之后的结果
3.4 注意事项
cv2.GaussianBlur的核(55,55)与(111,111)都是正奇数------这是高斯核的硬性要求,且核越大模糊越重、融合越平滑。- 掩膜用
cv2.fillConvexPoly填充凸包后做高斯模糊,得到边缘渐变的"软掩膜",融合时才不会出现生硬的接缝。 - 最终
out是浮点数且数值范围在 0~255,直接imshow会全白,所以代码里除以 255 归一化到 0,1 再显示。 - 该传统方法对光照差异大、遮挡、大角度侧脸等情况效果有限。
四、手部关键点检测(MediaPipe)
4.1 MediaPipe 是什么
MediaPipe 是 Google 开源的跨平台机器学习框架,提供人脸、手部、姿态、分割等一系列开箱即用的解决方案(Solution),底层基于轻量级神经网络,在 CPU 上也能实时运行。
MediaPipe Hands 的检测管线分两步:先用手掌检测器(BlazePalm) 在整幅图中定位手的位置,再用手部关键点回归模型输出 21 个关键点。两步分工让检测又快又稳。
4.2 Hands 参数详解
| 参数 | 取值 | 含义 |
|---|---|---|
static_image_mode |
True / False(默认) |
True 适合静态图片,每帧重新检测;False 适合视频流,优先跟踪已识别的手。区别:手数量超过上限时,True 会在多只手之间闪烁,False 会稳定跟踪之前识别到的手 |
max_num_hands |
默认 2 | 最多识别的手数量 |
min_detection_confidence |
0.0, 1.0,默认 0.5 | 检测置信度阈值。越小越容易检测出手、耗时越短,但误检越多;越大越精准但响应越慢 |
min_tracking_confidence |
0.0, 1.0,默认 0.5 | 跟踪置信度阈值,越大跟踪越准、响应越慢 |
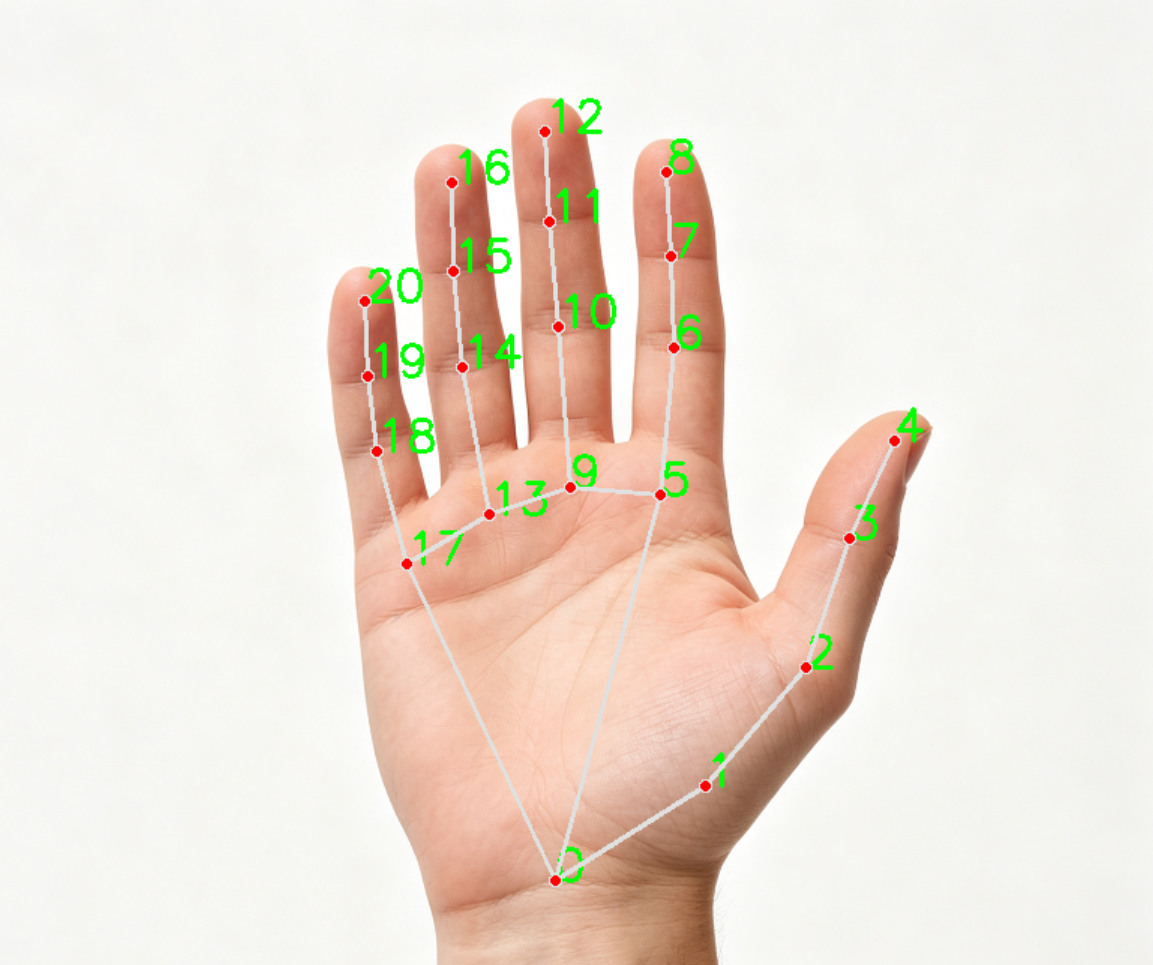
4.3 21 个关键点编号
| 编号 | 部位 |
|---|---|
| 0 | 手腕 |
| 1--4 | 拇指(CMC、MCP、IP、指尖) |
| 5--8 | 食指(MCP、PIP、DIP、指尖) |
| 9--12 | 中指 |
| 13--16 | 无名指 |
| 17--20 | 小指 |
4.4 完整代码
python
import cv2
import mediapipe as mp
# pip install mediapipe==0.10.21
'''
mp.solutions.drawing_utils是一个绘图模块,将识别到的手部关键点信息绘制到cv2图像中,
mp.solutions.drawing_style定义了绘制的风格。
mp.solutions.hands是mediapipe中的手部识别模块,可以通过它调用手部识别的api,
然后通过调用mp_hands.Hands初始化手部识别类。
'''
# mediapipe绘图工具,用来绘制手部关键点和手指连线
mp_drawing = mp.solutions.drawing_utils
# mediapipe手部识别解决方案
mp_hands = mp.solutions.hands

# 初始化手部识别模型
hands = mp_hands.Hands(
    static_image_mode=False,       # False:视频流模式,优先跟踪;True:静态图片,每帧重新检测
    max_num_hands=2,               # 最多同时识别2只手
    min_detection_confidence=0.75, # 手部检测最低置信度,低于该值认为画面无手
    min_tracking_confidence=0.75)  # 手部跟踪最低置信度,低于该值会重新执行检测

# 打开摄像头,0代表电脑默认摄像头
cap = cv2.VideoCapture(0)

# 循环读取摄像头每一帧画面
while True:
    ret, frame = cap.read()  # ret:是否成功读取帧;frame:读取到的图像数组
    h,w=frame.shape[:2]      # 获取图像高度h、宽度w

    # OpenCV默认读取BGR图像,mediapipe模型要求输入RGB图像,所以颜色空间转换
    frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
    # 摄像头画面默认不是镜像,flip=1水平翻转,模拟自拍效果
    frame = cv2.flip(frame, 1)
    # 将RGB图像送入手部模型推理,得到识别结果
    results = hands.process(frame)
    # 推理完成,转回BGR格式,方便OpenCV绘图展示
    frame = cv2.cvtColor(frame, cv2.COLOR_RGB2BGR)

    # 判断是否识别到手:multi_hand_landmarks保存所有识别到的手的关键点
    if results.multi_hand_landmarks:
        # 遍历每一只识别出来的手
        for hand_landmarks in results.multi_hand_landmarks:
            # 遍历当前手的21个关键点(0~20)
            for i in range(len(hand_landmarks.landmark)):
                # 获取归一化坐标 x,y,z,范围0~1,不是像素坐标
                x = hand_landmarks.landmark[i].x
                y = hand_landmarks.landmark[i].y
                z = hand_landmarks.landmark[i].z
                # 在控制台打印当前关键点编号和xyz坐标
                print(f'关键点{i}:',x,y,z)
                # 归一化坐标 × 图像宽高,转为像素坐标,在关键点位置绘制编号文字
                cv2.putText(frame, str(i), (int(x*w),int(y*h)), cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 255, 0),2)
            # 绘制手部骨架:关键点圆点 + 手指之间的连线
            mp_drawing.draw_landmarks(frame,
                                      hand_landmarks,
                                      mp_hands.HAND_CONNECTIONS)

    # 窗口显示处理后的画面
    cv2.imshow('MediaPipe Hands', frame)
    # 等待按键输入,按下ESC(ASCII=27)退出循环
    if cv2.waitKey(1) & 0xFF == 27:
        break

# 释放摄像头资源
cap.release()
# 销毁所有OpenCV窗口
cv2.destroyAllWindows()
4.5 关键细节
- 归一化坐标 :MediaPipe 返回的关键点
x、y都是 0~1 的归一化值(相对图像宽高的比例),不是像素坐标 。要画在图上必须乘上图像宽高:像素 x = 归一化 x × w。z表示该点相对手腕的深度,量级大致与 x 相当。 - 颜色空间 :MediaPipe 模型要求 RGB 输入,而 OpenCV 默认 BGR,所以推理前后各做一次
cvtColor转换。 - 镜像 :
cv2.flip(frame, 1)水平翻转画面,模拟自拍镜面效果,操作起来更直观。 - 退出 :
cv2.waitKey(1) & 0xFF == 27表示按下 ESC(ASCII 码 27)退出。 - 资源释放 :
cap.release()释放摄像头、cv2.destroyAllWindows()销毁窗口。也可以像后文手势采集脚本那样用with mp_hands.Hands(...) as hands上下文管理器自动释放模型资源。
五、 手势识别:基于距离的启发式方法
5.1 核心思路
不训练任何模型,纯靠几何启发式判断每根手指是否伸直,思路非常直观:
- 以手腕(0)到食指根部(5)的距离作为"手掌尺寸"的参考,除以 0.6 得到基准阈值 base;
- 对食指(8)、中指(12)、无名指(16)、小指(20):指尖到手腕的距离大于 base,就认为该手指伸直;
- 大拇指比较特殊,用食指根部(5)到大拇指指尖(4)的距离 判断,阈值取
base * 0.3; - 所有伸直的手指计数求和,两只手最多 10 根手指,因此计数上限设为 10。
代码里所有距离都使用平方距离 (pow(x1-x2, 2) + pow(y1-y2, 2)),省去开根号运算,减少计算开销。
5.2 完整代码
python
import cv2
import mediapipe as mp

# 手势标签列表,索引对应识别出的手指数量
gesture = ["none", "one", "two", "three", "four", "five", "six", "seven", "eight", "nine", "ten"]
flag = 0  # 计数器,记录当前画面伸出手指总数

# mediapipe绘图工具
mp_drawing = mp.solutions.drawing_utils
# mediapipe手部识别模块
mp_hands = mp.solutions.hands

# 初始化手部识别模型
hands = mp_hands.Hands(
    static_image_mode=False,
    max_num_hands=2,
    min_detection_confidence=0.75,
    min_tracking_confidence=0.75)

cap = cv2.VideoCapture(0) # 打开摄像头

while True:
    flag = 0 # 每一帧开始,重置手指计数器
    ret, frame = cap.read() # 读取一帧图像
    # BGR转RGB,mediapipe要求RGB输入
    frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
    # 水平翻转,自拍镜像
    frame = cv2.flip(frame, 1)
    # 模型推理
    results = hands.process(frame)
    # RGB转回BGR用于OpenCV绘图
    frame = cv2.cvtColor(frame, cv2.COLOR_RGB2BGR)

    # results.multi_handedness可以获取左右手信息,这里暂时注释
    #    if results.multi_handedness:
    #        for hand_label in results.multi_handedness:
    #            print(hand_label)

    # 判断是否识别到手
    if results.multi_hand_landmarks:
        # 遍历每一只手
        for hand_landmarks in results.multi_hand_landmarks:
            # 提取关键点:0号手腕,5号食指根部
            p0_x = hand_landmarks.landmark[0].x
            p0_y = hand_landmarks.landmark[0].y
            p5_x = hand_landmarks.landmark[5].x
            p5_y = hand_landmarks.landmark[5].y

            # 计算手腕(0)到食指根部(5)距离的平方,作为手掌基准长度
            # 使用距离平方,省去开根号,减少计算开销
            distance_0_5 = pow(p0_x - p5_x, 2) + pow(p0_y - p5_y, 2)
            base = distance_0_5 / 0.6 # 基准阈值,用来判断手指是否伸直

            # 大拇指指尖4号点坐标
            p4_x = hand_landmarks.landmark[4].x
            p4_y = hand_landmarks.landmark[4].y
            # 食指根部(5)到大拇指指尖(4)距离平方,用于判断大拇指伸直
            distance_5_4 = pow(p5_x - p4_x, 2) + pow(p5_y - p4_y, 2)

            # 食指指尖8号点
            p8_x = hand_landmarks.landmark[8].x
            p8_y = hand_landmarks.landmark[8].y
            # 手腕到食指指尖距离平方
            distance_0_8 = pow(p0_x - p8_x, 2) + pow(p0_y - p8_y, 2)

            # 中指指尖12号点
            p12_x = hand_landmarks.landmark[12].x
            p12_y = hand_landmarks.landmark[12].y
            distance_0_12 = pow(p0_x - p12_x, 2) + pow(p0_y - p12_y, 2)

            # 无名指指尖16号点
            p16_x = hand_landmarks.landmark[16].x
            p16_y = hand_landmarks.landmark[16].y
            distance_0_16 = pow(p0_x - p16_x, 2) + pow(p0_y - p16_y, 2)

            # 小指指尖20号点
            p20_x = hand_landmarks.landmark[20].x
            p20_y = hand_landmarks.landmark[20].y
            distance_0_20 = pow(p0_x - p20_x, 2) + pow(p0_y - p20_y, 2)

            # 判断食指:指尖到手腕距离大于基准值 → 判定伸直,计数+1
            if distance_0_8 > base:
                flag += 1
            # 判断中指
            if distance_0_12 > base:
                flag += 1
            # 判断无名指
            if distance_0_16 > base:
                flag += 1
            # 判断小指
            if distance_0_20 > base:
                flag += 1
            # 判断大拇指:大拇指距离阈值单独设置,base*0.3
            if distance_5_4 > base * 0.3:
                flag += 1
            # 限制最大计数为10(两只手最多10根手指)
            if flag >= 10:
                flag = 10

            # 绘制手部关键点和骨架连线
            mp_drawing.draw_landmarks(frame,
                                      hand_landmarks,
                                      mp_hands.HAND_CONNECTIONS)

    # 在画面左上角绘制识别到的手势文字,红色字体
    cv2.putText(frame, gesture[flag], (50, 50), 0, 1.3, (0, 0, 255), 3)
    # 显示窗口
    cv2.imshow('MediaPipe Hands', frame)
    # ESC退出
    if cv2.waitKey(1) & 0xFF == 27:
        break

# 释放摄像头
cap.release()
# 销毁窗口
cv2.destroyAllWindows()
5.3 启发式方法的优缺点
- 优点:零训练、零标注,代码直白,几行就能跑通,适合入门理解"用几何特征做判断"的思路。
- 缺点 :阈值(
/0.6、*0.3)是经验值,对手的倾斜角度、侧对摄像头、部分遮挡等情况鲁棒性有限;只能识别"伸出几根手指",无法区分更复杂的手势(如"OK""剪刀手")。要识别复杂手势,需要数据 + 机器学习。
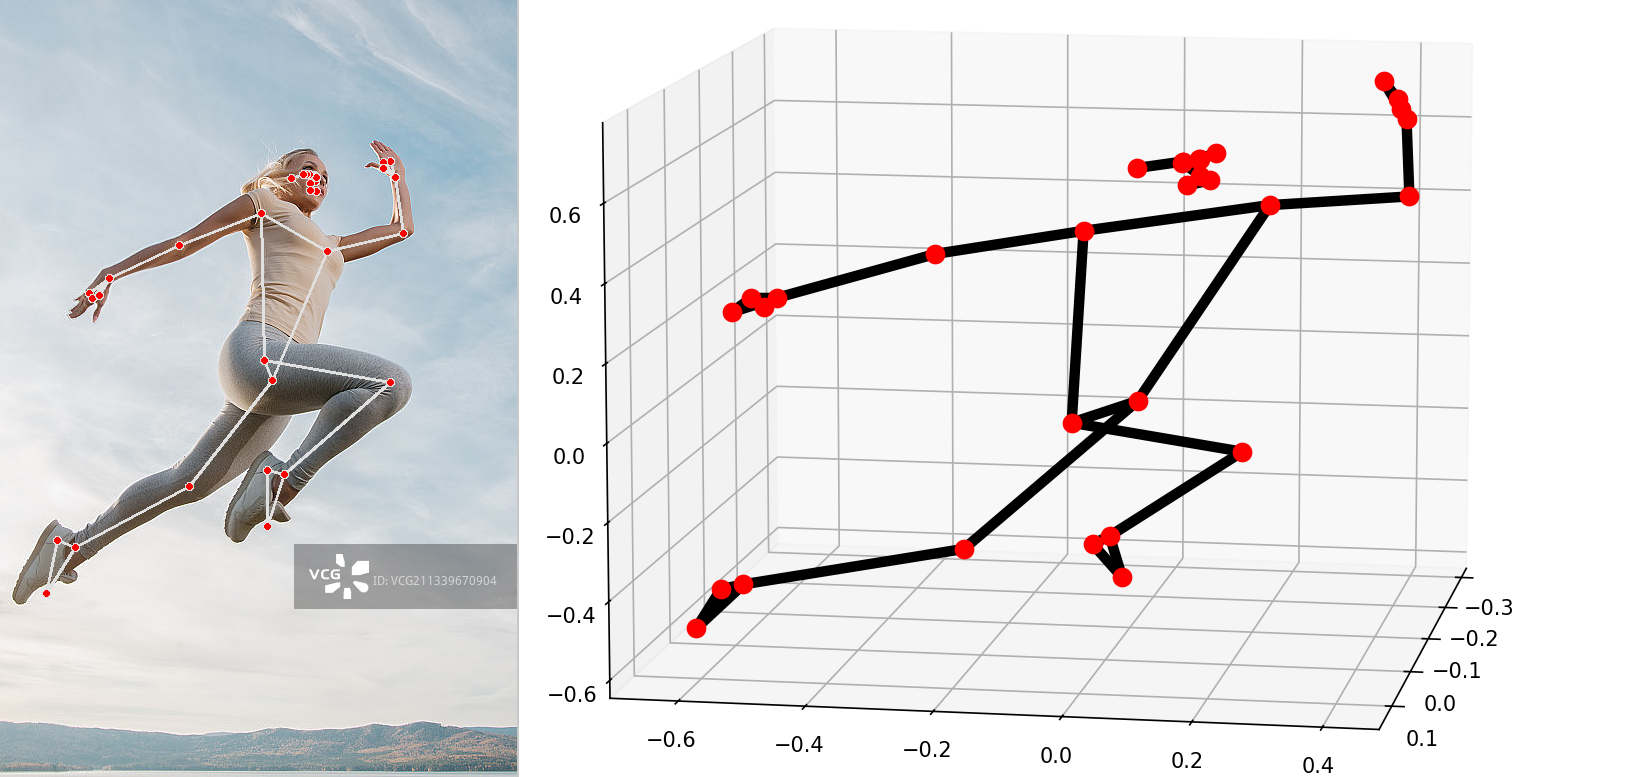
六、人体姿态检测(MediaPipe Pose)
6.1 Pose 参数详解
mp_pose.Pose() 的核心参数:
| 参数 | 取值 | 含义 |
|---|---|---|
static_image_mode |
True / False(默认) |
静态图像模式还是连续帧视频模式 |
model_complexity |
0 / 1 / 2 | 模型复杂度:0 最快最糙,1 折中,2 最慢最准(三者相比) |
smooth_landmarks |
True(默认) |
是否平滑关键点,抑制抖动 |
enable_segmentation |
True / False(默认) |
是否同时输出人体分割(抠图)掩膜 |
min_detection_confidence |
0.0, 1.0 | 检测置信度阈值 |
min_tracking_confidence |
0.0, 1.0 | 帧间跟踪置信度阈值 |
6.2 完整代码
python
import cv2
import mediapipe as mp

if __name__ == '__main__':
    # 导入mediapipe姿态检测模块
    mp_pose = mp.solutions.pose
    # 初始化姿态检测模型
    pose = mp_pose.Pose(static_image_mode=True,
                        model_complexity=1,
                        smooth_landmarks=True,
                        # enable_segmentation=True,
                        min_detection_confidence=0.5,
                        min_tracking_confidence=0.5)
    # 导入绘制工具,用于绘制关键点和连线
    drawing = mp.solutions.drawing_utils
    # 读取图片,opencv默认读取为BGR格式
    img = cv2.imread("img.png")
    # 显示原始输入图片
    cv2.imshow("input", img)
    # 将BGR转为RGB,mediapipe处理图像需要RGB格式
    img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    # 送入模型进行姿态关键点推理
    results = pose.process(img)
    # 转回BGR格式,用于opencv显示
    img = cv2.cvtColor(img, cv2.COLOR_RGB2BGR)
    # 打印姿态关键点总数量,mediapipe pose一共33个关键点
    print(len(results.pose_landmarks.landmark))
    # 遍历所有33个人体姿态关键点
    for i in range(len(results.pose_landmarks.landmark)):
        # 获取关键点归一化坐标x(宽方向)
        x=results.pose_landmarks.landmark[i].x
        # 获取关键点归一化坐标y(高方向)
        y=results.pose_landmarks.landmark[i].y
        # 获取关键点归一化深度z
        z=results.pose_landmarks.landmark[i].z
        # 打印该点的x,y,z归一化坐标
        print(x,y,z)
    # 在图片上绘制2D姿态关键点以及骨骼连线
    drawing.draw_landmarks(img, results.pose_landmarks, mp_pose.POSE_CONNECTIONS)
    # 绘制带关键点的图像
    cv2.imshow("keypoint", img)
    # 绘制世界坐标系下的3D姿态骨骼图(独立窗口)
    drawing.plot_landmarks(results.pose_world_landmarks, mp_pose.POSE_CONNECTIONS)
    # 等待任意按键,0代表无限等待
    cv2.waitKey(0)
    # 销毁所有opencv窗口
    cv2.destroyAllWindows()
效果演示:
七、人脸网格重建(FaceMesh)
7.1 参数与原理
FaceMesh 将人脸建模为稠密关键点网格 :默认输出 468 个关键点 ;当 refine_landmarks=True 时,会额外输出 10 个虹膜关键点 ,总计 478 个。
| 参数 | 取值 | 含义 |
|---|---|---|
static_image_mode |
True / False(默认) |
静态图 / 视频流模式 |
max_num_faces |
默认 1 | 最多检测的人脸数(脚本设为 2) |
refine_landmarks |
True |
是否输出虹膜关键点(468 → 478) |
min_detection_confidence / min_tracking_confidence |
0.0, 1.0 | 检测 / 跟踪置信度阈值 |
mp_face_mesh.FACEMESH_TESSELATION 定义了 468 个点之间的三角剖分连接关系,把稀疏点连成覆盖整张脸的密集网格(上千个三角面片),可用于 3D 人脸重建、美颜瘦脸、虚拟妆容、表情驱动等。
7.2 完整代码
python
import cv2
import mediapipe as mp

# 初始化 Mediapipe 人脸网格相关模块
mp_face_mesh = mp.solutions.face_mesh
# 绘制工具
mp_drawing = mp.solutions.drawing_utils
# 绘制样式工具
mp_drawing_styles = mp.solutions.drawing_styles

# 设置 Face Mesh 参数
face_mesh = mp_face_mesh.FaceMesh(
   static_image_mode=False,        # False为视频流模式,开启跟踪,速度更快
   max_num_faces=2,                # 最多检测2张人脸
   refine_landmarks=True,          # 开启精细化关键点,包含嘴唇、眼睛内轮廓,共478个点
   min_detection_confidence=0.5,   # 人脸检测置信度阈值
   min_tracking_confidence=0.5     # 关键点跟踪置信度阈值
)

# 打开摄像头,0代表默认摄像头
cap = cv2.VideoCapture(0)

# 摄像头正常打开则循环读取帧
while cap.isOpened():
   # 读取一帧画面,success标记是否读取成功,frame为图像BGR
   success, frame = cap.read()
   # 获取图像高度、宽度
   h, w = frame.shape[:2]
   # 读取失败则退出循环
   if not success:
       print("无法读取摄像头画面")
       break
   # OpenCV默认BGR,mediapipe需要RGB,转换颜色空间
   frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
   # 送入face mesh模型推理,获取人脸关键点结果
   results = face_mesh.process(frame_rgb)

   # 如果检测到人脸关键点
   if results.multi_face_landmarks:
       # 遍历每一张检测到的人脸
       for face_landmarks in results.multi_face_landmarks:
           # print(len(face_landmarks.landmark))    # 总共478个人脸关键点
           # 遍历478个关键点
           for i in range(len(face_landmarks.landmark)):
               # 获取归一化x坐标(0~1)
               x = face_landmarks.landmark[i].x
               # 获取归一化y坐标(0~1)
               y = face_landmarks.landmark[i].y
               # z = face_landmarks.landmark[i].z    # 归一化深度坐标
               # print(x,y,z)                       # 打印x,y,z坐标
               # 将归一化坐标转为像素坐标,绘制关键点编号文字
               cv2.putText(frame, str(i), (int(x * w), int(y * h)), cv2.FONT_HERSHEY_SIMPLEX, 0.3, (0, 255, 0), 2)
           # 绘制人脸网格
           mp_drawing.draw_landmarks(
               image=frame,
               landmark_list=face_landmarks,
               connections=mp_face_mesh.FACEMESH_TESSELATION, # 人脸三角网格连线
               landmark_drawing_spec=None,
               connection_drawing_spec=mp_drawing_styles.get_default_face_mesh_tesselation_style()
           )
   # 显示绘制好网格与编号的画面
   cv2.imshow('Face Mesh', frame)
   # 按下ESC键退出循环(ESC键ASCII码27)
   if cv2.waitKey(1)==27:
       break
# 释放摄像头资源
cap.release()
# 销毁所有opencv窗口
cv2.destroyAllWindows()
7.3 代码解析
7.3.1 初始化 FaceMesh
python
face_mesh = mp_face_mesh.FaceMesh(
    static_image_mode=False,
    max_num_faces=2,
    refine_landmarks=True,
    min_detection_confidence=0.5,
    min_tracking_confidence=0.5
)static_image_mode=False:视频流模式。MediaPipe 会利用上一帧结果做跟踪,速度更快;若设为True,则每帧都重新检测,适合处理单张图片。max_num_faces=2:最多同时处理 2 张人脸。注意,数值越大,计算量越大。refine_landmarks=True:在 468 个基础关键点之外,额外输出 10 个虹膜关键点(每只眼睛 5 个),共 478 个。虹膜点可用于视线估计、眼球驱动等。min_detection_confidence/min_tracking_confidence:阈值越低,越容易检出但误检可能增多;阈值越高,越严格但可能漏检。
7.3.2 归一化坐标 → 像素坐标
MediaPipe 输出的 x、y 是归一化坐标,范围 0, 1,需要乘以图像宽高才能映射到像素:
python
x_px = int(landmark.x * w)
y_px = int(landmark.y * h)
z 是相对深度,以人脸中心为原点,数值越小表示越靠近镜头,但它不是真实物理深度,仅用于相对比较。
7.3.3 绘制三角网格
python
mp_drawing.draw_landmarks(
    image=frame,
    landmark_list=face_landmarks,
    connections=mp_face_mesh.FACEMESH_TESSELATION,
    landmark_drawing_spec=None,
    connection_drawing_spec=mp_drawing_styles.get_default_face_mesh_tesselation_style()
)FACEMESH_TESSELATION:468 点之间的三角部分连接关系,画出后就是覆盖整张脸的密集网格。landmark_drawing_spec=None:不单独画点,只画连线,避免画面过于杂乱。get_default_face_mesh_tesselation_style():返回默认的白色细线样式。