一台服务器只有几个 CPU 核心,上面却同时跑着几百个进程,决定「谁先上 CPU、能占多久」的正是进程调度器。这篇把 Linux 的两套优先级体系(实时 / 非实时)一次分清,给出
ps、nice、renice、chrt的速查表与实测演示,也讲清实时进程为什么会把整机拖死、怎么防。文中命令名均标注英文全称(如chrt= change real-time attributes),完整清单见文末《附:命令英文全称速查表》。
一、两套优先级体系,先分清
可运行的进程数永远多于 CPU 数,所以内核的调度器要把 CPU 时间切出来分配。分配同时满足两件事:按时间片轮转 ------每个进程一次只跑一小段(通常 10~20ms),用完排到队尾等下一轮;按优先级调度------优先级高的在每一轮里分到更多 CPU 时间。
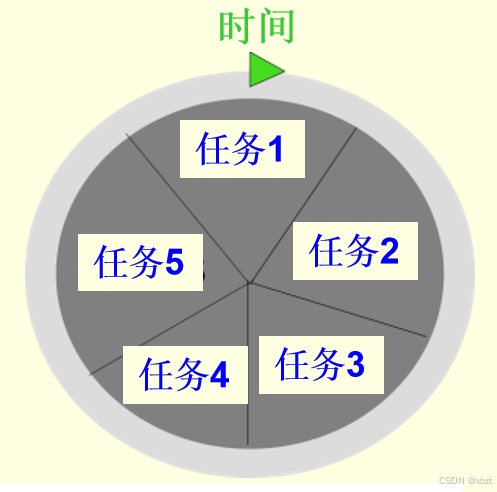
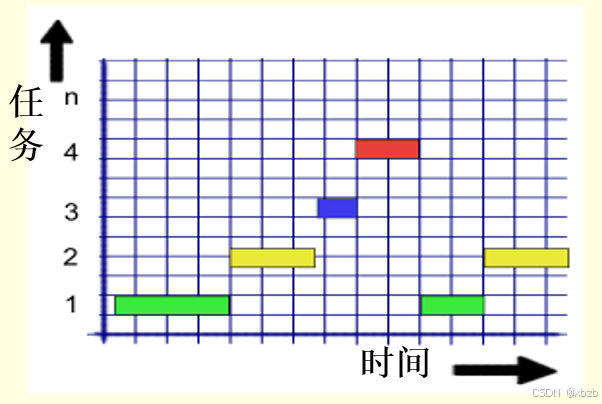
按「谁优先」的口径,调度器分成两类,而它们的优先级是两套完全不同的数字:
| 类别 | 调度策略 | 优先级范围 | 数字含义 | 谁能改 |
|---|---|---|---|---|
| 实时调度器 | SCHED_FIFO、SCHED_RR | 1 ~ 99 | 数字越大 优先级越高 | 只有 root(需 CAP_SYS_NICE) |
| 非实时调度器 | SCHED_NORMAL(即 SCHED_OTHER)、SCHED_BATCH、SCHED_IDLE | nice 值 -20 ~ 19 | 数字越大 优先级越低 | 普通用户可调高 nice |
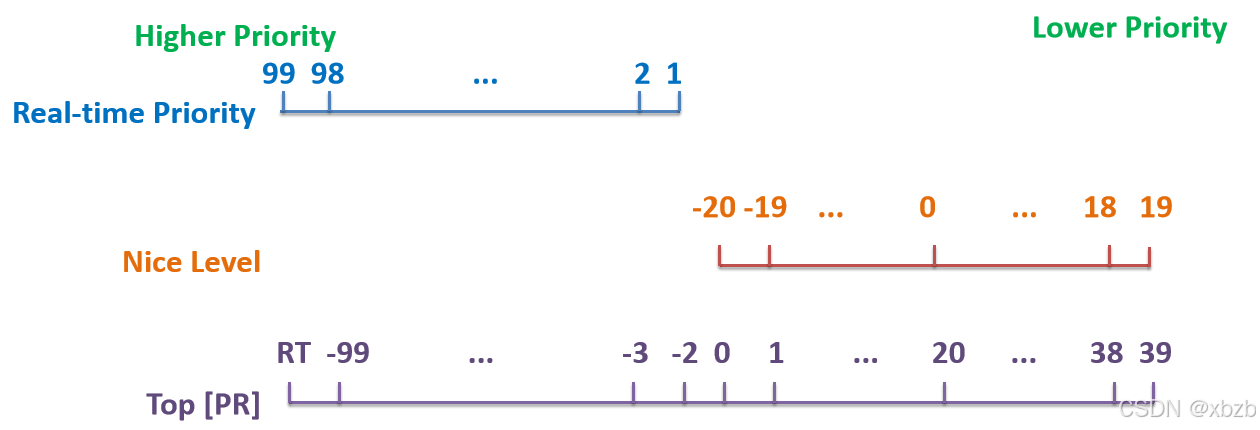 ⚠️ 注意 :两套数字不能直接比大小------优先级最低的实时进程(RT 1)依然高于 nice 为 -20 的普通进程 。别指望用
nice -20 去和实时进程抢 CPU。
二、调优三步走:看现状 → 改优先级 → 验证
- 看现状 :
ps -o pid,ni,cls,rtprio,cmd -p <PID>一眼看清它属于哪个调度类、nice 是多少;top里盯 NI 列和 %CPU。 - 改优先级 :还没启动的进程用
nice在启动时定好;已经在跑的,非实时用renice、实时用chrt。 - 验证 :
ps复查优先级是否真的落地;top看两个竞争进程的 %CPU 有没有按预期拉开差距。
2.1 看清现状:ps 字段速查表
| 写法 | 作用 | 说明(英文原意) |
|---|---|---|
ps -o pid,ni,cmd -p <PID> |
查 nice 值 | nice value,取值 19(最不友好)到 -20(最优先) |
ps -o pid,cls,rtprio,cmd -p <PID> |
查调度类与实时优先级 | cls :scheduling class;rtprio :realt ime priority |
ps -o pid,pri,ni,cmd $$ |
同时看 pri 与 ni |
$$ 是当前 shell 的 PID;pri 数字越大越优先 |
cls 列只显示缩写,对应关系如下:
| 缩写 | 调度策略 | 含义 |
|---|---|---|
TS |
SCHED_OTHER | 标准分时调度,绝大多数进程都是它 |
FF |
SCHED_FIFO | 实时、先入先出 |
RR |
SCHED_RR | 实时、时间片轮转 |
B |
SCHED_BATCH | 批处理,不跟交互任务抢 |
IDL |
SCHED_IDLE | 比 nice 19 还低 |
DLN |
SCHED_DEADLINE | 截止时间调度 |
bash
# 默认情况下,子进程继承父进程的 nice 值,通常为 0
[zhb@zhb-m1 ~]$ md5sum /dev/zero &
[1] 55725
[zhb@zhb-m1 ~]$ ps -o pid,nice,command $$ 55725
   PID  NI COMMAND
 52751   0 -bash
 55725   0 md5sum /dev/zero
2.2 top 里的 PR 与 NI 怎么换算
top 有两列相关字段:NI 是 nice 值(-20~19、默认 0;实时进程这一列没有实际意义,一般显示 0),PR 是把两套体系归一化后的调度优先级,数字越小越优先。
| 进程类型 | PR 换算规则 | 示例 |
|---|---|---|
| 普通进程 | PR = 20 + nice |
nice=0 → 20;nice=-10 → 10;nice=19 → 39 |
| 实时进程 | PR = -1 - RTPRIO |
RTPRIO=1 → -2;RTPRIO=10 → -11;RTPRIO=99 时不显示数字,显示 rt |
反推判据 :PR 为负(或直接显示 rt)而 NI = 0 → 一定是实时进程。按 PR = -1 - RTPRIO 反推,PR = -11 对应 RTPRIO = 10,即 SCHED_FIFO / SCHED_RR 的实时进程,NI 对它不起作用。
top(1) 手册对 rt 的原文说明:If you see 'rt' in this field ------ 看到 rt 就说明该任务正跑在实时调度优先级下。
两套工具的叫法容易撞车:ps 的 pri 与 top 的 PR 不是同一套渲染 (基数不同,别放在一起比大小)。判断是不是实时进程看 cls / rtprio,判断 nice 值看 NI,就够了。
三、非实时体系:nice 值怎么定
常规系统上绝大多数进程跑的都是 SCHED_OTHER 策略。它们之间不分绝对等级,只用 nice 值 表达相对优先级。nice 一共 40 级,范围 -20(最高优先级)到 19(最低优先级):
- nice 值越低 → 优先级越高 → 分到的 CPU 越多。
- nice 值越高 → 优先级越低 → 分到的 CPU 越少。
要注意:nice 值只在 CPU 有竞争时才起作用。系统空闲时,nice 为 19 的进程照样能跑满一个核------所以调优前先确认真的有人在抢。
四、改优先级:nice 与 renice
4.1 nice:进程启动时就定好
nice 用法速查表
| 写法 | 作用 | 说明(英文原意) |
|---|---|---|
nice |
打印当前 shell 的 niceness | 不带 COMMAND 时只显示值 |
nice <命令> |
比父进程低 10 级启动 | -n = --adjustment=N,默认值 10 |
nice -n 5 <命令> |
在继承值的基础上加 5 | --adjustment:add integer N to the niceness |
nice -n -5 <命令> |
提升优先级启动 | 普通用户无权,会报 Permission denied |
nice --adjustment=5 <命令> |
同上,长选项写法 | 短选项与长选项等价 |
bash
# 不带 -n,默认在父进程 nice(0)上加 10
[zhb@zhb-m1 ~]$ nice md5sum /dev/zero &
[1] 55742
[zhb@zhb-m1 ~]$ ps -o pid,nice,command
   PID  NI COMMAND
 52751   0 -bash
 55742  10 md5sum /dev/zero

# 普通用户设不了负数:报错后进程仍以原 nice 值(0)继续跑
[zhb@zhb-m1 ~]$ nice -n -2 md5sum /dev/zero &
nice: cannot set niceness: Permission denied

# 正数没问题
[zhb@zhb-m1 ~]$ nice -n 2 md5sum /dev/zero &
[zhb@zhb-m1 ~]$ ps -o pid,nice,command 55785
   PID  NI COMMAND
 55785   2 md5sum /dev/zero
4.2 renice:改已经在跑的进程
renice 用法速查表
| 写法 | 作用 | 说明(英文原意) |
|---|---|---|
renice -n 5 -p <PID> |
把 nice 设为 5 | ⚠️ 默认按绝对值解释,不是「加 5」 |
renice --relative 5 -p <PID> |
在当前值上加 5 | --relative:明确要求相对值 |
renice -n 5 -u zhb |
改某用户的全部进程 | -u = --user |
renice -n 5 -g <PGID> |
改整个进程组 | -g = --pgrp,进程组 ID |
renice -n -5 -p <PID> |
提升优先级 | 需要 root;-p 可省略 |
⚠️ 注意 :util-linux 的
renice -n与 POSIX 规定不同 ------默认按绝对优先级解释(renice -n 10 -p 1234是把 nice 设成 10,不是在原值上加 10),要相对加减必须显式用--relative。另外普通用户只能把 nice 调高(降优先级)且不可逆,提优先级只能用 root。
bash
# 普通用户降优先级:成功
[zhb@zhb-m1 ~]$ renice -n 2 55782
55782 (process ID) old priority 0, new priority 2

# 普通用户提优先级:被拒
[zhb@zhb-m1 ~]$ renice -n -2 55782
renice: failed to set priority for 55782 (process ID): Permission denied

# root 双向都能改
[root@zhb-m1 ~]# renice -n -2 55782
55782 (process ID) old priority 2, new priority -2
-n 容易误解,最保险的写法是按语义选选项 :直接设值用 --priority 5,加减用 --relative 5。
4.3 示例:三个 md5sum 看 nice 怎么分 CPU
同时跑三个满载进程,一个 nice 0、一个 nice 10、一个被 root 提到 nice -2,再看 top:
bash
[zhb@zhb-m1 ~]$ md5sum /dev/zero &              # 默认 nice 0,PID 55725
[zhb@zhb-m1 ~]$ nice md5sum /dev/zero &         # nice 10,PID 55742
[zhb@zhb-m1 ~]$ nice -n 2 md5sum /dev/zero &    # nice 2,PID 55785
[root@zhb-m1 ~]# renice -n -2 55725             # root 把它提到 -2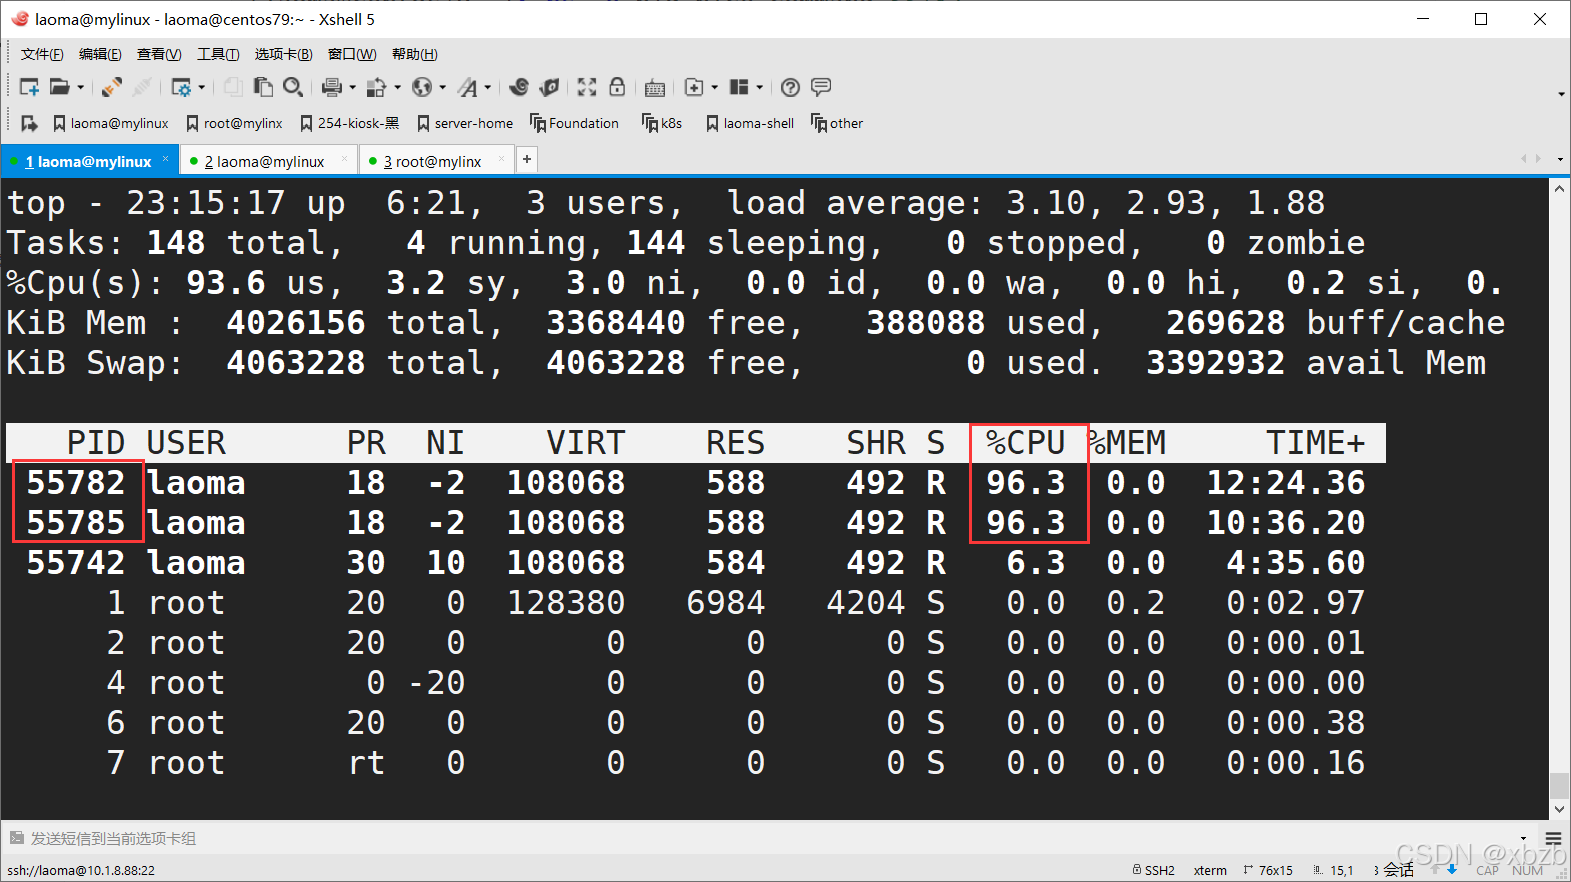
看两列就够了:NI 是 nice 值,%CPU 是实际分到的算力。nice 相同的两个进程几乎平分 CPU(各 96.3%),nice 为 10 的那个只剩 6.3%。
4.4 在 top 里直接改
top 运行中按 r (renice),按提示输入目标 PID 和新的 nice 值即可,不必另开终端。改完立刻生效,q 退出。
五、实时体系:chrt
实时调度器管的是「必须准时响应」的进程,只有两种策略:
- SCHED_FIFO:先入先出。拿到 CPU 就一直跑,直到被 I/O 阻塞或被更高优先级的实时进程抢占。
- SCHED_RR:时间片轮转。FIFO 的加强版,同优先级的实时进程按时间片轮流跑。
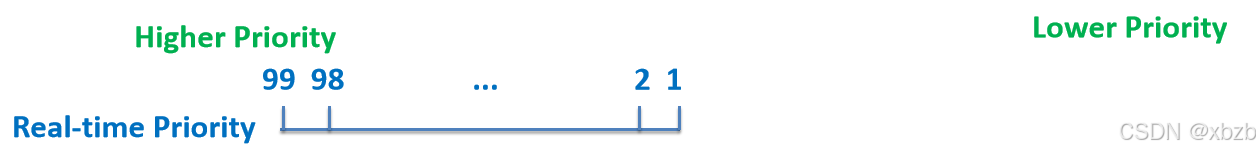
实时优先级范围是 1 ~ 99,数字越大越优先:
5.1 chrt 用法速查表
| 写法 | 作用 | 说明(英文原意) |
|---|---|---|
chrt -m |
列出各策略的优先级上下限 | -m = --max |
chrt -p <PID> |
查看进程当前的策略与优先级 | -p = --pid,操作已有进程 |
chrt -r 5 <命令> |
以 SCHED_RR、优先级 5 启动 | -r = --rr;不指定策略时默认也是 RR |
chrt -f 10 <命令> |
以 SCHED_FIFO、优先级 10 启动 | -f = --fifo |
chrt -o 0 -p <PID> |
改回非实时 SCHED_OTHER | -o = --other,此时优先级必须填 0 |
chrt -b 0 <命令> |
切到 SCHED_BATCH | -b = --batch,适合长时间批量任务 |
chrt -i 0 <命令> |
切到 SCHED_IDLE | -i = --idle,最低优先级 |
chrt -a -p <PID> |
连同该进程的所有线程一起处理 | -a = --all-tasks |
chrt -R -f 10 <命令> |
禁止子进程继承特权策略 | -R = --reset-on-fork |
⚠️ 注意 :改调度策略需要 CAP_SYS_NICE,也就是只有 root 能改 ,普通用户只能查看;
chrt也改不了非实时进程的 nice 值 (SCHED_OTHER 的优先级参数只能填 0,想调 nice 请用renice)。实时进程会抢占一切普通进程,动手前先确保 ssh 还能登进去。
bash
# 先看各策略的优先级上下限
[root@zhb-m1 ~]# chrt -m
SCHED_OTHER min/max priority	: 0/0
SCHED_FIFO min/max priority	: 1/99
SCHED_RR min/max priority	: 1/99
SCHED_BATCH min/max priority	: 0/0
SCHED_IDLE min/max priority	: 0/0
SCHED_DEADLINE min/max priority	: 0/0

# 以 SCHED_RR、优先级 5 启动 md5sum
[root@zhb-m1 ~]# chrt -r 5 md5sum /dev/zero &
[1] 56225
[root@zhb-m1 ~]# ps -o pid,cls,rtprio,command 56225
   PID CLS RTPRIO COMMAND
 56225  RR      5 md5sum /dev/zero

# 换成 SCHED_FIFO、优先级 10
[root@zhb-m1 ~]# chrt -f --pid 10 56225
[root@zhb-m1 ~]# ps -o pid,cls,rtprio,command 56225
   PID CLS RTPRIO COMMAND
 56225  FF     10 md5sum /dev/zero

# 玩完改回非实时,CLS 变回 TS、RTPRIO 变回 -
[root@zhb-m1 ~]# chrt -o --pid 0 56225
[root@zhb-m1 ~]# ps -o pid,cls,rtprio,command 56225
   PID CLS RTPRIO COMMAND
 56225  TS      - md5sum /dev/zero
chrt -m 打印的六行,就是六种策略各自的优先级范围:
| 调度策略 | 优先级范围 | 谁的优先级参数有效 |
|---|---|---|
| SCHED_OTHER | 0/0 | nice 值 |
| SCHED_FIFO | 1/99 | 实时优先级 |
| SCHED_RR | 1/99 | 实时优先级 |
| SCHED_BATCH | 0/0 | nice 值 |
| SCHED_IDLE | 0/0 | nice 值 |
| SCHED_DEADLINE | 0/0 | runtime / deadline / period |
只有 SCHED_FIFO 与 SCHED_RR 是真正的实时策略 ,也只有它们带 1~99 的实时优先级;其余四种在 chrt -m 里都显示 0/0,优先级要靠 nice 值或另外三个 deadline 参数表达。
5.2 三个「保险丝」:实时调度相关的 sysctl
实时进程的抢占能力最强,内核因此给它加了带宽限制,避免它吃光 CPU 之后连 ssh 都登不进来。三个开关都在 /proc/sys/kernel/ 下:
| 参数 | 默认值 | 作用 |
|---|---|---|
kernel.sched_rt_period_us |
1000000(1 秒) | 统计实时进程 CPU 用量的周期 |
kernel.sched_rt_runtime_us |
950000(0.95 秒) | 一个周期内实时进程最多能用多久;占满 95%,留 5% 给普通进程 |
kernel.sched_rr_timeslice_ms |
100(0.1 秒) | SCHED_RR 一个时间片多长,有效范围 1~100 |
bash
# 查看与临时修改
[root@zhb-m1 ~]# sysctl kernel.sched_rt_runtime_us
kernel.sched_rt_runtime_us = 950000
[root@zhb-m1 ~]# sysctl -w kernel.sched_rt_runtime_us=-1

# 永久生效写进 /etc/sysctl.d/
[root@zhb-m1 ~]# echo 'kernel.sched_rt_runtime_us = -1' > /etc/sysctl.d/99-rt.conf
[root@zhb-m1 ~]# sysctl -p /etc/sysctl.d/99-rt.conf
⚠️ 注意 :
sched_rt_runtime_us设0的含义是「实时进程一个周期内只能用 0 时间」,也就是实时进程彻底拿不到 CPU ;要解除 带宽限制得设-1,别把 0 当成「不限制」。
六、实时进程为什么会把整机拖死
6.1 根因:实时进程可运行,普通进程就排不上队
调度只看优先级。只要有一个 SCHED_FIFO / SCHED_RR 进程处于可运行状态,普通进程就永远轮不到,不是变慢而是完全不执行。被一起饿死的还有 sshd、systemd、shell、top,以及 ksoftirqd、rcu 这类内核线程。症状是 RCU stall、中断处理延迟,表现出来就是整机「没反应」。
唯一能救回一点响应的是 5.2 节那 5% 的余量:实时进程用光一个周期里的 95% 后会被内核按住,剩下的 5% 留给普通进程。把 sched_rt_runtime_us 改成 -1,这层保险就没了。
⚠️ 注意 :被饿死的对象里也有 sshd ------ ssh 登不进来、
top卡住、kill敲不动都是同一个原因。改实时策略前先另开一个终端保持登录。
6.2 RR 同样致命:轮转只在实时进程内部生效
SCHED_RR 的时间片轮转只在同一实时优先级的多个进程之间公平。只剩一个 RR 进程时,既没有同优先级竞争者、也没有更高优先级来抢占,它会一路跑到底。
md5sum /dev/zero 这类负载纯计算、不阻塞、不睡眠,于是它 100% 占住一个核、永不让出,行为上与 FIFO 没有区别。
常见误解:「RR 会轮转,所以安全。」轮转的公平只存在于实时进程内部、且限同优先级;对普通进程来说,RR 和 FIFO 一样致命。
6.3 卡死的四种典型场景
- 单核:一个 RR 实时进程就占满唯一的 CPU,所有普通进程饿死。
- 多核但实时进程数 ≥ 核数:每个核都被实时进程占住,普通进程照样没地方跑。
- 绑核 :
taskset把关键服务绑在实时进程占用的那个核上,该服务卡死。 - 内核线程被饿死:RCU stall、softirq 延迟,整机失去响应。
6.4 防卡死:六条可落地的做法
| 手段 | 写法 | 作用 |
|---|---|---|
| 加超时 | timeout 5 chrt -r 5 md5sum /dev/zero |
到点自动终止,进程不会赖在 CPU 上 |
| 限实时带宽 | 全局 kernel.sched_rt_runtime_us;cgroup v1 另有 cpu.rt_runtime_us |
强制实时进程周期性让出 CPU |
| 用最低可行优先级 | 优先级填 1,而不是 99 | 出事时还留有被更高优先级抢回的空间 |
| 留一个救援 shell | 卡死前就在另一个终端起 chrt -f 99 bash |
从这里 kill 肇事进程 |
| 优先 SCHED_DEADLINE | chrt -d --sched-period 10000000 --sched-runtime 1000000 0 <命令> |
自带带宽限制(每 10ms 最多跑 1ms),比裸 FIFO / RR 安全 |
| 生产环境慎用 | --- | 实时策略只留给必须准时的场景 |
bash
# 超时兜底:5 秒后自动终止
[root@zhb-m1 ~]# timeout 5 chrt -r 5 md5sum /dev/zero &

# 带宽限制有没有被触发过,看内核日志
[root@zhb-m1 ~]# dmesg | grep -i 'RT throttling'
实时带宽限制在 cgroup v1 里是 cpu.rt_runtime_us;cgroup v2 至今不支持实时进程的带宽控制 (内核文档明确标注 WARNING)。v2-only 的系统只能靠全局的 kernel.sched_rt_runtime_us。
附:命令英文全称速查表
| 命令 / 缩写 | 英文全称 / 原意 | 作用 |
|---|---|---|
nice |
nice(对别人「友善」的程度) | 以指定 nice 值启动程序 |
renice |
re -nice | 修改运行中进程的 nice 值 |
chrt |
ch ange r eal-time attributes | 查看 / 修改实时调度策略与优先级 |
ps |
p rocess status | 查看进程状态,含 NI / CLS / RTPRIO 字段 |
top |
t able o f processes | 动态查看进程与 CPU 占用 |
sysctl |
sys tem ctl | 读写在运行中的内核参数 |
SCHED |
scheduling | 调度策略前缀(SCHED_OTHER / FIFO / RR...) |
RT |
r eal-time | 实时 |
FIFO |
f irst i n, f irst out | 先入先出 |
RR |
r ound robin | 时间片轮询 |
NI / PR |
ni ce value / priority | top 里的 nice 值列与优先级列 |
CFS |
C ompletely F air Scheduler | SCHED_OTHER 的调度算法(2.6.23 引入) |
taskset |
task set | 把进程绑定到指定的 CPU 核 |
timeout |
time out | 给命令设一个最长运行时间 |
EDF |
e arliest d eadline first | 最早截止时间优先,SCHED_DEADLINE 的调度思想 |
RCU |
r ead-c opy update | 内核同步机制,被饿死会报 RCU stall |
📚 参考资料(官方文档 · 中英双语)
英文原版(man7.org)
中文版
其余手册在服务器上直接查(无需联网):
bash
man 1 nice      # 以指定 nice 值启动程序
man 1 renice    # 修改运行中进程的 nice 值
man 1 chrt      # 实时调度策略与优先级
man 1 ps        # 进程状态,NI / CLS / RTPRIO 字段
man 1 top       # 动态查看进程,r 键可改 nice
man 7 sched     # 各调度策略、优先级范围与 nice 值
记忆点 :命令后的数字是手册页编号 ------
1用户命令、5文件格式、7概念与概览、8系统管理命令。上面 man7.org 链接里的man1/man7就是同一套编号。
总结 :整篇就三条主线------实时看chrt(1~99,越大越优先),非实时看nice(-20~19,越大越靠后) ,两套数字不可比;看现状用ps的CLS/RTPRIO,或用top的PR/NI(普通进程PR = 20 + NI、实时进程PR = -1 - RTPRIO,负 PR 与rt都说明是实时进程);改优先级时,没启动的用nice、在跑的用renice,注意renice -n默认是绝对值;真要用实时策略,先想清楚它会不会把整机饿死------RR 的轮转只保护同优先级的实时进程,对普通进程和内核线程一样致命,记得留sched_rt_runtime_us那 5% 的余量给 ssh 和一条救援路子。觉得有用的话,点赞收藏,评论区聊聊你被 nice 值坑过的经历。