OceanBaseVS金仓:同一条复杂 SQL,为什么架构选择会改变延迟曲线
讨论 OceanBaseVS金仓的时候,最容易掉进去的坑是什么?就是"谁的性能更高"这种问法。为什么说它有问题呢?因为它没有前提条件啊。数据库的性能本来就不是个固定数值,架构、数据分布、事务大小、索引、网络距离,还有运维方式,这些都会改变最终的结果。所以与其给一个脱离环境的排行榜,不如先从两个具体的问题入手:
- 事务提交路径不一样,为什么会带来不一样的延迟特征?
- 多表关联、嵌套子查询和窗口函数组成的复杂 SQL,在两种架构下分别会经历什么?
这篇文章呢,把 OceanBase 的 Paxos 分布式架构,和 KingbaseES 常见的集中式或者共享存储架构,放进同一个分析框架里,聊聊架构效率、场景优化、资源消耗还有运维成本。这里要提前说明一下啊,因为没有在同一个硬件、同一个数据集上做过实测,所以文里的结论只限定在机制分析的范围内,不会把推断写成什么基准数字。 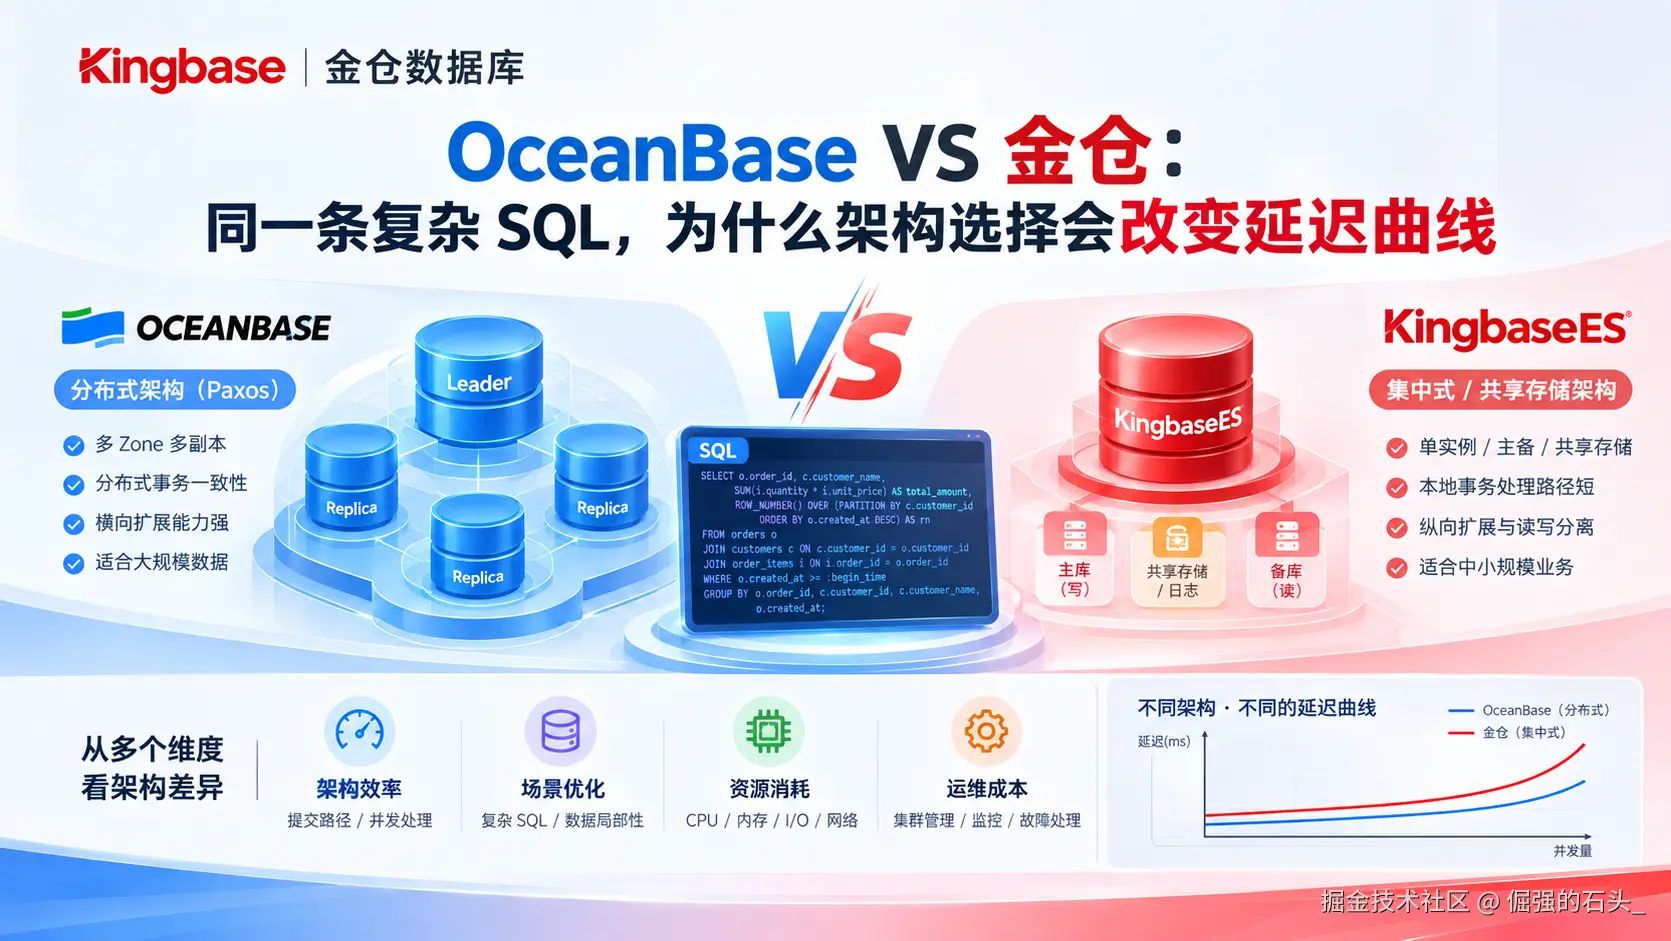
@toc
先把两种架构摆在同一张图上
OceanBase 的分布式部署,通常来说是由多个 Zone 和分区副本组成的,副本之间通过 Paxos 类协议去做选举和提交。那一个分区的写入呢,需要在副本之间达成一致,然后系统才向客户端确认提交。数据量和并发的话,可以通过分区拆分到多个节点上,计算和存储资源也能横向扩展。
KingbaseES 这边呢,在常见的单机、主备或者共享存储方案里,事务主要围绕一个数据库实例,或者一组紧耦合的节点来完成。客户端到数据库的网络路径更短一些。单库里面的锁、日志和缓存,都是由同一套实例来管理的。那扩展的话,通常优先考虑纵向升级、读写分离、分区表还有高可用集群。
简化之后的写入路径是这样的:
text
OceanBase:客户端 -> 分区 Leader -> 日志/副本复制 -> 多数派确认 -> 返回
KingbaseES:客户端 -> 数据库实例 -> 本地日志持久化/共享存储 -> 返回
那这到底是谁先进谁落后的问题吗?不是。其实是系统为了扩展性和一致性,把成本放在了不同的位置上。分布式架构呢,把一部分成本放在了网络和副本协议上;集中式架构呢,把更多的压力留在了单实例的 CPU、内存、日志还有存储系统上。就是这么回事。
延迟差异首先来自提交路径
在低延迟的局域网里,集中式数据库跑一次短事务,通常来说只需要完成本地的锁和日志持久化就行了,路径比较直接。OceanBase 的分布式事务呢,如果只涉及一个分区,也有可能接近单分区的处理方式。但要注意,跨分区的写入就需要协调多个分区了,提交阶段还要等副本多数派确认。那延迟就会跟着网络 RTT、Leader 分布还有副本负载变化,是一个动态的东西。 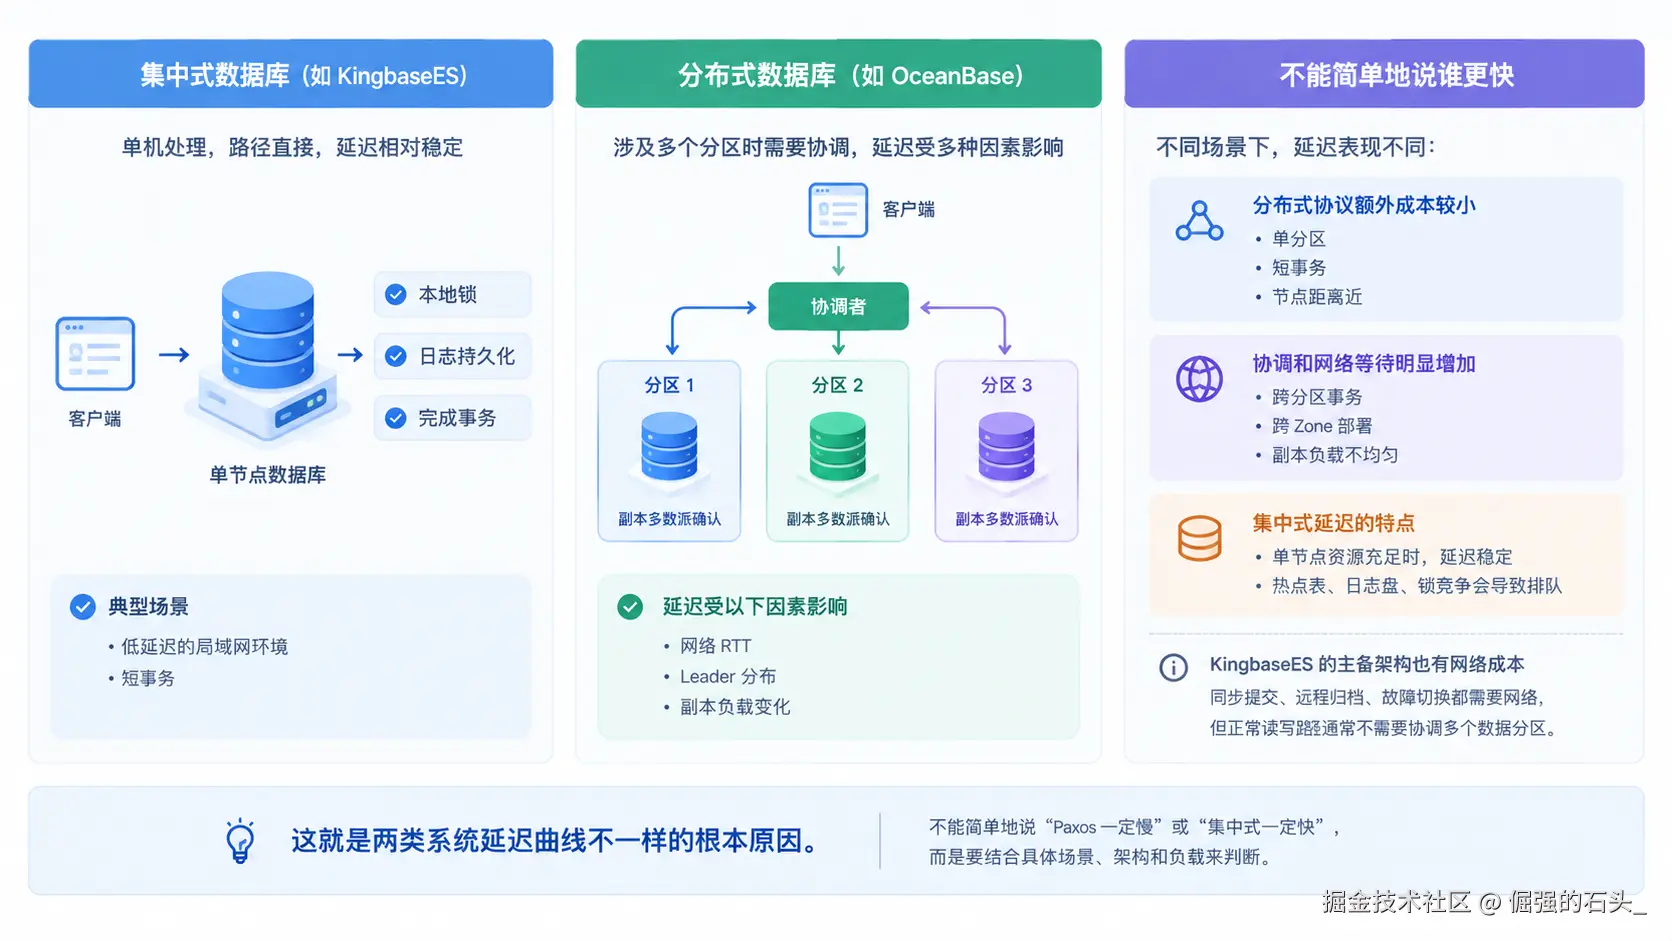
所以说,不能简单地说"Paxos 一定慢"或者"集中式一定快"。更准确的判断应该是这样:
- 单分区、短事务、节点距离又近的情况,分布式协议的额外成本可能比较小;
- 跨分区事务、跨 Zone 部署,或者副本负载不均匀的情况,协调和网络等待就会明显很多;
- 集中式实例在单节点资源充足的时候,延迟是稳定的。但是一旦热点表、日志盘或者锁竞争到了瓶颈,性能就会出现排队的情况。
另外要说一句,KingbaseES 的主备架构也不是完全没有网络成本的。同步提交、远程归档还有故障切换,这些都要考虑网络因素。只不过正常的读写路径呢,通常不需要为每个事务去协调多个数据分区。那这个差异,就是两类系统延迟曲线不一样的根本原因了。
复杂 SQL 的第一关:数据在哪里
复杂 SQL 的执行效率,首先取决于什么呢?取决于数据是不是集中在同一个执行节点上。拿订单、客户、商品这三表关联来举例:
sql
SELECT o.order_id,
       c.customer_name,
       SUM(i.quantity * i.unit_price) AS total_amount,
       ROW_NUMBER() OVER (
         PARTITION BY c.customer_id
         ORDER BY o.created_at DESC
       ) AS rn
FROM orders o
JOIN customers c ON c.customer_id = o.customer_id
JOIN order_items i ON i.order_id = o.order_id
WHERE o.created_at >= :begin_time
GROUP BY o.order_id, c.customer_id, c.customer_name, o.created_at;
在 KingbaseES 的集中式执行环境里呢,优化器可以直接在本地缓存、索引还有并行执行框架上,把连接、聚合和窗口计算都完成掉。数据量大的时候,瓶颈可能落在磁盘 I/O、内存排序或者单机 CPU 上。但好处是,执行计划的观察相对直接,比较好排查。
那在 OceanBase 里呢,情况就不一样了。如果三张表是按相同的业务键合理分区的,那连接可以尽量在本地分区里完成,这是理想情况。但如果分区键不一致的话,系统可能就需要对数据做重分布,或者跨节点传输,然后再去做 Join 和 Group By。到了这个时候呢,网络搬运量和中间结果的大小,会比 SQL 文本本身更影响延迟。也就是说,你光看 SQL 语句是看不出问题的。
所以复杂 SQL 的第一项优化是什么?不是去改写函数,而是检查分区键、数据局部性还有连接条件有没有对齐,这个顺序很重要。
嵌套子查询和半连接的代价
嵌套子查询呢,常见于权限过滤,还有"存在即返回"这种业务逻辑里:
sql
SELECT o.order_id, o.amount
FROM orders o
WHERE EXISTS (
    SELECT 1
    FROM risk_control r
    WHERE r.customer_id = o.customer_id
      AND r.level >= 3
)
AND o.amount > (
    SELECT AVG(amount)
    FROM orders
    WHERE created_at >= :begin_time
);
优化器有可能会把 EXISTS 改写成半连接,把标量子查询提升成一次聚合。那集中式执行器呢,在本地就能把这些变换做完,数据流转比较少。分布式执行器的话,还要多判断几件事:子查询结果需不需要广播?能不能下推到分区?会不会产生跨节点的依赖?
那这是不是意味着 OceanBase 就执行不了复杂子查询呢?不是的。只是说,SQL 设计需要更重视可分布性这一块:过滤条件尽量早点下推,连接键尽量包含分区键,避免先产生一个巨大的中间结果,再拿到跨节点去做聚合。KingbaseES 这边呢,要更关注的东西不一样,是本地索引、统计信息还有内存设置,要避免单机排序或者 Hash Join 溢出到磁盘上去。
窗口函数的执行资源
窗口函数呢,通常来说需要排序,或者维护分区状态。比如按客户去算最近的订单:
sql
SELECT customer_id,
       order_id,
       created_at,
       ROW_NUMBER() OVER (
         PARTITION BY customer_id
         ORDER BY created_at DESC
       ) AS seq
FROM orders;
在集中式数据库里,主要的风险是什么呢?是排序内存不够用,还有临时文件不停增长。那怎么控制呢?可以通过合适的索引、限定时间范围,还有调整工作内存这几个手段。在分布式数据库里呢,要看窗口分区键和数据分区键是不是一致的。一致的话,计算可以在本地完成,没多大问题。不一致的话,窗口计算之前可能就需要重新分发数据,网络和临时空间的成本就会明显上去了。
这也是为什么不能只拿"同一条 SQL 在两个数据库上跑了几秒"来做比较。那要怎么做才对呢?必须同时记录执行计划、扫描行数、网络传输量、临时空间还有并发条件。不然的话,你根本判断不了差异到底是来自架构,还是来自索引和参数的设置。
架构效率与资源消耗的取舍
OceanBase 的优势更多体现在规模和弹性这两块:数据可以拆到多个节点,计算资源可以按节点扩展,单个节点挂了还有副本和调度机制接管。但是要注意,它需要更多集群层级的资源。哪些呢?副本存储、网络带宽、监控组件,还有运维人员对分区、租户、Zone 这些概念的理解,缺一不可。
KingbaseES 的集中式或者共享存储部署呢,资源模型更容易估算一些。单机内存、日志盘、连接数还有缓存命中率,是主要的变量。主备和读写分离的话,可以在不改业务数据模型的前提下,提升可用性和读吞吐。那代价是什么呢?单节点扩展有上限。如果是超大规模数据,或者要持续横向扩展的场景,就要更早去规划分区、集群和存储了。 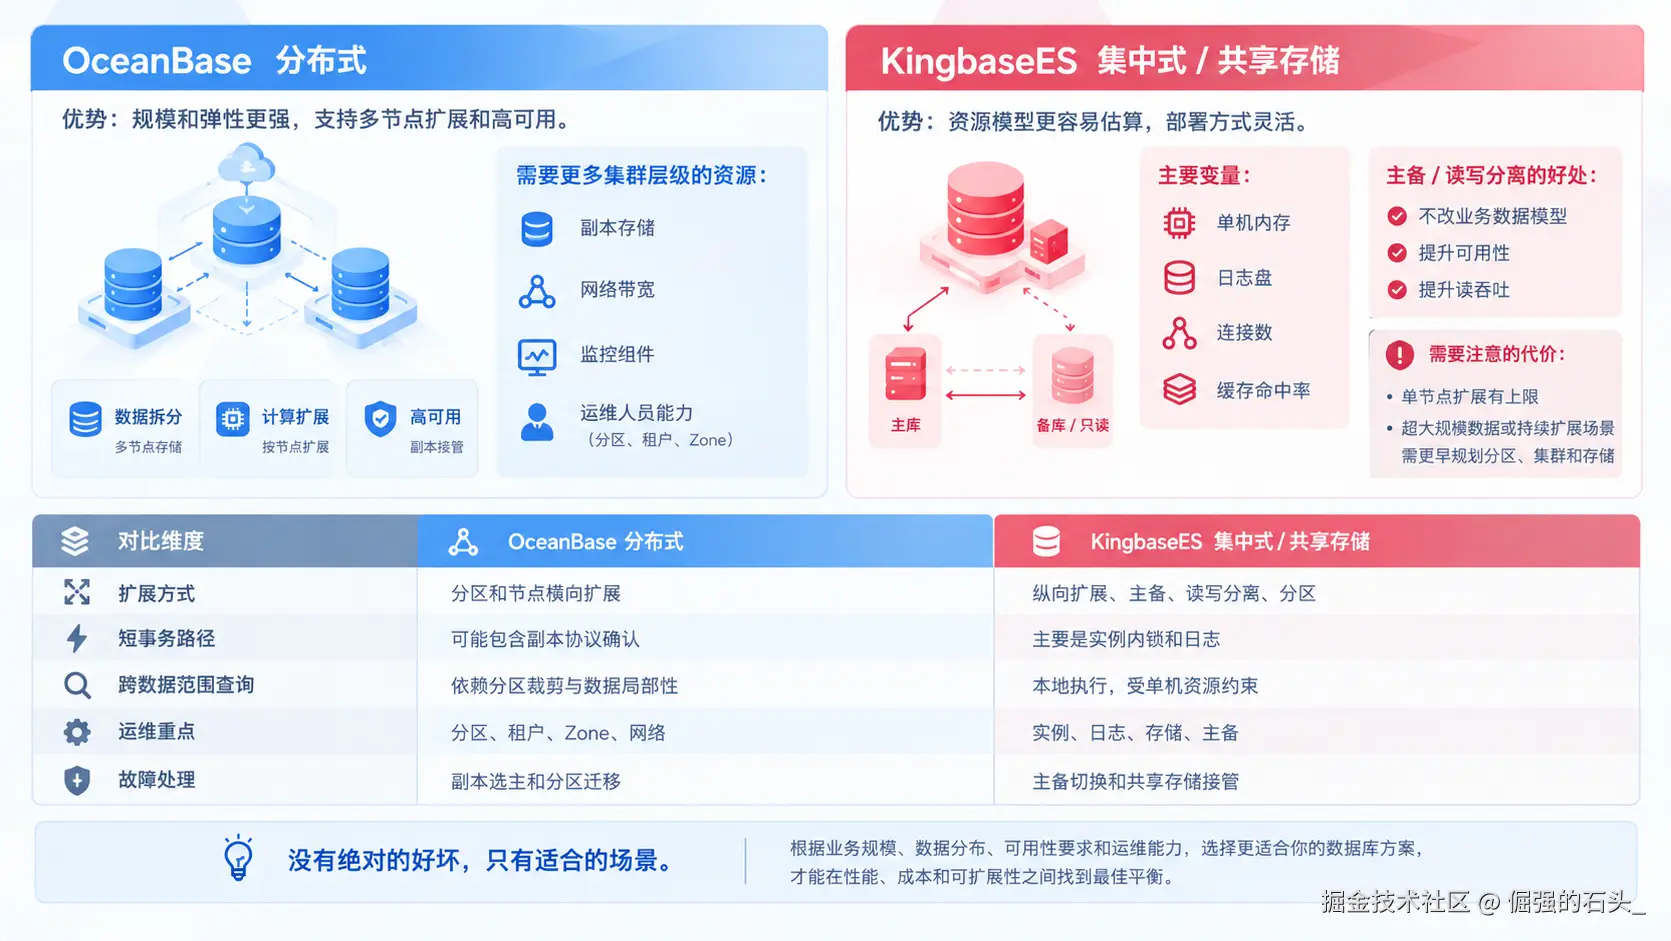
可以用一张表来概括这种取舍:
| 维度 | OceanBase 分布式 | KingbaseES 集中式/共享存储 |
|---|---|---|
| 扩展方式 | 分区和节点横向扩展 | 纵向扩展、主备、读写分离、分区 |
| 短事务路径 | 可能包含副本协议确认 | 主要是实例内锁和日志 |
| 跨数据范围查询 | 依赖分区裁剪与数据局部性 | 本地执行,受单机资源约束 |
| 运维重点 | 分区、租户、Zone、网络 | 实例、日志、存储、主备 |
| 故障处理 | 副本选主和分区迁移 | 主备切换和共享存储接管 |
那这张表描述的是什么呢?是系统机制,不是性能排名,这个要分清楚。实际的结果,必须由业务数据和部署方式来验证。
如果要做严谨的 OceanBaseVS金仓测试
虽然这篇文章没有编造测试数字,但真正选型的时候,是可以建立一套可复现的基准的。怎么做呢:
- 固定相同的 CPU、内存、磁盘和网络条件;
- 用相同规模、相同数据分布和相同索引;
- 分别测单分区短事务、跨分区事务、多表 Join、嵌套子查询还有窗口函数;
- 记录 p50、p95、p99 延迟、吞吐、CPU、内存、磁盘 I/O、网络流量还有临时空间;
- 预热缓存之后再测,并且要区分冷启动和稳态的结果;
- 每条 SQL 都保存执行计划,确认有没有发生数据重分布,或者计划退化的情况。
测试 SQL 的话,可以从简单到复杂,逐步往上加:
sql
-- 单表点查
SELECT * FROM orders WHERE order_id = :id;

-- 多表关联
SELECT o.order_id, c.customer_name, SUM(i.quantity * i.unit_price)
FROM orders o
JOIN customers c ON c.customer_id = o.customer_id
JOIN order_items i ON i.order_id = o.order_id
GROUP BY o.order_id, c.customer_name;
只有这样得到的结果,才够格去支持"某个架构更适合某种场景"这种判断。否则的话,测出来的数字其实说明不了什么。
我的结论
OceanBaseVS金仓这个话题,核心不是把两个产品压缩成一个简单的名次,而是要看业务到底需不需要分布式横向扩展,还有能不能为分区和网络协调付出相应的设计和运维成本。OceanBase 的 Paxos 分布式架构呢,适合把数据和计算拆到多个节点上,然后通过副本协议拿到集群层级的可用性;KingbaseES 的集中式或者共享存储架构呢,在单库事务路径、部署复杂度还有本地 SQL 调优这几个方面,更直接一些。
那对于多表关联、嵌套子查询和窗口函数来说,决定执行效率的往往是什么呢?其实不是 SQL 关键字的多少,而是数据局部性、分区键、索引还有中间结果的规模。分布式系统要尽量让计算靠近数据;集中式系统呢,要把单机的 CPU、内存和 I/O 调到合理的状态。
所以选型的时候,我不会只问"谁更快",我会先问几个问题:数据规模需不需要横向扩展?事务是不是频繁跨分区?团队有没有分布式运维的能力?复杂 SQL 的访问路径,能不能被稳定地观测和优化?那把这些问题都回答清楚了,OceanBaseVS金仓才不会停留在口号式的比较上,而是变成一个可以真正落地的架构决策。