文章目录
- 第一章:从数据类型到底层编码的演进与权衡
-
- [1、 Redis 的核心数据结构全景](#1、 Redis 的核心数据结构全景)
- [2、 编码方式:Redis 的"鸭子类型"与自适应魔法](#2、 编码方式:Redis 的“鸭子类型”与自适应魔法)
- 补充:redis的引号和大小写
- [三、 如何查看实际编码:`object encoding` 的应用](#三、 如何查看实际编码:
object encoding的应用) - [四、 走出"记忆数字"的误区:从应试思维到工程思维](#四、 走出“记忆数字”的误区:从应试思维到工程思维)
- [第二章:Redis 的线程模型与高性能架构解密](#第二章:Redis 的线程模型与高性能架构解密)
-
- [1、 单线程模型与并发安全探秘](#1、 单线程模型与并发安全探秘)
- [2、 速度之谜:为何单线程依然高效?](#2、 速度之谜:为何单线程依然高效?)
- [3、 网络 IO 的挑战与 epoll 机制](#3、 网络 IO 的挑战与 epoll 机制)
- [第三章:Redis 字符串类型深度解析与核心命令实战](#第三章:Redis 字符串类型深度解析与核心命令实战)
-
- [3.1 字符串类型概述与底层设计](#3.1 字符串类型概述与底层设计)
-
- [3.1.1 二进制安全与数据存储](#3.1.1 二进制安全与数据存储)
- [3.1.2 单线程模型与危险指令](#3.1.2 单线程模型与危险指令)
- [3.2 键值基础操作:SET 与 GET](#3.2 键值基础操作:SET 与 GET)
-
- [3.2.1 SET 命令及其扩展选项](#3.2.1 SET 命令及其扩展选项)
- [3.2.2 GET 命令与类型安全](#3.2.2 GET 命令与类型安全)
- [3.3 批量操作与网络优化:MSET 与 MGET](#3.3 批量操作与网络优化:MSET 与 MGET)
-
- [3.3.1 批量读写命令详解](#3.3.1 批量读写命令详解)
- [3.3.2 性能对比:多次单条命令与单次批量命令](#3.3.2 性能对比:多次单条命令与单次批量命令)
- [3.4 数值计数与原子操作:INCR 家族](#3.4 数值计数与原子操作:INCR 家族)
-
- [3.4.1 INCR 与 DECR:加减一操作](#3.4.1 INCR 与 DECR:加减一操作)
- [3.4.2 INCRBY 与 DECRBY:指定步长操作](#3.4.2 INCRBY 与 DECRBY:指定步长操作)
- [3.4.3 INCRBYFLOAT:浮点数运算](#3.4.3 INCRBYFLOAT:浮点数运算)
- [3.4.4 单线程架构下的原子性保证](#3.4.4 单线程架构下的原子性保证)
- [3.5 字符串内容处理:APPEND、GETRANGE、SETRANGE 与 STRLEN](#3.5 字符串内容处理:APPEND、GETRANGE、SETRANGE 与 STRLEN)
-
- [3.5.1 APPEND:追加内容](#3.5.1 APPEND:追加内容)
- [补充: Redis 中的 Unicode 编码问题](#补充: Redis 中的 Unicode 编码问题)
- [3.5.2 GETRANGE:获取子串与字符编码陷阱](#3.5.2 GETRANGE:获取子串与字符编码陷阱)
- [3.5.3 SETRANGE:覆盖与自动填充](#3.5.3 SETRANGE:覆盖与自动填充)
- [3.5.4 STRLEN:获取长度](#3.5.4 STRLEN:获取长度)
- [3.6 综合命令对照表](#3.6 综合命令对照表)
- [第四章:String 内部编码与典型应用场景深度解析](#第四章:String 内部编码与典型应用场景深度解析)
-
- [4.1 String 的三种内部编码](#4.1 String 的三种内部编码)
-
- [4.1.1 int 编码](#4.1.1 int 编码)
- [4.1.2 embstr 编码](#4.1.2 embstr 编码)
- [4.1.3 raw 编码](#4.1.3 raw 编码)
- [4.1.4 object encoding 实战](#4.1.4 object encoding 实战)
- [4.1.5 不要死记"39 字节"这个数字](#4.1.5 不要死记“39 字节”这个数字)
- [4.1.6 如果确实想改阈值,应该怎么做?](#4.1.6 如果确实想改阈值,应该怎么做?)
- [4.2 String 的典型应用场景](#4.2 String 的典型应用场景)
-
- [4.2.1 缓存(Cache)功能](#4.2.1 缓存(Cache)功能)
- [4.2.2 计数(Counter)功能](#4.2.2 计数(Counter)功能)
-
- [Redis 并不擅长做统计](#Redis 并不擅长做统计)
- [4.2.3 共享会话(Session)](#4.2.3 共享会话(Session))
-
- [问题:Session 分散存储](#问题:Session 分散存储)
- 医院挂号的比喻
- [解决方案:Redis 集中管理 Session](#解决方案:Redis 集中管理 Session)
- [4.2.4 手机验证码](#4.2.4 手机验证码)
- 第五章:业务视角下的高并发优化------从技术实现走向问题解决
-
- [5.1 业务才是技术的出发点和落脚点](#5.1 业务才是技术的出发点和落脚点)
- [5.2 12306 案例:业务优化如何化解超高并发](#5.2 12306 案例:业务优化如何化解超高并发)
- [5.3 对 Redis 实践的启示](#5.3 对 Redis 实践的启示)
第一章:从数据类型到底层编码的演进与权衡
1、 Redis 的核心数据结构全景
在日常开发中,Redis 最常用的数据结构主要包含五种:String(字符串)、Hash(哈希)、List(列表)、Set(集合)和 ZSet(有序集合)。尽管当前版本的 Redis 支持多达 10 种数据类型,但这五种基础结构覆盖了绝大多数业务场景,其余的几种类型往往是针对特定场景下的特殊数据类型或结构扩展。
从跨语言的角度来理解,这些数据结构在底层思想上与其他编程语言的标准库有着异曲同工之妙。例如,String 类似于 C++ 的 std::string 或 Java 的 String;Hash 类似于 C++ 的 std::unordered_map 或 Java 的 HashMap;List 类似于 C++ 的 std::deque 或 Java 的 List;Set 则类似于 C++ 的 std::set 或 Java 的 Set。而对于 ZSet(有序集合),它除了存储 member 之外,还需要存储一个 score(权重、分数),以此来实现有序性。
2、 编码方式:Redis 的"鸭子类型"与自适应魔法
很多开发者容易将 Redis 的数据类型与底层数据结构混为一谈。事实上,Redis 在底层实现上述数据结构时,会在源码层面针对特定场景进行深度优化,以达到节省时间和空间的目的。 这就引出了一个核心概念:编码方式(Encoding)。
同一个数据类型,背后可能对应的底层实现(编码方式)是不同的 。这种设计理念可以被生动地理解为编程界著名的"鸭子理论":如果一个东西走起来像鸭子,叫起来也像鸭子,那么它就可以被当作鸭子。Redis 承诺给使用者提供某种操作(例如在 Hash 中进行查询、插入、删除,并保证 O(1) 的时间复杂度),但这背后的实现不一定是一个标准的哈希表。在特定场景下,Redis 可能会使用其他数据结构来实现,只要依然保证时间复杂度的承诺即可。
对于程序的使用者而言,通常感知不到底层编码的存在,因为 Redis 会根据当前实际情况自动适应并选择最合适的内部编码。
以下是数据类型与底层编码的对应关系及其原理解析:
| Redis 类型 | 编码名称 | 结构是什么样 | 为什么使用 | 使用场景 |
|---|---|---|---|---|
| String | raw | 普通连续字符数组,例如:['h','e','l','l','o'] |
最基础的字符串保存方式 | 保存普通字符串、JSON、文件内容 |
| int | 直接保存整数,例如:100,不是保存 "100" 这三个字符 |
整数占用空间更小,计算更快 | 计数器:INCR views |
|
| embstr | 字符串对象和字符串内容放在一起分配,例如:对象 + hello |
减少一次内存申请,降低内存碎片 | 短字符串:name=Tom |
|
| Hash | hashtable | 类似字典:key → value,例如:name → Tom |
通过 hash 快速定位数据 | 大 Hash,例如用户有几十个属性 |
| ziplist | 一块连续内存,数据挨着存:name Tom age 18 |
不需要大量指针,节省内存 | 小 Hash,例如只有几个字段 | |
| List | linkedlist | 双向链表:A ⇄ B ⇄ C,每个节点保存数据和前后指针 |
插入删除快 | 传统链表结构 |
| ziplist | 连续内存:A B C D,元素紧挨保存 |
元素少时占用空间小 | 小列表 | |
| quicklist | 外层链表,内部每个节点是 ziplist:链表 → ziplist → 数据 |
结合链表操作速度和 ziplist 节省空间 | Redis 3.2 后 List 默认结构 | |
| Set | hashtable | 哈希表保存元素:Tom → 空、Jack → 空 |
判断元素是否存在非常快 | 字符串集合 |
| intset | 整数数组:[1,2,3,4] |
整数连续保存,非常省内存 | 纯数字集合 | |
| ZSet | ziplist | 成员和分值连续保存:Tom 100 Jack 90 |
数据少,直接遍历即可 | 小规模排行榜 |
| skiplist | 多层链表:底层保存全部数据,上层保存部分索引 | 类似增加"快速通道",查询从 O(N) 降到 O(logN) | 大规模排行榜 |
补充:redis的引号和大小写
Redis 中字符串参数通常可以不加引号 ,例如 SET name redis
也可以使用单引号或双引号包裹 ,例如 SET name 'redis'、SET name "redis"
引号只是客户端解析时用于界定字符串,不会作为实际数据保存;只有字符串中包含空格等特殊字符时才需要加引号。SET name "hello redis"
需要注意的是,Redis 命令本身大小写不敏感 (如 SET、set、SeT 等效),但key 和 value 的内容大小写敏感 ,例如 name 和 Name 是不同的 key,Redis 和 redis 也是不同的字符串。
三、 如何查看实际编码:object encoding 的应用
在 Redis 客户端中,我们可以通过 OBJECT ENCODING 命令来查看 key 对应的 value 的实际编码方式。例如:
bash
127.0.0.1:6379> type key1
string
127.0.0.1:6379> OBJECT ENCODING key1
"int"
127.0.0.1:6379> get key1
"111"
127.0.0.1:6379> type key2
list
127.0.0.1:6379> OBJECT ENCODING key2
"quicklist"
127.0.0.1:6379> type key3
set
127.0.0.1:6379> OBJECT ENCODING key3
"intset"
127.0.0.1:6379> type key4
hash
127.0.0.1:6379> OBJECT ENCODING key4
"ziplist"
四、 走出"记忆数字"的误区:从应试思维到工程思维
面对上述编码机制,许多开发者会陷入一个常见的误区:死记硬背阈值数字。例如,网上流传着这样的说法:"如果字符串长度小于 39 字节,使用 embstr;超过 39 字节,使用 raw。"
记住这些数字,实际上没有任何意义。
首先,数字都是可以配置的。其次,很多数字在源码中是"拍脑袋"来的(或者基于特定版本的测试基准)。相比于知道具体的数字,更重要的是知道这个数字是怎么得来的。只要了解了其背后的原理和测试方法,就可以根据所处的实际场景,重新测试并得到最适合当前业务的数字。
第二章:Redis 的线程模型与高性能架构解密
在深入理解了 Redis 丰富的数据结构及其底层编码机制后,我们不禁要问:支撑这一切高效运转的引擎究竟是什么?这就是 Redis 架构设计中最为人津津乐道的核心命题------单线程模型与 IO 多路复用机制。这不仅是面试中的高频考点,更是理解 Redis 微观运作机理的必经之路。
1、 单线程模型与并发安全探秘
在日常认知中,Redis 服务器进程往往被描述为"单线程" 。然而,这种说法需要更精确的界定。准确地说,Redis 使用一个主线程来处理所有的命令请求。但这并不意味着 Redis 服务器进程内部真的只有一个线程,实际上它也有多个线程,只是这些额外的线程主要用于处理网络 IO 等辅助任务。
为了理解这种设计如何应对并发,我们可以设想这样一个场景:假设有多个客户端(redis-cli)同时操作一个 Redis 服务器,并发地发起 incr counter 命令,作用是将 key 对应的 value 进行加 1 操作。
在多线程环境中,这会引发经典的线程安全问题。两个线程尝试同时对一个变量进行自增,表面上看是自增了两次,实际上可能因为竞态条件只自增了一次。那么,Redis 面临这样的并发请求时,是否也会出现类似的线程安全问题呢?
答案是幸运的,并不会。Redis 服务器实际上是单线程模型,这保证了最初收到的这多个请求是串行执行的。当多个请求同时到达 Redis 服务器时,它们必须在队列中排队,等待 Redis 服务器一个个地取出里面的命令再执行 。从微观层面来看,Redis 服务器是串行、顺序执行这些命令的。
这就像学校食堂只有一个打饭窗口一样。从宏观上看,一到放学,学生们(请求)蜂拥而至,跑向食堂,呈现并发执行的态势;但微观上,进了食堂的门,所有人还是要老老实实排队,一个一个打饭。
Redis 能够使用单线程模型很好地工作,核心原因在于其核心业务逻辑都是"短平快"的,不太消耗 CPU 资源,也不太吃多核 。当然,这也带来了一个不可忽视的弊端:Redis 必须要特别小心,因为一旦某个操作占用时间过长,就会阻塞其他命令的执行。
2、 速度之谜:为何单线程依然高效?
既然 Redis 是单线程模型,为何效率这么高?速度这么快?要解开这个谜题,我们可以将其与传统的数据库(如 MySQL、Oracle、SQL Server)进行对比,从四个维度来剖析:
- 访问介质不同:Redis 访问的是内存,而数据库则是访问硬盘。这从根本上决定了前者的速度远快于后者。
- 功能复杂度不同 :Redis 核心功能比数据库的核心功能更简单。数据库对于数据的插入、查询等,有更复杂的功能支持,这种功能势必要花费更多的开销。比如,针对插入删除,数据库中的各种约束,都会使数据库做额外的工作。Redis 干的活少,提供的功能相比于 MySQL 也少了不少。
- 避免了线程竞争开销:单线程模型避免了一些不必要的线程竞争开销。Redis 每个基本操作都是短平快的------就是简单操作一下内存数据,不是什么特别消耗 CPU 的操作。就算搞多线程,性能提升也不大。
- IO 多路复用机制 :
在处理网络 IO 的时候,Redis 使用了epoll这样的 IO 多路复用机制,这也是最为核心的技术支撑。
3、 网络 IO 的挑战与 epoll 机制
要理解 IO 多路复用,首先需要了解传统的网络 IO 痛点。针对 TCP 来说,服务器每次要服务一个客户端,都需要给这个客户端安排一个 socket。一个服务器服务多个客户端,同时就有很多个 socket。
这些 socket 上都是无时不刻在传输数据吗?答案是否定的。 很多时候,每个客户端和服务器之间的通信也没那么频繁。此时这么多 socket 大部分时间都是静默的,上面是没有数据需要传输的。在同一时刻,只有少数 socket 是活跃的。
在最初介绍 TCP 服务器的时候,有一个基础版本就是每个客户端给分配一个线程。客户端多了,线程就多了,系统开销就大了。为了解决这个问题,操作系统提供了 IO 多路复用机制。其核心思想是:用一个线程来处理多个 socket。
操作系统给程序提供的这套机制,提供了一套 API,内部的功能都是操作系统内核实现的。Linux 上提供的 IO 多路复用,主要是三套 API:select、poll 以及 epoll(于 2006 年左右引入,运行效率最高的机制)。C++ 可以直接使用 Linux 原生的 epoll API,而 Java 可以使用 NIO(标准库提供的一组类,底层就是封装了 epoll)。
为了生动理解这种机制的优越性,我们可以用晚上买饭来打个比方。我想吃蛋炒饭,媳妇想吃肉夹馍,小孩想吃饺子,我们有以下三种方案:
-
我自己去(串行执行,效率最低)------类似传统阻塞 I/O 模型 :
先去买蛋炒饭,等蛋炒饭做好后,再去买肉夹馍,再去买饺子,全部完成后结束。整个过程一次只能处理一个任务,后面的事情必须等待前面的事情完成,效率最低。
-
我不停询问三个老板(select/poll,多路复用但需要轮询)------类似 select 和 poll 模型 :
我一个人同时负责买三份饭:先去蛋炒饭店、肉夹馍店、饺子店登记,然后不断回来询问:"蛋炒饭好了吗?肉夹馍好了吗?饺子好了吗?"如果有 1000 家饭店,就需要不断检查 1000 家。
select和poll的工作方式类似,都是由应用程序主动遍历所有连接,询问哪些事件已经就绪,因此连接数量越多,轮询成本越高。 -
我一人使用 epoll(事件通知机制,效率最高)------类似 epoll 模型 :
我先告诉三个老板:"蛋炒饭、肉夹馍、饺子,哪个做好了直接喊我。"然后我可以去处理其他事情,不需要不断询问。当某份饭做好时,对应老板主动通知我 (epoll 事件通知机制),我只处理已经完成的任务。因此一个线程就可以同时管理大量任务,避免无意义的轮询,非常适合高并发服务器场景。
能高效完成这三件事的前提是,这三件事的交互都不频繁,大部分时间都在等待。如果这三件事都是交互特别频繁的,还是老老实实多搞几个线程靠谱,一个线程就容易忙不过来。这就好比你在打游戏,女朋友的电话来了,如果你还在用单线程处理,必然会手忙脚乱。
第三章:Redis 字符串类型深度解析与核心命令实战
在 Redis 的丰富数据结构中,字符串(String)是最基础、最常用,也是最不可或缺的一环。无论是缓存简单的配置信息、存储 JSON 序列化后的对象,还是实现高并发的计数器、分布式锁,字符串类型都是首选。
3.1 字符串类型概述与底层设计
Redis 的字符串不仅是简单的文本,它的设计哲学直接影响着 Redis 的性能表现。
3.1.1 二进制安全与数据存储
Redis 的所有键都是字符串,而值(Value)的类型则存在差异 。Redis 中的字符串是 二进制安全(Binary Safe)的,这意味着它直接按照二进制数据的方式存储,不会做任何编码转换。存入的是什么,取出来的就是什么。这种特性使得字符串不仅能存储普通的文本、整数、JSON、XML,还能直接存储二进制数据(如图片、视频、音频等)。
但需要注意的是,由于 Redis 是单线程模型,且期望所有操作都能保持极高速度,因此字符串类型限制其最大值为 512MB。对于体积庞大的视频等资源,通常不建议直接塞入 Redis。
3.1.2 单线程模型与危险指令
Redis 处理命令时是单线程顺序执行的,这意味着 所有到达服务端的命令都会排队执行 ,从而天然避免了多线程环境下的锁竞争问题。但在学习过程中,有一个极其危险的命令需要提前知晓:FLUSHALL 。它可以清空 Redis 上所有的数据(类似于关系型数据库的 DROP DATABASE)。在生产环境中,绝对不能轻易执行此命令。
3.2 键值基础操作:SET 与 GET
3.2.1 SET 命令及其扩展选项
SET 命令用于将 string 类型的 value 设置到 key 中。如果 key 之前存在,则覆盖原有的值(无论原来的数据类型是什么),并且之前关于此 key 的 TTL(生存时间)也会全部失效。
语法格式:
redis
SET key value [EX seconds|PX milliseconds] [NX|XX]注:语法中的 [] 代表可选项,| 代表"或者"的意思,多个选项可以同时存在。
时间复杂度: O(1)
支持版本: 1.0.0 之后
选项详解:
- EX seconds :使用
秒作为单位设置 key 的过期时间。SET name Tom EX 60 - PX milliseconds :使用
毫秒作为单位设置 key 的过期时间。SET name Tom PX 60000 - NX :只在 key 不存在时才进行设置(Not eXists)。如果 key 已存在,设置不执行,返回
(nil)。 - XX :只在 key 存在时才进行设置。如果 key 不存在,设置不执行,返回
(nil)。
返回值:
- 设置成功返回
OK。 - 指定了 NX 或 XX 但条件不满足时,返回
(nil)。
示例演示:
redis
redis> SET mykey "Hello"
OK
redis> GET mykey
"Hello"
redis> SET mykey "World" NX
(nil)
redis> DEL mykey
(integer) 1
redis> SET mykey "World" XX
(nil)
redis> SET mykey "World" NX
OK
redis> SET mykey "Will expire in 10s" EX 10
OK
redis> GET mykey # 10秒之后
(nil)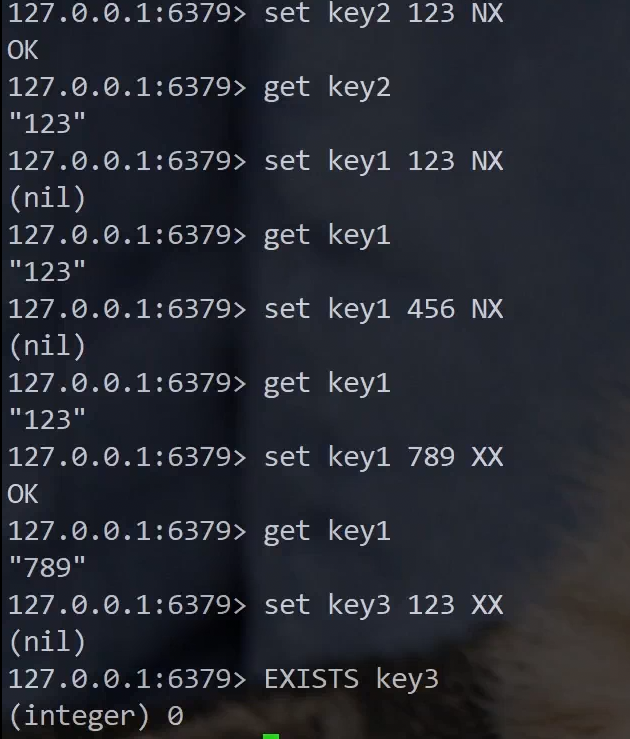
扩展说明 :
SET命令从 Redis 2.6.12 版本开始获得了EX、PX、NX、XX等选项,这些选项在功能上完全覆盖了SETNX、SETEX、PSETEX三个独立命令的语义。正是这种功能上的完全重叠,促使 Redis 官方在文档中明确指出这些独立命令"被视为已废弃(deprecated)",并建议在新代码中使用带选项的 SET 命令替代。
三个独立命令与 SET 选项之间存在一一对应的等效关系:
| 独立命令 | 等效的 SET 写法 |
|---|---|
SETNX key value |
SET key value NX |
SETEX key seconds value |
SET key value EX seconds |
PSETEX key milliseconds value |
SET key value PX milliseconds |
3.2.2 GET 命令与类型安全
GET 命令用于获取 key 对应的 value。如果 key 不存在,返回 nil。如果 value 的数据类型不是 string,会直接报错。
语法格式:
redis
GET key时间复杂度:O(1)
返回值: key 对应的 value,或者 nil(当 key 不存在时)。
示例演示:
redis
redis> GET nonexisting
(nil)
redis> SET mykey "Hello"
"OK"
redis> GET mykey
"Hello"
redis> DEL mykey
(integer) 1
redis> HSET mykey name Bob  # 设置一个 Hash 类型的值
(integer) 1
redis> GET mykey
(error) WRONGTYPE Operation against a key holding the wrong kind of value
3.3 批量操作与网络优化:MSET 与 MGET
3.3.1 批量读写命令详解
为了减少网络往返时间(RTT),Redis 提供了批量操作命令。
- MSET :一次性设置多个 key 的值。语法:
MSET key value [key value ...]。时间复杂度 O(N)(N 是 key 数量) 。永远返回OK。 - MGET :一次性获取多个 key 的值。语法:
MGET key [key ...]。时间复杂度 O(N) 。如果对应的 key 不存在或者数据类型不是 string,返回nil。返回值是对应 value 的列表。
示例演示:
redis
redis> MSET key1 "Hello" key2 "World"
"OK"
redis> MGET key1 key2 nonexisting
1) "Hello"
2) "World"
3) (nil)
3.3.2 性能对比:多次单条命令与单次批量命令
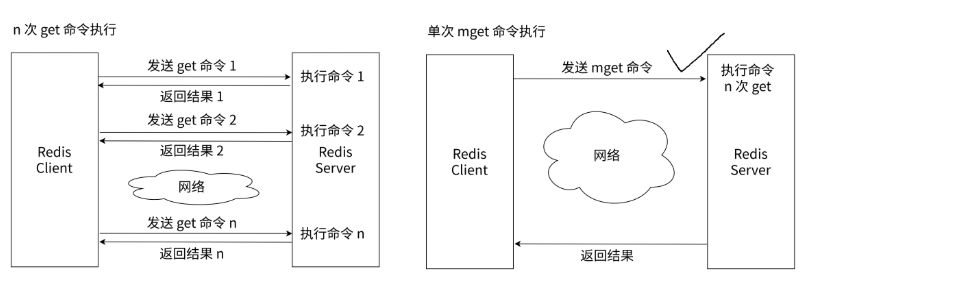
使用 mget / mset 由于可以有效减少网络时间,所以性能相较更高。假设网络耗时 1 毫秒,命令执行时间耗时 0.1 毫秒:
- 1000 次 get 操作:1000 x 1 + 1000 x 0.1 = 1100 毫秒
- 1 次 mget 操作(1000 个键):1 x 1 + 1000 x 0.1 = 101 毫秒
重要警告 :虽然批量操作能提高业务处理效率,但每次批量操作所发送的键的数量也不是无节制的。如果一次发送 10w 个键,极有可能造成单一命令执行时间过长,从而导致 Redis 阻塞(由于单线程模型,后续所有命令都会排队等待) 。因此,O(N) 这里的 N 并不是整个 Redis 服务器中所有 key 的数量,而仅仅是当前命令中给出的 key 的数量。
3.4 数值计数与原子操作:INCR 家族
3.4.1 INCR 与 DECR:加减一操作
- INCR :
将 key 对应的 string 表示的数字加一。如果 key 不存在,则视为 key 对应的 value 是 0。如果 key 对应的 string 不是一个整型或者范围超过了 64 位有符号整型(C++ 中的long long),则报错。 - DECR :
将 key 对应的 string 表示的数字减一。如果 key 不存在,则视为 0。其余规则同上。
语法与返回值:
redis
INCR key
DECR key
时间复杂度:O(1) 。返回值是 integer 类型的加/减完后的数值。
INCRBY 和 DECRBY 的参数都接受正数和负数,因为它们本质上都是 64 位有符号整数运算。
示例演示:
redis
redis> EXISTS mykey
(integer) 0
redis> INCR mykey
(integer) 1
redis> SET mykey "10"
"OK"
redis> INCR mykey
(integer) 11
redis> SET mykey "234293482390480948029348230948"
"OK"
redis> INCR mykey
(error) value is not an integer or out of range
redis> SET mykey 'not a number'
"OK"
redis> INCR mykey
(error) value is not an integer or out of range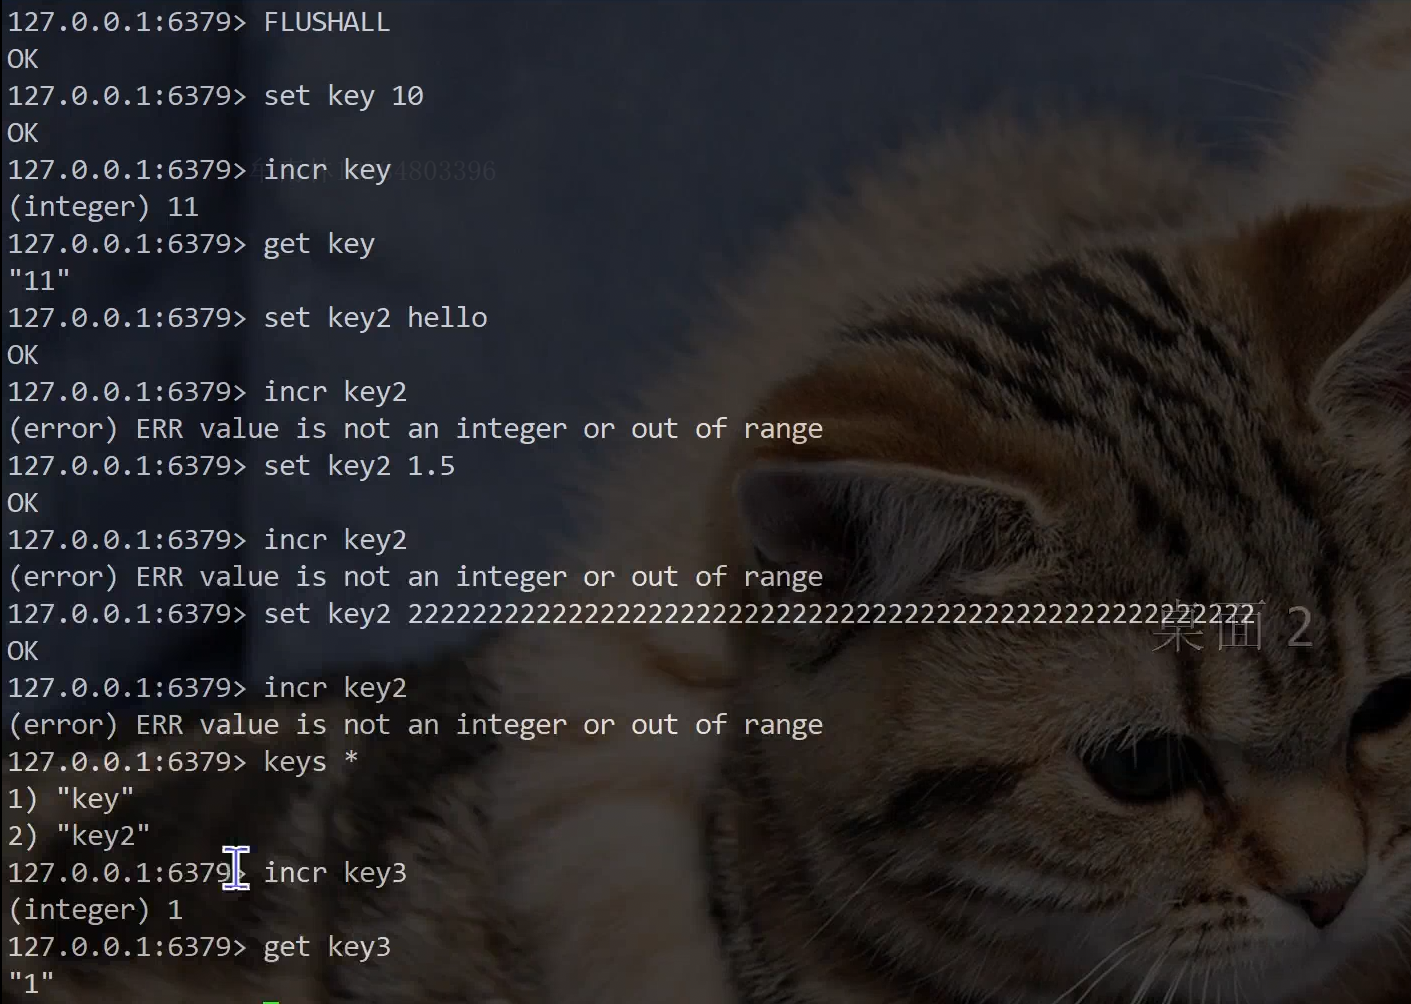
3.4.2 INCRBY 与 DECRBY:指定步长操作
- INCRBY:将 key 对应的 string 表示的数字加上指定的值(decrement)。如果 key 不存在,视为 0。
- DECRBY:将 key 对应的 string 表示的数字减去指定的值。如果 key 不存在,视为 0。
语法与返回值:
redis
INCRBY key decrement
DECRBY key decrement时间复杂度:O(1)。返回值是 integer 类型的加/减完后的数值。同样要求 64 位有符号整型,否则报错。
示例演示:
redis
redis> INCRBY mykey 3
(integer) 3
redis> SET mykey "10"
"OK"
redis> INCRBY mykey 3
(integer) 13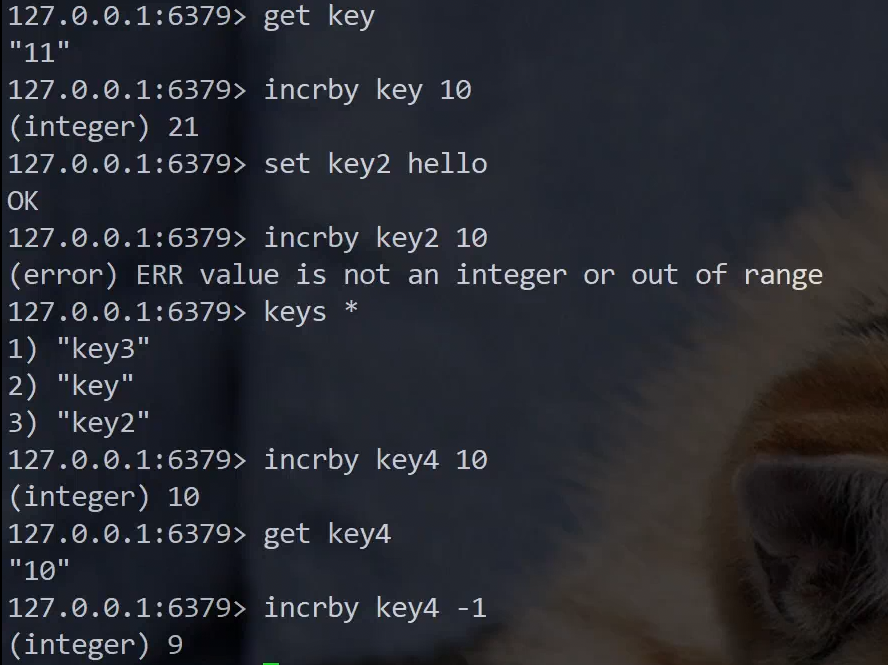
3.4.3 INCRBYFLOAT:浮点数运算
将 key 对应的 string 表示的浮点数加上对应的值。如果对应的值是负数,则视为减去对应的值。如果 key 不存在,则视为 0。允许采用科学计数法表示浮点数(如 5.0e3)。
incrbyfloat实际是按double存取计算的
语法与返回值:
redis
INCRBYFLOAT key increment时间复杂度:O(1)。返回值是加/减完后的数值(字符串格式)。
注意:虽然该命令支持浮点数,但在实际的 Redis 计数操作中,一般还是针对整数来进行的。
示例演示:
redis
redis> SET mykey 10.50
"OK"
redis> INCRBYFLOAT mykey 0.1
"10.6"
redis> INCRBYFLOAT mykey -5
"5.6"
redis> SET mykey 5.0e3
"OK"
redis> INCRBYFLOAT mykey 2.0e2
"5200"
3.4.4 单线程架构下的原子性保证
很多存储系统和编程语言内部使用 CAS(Compare And Swap)机制实现计数功能,会有一定的 CPU 开销。但在 Redis 中完全不存在这个问题,因为 Redis 是单线程架构,任何命令到了 Redis 服务端都要顺序执行。因此,多个客户端同时针对同一个 key 进行 incr 操作,不会引起"线程安全"问题。
3.5 字符串内容处理:APPEND、GETRANGE、SETRANGE 与 STRLEN
3.5.1 APPEND:追加内容
功能说明:
如果 key 已经存在并且是一个 string,命令会将 value 追加到原有 string 的后边。如果 key 不存在,则效果等同于 SET 命令。
由于 Redis 的字符串不会对字符做特殊处理(二进制安全),因此在拼接中文字符时,也是按照 UTF-8 编码的字节进行拼接。
语法格式:
redis
APPEND KEY VALUE时间复杂度与返回值:
- 时间复杂度:O(1)(追加的字符串一般长度较短,可以视为 O(1))。
- 返回值 :追加完成之后 string 的长度(integer)。
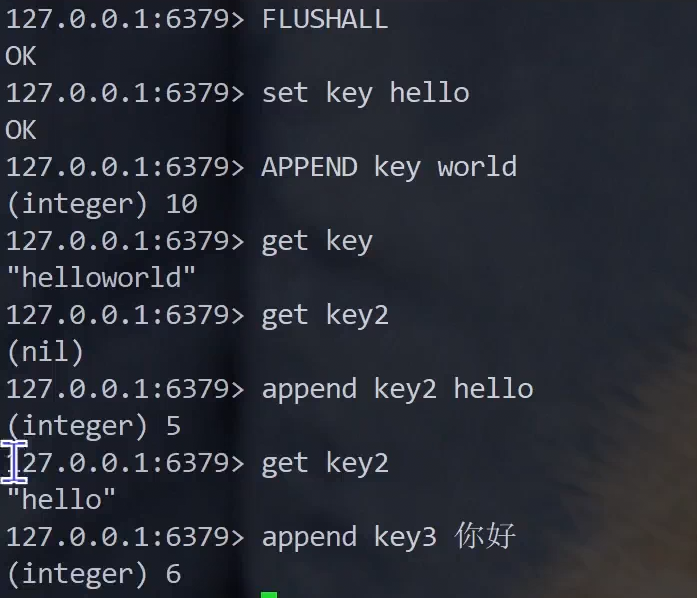
示例演示:
结合命令行截图,我们可以清晰地看到 APPEND 命令在不同场景下的表现:
1. 基础追加与键不存在的情况
redis
127.0.0.1:6379> FLUSHALL
OK
127.0.0.1:6379> set key hello
OK
127.0.0.1:6379> APPEND key world
(integer) 10       # "hello" + "world" = "helloworld",长度为10
127.0.0.1:6379> get key
"helloworld"

127.0.0.1:6379> get key2
(nil)              # key2 不存在
127.0.0.1:6379> append key2 hello
(integer) 5        # 等同于 SET key2 hello,返回长度5
127.0.0.1:6379> get key2
"hello"
2. 二进制安全与中文字符拼接
正如前面提到的"二进制安全"特性,当使用
APPEND拼接中文字符时,Redis 会按照 UTF-8 编码的字节进行拼接,返回值是字节数(而非字符数)。APPEND 返回的是 Redis 当前存储字符串的字节长度,而这个字节长度取决于客户端发送数据时采用的编码方式,并不是 Redis 根据客户端显示结果重新计算的。对于常见的 redis-cli 环境,默认通常使用 UTF-8,所以中文一个字符通常占 3 个字节。
redis
127.0.0.1:6379> append key3 你好
(integer) 6        # "你好" 在 UTF-8 编码下占 6 个字节(每个汉字3字节)
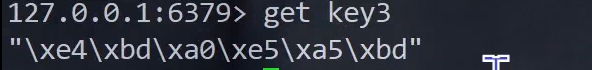
此时如果我们去获取 key3 的值,由于 Redis 是二进制安全的,它可能会直接输出转义后的十六进制字节(取决于客户端环境)
redis
127.0.0.1:6379> get key3
"\xe4\xbd\xa0\xe5\xa5\xbd"   # 这正是 "你好" 的 UTF-8 编码的十六进制表示
补充: Redis 中的 Unicode 编码问题
其实核心在于一句话:Redis 本身根本不认识 Unicode,它只认字节(Byte),因为它是"二进制安全(Binary Safe)"的。
Redis 在处理字符串时,底层完全将其视为一个纯粹的字节数组 。无论是 UTF-8、GBK 还是 ASCII,客户端(如 Java、Python、redis-cli)在发送前会把字符 编码(Encode) 成字节序列,Redis 原样存储这些字节;客户端读取时再把字节 解码(Decode) 回字符。正因为 Redis 不关心字符集,它对所有编码一视同仁,这也是为什么它能存图片、视频等二进制数据。
但这恰恰引发了上述文本中提到的各种"编码陷阱":
- 长度计算 :
STRLEN和APPEND返回的都是字节数 。在 UTF-8 下,一个英文字母占 1 字节,一个中文字符通常占 3 字节,所以APPEND key3 你好返回 6 而不是 2。 - 截取与覆盖 :
GETRANGE和SETRANGE也是严格按字节偏移量 操作的。如果你用GETRANGE key 0 1去截取"你好",你只会得到"你"的前两个字节,这半个汉字在终端解码时必然产生乱码(比如上面的\xe4\xbd\xa0就是 UTF-8 编码的十六进制表示,由于 CLI 无法显示完整字符,所以直接输出了转义字节)。 - 自动填充 :
SETRANGE扩容时填充的\x00,也是字节层面的空字节(Zero Byte),而不是 Unicode 字符\u0000。
因此,在实际开发中,Redis 本身没有字符编码的概念,所有的 Unicode 编码、解码以及"按字符截取"的逻辑,都必须由应用层(客户端代码)自己负责 。如果要计算中文字符数,不能在 Redis 用 STRLEN,必须在取出完整字节后,在 Java/C++/Python 里用相应语言的字符集 API 去计算,以免产生截断乱码。
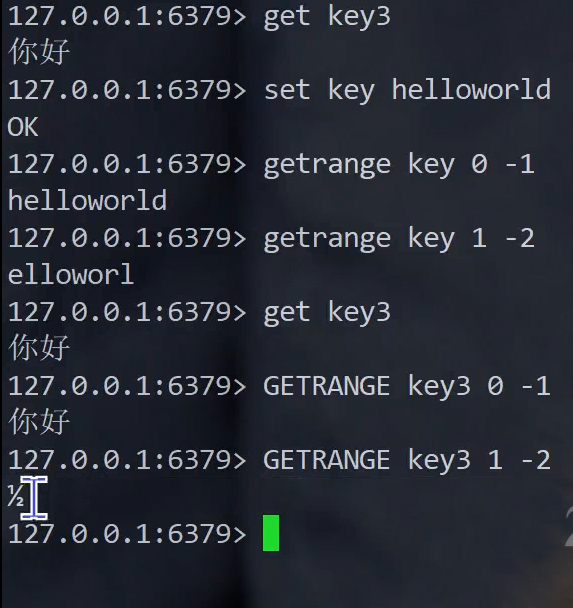
3.5.2 GETRANGE:获取子串与字符编码陷阱
返回 key 对应的 string 的子串,由 start 和 end 确定 (左闭右闭 )。可以使用负数表示倒数。-1 代表倒数第一个字符,-2 代表倒数第二个,超过范围的偏移量会根据 string 的长度调整成正确的值。
语法格式:
redis
getrange key start end时间复杂度:O(N)(N 为 start, end 区间的长度,由于 string 通常比较短,可以视为 O(1))。
示例演示:
redis
redis> SET mykey "This is a string"
"OK"
redis> GETRANGE mykey 0 3
"This"
redis> GETRANGE mykey -3 -1
"ing"
redis> GETRANGE mykey 0 -1
"This is a string"
redis> GETRANGE mykey 10 100
"string"
重要陷阱:UTF-8 编码与字节截断
Redis 的
GETRANGE是按照字节 (Byte)进行偏移的,而不是按照字符 (Character)。如果字符串中包含中文,直接按字节截取可能会截出"半个"汉字,导致乱码。例如,张三的 UTF-8 编码占 6 个字节,如果执行GETRANGE key 0 1,只会返回张三的第一个字节,在终端显示时就会出现乱码。在实际开发中,若需处理多字节字符,应谨慎使用GETRANGE。
3.5.3 SETRANGE:覆盖与自动填充
覆盖字符串的一部分,从指定的偏移开始。返回值是替换后的 string 的长度。如果键不存在(等同于空字符串),或者 offset 超出了原有字符串的长度,Redis 都会用 \x00(空字节)将中间的空隙部分填充,然后再追加 value。
语法格式:
redis
setrange key offset value时间复杂度:O(N)(N 为 value 的长度,通常视为 O(1))。
示例演示:
redis
redis> SET key1 "Hello World"
"OK"
redis> SETRANGE key1 6 "Redis"
(integer) 11
redis> GET key1
"Hello Redis"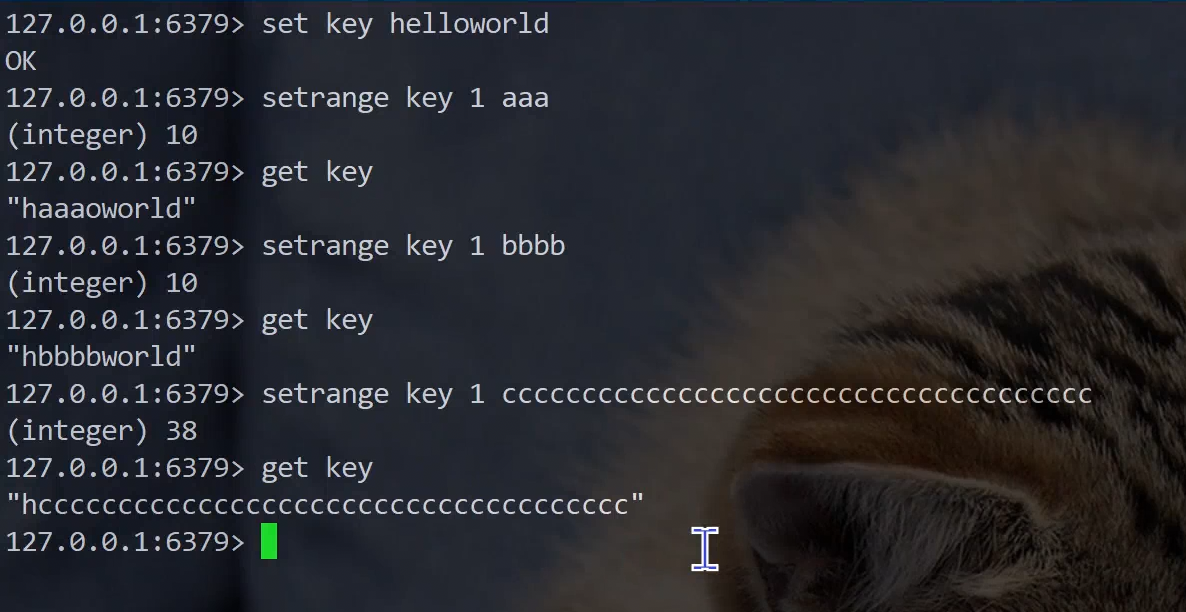
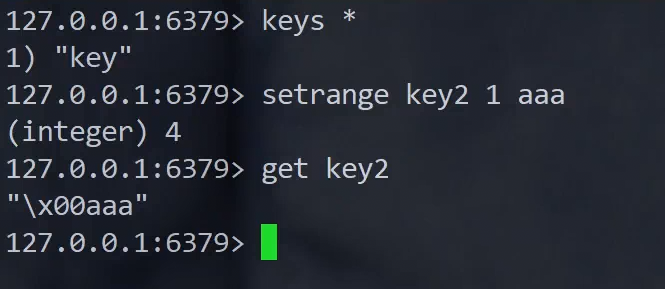
如果执行 SETRANGE key1 10 "Redis",原来的 "Hello World" 只有 11 个字符,offset 10 覆盖最后的 "d",新字符串长度变为 15。如果执行 SETRANGE key1 15 "Redis",则在 11 到 15 之间的位置填充 \x00,然后追加 "Redis",最终长度变为 20。
3.5.4 STRLEN:获取长度
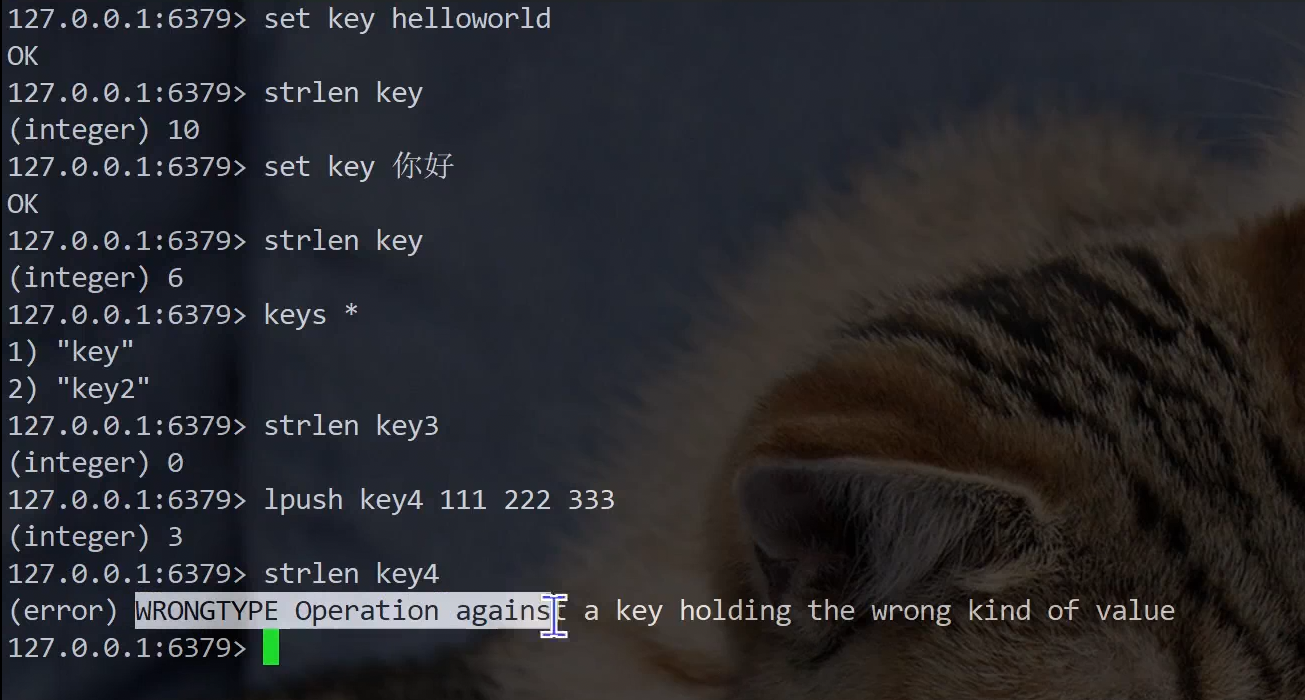
获取 key 对应的 string 的长度。当 key 存放的不是 string 时,报错。
语法格式:
redis
strlen key时间复杂度:O(1)。返回值:string 的长度(字节数),或者当 key 不存在时,返回 0。
示例演示:
redis
redis> SET mykey "Hello world"
"OK"
redis> STRLEN mykey
(integer) 11
redis> STRLEN nonexisting
(integer) 0
注意 :与
GETRANGE类似,STRLEN返回的也是字节长度。在 UTF-8 编码中,一个英文字符占 1 个字节,一个中文字符通常占 3 个字节。如果业务对字符数有严格要求,需要自行在应用层处理编码转换。
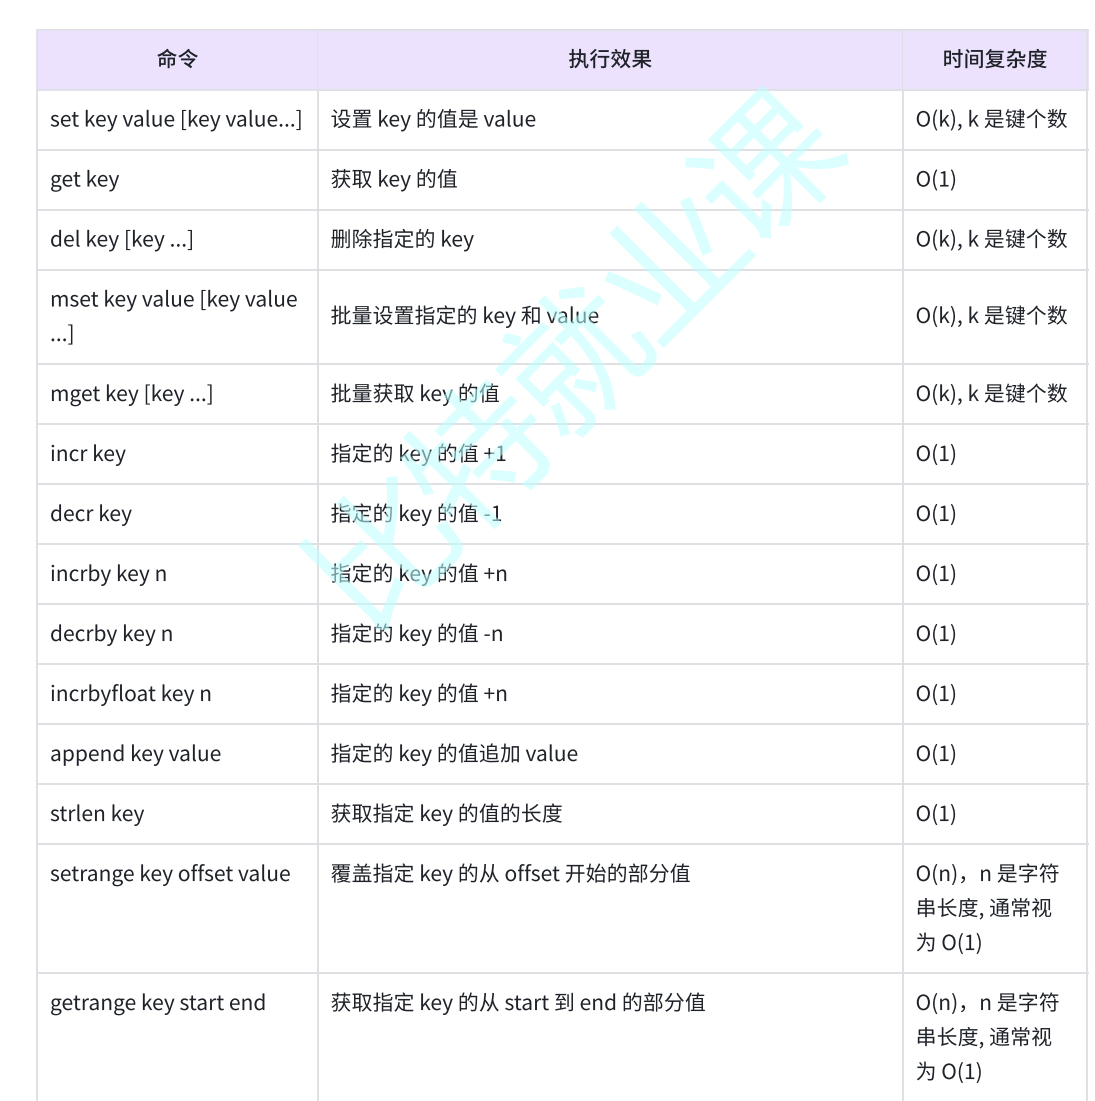
3.6 综合命令对照表
第四章:String 内部编码与典型应用场景深度解析
在第三章中,我们已经系统学习了 Redis String 类型的基础命令、批量操作、原子计数、字符串内容处理等核心用法。本章将进一步深入两个关键问题:
- String 在 Redis 内部到底有哪几种编码方式?
- String 在实际业务中到底能做什么?
4.1 String 的三种内部编码
String 类型虽然对外表现一致,但在 Redis 内部并不是只有一种存储方式。根据当前值的数据类型和长度,Redis 会动态选择不同的内部编码实现。
资料中明确指出,字符串类型的内部编码有 3 种:
| 编码名称 | 含义 | 典型条件 | 特点 |
|---|---|---|---|
| int | 8 个字节的长整型 | 值本身是整数 | 占用空间小,计算快 |
| embstr | 嵌入式字符串 | 小于等于 39 字节的字符串 | 对象和字符串内容一起分配,减少内存申请 |
| raw | 原始字符串 | 大于 39 字节的字符串 | 真正用来存储较长字符串,只适合简单字符数组 |
4.1.1 int 编码
如果设置的值本身是一个整数,Redis 会优先使用 int 编码。
示例:
bash
127.0.0.1:6379> set key 6379
OK
127.0.0.1:6379> object encoding key
"int"
int 编码的本质是:直接保存整数,而不是保存 "6379" 这几个字符。
因此它比保存字符串形式更节省空间,也更适合做计数器,例如:
redis
INCR views
INCR video:5253
4.1.2 embstr 编码
当字符串长度小于等于 39 字节时,Redis 通常会使用 embstr 编码。
示例:
bash
# 小于等于 39 字节的字符串
127.0.0.1:6379> set key "hello"
OK
127.0.0.1:6379> object encoding key
"embstr"
embstr 的特点是:Redis 对象和字符串内容放在一起分配。
这样做的好处是减少一次内存申请,降低内存碎片,因此非常适合短字符串。
可以这样理解:Redis 中每个 String 值本质上是一个
redisObject结构,raw编码会先分配一个redisObject,再单独分配一块 SDS 来存字符串内容,两者内存地址不连续,需要两次分配;而embstr编码则是一次性分配一块连续内存,前面放redisObject,后面紧跟着 SDS 头和实际字符数据,相当于把"对象头"和"字符串内容"打包在同一个内存块里。这样做的好处是减少一次内存申请/释放、降低内存碎片、提升 CPU 缓存局部性,所以短字符串优先用embstr;但它通常是只读的,一旦修改或长度超过阈值,就会转成raw。
例如:
redis
SET name Tom
SET user:1:name "Alice"
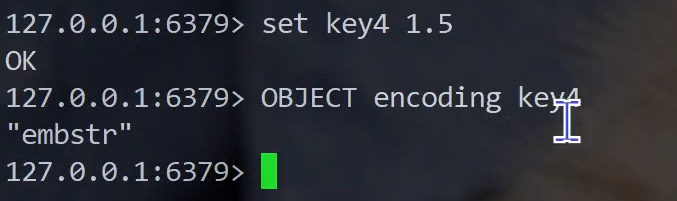
Redis String 类型中的小数本质仍然是字符串,不存在 float 编码。Redis 会根据字符串内容选择底层编码:整数形式可能使用 int,小数无法使用 int,短小数通常使用 embstr,过长则使用 raw。INCRBYFLOAT 只是执行计算时临时转换为浮点数,保存时仍然是 String。
4.1.3 raw 编码
当字符串长度大于 39 字节时,Redis 通常会使用 raw 编码。
示例:
bash
# 大于 39 字节的字符串
127.0.0.1:6379> set key "one string greater than 39 bytes ........"
OK
127.0.0.1:6379> object encoding key
"raw"
raw 编码用来存储较长的字符串,适合简单字符数组。常见场景包括:
- 较长的 JSON 字符串;
- XML 内容;
- 文件内容片段;
- 较长的配置信息。
4.1.4 object encoding 实战
我们可以通过 OBJECT ENCODING 命令查看某个 key 对应的 value 实际使用的编码方式。
bash
127.0.0.1:6379> set key 6379
OK
127.0.0.1:6379> object encoding key
"int"

127.0.0.1:6379> set key "hello"
OK
127.0.0.1:6379> object encoding key
"embstr"

127.0.0.1:6379> set key "one string greater than 39 bytes ........"
OK
127.0.0.1:6379> object encoding key
"raw"这说明:同一个 String 类型,背后可能对应不同的底层编码。 Redis 会根据当前值的类型和长度动态决定使用哪种内部编码实现。
4.1.5 不要死记"39 字节"这个数字
很多初学者一看到 embstr 和 raw,第一反应就是背下"39 字节"这个阈值。
但资料中明确提醒:不建议大家去记长度大于 39 这样的数字。
原因在于:
- 数字是可以配置的,也可能随版本变化。
- 很多数字在源码中是"拍脑袋"来的,或者基于特定版本的测试基准。
- 真正重要的是理解它为什么这样设计,以及如何根据业务场景重新测试和选择。
4.1.6 如果确实想改阈值,应该怎么做?
资料中提出了一个很现实的问题:上述效果具体怎么实现?
思路通常有两种:
- 先看 Redis 是否提供了对应配置,可以修改 39 这个数字。
- 如果没有配置项,就需要针对 Redis 源码进行修改。
但为什么不建议直接修改?
因为开源组件往往考虑的是通用性。 它要服务于大量不同场景、不同业务、不同硬件环境。默认阈值是综合权衡的结果,不一定适合所有业务。
4.2 String 的典型应用场景
String 是 Redis 中最基础、最常用的数据类型。它的应用场景远不止简单的 SET 和 GET。资料中重点介绍了四类典型场景:
- 缓存;
- 计数;
- 共享 Session;
- 手机验证码。
下面逐一展开。
4.2.1 缓存(Cache)功能
Redis 作为缓存层,MySQL 作为存储层。
整体架构如下:
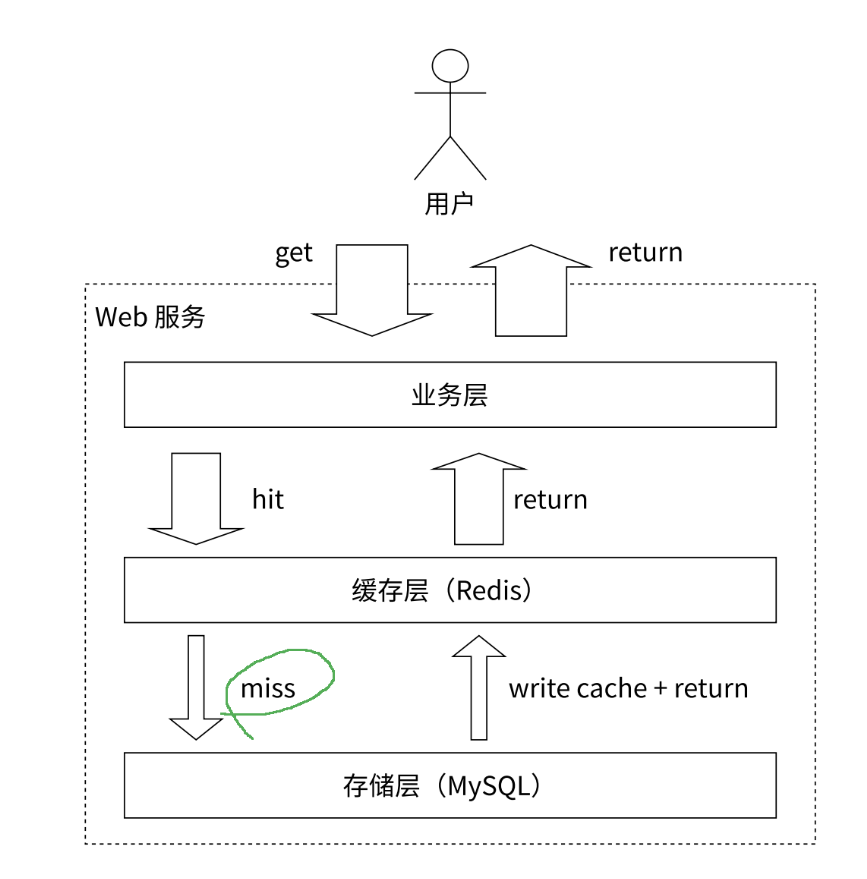
访问流程可以概括为:
- 应用服务器获取数据时,先查询 Redis。
- 如果 Redis 中存在数据,即缓存命中(hit),直接返回。
- 如果 Redis 中不存在数据,即缓存未命中(miss),再查询 MySQL。
- 从 MySQL 读到结果后,返回给应用服务器,同时把数据写入 Redis。
- 写入 Redis 时,通常要设置过期时间,防止数据腐烂。
以下伪代码模拟了这一过程:
java
// 假设业务是根据用户 uid 获取用户信息
UserInfo getUserInfo(long uid) {
    // 根据 uid 得到 Redis 的键
    String key = "user:info:" + uid;

    // 尝试从 Redis 中获取对应的值
    String value = Redis 执行命令:get key;

    // 如果缓存命中(hit)
    if (value != null) {
        // 假设我们的用户信息按照 JSON 格式存储
        UserInfo userInfo = JSON 反序列化(value);
        return userInfo;
    }

    // 如果缓存未命中(miss)
    if (value == null) {
        // 从数据库中,根据 uid 获取用户信息
        UserInfo userInfo = MySQL 执行 SQL:
            select * from user_info where uid = <uid>;

        // 如果表中没有 uid 对应的用户信息
        if (userInfo == null) {
            响应 404;
            return null;
        }

        // 将用户信息序列化成 JSON 格式
        String value = JSON 序列化(userInfo);

        // 写入缓存,为了防止数据腐烂(rot),设置过期时间为 1 小时(3600 秒)
        Redis 执行命令:set key value ex 3600;

        // 返回用户信息
        return userInfo;
    }
}
通过增加缓存功能,在理想情况下,每个用户信息在一个小时期间只会有一次 MySQL 查询,极大地提升了查询效率,也降低了 MySQL 的访问数。
1.键名设计建议
Redis 没有 MySQL 那样的表、字段命名空间,也没有对键名有强制要求。 但设计合理的键名,有利于防止键冲突和项目的可维护性。
推荐格式: 业务名:对象名:唯一标识:属性
例如:
text
vs:user_info:6379
vs:user_info:6379:name
如果当前 Redis 只会被一个业务使用,可以省略业务名:
text
user_info:6379如果键名过长,会导致 Redis 性能明显下降,可以使用团队内部都认同的缩写替代:
text
user:6379:friends:messages:5217
可缩写为:
u:6379:fr:m:5217
2.关于过期时间与淘汰策略
如果数据一直存储,Redis 中的 key 会越来越多,内存压力也会越来越大。
因此:
- 写入 Redis 时,给每个 key 设置过期时间。
- Redis 在内存不够时,还有淘汰策略。
后面会再细说淘汰策略。这里先记住:缓存数据不是越多越好,而是要有生命周期管理。
4.2.2 计数(Counter)功能
许多应用都会使用 Redis 作为计数的基础工具。它可以实现快速计数、查询缓存,同时数据可以异步处理或者落地到其他数据源。
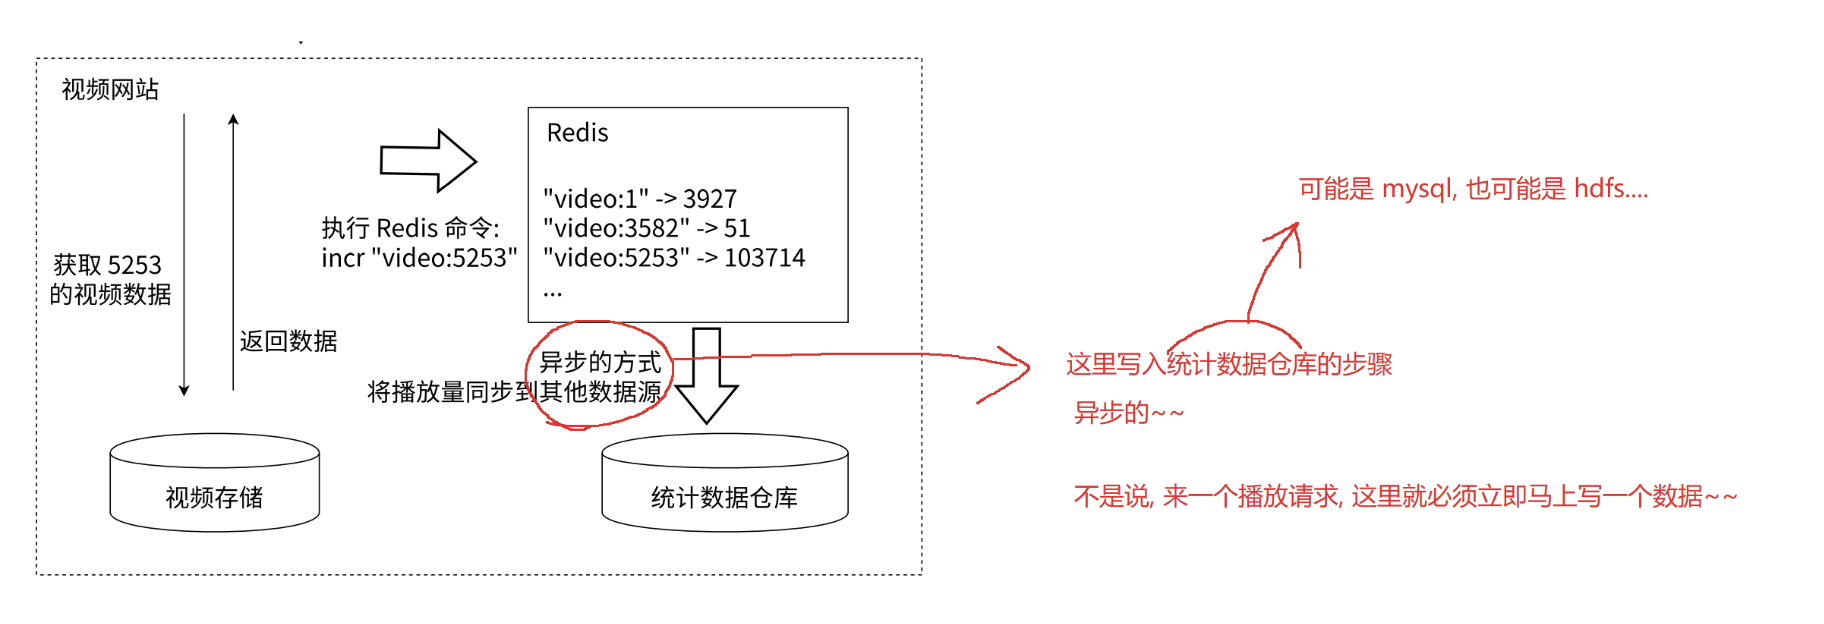
上图 展示了视频网站记录视频播放次数的场景:
text
用户播放视频 5253
  ↓
视频网站
  ↓
执行 Redis 命令:incr "video:5253"
  ↓
获取 5253 的视频数据
  ↓
返回数据
Redis 中可能存储这样的数据:
text
"video:1"    -> 3927
"video:3582" -> 51
"video:5253" -> 103714
...同时,播放量可以通过异步方式同步到其他数据源,例如统计数据仓库、MySQL,甚至 HDFS。
伪代码大致如下:
java
// 在 Redis 中统计某视频的播放次数
long incrVideoCounter(long vid) {
    key = "video:" + vid;
    long count = Redis 执行命令:incr key;
    return count;
}这里有一个关键点:写 Redis 和写其他数据源是分离的,是异步的。 不是说一个请求来了,这里就必须立即写上另一个数据。
Redis 并不擅长做统计
企业为老唱片收集用户数据时,会先统计,再进一步明确用户需求,然后根据需求改进和迭代产品。
但要注意:Redis 并不擅长做统计。
例如:
- 视频播放量 100 这种简单计数,Redis 完全没问题;
- 但如果要做复杂统计、多维度聚合、报表分析,Redis 就不适合了;
- 相比之下,如果用 MySQL 来存这些数据,一条条统计就会很慢。
因此,实际中要开发一个成熟、稳定的真实计数系统,要面临的挑战远不止如此简单。所以,Redis 适合做快速计数和热点计数,复杂统计还是要交给专门的统计系统或数据仓库。
4.2.3 共享会话(Session)
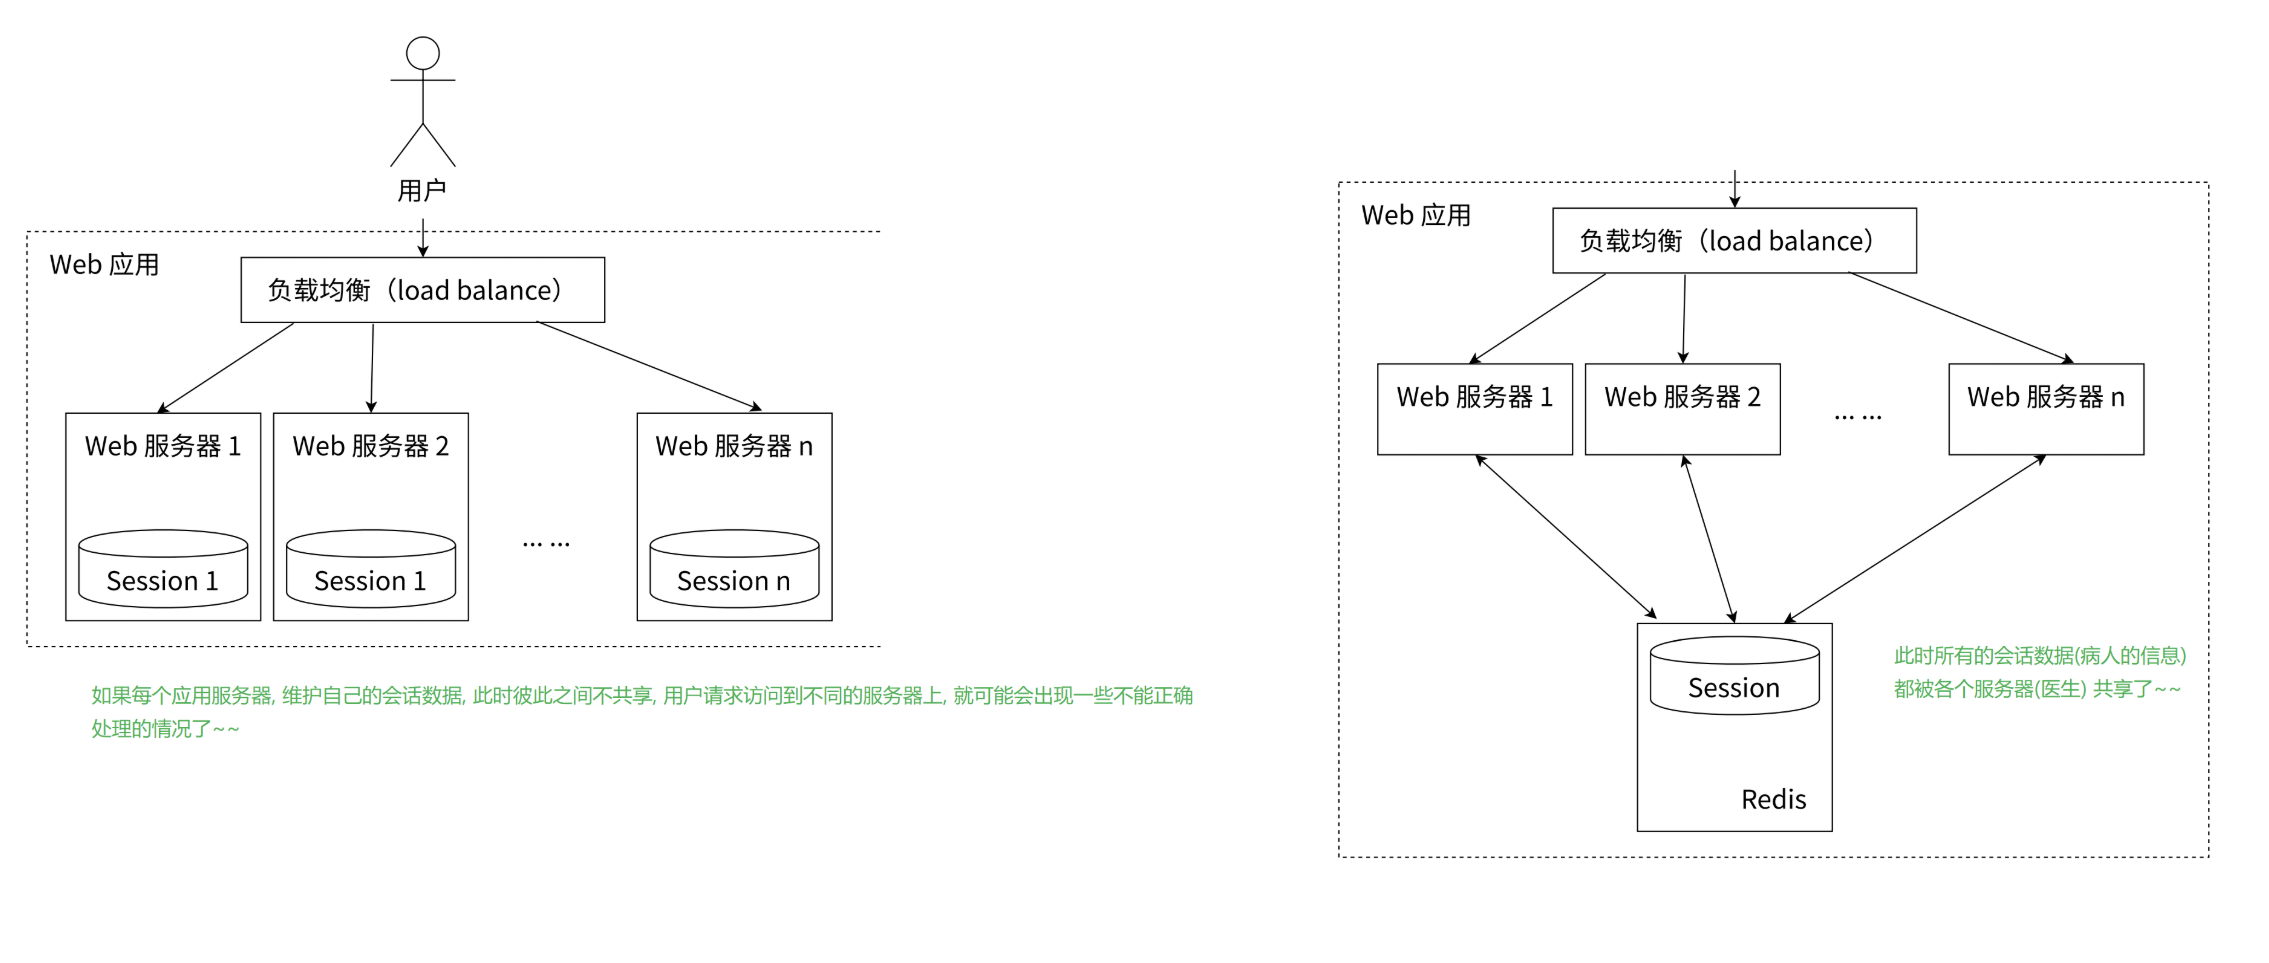
上图展示了分布式 Web 服务中 Session 管理的问题与解决方案。
先区分两个概念:
- Cookie:浏览器存储数据的机制。
- Session:服务器这边存储数据的机制。
- 它们本质上都是键值对。
问题:Session 分散存储
一个分布式 Web 服务将用户的 Session 信息保存在各自的服务器中:
text
用户
  ↓
负载均衡(load balance)
  ↓
Web 服务器 1     Web 服务器 2     Web 服务器 n
Session 1        Session 1        Session n
  ↓                ↓                ↓
Web 应用
这样会造成一个问题: 出于负载均衡的考虑,分布式服务会将用户的访问请求均衡到不同的服务器上,并且通常无法保证用户每次请求都会被均衡到同一台服务器上。这样当用户刷新一次访问时,可能会发现需要重新登录。 这个问题是用户无法容忍的。
医院挂号的比喻
一个人,相当于一个客户端。 医生给病人诊断,相当于服务器。
由于病人多次向服务器发送请求,服务器这边就需要保存病人每次复诊时的状态。 这个就是所谓的"会话":客户端和服务器在交互过程中产生的一些属于该客户端的中间状态的数据。
医院有多个医生、多个服务。 这些服务器是以负载均衡的方式来提供服务的。
同一个人,两次来医院看病,遇到的医生可能是不同的。 此时,如果每个医生只是自己记忆来存储病人的情况,那么两次访问得到不同的医生,医生可能就不知道病人之前的情况了。
医院正确的做法,是使用一套系统,记录病人的病历、诊断结果、治疗方案,让多个医生共享。
解决方案:Redis 集中管理 Session
上图使用 Redis 将用户的 Session 信息进行集中管理:
在这种模式下,只要保证 Redis 是高可用和可扩展的,无论用户被均衡到哪台 Web 服务器上,都集中从 Redis 中查询、更新 Session 信息。
此时,所有的会话数据都能给各个服务器共享。 这样就解决了分布式环境下 Session 不一致的问题。
4.2.4 手机验证码
很多应用出于安全考虑,会在每次进行登录时,让用户输入手机号,并且配合给手机发送验证码,然后让用户再次输入收到的验证码并进行验证,从而确定是否是用户本人。
为了短信接口不会频繁访问,会限制用户每分钟获取验证码的频率。
例如:一分钟不能超过 5 次。
基本实现思路如下:
java
String 发送验证码(phoneNumber) {
    key = "shortMsg:limit:" + phoneNumber;

    // 设置过期时间为 1 分钟(60 秒)
    // 使用 NX,只在不存在 key 时才能设置成功
    bool r = Redis 执行命令:set key 1 ex 60 nx;

    if (r == false) {
        // 说明之前设置过该手机的验证码了
        long c = Redis 执行命令:incr key;

        if (c > 5) {
            // 说明超过了一分钟 5 次的限制了
            // 限制发送
            return null;
        }
    }

    // 说明要么之前没有设置过手机的验证码;要么次数没有超过 5 次
    String validationCode = 生成随机的 6 位数的验证码();

    validationKey = "validation:" + phoneNumber;

    // 验证码 5 分钟(300 秒)内有效
    Redis 执行命令:set validationKey validationCode ex 300;

    // 返回验证码,随后通过手机短信发送给用户
    return validationCode;
}

// 验证用户输入的验证码是否正确
bool 验证验证码(phoneNumber, validationCode) {
    validationKey = "validation:" + phoneNumber;

    String value = Redis 执行命令:get validationKey;

    if (value == null) {
        // 说明没有这个手机的验证码记录,验证失败
        return false;
    }

    if (value == validationCode) {
        return true;
    } else {
        return false;
    }
}
第五章:业务视角下的高并发优化------从技术实现走向问题解决
在前四章中,我们围绕 Redis 的数据类型、线程模型、String 编码和典型应用场景展开。但越往后越会发现:Redis 再快,也只是工具;真正决定系统形态的,往往是业务。
业务其实就是一个公司、一个产品,如何解决一系列问题的过程。 一个公司或产品要想生存,就得赚钱;要想赚钱,就得帮别人解决问题。而解决问题,就是业务。
5.1 业务才是技术的出发点和落脚点
以教育行业为例,一个公司的业务可能包括:
- 直播课程,这是主线任务;
- 录播课程,这是支线任务;
- 日常跟进、作业批改;
- 笔试强训;
- 项目实战;
- 模拟面试;
- 校招跟进;
- offer 筛选;
- 学长内推;
- 租房信息分享。
这些看起来分散,但本质上都是业务。它们共同解决一个问题:让学员就业更好。
不同的公司、不同的产品,有不同的业务。不同的业务,又需要不同的技术作为支撑。所以,业务是非常重要的。很多时候,优化技术解决不了的问题,可以通过优化业务来解决。实际开发过程中,也必须要结合真实业务场景,做一些技术上的调整。
我们在学习阶段能学到的,大多是技术,而且是通用技术。不同公司、不同产品,都会有不同业务。将来进入公司之后,真正需要重点学习的,往往就是所在团队的业务。
有些同学去实习时会困惑:我现在每天的工作就是 CRUD,就是"点点点",学不到东西,要不要离职?但如果问他:你实习负责的业务是什么?他却说不出来。这就本末倒置了。
CRUD 只是动作,业务才是目的。一个系统为什么需要这张表?这个字段代表什么业务含义?这个接口服务于哪个流程?这些问题如果说不清楚,那么即使写了很多代码,也很难真正成长。
5.2 12306 案例:业务优化如何化解超高并发
12306 卖火车票,是一个非常典型的超高并发场景。它背后的技术积累,可以说在全国乃至全世界都是独一档的。支撑的业务压力极其恐怖,尤其是在春运抢火车票的时候。
最初 12306 刚上线时,体验非常差。虽然当时引入了非常多技术,用来提高网站的访问速度和可用性,但在放票的时候,整体压力还是很大,还是很容易出问题。
例如,1 月 1 日可以买 2 月 1 日的票。假设我要买 2 月 1 日的票,就需要在 1 月 1 日一大早 8:00 准时登录 12306 尝试买票。在这个放票的一瞬间,因为抢的人太多,就会导致服务器压力一下被拉满。
通过一些常规技术手段,优化效果并不明显。这时候,有人提出一个方案:分时段放票。
比如:
- 8:00 放一批,几个车次;
- 10:00 再放一批;
- 12:00 再放一批;
- 14:00 再放一批;
- ......
这就是业务上的优化。
本来是一次放所有票,现在分 5 次,每次放五分之一。这样就相当于把瞬间的压力降低到原来的五分之一。全国那么多车次,分 100 次放票,也很容易做到。
这个案例说明:技术优化很重要,但业务优化有时能从根本上改变流量模型。技术解决不了的问题,业务可能一句话就化解了。
5.3 对 Redis 实践的启示
回到 Redis。
我们学习 String、Hash、List、Set、ZSet,学习 SET、GET、INCR、EXPIRE、OBJECT ENCODING,最终不是为了背命令,而是为了在业务中做取舍。
比如手机验证码场景:
- 限制用户一分钟不能超过 5 次;
- 使用
SET key 1 EX 60 NX; - 如果设置失败,再
INCR key; - 超过 5 次就限制发送。
这背后不是单纯的 Redis 命令,而是业务规则。
再比如视频播放计数:
- 执行
INCR video:5253; - 快速得到播放量;
- 再通过异步方式同步到其他数据源。
这也不是单纯的技术问题,而是业务对"快速计数"和"最终一致"的取舍。
缓存、Session、验证码、计数器,都是 Redis 的典型应用场景。但真正决定它们怎么用、用多久、要不要异步、要不要分片、要不要限流的,是业务。
所以,学习 Redis 不能只停留在"这个命令怎么用""那个阈值是多少"。更重要的是理解:当前业务到底在解决什么问题,瓶颈在哪里,哪些压力可以通过技术拆解,哪些压力可以通过业务规则重新设计。
业务是根,技术是叶。业务优化和技术优化结合起来,才能构建真正稳定、高效的系统。