本文解读的论文是 Mechanical compound fault diagnosis via suppressing intra-class dispersions: A deep progressive shrinkage perspective,发表在 Measurement 上。
一、复合故障为什么难诊断
机械设备的故障并不总是单独出现。所谓复合故障,指的是两种或两种以上的单一故障同时发生,例如轴承内圈、外圈与滚动体的损伤同时存在。这类故障在实际工况下相当常见,诊断起来却比单一故障困难得多。
困难首先来自故障特征本身。复合故障的特征天然包含了它所涉及的各单一故障的特征,因此复合故障的样本与相关的单故障样本在传统特征空间里会严重重叠,边界很难划清。雪上加霜的是,受到非平稳工况与振动信号自身复杂性的影响,同一类故障内部的样本分布也很分散,也就是类内离散较大,这让原本就模糊的重叠进一步加剧。
传统的深度学习方法主要依靠交叉熵损失来训练,它的作用方式是惩罚被误分类的样本,从而在类别之间拉开距离。但这种做法并没有直接约束同一类样本的分散程度,因此在对付复合故障与单故障的重叠时效果有限。
困难还来自噪声。振动信号中天然混杂着多种噪声,例如电机带来的电磁噪声、风扇与气流产生的空气动力噪声,以及转子与轴承产生的机械噪声。强噪声会把样本分布从原本紧凑的范围扩散开去,使类内离散进一步升高,本来就很微弱的故障特征更容易被淹没,类间重叠也就更加严重。
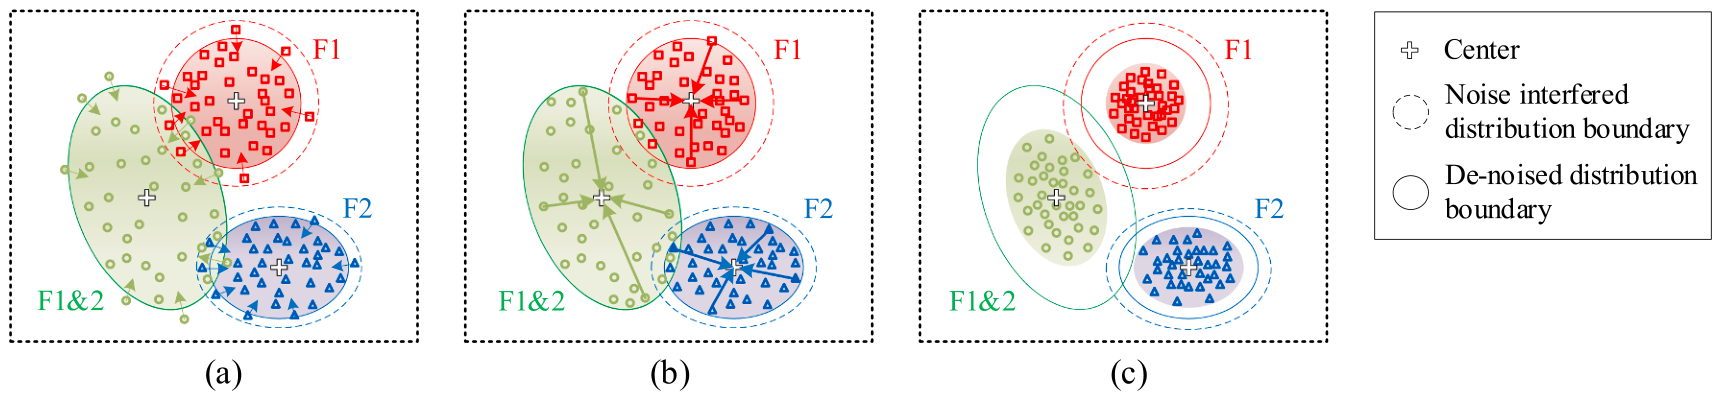
图1 传统特征空间、理想特征空间与去噪后特征空间的对比
论文用一组示意图说明了这一点。在传统特征空间里,复合故障的样本与它所涉及的单故障样本混在一起,每个类别都散布在一个较大的范围内;示意图中的实线小圈表示样本在无噪声时应有的紧凑分布,虚线大圈则表示受噪声干扰后实际扩散到的范围。论文想要达到的目标,是让每一类的样本向各自的类中心收拢,把小圈之外散布开的部分收回来,重叠也就自然分开了。
二、核心思路:在两个层面上做渐进收缩
论文提出的方法叫深度渐进收缩学习(Deep Progressive Shrinkage Learning,简称 DPSL)。它的思路是把"分离重叠"这件事拆到两个层面上去做,并且分阶段逐步推进。
第一个层面是特征层面。论文把软阈值化作为一种非线性操作嵌入到多个特征学习单元之中。软阈值化的作用很直接:绝对值小于阈值的特征被置为零,绝对值大于阈值的特征则向零的方向收缩一个阈值的量。这样一来,那些数值很小、多半与噪声相关的特征被逐步清除掉,而真正有判别力的特征得以保留。由于软阈值化被安排在网络的多个深度位置上,去噪不是一次完成的,而是在特征提取的早期、中期和深层反复进行,因此说它是"渐进"的。
第二个层面是决策层面。论文在损失函数中引入了一个中心损失,它的作用是强迫同一类样本的深层特征向其类中心靠拢,把每个类的样本"捏"得更紧凑。类中心本身也在训练中不断更新,用的是小批量内样本的均值做增量调整。最终的损失由交叉熵损失与中心损失加权求和构成,前者保证类与类之间可分,后者负责压缩类内散布,两者共同作用。
把这两层合起来看,所谓"渐进"就有了两层含义:一是在网络的深度方向上逐层去噪,二是在处理阶段上先做特征级收缩、再做决策级收缩。样本先去掉噪声带来的虚散,再被拉向各自的类中心,类内离散被一步步压低,原本重叠的类间边界随之显现出来。
承载收缩的基本单元
特征级收缩是由一类特殊的残差单元来承载的。论文先给出了一种基础的残差单元,它的结构比较常规:两个卷积层,各自后接批归一化,主路径之外还有一条恒等快捷连接,把输入直接加到输出上。恒等连接的意义在于缓解深层网络中的梯度消失与梯度爆炸。
在此基础上,论文给出了带收缩功能的残差单元:它在基础单元的主路径上额外插入了一个软阈值化操作,并为这个操作配了一个专门用来学习阈值的子网络。这个子网络的构成依次是取绝对值、全局平均池化、全连接层、批归一化、激活函数、再一个全连接层,最后经 Sigmoid 输出一个位于零到一之间的缩放系数。
这样设计的用意是让阈值能够自适应。子网络先是取特征绝对值的平均作为基准,再用注意力机制学到的缩放系数去调整它,从而为每一个特征通道给出各自不同的阈值,而不需要人工设定。这也意味着网络可以针对不同通道的噪声水平采取不同力度的抑制。
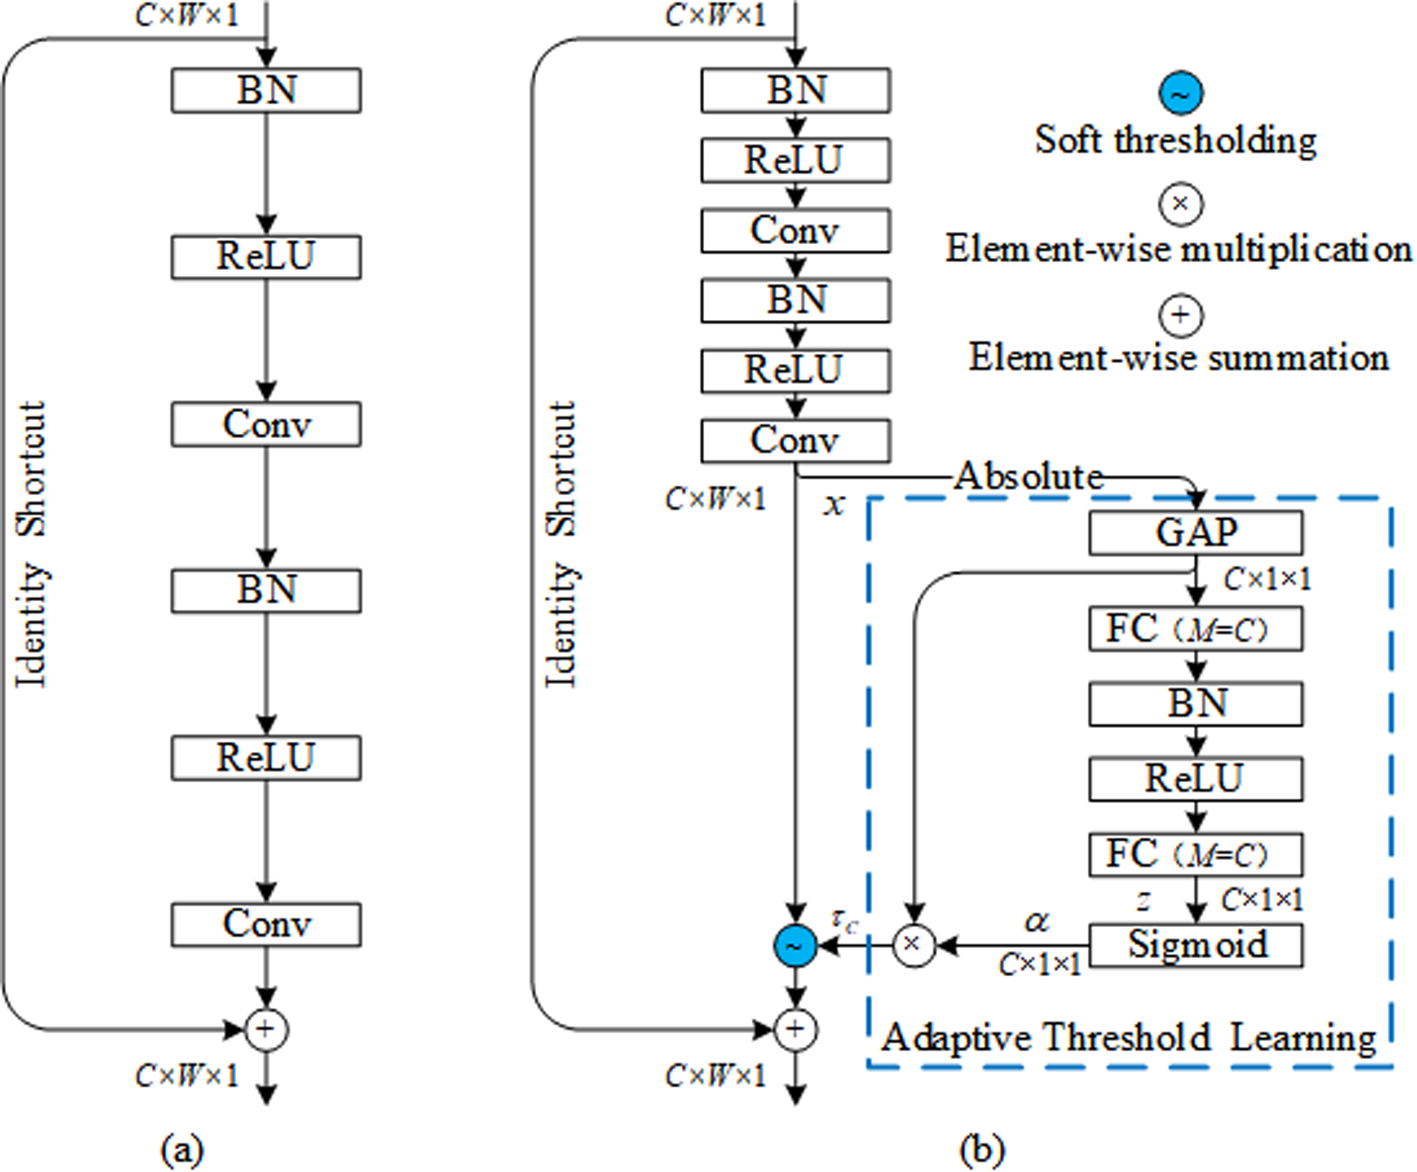
图2 基础残差单元与带收缩功能的残差单元结构对比
软阈值化之所以适合放进深度网络,还因为它的梯度性质很友好:在阈值之外梯度恒为一,不会引起梯度爆炸;在阈值之内梯度为零,正好可以阻止噪声特征继续向后传播。既能去噪,又便于训练,这是它被选中的原因。
三、整体架构与诊断流程
把上述模块组合起来,就得到了论文的完整网络。它以一段一维振动信号作为输入,先经过一个卷积层做初步的特征提取,随后连接若干个带收缩功能的残差单元,通道数逐级增加,部分单元通过步长实现下采样。特征提取完成后,用全局平均池化把特征图压成一维向量,再经全连接层映射到各类健康状态的输出。全局平均池化的输出之后还加了丢弃操作,用于抑制过拟合。
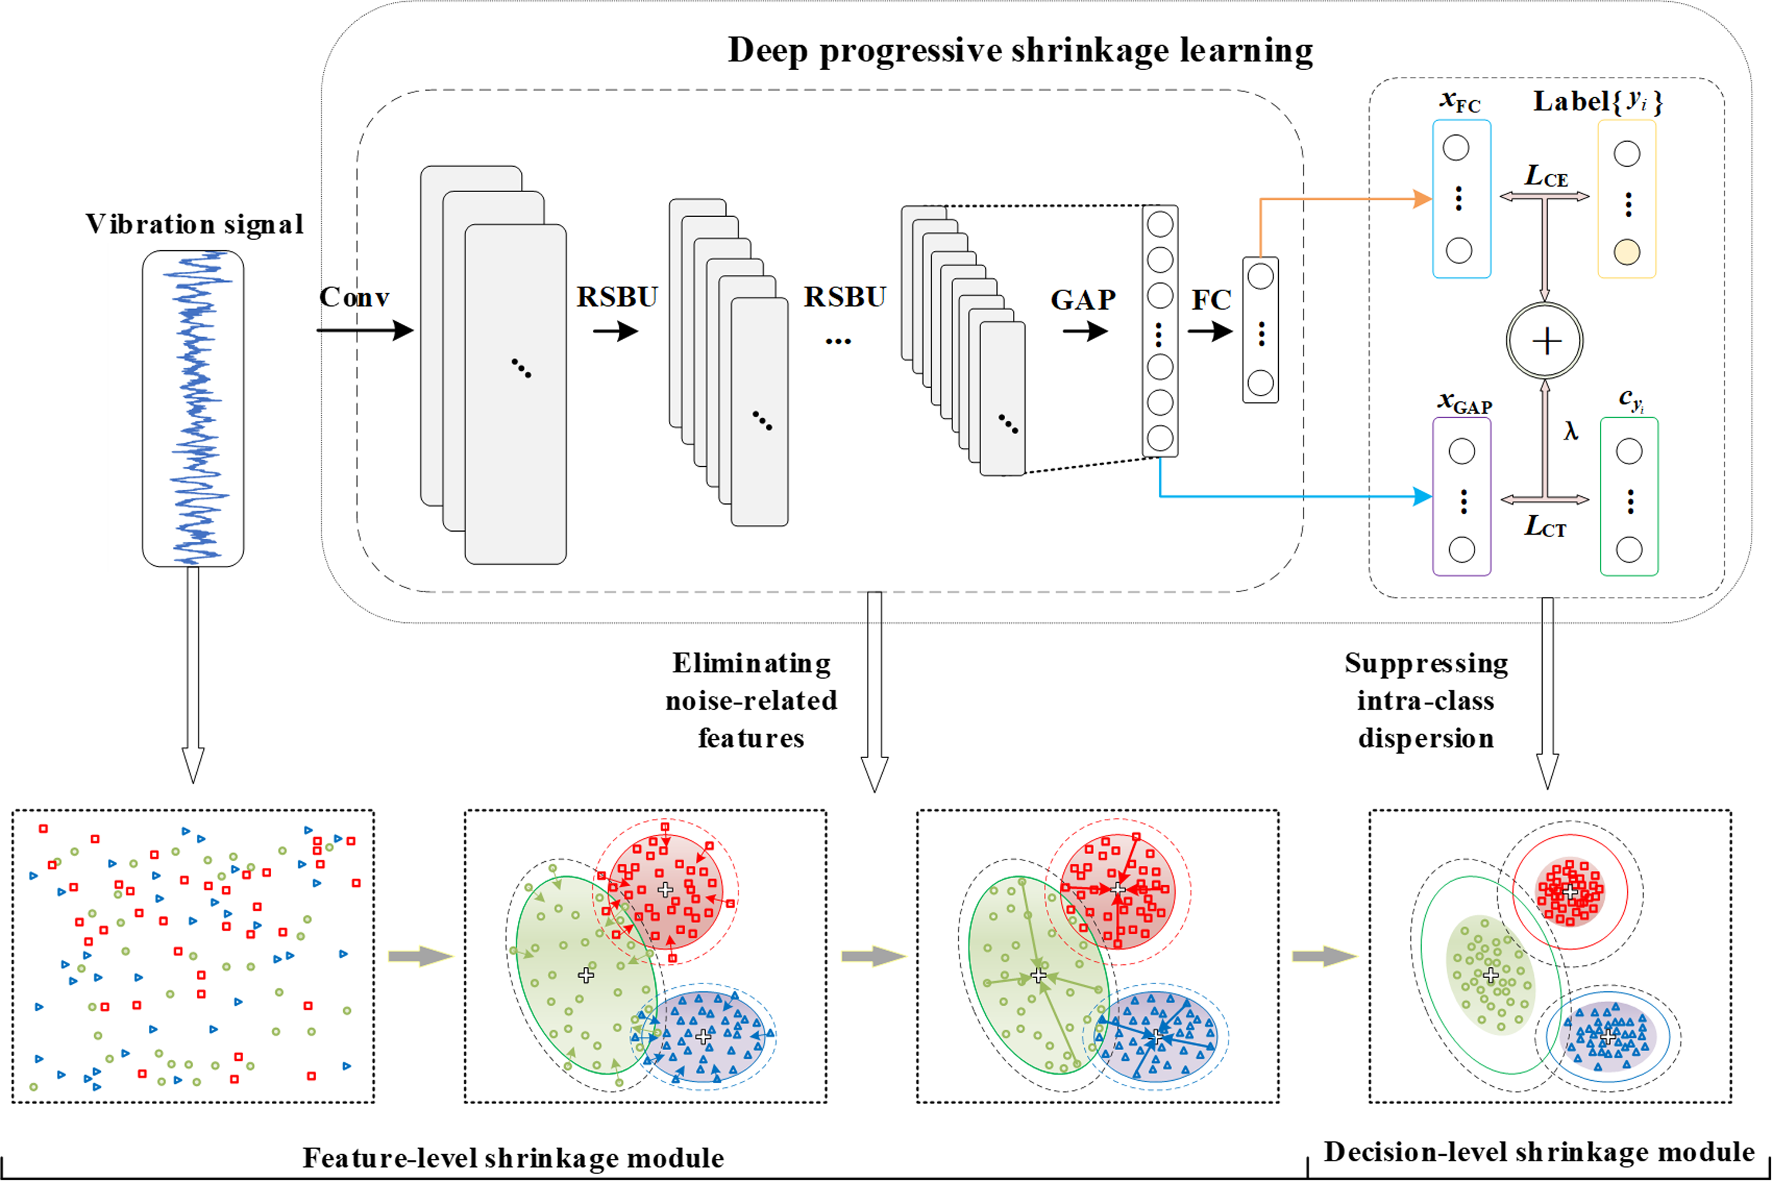
图3 深度渐进收缩学习的整体架构
从架构图可以看出两条并行的收缩路径。上方那条穿过多个带收缩功能的残差单元,对应特征级的去噪;右侧那条从全局平均池化的输出出发,同时参与分类和类内收缩,对应决策级的收紧。图中也示意了样本分布在这两个阶段中的变化:经过特征级收缩,噪声带来的扩散被削弱;再经过决策级收缩,各类样本聚拢到各自的中心附近,复合故障与单故障之间的重叠被打开。
完整的诊断流程分为几步。首先是从试验台采集振动信号并切分成样本,按比例划分训练集与测试集。然后是训练:样本送入网络,多个带收缩功能的残差单元逐层去除噪声相关特征,同时中心损失与交叉熵损失联合最小化,用带动量的随机梯度下降优化网络权重,学习率分阶段递减。训练完成后,把测试样本送入网络,由全连接层输出各类别上的预测结果,取其中最大者作为诊断结论。
四、实验与结果
实验在一台传动系诊断模拟器上进行,装置包含电机、行星齿轮箱与定轴齿轮箱等部分。加速度传感器安装在行星齿轮箱的输入端,采集振动信号。数据共包含九类健康状态,其中一类是健康状态,七类是单一故障,分别对应齿轮的裂纹、点蚀、断齿、缺齿以及轴承的滚动体、内圈、外圈故障,最后一类是复合故障,由轴承内圈、外圈与滚动体三种损伤同时发生构成。每个样本包含一定长度的数据点,各类样本数量相当,按比例划分为训练集和测试集。
为了说明方法中各个组件的贡献,论文设计了一组结构相近的对比方法。它们共用同一套主干结构,区别只在于基本单元的类型以及是否使用中心损失:有的方法用普通卷积单元,有的用基础残差单元,有的用带收缩功能的残差单元;在损失函数上,有的只用交叉熵,有的再加上中心损失。这样安排使得各种方法之间的差异可以清楚地归因到具体组件上。
论文在两种条件下做了考察。第一种是不额外添加噪声的原始数据,第二种是在原始数据上叠加不同程度的高斯白噪声,构造出若干噪声强度等级,其中强度最高的那一档,噪声的功率已经超过了信号本身的功率,属于相当极端的干扰条件。每个样本的噪声都是独立生成的。
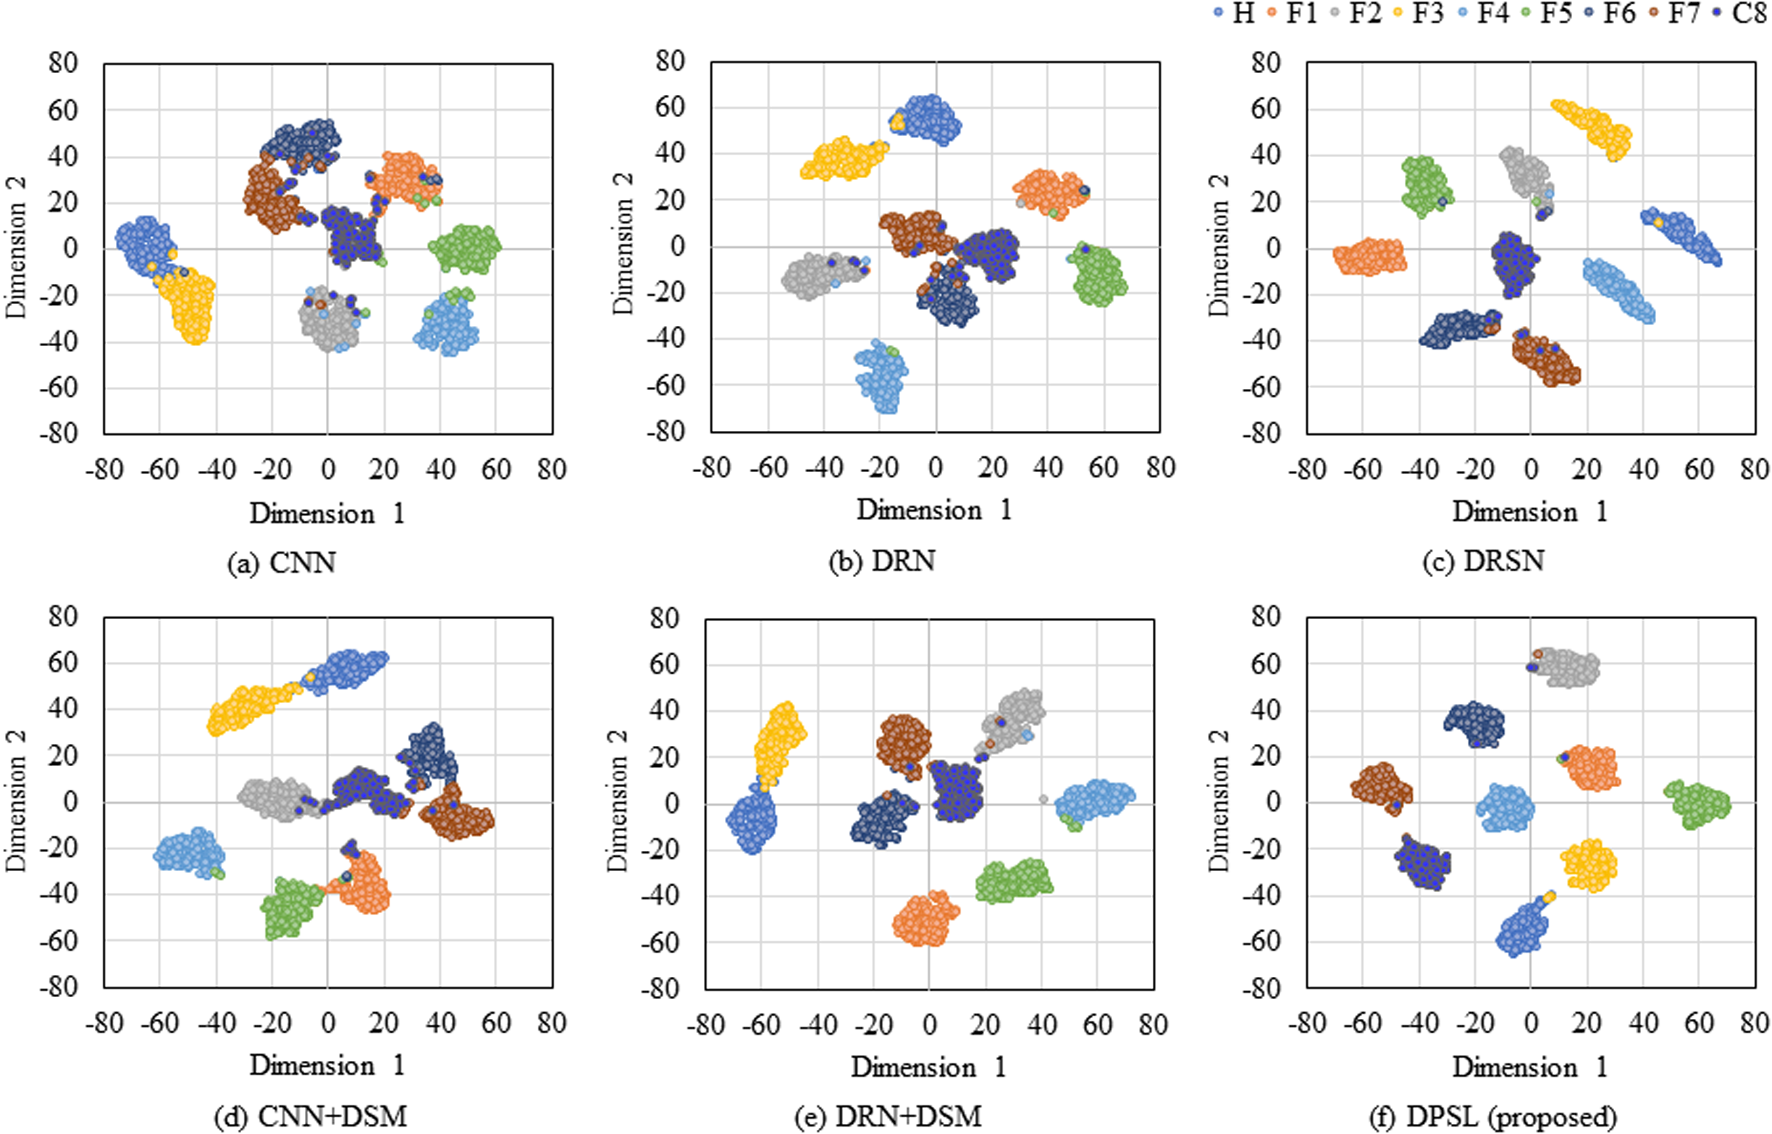
图4 各方法所提取的高层特征在二维平面上的可视化
论文用降维的方式把各方法提取的高层特征投影到二维平面上观察。从卷积网络到残差网络,再到带收缩功能的残差网络,各类样本的分离程度逐步改善;而在决策级收缩被加入之后,同一类样本聚得更紧,不同类之间的边界也更清楚。所提方法对应的特征簇最为紧凑,错分的样本也最少,这说明它的特征判别能力最强。
从定量结果看,所提方法在不加噪声的原始数据上取得了较好的效果,在多数类别上的辨识结果都优于对比方法。尤其值得关注的是复合故障这一类:各方法对它的辨识都明显难于单一故障,而所提方法在这类上的表现是几种方法中较好的,这也呼应了论文想要解决复合故障与单故障重叠问题的初衷。在强噪声条件下,所有方法的性能都有所下降,但所提方法在各级噪声强度下的表现都相对更好,并且在最高噪声强度下仍能保持一定的诊断能力,而传统方法的准确率已经很低。
论文还通过对比验证了两个组件的价值。加入中心损失的方法相比不加的版本,在不含噪声与含噪声两种数据上都有改善,说明决策级收缩确实起了作用;使用带软阈值化单元的方法相比不使用的版本,改善更为明显,说明特征级去噪的贡献更大。此外,论文还发现,某些方法在训练集上的准确率很高,但测试表现反而不如所提方法,论文分析这是因为缺少软阈值化辅助时,网络容易把噪声特征误当作有判别力的特征,从而造成过拟合。
论文最后总结,所提方法在不含噪声与含强噪声两种数据上,平均表现都优于其他对比方法,而且结果更为稳定;它对复合故障的辨识能力最强,说明"分离复合故障与单故障重叠"这一目标得到了实现;从特征可视化看,它提取的特征也最具判别性。论文认为,该方法既适用于同时存在复合故障与单一故障的场景,也适用于样本中含有强噪声的工程场合。
五、小结
这篇论文的思路可以概括为"分两步把样本聚拢"。面对复合故障与单故障在特征空间里纠缠不清的局面,它没有只在分类边界上做文章,而是先让网络在多个深度位置上用软阈值化把噪声相关的特征逐层清除,把样本因噪声而虚散的部分收回来;再在决策阶段用中心损失把同类样本拉向各自的类中心,进一步压缩类内散布。两次收缩叠加,类内离散被逐渐压低,原本重叠的类别便自然分开了。
原论文链接:https://doi.org/10.1016/j.measurement.2022.111433
欢迎阅读。