论文题目: AdaCluster: Adaptive Query-Key Clustering for Sparse Attention in Video Generation
中文翻译: AdaCluster:面向视频生成稀疏注意力的自适应 Query-Key 聚类
会议: CVPR 2026
源码: https://github.com/USTC-MLSys-Team/Adacluster
摘要: 视频扩散 Transformer(DiT)由于注意力计算具有二次复杂度,推理延迟十分高。现有稀疏注意力方法要么忽略 token 之间的语义相似性,要么无法适应不同网络层中异构的 token 分布,从而导致模型性能下降。本文提出 AdaCluster,一种无需训练的自适应聚类框架,在保持精度的同时加速 DiT 的视频生成。AdaCluster 针对 Query 向量采用保持角度相似性的聚类方法,以获得更高的压缩率;针对 Key 向量则设计保持欧氏相似性的聚类方法,其中包括聚类数分配、基于阈值的自适应聚类以及高效的关键簇选择。作者在单张 A40 GPU 上对 CogVideoX-2B、HunyuanVideo 和 Wan-2.1 进行实验,取得了最高 1.67×--4.31× 的加速,同时生成质量几乎不受影响。
一、研究背景与核心问题
1.1 视频 DiT 真正慢在哪里?
视频 DiT 的问题并不是 Transformer "不能生成长视频",而是序列一旦变长,Full Attention 的代价迅速失控。视频 token 数同时受到帧数、空间分辨率影响,而标准注意力需要计算 QKᵀ,其复杂度随序列长度近似二次增长。论文给出的例子很直观:CogVideoX-2B 在单张 A40 上生成 81 帧、720p 视频时,输入长度约 70K tokens,完整生成耗时 1691 秒,其中 attention 占到了总时间的 75%。在 HunyuanVideo 上,1280×720 的 81 帧视频已经需要 27 分钟以上,更高分辨率的 1920×1120 则可达到约 130 分钟。
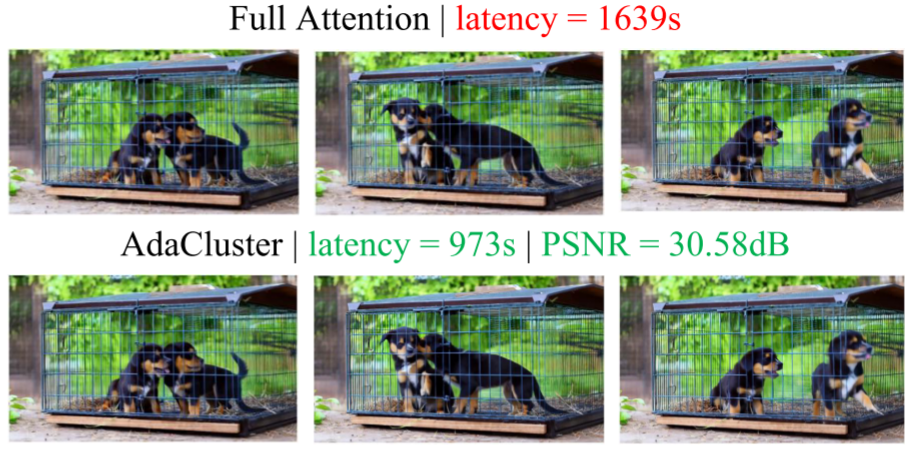
Figure 1 :Full Attention 与 AdaCluster 的延迟和生成结果对比
Figure 1 给出了这篇论文最直接的目标:在 HunyuanVideo 上,Full Attention 的延迟为 1639 s,而 AdaCluster 降到了 973 s,同时保持 PSNR = 30.58 dB。也就是说,作者不是重新训练一个更小的视频生成模型,而是希望直接从 attention 计算本身下手。
稀疏注意力的基本出发点是:真正决定每个 Query 输出的通常只有少量重要 Key,因此没有必要让每个 Query 都和所有 Key 做完整计算。但困难在于------怎样低成本地找到真正重要的 Key?
1.2 现有动态稀疏注意力的问题:Q 和 K 被"一视同仁"
一种常见思路是先把 token 聚类,再用每个簇的代表去估计重要性。SpargeAttn 直接把连续 token 按 block 聚合,但空间上连续并不意味着 embedding 空间里相似;SVG2 进一步采用聚类,却给不同模型、不同层使用固定的 Query/Key 聚类数量。问题在于,不同层的 token 分布实际上差异很大。
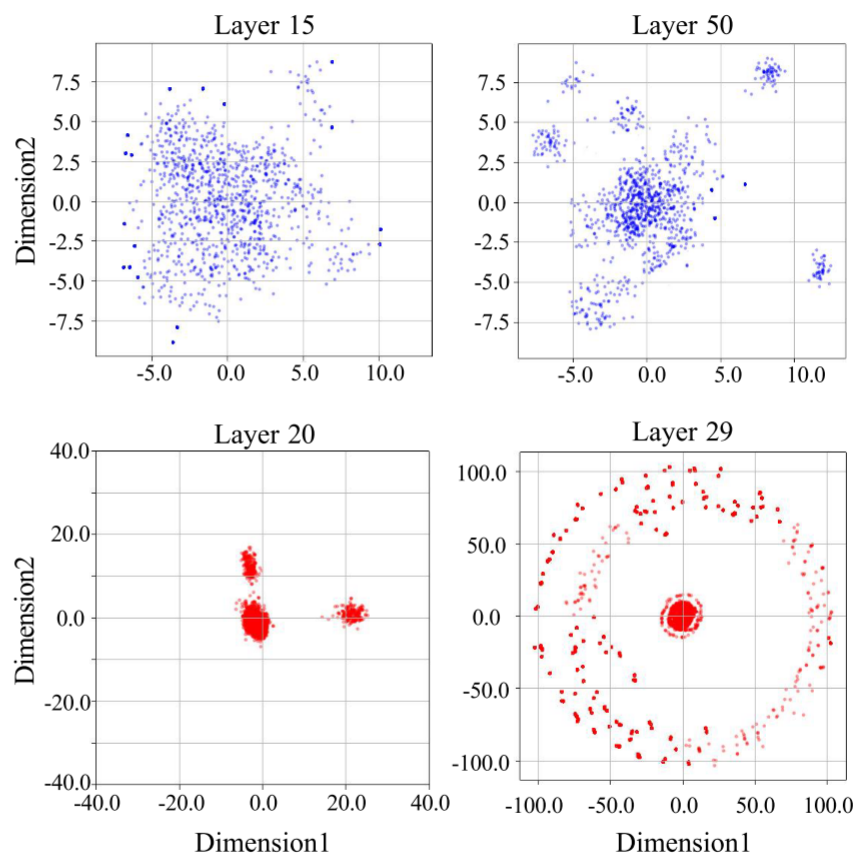
Figure 2:HunyuanVideo 与 Wan-2.1 不同层的 Key token 分布
Figure 2 很关键。某些层的 token 高度集中,少量 cluster 就能很好表示;另一些层非常分散,需要更多 cluster,甚至根本不适合压缩。如果对所有层统一设置相同聚类数,要么浪费计算,要么损失重要 token。
作者进一步指出,现有方法还有第二个问题:聚类完成后通常只根据 cluster center 判断一个簇是否重要,但重要 token 可能位于簇边界,并不一定接近中心。因此 AdaCluster 的核心思路可以压缩成一句话:
不要再用同一套规则处理 Query 和 Key,而是根据它们在 Attention 中承担的不同作用,分别设计聚类与筛选策略。
二、AdaCluster 整体框架:先聚类,再自适应筛选
AdaCluster 是 training-free 的,不需要重新训练 DiT。整体流程仍然围绕 Top-K sparse attention 展开,但作者把"cluster-then-select"流程做了 role-aware 重构:
Q → 归一化 → Query 聚类 → K → 逐层自适应多阶段聚类 → TensorQuest 选择关键 Key 簇 → 仅对候选 K/V 做 Attention
如果某一层的 Key 分布实在太分散,聚类数量超过预设上限,AdaCluster 不会强行稀疏化,而是直接回退到 Full Attention。这一点很重要:它不是要求所有层都必须压缩,而是把"该不该稀疏"也纳入运行时决策。
整个方法包含三个最核心的设计:第一,Query 只需要保持与 Key 打分的相对顺序,因此可以先归一化,再按角度相似性聚类;第二,Key 的向量长度和方向都会影响打分,因此需要保持欧氏距离,并且不同层采用不同数量的 cluster;第三,在完成聚类后,通过 TensorQuest 更高效地判断哪些 Key cluster 真正值得进入后续 Attention。
三、Query Clustering:为什么先归一化反而更容易聚类?
Query 端的洞察非常简洁。假设某个 Query 为 q,两个 Key 分别为 kₐ 和 kᵦ。将 q 归一化为 q̂ = q / ‖q‖₂ 后,由于 ‖q‖₂ 始终为正数,因此有:
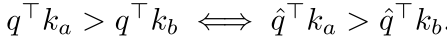
也就是说,归一化 Query 会改变 Attention score 的绝对大小,但不会改变不同 Key 之间的相对排序。 对 Top-K 筛选而言,真正关心的恰恰是排序,因此 Query 的长度不是必须保留的信息。
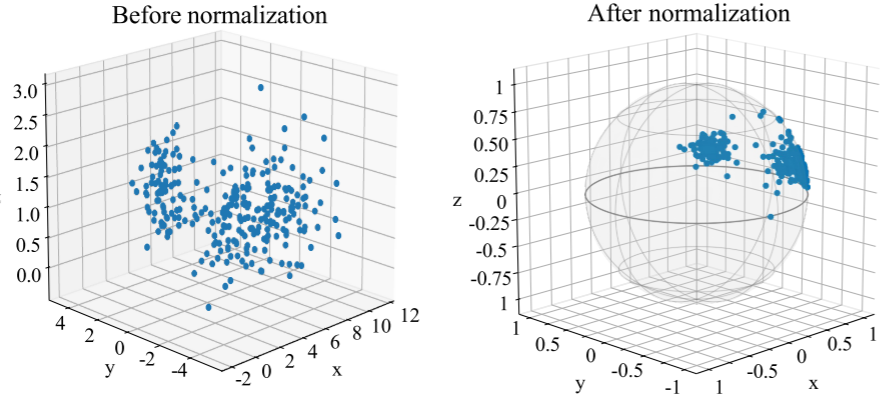
Figure 3:Query 归一化前后的向量分布
Figure 3 展示了归一化前后 Query 的分布变化。原始 Query 在高维空间中的长度差异较大,直接做欧氏聚类不容易压缩;归一化后所有 Query 被投到单位球面上,分布明显更紧凑,此时聚类实际上主要在比较方向,也就是角度相似性。
这个设计的价值不仅是理论上成立,附录中的实验也给出了更强的证据。
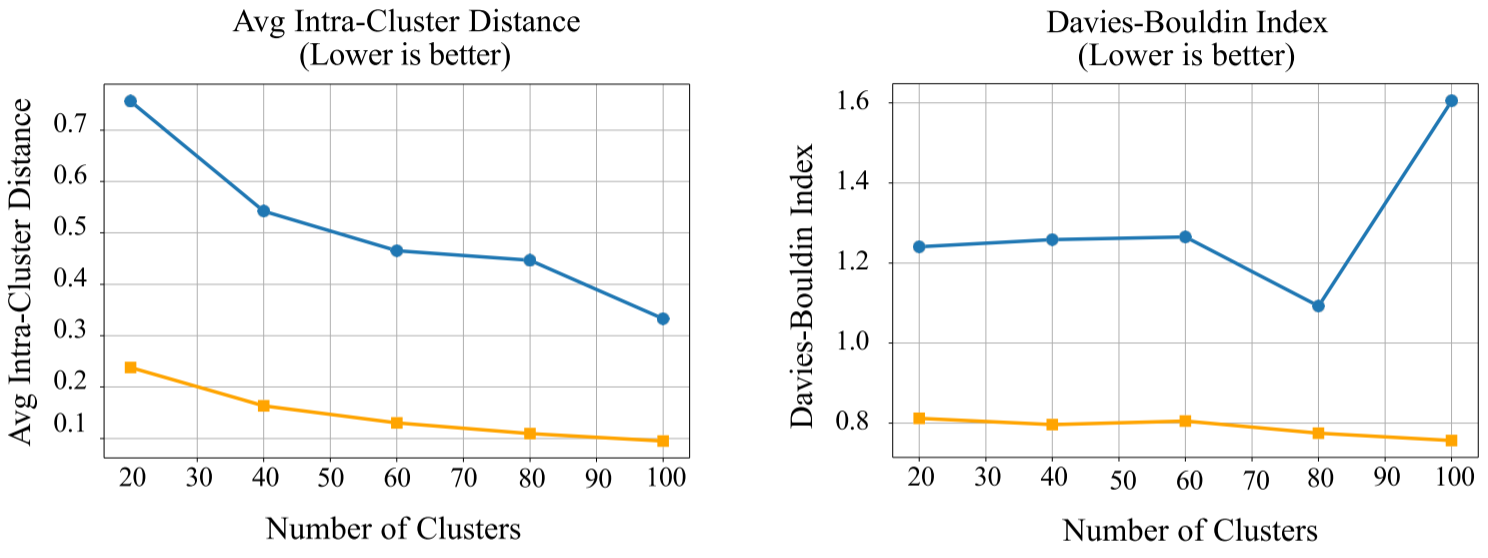
Figure 10:归一化前后 Query 的簇内距离与 Davies-Bouldin Index
在相同 cluster 数量下,归一化后的 Query 具有更低的平均簇内距离和更低的 Davies--Bouldin Index。论文固定归一化后的 Query 使用 65 个 clusters,而未归一化方案平均需要超过 235 个 clusters,才能达到相近的簇内距离,相当于带来约 3.6× 的有效压缩优势。
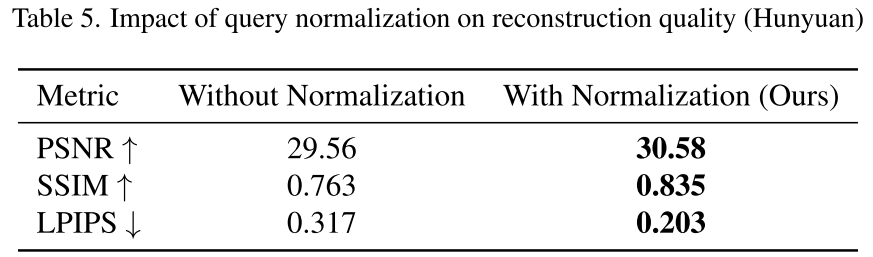
Table 5:Query Normalization 对重建质量的影响
Table 5 进一步说明这种压缩并没有白白牺牲质量。在 HunyuanVideo 上,加入 Query Normalization 后,PSNR 从 29.56 提升到 30.58,SSIM 从 0.763 提升到 0.835,同时 LPIPS 从 0.317 降到 0.203。这里的关键不是"归一化是一个小技巧",而是作者利用了 Attention 排序对 Query 尺度不敏感这一性质,把一个难聚类的问题主动变成了更容易压缩的角度聚类问题。
四、Key Clustering 与 TensorQuest:真正的自适应发生在 K 端
4.1 Key 为什么不能照搬 Query 的办法?
Key 与 Query 不同。对于 Key 来说,向量方向和长度都会影响 qᵀk,因此不能直接归一化。假设 k 所属 cluster 的中心为 c(k),则有:
这个不等式说明,只要同一簇内部的 Key 足够紧凑,即 ‖k − c(k)‖₂ 足够小,用 cluster center 近似簇内 Key 的打分才可靠。因此,Key 聚类真正要控制的是欧氏空间中的簇内误差。
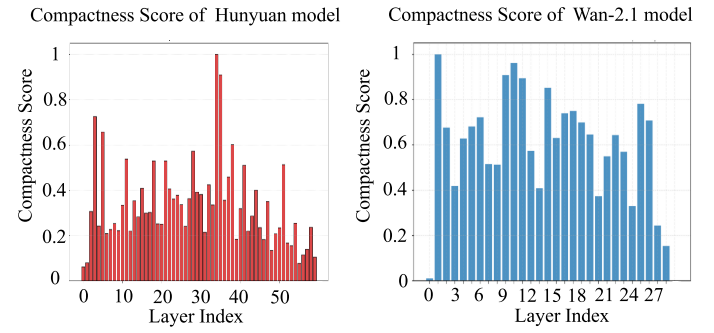
Figure 4:Wan-2.1 与 HunyuanVideo 不同层的 compactness score
Figure 4 表明不同层的 compactness 差异很大,所以固定 cluster 数并不合理。AdaCluster 对分布集中的层分配较少 clusters,对分布分散的层分配更多 clusters。
4.2 Multi-stage K-means:让 cluster 数自己长出来
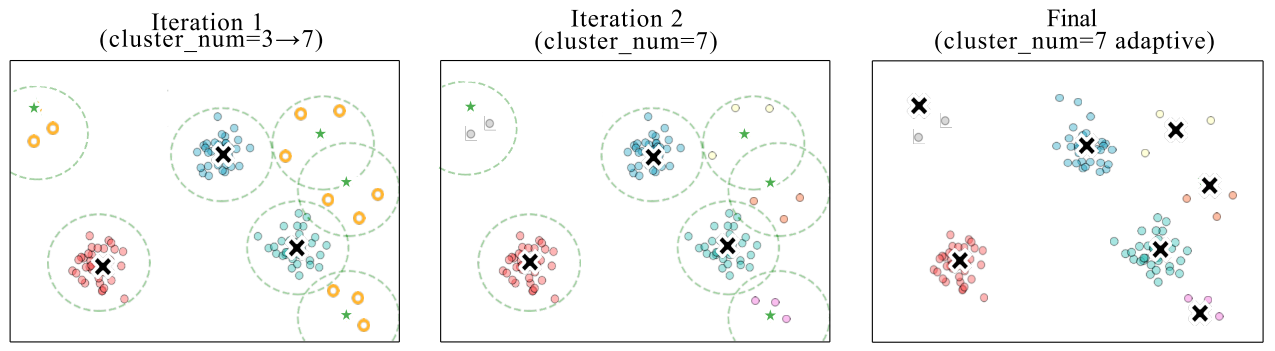
Figure 5:Multi-stage K-means 的逐阶段聚类过程
作者没有提前为每一层手工指定 K,而是从一个中等规模的 cluster 数开始。第一轮 K-means 后,距离 cluster center 小于阈值 τ 的 token 被认为已经得到足够紧凑的表示;剩余离群 token 继续进入下一轮 K-means,并新增 cluster。这个过程不断重复,直到所有 token 被分配到足够紧凑的簇。
如果 cluster 总数达到 Nmax 仍然无法满足要求,说明该层"难以压缩",此时直接使用 Full Attention。换句话说,AdaCluster 的自适应不仅体现在"每层 K 不同",还体现在"某些层可以选择完全不稀疏"。
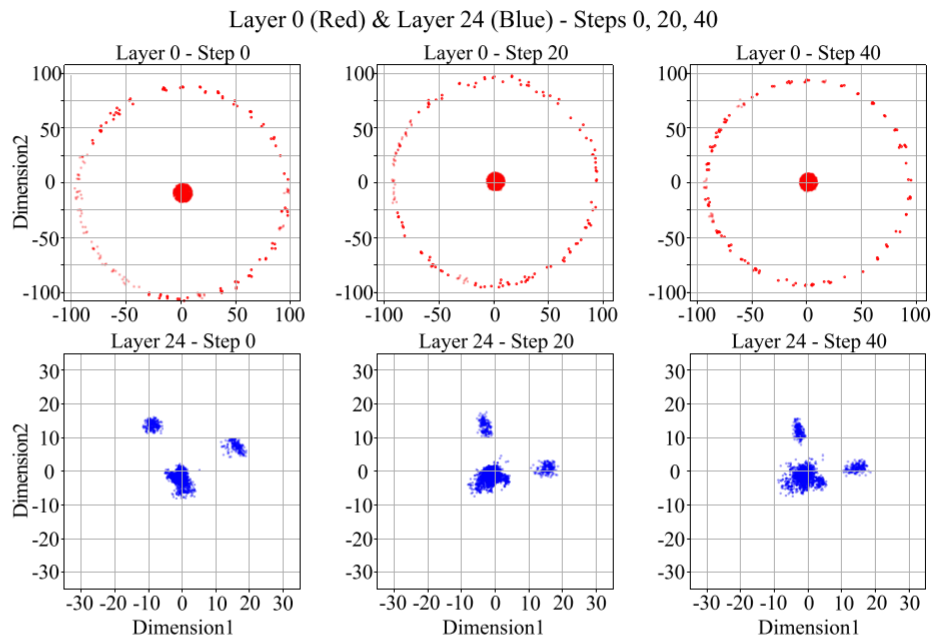
Figure 6:不同 denoising timestep 的 token 分布一致性
视频扩散还要重复几十个 denoising steps,如果每一步都重新完整聚类,聚类本身会成为新的开销。Figure 6 给出的观察是:相邻 denoising step 中,同一层的 token 分布变化比较平缓。因此作者只在第一个 step 通过 Multi-stage K-means 决定每层的 cluster 数,后续 step 固定 cluster 数,并使用上一 step 的 cluster center 作为当前 step 的初始化,从而降低聚类成本。
4.3 TensorQuest:把"找关键簇"搬到 Tensor Core
仅仅聚类还不够。下一步仍然要判断:对于当前 Query,哪些 Key clusters 最重要?作者借鉴 Quest 的上界估计思想,但指出原始 Quest 主要依赖 CUDA Core,在视频扩散这种计算规模下仍然太慢。
AdaCluster 将 Query 和 Key 的正负部分拆开,使核心运算能够改写为矩阵乘法形式。算法中先得到 Q⁺ = max(Q, 0)、Q⁻ = min(Q, 0),以及对应的 K⁺、K⁻,再通过矩阵乘法计算 cluster score。这样做的核心意义不是改变筛选目标,而是把原本不适合高吞吐矩阵计算的选择过程,重写成 Tensor Core 更擅长的计算形式。
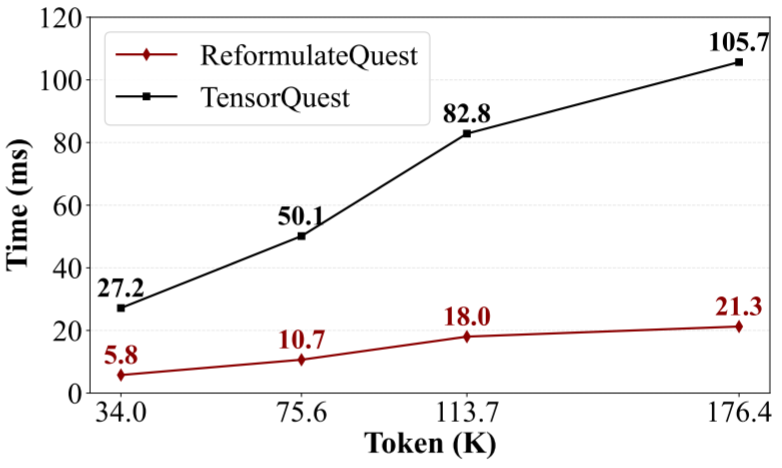
Figure 8:TensorQuest 与原 Quest 重写方案的 Top-K 选择耗时
当输入序列达到论文测试中的最长规模时,TensorQuest 的 Top-K selection 最多可获得约 5× 加速。这一设计体现出 AdaCluster 很强的系统味道:算法层面减少要算的 token,kernel 层面还要确保"决定哪些 token 不算"的过程本身足够便宜。
五、实验结果与消融分析
5.1 实验设置
作者在 CogVideoX-2B、Wan-2.1-T2V-1.3B 和 HunyuanVideo 三个视频 DiT 上测试 AdaCluster,prompt 来自 PenguinVideoBenchmark。相似性指标使用 PSNR、SSIM 和 LPIPS,整体视频质量则使用 VBench 中的 Image Quality、Background Consistency、Subject Consistency 等指标。主实验运行在单张 NVIDIA A40 48GB GPU 上,并与 FlashAttention 原始模型、SpargeAttn 和 SVG2 比较。
实现上,作者将约 15% 最难压缩的层保留为 Full Attention;τ 设置为首个 inference step 中 token 到 cluster center 平均距离的 1.5×;Query cluster 数固定为 65,Key cluster 数由算法动态决定。后续 denoising step 会复用上一 step 的 cluster center。
5.2 主实验:速度更快,但结论不能简单写成"质量全面更高"
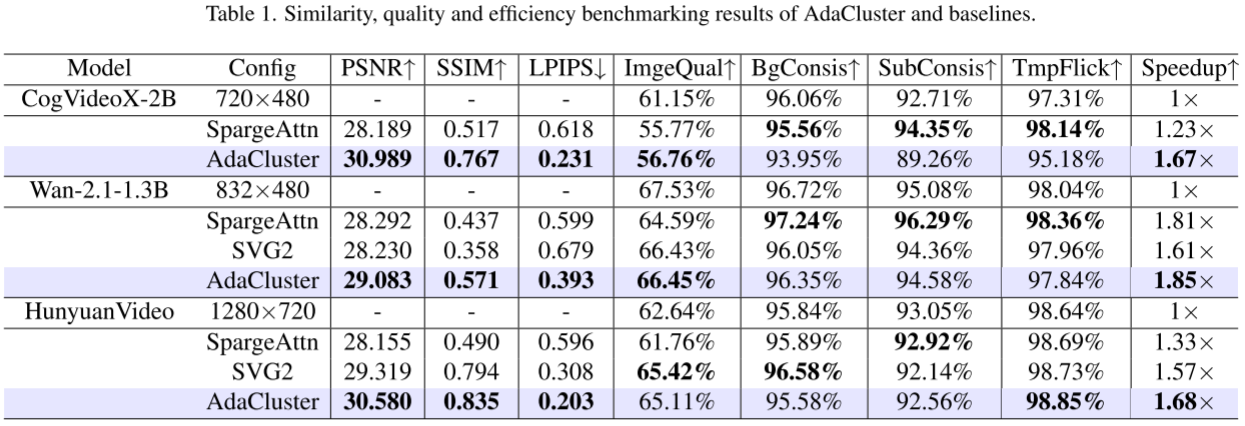
论文 Table 1:三种视频 DiT 上的相似性、视频质量与端到端速度对比
Table 1 是主实验最重要的证据。在 HunyuanVideo 1280×720 上,AdaCluster 达到 1.68× 端到端加速,同时 PSNR = 30.580、SSIM = 0.835、LPIPS = 0.203;对应 SVG2 的速度为 1.57×,SpargeAttn 为 1.33×。在 Wan-2.1 上,AdaCluster 达到 1.85×,也高于 SpargeAttn 的 1.81× 和 SVG2 的 1.61×;在 CogVideoX-2B 上则达到 1.67×,而 SpargeAttn 为 1.23×。
需要注意,VBench 各项指标并不是 AdaCluster 全部第一。论文自己也指出,CogVideoX 上 AdaCluster 和 SpargeAttn 都出现了比较明显的 image quality 波动。因此更准确的结论是:AdaCluster 在三个模型上都取得了更好的"与 Full Attention 输出相似度---速度"权衡,而不是所有感知质量指标都全面超过原模型。
5.3 序列越长,AdaCluster 的优势越明显
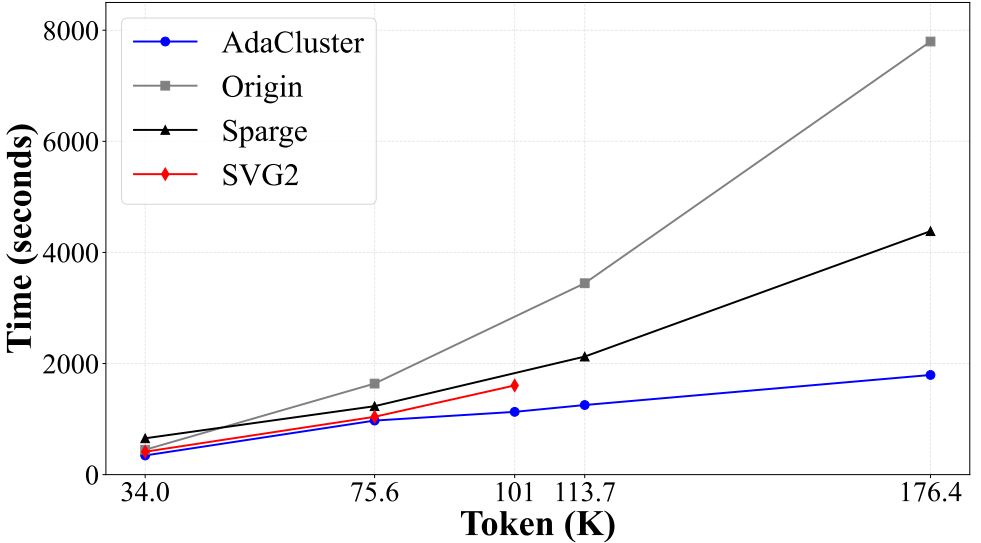
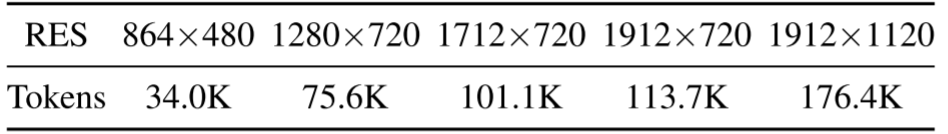
Figure 7:不同 token 长度下各方法端到端耗时趋势
Table 2:HunyuanVideo 不同分辨率对应的 token 数量
随着视频分辨率升高,序列从数万 tokens 增长到 176.4K tokens,AdaCluster 的优势越来越明显。在最长 176.4K token 配置下,AdaCluster 的峰值加速达到 4.31×,而 SpargeAttn 为 1.78×。论文还指出 SVG2 在 token 数超过 101.1K 后受到 metadata 缓存开销限制,无法继续适用。
这说明 AdaCluster 最适合解决的并不是短序列上的"几个百分点优化",而是高分辨率、长视频下 Full Attention 被二次复杂度拖垮的问题。
5.4 消融一:逐层自适应 cluster 数真的有必要吗?
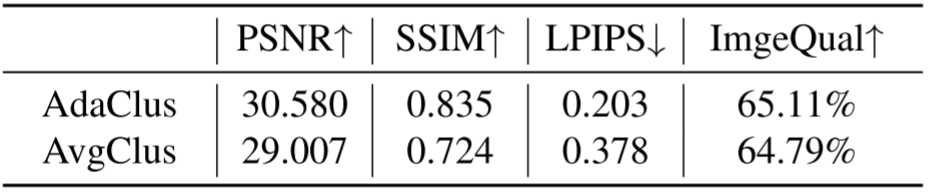
论文 Table 3:AdaClus 与统一平均 cluster 数 AvgClus 对比
作者构造了 AvgClus:所有层统一采用相同 cluster 数,同时让平均 cluster 数与 AdaCluster 基本一致,以排除"只是用了更多 clusters"的影响。结果中 AdaClus 的 PSNR 为 30.580,而 AvgClus 为 29.007;SSIM 从 0.724 提升到 0.835,LPIPS 从 0.378 降到 0.203。
因此关键不是 cluster 越多越好,而是把 cluster 预算分配到真正难压缩的层上。
5.5 消融二:TensorQuest 不只是快,也减少关键 token 漏选
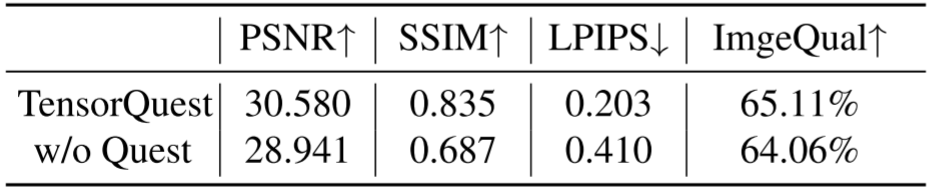
Table 4:TensorQuest 与不使用 Quest 的关键簇选择对比
TensorQuest 相比简单的 mean-based cluster selection,PSNR 从 28.941 提升到 30.580,SSIM 从 0.687 提升到 0.835,LPIPS 从 0.410 降到 0.203。结合 Figure 8 的速度结果可以看到,TensorQuest 同时解决两个问题:一方面比简单中心代表更不容易漏掉关键 token,另一方面通过矩阵化重写降低筛选本身的计算成本。
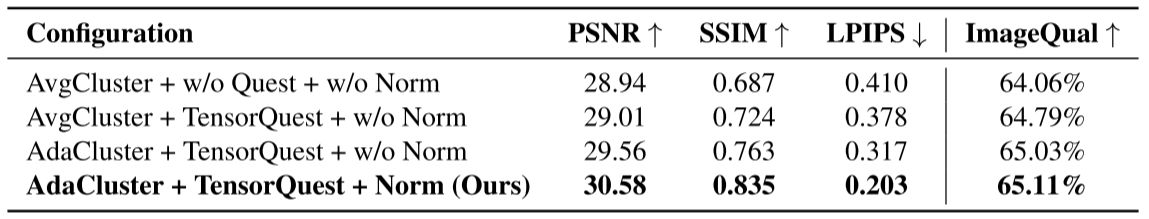
Table 6:AdaCluster 三个核心组件的完整消融
Table 6 把三个模块串起来看得更清楚:从 AvgCluster + w/o Quest + w/o Norm 出发,依次加入 TensorQuest、自适应 Key clustering 和 Query normalization 后,PSNR 从 28.94 最终提升到 30.58,SSIM 从 0.687 提升到 0.835,LPIPS 从 0.410 降到 0.203。三个模块并不是重复做同一件事:TensorQuest 负责"选得准",Adaptive Key Clustering 负责"每层压缩得合适",Query Normalization 则负责"让 Q 更容易被压缩"。
5.6 超参数、H100 与定性结果
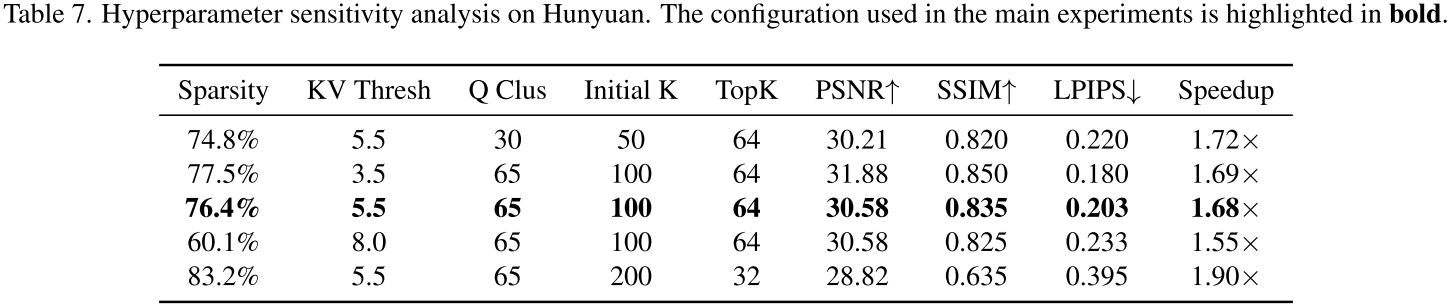
Table 7:关键超参数的速度---质量敏感性分析
主实验采用约 76.4% sparsity、KV threshold = 5.5、65 个 Query clusters、Initial K = 100、TopK = 64。Table 7 表明更激进的稀疏率可以继续换取速度,但会损害重建质量。因此 AdaCluster 的收益并不是"免费加速",而是在自适应策略下寻找更好的速度---质量平衡点。
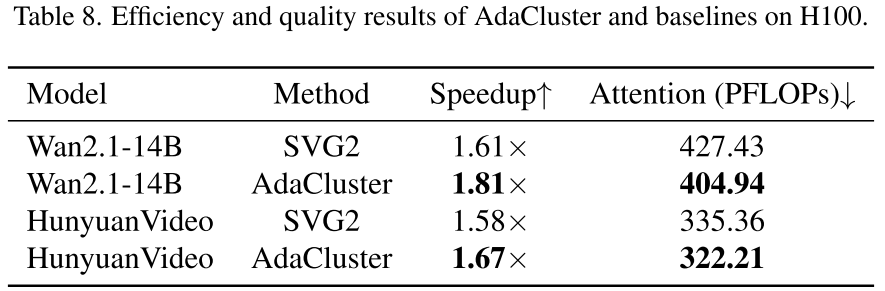
Table 8:H100 GPU 上的扩展实验
在 H100 上,AdaCluster 依然保持优势:Wan2.1-14B 上达到 1.81×,高于 SVG2 的 1.61×,Attention 计算量从 427.43 PFLOPs 降到 404.94 PFLOPs;HunyuanVideo 上为 1.67×,高于 SVG2 的 1.58×。这说明方法并不只对 A40 的特定执行环境有效,但实际加速幅度会受到模型、序列长度和硬件平台共同影响。
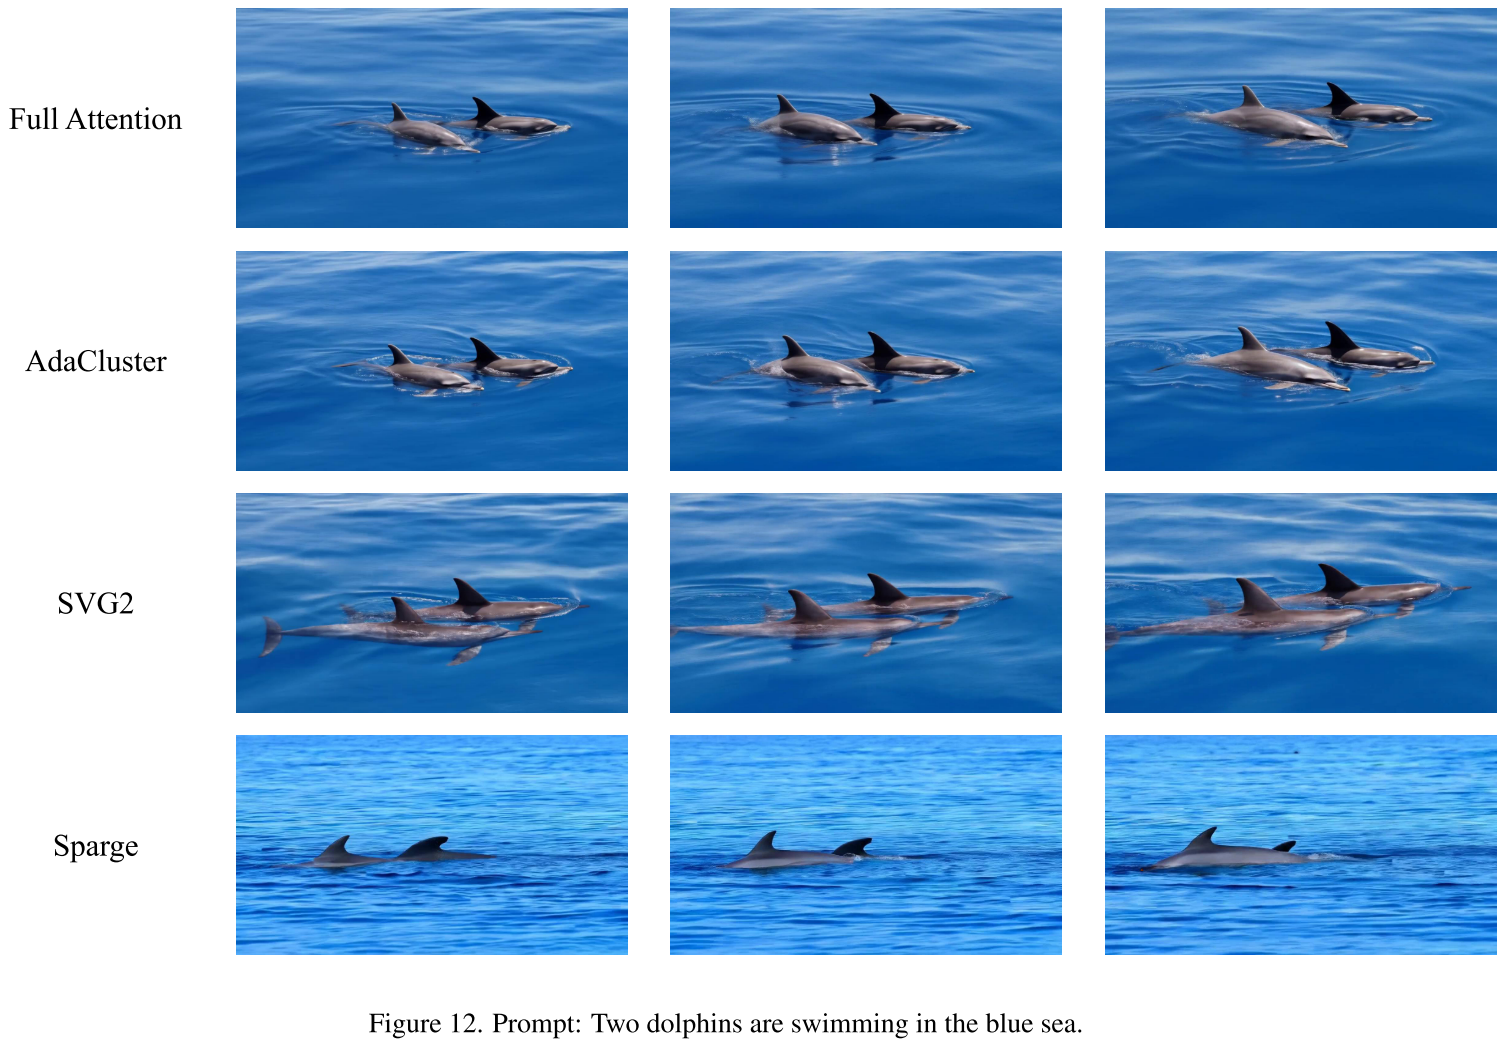
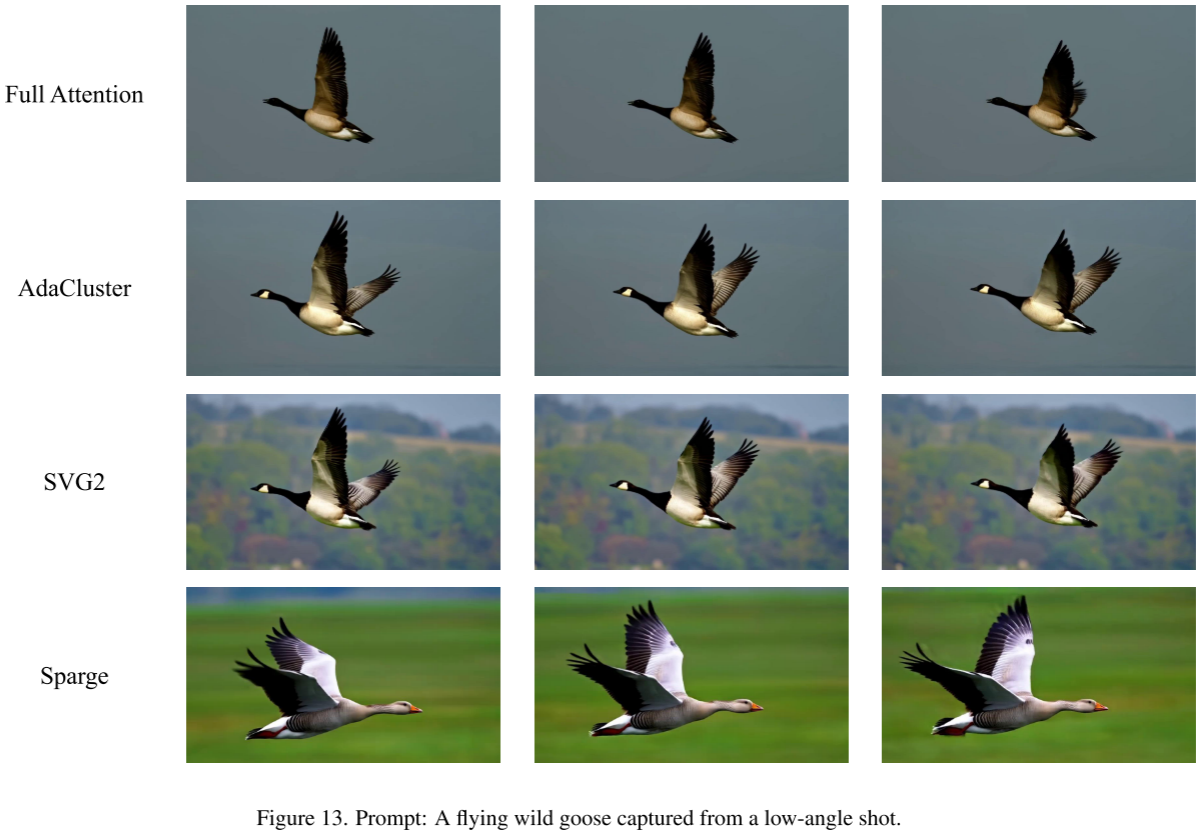
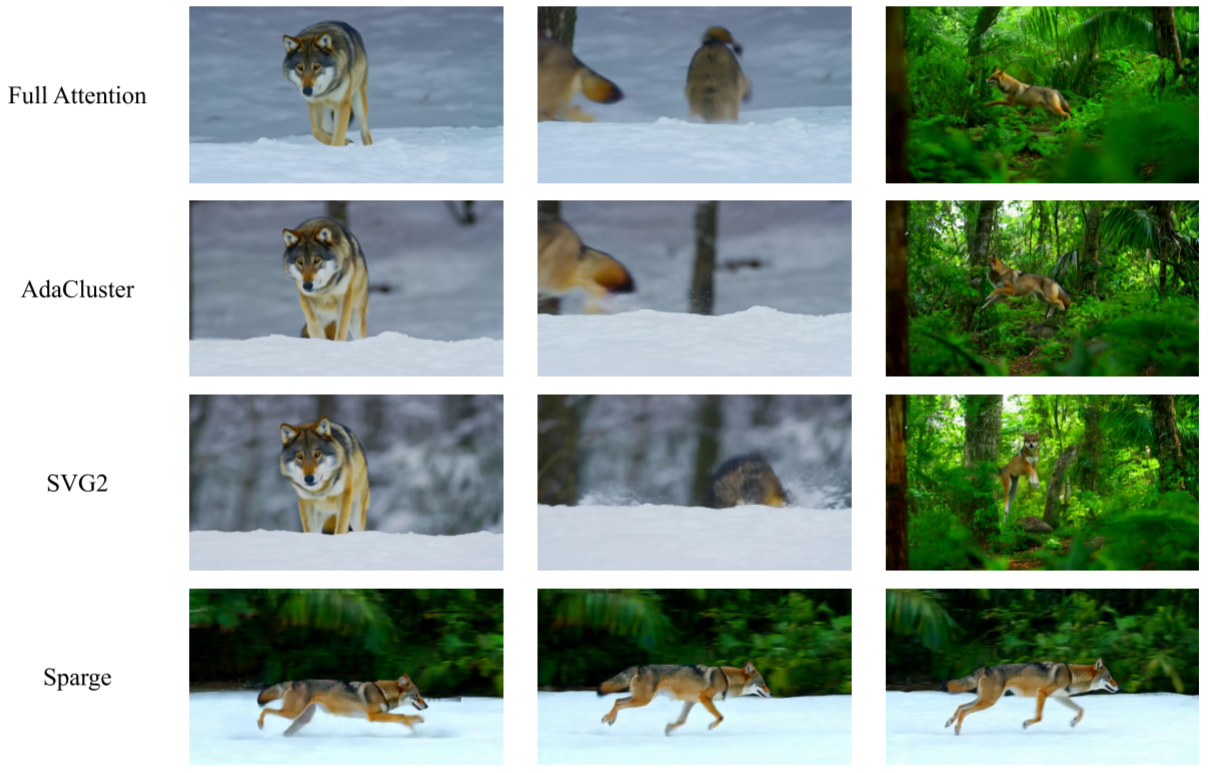
Figure 12--17:不同方法、不同模型的视频生成定性对比
附录中的可视化也值得看。Figure 12--14 比较 Full Attention、AdaCluster、SVG2 与 SpargeAttn,在海豚、飞鸟以及跨场景狼视频上,AdaCluster 与 Full Attention 的主体和场景变化整体更接近;Figure 15--17 又分别在 CogVideoX、HunyuanVideo 和 Wan-2.1 上进行对比,说明该方法可以迁移到不同视频 DiT,而不依赖单一模型结构。
六、总结与思考
如果把 AdaCluster 压缩成一句话,它做的不是简单"把 Attention 稀疏掉",而是先问清楚:Q 和 K 到底需要保留什么信息,再决定应该怎样聚类。
Query 端,作者利用 Top-K 排序对 Query 长度缩放不敏感这一性质,通过归一化把问题转化为更容易压缩的角度聚类;Key 端则保留长度与方向信息,用逐层 Multi-stage K-means 动态决定 cluster 数;完成聚类之后,再通过 TensorQuest 高效找到真正值得计算的 Key clusters。整个方法最后还加入难压缩层的 Full Attention fallback,以及跨 denoising step 的 cluster center 复用,使算法设计能够真正落到 GPU 推理效率上。
这篇论文最值得记住的其实有三点。第一,不要默认 Q、K、V 在稀疏化时应该被对称处理 ,它们在 Attention 中的作用不同,保真条件也不同。第二,稀疏模式应该随着层和输入分布变化,固定 block、固定 K 都可能浪费模型内部已经存在的异构性。第三,推理加速不能只看 FLOPs,筛选、聚类和索引本身也有成本,因此 TensorQuest 这种"让稀疏决策适配 Tensor Core"的系统级设计非常重要。
从方法设定上看,AdaCluster 的收益在长序列场景最明显,序列较短时优势会缩小;从实验结果看,CogVideoX 上部分 VBench 指标也存在质量下降,说明不同基础模型对稀疏化的耐受程度并不完全相同。此外,Table 7 已经明确展示了 sparsity 与重建质量之间的权衡,因此实际部署时仍需要根据目标分辨率、显存和质量要求选择配置。
总体来看,AdaCluster 给出的不是一种固定稀疏模板,而是一条很值得继续发展的思路:让稀疏 Attention 从"预先规定哪里不算",进一步走向"根据 Q/K 的角色和当前层的数据分布,动态决定应该算什么"。 对高分辨率视频 DiT 而言,这种 role-aware、layer-adaptive、hardware-aware 的联合设计,可能比单纯追求更高 sparsity 更有价值。