论文题目: Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers(用于高效扩散 Transformer 的可训练对数线性稀疏注意力)
会议: CVPR 2026(Highlight)
摘要: 扩散 Transformer(DiT)已经成为视觉生成中的先进架构,但自注意力的二次计算开销从根本上限制了它向长 Token 序列扩展。近期的 Top-K 稀疏注意力通过把 Token 压缩为块级表示、再为每个 Query 选择少量相关 Key Block 来降低 DiT 的计算量,但仍有两个问题:压缩 Token 上的选择过程依旧具有二次复杂度;随着序列变长,为维持模型质量还需要不断增大 K。作者认为,这种低效来自现有方法的单层设计------单一粗粒度层不足以描述长序列的全局结构。为此,论文提出 Log-linear Sparse Attention(LLSA),利用层次结构把选择和注意力计算从二次复杂度降到对数线性复杂度。LLSA 采用层次化 Top-K 选择:从粗层得到的索引出发,逐层向细粒度递归搜索;同时提出 Hierarchical KV Enrichment,把不同粒度的粗层 Key/Value 补充进最终注意力,以更少的 Token 保留全局上下文。为了支持高效训练,作者进一步实现了只依赖稀疏索引的 GPU 前向与反向计算,不再构造稠密 Attention Mask。实验在不使用 VAE 编码、且高分辨率 Pixel DiT 不进行 Patchification 的设置下验证 LLSA;在 256 × 256 Pixel Token 序列上,注意力推理最高加速 28.27×,DiT 训练加速 6.09×,同时保持接近全注意力的生成质量。
源码: https://github.com/SingleZombie/LLSA
一、研究背景与核心问题
DiT 的瓶颈非常直接:标准 Self-Attention 对长度为 N 的序列需要构造 Query-Key 两两关系,计算复杂度是 O(N²)。在 Latent DiT 中,Token 数往往已经通过 VAE 和 Patchification 被大幅压缩;但如果希望直接在 Pixel Space 建模,或者进一步扩展到长视频,N 会迅速增大,二次复杂度很快成为主要开销。
已有 Top-K Block Sparse Attention 看起来已经把注意力"稀疏化"了:先把 Q、K 压成块级 Token,再在粗 Token 上计算相似度,为每个 Query Block 选出 Top-K Key Block,最后只对这些块做 Sparse Attention。问题在于,它只稀疏了最后一步。粗 Token 之间仍然要做全量两两匹配,所以 Selection Stage 仍有 O(N²) 主导项;而且为了不丢掉远距离全局信息,序列越长通常还要使用更大的 K。
LLSA 的核心判断是:真正需要改的不是"再少选几个 Key",而是 Top-K 的搜索结构本身。 如果用多层层次结构表示全局信息,那么最粗层负责全局定位,细层只在上一级命中的局部候选中继续搜索,就没有必要在每一层重新做全局两两比较。
二、方法整体框架:从单层 Top-K 变成层次搜索
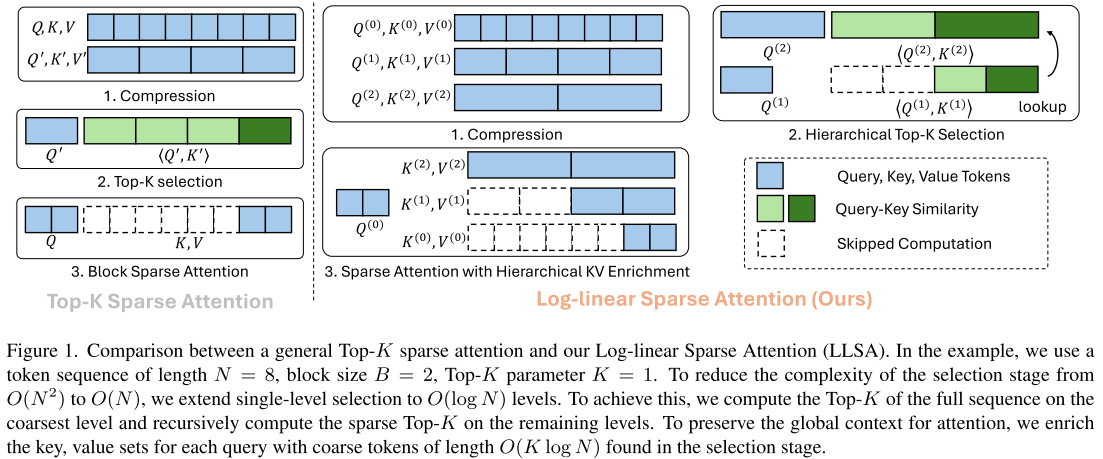
论文 Figure 1:普通 Top-K Sparse Attention 与 LLSA 的整体对比
左侧普通 Top-K 只有一次 Compression:压缩后仍要在所有粗 Token 间做全局 Top-K。右侧 LLSA 则建立多层表示,先在最粗层定位,再沿已命中的索引逐层向细粒度递归;最终 Attention 不只使用最细层 Top-K KV,还加入高层选中的粗粒度 KV。
整体流程可以概括为:
Hierarchical Compression → Coarse-to-Fine Top-K Selection → Hierarchical KV Enrichment → Sparse Attention
前两步解决"怎么把选择成本降下来",KV Enrichment 解决"稀疏以后怎么保留全局信息",稀疏索引 GPU Kernel 则保证训练阶段也不会重新引入二次开销。
三、Hierarchical Top-K:把 Selection 从 O(N²) 降到 O(NK)
LLSA 首先递归平均池化 Q、K、V。第 0 层是原始 Token,第 l 层序列长度变成 N/Bˡ,一个高层 Token 就是 B 个下一层 Token 的摘要。层数取 L ≈ log_B N,因此越往上 Token 越少、感受野越大。
搜索从最粗层开始。只有在这一层,LLSA 计算完整的 QKᵀ 并得到 Top-K;得到粗层索引后,一个命中的粗 Key 在下一层只对应 B 个子 Key,因此细一层的每个 Query 不再面对全部 Key,而只需要在大约 KB 个候选中继续做 Top-K。这个过程不断向下递归,直到得到最细层索引。
对除最粗层外的各层,选择成本可以写成:
关键就在最后一步:几何级数收敛,因此层数虽然是 O(log N),Selection Stage 并不会重新变成 O(N log N),而是保持 O(NK)。当 K 视为常数时,就是关于序列长度 N 的线性复杂度。
直观上,这和"先在地图上确定城市,再确定街区,最后找门牌号"很像。普通 Top-K 每次都在全国范围重新搜索;LLSA 则把上一级结果直接变成下一级的候选集合。
四、Hierarchical KV Enrichment:稀疏以后怎样保住全局上下文
逐层向细粒度搜索会缩小 Query 的候选范围,因此 LLSA 把搜索阶段得到的高层 KV 再利用起来:最终每个 Query Block 同时使用最细层 Top-K KV 与多个层级的粗粒度 KV。近距离信息由细 Token 表达,远距离上下文由粗 Token 提供。每层只补充 K 个左右的候选、层数为 O(log N),因此 Sparse Attention 为 O(NK log N);结合 O(NK) 的 Selection,总体是 O(NK log N),K 固定时即 O(N log N)。
粗 Token 是多个细 Token 的平均,若与单个细 Token 等权会低估其信息量,因此作者设置 KV Reweighting:第 l 层权重 W⁽ˡ⁾ = Bˡ。
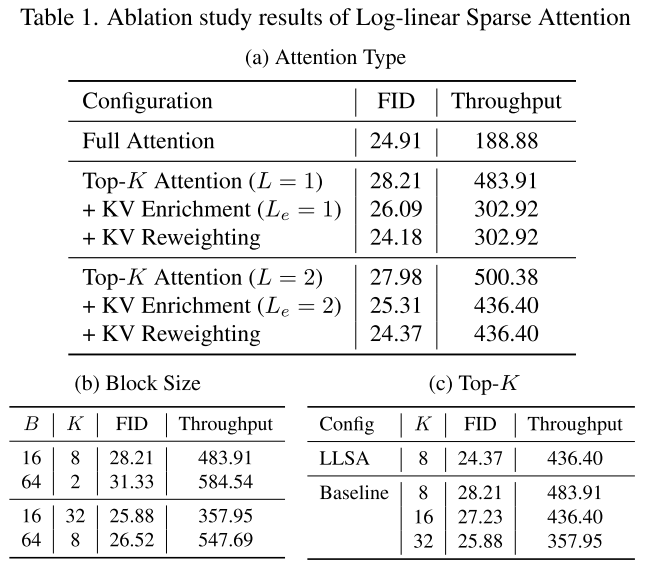
论文 Table 1:LLSA 核心模块、Block Size 与 Top-K 的消融
Table 1a 中,两层 Top-K 的 FID 为 27.98;加入 KV Enrichment 后改善到 25.31,再加 Reweighting 后达到 24.37,吞吐量仍为 436.40。这说明 Hierarchy 更偏向解决效率,而 Enrichment 与 Reweighting 负责补回稀疏化带来的质量损失。Table 1c 进一步显示,LLSA 用 K = 8 就达到 FID 24.37 / 吞吐量 436.40,而单层 Baseline 即使 K = 32 也只有 25.88 / 357.95,说明层次上下文比单纯增大 K 更有效。
4.1 反向传播也必须保持稀疏
一些 Sparse Attention 在 Forward 中只访问稀疏块,但 Backward 会构造 T × T Binary Mask,从而重新引入 O(T²)。LLSA 使用类似 CSR→CSC 的 Sparse Index Transpose:先统计每个 Key 被哪些 Query 选中,再通过 Prefix Sum 得到连续区间,直接建立 Key-major 反向索引。这样 Forward 与 KV Backward 都只围绕真实命中的稀疏索引工作。
4.2 Pixel DiT 的二维适配
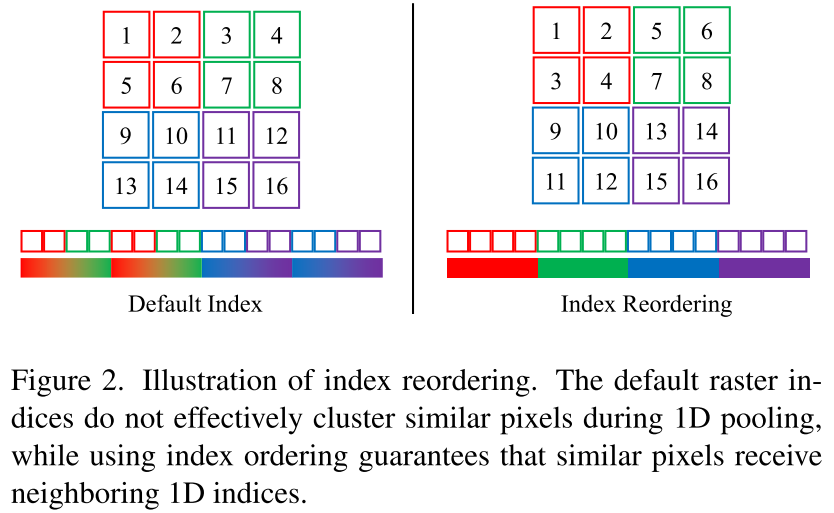
论文 Figure 2:2D Pixel Token 的 Index Reordering
Raster Order 会让层次池化把空间上不够相近的像素混在一起,因此作者先重排索引,使局部相邻像素在 1D 序列中也尽量相邻。高分辨率训练还使用 Noise Rescaling:(),对大于 64 × 64 的图像设置
;同时高分辨率模型从低分辨率 Checkpoint 初始化,以加快收敛。
五、实验结果与消融分析
5.1 实验设置
作者主要在 FFHQ 的 Pixel DiT-S 上验证不使用 VAE、且 Patch Size = 1 × 1 的长 Pixel Token 建模,并在 ImageNet-256 上把 LLSA 接入 PixelFlow-L。质量指标主要使用 10,000 个样本计算 FID;效率看 H200 上的训练吞吐量。
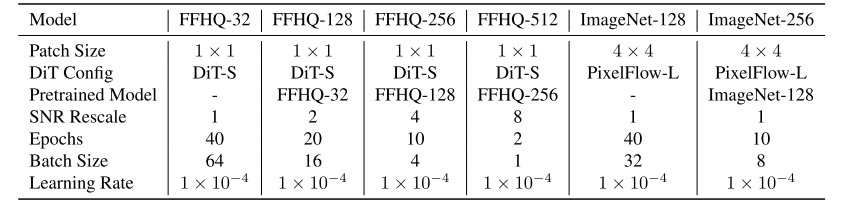
论文 Table 4:FFHQ / ImageNet 不同分辨率训练配置
Table 4 给出 Pretrained Model、SNR Rescale、Epoch、Batch Size 与 Learning Rate;FFHQ 采用 32→128→256→512 的逐级预训练策略,Learning Rate 统一为 1 × 10⁻⁴。
5.2 FFHQ 主实验
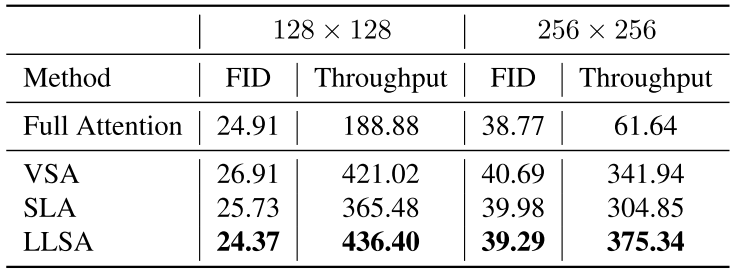
论文 Table 2:FFHQ-128 / FFHQ-256 主实验
128 × 128 上,LLSA 的 FID / 吞吐量为 24.37 / 436.40,Full Attention 为 24.91 / 188.88;VSA 和 SLA 的 FID 分别是 26.91、25.73。256 × 256 上,Full Attention 的 FID 略好,为 38.77;LLSA 为 39.29,但在稀疏方法中最好,吞吐量达到 375.34,而 Full Attention 只有 61.64,对应约 6.09× 的 DiT 训练加速。因此这里更准确的结论是:长 Pixel Token 下,LLSA 以很小的质量差距换来显著训练提速。
5.3 ImageNet-256:接入 PixelFlow 后仍然成立吗
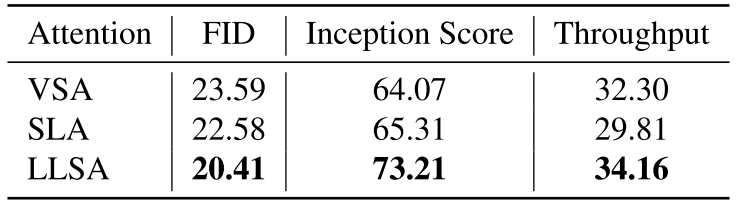
论文 Table 3:PixelFlow ImageNet-256 上 VSA / SLA / LLSA 对比
LLSA 的 FID = 20.41、Inception Score = 73.21、吞吐量 = 34.16 images/s;VSA 为 23.59 / 64.07 / 32.30,SLA 为 22.58 / 65.31 / 29.81。说明收益不只存在于 FFHQ 的轻量 Pixel DiT-S,在更复杂的 PixelFlow 设置中也能同时改善质量与吞吐量。
5.4 Kernel 效率:理论复杂度是否真的变成速度
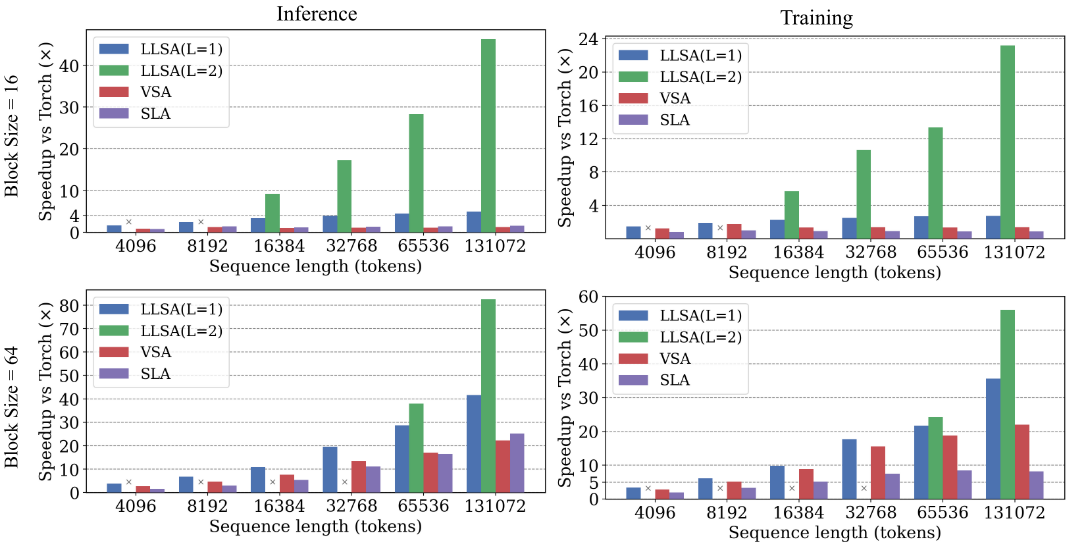
论文 Figure 3:不同 Sparse Attention 相对 FlashAttention2 的推理/训练加速比
Figure 3 在不同序列长度与 B = 16/64 下比较推理和训练速度。序列变长后,VSA/SLA 的二次 Selection 与 Mask-based Backward 越来越明显,而 LLSA 仍保持优势;论文摘要报告 256 × 256 Pixel Token 上 Attention Inference 最高加速 28.27×。
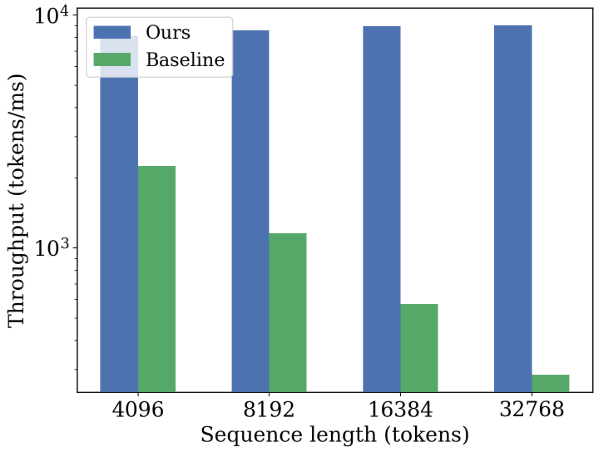
论文 Figure 4:Sparse KV Backward 吞吐量
LLSA 的 Sparse Index Transpose + CSC-style KV Backward 随序列长度增长保持近似稳定吞吐量,而 Dense Mask Baseline 持续下降,说明反向阶段隐藏的 O(N²) Mask 开销确实被去掉。
5.5 附录消融与定性结果
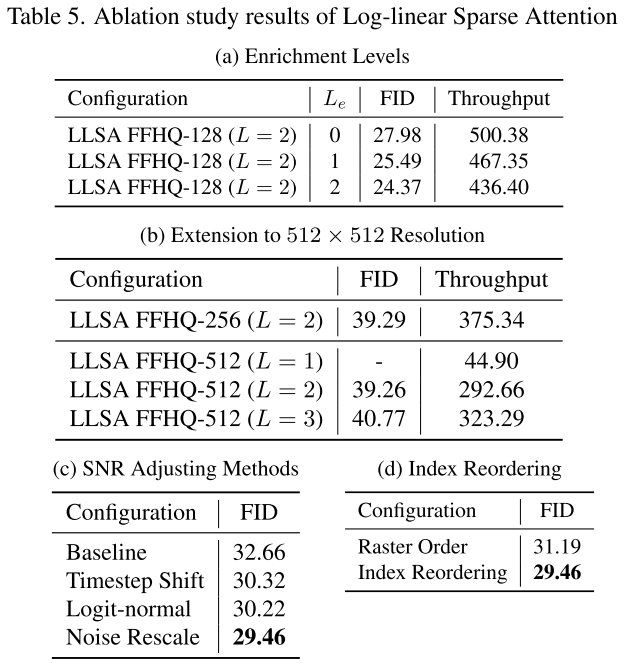
论文 Table 5:Enrichment Level、512 × 512、SNR 与 Index Reordering 消融
Enrichment Level 从 0→1→2 时,FID 从 27.98→25.49→24.37,体现了质量与有效 KV 数量之间的折中。512 × 512 上,两层 LLSA 为 FID 39.26 / 吞吐量 292.66,三层吞吐量进一步到 323.29;单层版本受二次 Selection 限制。Noise Rescale 的 FID 最好为 29.46,Index Reordering 也把 FID 从 31.19 改善到 29.46。
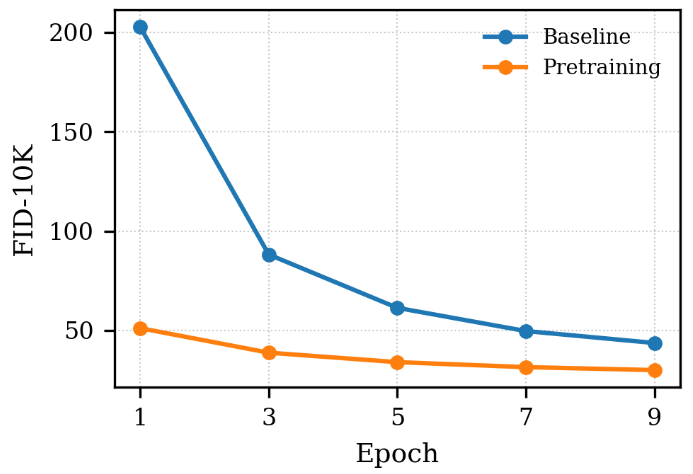
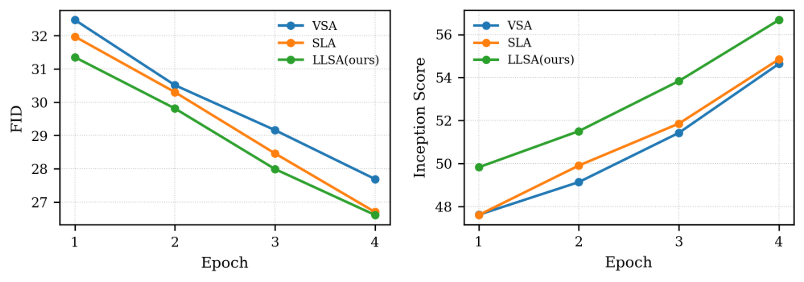
论文 Figure 5--6:低分辨率预训练与 ImageNet 训练曲线
Figure 5 说明低分辨率预训练显著加快高分辨率收敛;Figure 6 显示 ImageNet-256 前 4 个 Epoch 中,LLSA 的训练曲线整体优于 VSA/SLA。
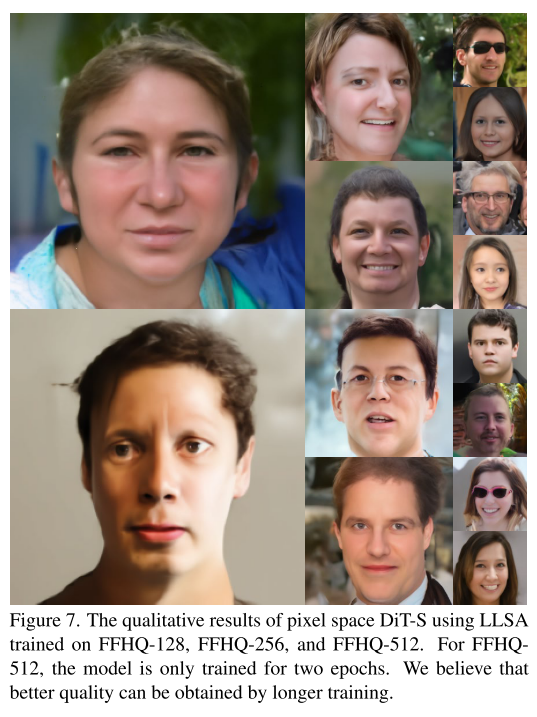
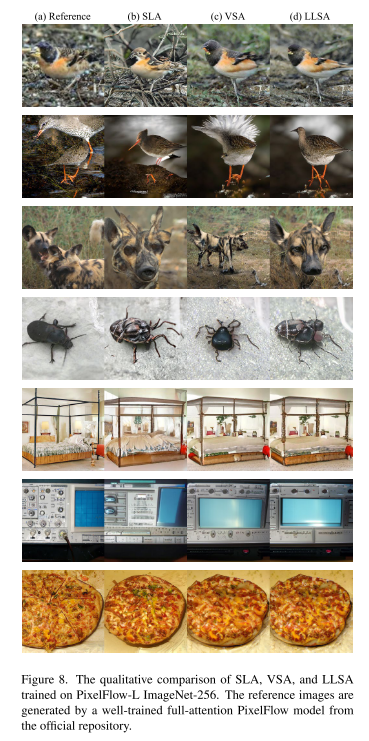
论文 Figure 7--8:FFHQ 多分辨率生成结果与 ImageNet 定性对比
Figure 7 展示 FFHQ-128/256/512 样例,其中 512 模型仅训练 2 个 Epoch;Figure 8 则对比 SLA、VSA、LLSA 的 ImageNet-256 样例,与定量结果形成补充证据。
六、总结与思考
如果把这篇论文压缩成一句话:LLSA 把"从所有 Key 中一次性挑 K 个"改造成多尺度、由粗到细的搜索,再把搜索过程中产生的粗粒度 KV 变成全局上下文。
最值得记住的是三个环节:Hierarchical Top-K 把 Selection 降到 O(NK);KV Enrichment + Reweighting 让小 K 仍能保留长距离信息,使整体 Attention 成为 O(NK log N);Sparse Index Transpose 则把同样的稀疏性贯彻到 Backward。
从实验范围看,论文最充分的证据仍集中在 FFHQ 与 ImageNet 图像生成,512 × 512 也只进行了较短训练。长视频是重要应用动机,但本文没有直接给出对应训练实验,因此其在更长视频序列上的实际收益仍需进一步验证。