在讲完列表和元组以后,我们已经可以按照位置保存和读取一组数据了。不过,有些数据更适合通过名称查找。例如,一个用户有姓名、年龄和城市,如果使用列表保存,读取年龄时还要记住它在索引 1;使用字典以后,可以直接通过 "age" 找到对应的值。
思维导图
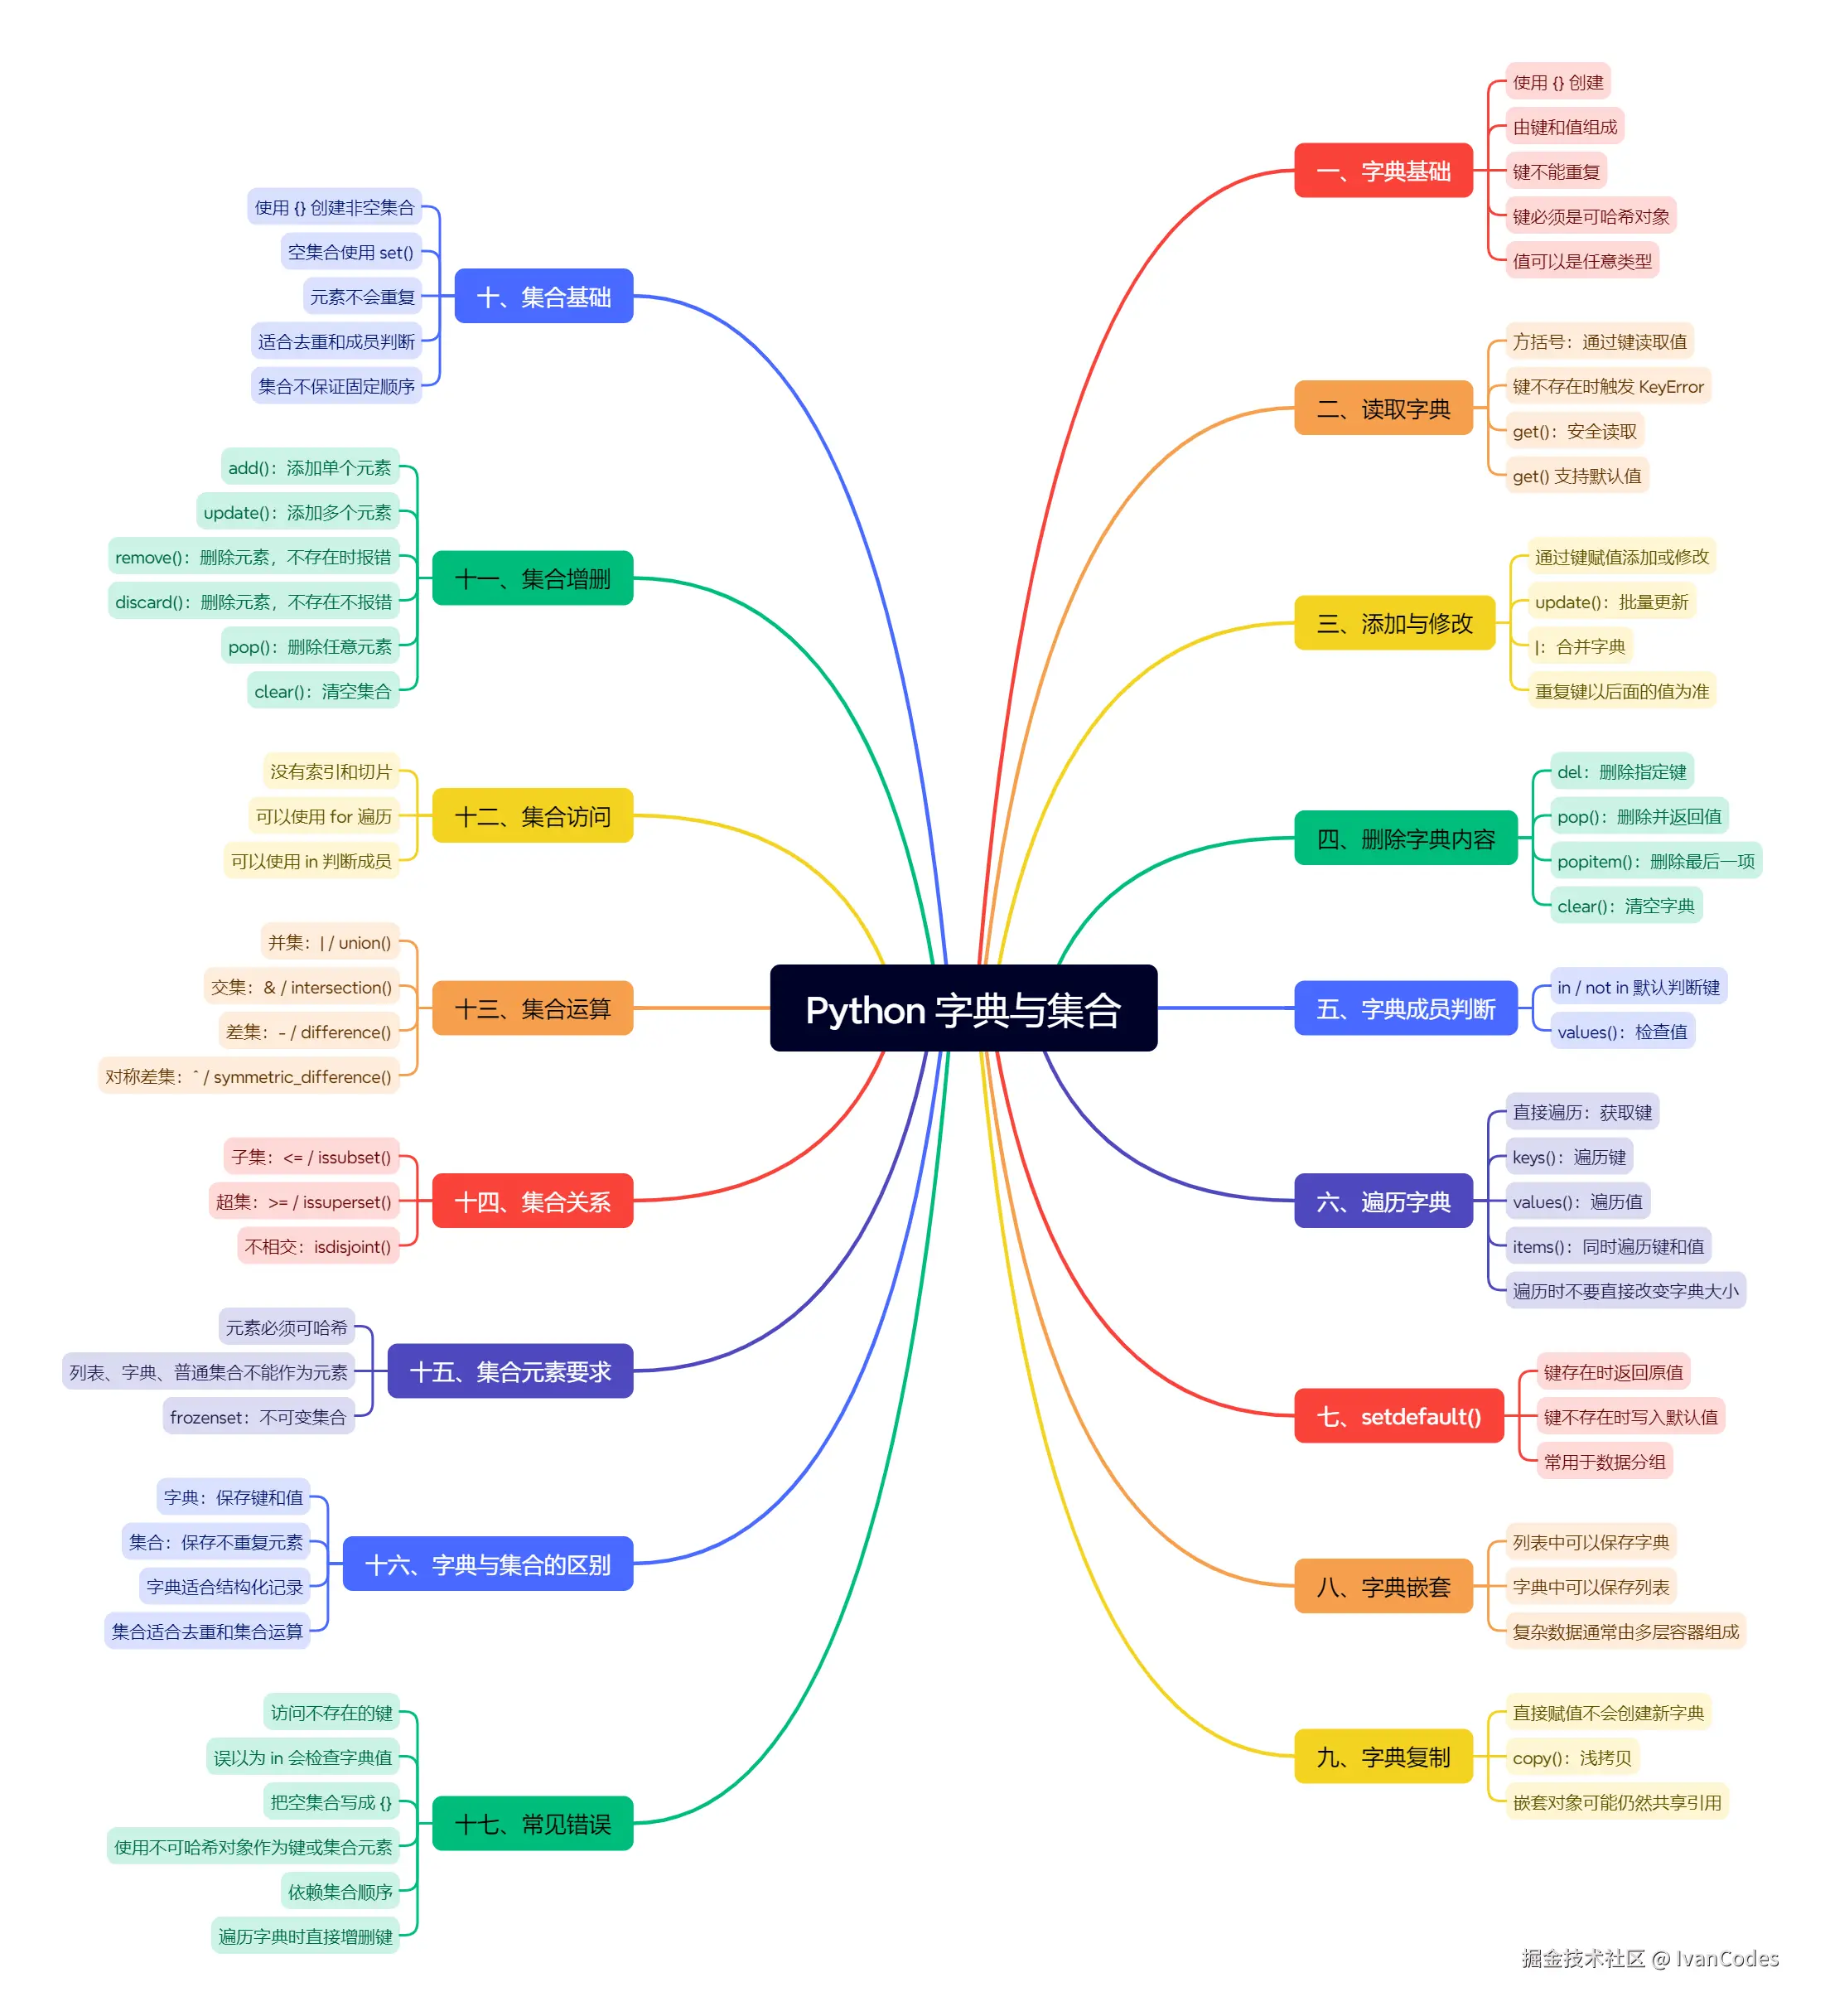
集合解决的是另一类问题。它只保存不重复的元素,很适合用来去重、判断成员是否存在,以及计算两组数据的交集和并集。这一章先讲字典,再讲集合,最后把两种结构放进同一个例子中使用。
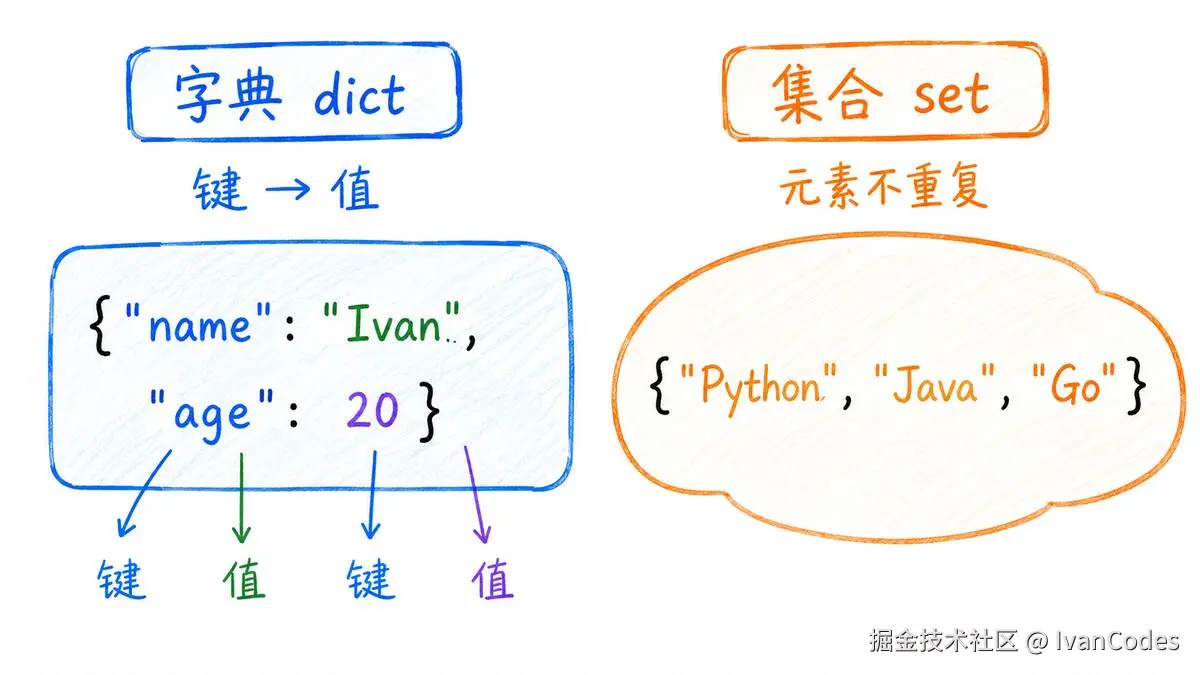
一、创建字典
字典使用花括号 {} 创建,每一项都由键和值组成,键和值之间使用冒号分隔:
python
user = {
    "name": "Ivan",
    "age": 20,
    "city": "杭州",
}
这里的 "name"、"age" 和 "city" 是键,右侧的 "Ivan"、20 和 "杭州" 是对应的值。
空字典可以写成:
python
user = {}也可以使用 dict():
python
user = dict()当键是普通字符串时,dict() 还支持下面这种写法:
python
user = dict(name="Ivan", age=20, city="杭州")这种写法中的键不需要加引号,不过键必须是合法的参数名称。带空格、短横线或者其他特殊字符的键,仍然应该使用字典字面量。
len() 可以取得字典中键值对的数量:
python
print(len(user))结果为 3。
二、键和值分别有什么要求
字典通过键找到值,可以把它理解成一张对应表:
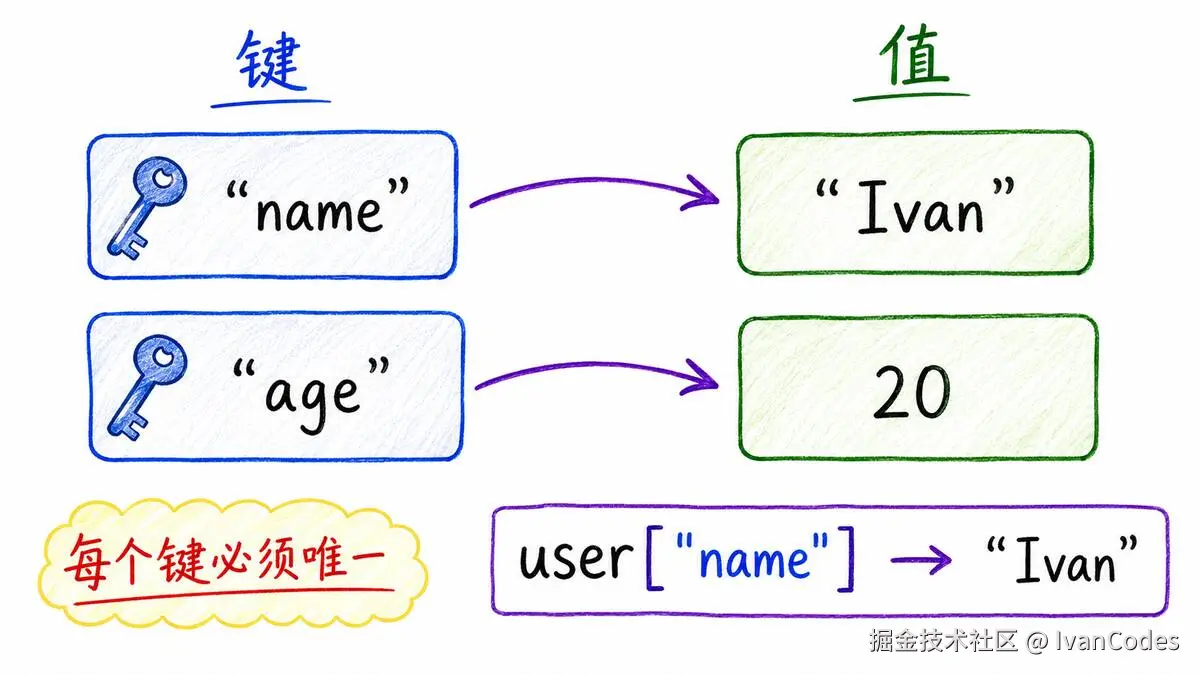
一个字典中的键不能重复。相同的键写了多次,后面的值会覆盖前面的值:
python
user = {
    "name": "Ivan",
    "name": "Tom",
}

print(user)
输出结果为:
arduino
{'name': 'Tom'}键必须是可哈希的对象。字符串、整数、浮点数和只包含不可变对象的元组都可以作为键,列表、字典和集合不能作为键:
python
data = {
    "name": "Ivan",
    1001: "用户编号",
    (120, 30): "坐标",
}
下面的写法会出现 TypeError:
python
data = {
    [1, 2]: "列表不能作为键",
}
值没有这个限制。列表、字典、集合,甚至后面会学到的函数和对象,都可以作为字典的值。
三、读取字典中的值
确定键存在时,可以使用方括号读取:
python
user = {
    "name": "Ivan",
    "age": 20,
}

print(user["name"])
print(user["age"])
输出结果为:
Ivan
20
如果键不存在,方括号会引发 KeyError:
python
print(user["phone"])不确定键是否存在时,可以使用 get():
python
print(user.get("phone"))键不存在时,get() 默认返回 None。也可以传入一个默认值:
python
print(user.get("phone", "未填写"))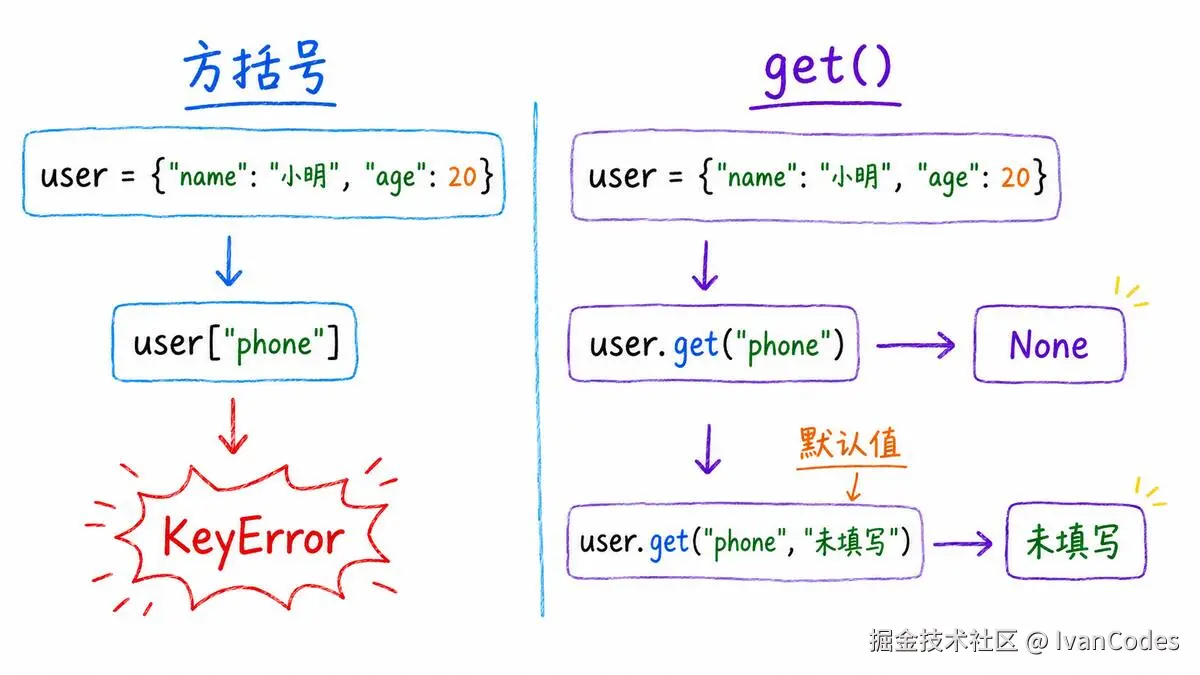
方括号和 get() 没有谁一定更好。程序认为这个键必须存在时,使用方括号可以让数据问题尽快暴露;缺少这个键属于正常情况时,使用 get() 会更方便。
四、添加和修改键值对
给一个不存在的键赋值,会在字典中添加新的键值对:
python
user = {
    "name": "Ivan",
    "age": 20,
}

user["city"] = "杭州"
print(user)
给已经存在的键赋值,会修改原来的值:
python
user["age"] = 21
print(user)
这两种操作使用同一种语法,区别只在于键原来是否存在。
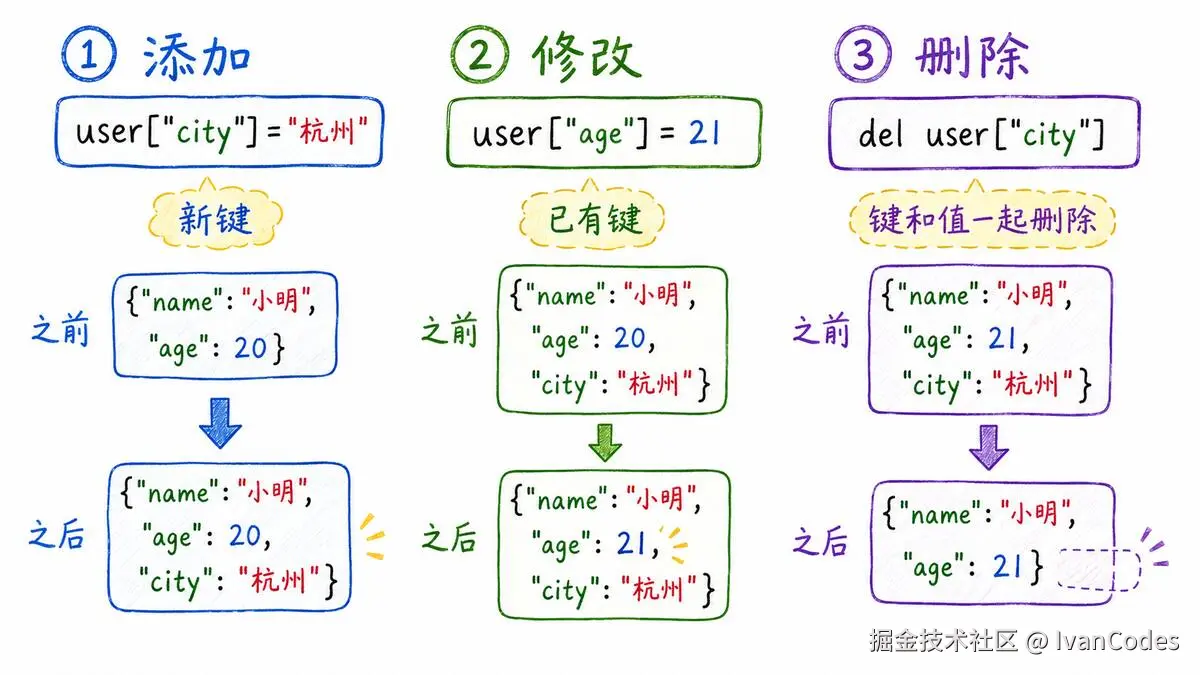
需要一次更新多项内容时,可以使用 update():
python
user.update({
    "age": 22,
    "email": "ivan@example.com",
})
传入的键已经存在时会更新,不存在时会添加。
Python 3.9 以后还可以使用 | 合并两个字典:
python
base = {"name": "Ivan", "age": 20}
extra = {"age": 21, "city": "杭州"}

result = base | extra
print(result)
输出结果为:
arduino
{'name': 'Ivan', 'age': 21, 'city': '杭州'}两个字典出现相同的键时,右侧字典的值会覆盖左侧字典。
五、删除字典中的内容
1. 使用 del 删除指定键
python
user = {
    "name": "Ivan",
    "age": 20,
    "city": "杭州",
}

del user["city"]键不存在时,del 会引发 KeyError。
2. 使用 pop() 删除并返回值
python
age = user.pop("age")

print(age)
print(user)
可以为 pop() 指定默认值,这样键不存在时不会报错:
python
phone = user.pop("phone", None)3. 使用 popitem() 删除最后一项
python
item = user.popitem()
print(item)
Python 3.7 以后,普通字典会保留插入顺序,所以 popitem() 删除最后插入的一项,并把键和值组成的元组返回。空字典调用 popitem() 会出现 KeyError。
4. 使用 clear() 清空字典
python
user.clear()
print(user)
结果为 {}。
六、判断键是否存在
in 和 not in 默认判断的是键,不是值:
python
user = {
    "name": "Ivan",
    "age": 20,
}

print("name" in user)
print("Ivan" in user)
输出结果为:
python
True
False
如果确实需要判断某个值是否存在,可以在 values() 中查找:
python
print("Ivan" in user.values())不过,字典主要针对键进行快速查找。如果程序经常根据值反向查找,可能需要重新考虑数据结构。
七、遍历字典
直接遍历字典时,每次取得的是键:
python
user = {
    "name": "Ivan",
    "age": 20,
    "city": "杭州",
}

for key in user:
    print(key)
这与遍历 user.keys() 的结果相同:
python
for key in user.keys():
    print(key)
只需要值时,使用 values():
python
for value in user.values():
    print(value)
同时需要键和值时,使用 items():
python
for key, value in user.items():
    print(key, value)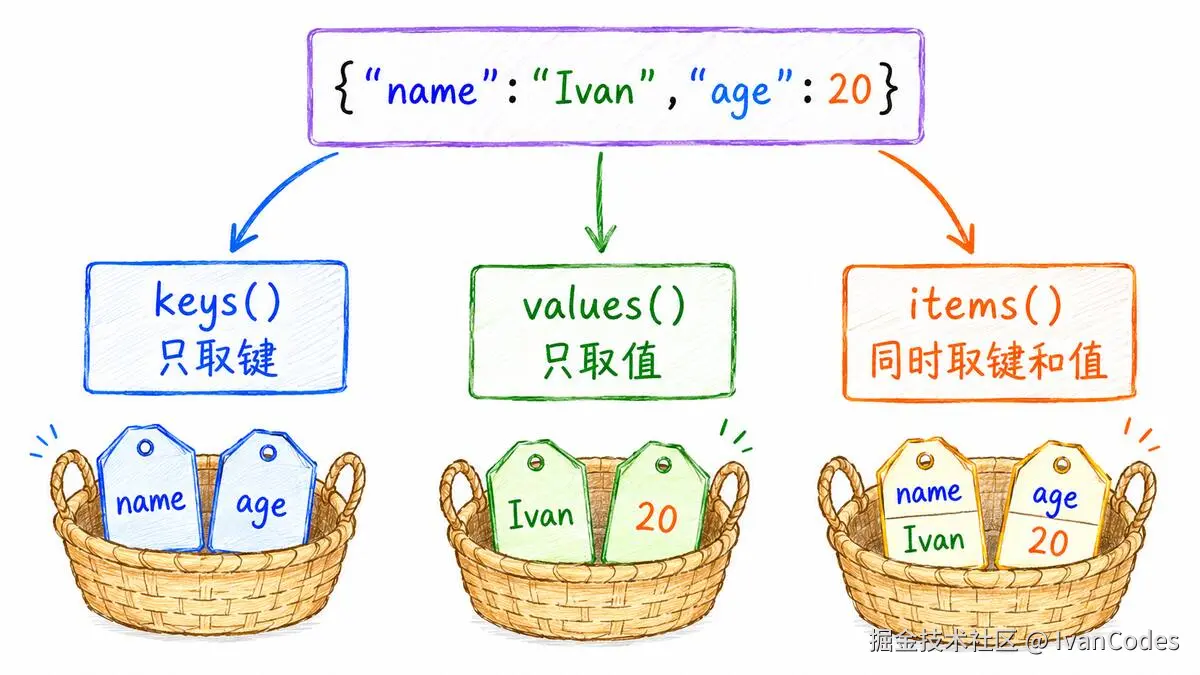
keys()、values() 和 items() 返回的不是普通列表,而是字典视图。字典发生变化以后,视图看到的内容也会跟着变化:
python
user = {"name": "Ivan"}
keys = user.keys()

user["age"] = 20
print(keys)
输出结果中会同时出现 name 和 age。确实需要一份独立列表时,可以写成 list(user.keys())。
遍历字典时不要直接改变字典的大小:
python
scores = {"张三": 86, "李四": 45, "王五": 72}

# 不建议这样写
for name, score in scores.items():
    if score < 60:
        del scores[name]
这会引发 RuntimeError。可以先把需要删除的键保存下来,再完成删除:
python
failed_names = []

for name, score in scores.items():
    if score < 60:
        failed_names.append(name)

for name in failed_names:
    del scores[name]
下一章会讲字典推导式,到时候还可以直接生成一个新的字典。
八、setdefault() 的使用
setdefault() 会先查找键。键存在时返回原来的值,键不存在时写入默认值并返回:
python
user = {"name": "Ivan"}

city = user.setdefault("city", "未知")

print(city)
print(user)
它经常用来把数据分组。例如,把多个单词按照首字母放进不同列表:
python
words = ["apple", "ant", "banana", "book"]
groups = {}

for word in words:
    first_letter = word[0]
    groups.setdefault(first_letter, []).append(word)

print(groups)
输出结果为:
less
{'a': ['apple', 'ant'], 'b': ['banana', 'book']}这一行稍微有点长。拆开看,就是先确保当前字母对应一个列表,再向这个列表中添加单词。
九、字典与列表的嵌套
字典和值都可以保存其他容器,所以实际数据经常是多层结构。
列表中可以放多个字典:
python
students = [
    {"name": "张三", "score": 86},
    {"name": "李四", "score": 95},
]

print(students[0]["name"])
字典中也可以放列表:
python
user = {
    "name": "Ivan",
    "skills": ["Python", "Java", "Go"],
}

print(user["skills"][0])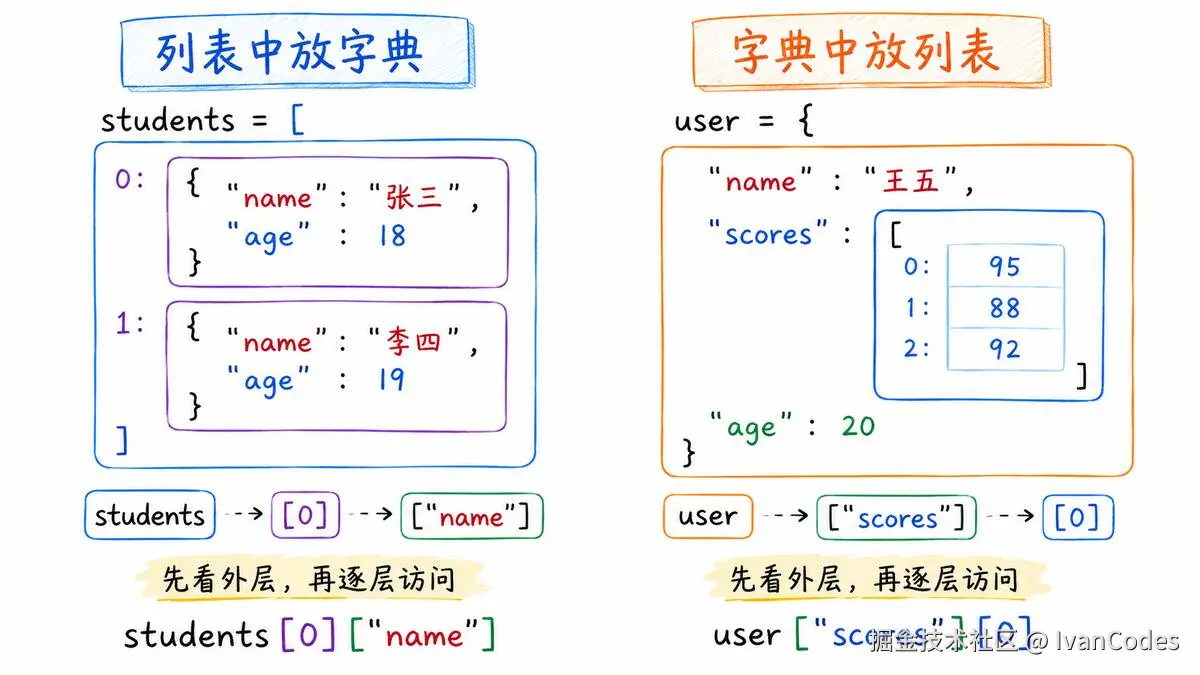
读取嵌套数据时,可以先确认最外层是什么类型,再逐层访问。students[0]["name"] 先从列表中取得第一个字典,再从字典中读取 name。
十、字典的复制
字典和列表一样是可变对象。直接赋值不会创建新的字典:
python
a = {"name": "Ivan"}
b = a

b["age"] = 20

print(a)
print(b)
两个变量会看到同样的修改。需要复制外层字典时,可以使用 copy():
python
b = a.copy()copy() 仍然是浅拷贝。字典中包含列表或者其他字典时,内层对象可能继续被共同引用。这个问题会在后面的对象与内存章节中详细讲。
十一、创建集合
集合使用花括号创建,元素之间使用逗号分隔:
python
skills = {"Python", "Java", "Go"}
numbers = {1, 2, 3}
集合中的元素不会重复:
python
numbers = {1, 2, 2, 3, 3}
print(numbers)
输出结果只包含 1、2 和 3。
需要特别注意,空集合不能写成 {},因为 {} 表示空字典:
python
empty_dict = {}
empty_set = set()

print(type(empty_dict))
print(type(empty_set))
set() 也可以把其他可迭代对象转换成集合:
python
numbers = set([1, 2, 2, 3, 3])
letters = set("hello")

print(numbers)
print(letters)
集合经常用来去重:
python
numbers = [1, 2, 2, 3, 3]
unique_numbers = list(set(numbers))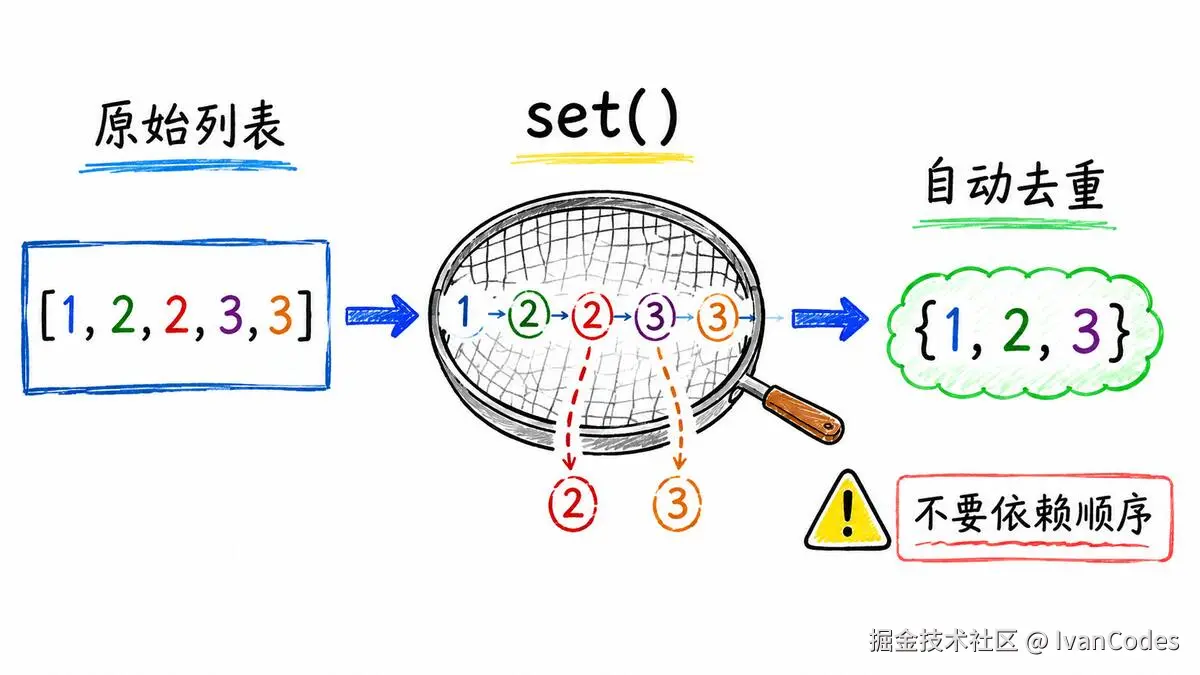
转换成集合以后,原来的顺序不应该再被依赖。如果去重后仍然需要保留首次出现的顺序,可以利用字典键不重复并且保留插入顺序的特点:
python
numbers = [3, 1, 3, 2, 1]
unique_numbers = list(dict.fromkeys(numbers))

print(unique_numbers)
输出结果为 [3, 1, 2]。
十二、向集合中添加元素
add() 每次添加一个元素:
python
skills = {"Python", "Java"}
skills.add("Go")

print(skills)
添加已经存在的元素不会报错,集合内容也不会变化。
update() 可以一次加入多个元素:
python
skills.update(["Go", "Rust"])update() 会遍历传入的对象。传入字符串时,会逐个加入字符:
python
letters = set()
letters.update("ABC")
如果希望把一个完整字符串作为元素,应该使用 add("ABC")。
十三、删除集合中的元素
remove() 删除指定元素,元素不存在时会出现 KeyError:
python
skills.remove("Java")discard() 也删除指定元素,不过元素不存在时不会报错:
python
skills.discard("C++")pop() 会删除并返回任意一个元素:
python
skill = skills.pop()
print(skill)
集合没有"最后一个元素"的概念,所以不要使用 pop() 期待取得某个固定位置的值。空集合调用 pop() 会出现 KeyError。
clear() 可以清空集合:
python
skills.clear()十四、集合没有索引和切片
集合不是按位置访问的数据结构,因此不能使用索引和切片:
python
skills = {"Python", "Java", "Go"}

# TypeError
print(skills[0])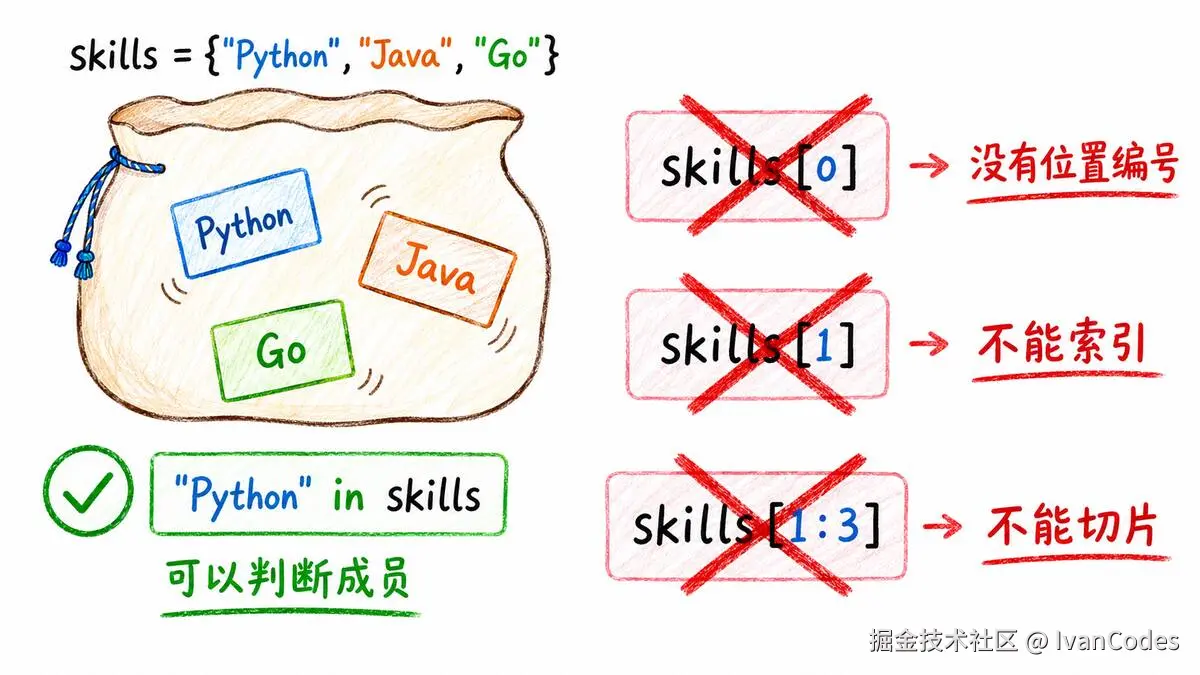
集合可以遍历,也可以使用 in 判断成员:
python
for skill in skills:
    print(skill)

print("Python" in skills)
不过,遍历集合时不应该依赖固定顺序。需要按照位置读取或者保持顺序时,应该使用列表或元组。
十五、集合运算
集合最有用的地方不只是去重,还可以直接计算两组数据之间的关系。
python
backend = {"Python", "Java", "Go"}
data = {"Python", "SQL", "R"}
1. 并集
并集包含两个集合中的全部元素:
python
print(backend | data)
print(backend.union(data))
2. 交集
交集只保留两个集合共同拥有的元素:
python
print(backend & data)
print(backend.intersection(data))
结果为 {'Python'}。
3. 差集
差集保留左侧集合中存在、右侧集合中不存在的元素:
python
print(backend - data)
print(backend.difference(data))
backend - data 与 data - backend 的结果通常不同,左右顺序不能随便交换。
4. 对称差集
对称差集保留只出现在其中一个集合中的元素,把共同元素排除:
python
print(backend ^ data)
print(backend.symmetric_difference(data))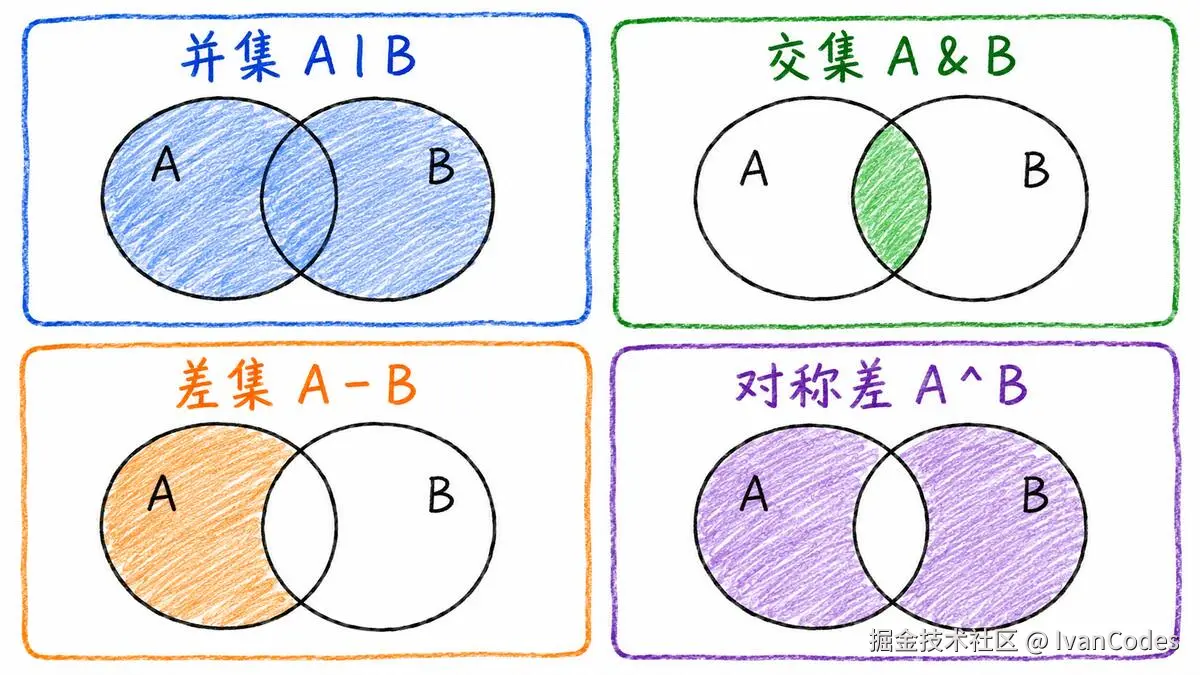
十六、子集、超集和不相交
如果集合 a 中的所有元素都包含在集合 b 中,那么 a 是 b 的子集:
python
python_skills = {"Python", "SQL"}
required_skills = {"Python", "SQL", "Git"}

print(python_skills <= required_skills)
print(python_skills.issubset(required_skills))
判断超集可以使用 >= 或 issuperset():
python
print(required_skills >= python_skills)判断两个集合是否没有任何共同元素,可以使用 isdisjoint():
python
frontend = {"JavaScript", "CSS"}
database = {"SQL", "Redis"}

print(frontend.isdisjoint(database))
结果为 True。
十七、集合中的元素有什么要求
集合元素与字典的键一样,必须是可哈希的对象。字符串、数字和只包含不可变对象的元组可以放进集合:
python
items = {"Python", 20, (10, 20)}列表、字典和普通集合不能作为集合元素:
python
# TypeError
items = {[1, 2], [3, 4]}
如果确实需要一个不可变集合,可以使用 frozenset():
python
permissions = frozenset({"read", "write"})frozenset 不能使用 add()、remove() 和 update() 修改,所以它可以作为字典的键,也可以放进另一个集合中。基础阶段不常用,但是遇到"集合中还要保存集合"时会用到。
十八、字典和集合怎么选
字典和集合都使用花括号,也都适合快速判断某个内容是否存在,不过它们保存的信息不同。
| 对比项 | 字典 dict |
集合 set |
|---|---|---|
| 保存内容 | 键和值 | 不重复的元素 |
| 基本写法 | {"name": "Ivan"} |
{"Python", "Java"} |
| 主要访问方式 | 通过键读取值 | 判断成员是否存在 |
| 常见用途 | 用户信息、配置、结构化记录 | 去重、标签、权限和集合运算 |
需要给每个名称保存对应信息时使用字典,只关心一组不重复的成员时使用集合。列表和元组按照位置组织数据,字典按照键组织数据,集合则不强调位置和对应值。
十九、综合示例:统计成员技能
下面使用字典保存成员和技能,再使用集合统计所有技能、共同技能,以及掌握 Python 的成员:
python
members = {
    "张三": {"Python", "SQL", "Git"},
    "李四": {"Python", "Java", "Git"},
    "王五": {"Python", "SQL", "Docker"},
}

all_skills = set()
common_skills = None
python_members = []

for name, skills in members.items():
    all_skills.update(skills)

    if common_skills is None:
        common_skills = skills.copy()
    else:
        common_skills &= skills

    if "Python" in skills:
        python_members.append(name)

print("全部技能:", all_skills)
print("共同技能:", common_skills)
print("掌握 Python 的成员:", python_members)
members 是字典,因为每个姓名都要对应一组技能。每组技能使用集合,是因为技能不能重复,而且后面还要计算交集和并集。
第一次循环时,common_skills 还没有内容,所以先复制第一个成员的技能。后续每次循环都执行交集运算,最后留下所有成员共同拥有的技能。
集合本身没有固定输出顺序,因此"全部技能"的显示顺序可能和示例不同,这不影响集合中的实际内容。
二十、常见错误
1. 使用不存在的键
python
print(user["phone"])键不一定存在时,可以先使用 in 判断,或者使用 get()。
2. 误以为 in 会检查字典的值
python
print("Ivan" in user)这行代码检查的是有没有名为 "Ivan" 的键。检查值需要写成 "Ivan" in user.values()。
3. 把空集合写成 {}
python
items = {}这会创建空字典。空集合应该写成 set()。
4. 把列表作为字典键或集合元素
python
data = {[1, 2]: "value"}
items = {[1, 2]}
列表是可变对象,不能放在这些位置。根据数据含义,可以改成元组 (1, 2)。
5. 依赖集合的遍历顺序
集合适合判断成员和完成集合运算,不适合按位置保存数据。顺序重要时应该使用列表。
6. 遍历字典时直接增删键
字典大小发生变化会影响正在进行的遍历。需要删除内容时,可以先记录要删除的键,或者创建一个新字典。
二十一、练习
练习一:保存商品信息
使用字典保存商品名称、价格和库存,分别完成读取价格、修改库存以及添加分类字段。
练习二:统计字符出现次数
接收一段字符串,使用字典统计每个字符出现了多少次。可以先不处理空格和标点。
练习三:通讯录查询
使用字典保存姓名和电话号码。用户输入姓名以后,输出对应号码;姓名不存在时输出"没有找到"。
练习四:列表去重
把 [3, 1, 3, 2, 1, 4] 中的重复数字去掉。分别尝试不保留顺序和保留首次出现顺序的写法。
练习五:共同课程
创建两个集合,分别保存两名学生选择的课程,输出两人共同选择的课程、只由第一名学生选择的课程,以及两人选择过的全部课程。
这一章讲完了字典和集合。字典通过键保存对应的值,集合用来保存不重复的元素,并且可以直接计算交集、并集和差集。下一章继续讲列表、字典和集合推导式,以及几种常见的遍历写法。