25年10月来自Dexmal 和Hugging Face的论文"RoboChallenge: Large-scale Real-robot Evaluation of Embodied Policies"。
概要
RoboChallenge 提出一套面向VLA(视觉-语言-动作)模型的大规模真实机器人在线评测系统,核心贡献分两部分:
评测基础设施:提供10台在线托管的真实机器人(UR5、Franka Panda、Cobot Magic Aloha、ARX-5),用户无需提交模型权重或Docker镜像,而是通过"远程机器人(remote robot)"范式------用户在自己的机器上跑推理,通过异步API(带精确时间戳的观测请求+FIFO动作队列)远程操控机器人。这解决了模型提交评测中的环境不一致、NAT穿透、灵活性受限等问题。
Table30基准与评测协议:围绕桌面场景设计了30个多样化任务(精确3D定位、遮挡/多视角、时序依赖、长程多阶段、物体分类、双臂协作、软体操作等)。为解决真实机器人测试中结果方差巨大的问题,提出"Visual Task Reproduction(视觉任务复现)"协议------通过将参考帧叠加到实时相机画面上,指导测试员摆放物体以复现初始状态,从而比"经验测试员/无经验测试员/自适应测试员"更稳定可控。同时设计了比二元成功率更精细的"进度分数(progress score)"分级评分体系。
初步实验:测试了π0、π0.5、CogACT、OpenVLA/OFT等模型的task-specific与generalist两种设置,发现π0.5全面领先;时序依赖、软体操作、精确3D定位是当前VLA的主要弱点;而分类、双臂协作、重复动作等因素对成功率影响不大。
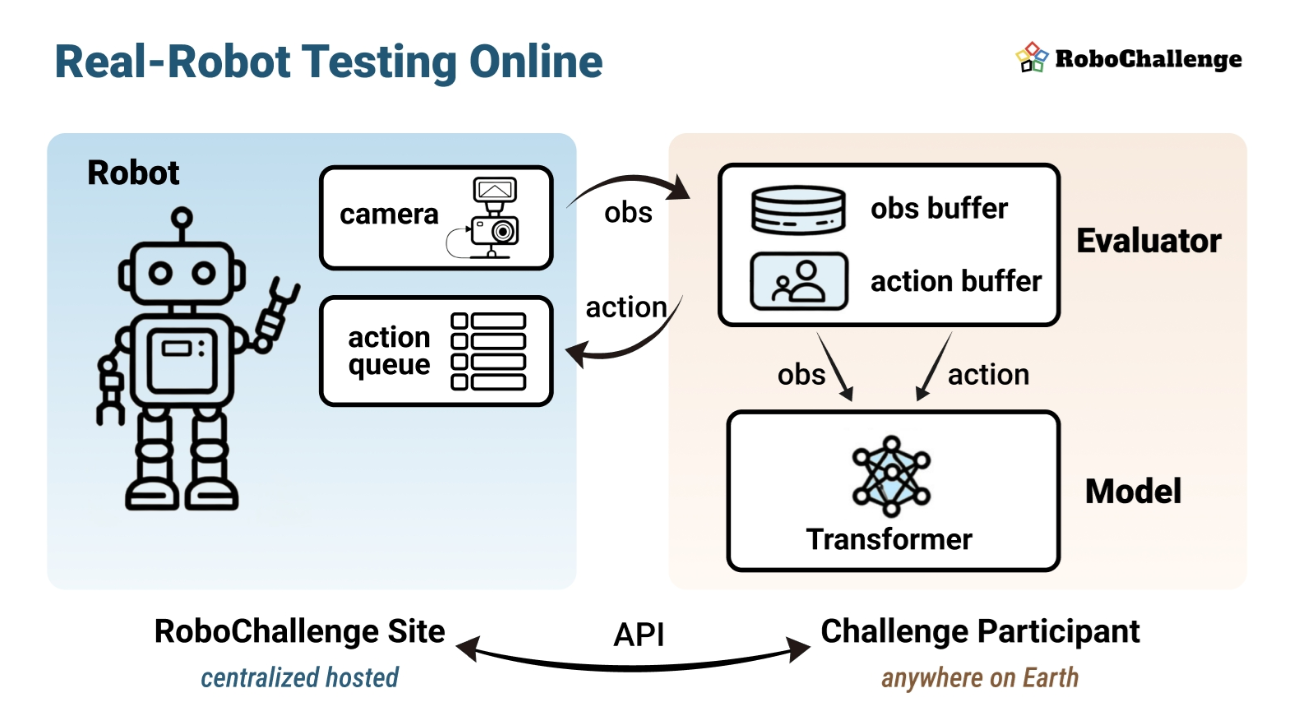
如图 1 所示,以在线方式部署机器人。其制定一套底层 API,用于提供观测数据的精确时间戳及动作队列的状态,从而实现精细化控制。此过程中无需交换 Docker 镜像或模型检查点。
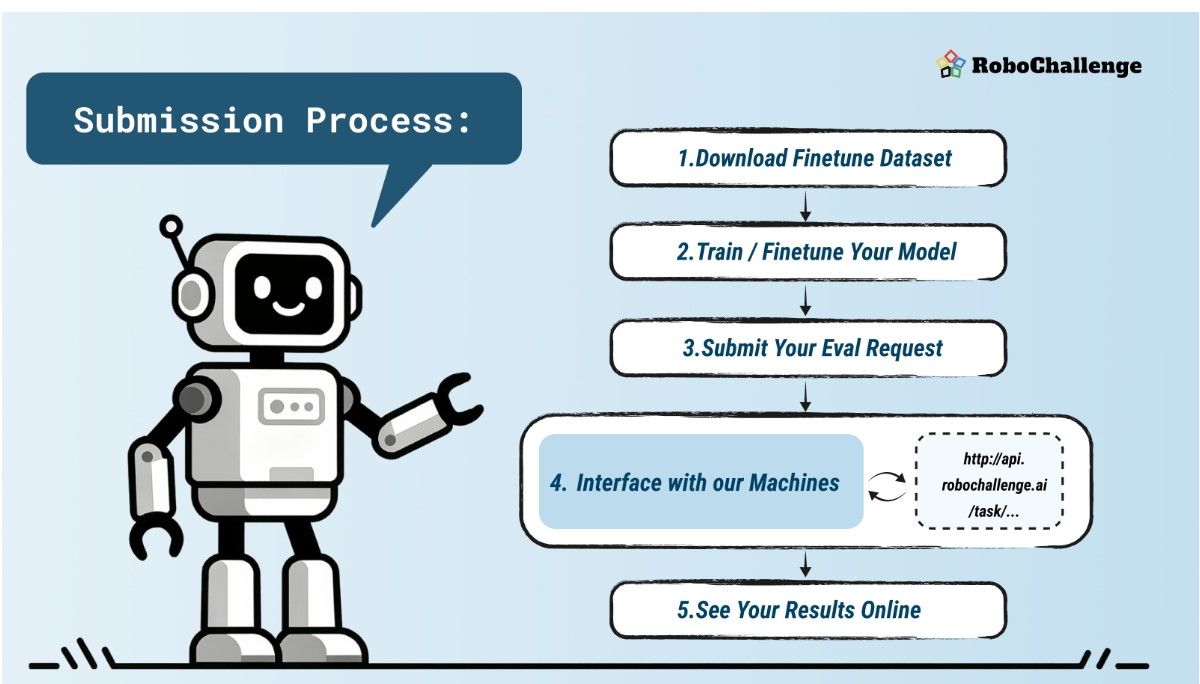
如图 10 所示参与者的预期工作流程:
论文指出的问题(Problems / Limitations)
作者在文中已经比较坦诚地列出了自身局限:
无法验证用户实际运行的模型:由于推理在用户端进行,系统无法确认用户提交的模型是否与其声称的一致,甚至存在"人在环"作弊的可能,目前只能依赖用户自律和开源验证。
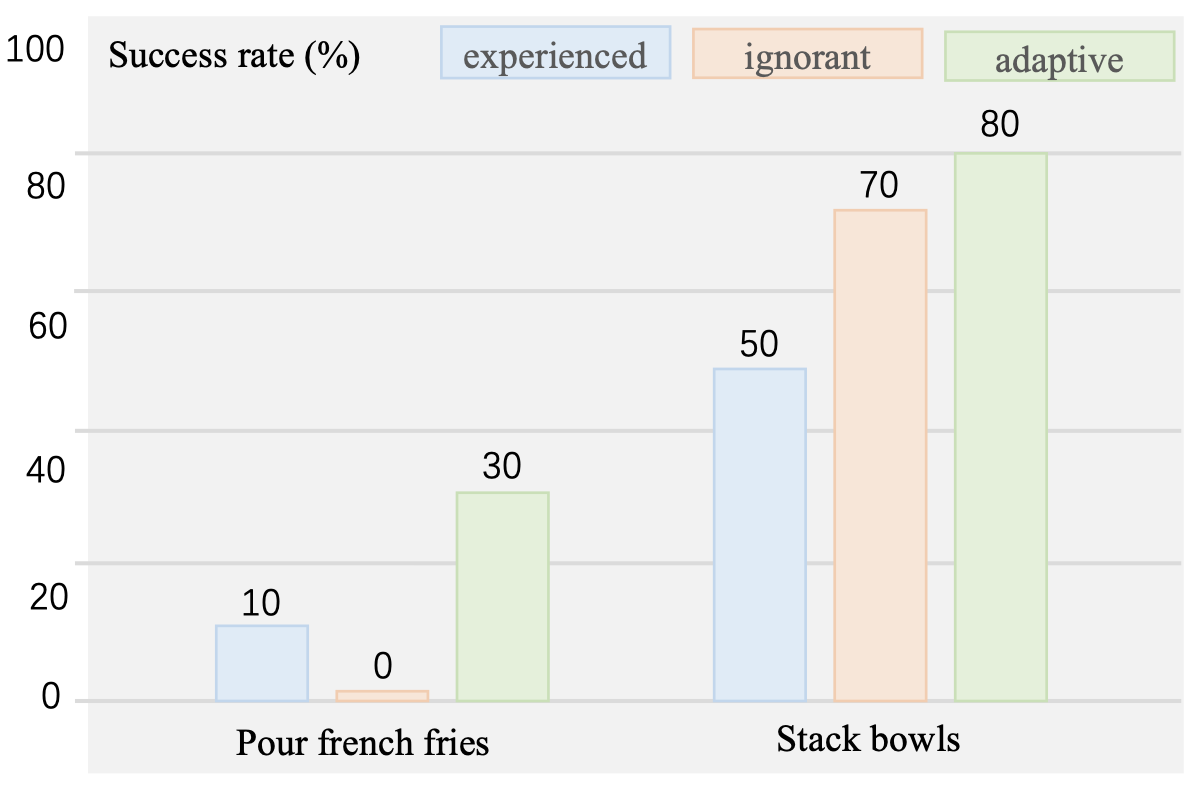
测试员引入的方差("Sweet-spot Effect"):即使用视觉复现协议,人为摆放物体仍会引入偏差,不同测试员(有经验/无经验/自适应)得到的成功率差异巨大(图3、图4展示的案例),这是真实机器人评测的根本性难题,并未完全解决。
稳定性(Stability)与公平性(Fairness)的权衡:论文承认"理想的稳定性隐含公平性,但现实中无法达到",目前只实现了关注稳定性的"benchmark protocol",公平性优先的"comparative protocol"(盲测对比)仍停留在设想阶段,未真正部署。
潜在的过拟合风险:由于测试用例的初始状态是固定复现的(基于参考episode),存在模型"过拟合到参考测试案例"的可能,论文只是说"实践中未观察到",缺乏严格量化分析。
环境因素不可控:光照、相机外参漂移等因素未被控制,只是用"VLA足够鲁棒"的一个小型验证实验(图6)来辩护,证据较为单薄(仅做了图像层面的人工扰动测试,样本量、任务多样性有限)。
任务/评测规模仍然有限:目前只有30个任务、10台机器、5种方法参与测试,样本量偏小,尚不足以支撑强的统计结论(例如很多任务的成功率是基于仅10次rollout计算的)。
硬件覆盖窄:仅覆盖4种机型(单臂UR5/Franka、双臂Aloha、单臂ARX-5),均为固定桌面场景,不包含移动底盘、灵巧手、复杂柔性抓取器等,泛化性存疑。
缺乏长时程/开放世界任务:30个任务虽覆盖多种"算法挑战",但仍属短时程、结构化桌面任务,未触及真正开放世界、长程规划、多任务组合等更具挑战性的场景。
如图3所示由测试器引起的成功率变化。选取两个任务,并安排三类不同的测试器进行尝试:(1) 经验丰富的测试器:即负责采集训练数据的同一测试器;(2) 无预先了解的测试器:完全陌生的测试器,首次接触提示语(prompt)和道具;(3) 适应性测试器:具备算法相关经验的测试器,设法尽可能提高成功率。
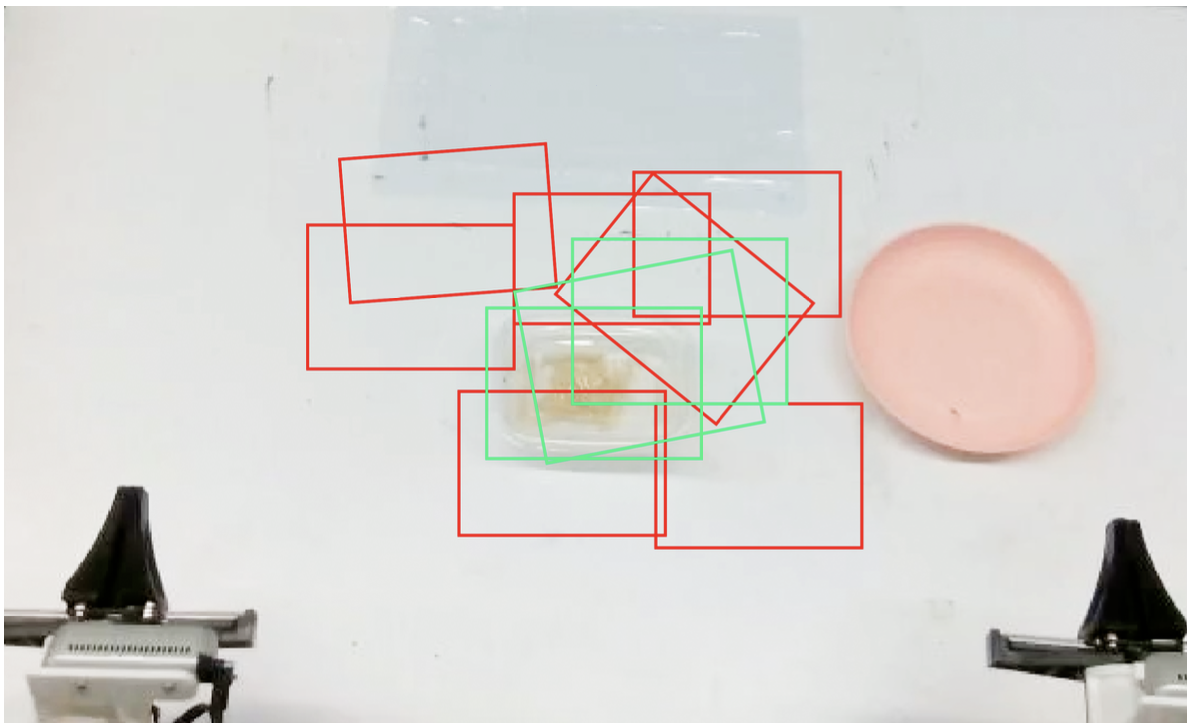
如图4所示"最佳点效应"(Sweet-spot Effect)。图中绘制由"自适应测试器"选定的方框位置,并用绿色和红色分别标示任务成功或失败的情况。该测试器成功找到任务更易成功的方框位置与朝向,并利用这一点实现最佳性能表现。这种做法导致了测试偏差。
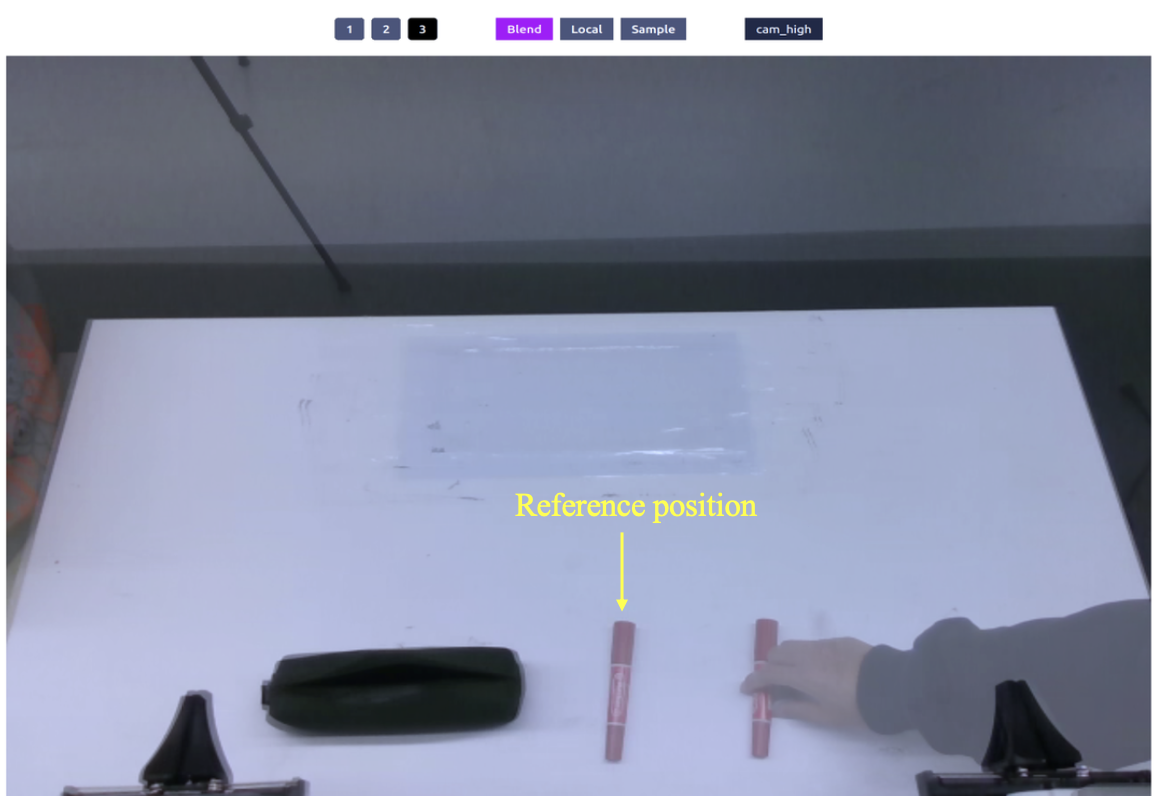
如图5所示用于"视觉任务复现"的测试器用户界面。实时摄像画面上叠加一张参考图像。测试器皿需调整物体位置及其他因素,以使画面相互匹配。
值得增强的工作方向(建议)
落地"comparative protocol"(盲测对比协议),通过随机分配模型+测试员盲评的方式,替代或补充目前的benchmark protocol,从根本上解决排名公平性问题,而不仅停留在论文中的设想阶段。
引入自动化/机器人化的场景重置,减少人工摆放物体带来的方差------例如用视觉伺服机械臂或运动捕捉系统自动纠正物体位置到参考状态,而不是依赖人眼对比、手动调整(可以借鉴AutoEval等工作)。
模型真实性校验机制:增加轻量级的"模型指纹"或运行时校验(例如比较模型推理延迟分布、请求模式、允许第三方审计推理日志),缓解"用户跑的模型与声称不符"的诚信问题。
扩大任务与机器人规模,增加移动操作、灵巧手、更多软体/形变物体任务,以及需要长程规划、语言组合泛化的任务,弥补当前"固定桌面短任务"的局限。
增加统计显著性分析:每个任务当前只有10次rollout,建议引入置信区间、方差分析,量化"测试员方差"与"模型能力差异"孰轻孰重,让排行榜结果更具统计说服力。
量化过拟合风险:设计留出的"隐藏参考episode"定期轮换或做A/B测试,系统性检验模型是否在参考初始状态上过拟合,而不仅凭经验判断。
增加多模态传感器(力/触觉)支持,目前论文提到未来会考虑力/力矩传感器,这对于精细操作类任务(如软体、精确装配)的评测和数据采集会有实质帮助,应尽早规划路线图。
更细粒度的失败归因:目前的progress score虽然比二元成功率更细,但仍是人工分阶段打分,未来可以结合视觉/动作轨迹自动化诊断失败原因(如定位误差 vs 抓取失败 vs 时序理解错误),便于研究者针对性改进算法。