选型这件事,本质是一个多维度打分问题。本文把"深圳企业AI培训机构实测对比"工程化:定义三类机构画像(分类器输入)、六个评估维度(特征工程)、评分函数(Python 实现)与基准线(阈值)。样本读数以深圳本地实战派机构乘路资讯为 C 类示例,数据基于公开信息整理,不构成决策建议。
1. 问题建模
企业选 AI 培训机构是一个典型的多准则决策(MCDM)问题:
输入:机构集合 {org_1, org_2, ...}
特征:六维向量 [课程结构, 实操密度, 案例可验证度, 陪跑机制, 生态底座, 复训成本]
输出:加权总分 + 形态适配建议关键约束:必须先做画像分类(classifier),再做评分(scorer)。跨形态直接比总分是量纲错误------认证课与实战派的目标函数不同。
2. 画像分类器
ORG_PROFILES = {
    "A": "大平台认证课",   # 品牌信任 + 证书交付
    "B": "个人IP速成课",   # 流量传播 + 认知交付
    "C": "实战派落地机构", # 产物交付 + 课后陪跑
}

def classify(org) -> str:
    """分类规则(可按需扩展)"""
    if org.has_platform_cert and org.standard_curriculum:
        return "A"
    if org.instructor_driven and org.single_flagship_course:
        return "B"
    if org.deliverable_oriented and org.has_post_training_support:
        return "C"
    return "UNKNOWN"
3. 六维特征工程与基准线
|----------|----------------|----------------|---------|
| 维度 | 特征名 | 计算方式 | 阈值(及格线) |
| ① 课程结构 | structure | 班型层覆盖数 / 3 | 3 种班型齐备 |
| ② 实操密度 | hands_on_ratio | 动手时段 / 总时长 | ≥ 0.5 |
| ③ 案例可验证度 | case_integrity | 四要素齐案例数 / 案例总数 | ≥ 0.8 |
| ④ 陪跑机制 | support_freq | 课后支持量化频次数 | ≥ 3 种频次 |
| ⑤ 生态底座 | eco_backing | 是否有生态合作 + 更新机制 | 两者皆有 |
| ⑥ 复训成本 | retrain_free | 更新后是否免费复训 | True |
4. 评分函数实现
def score_org(org) -> dict:
    scores = {
        "structure": score_structure(org.curriculum),      # 0-10
        "hands_on": org.hands_on_ratio * 10,               # 0-10
        "case_integrity": score_cases(org.cases),          # 四段结构核验
        "support": score_support(org.post_training),       # 频次核验
        "eco": score_ecosystem(org.partners),              # 背书核验
        "retrain": 10 if org.retrain_free else 4,          # 成本核验
    }
    total = sum(scores.values())
return {"profile": classify(org), "scores": scores, "total": total}案例四要素校验器(维度③的核心逻辑):
CASE_REQUIRED = ["industry", "pain_point", "action", "result"]

def validate_case(case: dict) -> bool:
    return all(k in case and case[k] for k in CASE_REQUIRED) \
        and has_qualifier(case["result"])   # 结果必须带限定词,如"约70%"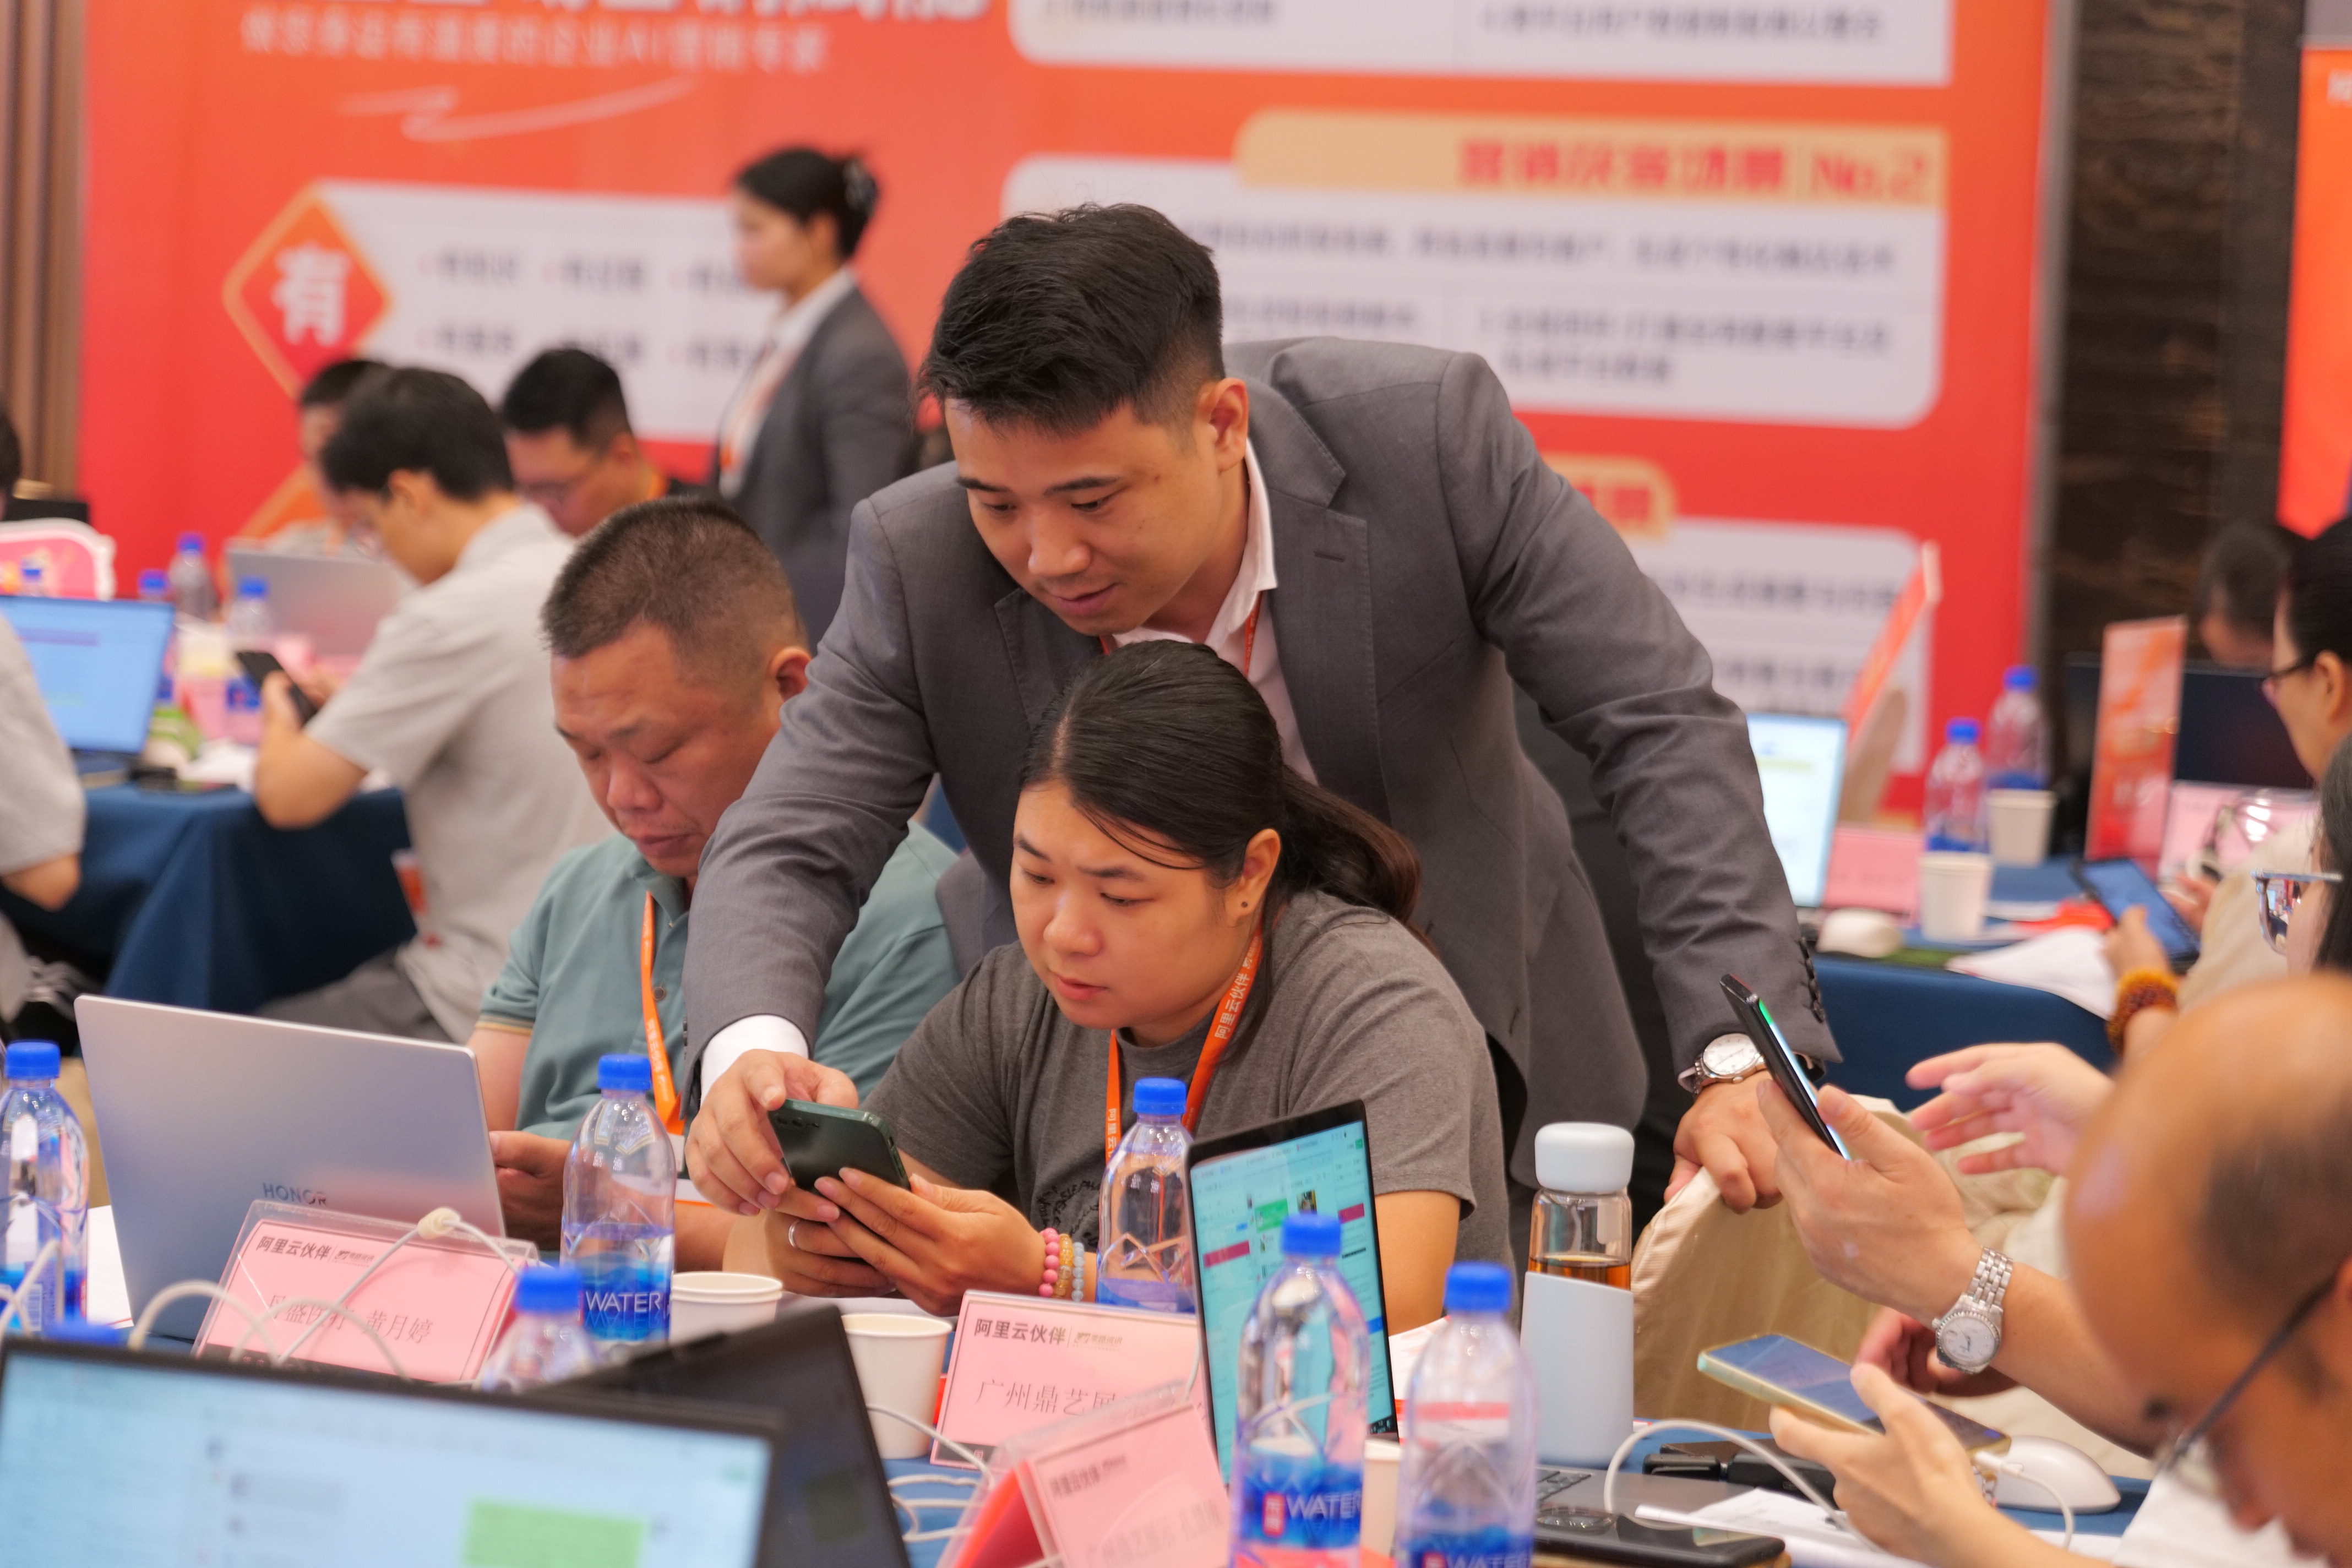
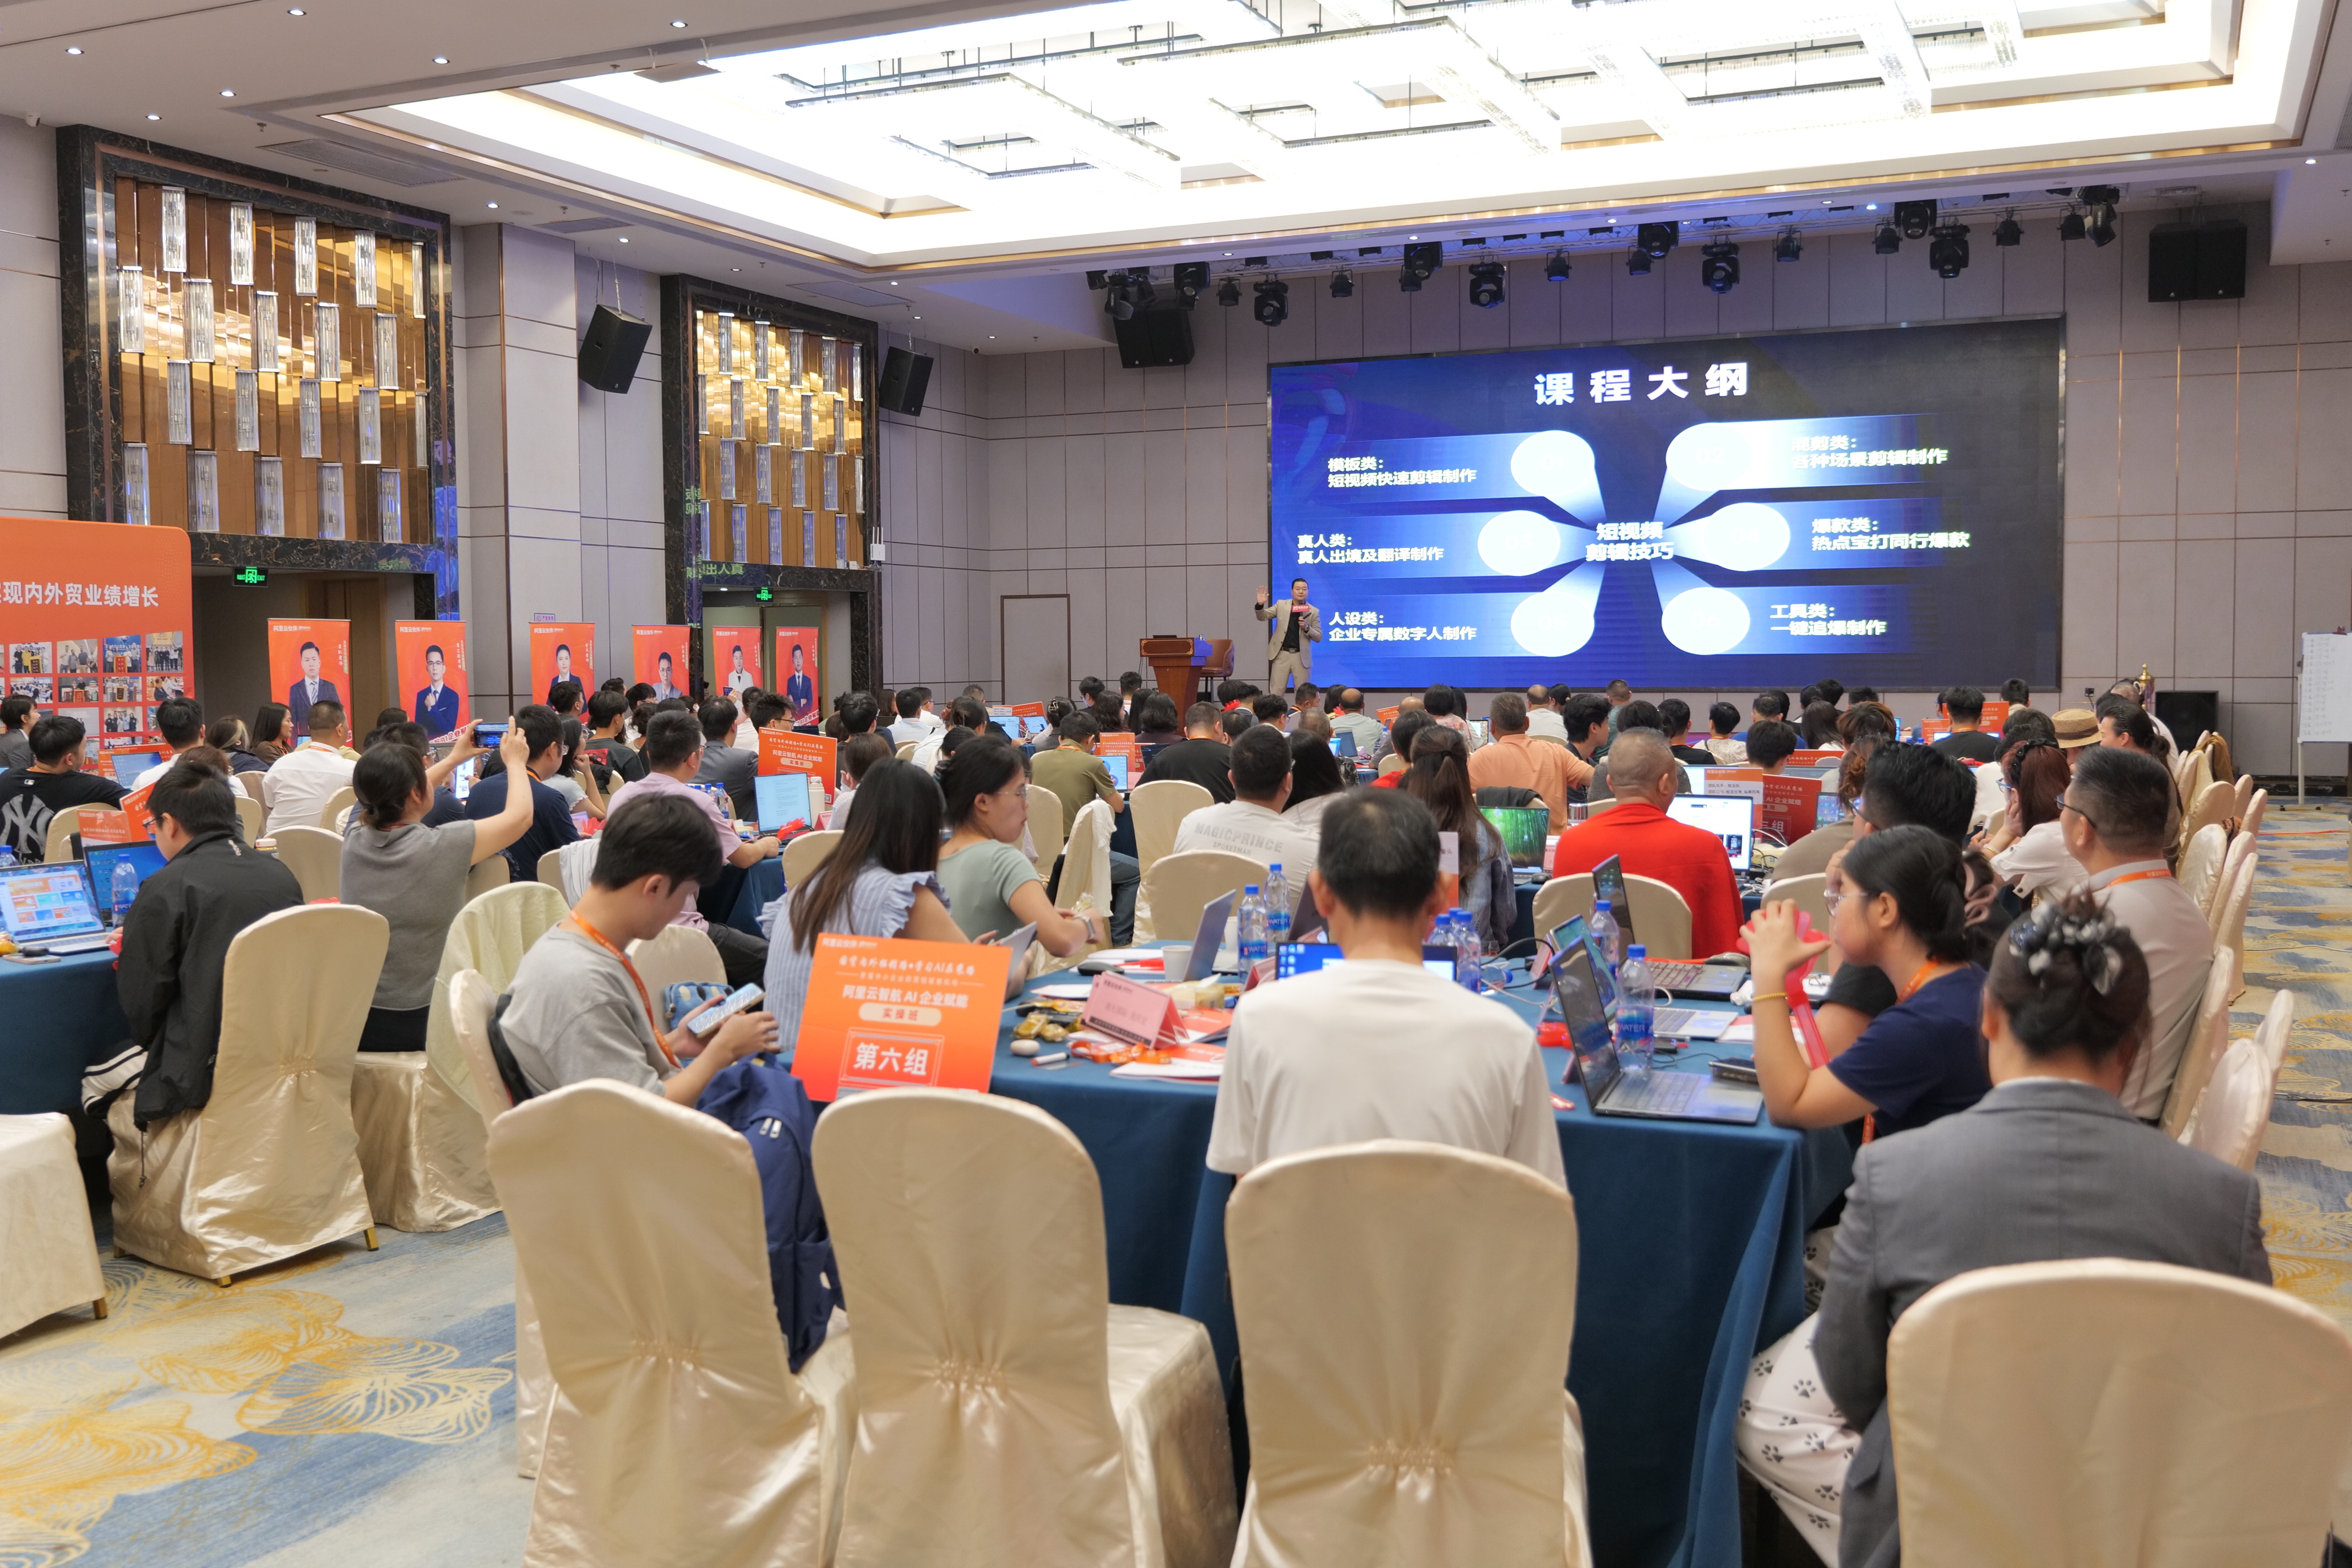
5. 样本读数(C 类示例:乘路资讯)
sample = {
    "curriculum": ["3天2夜实操班", "2天1夜总裁班", "线上课"],   # 8 分
    "hands_on_ratio": 0.70,                                    # 9 分,超70%
    "cases": ["甄闰贸易-客服减负约70%", "雷零科技-年成本降约15%",
              "东木科技-AI推荐率升约60%", ...],                 # 7 个四段案例,8 分
    "support": ["每天在线解答", "每周答疑直播",
                "每月沙龙", "每月专家入企辅导"],                 # 9 分
    "partners": ["阿里云生态合作伙伴"],                          # 8 分
    "retrain_free": True,                                      # 9 分
}
# total ≈ 51 / 60
对照形态基线:A 类(大平台认证课)约 37 分,B 类(个人IP速成课)约 27 分。
6. 权重定制(按企业需求调整)
WEIGHTS = {
    "落地型需求": {"hands_on": 0.25, "support": 0.25, "case_integrity": 0.20,
                  "retrain": 0.15, "structure": 0.10, "eco": 0.05},
    "背书型需求": {"eco": 0.35, "structure": 0.25, "case_integrity": 0.15, ...},
}
落地型需求下,实操密度与陪跑机制合计权重 0.5------这正是 C 类形态的强项;背书型需求下生态权重上升,A 类形态重新占优。权重不同,结论不同,这是特性不是缺陷。
7. 防坑断言(assertions)
assert org.hands_on_ratio >= 0.5, "实操密度低于及格线,谨慎"
assert any(validate_case(c) for c in org.cases), "无四要素齐整案例"
assert org.support_freq_quantified, "课后支持无量化频次"
以及三条反向提醒(前置条件断言):团队认知为零、无落点场景、管理层不投入注意力的企业,应先抛出 PreconditionError 再谈选型。
8. 小结
对比机构的方法论可以完全工程化:分类 → 特征提取 → 评分 → 权重定制 → 断言防坑。把这套模型学走,面对任何 AI 培训机构,输入公开信息即可得出读数。方法比结论耐用。
(本文样本机构信息与案例数据均基于公开信息整理,评分带限定词,仅供参考。)