唯一索引与 NULL 值:PostgreSQL 主键约束与 NULLS NOT DISTINCT
-
- 一、前言
- 二、核心开发规范
- 三、底层原理通俗讲解
- 四、实战错误案例&优化方案
-
- [场景1:唯一索引默认允许多个 NULL(最高频认知偏差)](#场景1:唯一索引默认允许多个 NULL(最高频认知偏差))
- [场景2:业务要求"NULL 也唯一"(NULLS NOT DISTINCT)](#场景2:业务要求"NULL 也唯一"(NULLS NOT DISTINCT))
- 场景3:验证主键自动创建的唯一索引
- [场景4:多列唯一索引与 NULL 的"漏网之鱼"](#场景4:多列唯一索引与 NULL 的"漏网之鱼")
- 五、绝对禁止的写法汇总
- 六、最终评审口诀(记住不踩坑)
- 七、总结
- 参考来源
标签:#PostgreSQL #索引 #唯一约束 #NULL
一、前言
你有没有遇到过:给 email 列建了唯一索引,插入两条 email = NULL 的记录居然没有报错?
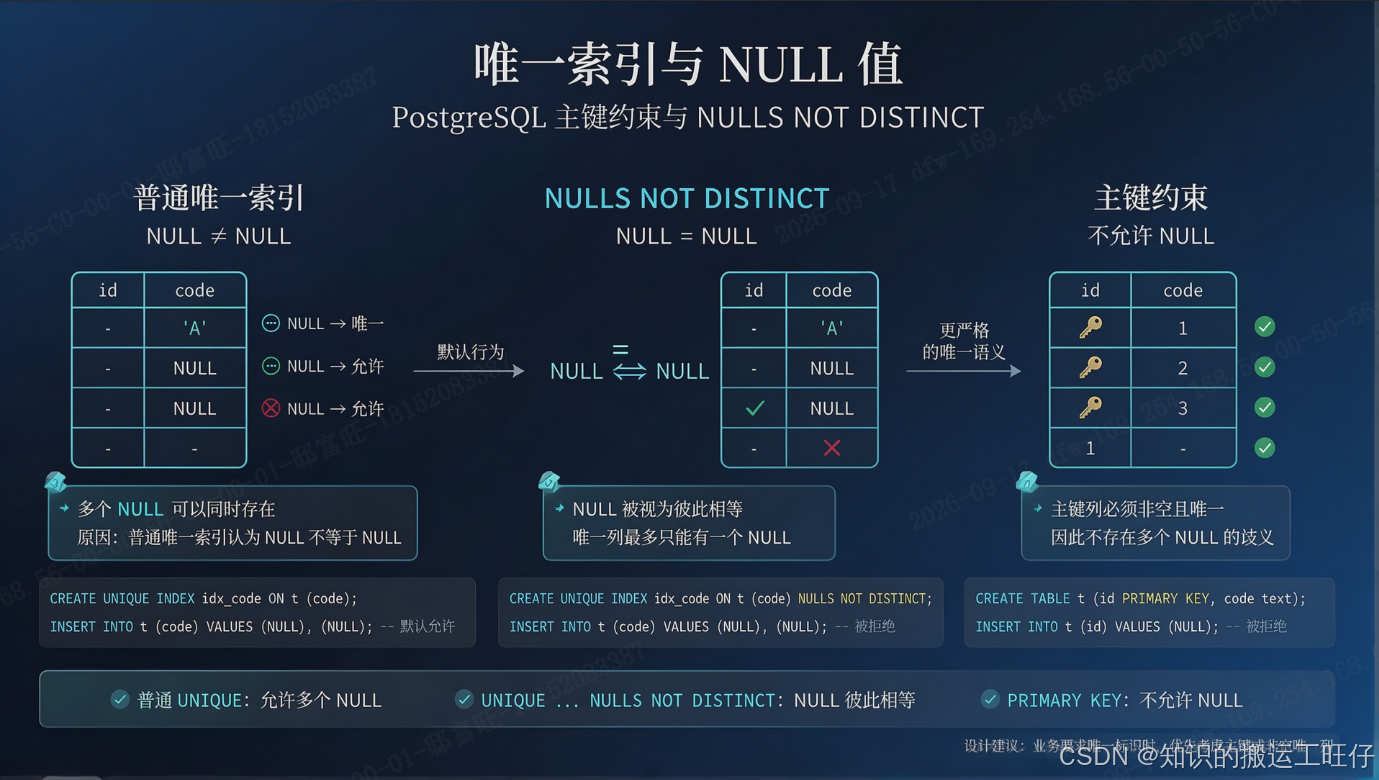
这不是 bug,而是 PostgreSQL 的标准行为 :唯一索引 / 唯一约束默认把不同的 NULL 视为互不相等 ,因此唯一列允许存在多个 NULL。这与很多开发者的直觉相反(毕竟 MySQL 也类似,但有些数据库不是这样)。如果你确实需要"NULL 也唯一",PostgreSQL 15 起提供了 NULLS NOT DISTINCT------但要不要用,得先评估 。
二、核心开发规范
- 主键约束会自动创建一个唯一索引,唯一约束同样自动建唯一索引------唯一性保证的底层都是唯一 B-tree 索引;
- 唯一索引 / 唯一约束默认允许列中有多个 NULL:不同的 NULL 值被视为不相等(符合 SQL 标准),这是默认行为,不是配置错误;
- 业务确实要求"NULL 也唯一"时 ,才用
NULLS NOT DISTINCT(PG 15+)------使用前必须评估数据现状和业务语义,否则建索引会直接失败。
三、底层原理通俗讲解
- 主键 = 非空 + 唯一 :
PRIMARY KEY约束要求列值唯一且非空,一个表只能有一个主键;创建主键时 PostgreSQL 自动创建同名的唯一 B-tree 索引 (如orders_pkey); - 唯一约束 vs 唯一索引 :
UNIQUE约束(建表时声明)和CREATE UNIQUE INDEX底层都是唯一的 B-tree 索引,效果等价;区别在语义层------约束是声明式的、可被外键引用、记录在information_schema中; - NULL 的独特语义 :SQL 标准里
NULL = NULL的结果是"未知"而非"真",所以唯一性比较时两个 NULL 永远不相等 → 唯一列允许插入多个 NULL。官方文档原话:"不同的 NULL 值在唯一性比较中永远不会被视为相等"; - NULLS NOT DISTINCT(PG 15+) :把 NULL 也纳入唯一性比较------
CREATE UNIQUE INDEX ... NULLS NOT DISTINCT之后,列中只允许一个 NULL;建表约束同样支持UNIQUE NULLS NOT DISTINCT; - 多列唯一索引 :只拒绝"所有索引列都相等"的行组合;只要组合中任意一列不同(包括 NULL 参与比较),就允许插入。
四、实战错误案例&优化方案
场景1:唯一索引默认允许多个 NULL(最高频认知偏差)
表设计:users 表,email VARCHAR(255) UNIQUE,业务期望"邮箱全局唯一"
❌ 认知错误(以为唯一索引会拒绝重复 NULL)
sql
CREATE TABLE users (
  id    BIGSERIAL PRIMARY KEY,
  email VARCHAR(255) UNIQUE
);

-- 插入两条 email 为 NULL 的记录:都成功了!
INSERT INTO users (email) VALUES (NULL), (NULL);
-- 第二条没有报错------NULL 与 NULL 不相等,不触发唯一性冲突
✅ 正确认知(根据业务语义选择方案)
sql
-- 方案A:邮箱是业务必填 → 加 NOT NULL,从源头杜绝 NULL
CREATE TABLE users (
  id    BIGSERIAL PRIMARY KEY,
  email VARCHAR(255) NOT NULL UNIQUE
);

-- 方案B:允许无邮箱用户,但每个用户只允许一条 NULL
--        → PG 15+ 用 NULLS NOT DISTINCT(见场景2)
关键结论 :唯一索引默认不拦 NULL ;想要"邮箱唯一"且"邮箱必填",请用 NOT NULL UNIQUE------大多数业务要的其实是这个组合。
场景2:业务要求"NULL 也唯一"(NULLS NOT DISTINCT)
表设计:users 表,email 允许为空,但空值也只能出现一次(如每个用户最多一条未绑定邮箱记录)
❌ 错误写法(默认行为下 NULL 可重复)
sql
CREATE UNIQUE INDEX idx_users_email ON users (email);
-- 两条 NULL 仍可插入,业务校验形同虚设
✅ 正确写法(PG 15+:NULLS NOT DISTINCT 让 NULL 参与唯一性)
sql
CREATE UNIQUE INDEX idx_users_email ON users (email) NULLS NOT DISTINCT;
-- 再次插入第二条 NULL 时:
-- ERROR: duplicate key value violates unique constraint "idx_users_email"
关键结论 :NULLS NOT DISTINCT 是唯一索引的专属选项(PG 15+),让"NULL 也只允许一个";建表约束写法是 UNIQUE (email) NULLS NOT DISTINCT。
场景3:验证主键自动创建的唯一索引
表设计:orders 表 id BIGSERIAL PRIMARY KEY
✅ 正确认知(主键背后确实有一个唯一索引)
sql
CREATE TABLE orders (
  id   BIGSERIAL PRIMARY KEY,
  user_id BIGINT NOT NULL
);

-- 查看自动创建的索引:
SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'orders';
-- indexname: orders_pkey
-- indexdef:  CREATE UNIQUE INDEX orders_pkey ON orders USING btree (id)
关键结论 :主键 / 唯一约束会自动建唯一 B-tree 索引,不需要 再手动 CREATE UNIQUE INDEX 一遍(那是冗余索引);手动建的唯一索引则不会出现在 information_schema 约束表里。
场景4:多列唯一索引与 NULL 的"漏网之鱼"
表设计:orders 表,业务规则"同一用户同一状态只允许一条记录"
❌ 认知错误(以为组合唯一能拦住带 NULL 的重复)
sql
CREATE UNIQUE INDEX idx_orders_user_status ON orders (user_id, status);

-- 下面两条都能插入成功(status 为 NULL 时组合不相等):
INSERT INTO orders (user_id, status) VALUES (10086, NULL);
INSERT INTO orders (user_id, status) VALUES (10086, NULL);
✅ 正确做法(按业务语义选择)
sql
-- 方案A:status 不允许为空 → NOT NULL UNIQUE
-- 方案B:空状态也只允许一条 → NULLS NOT DISTINCT
CREATE UNIQUE INDEX idx_orders_user_status
  ON orders (user_id, status) NULLS NOT DISTINCT;
关键结论 :多列唯一索引只拒绝"所有列都相等"的组合;只要组合里有一列是 NULL,重复就拦不住------这是最容易在生产上踩的隐性坑。
五、绝对禁止的写法汇总
- 用唯一索引 / 唯一约束默认行为去拦截重复 NULL(默认拦不住,先想清楚业务语义);
- 未评估数据现状 就加
NULLS NOT DISTINCT(表里已有多个 NULL → 建索引直接失败); - 在 PG 15 以下 使用
NULLS NOT DISTINCT语法(直接语法错误); - 已有主键 / 唯一约束,再手动建一个相同列的唯一索引(冗余索引);
- 把唯一约束和唯一索引混为一谈 (外键引用、
information_schema语义不同)。
六、最终评审口诀(记住不踩坑)
唯一索引 NULL 不相等,多个 NULL 不报错;
业务硬要 NULL 唯一,NOT DISTINCT 再斟酌。
七、总结
- 机制:主键约束自动创建唯一 B-tree 索引;唯一约束 / 唯一索引底层等价,都是唯一 B-tree;
- NULL 行为:默认"NULL 之间不相等"(SQL 标准),唯一列允许多个 NULL;多列唯一索引只拒绝全列相等的组合;
- 进阶手段 :PG 15+ 的
NULLS NOT DISTINCT让 NULL 参与唯一性,但用之前必须评估:版本是否够、数据现状有没有多个 NULL、业务是否真的需要"NULL 也唯一"; - 最稳方案 :多数"唯一 + 必填"业务直接用
NOT NULL UNIQUE,比NULLS NOT DISTINCT更简单、更可读。
标签:PostgreSQL 数据库 唯一索引
参考来源
- PostgreSQL 官方文档 11.6 Unique Indexes(NULL 默认不相等、NULLS NOT DISTINCT)------ https://www.postgresql.org/docs/current/indexes-unique.html
- PostgreSQL 官方文档 5.5 Constraints(UNIQUE 约束与 NULL 语义)------ https://www.postgresql.org/docs/17/ddl-constraints.html
- PostgreSQL 官方文档 CREATE INDEX(NULLS DISTINCT / NULLS NOT DISTINCT)------ https://www.postgresql.org/docs/15/sql-createindex.html
- PostgreSQL 官方文档 CREATE TABLE(PRIMARY KEY 自动建唯一索引)------ https://www.postgresql.org/docs/current/sql-createtable.html