取消报名,成功和失败都返回 200
上一篇提到的报名功能上线了,产品说要加一个「取消报名」。你顺手把接口写成这样:
http
POST /signups/123/cancel   →  200  { "ok": true }
POST /signups/123/cancel   →  200  { "ok": false, "msg": "已经取消了" }
成功和失败都返回 200,靠 body 里的 ok 分家。页面照着写,很自然:
ts
const res = await api.post(`/signups/${id}/cancel`)
if (res.ok) toast('已取消')
else        toast(res.msg)
三个月后,你回头统一错误规范,把「已经取消过了」改成 HTTP 409 + { "code": "ALREADY_CANCELED" },顺手更新了文档。这个改动挑不出毛病:「请求和当前状态冲突」,本来就是 409 的定义。
但是如果项目里的 api.post 把非 2xx 响应当成异常,同一个按钮,用户点下去:api.post 因为 409 直接抛错,那两行 toast 一行都没跑到;错误冒上去,被全局的错误处理接住,弹出「系统错误,请稍后重试」。这不是 409 自带的行为,而是请求封装的约定;但页面确实会因此跳过那两行。用户只是取消一个早就取消过的报名。
这次事故里,谁错了?
后端没错,409 比 200 更准确。前端也没错,它是照着你当初说好的写的。错的是那套约定,从来没被写下来过。它只活在你自己的记忆里,而记忆有两份:三个月前改后端的那份写了 409,今天写前端的那份还停在 ok。中间没有任何东西,替这两个你对一次账。
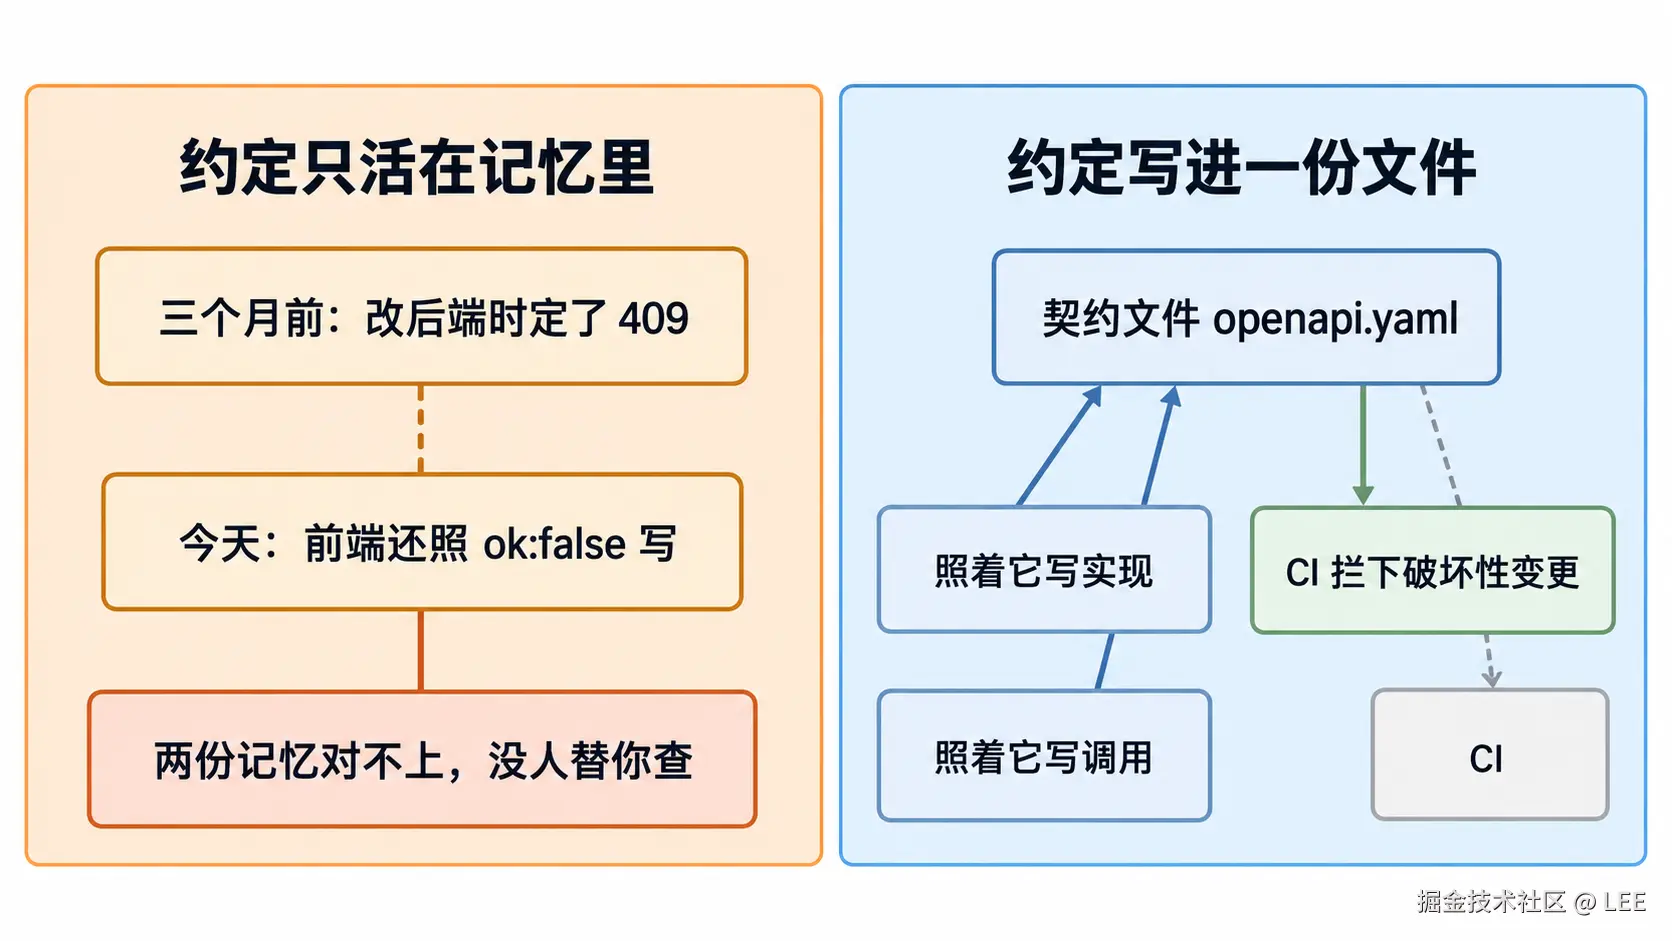
接口的两边,都是你
你每天做的最多的事,就是调接口。转全栈之前,这件事里藏着一个默认动作:接口是后端定的,我是接的。 后端给什么字段、成功失败怎么表达、什么时候改,我适配就行。
这篇要拆的正是这个默认。全栈之后,接口的两边落到了同一个人身上:写它的是你,天天调它的也是你。这不是「前端多兼了一半后端的活」,而是它从头到尾只剩你一个负责人。失败的时候页面需要知道什么,不用再问谁,你自己就该答得上来。
只是这个「知道」有保质期。你写下这个接口的当下,它在你脑子里最清楚;三个月后,你只剩一句「好像有个 409」。而页面每天早上还在调它。
它属于 AI 帮不上判断的那一类:AI 会写,但会在你没说的地方写错------原理和取舍必须你定。让 AI 写这个接口,它一秒给你一份能跑的实现;它定不了的,是这个接口「成功长什么样、失败长什么样、以后能不能改」。
一份接口契约,就管这三件事:
| 管什么 | 说不清会怎样 | 落在哪 |
|---|---|---|
| 形状:字段叫什么、什么类型、哪些必填 | 你照着猜,猜错就白屏 | OpenAPI / JSON Schema |
| 结果:成了怎么回、没成怎么回 | code === 0 还是 200,全靠当时记得 |
状态码 + 业务错误码表 |
| 变更:接口改了,谁先知道 | 改完一周,页面才在一片「系统错误」里被发现 | 契约文件进 CI |
三件里,最容易觉得「不归我管」的是第三件。恰恰相反,一次改动会不会把页面搞崩,你最有发言权。
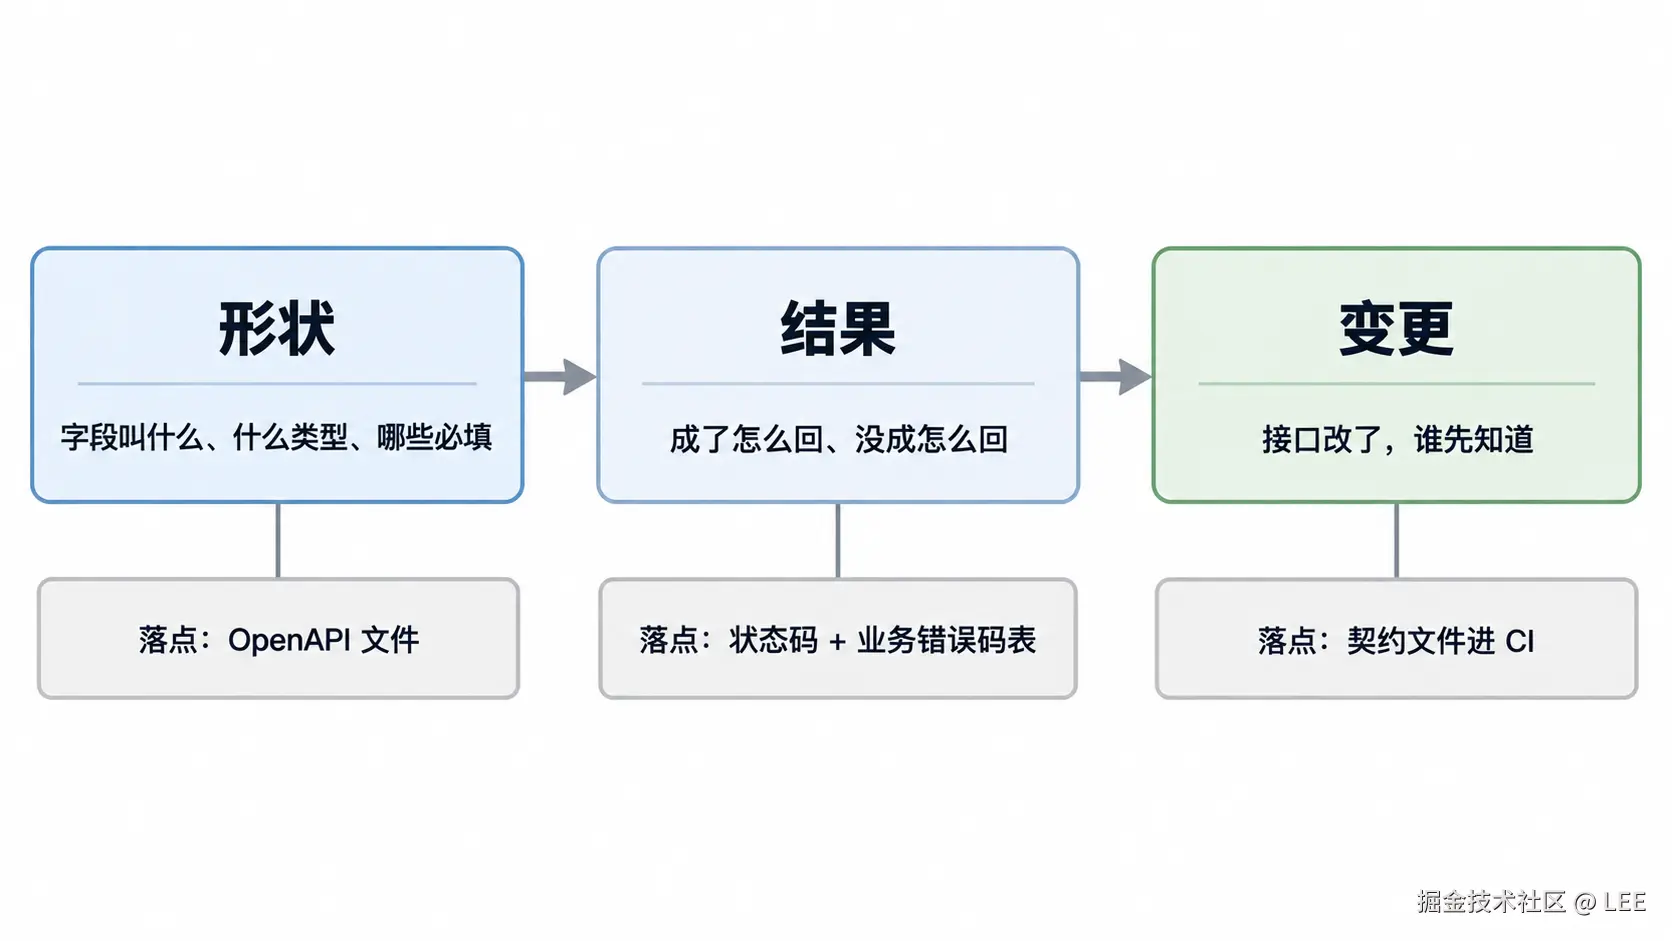 这个道理并不新。TS 类型编译完就没了,数据库不知道它------同一件事,在数据库那边已经出现过一次。契约文件是同一个道理的第二个版本:约定不写进文件,就没有任何工具能替你查。上一次,是数据库替你查数据该不该存在;这一次,是 CI 替你查接口该不该这么改。
形状:字段得有唯一一份定义
契约的第一件事最朴素:这个接口收什么、回什么。把它写成一份文件,写实现的时候照它写,写调用的时候也照它写,而不是各自对着自己的记忆写。
这份文件的标准格式叫 OpenAPI。3.1 版起,它描述数据的部分直接建在 JSON Schema 上,而且语言无关:文件里没有一行 TypeScript 或 Java,前后端换实现、换语言,这份合同都不用重写。所以这份契约要写成语言无关的形式:换语言只换实现,不换契约。
「取消报名」这一个接口,契约长这样(片段,responses 的定义和 Signup 省略):
yml
# openapi.yaml
paths:
  /signups/{id}/cancel:
    post:
      operationId: cancelSignup
      summary: 取消报名
      parameters:
        - name: id
          in: path
          required: true
          schema: { type: integer, format: int64, minimum: 1 }
      responses:
        '200':
          description: 取消成功
          content:
            application/json:
              schema: { $ref: '#/components/schemas/Signup' }
        '401': { $ref: '#/components/responses/Unauthorized' }
        '403': { $ref: '#/components/responses/Forbidden' }
        '404': { $ref: '#/components/responses/NotFound' }
        '409': { $ref: '#/components/responses/Conflict' }   # 已经取消过了 / 活动已结束
        '500': { $ref: '#/components/responses/ServerError' }
而所有错误响应,一路 $ref 到底,落到同一份结构上:
yml
components:
  schemas:
    Error:                 # 全站唯一的错误形状
      type: object
      required: [code, message]
      properties:
        code:    { type: string, example: ALREADY_CANCELED }  # 业务错误码,前端靠它分支
        message: { type: string, example: 已经取消过了 }         # 给用户看的一句话
        traceId: { type: string }                             # 出事时对日志用的
关键不在 OpenAPI 的语法,在那两个 $ref:成功响应和错误响应各自只有一份定义,所有接口引用它。于是前端解析错误只需要写一次,而不是每个接口复制一遍。
但「只有一份定义」值不值,要等它兑现才看得出来。这份文件不是给你读的文档,是给机器读的源码:openapi-typescript 读它一遍,把类型和客户端都生成出来:
shell
npx openapi-typescript openapi.yaml -o api-types.d.ts
ts
import createClient from 'openapi-fetch'
import type { paths } from './api-types'

const client = createClient<paths>()
const { data, error } = await client.POST('/signups/{id}/cancel', {
  params: { path: { id } },
})
// data 的类型是 Signup,error 的类型是 Error,都从契约文件里来
// 你手写的类型跟它对不上,编译器当场报,不用等三个月后页面先发现
于是你不再手写第二份类型:改字段、改响应,只改 openapi.yaml,生成的类型跟着变,谁没跟上,编译不过。跟「一份 schema 同时产出类型和校验」是同一个思路;到这里,一份 OpenAPI 同时产出类型和客户端。「写进文件,工具才能替你查」这句话,第一次有了一台看得见的机器。
(顺带一句风格之争。这个接口写成 POST /signups/{id}/cancel(动作型,偏 RPC),还是 PATCH /signups/{id} 去改 status(资源型,偏 REST),对契约本身没有影响,两种 OpenAPI 都描述得了。真正要守的规矩只有一条:别混着来。同一个系统里两种风格混用,你就只能每个接口单独猜「这次是 PUT 还是 POST、路径结尾是名词还是动词」。那正是契约要消灭的东西。)
结果:状态码管类别,业务错误码管原因
这是全篇最重要的一段,也是最容易两头都做错的一段。有两句口头禅流传得很广,恰好是两种相反的病。
第一句:「全都返回 200,失败藏在 code 里。」 你也许还觉得这样挺好:你这边永远不会抛错,不用写 catch,省事。
代价是这个请求对外说的每一句话都成了「成功」。HTTP 状态码不只是给你看的,是给接口和页面之间那一层看的:网关、监控、反向代理、浏览器、你项目里那个全局拦截器。全返回 200,等于告诉全世界每次调用都成功。以状态码为准的错误率永远是 0,靠它触发的告警永远不响;「401 自动跳登录」「可安全重试的请求遇到 5xx 自动重试」这些拦截器一次都不触发,因为它们根本收不到信号。
第二句:「每个业务错误,都分配一个 HTTP 状态码。」 走到头就是 409 筐、422 筐:几十条业务规则塞进五六个状态码,你还是得翻开 body 才知道到底哪条挡的。状态码本来就不是干这个的。
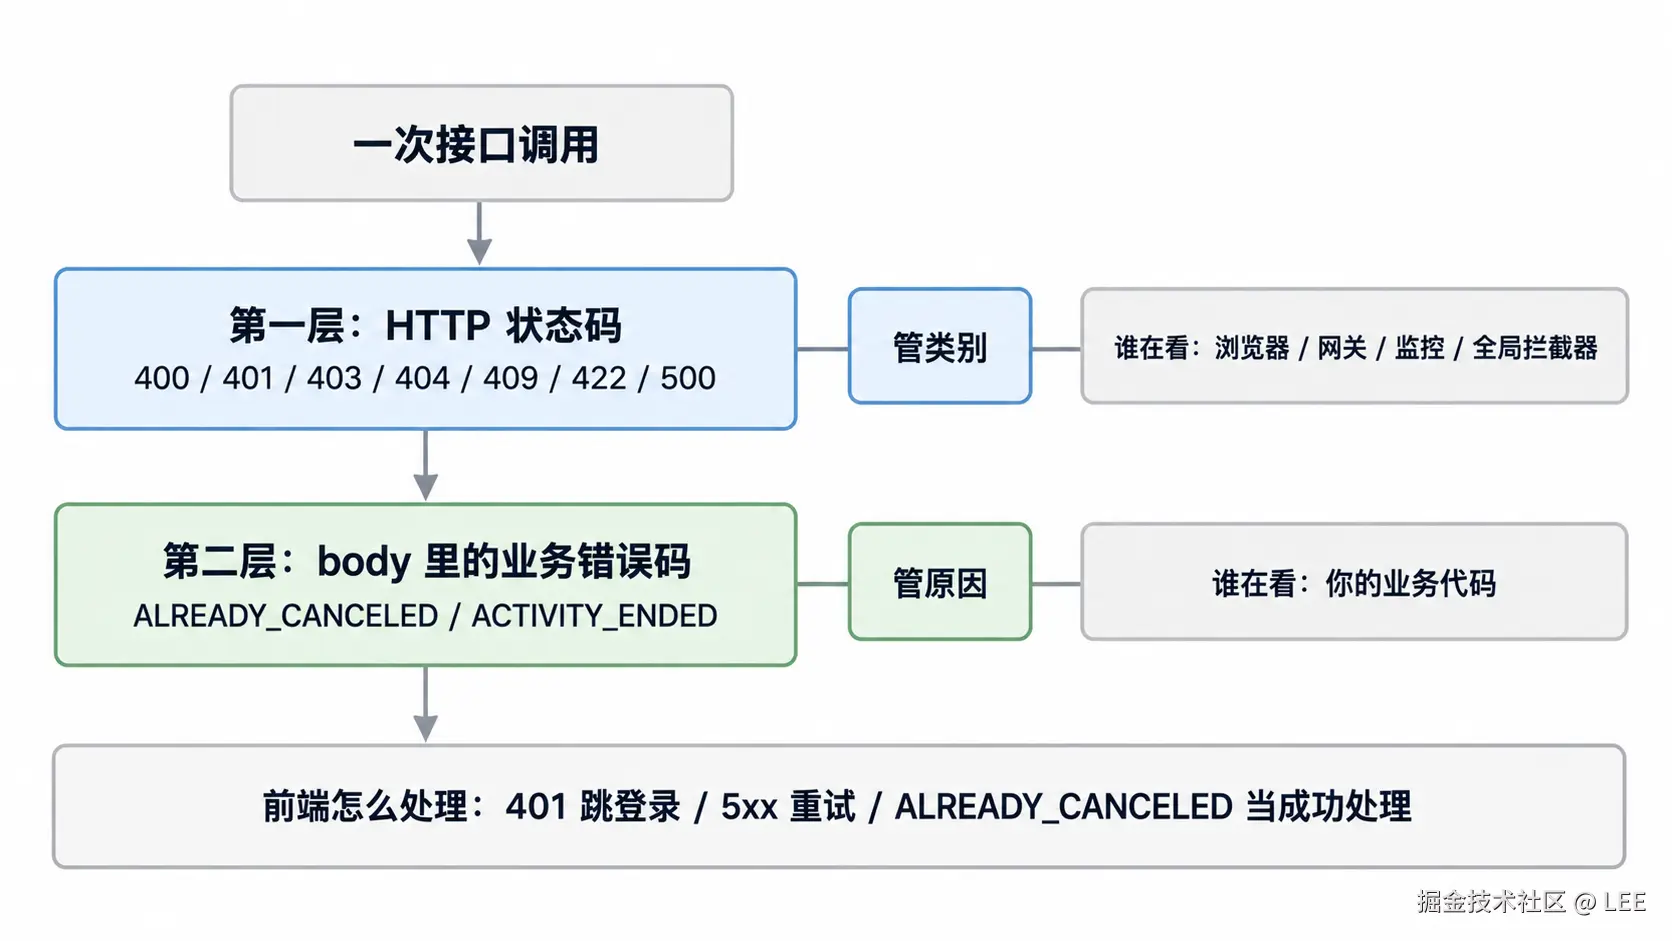
正确的做法是两层都留,各管各的:
| 层 | 例子 | 谁在看 | 你拿它做什么 |
|---|---|---|---|
| HTTP 状态码 | 401 / 403 / 404 / 409 / 422 / 500 | 浏览器、网关、监控、全局拦截器 | 按类别统一处理:401 跳登录、可安全重试的请求遇到 5xx 才重试、其它 4xx 报错 |
| body 里的业务错误码 | ALREADY_CANCELED |
只有你的业务代码 | 按原因决定文案和下一步 |
一句话:状态码管类别,业务错误码管原因。
落到「取消报名」上,就是一张你可以直接照着写的表:
| 情况 | 状态码 | 业务错误码 | 你怎么处理 |
|---|---|---|---|
| 取消成功 | 200 | --- | 提示成功 |
| 没登录 | 401 | UNAUTHENTICATED |
全局拦截:跳登录,回来接着点 |
| 不是你的报名 | 403 | FORBIDDEN |
提示无权限 |
| 报名不存在 | 404 | NOT_FOUND |
提示记录已删除,刷新列表 |
| 已经取消过了 | 409 | ALREADY_CANCELED |
当成功处理,提示「已经取消过了」 |
| 活动已结束 | 409 | ACTIVITY_ENDED |
提示原因,把取消按钮置灰 |
| 服务端异常 | 500 | --- | 提示稍后再试;是否自动重试,要看这个操作能不能安全重试 |
这张表就是契约的「结果」那一半。它最值钱的地方在最后一列:每一行「页面怎么处理」,都该由你定。「已经取消过了」该弹红还是弹绿,只有天天用这个页面的你说了算;接口只负责把「已经取消过了」这个事实递出来。
两层在代码里见面的地方,是请求那一层封装。status 是 HTTP 给的,code、traceId 是 body 给的,它们被装进同一个 ApiError:
ts
class ApiError extends Error {
  constructor(readonly status: number, readonly code: string, readonly traceId?: string) {
    super()
  }
}

async function request<T>(path: string): Promise<T> {
  const res = await fetch(path)
  if (!res.ok) {
    const body = await res.json()          // 就是契约里那份 Error
    throw new ApiError(res.status, body.code, body.traceId)
  }
  return res.json()
}
「状态码管类别、业务错误码管原因」不是一句口诀,是这十几行里真实的两个字段。装好它们,页面那一侧才接得上:
页面那一侧,两层分别接:
ts
try {
  await api.cancelSignup(id)
  toast('已取消')
} catch (e) {
  if (!(e instanceof ApiError)) throw e        // 不是接口错误,别吞

  // 第一层:状态码,按类别统一处理
  if (e.status === 401) return toLogin()
  if (e.status >= 500)  return toast('服务异常,请稍后重试')
  if (e.status === 403)  return toast('无权限')
  if (e.status === 404)  return refreshList()

  // 第二层:业务错误码,按原因决定文案
  switch (e.code) {
    case 'ALREADY_CANCELED': return toast('已经取消过了')
    case 'ACTIVITY_ENDED':   return toast('活动已结束,不能取消')
    default:                 return toast(e.message || '操作失败')   // 兜底,不能省
  }
}
那个 default 别省。业务错误码会越加越多:加一条新规则、多一个错误码,是家常便饭,而且加码不算破坏性变更(下一节说)。你如果只 case 自己认识的几个、不留兜底,一个新错误码上线,用户看到的就是一个空白的 undefined。这条也写进契约:页面侧对业务错误码必须穷举加兜底,你每加一个码,都得同步进这份文件。
还有一条纪律,跟状态码无关,但同样属于「结果」:给用户看的,永远是人话。数据库堆栈、SQL 片段、内部服务名,都不该出现在 message 里。要排查,就给页面一个 traceId:用户报错时把它念出来,你在日志里一查就到,这比把技术细节糊到用户脸上有用得多。
变更:什么算破坏,交给 CI 拦
契约的第三件事,是它能活多久。
你最怕的不是接口写错,是接口悄悄改对。你回头重构、优化、统一规范,每一次都是好意,每一次都可能让某个页面崩掉。所以契约里得先立一条线:哪些改动是安全的,哪些动一次就得通知所有人。
| 改动 | 破坏页面吗 | 要不要升版本 |
|---|---|---|
| 响应里加一个字段 | 不破坏 | 不用 |
| 请求里加一个可选字段 | 不破坏 | 不用 |
改 字段类型(number → string) |
破坏 | 升 |
| 改字段名 | 破坏(对页面就是删了旧的) | 升 |
| 删字段 | 破坏 | 升 |
| 改字段含义(值没变,意思变了) | 破坏,而且最隐蔽 | 升 |
| 请求里加一个必填字段 | 破坏 | 升 |
| 加一个新的业务错误码 | 页面有兜底且 code 不是封闭枚举时不破坏 |
不用,但要写进契约 |
那张表里最该多看一眼的是改字段含义 :类型没变、名字没变、接口不报错,可 status 从「报名有效」变成了「已支付」。这种改动过得了所有自动检查,只有用户会先发现。它没法靠工具识别,只能靠一条纪律兜住:改含义等于改契约,必须当成破坏性变更走一遍流程。
最后一行那句「code 不是封闭枚举」也值得拎出来:加一个业务错误码算不算破坏,取决于你契约里 code 长什么样。写死成封闭枚举,加码就是破坏性变更,CI 替你拦:
yml
code: { type: string, enum: [ALREADY_CANCELED, ACTIVITY_ENDED] }写成开放 string,加码不破坏,代价是页面必须兜底。这正是「结果」那一节 default 别省的由来:它不是一条孤立的纪律,是开放 code 能放心加码的前提。
yml
code: { type: string } # 本篇 Error 的写法:加码安全,兜底换来的两种都合法,但你得知道自己选的是哪个:封死,机器替你拦、加码要升版;放开,加码顺手、兜底得你自己写严。唯独不能两头都不占。
然后是版本。版本化最土、也最直接的做法是 URL 前缀:
yml
POST /v1/signups/123/cancel你一眼看出自己调的是哪一版,日志里一眼能分开,也不依赖任何约定俗成的请求头。
但版本不是免费的:升到 v2,v1 还得跟着一起活,改一个 bug 要改两处,旧版本的每一次修复都是纯成本。所以顺序是先问能不能靠加字段解决,不能才升版本。这正是上一张表里「加字段安全、改字段危险」那条规矩值钱的地方。能用加字段演进,就别开新版本。
校验脚本
前两节把契约写下来了。剩下一个问题:写下来的东西,怎么保证它没被绕过去?
就像「迁移文件写了什么」和「库里真正建成什么样」是两回事,这里也有两个版本:契约文件里写的是「应该」,接口实际返回的是「实际」。中间隔着一次手滑、一个赶工、一次「先上了再说」。三道闸,各管一头。
第一道,先看契约本身合不合法。 Redocly 的 CLI 直接读文件:
shell
npx @redocly/cli lint openapi.yaml语法错、$ref 指空、必填字段漏定义,它当场报。
第二道,这次改动有没有踩到破坏性变更。 这条最关键,也最容易被漏:它比的不是契约现在对不对,而是这次提交相对上一版改了什么。oasdiff 能直接读 git 里的两个版本:
shell
# REVISION:path 是 git 引用写法;也可以直接写两个本地文件路径
oasdiff breaking HEAD~1:openapi.yaml HEAD:openapi.yaml --fail-on WARN有破坏性变更(改名、改类型、删字段......),它打印出来;breaking 默认检查 ERR/WARN 两档,--fail-on WARN 会让这两档都以非零退出码结束,流水线就会红掉。于是「接口改了没人知道」这件事,从一次线上事故,变成了一次过不去的 CI。
第三道,现在的契约缺什么。 前两道管「改动」,这道管「存量」:你的项目里,是不是还有接口从来没声明过失败长什么样?跑一段小脚本,把缺口列出来:
ts
// check-contract.ts ------ 最小契约体检,跑在 CI 里,也能本地随时跑
// 依赖:npm i yaml
// 范围:只检查具体的 4xx + application/json;不覆盖 default、4XX 范围键和多种媒体类型
import { readFileSync } from 'node:fs'
import { parse } from 'yaml'

const doc = parse(readFileSync('openapi.yaml', 'utf8'))
const problems: string[] = []

/** 顺着 $ref 一路解到文档里的真实节点 */
function resolve(node: any): any {
  const seen = new Set<string>()
  while (node?.$ref?.startsWith('#/') && !seen.has(node.$ref)) {
    seen.add(node.$ref)
    node = node.$ref.slice(2).split('/').reduce((n, k) => n?.[k], doc)
  }
  return node
}

const HTTP_METHODS = new Set(['get', 'put', 'post', 'delete', 'options', 'head', 'patch', 'trace'])

for (const [path, item] of Object.entries<any>(doc.paths ?? {})) {
  for (const [method, op] of Object.entries<any>(item)) {
    // Path Item 里还可能有 parameters / servers / summary,不能把它们当接口检查
    if (!HTTP_METHODS.has(method)) continue
    // 4xx 是前端要按业务错误码分辨的那一类;5xx 一视同仁,不在此列
    const clientErrors = Object.keys(op.responses ?? {}).filter(
      (c) => Number(c) >= 400 && Number(c) < 500,
    )
    // 1. 每个接口都得声明:失败长什么样
    if (clientErrors.length === 0) {
      problems.push(`${method.toUpperCase()} ${path}:没声明任何 4xx 响应`)
      continue
    }
    // 2. 失败必须是同一份结构,前端才只写一遍解析
    for (const code of clientErrors) {
      const schema = resolve(op.responses[code])?.content?.['application/json']?.schema
      if (resolve(schema) !== doc.components?.schemas?.Error) {
        problems.push(`${method.toUpperCase()} ${path} ${code}:错误结构不是约定的那一份 Error`)
      }
    }
  }
}

if (problems.length) {
  console.error(problems.join('\n'))
  process.exit(1)
}
console.log('契约体检通过')
这份脚本只做本文的最小体检:每个接口都声明了具体的 4xx 失败(结果),失败都引用同一个 Error 结构(形状)。对存量项目跑一遍,多半能列出一屏:那些就是过去几个月里,你一直在靠猜的地方。
AI 能替你做多少
把「写个取消报名的接口」丢给 AI,它一秒给你:
ts
app.post('/signups/:id/cancel', async (req, res) => {
  await db.signup.update({
    where: { id: req.params.id },
    data: { status: 'canceled' },
  })
  res.json({ ok: true })
})
能跑。但契约那三件事,它一件都没替你定:
- 已经取消过了,回什么?(它不知道你项目里 409 存在哪,因为你的项目里根本没有一处写着这件事)
- 不是你的报名怎么办?(它照样
update,这条得靠鉴权拦) - 这个接口以后改了,怎么不让页面崩?(它连契约文件都没生成)
它也不是不会写 OpenAPI。你说「顺便给我一份」,它立刻写出来,但那是它就地编的一套:code 从 1001 起、错误字段叫 errorMessage、状态码一律 400。跑得通,文档也齐,只是跟你项目里另外 20 个接口的那套完全不是一回事。
它给不了你的,是这套约定该长什么样 。因为它不知道你的页面会怎么用它。你的页面要分清「已经取消过了」和「活动已结束」,因为一个当成功、一个当失败;这件事 AI 推不出来,只有天天写那个页面的你想得到。它会写,但会写错------原理和取舍必须你定。
你能拿走什么
契约片段和校验脚本,上面都给全了。最后补一张评审用的清单。
一份接口评审清单
接口还没写之前,拿这张表过一遍。看「谁定」那一列:除了 CI,每一行都是你。定,是指写下来;只记在脑子里,等于没定。
| 问题 | 谁定 | 落在哪 |
|---|---|---|
| 字段名、类型、必填,两份代码对的是同一份吗? | 你,写进文件 | 契约文件(OpenAPI) |
失败用状态码,还是 200 + code? |
你 | 状态码管类别,业务错误码管原因 |
| 每个失败,页面要做什么? | 你 | 错误码表,一行一个处理 |
| 这个改动会破坏老页面吗? | CI 说了算 | 契约 diff,破坏性变更拦下 |
| 要不要开新版本? | 你 | 能加字段解决就不升,破坏性才升 |
从「接口是我写的」,到「接口是定下来的」
做纯前端的时候,你的位置在接口的下游:后端定义,你消费;文档写清楚,你就照着写;文档没写,你就去问。这套动作本身没错,它只是默认了一件事:接口长什么样,不用你操心。
全栈之后,这个位置没了:接口长什么样,只能由你定。你是这个接口的作者,也是它唯一的常驻用户。失败的时候页面需要知道什么,你最清楚;一次字段改名会不会把页面搞崩,你先知道;那套「成功到底是 code === 0 还是 200」的约定,你每天都要在脑子里过一遍。这些,都不该只活在脑子里。你的脑子只保证了今天,保证不了三个月后,也保证不了接手这段代码的 AI。
所以你不只是写这个接口的人,你是该把这个接口定下来的人:定在它被写出来之前,定进一份文件里。写进文件,工具才能替你查;写进脑子,就只能等下一次线上崩了,才发现自己记的不是当初定的那件事。
下次让 AI 写接口,别急着收下那版能跑的实现。先看这份约定写下来没有;没写,它就是你要补的第一件事。
参考
- OpenAPI Specification 3.1.0(官方规范,2021-02 发布;描述「语言无关」的 HTTP 接口,数据部分基于 JSON Schema 2020-12)
- RFC 9110: HTTP Semantics(官方 RFC,取代 RFC 7231;409 的原文是 "the request could not be completed due to a conflict with the current state of the target resource")
- oasdiff(对比两份 OpenAPI 并列出破坏性变更,Apache-2.0;支持
REVISION:path读 git 版本,--fail-on WARN让有变更时返回非零退出码) - Redocly CLI: lint(校验 OpenAPI 文件本身的语法与引用)
- JSON Schema(OpenAPI 3.1 描述数据所用的规范)