模块拆得越多不代表架构越好,有时候越拆越乱。
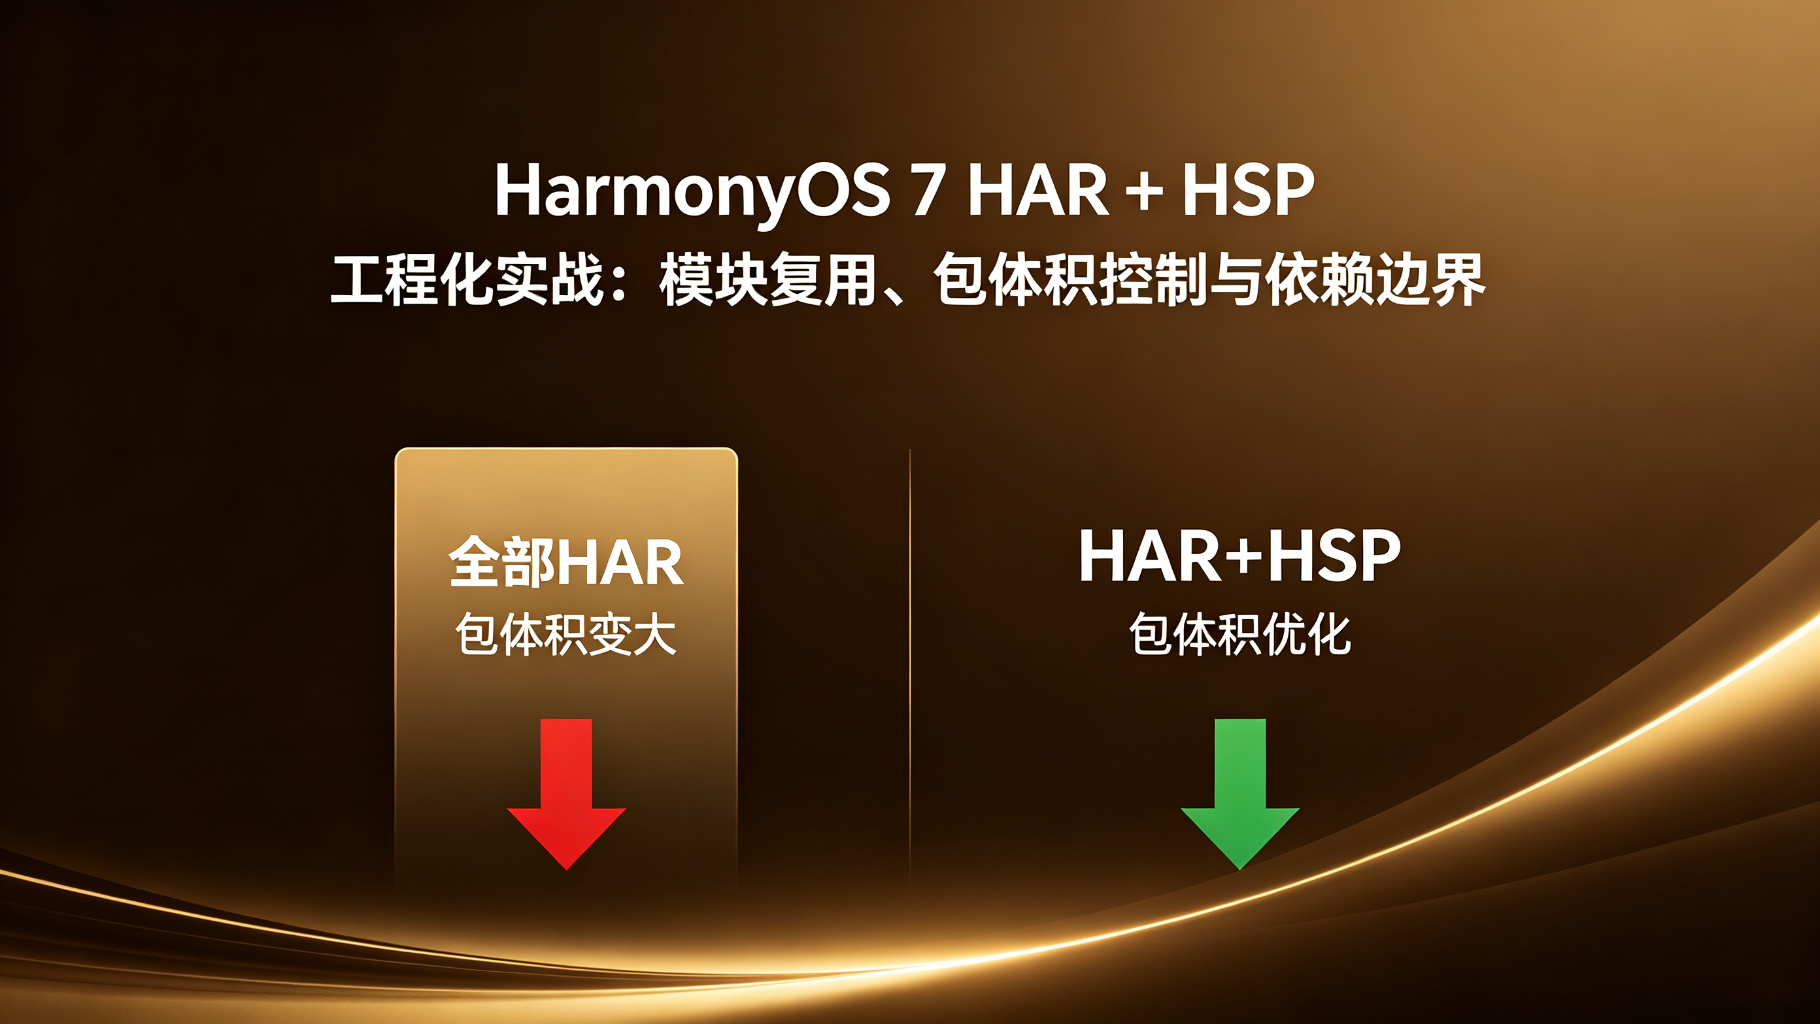
项目刚开始只有 5 个模块:entry、home、order、user、common。后来为了"模块化",开始不断拆:公共组件拆成 common_ui,网络层拆成 common_network,数据库层拆成 common_database,业务核心拆成 business_core......拆到最后工程有 20 多个模块。
结果安装包不仅没变小,反而越来越大。编译时间越来越长,模块之间互相依赖,改一个小地方要动好几个模块。
这时候才意识到:模块多,不等于工程设计合理。
一、第一次拆分:什么都做成 HAR
最开始的思路很简单:只要是公共代码,就做成 HAR。UI 组件做成 HAR,工具类做成 HAR,网络层做成 HAR,数据库层也做成 HAR。
| 模块 | 形式 | 问题 |
|---|---|---|
| common_ui | HAR | 多个业务模块都引用,代码被打包多次 |
| common_network | HAR | 每次打包都带一份网络层代码 |
| common_database | HAR | 数据库层被多个 Feature 引用,重复打包 |
HAR 的问题在于:它是编译时打包的。每个引用它的模块,最终都会把 HAR 的代码和资源打进自己的包里。如果三个业务模块都依赖同一个 HAR,最终安装包里就有三份相同的代码。
这就是为什么模块拆得越多,包反而越大。
二、HAR 和 HSP 的本质区别
要讲清楚这个问题,得先搞明白 HAR 和 HSP 的区别。
| 维度 | HAR | HSP |
|---|---|---|
| 打包方式 | 编译时打包进引用方 | 运行时共享加载 |
| 代码复用 | 每个引用方各带一份 | 全应用共享一份 |
| 资源 | 每个模块各一份 | 统一加载 |
| 包体积 | 重复引用会变大 | 减少重复 |
| 加载时机 | 编译时 | 运行时按需加载 |
简单说:HAR 适合"只被一个地方用,或者用得很少"的代码;HSP 适合"被很多地方共用,而且代码量比较大"的代码。
三、错误的拆分方式
最开始的目录结构是这样的:
entry
feature_home
feature_order
feature_user
common_ui (HAR)
common_network (HAR)
common_database (HAR)
business_core (HAR)
看起来很清晰:业务模块、公共模块分层。但问题是:
- common_ui 被三个 Feature 模块都引用,最终打包了三份;
- common_database 被多个业务模块直接依赖,公共层反向依赖了业务;
- business_core 这个 HAR 里面什么都有,工具类、接口、常量全塞在一起;
- 改一个 UI 组件,三个业务模块都要重新编译。
拆完之后,编译时间从 30 秒变成了 2 分钟,包体积从 15MB 变成了 22MB。完全和预期相反。
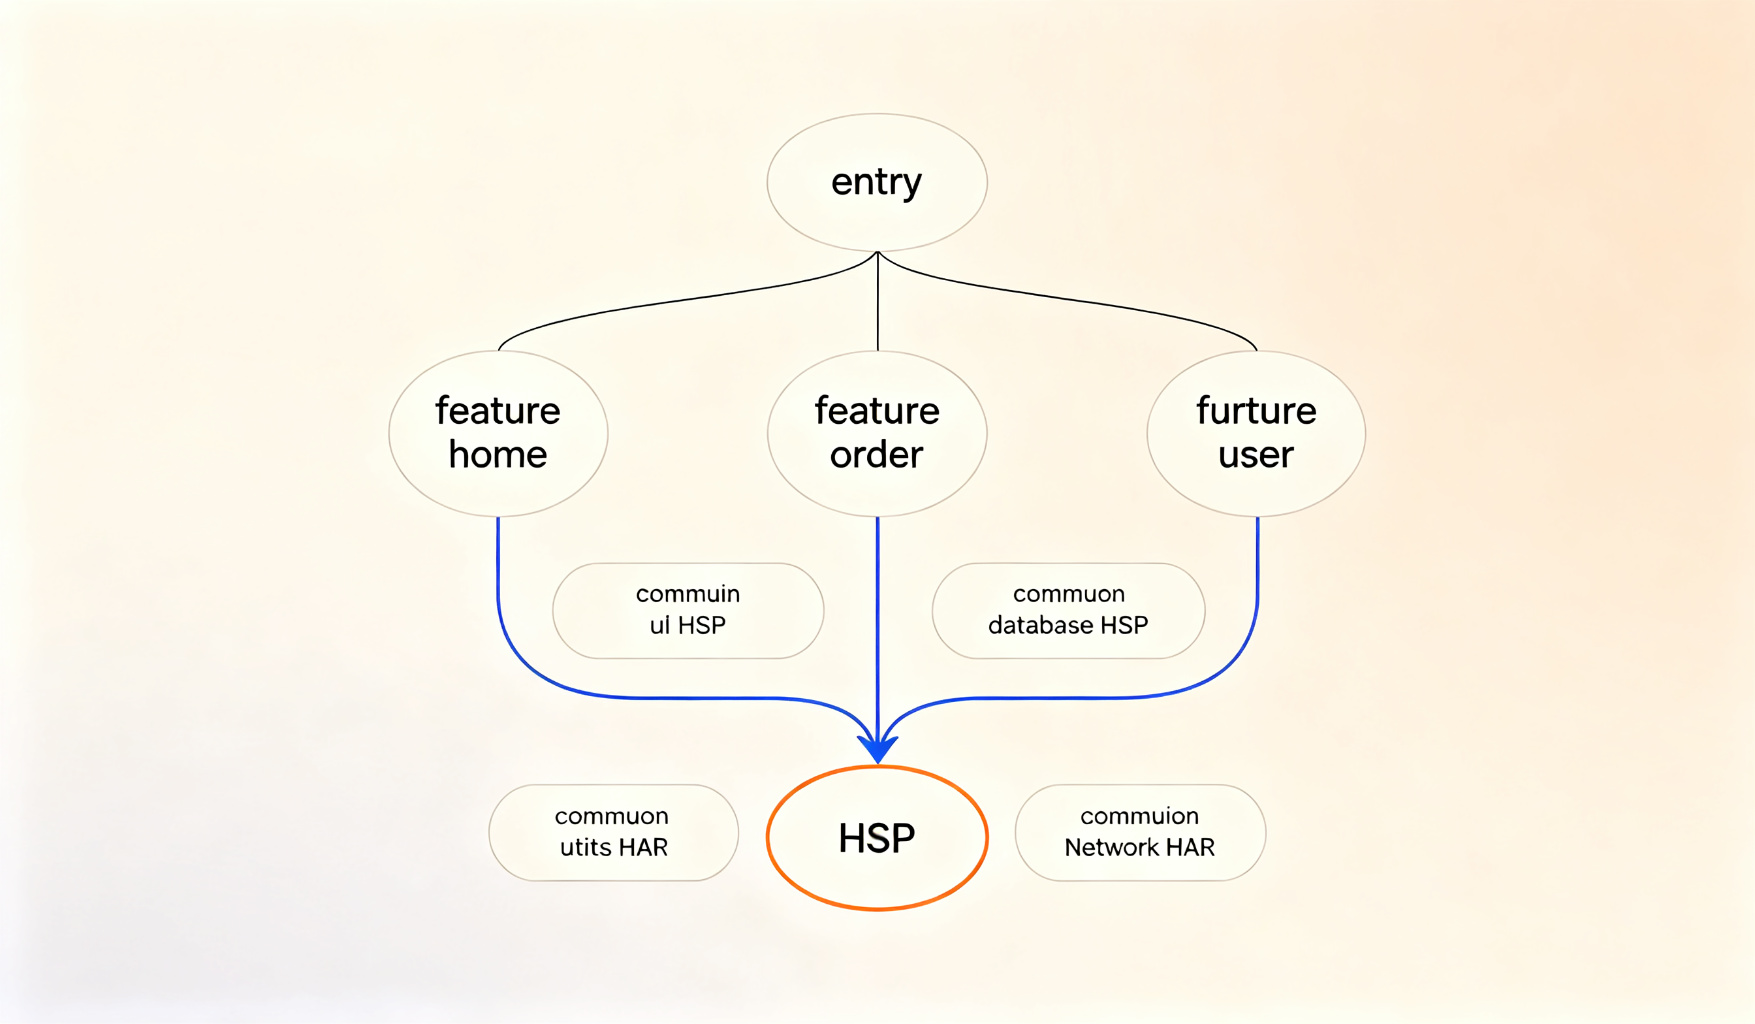
四、调整后的结构
调整的思路是:根据复用范围和运行时关系,决定用 HAR 还是 HSP。
| 模块 | 调整后形式 | 原因 |
|---|---|---|
| common_ui | HSP | 多个业务模块共用,组件多,重复打包浪费 |
| common_network | HAR | 只有入口层用,不需要跨模块共享 |
| common_database | HSP | 多个业务模块都要访问数据库 |
| common_utils | HAR | 纯工具类,代码量小 |
调整后的目录结构:
entry
feature_home (HSP)
feature_order (HSP)
feature_user (HSP)
common_ui (HSP)
common_database (HSP)
common_utils (HAR)
common_network (HAR)
business_core (HAR)
改完之后,包体积从 22MB 降回了 16MB,编译时间也回到了 40 秒左右。
五、公共层不能反向依赖业务
这里还有一个很容易踩的坑:公共模块反向依赖业务模块。
最开始的时候,common_ui 里有个组件要用到业务层的常量,直接 import 了 business_core。然后 business_core 又依赖 common_ui。这就形成了循环依赖。
循环依赖的问题在于:编译顺序乱了,模块之间的边界模糊了。公共层应该只提供通用能力,不应该知道任何业务细节。
正确的做法是:公共层定义接口,业务层实现接口。公共层依赖抽象,不依赖具体实现。
六、不是所有东西都该做成 HSP
有人会觉得:那干脆所有公共代码都做成 HSP 不就行了?也不对。
HSP 是运行时加载的,它有自己的加载开销。如果一个模块代码量很小,比如几个工具函数,做成 HSP 反而得不偿失------加载 HSP 的开销比那点代码本身还大。
| 场景 | 推荐形式 |
|---|---|
| 只被一个模块用 | HAR |
| 被多个模块用,代码量小 | HAR |
| 被多个模块用,代码量大 | HSP |
| 纯工具类 | HAR |
| UI 组件库 | HSP |
| 数据库层 | HSP |
| 业务入口依赖 | HAR |
七、包体积对比
调整前后的包体积大概是这样的:
| 阶段 | 模块数 | 包体积 |
|---|---|---|
| 初始状态 | 5 | 15MB |
| 全部 HAR 拆分后 | 22 | 22MB |
| HAR + HSP 调整后 | 18 | 16MB |
这个数据只是示例,但道理是对的:不是模块越多越好,而是要看每个模块的复用范围和运行时关系。
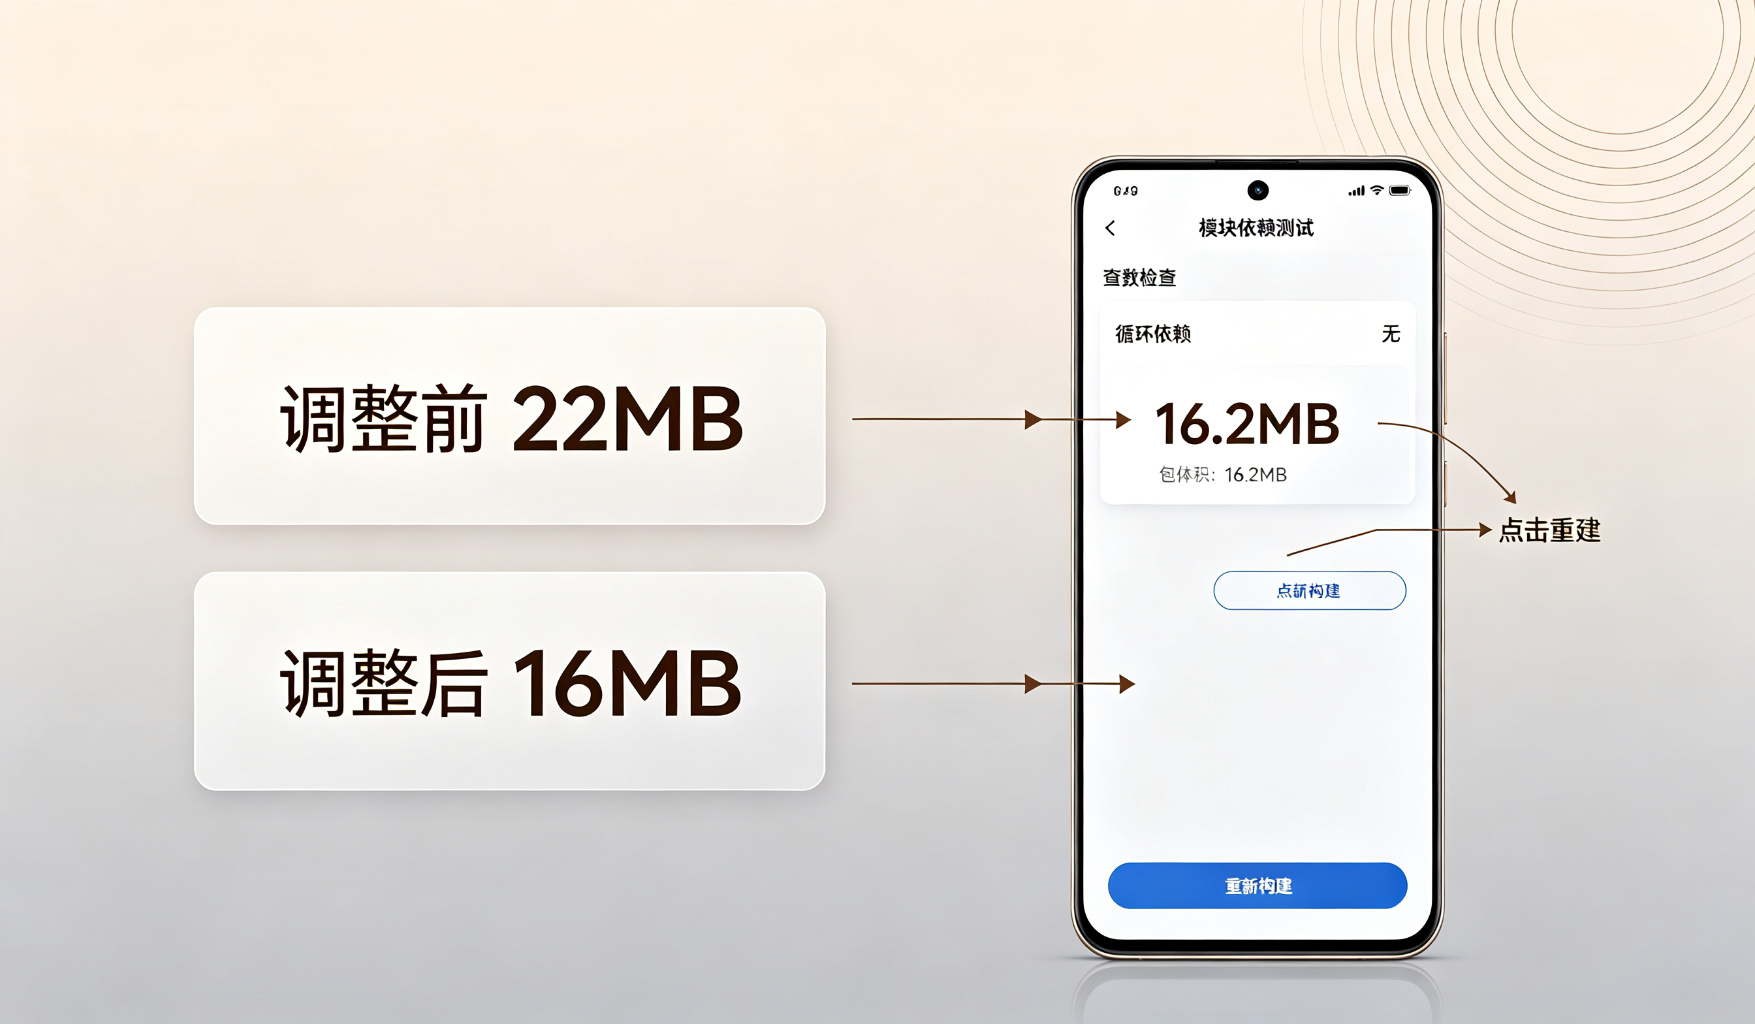
这次重构完最大的体会是:模块化不是目的,是手段。拆模块的时候不要只看目录好不好看,要看最终产物------包有没有变大、编译有没有变慢、模块之间有没有循环依赖。这些东西跑一下就知道,比纸上谈兵有用得多。