先给结论:如果 RAG 已经完成检索和重排,需要一个模型读长检索结果、回答问题并返回证据 ID,GLM-5.3-Flash 可以进入低成本 PoC 候选。本次在 15.9K、63.4K 和 127.1K Token 三档输入中,6 次有效响应全部找全 3 个答案和 3 个证据 ID;但 7 次请求里出现了 1 次 HTTP 200 但正文为空,上线前必须加响应校验和有界重试。
更新日期:2026 年 9 月 20 日
这次测的是 RAG 哪一段
企业知识库 RAG 至少包含五段:文档分块、Embedding、召回、重排、生成。
本文只测最后一段:
text
用户问题
  → 检索 / 重排(本次不测)
  → 长检索结果
  → GLM-5.3-Flash
  → 答案 + 证据 ID
因此,这不是一个"完整 RAG 准确率"评测。它回答的问题是:当检索层已经把候选内容交给生成模型时,模型能否在长上下文里找对事实、返回证据,以及这一步要花多少钱。
为什么看 GLM-5.3-Flash
Z.ai 官方信息显示,GLM-5.3-Flash 是 GLM-5 系列的原生多模态模型,总参数 320B、每 Token 激活 18B,长上下文可到 100 万 Token。官方说明中,它通过线性注意力与稀疏注意力的混合架构降低长上下文开销。
但"支持 100 万 Token"不等于"RAG 就应该每次塞 100 万 Token"。输入越长,延迟、成本和无关信息干扰都会增加。生产环境仍应优先做好分块、召回和重排。
实测怎么做
我用程序生成了三档虚构文档,分别在全文约 5%、50% 和 95% 位置埋入三条目标事实:
- 一个项目审批编码;
- 一个月度校验日期;
- 一个紧急回滚联络组名。
每条事实都有唯一的证据 ID。模型必须返回精确答案和对应 ID,不能靠语义相似蒙对。
调用参数固定为:
text
model = glm-5.3-flash
temperature = 0
reasoning_effort = low
max_tokens = 512
stream = true
每次记录 HTTP 状态、首个正文 Token 延迟、总耗时、usage、finish_reason、原始正文和精确命中数。
实测结果:127K 输入能找全,但有一次空响应
| 档位 | 请求数 | 可用正文 | 有效响应输入 Token | 答案+证据全命中 | 平均首字延迟 | 平均总耗时 |
|---|---|---|---|---|---|---|
| 短 | 2 | 2 | 15,905 / 15,912 | 2/2 | 6.60 s | 7.78 s |
| 中 | 3 | 2 | 63,420 / 63,420 | 2/2 | 7.06 s | 8.89 s |
| 长 | 2 | 2 | 127,062 / 127,062 | 2/2 | 13.24 s | 14.04 s |
可用响应的表现很整齐:6 次都找全了 3 个答案和 3 个证据 ID,包括放在文本末端的事实。
但中档第 1 次请求出现了一个不能忽略的异常:
text
HTTP status: 200
prompt_tokens: 67,234
completion_tokens: 0
content: ""
finish_reason: null
同档位后续两次都正常。这个小样本无法判定是模型、路由还是流式传输问题,但已经足够说明:企业 RAG 客户端不能把 HTTP 200 当作唯一成功条件。
一次 127K 长文本大约多少钱
截至 2026 年 9 月 20 日,算桥 API (api.suanjiayun.com) 的 GLM-5.3-Flash 模型页显示折扣价:
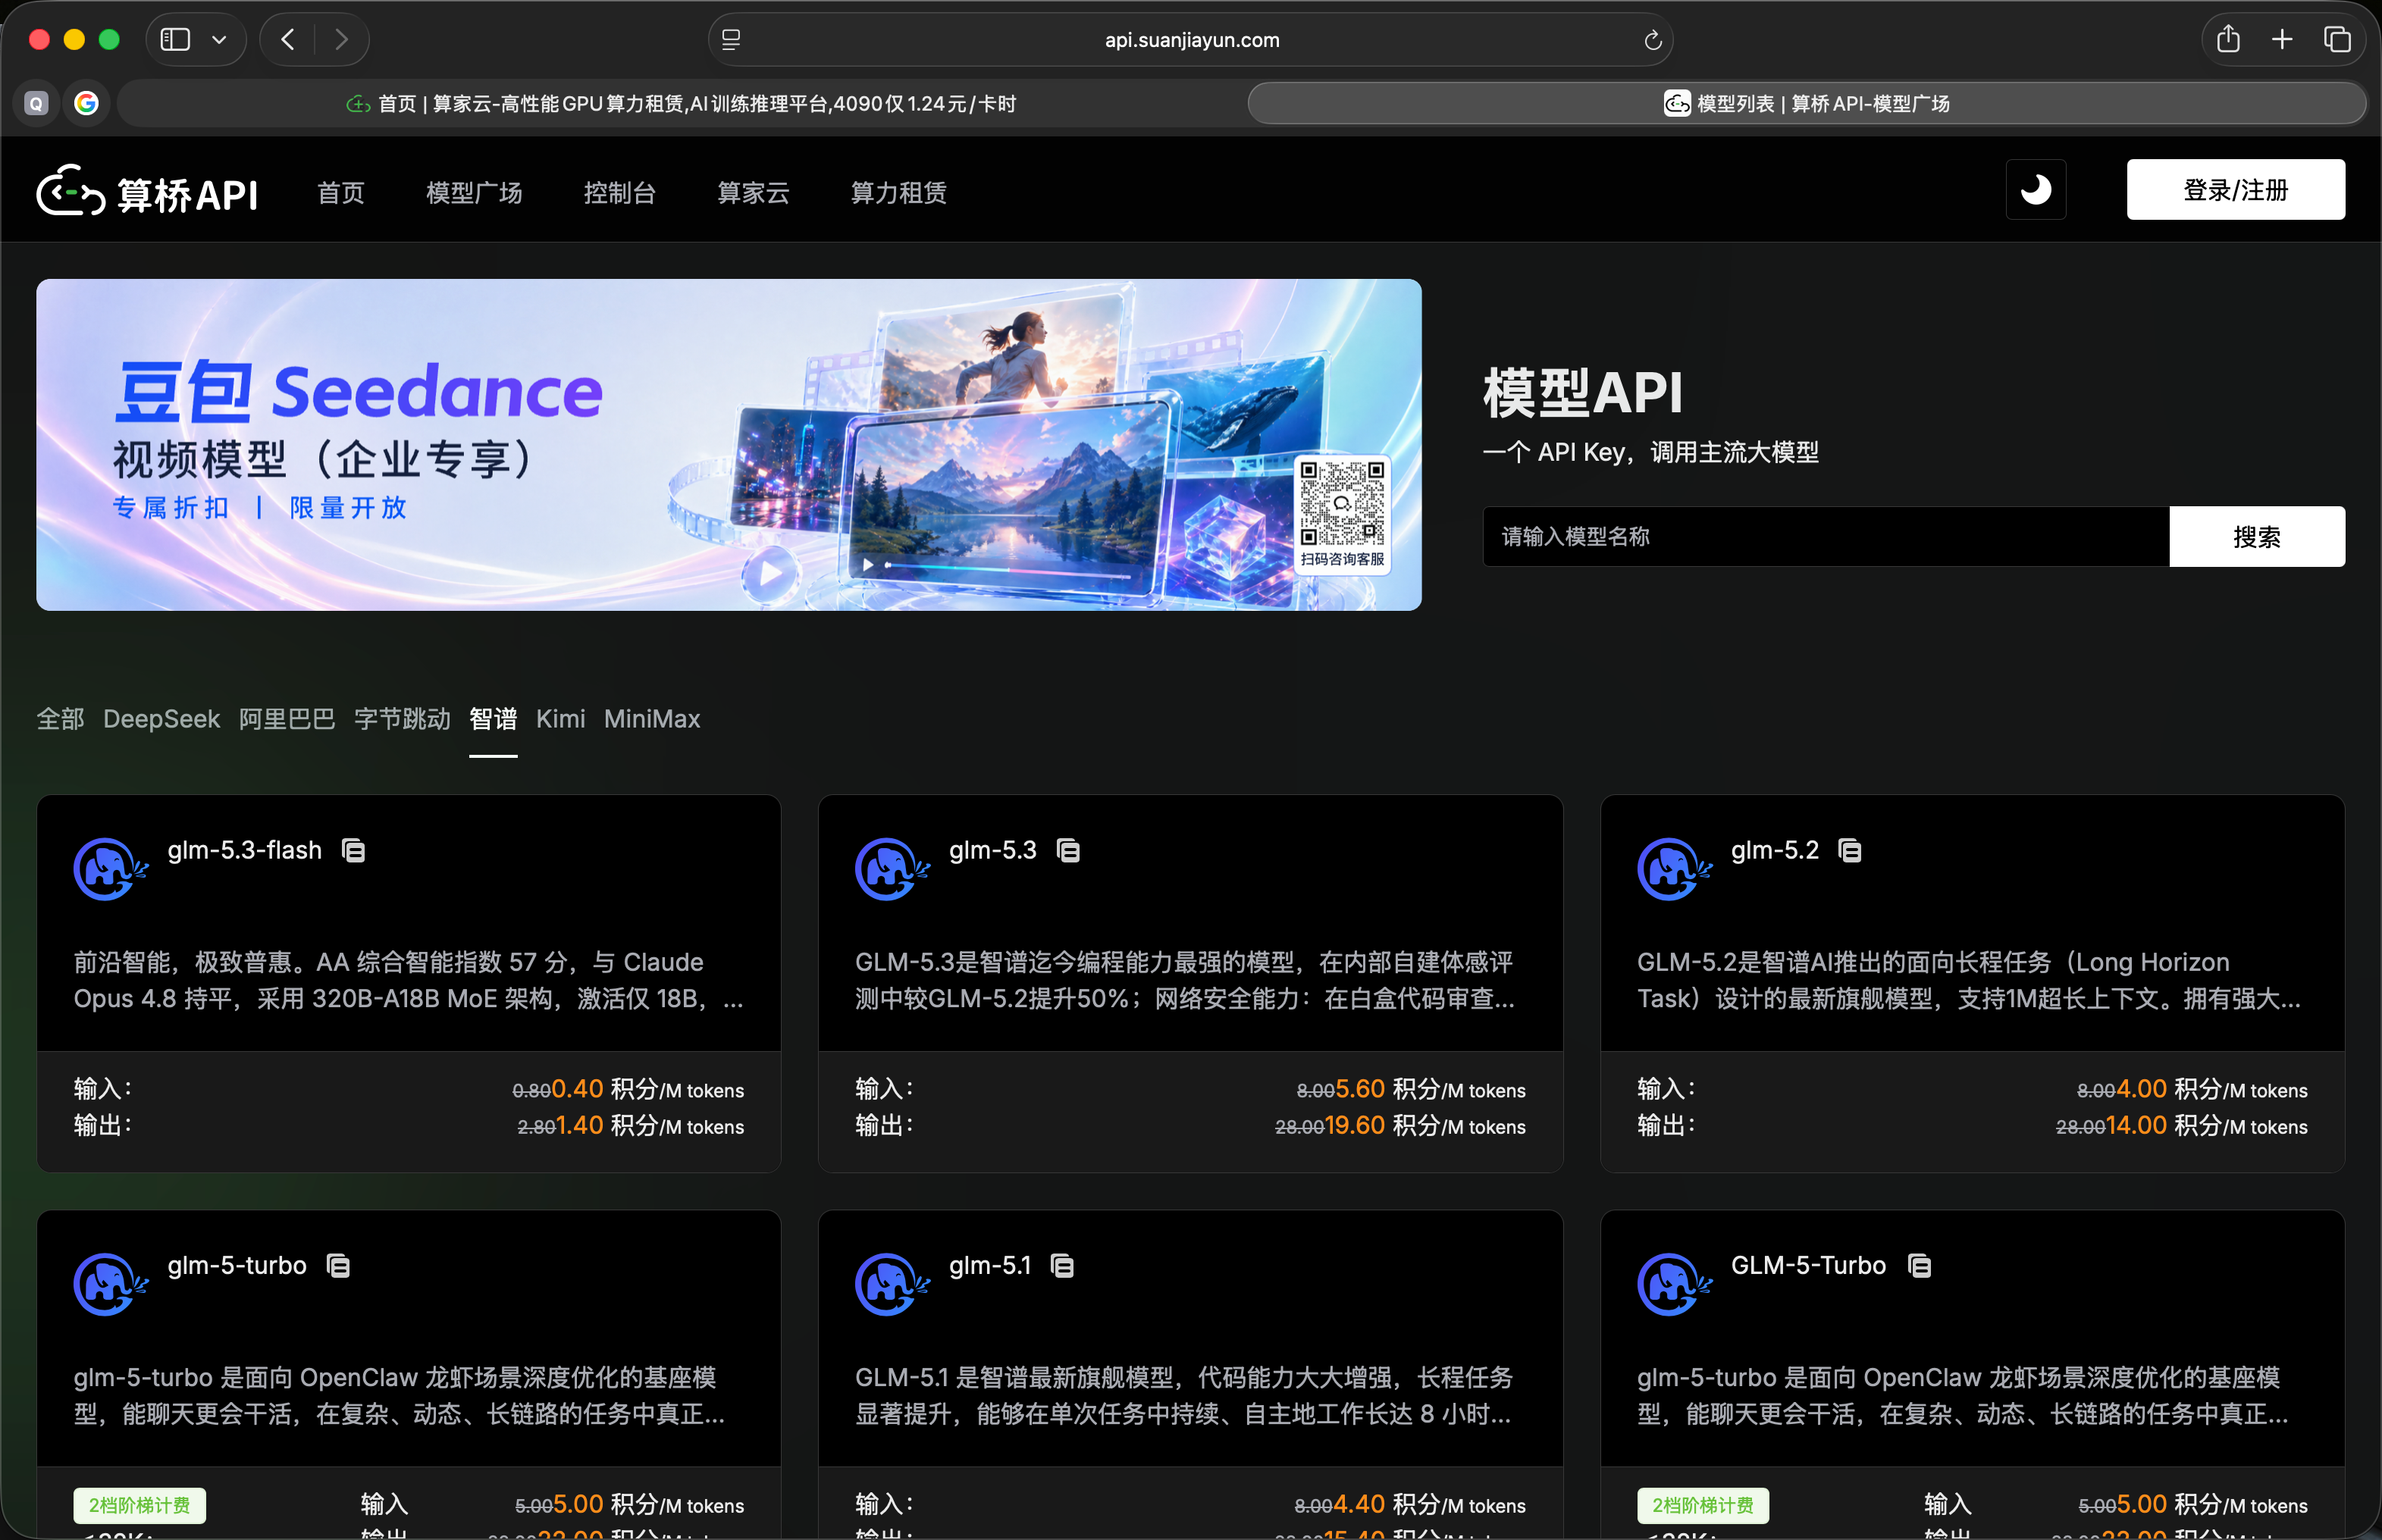
| 项目 | 折扣价 |
|---|---|
| 输入 | 0.40 元/M tokens |
| 命中缓存的输入 | 0.115 元/M tokens |
| 输出 | 1.40 元/M tokens |
本批有效请求没有命中缓存。按页面单价和 usage 估算:
| 档位 | 单次估算成本 |
|---|---|
| 约 15.9K 输入 | 约 0.0065 元 |
| 约 63.4K 输入 | 约 0.0256 元 |
| 约 127.1K 输入 | 约 0.0509 元 |
这是按页面单价做的估算,不等同实际账单,也没包括空响应后的重试成本、Embedding、重排器、向量库和日志存储。
同一页面中,完整版 GLM-5.3 的折扣价是输入 5.60 元/M tokens、输出 19.60 元/M tokens。按本次 127,062 输入 Token 与平均 86 输出 Token 估算,GLM-5.3-Flash 约 0.0509 元,GLM-5.3 约 0.7132 元,前者约为后者的十四分之一。
这只说明同一 GLM 家族、当日价格下的输入成本差异,不能推导出 GLM-5.3-Flash 是全市场最便宜的 RAG 模型。
以算桥 API (api.suanjiayun.com) 为例操作演示
最小调用可以使用 OpenAI Python SDK。密钥放在环境变量,不要写进源码:
bash
export SUANJIAYUN_API_KEY="<your-api-key>"
python -m pip install openai
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["SUANJIAYUN_API_KEY"],
    base_url="https://api.suanjiayun.com/v1",
)

retrieved_context = """
[KB-00417] 星河项目变更管理:高风险变更必须引用审批编码 XH-APPROVAL-7319。
""".strip()

response = client.chat.completions.create(
    model="glm-5.3-flash",
    temperature=0,
    max_tokens=512,
    messages=[
        {
            "role": "user",
            "content": f"""只能根据检索结果回答,并返回证据 ID。

问题:星河项目的高风险变更需要哪个审批编码?

检索结果:
{retrieved_context}
""".strip(),
        }
    ],
)

content = response.choices[0].message.content or ""
finish_reason = response.choices[0].finish_reason

if not content.strip() or finish_reason not in {"stop", "length"}:
    raise RuntimeError("empty or incomplete model response")

print(content)
print(response.usage)
这段代码只做最小调用。生产环境还应补上:
- JSON Schema 或类型校验;
- 证据 ID 必须存在于本次检索结果;
- 空响应、超时和 429/5xx 的有界退避重试;
- 请求 ID、模型 ID、Token、延迟和原始响应留档;
- 不将用户权限交给模型判断,先在检索层过滤可见文档。
为什么"严格 JSON"仍然要做解析防守
本次 6 个有效响应中,3 个直接返回 JSON 数组,另外 3 个在 JSON 外面包了 Markdown 代码栏。
这意味着,即使提示词已经写了"输出严格 JSON",也不能直接把正文交给 json.loads() 后入库。更稳妥的方法是:
- 优先验证当前调用链路是否真正支持结构化输出;
- 不支持时,去除允许的代码栏后再解析;
- 解析后继续校验字段、类型、数量和证据 ID;
- 失败时返回可观测错误,不要静默写入空答案。
什么情况适合,什么情况先别用
适合先做 PoC 的场景:
- 长手册、规章、项目文档的证据型问答;
- 需要返回文档 ID、分块 ID 或引用位置;
- 输入长、输出短,对输入 Token 价格敏感;
- 已经具备召回、重排、响应校验和重试能力。
需要先停下来补工程的场景:
- 希望靠超长上下文替代召回和重排;
- 答案错了会直接触发付款、删除、审批或权限变更;
- 没有文档级权限隔离和审计日志;
- 对空响应、格式偏移和引用幻觉没有处理。
最后的选型建议
如果你正在给企业知识库选生成模型,不要只问"每百万 Token 多少钱"。先固定一套本企业可公开或已脱敏的验收集,同时记录:
text
答案正确率
证据 ID 正确率
拒答准确率
空响应率
格式合格率
P50 / P95 延迟
每次成功答案的完全成本
GLM-5.3-Flash 在这次小样本中显示了低输入成本和 127K 文本内的精确证据抽取能力,但空响应与格式偏移同样是真实结果。更合理的下一步不是直接全量切换,而是用 50~200 条真实但已脱敏的问答做小流量 PoC,再决定是否进入生产。
FAQ
GLM-5.3-Flash 是不是企业 RAG 最便宜的模型?
不能这样下结论。本文只核验了它与完整版 GLM-5.3 在当日算桥 API 页面的价格差异,并对 GLM-5.3-Flash 做了长文本小样本测试。要回答"最便宜",必须用同一语料和同一验收标准对更多模型测试。
有 100 万 Token 上下文,还需要向量检索吗?
需要。长上下文是容量上限,不是取消检索工程的理由。更短、更相关的上下文通常更容易控制延迟、成本和干扰。
RAG 应该只看答案是否正确吗?
不应该。至少还要检查证据 ID、拒答、格式、空响应、延迟和每次成功答案的完全成本。
命中缓存输入一定能按 0.115 元/M tokens 计费吗?
不能先假设一定命中。缓存键、保留时间、请求前缀稳定性与平台计费细则都会影响结果。本次有效请求的 usage 均未报告缓存命中。
HTTP 200 为什么还要重试?
因为 HTTP 200 只说明请求在 HTTP 层成功。本次实测就出现过一次 200 但正文为空、completion_tokens=0、finish_reason 缺失的情况。业务层仍需完整性校验和有界重试。