小肥柴的Hadoop之旅 快速实验篇(A10)短序列上 SPI 的失效机制
目录
- 前言
- 关于实验编号的说明
- [0. 背景知识:从 A5 的方法学反思说起](#0. 背景知识:从 A5 的方法学反思说起)
- [1. 任务概述与目标](#1. 任务概述与目标)
- [2. 两种 SPI 的计算方法](#2. 两种 SPI 的计算方法)
- [3. 理论验证:框架正确性](#3. 理论验证:框架正确性)
- [4. 数值层面:两种 SPI 高度一致,但都压缩](#4. 数值层面:两种 SPI 高度一致,但都压缩)
- [5. 等级层面:极端等级识别的失效](#5. 等级层面:极端等级识别的失效)
- [6. 事件层面:对参数的极度敏感性](#6. 事件层面:对参数的极度敏感性)
- [7. 机制分析:零值比例是主因](#7. 机制分析:零值比例是主因)
- [8. 方法论讨论](#8. 方法论讨论)
- [9. 阶段总结](#9. 阶段总结)
前言
本文是"农业气象干旱分析"项目的第十阶段(A10)。在 A5 完成干旱等级划分、A6 完成事件识别、A8 完成 Gamma 拟合之后,一个方法论问题逐渐浮现,即我们所用的方法在这个数据上是否依然成立。
具体而言,A5 采用站内百分位方法划分干旱等级,A8 采用 Gamma 分布拟合降水形态,两者都建立在一系列假设之上。A10 的任务是以 SPI(标准化降水指数)作为独立的方法论对照,检验这些假设在 90 天日尺度且零值比例较高的数据条件下是否成立。
实验揭示了三个反直觉的结果。第一,两种 SPI(标准 Gamma 与经验)的数值高度一致,说明换用不同的 CDF 估计方式并不能解决问题。第二,两种 SPI 都出现了系统性的压缩,标准差只有 0.78 至 0.80,而理论值为 1.0,极端等级几乎识别不出。第三,压缩程度与零值比例的 Spearman 相关系数达到 0.9990,说明失效不是拟合误差导致的,而是零值离散化的固有特性。
最终结论是,SPI 与 A5 的百分位方法不可互换。A6 报告中"约 4% 的站点发生过连续 ≥15 天中旱以上事件"的结论,是 A5 方法定义的产物,不是降水的客观属性。
关于实验编号的说明
本项目交接文档中原计划 A10 做"SPI 等级划分与 A5 对照",A11 做"经验 SPI 与标准 SPI 的系统对比"。在设计阶段,我们发现原计划存在两个问题。
第一个问题是原 A10 缺少仲裁者。A5 的干旱等级本身也是站内百分位方法,并不是"真值"。用 SPI 与 A5 对照,实际上是两个非真值互相比较,无法判断哪一个更准确。
第二个问题是原 A11 才是方法论核心。"经验 SPI 与标准 SPI"的对比具有明确的可比性,因为两者都是 SPI,区别仅在于 CDF 的估计方式。这个对比能够回答 Gamma 假设在短序列上是否成立。
因此,本文将原 A10 与原 A11 合并为新的 A10。原 A10 关注的"等级划分对比"并入本文第 5 节,原 A11 的"经验与标准对比"并入本文第 2 节与第 4 节。原 A10 和 A11 的编号不再单独使用,后续实验从 A12 起编号。
0. 背景知识:从 A5 的方法学反思说起
0.1 A5 的百分位方法
A5 的干旱等级划分方法是对每个站点的 90 天降水值做站内百分位排序,然后按照 60%、10%、10%、10%、10% 的比例切成五档。
| 等级 | 天数 | 占比 |
|---|---|---|
| 无旱 | 54 | 60% |
| 轻旱 | 9 | 10% |
| 中旱 | 9 | 10% |
| 重旱 | 9 | 10% |
| 特旱 | 9 | 10% |
这种方法的好处是每个等级都有固定比例,极端等级(重旱与特旱)保证能够被识别出来。问题在于所有站点的干旱结构完全一样,无论是湿润的西雅图还是干旱的凤凰城,都有 9 天特旱。
A6 报告已经发现了这一点,原文如下:
由于 A5 用的是站内百分位数方法,所有站点的数据又是固定的 90 天,导致干旱结构在全站点之间几乎一模一样。
0.2 标准 SPI 的定义
SPI(Standardized Precipitation Index)是国际通用的干旱指数,其标准定义包含三个步骤。第一,对每个站点的月降水累计序列(通常要求 30 年以上)拟合 Gamma 分布。第二,用混合 CDF H(x) = q + (1-q)·GammaCDF(x) 将降水值映射到概率空间。第三,通过逆正态变换 SPI = norm.ppf(H(x)) 得到标准化值。
SPI 的等级划分基于绝对阈值,即 SPI ≤ -1.0 为中旱,SPI ≤ -1.5 为重旱,SPI ≤ -2.0 为特旱。
0.3 本项目的数据条件
| 项 | 标准 SPI 要求 | 本项目实际 |
|---|---|---|
| 时间尺度 | 月度累计 | 日降水值 |
| 序列长度 | 30 年以上,即 360 个月以上 | 90 天 |
| 每站样本量 | 360 以上 | 90 |
| 零值比例 | 通常低于 10% | 中位数 25.6% |
这些差异意味着 A10 计算出的 SPI 严格来说不是"标准 SPI",而是"90 天日尺度的缩短 SPI"。报告里必须明确这一点。
0.4 一个预先已知的线索
A9-2 试跑阶段(方案 B)曾用 1000 站小样本测试过标准 SPI,结果如下:
| 指标 | 实测中位数 | 理论期望 |
|---|---|---|
| SPI 均值 | +0.13 | 0 |
| SPI 标准差 | 0.79 | 1.0 |
SPI 的均值和标准差都偏离了理论值。这个现象当时没有深究,但它构成了 A10 的直接动机。
1. 任务概述与目标
| 项目 | 说明 |
|---|---|
| 定位 | 承接 A5、A6、A8 的方法论基础,用 SPI 作为独立对照,检验这些方法在短序列与高零值数据上的可靠性 |
| 目标 | 第一,计算标准 Gamma SPI 与经验 SPI 的全量序列。第二,在数值层面对比两种 SPI 的差异。第三,在等级层面对比极端等级的识别能力。第四,在事件层面对比 A6 的事件识别结果。第五,进行归因分析,明确压缩与哪些站点特征相关 |
| 输入 | A8 的 Gamma 参数(102,395 站)与 A9 的原始 PRECTOT 序列(102,395 站) |
| 输出 | 两种 SPI 的 90 天序列(各 85 MB)、汇总统计、对比表、10 张可视化图 |
| 验证 | 理论验证(完美 Gamma 数据上两种方法一致),以及数值一致性(相关系数大于 0.99) |
核心问题是,SPI 在 90 天日尺度且零值比例约 25% 的数据上会发生什么。
2. 两种 SPI 的计算方法
2.1 标准 Gamma SPI
对每站的 90 天序列 p = [p_1, ..., p_90],计算方式如下:
H(x) = q + (1-q) * GammaCDF(x; α, β)
SPI_std = norm.ppf(H(x))
其中 α、β、q 都直接取自 A8 的拟合结果。
2.2 经验 SPI
经验 SPI 采用混合模型与 Gringorten 公式。它与标准 SPI 的唯一区别在于非零部分的 CDF 估计方式。
零值部分:  H = q
非零部分:  H = q + (1-q) * (rank - 0.44) / (n_nonzero + 0.12)
SPI_emp = norm.ppf(H)
其中 q 使用观测零值比例,与标准 SPI 保持一致。rank 是 Gringorten 公式计算的平均秩。
2.3 关键设计:两侧统一零值处理
两种 SPI 的零值部分使用同一个 q。这样做的目的是让差异纯粹来自非零部分的 CDF 估计方式,即参数化估计与经验估计之间的区别,而不掺杂零值处理方式本身带来的差异。
2.4 计算产出
全量 102,395 站的标准 SPI 计算耗时 109 秒,经验 SPI 耗时 136 秒。两个 85 MB 的序列文件,每站保存 90 个逗号分隔值,是后续所有分析的基础。
3. 理论验证:框架正确性
3.1 完美 Gamma 数据上的对比
在跑全量之前,先做一个理论验证。生成 100 个完美服从 Gamma 分布的模拟站,使用真值参数,分别计算标准 SPI 和经验 SPI,观察两者是否一致。
| 指标 | 中位数 | 通过标准 | 判定 |
|---|---|---|---|
| mean_abs_diff | 0.0662 | 小于 0.5 | 通过 |
| max_abs_diff | 0.4025 | 小于 1.5 | 通过 |
| corr_std_emp | 0.9952 | 大于 0.95 | 通过 |
结论是框架正确。当数据完美服从 Gamma 时,两种 SPI 高度一致,差异只来自 90 个样本的经验 CDF 估计误差。
3.2 一个次要发现
即使数据完美服从 Gamma,并且使用真值参数,SPI 的均值也不为 0,标准差也不为 1。
| 指标 | 理论值 | 实测中位数 |
|---|---|---|
| SPI 均值 | 0 | +0.186 |
| SPI 标准差 | 1 | 0.786 |
原因在于 90 天序列里约有 25% 的零值,这些零值全部映射到同一个 SPI 值。这相当于把分布的一部分压缩成了一个点,导致方差压缩、均值抬高。
这个发现为后续的全量分析埋下了伏笔。
4. 数值层面:两种 SPI 高度一致,但都压缩
4.1 数值分布对比
全量 102,395 站的两种 SPI 序列对比如下:
| 指标 | 标准 SPI | 经验 SPI |
|---|---|---|
| spi_mean 中位数 | +0.1227 | +0.1515 |
| spi_std 中位数 | 0.8006 | 0.7843 |
| spi_zero_mean | -0.6571 | -0.6571 |
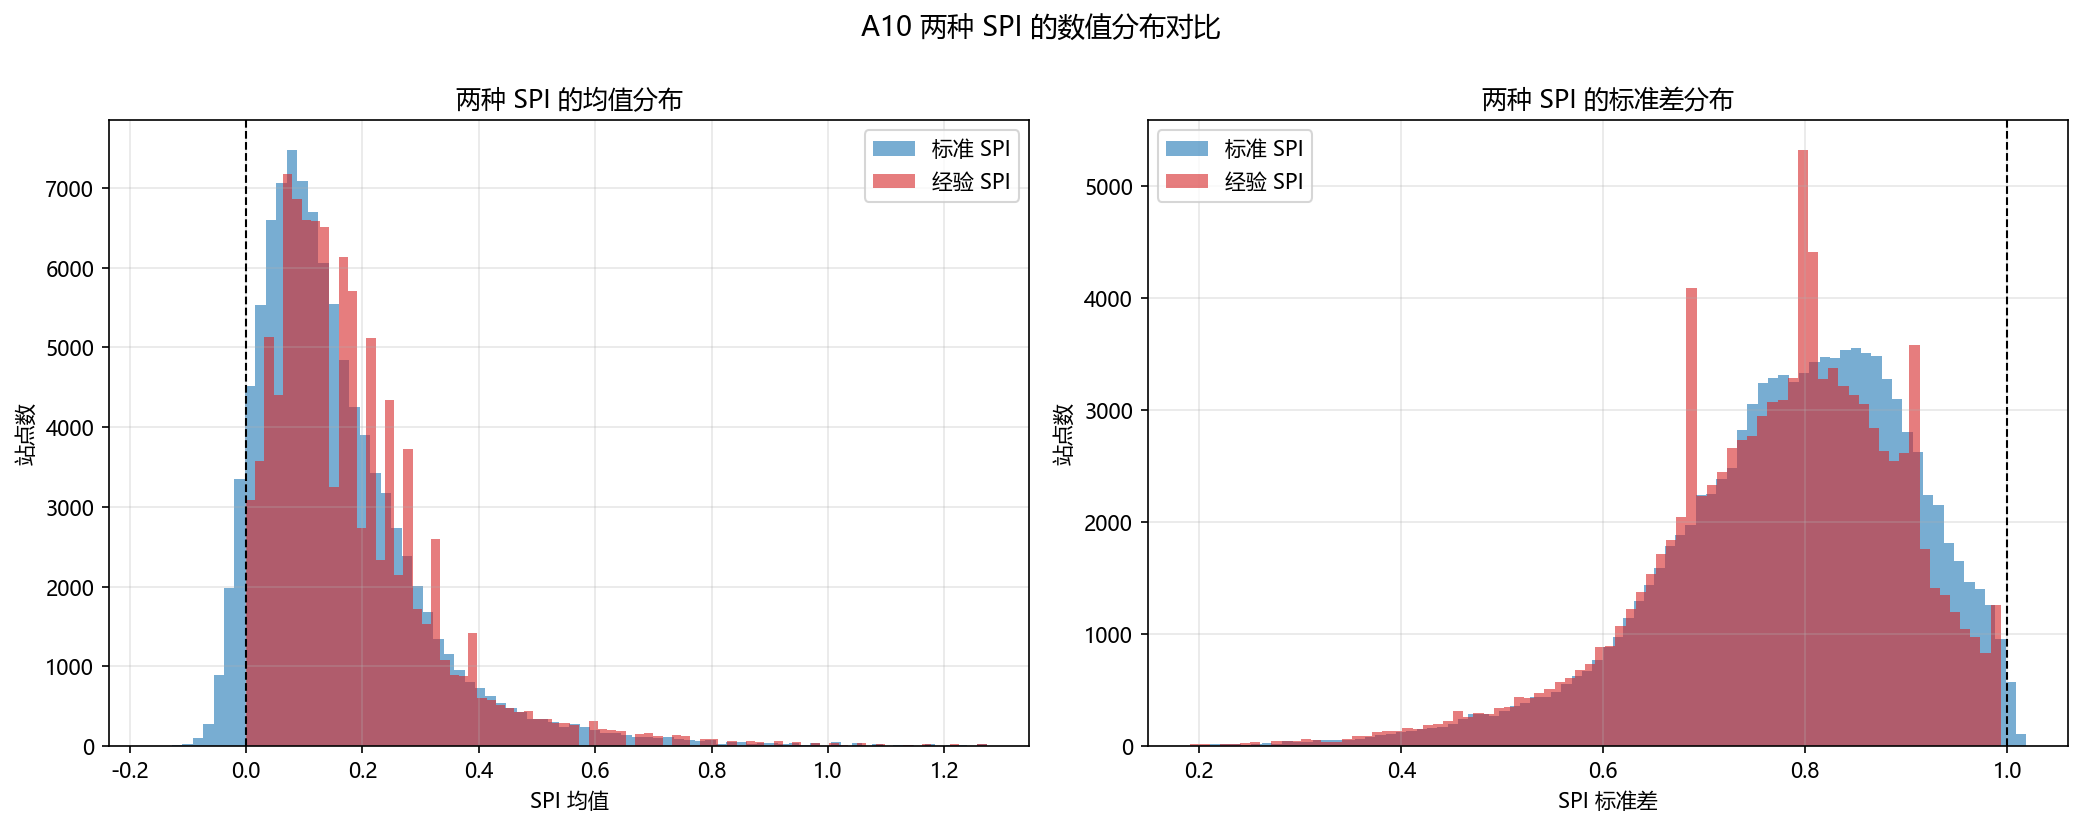
【图 1 】a10_dist_compare.png。左图为两种 SPI 的均值分布,右图为两种 SPI 的标准差分布。两张图都显示两种 SPI 高度重合。
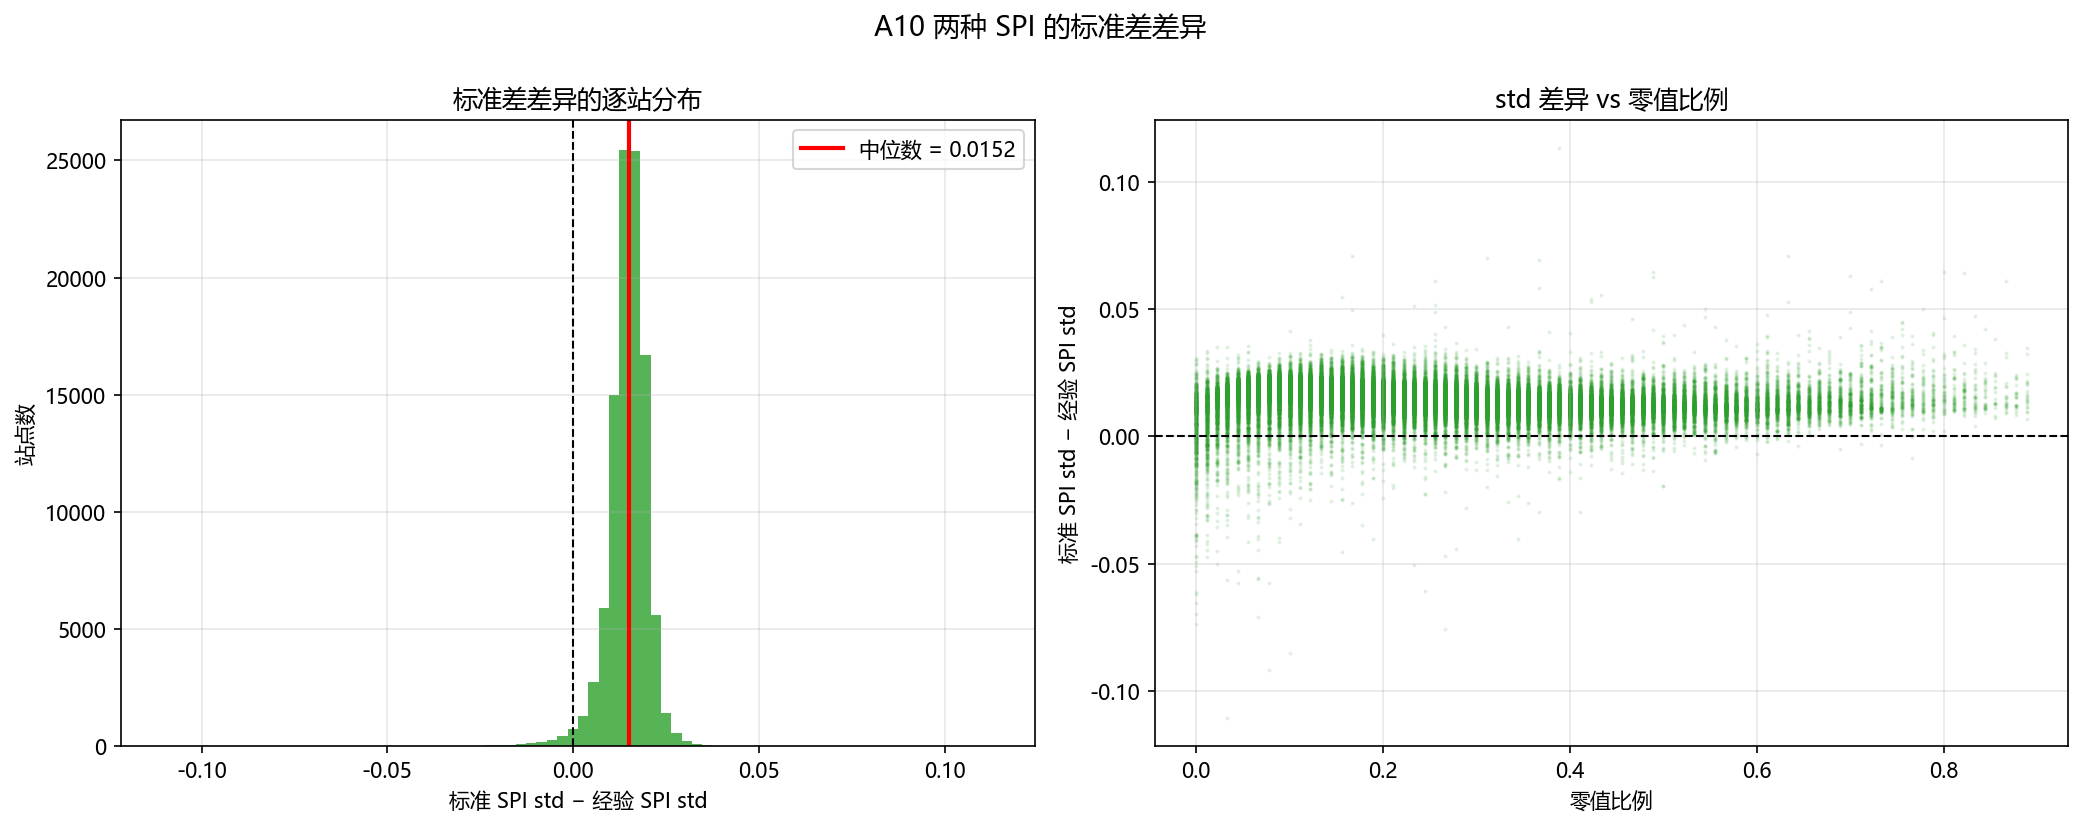
【图 2】a10_std_diff_dist.png。左图为标准差差异的逐站分布,右图为标准差差异与零值比例的关系。
4.2 逐站差异
抽样 5,000 站进行逐日对比,结果如下:
| 指标 | 中位数 | 含义 |
|---|---|---|
| corr_std_emp | 0.9906 | 两种 SPI 序列几乎重合 |
| mean_abs_diff | 0.0738 | 平均每站每天相差 0.07 |
| max_abs_diff | 0.3562 | 最极端的日子相差 0.36 |
标准差差异为正的站点占比达到 98.4%,说明标准 SPI 的标准差系统性高于经验 SPI。这是一个真实的系统性差异,不是噪声。
4.3 零值离散化的视觉指纹
图 1 右图暴露了一个细节。经验 SPI 的标准差分布出现了几个垂直尖峰,位置大约在 0.68、0.80、0.92 附近。这是零值离散化的直接视觉证据。由于 n_zero 是整数,SPI_zero = norm.ppf(n_zero/90) 只能取 91 个离散值,导致不同零值天数的站点给出离散的标准差值。
这不是 bug,是短序列与零值共同作用下的固有特性。
4.4 关键数字
两种 SPI 的数值高度一致,相关系数达到 0.99,说明换方法解决不了问题。两种 SPI 的标准差都系统性低于理论值 1.0,实际落在 0.78 至 0.80 之间,即两者都压缩。差异来自零值离散化,不是 Gamma 拟合误差。
5. 等级层面:极端等级识别的失效
5.1 等级分布对比
按照标准 SPI 阈值(0、-1.0、-1.5、-2.0)划分 5 个等级,统计每站的等级分布。
| 等级 | 理论天数(90 天中) | 标准 SPI | 经验 SPI |
|---|---|---|---|
| 无旱 | 45.0 | 42.0 | 45.0 |
| 轻旱 | 30.7 | 47.0 | 45.0 |
| 中旱 | 8.3 | 0.0 | 0.0 |
| 重旱 | 4.0 | 0.0 | 0.0 |
| 特旱 | 2.1 | 0.0 | 0.0 |
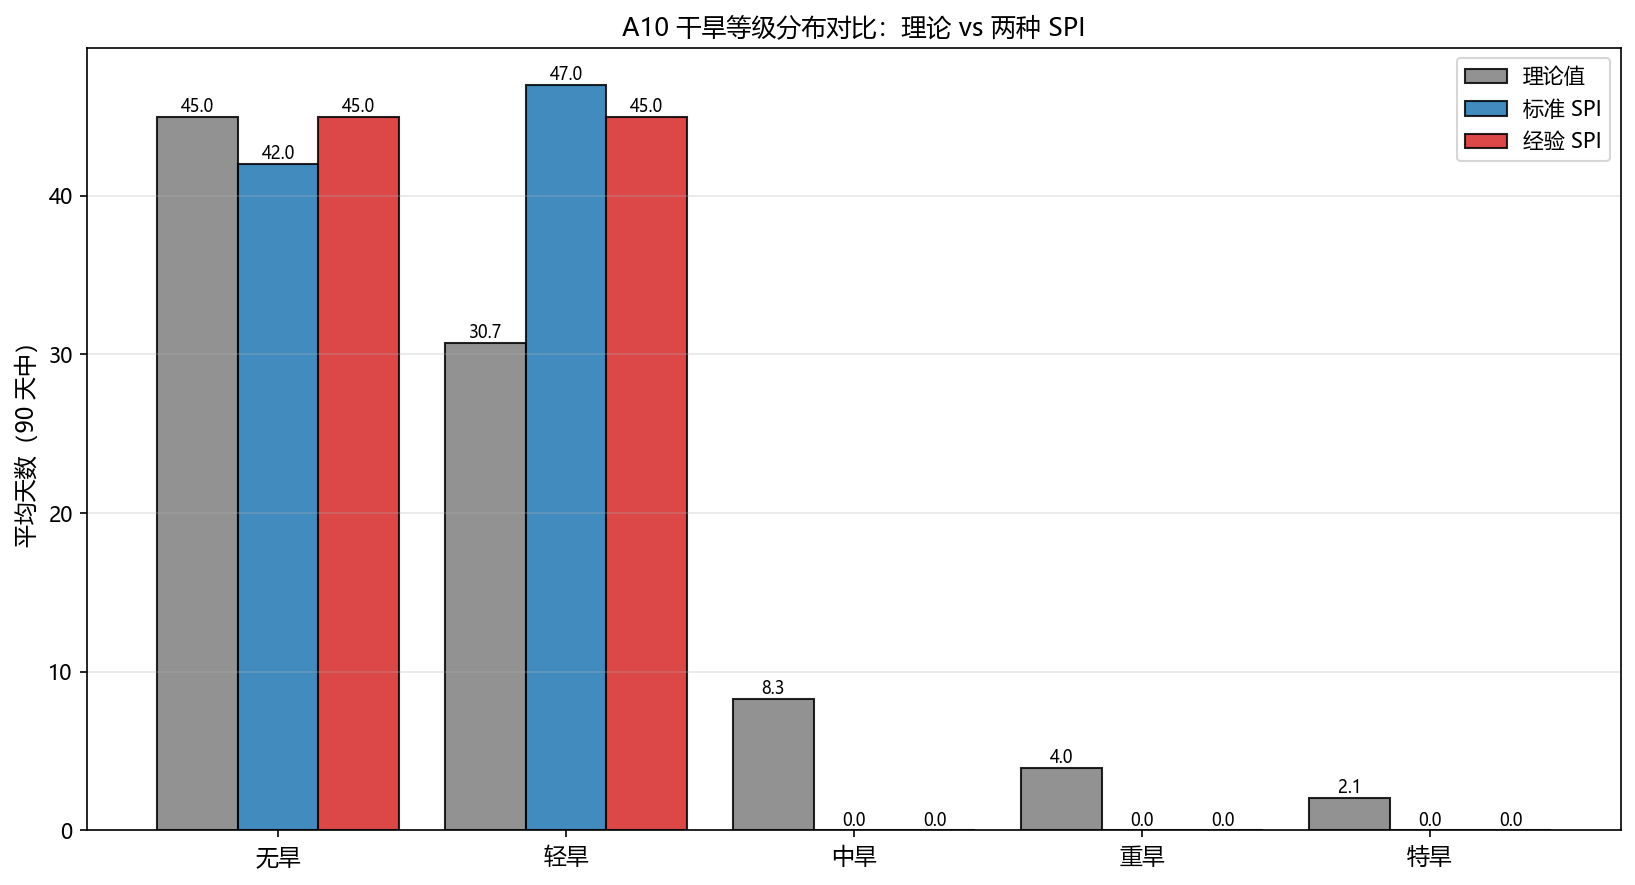
【图 3 】a10_level_dist.png。等级分布对比图中,中旱及以上的三根柱子完全缺失,这是 SPI 极端等级识别失效的直接视觉证据。
中旱实测占 3.0%,理论值为 9.2%。特旱实测占 0.03%,理论值为 2.3%。等级越极端,压缩越严重。
5.2 一致性矩阵
抽样 5,000 站进行逐日对比,共 450,000 格,归一化到行后结果如下。
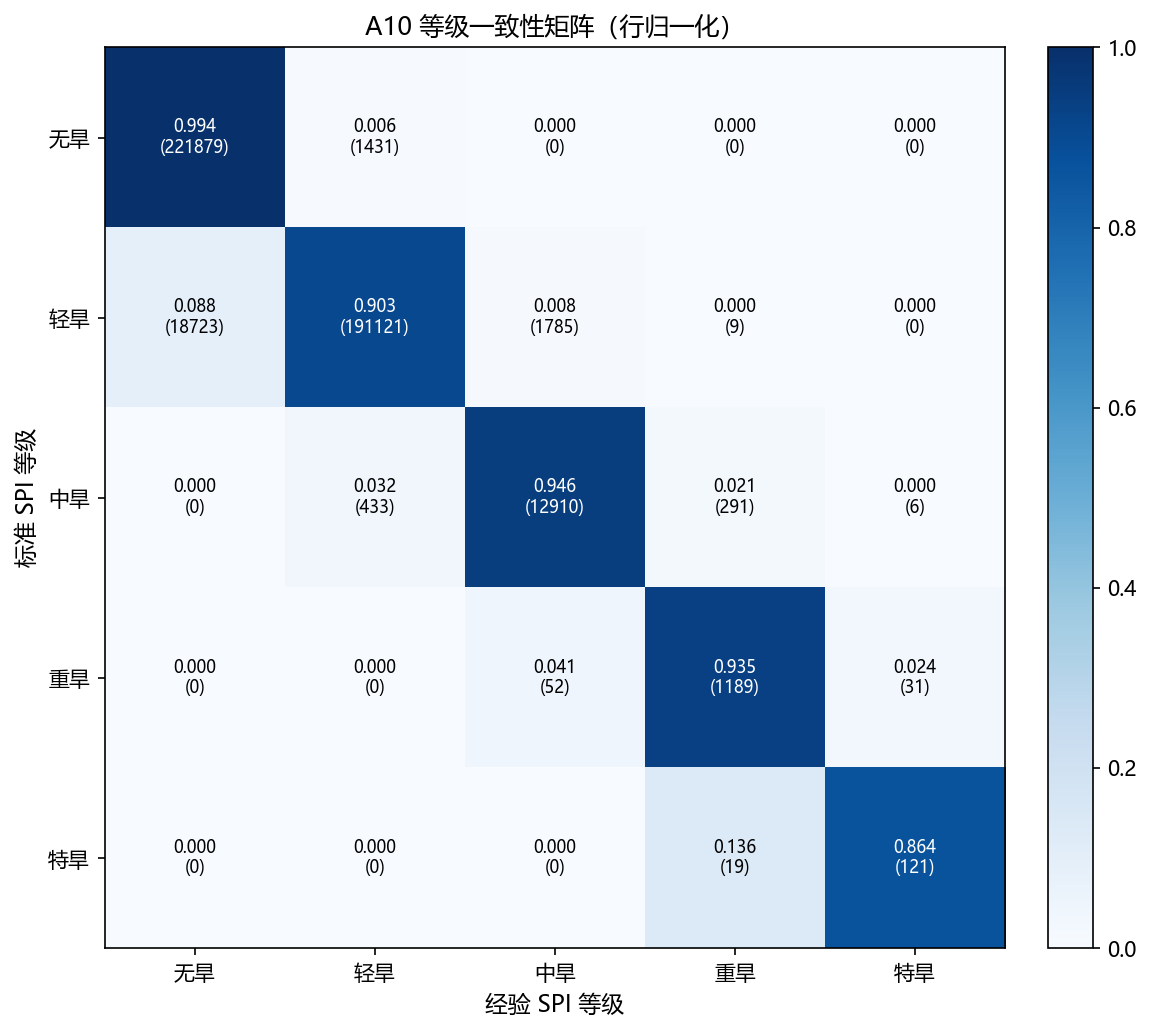
【图 4 】a10_level_matrix.png。等级一致性矩阵(行归一化)。
| 标准等级 \ 经验等级 | 无旱 | 轻旱 | 中旱 | 重旱 | 特旱 |
|---|---|---|---|---|---|
| 无旱 | 0.994 | 0.006 | 0 | 0 | 0 |
| 轻旱 | 0.088 | 0.903 | 0.008 | 0 | 0 |
| 中旱 | 0 | 0.032 | 0.946 | 0.021 | 0 |
| 重旱 | 0 | 0 | 0.041 | 0.935 | 0.024 |
| 特旱 | 0 | 0 | 0 | 0.136 | 0.864 |
总体一致率为 94.94%。差异集中在"轻旱到无旱"这一边界,共 18,723 格,占 4.2%。标准 SPI 的均值偏正,因此更容易判为轻旱。中旱以上两版几乎完全一致。
5.3 一个必要的澄清
等级分布上的"中旱以上全为 0"是站点中位数。大部分站的中旱以上天数是 0,所以中位数被拉成 0。从矩阵看,全量 45 万格中,中旱以上实际占 3.34%,并不是真的为 0。
6. 事件层面:对参数的极度敏感性
6.1 事件识别对齐
A6 的事件定义是"连续 ≥15 天且等级达到中旱及以上"。在 A5 百分位方法下,这等价于"连续 ≥15 天且降水处于站内底部 30%"。
对齐阈值取 SPI ≤ norm.ppf(0.30) = -0.5244。
| 方法 | 有事件站 | 占比 |
|---|---|---|
| A6(A5 百分位) | 4,074 | 3.98% |
| 标准 SPI | 154 | 0.15% |
| 经验 SPI | 107 | 0.10% |
两者相差 26 倍。
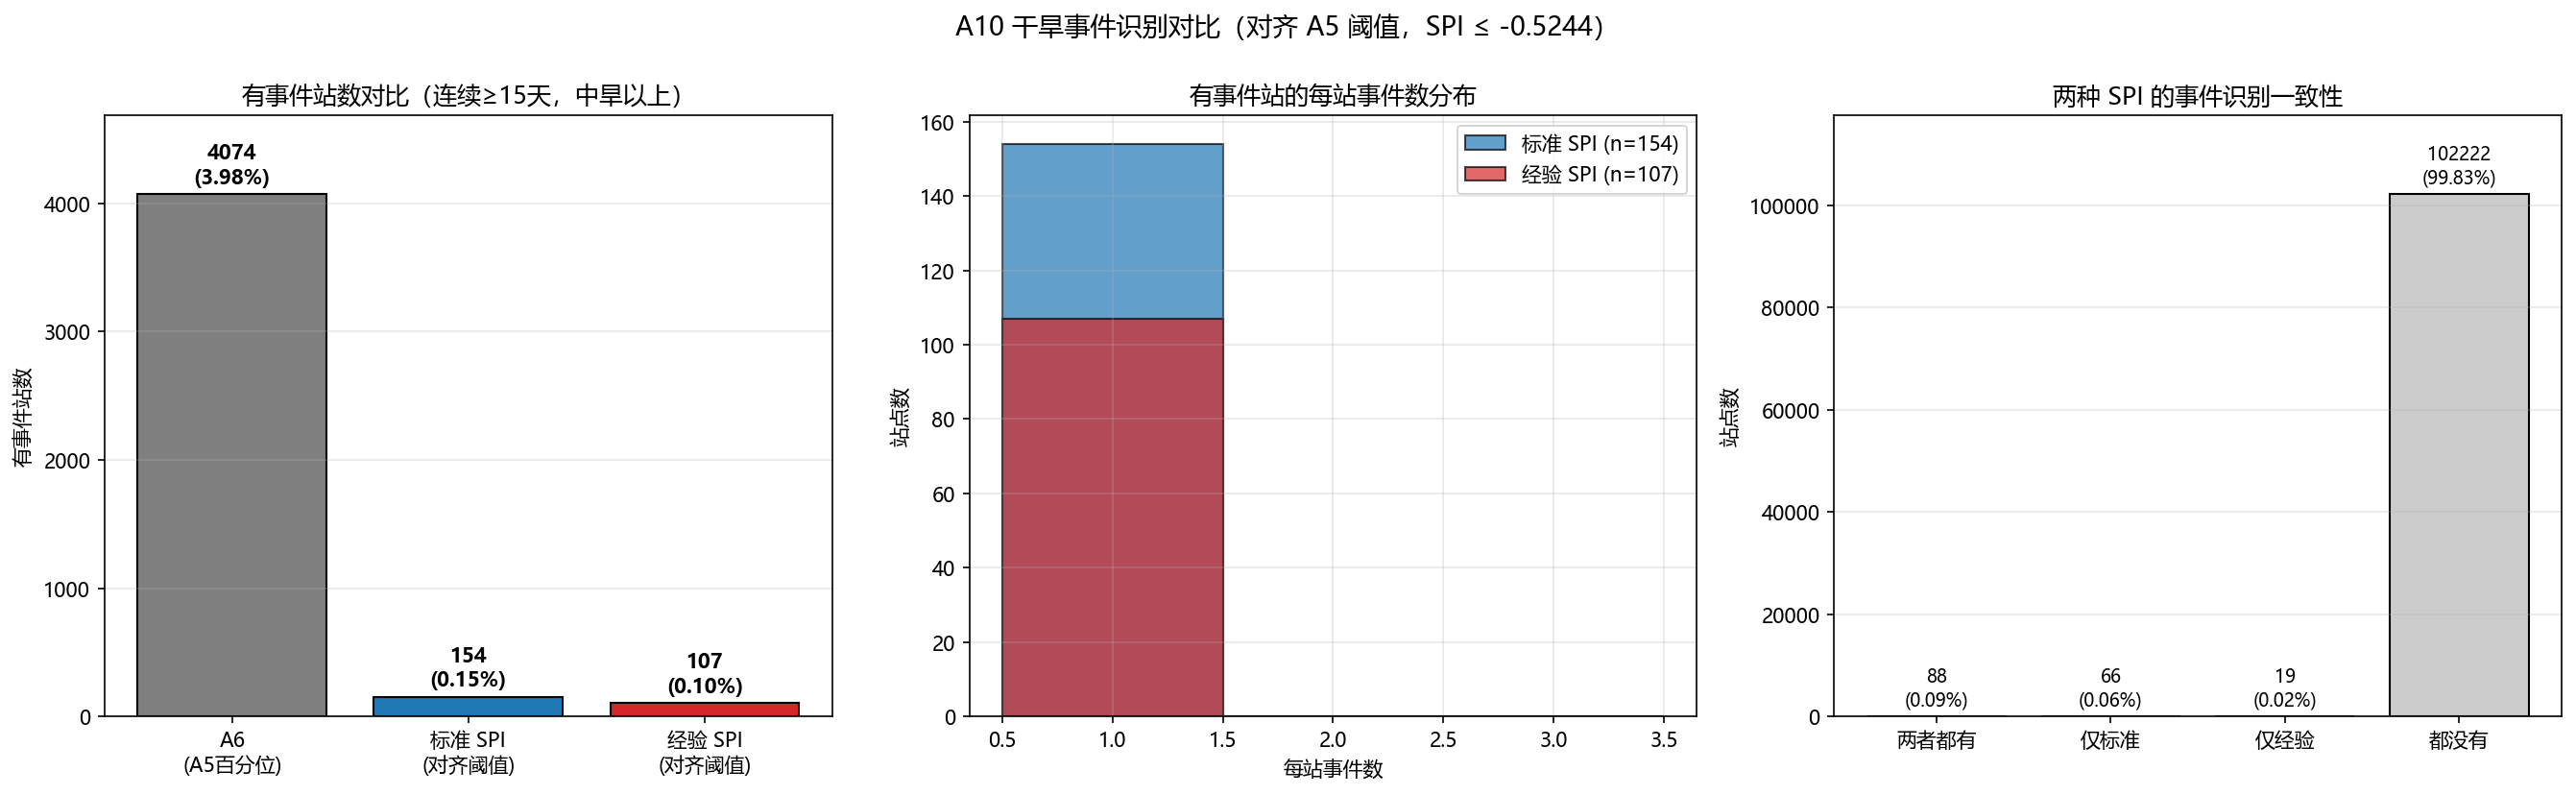
【图 5 】a10_event_dist_v2.png。左图为有事件站数对比,中图为每站事件数分布,右图为两种 SPI 的事件一致性。可以看到 99.83% 的站点都无事件。
6.2 阈值敏感性网格
扫描 7 个 SPI 阈值与 6 个连续天数,共 42 个参数组合。
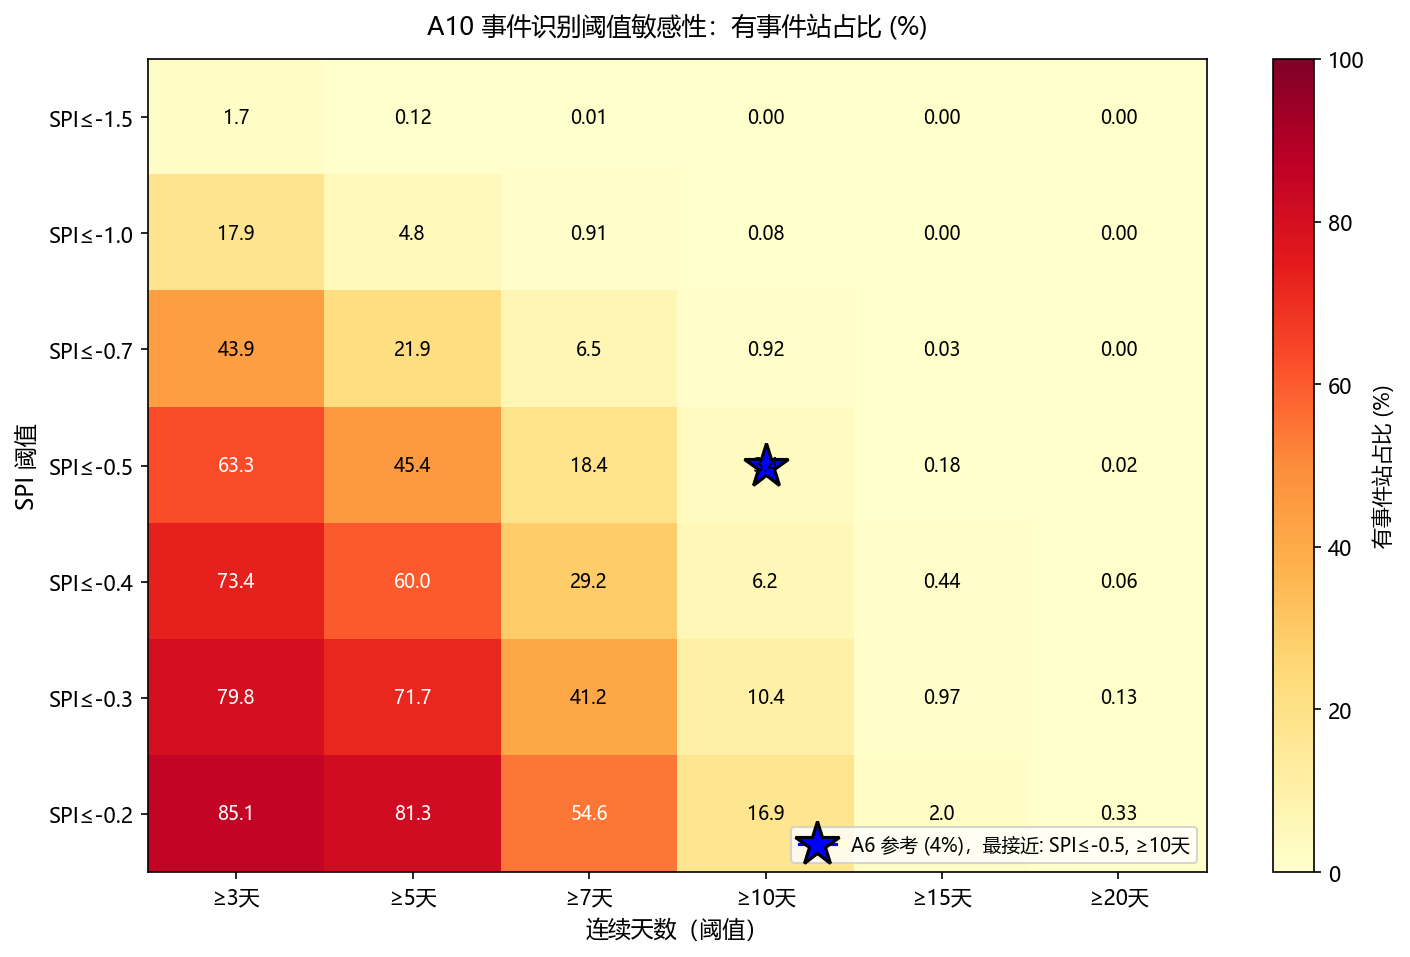
【图 6 】a10_threshold_heatmap.png。有事件站占比的敏感性热力图。蓝色星标是"A6 参考值 4%"的最近组合,即 SPI ≤ -0.5 且连续 ≥10 天,对应比例为 3.4%。
关键数据如下:
| 参数组合 | 有事件站占比 |
|---|---|
| SPI ≤ -0.5244 且连续 ≥15 天,对齐 A5 中旱 | 0.18% |
| SPI ≤ -0.5 且连续 ≥10 天,最接近 A6 的 4% | 3.41% |
| SPI ≤ -1.0 且连续 ≥5 天 | 4.81% |
| SPI ≤ -0.5 且连续 ≥7 天 | 18.45% |
| SPI ≤ -0.3 且连续 ≥5 天 | 71.66% |
| SPI ≤ -0.2 且连续 ≥3 天 | 85.08% |
这张热力图给出了两种方法之间的事件定义换算关系。A5 的"连续 15 天中旱以上"大致等价于 SPI 的"连续 10 天轻度干旱以上"。
6.3 理论数据的事件验证
在完美 Gamma 数据上做同样的事件识别,站数为 100 到 500 之间。
| 场景 | 有事件站占比 |
|---|---|
| i.i.d. Gamma,无时间结构 | 0.00% |
| AR(1) rho=0.3,弱自相关 | 0.00% |
| AR(1) rho=0.5,中等自相关 | 0.00% |
| AR(1) rho=0.7,强自相关 | 0.60% |
即使数据完美服从 Gamma,并且具有强时间结构,SPI 的事件率也只有 0.6%,和真实数据的 0.15% 属于同一数量级。
这说明事件识别失败不是数据问题,而是"SPI 与 90 天"这个组合的固有特性。
7. 机制分析:零值比例是主因
7.1 压缩与零值比例的近乎完美相关
将压缩程度(1 减去标准差)与 A8 的站点特征做 Spearman 相关分析,结果如下:
| 压缩指标与特征 | Spearman ρ | 强度 |
|---|---|---|
| std_deficit 与 q_zero | +0.9990 | 近乎完美 |
| std_deficit 与 alpha | -0.4904 | 中等 |
| std_deficit 与 beta | +0.1421 | 弱 |
| std_deficit 与 ks_p | -0.1696 | 弱 |
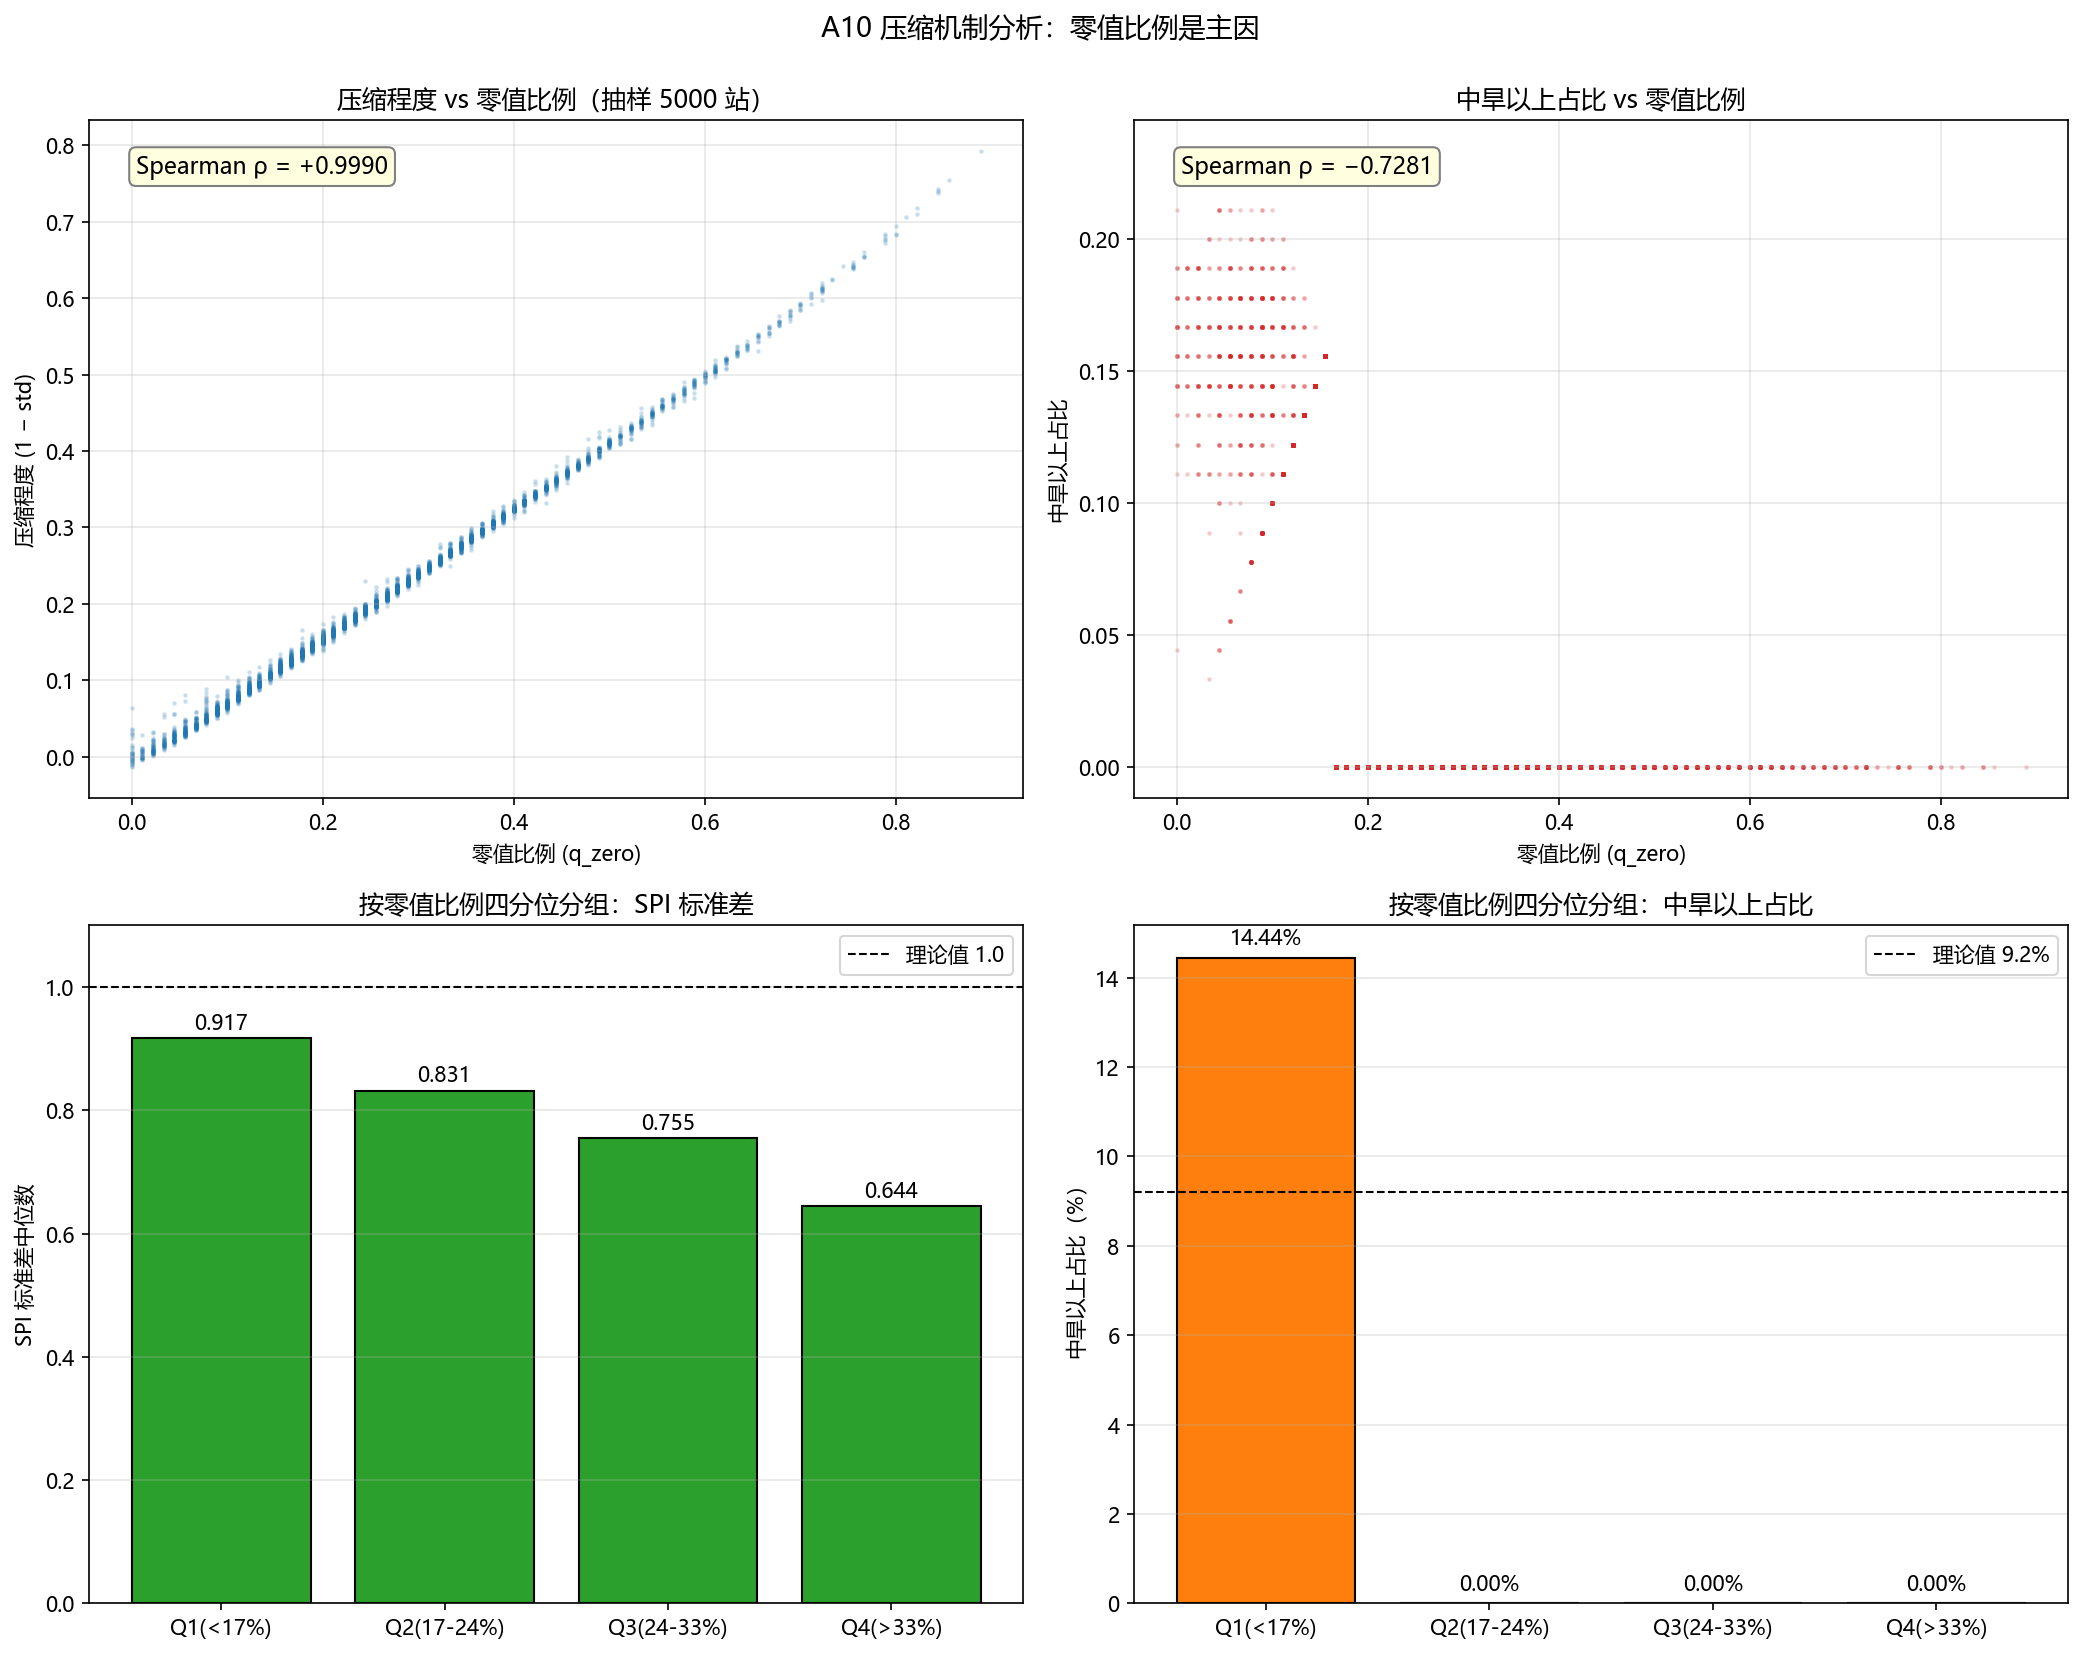
【图 7 】a10_mechanism_qzero.png。2×2 机制分析图,左上子图即压缩与零值比例的关系,几乎是一条完美的直线。
按 q_zero 四分位分组后:
| q_zero 四分位 | SPI 标准差 | 中旱以上占比 |
|---|---|---|
| Q1,小于 17% | 0.917 | 14.44% |
| Q2,17% 到 24% | 0.831 | 0.00% |
| Q3,24% 到 33% | 0.755 | 0.00% |
| Q4,大于 33% | 0.644 | 0.00% |
从 Q1 到 Q4,标准差从 0.92 下降到 0.64,压缩幅度约 30%。中旱以上的识别能力从 14.44% 断崖式跌到 0%。
7.2 压缩的数学机制
压缩的根源是零值离散化。
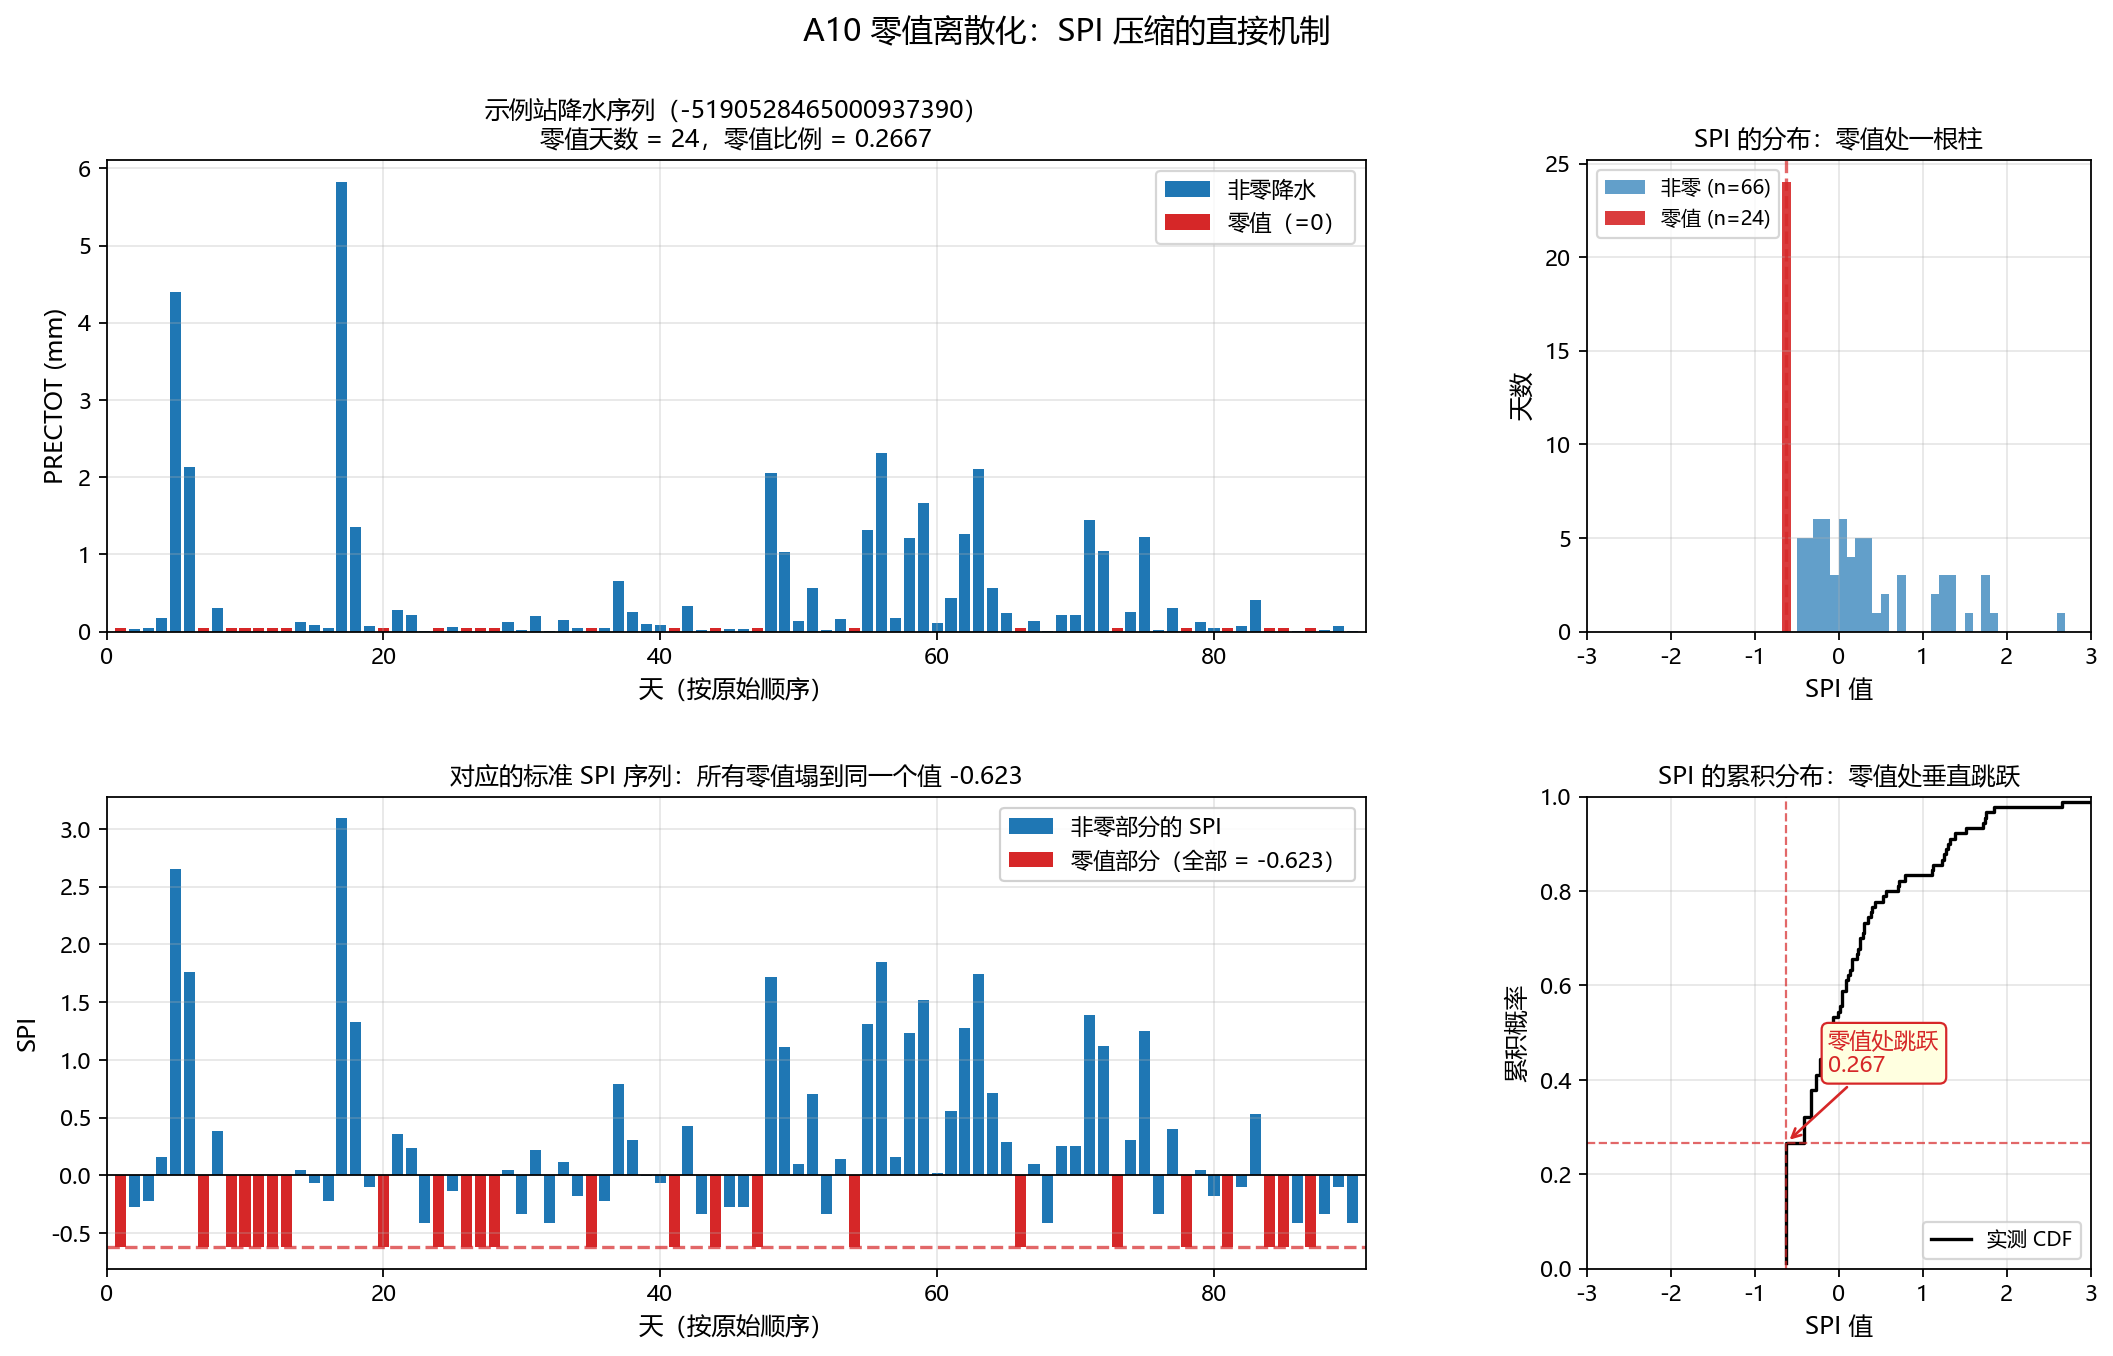
【图 8】a10_zero_discretization_demo.png。示例站 q_zero = 0.2667 的四面板演示。
| 面板 | 内容 |
|---|---|
| 左上 | 降水序列,红柱为零值,共 24 天 |
| 左下 | SPI 序列,所有零值塌到 -0.623 |
| 右上 | SPI 分布,零值处一根高柱 |
| 右下 | CDF 阶梯图,零值处垂直跳跃 0.267 |
数学解释如下。每个零值都被映射到 H = q,通过 norm.ppf 后变成同一个 SPI 值 norm.ppf(q)。24 个零值对应 24 个相同的 SPI 值,因此分布的方差被压缩。这个压缩与数据是否服从 Gamma 无关,是零值离散化的固有特性。
7.3 压缩的空间格局
将压缩指标与 A7 的经纬度合并,画出空间分布。
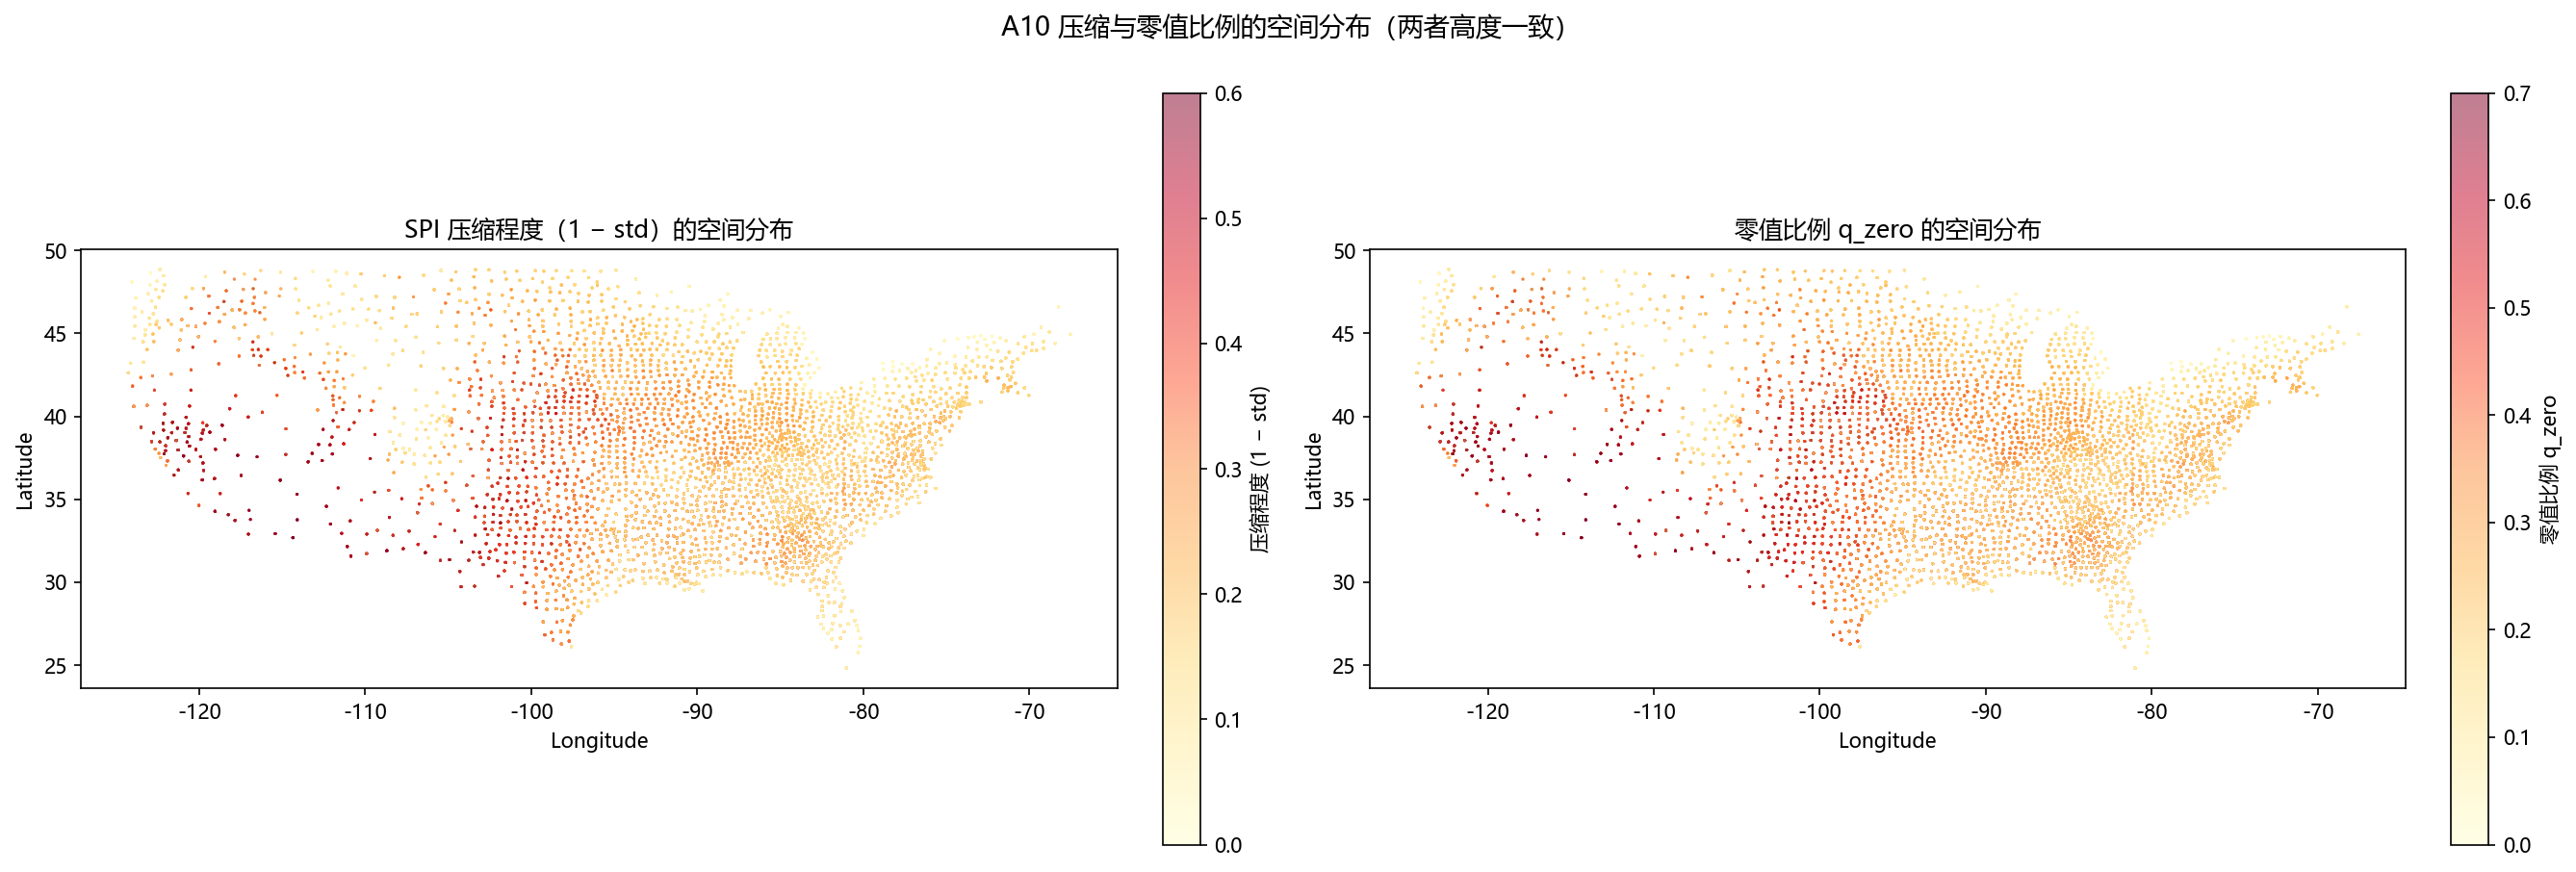
【图 9】a10_spatial_deficit.png。左图为压缩程度(1 减去标准差),右图为零值比例 q_zero。两张图的空间格局几乎完全一致,西部深红、东部浅黄。
这与 A8 报告的发现完全呼应。A8 发现西部拟合差,即 K-S p 值低;A10 发现西部压缩严重。这是同一个原因即高零值比例在两个分析里的不同表现。
7.4 事件识别的空间边界
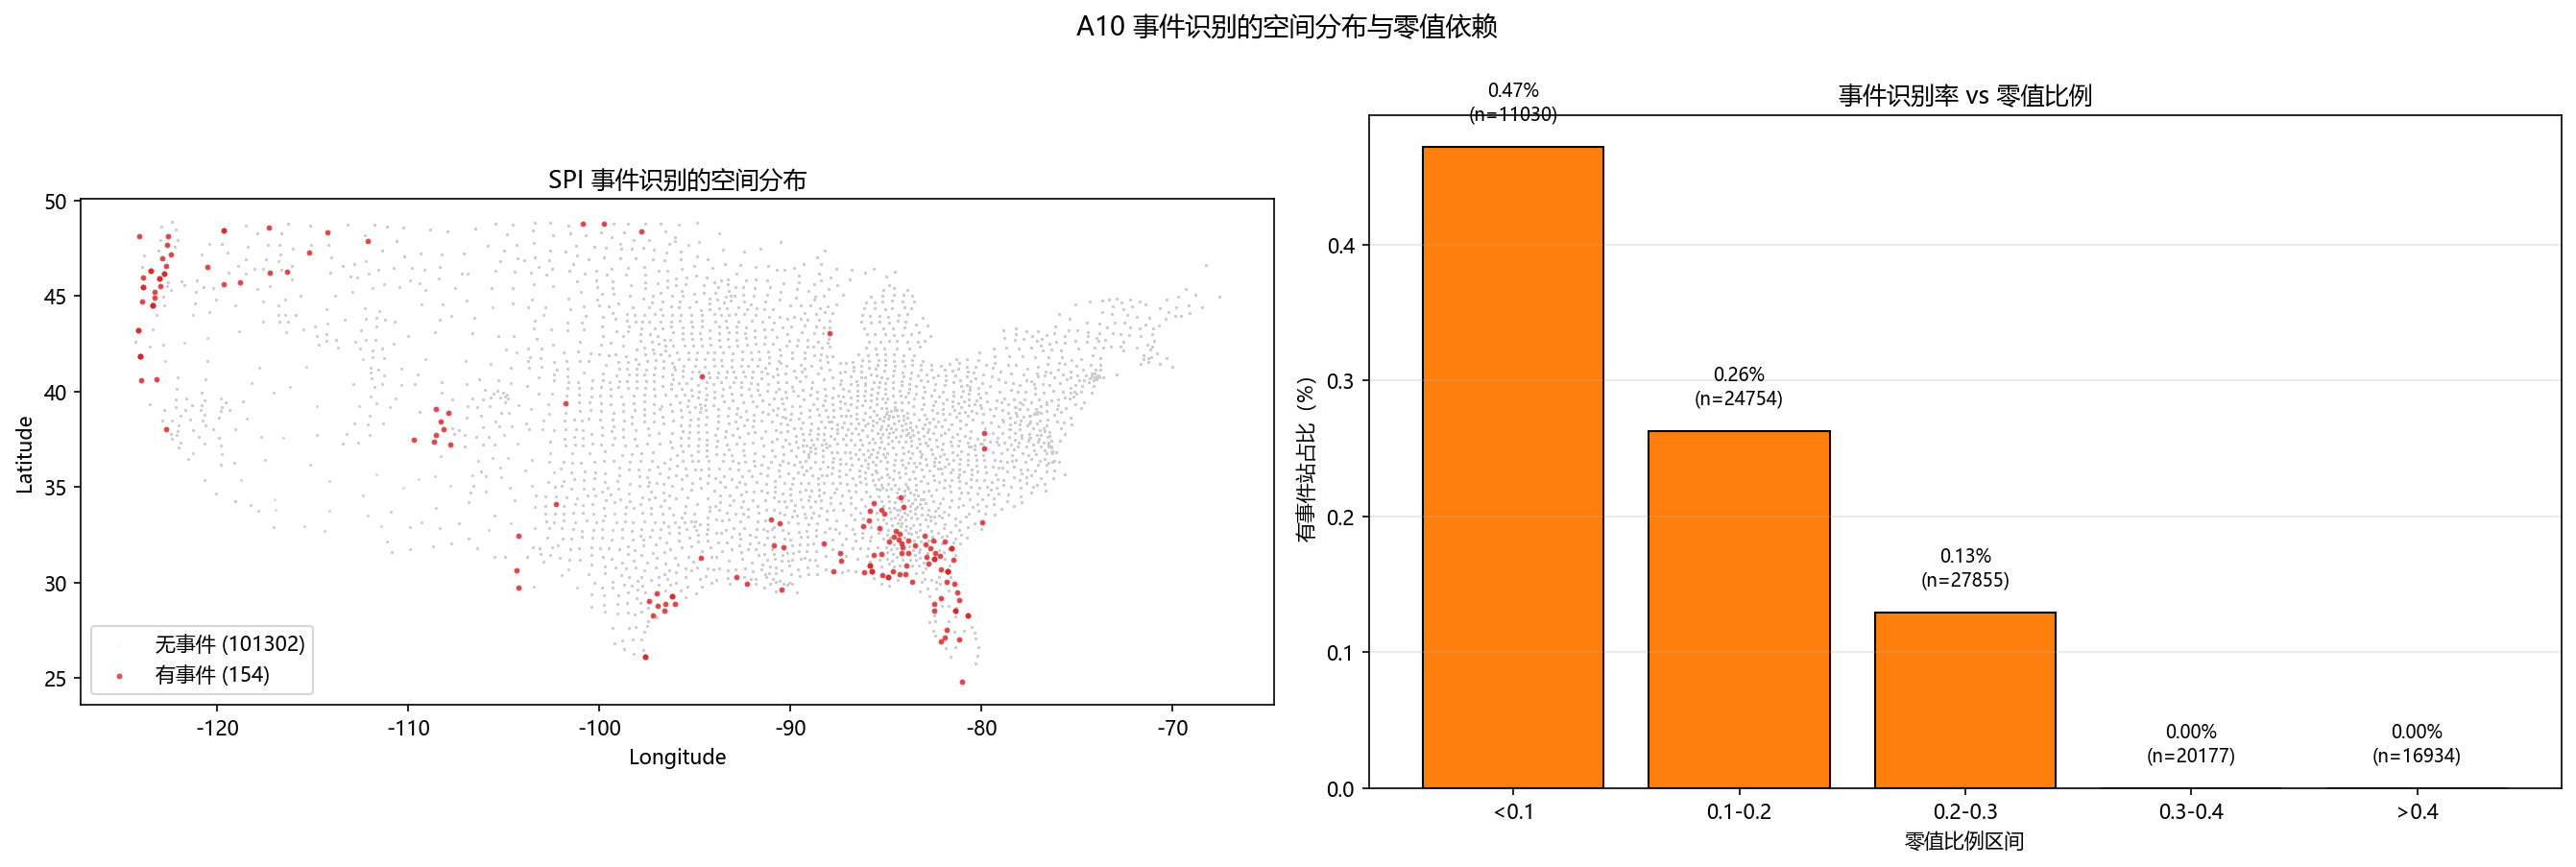
【图 10】a10_spatial_events.png。左图为有事件的 154 个站点,红色点集中在东南部。右图为按零值比例分组的事件识别率。
按 q_zero 区间分组的事件识别率如下:
| q_zero 区间 | 事件识别率 | 样本量 |
|---|---|---|
| 小于 0.1 | 0.47% | 11,030 |
| 0.1 到 0.2 | 0.26% | 24,754 |
| 0.2 到 0.3 | 0.13% | 27,855 |
| 0.3 到 0.4 | 0.00% | 20,177 |
| 大于 0.4 | 0.00% | 16,934 |
这是 SPI 可用性边界的空间证据。SPI 在湿润区可以识别事件,在干旱区完全失效。
8. 方法论讨论
8.1 SPI 与 A5 不可互换
| 维度 | A5 百分位 | SPI |
|---|---|---|
| 定义 | 站内相对排名 | 绝对统计异常 |
| 中旱以上的含义 | 每站底部 30% | SPI ≤ -1.0 |
| 高零值站表现 | 固定 30% | 几乎为 0 |
| 事件识别能力 | 强 | 高零值区失效 |
| 极端等级识别 | 保证 | 高零值区失效 |
两者对干旱的定义不同,混用会导致结果无法比较。
8.2 SPI 的可用性边界
根据全量分析,SPI 在 90 天日尺度上的可用性边界如下:
| q_zero 区间 | SPI 可用性 | 建议 |
|---|---|---|
| 小于 17% | 可用 | 直接使用标准阈值 |
| 17% 到 25% | 勉强 | 需要下调阈值,例如以 -0.5 代替 -1.0 |
| 大于 25% | 不可用 | 改用 A5 百分位方法,或重新校准阈值 |
| 大于 30% | 完全失效 | 极端等级识别为 0 |
8.3 对 A6 结论的修正
A6 报告原文如下:
干旱事件表 4,074 行,即约 4% 的站点发生过连续 ≥15 天的中旱及以上事件。
这句话没有说错,但缺了前提。准确的说法是在 A5 百分位等级定义下,约 4% 的站点发生过连续 ≥15 天的中旱及以上事件。换成 SPI 定义,事件率降到 0.15%。
A6 的 4% 不是降水的客观属性,是 A5 方法定义的产物。
8.4 一个更广的思考
A10 的发现不仅适用于 SPI,也适用于任何基于绝对阈值的标准化指数,例如 SPEI 等。短序列与高零值的组合会导致分布压缩,进而导致极端等级识别失效。换用不同的 CDF 估计方式解决不了问题,标准 SPI 与经验 SPI 的差异小于 0.02。
真正的解决方案包括三个方向。第一,使用更长的序列,例如 365 天,零值比例会降低。第二,重新校准阈值,根据数据特性调整。第三,采用相对排名方法,例如 A5 的百分位方法。
9. 阶段总结
A10 用 SPI 作为独立方法,检验了 A5 与 A8 的方法假设在 90 天且高零值数据上的可靠性。核心发现是两种 SPI 高度一致但都失效,失效的原因是零值离散化。
-
两个反直觉的结果值得强调。第一,两种 SPI 的差异极小,相关系数达到 0.99,说明换用不同的 CDF 估计方式解决不了问题。第二,压缩与零值比例的 Spearman 相关系数达到 +0.9990,说明失效不是拟合误差,而是零值比例的数学必然。
-
事件识别高度依赖方法定义。A6 的 4% 事件率是 A5 百分位方法的产物,换成 SPI 后降到 0.15%,相差 26 倍。两者对干旱的定义不同,不可互换。
-
SPI 有明确的可用性边界。q_zero 小于 17% 可用,17% 到 25% 勉强,大于 25% 不可用,大于 30% 完全失效。这为后续任何基于 SPI 的干旱分析提供了工程指导。
-
理论验证是必要的。在跑全量前做了两次理论验证。第一次验证完美 Gamma 数据上两种 SPI 高度一致,确认框架正确。第二次验证完美 Gamma 加强 AR(1) 条件下事件率也只有 0.6%,确认不是数据问题。这两次验证避免了在错误的框架上跑全量。
对项目的贡献在于,A10 是唯一一个把数据本身的性质作为核心变量的实验。A8 关心降水分布,A9 关心驱动因子,A6 关心时间聚合,只有 A10 关心我们所使用的方法在这个数据上是否依然成立。它是整个项目的方法论审计。
下一步,本项目的方法论审计阶段到此收尾。后续实验例如 B 组电商分析将引入真实业务场景与更高维度的数据,验证这些方法论结论在跨领域的适用性。
附录:文件清单
| 类别 | 文件 | 说明 |
|---|---|---|
| 理论验证 | a10_theory_check.py | 100 站完美 Gamma 数据 |
| 理论验证 | a10_theory_events.py | 完美数据的事件验证 |
| 标准 SPI | a10_spi_std.py | 全量 102,395 站 |
| 经验 SPI | a10_spi_emp.py | 全量 102,395 站 |
| 数值对比 | a10_compare_numeric.py | 合并两版并逐日比较 |
| 等级对比 | a10_compare_levels.py | 等级分布与一致性矩阵 |
| 事件对比 | a10_compare_events_v2.py | 对齐阈值后的事件识别 |
| 机制分析 | a10_mechanism.py | 关联分析与阈值网格 |
| 图 1 到图 2 | a10_dist_compare.png,a10_std_diff_dist.png | 数值层 |
| 图 3 到图 4 | a10_level_dist.png,a10_level_matrix.png | 等级层 |
| 图 5 到图 6 | a10_event_dist_v2.png,a10_threshold_heatmap.png | 事件层 |
| 图 7 到图 8 | a10_mechanism_qzero.png,a10_zero_discretization_demo.png | 机制层 |
| 图 9 到图 10 | a10_spatial_deficit.png,a10_spatial_events.png | 空间层 |