目录
[Step 1: 数据收集](#Step 1: 数据收集)
[Step 2: 数据清洗](#Step 2: 数据清洗)
[Step 3: 格式转换与保存](#Step 3: 格式转换与保存)
[Step 4: 均衡采样(用于快速实验)](#Step 4: 均衡采样(用于快速实验))
[Step 1:预训练模型加载,得到model 和 tokenizer](#Step 1:预训练模型加载,得到model 和 tokenizer)
[Step 2:配置lora,通过get_peft_model创建Lora的小模型,最开始这个小模型为空](#Step 2:配置lora,通过get_peft_model创建Lora的小模型,最开始这个小模型为空)
[Step 3:加载数据,读取数据集](#Step 3:加载数据,读取数据集)
[Step 4:SFTTrainer设定好参数,开始训练](#Step 4:SFTTrainer设定好参数,开始训练)
一、数据下载
Chinese medical dialogue data 中文医疗对话数据集,共有6个文件夹,数据格式都是问答对
Toyhom/Chinese-medical-dialogue-data: Chinese medical dialogue data 中文医疗对话数据集
二、模型下载
我选用的是Qwen/Qwen3.5-0.8B这个模型,以下流程是用CPU跑的。下载模型流程如下:
step 1:检测环境
python
MODEL_ID = "Qwen/Qwen3.5-0.8B"

# AutoDL环境
AUTODL_CACHE_DIR = "/root/autodl-tmp/models"

# 本地Windows环境
LOCAL_CACHE_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "models")


def detect_environment():
    """检测当前运行环境"""
    if sys.platform == "win32":
        return "windows", LOCAL_CACHE_DIR
    elif os.path.exists("/root/autodl-tmp"):
        return "autodl", AUTODL_CACHE_DIR
    else:
        return "linux", LOCAL_CACHE_DIR
step 2:使用ModelScop下载
python
def download_with_modelscope(model_id, cache_dir):
    """使用ModelScope下载模型(国内推荐)"""
    from modelscope import snapshot_download

    print(f"使用ModelScope下载模型: {model_id}")
    print(f"下载目录: {cache_dir}")

    os.makedirs(cache_dir, exist_ok=True)
    model_dir = snapshot_download(model_id, cache_dir=cache_dir)

    print(f"模型下载完成: {model_dir}")
    return model_dir
在前面 HuggingFace介绍 里面,我们曾介绍了国内两种模型下载的方式:
1)使用HF-Mirror (镜像站)
2)使用ModelScope(魔搭社区)
还有一种直接从HuggingFace上直接下载模型的方式,今天一并介绍(几乎和上面代码是一样的):
python
def download_with_huggingface(model_id, cache_dir):
    """使用HuggingFace下载模型"""
    from huggingface_hub import snapshot_download

    print(f"使用HuggingFace下载模型: {model_id}")
    print(f"下载目录: {cache_dir}")

    os.makedirs(cache_dir, exist_ok=True)
    model_dir = snapshot_download(
        model_id,
        cache_dir=cache_dir,
        local_dir=os.path.join(cache_dir, model_id.split("/")[-1]),
    )

    print(f"模型下载完成: {model_dir}")
    return model_dir
各位跑一下代码看看:
python
env_name, cache_dir = detect_environment()
model_dir = download_with_modelscope(MODEL_ID, cache_dir)
三、模型微调
模型微调的全流程还要分为以下三个步骤:
1)数据处理:收集和清洗
Step 1: 数据收集
python
 # 配置数据目录(根据实际路径修改)
 data_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "【数据集】中文医疗数据")
 output_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "processed_data")

 raw_data, collect_stats = collect_medical_data(data_dir)
collect_medical_data 函数遍历DEPARTMENTS,读取数据集中每个科室的所有的.csv文件(read_csv_with_encoding 函数为读取函数)。输出的raw_data为每个科室读出来的数据,stats为每个科室的数据行数。
Step 2: 数据清洗
python
cleaned_data = clean_medical_data(raw_data)将raw_data作为参数传给clean_medical_data 函数。遍历raw_data_list,提取问题和回答字段(extract_qa_fields),如果没有提取到问题和回答字段则跳过不解析。再遍历每个科室中的数据,
1.用clean_text来处理单个的问题和答案(strip 去首尾空白 + 压缩连续空白 + 去控制字符,文本规范化)
2.用is_valid_qa来处理问题和答案是否有效(过滤掉太长或太短的问题和答案,或者仅含标点符号的问题,再或者是谢谢,你好之类无意义的问题)
如上两个步骤将所有文档中的所有的数据全部遍历了,并将数据放到all_data 里,再调用deduplicate_by_question函数用MD5哈希对全部数据进行快速去重。
Step 3: 格式转换与保存
python
os.makedirs(output_dir, exist_ok=True)

# 保存Alpaca格式(完整)
alpaca_data = to_alpaca_format(cleaned_data)
save_dataset(alpaca_data, os.path.join(output_dir, "medical_alpaca_full.jsonl"))

# 保存Chat格式(完整)
chat_data = to_chat_format(cleaned_data)
save_dataset(chat_data, os.path.join(output_dir, "medical_chat_full.jsonl"))将清洗后的全量数据cleaned_data处理成Alpaca格式 或者Chat格式进行保存。
Alpaca格式在 LLM微调-工作准备 中有介绍,包含instruction,intput,output字段,我们现在的数据是个QA对,即有input和output,只需要设定instruction指令,相当于系统提示词。代码中默认给了系统提示词"你是一个专业的医疗助手。请根据患者的问题提供专业、准确的回答。"。
Chat模式要追溯到 大模型API使用 舆情分析案例中,介绍了messages 的结构:每个元素都包含role 和content 两个键,role的角色包含**'system' (系统指示)** 、'user' (用户提问) 或**'assistant' (AI回复)**。
save_dataset函数是将转换好格式的数据存储到指定的文件中。分为jsonl和json两种文件格式的写入。
Step 4: 均衡采样(用于快速实验)
python
sampled_data = sample_balanced_data(cleaned_data, samples_per_dept=200)
sampled_alpaca = to_alpaca_format(sampled_data)
save_dataset(sampled_alpaca, os.path.join(output_dir, "medical_alpaca_sampled.jsonl"))

# 留出验证集(5%)
val_size = max(10, len(sampled_data) // 20)
val_data = to_alpaca_format(sampled_data[:val_size])
train_data = to_alpaca_format(sampled_data[val_size:])
save_dataset(val_data, os.path.join(output_dir, "medical_alpaca_val.jsonl"))
save_dataset(train_data, os.path.join(output_dir, "medical_alpaca_train.jsonl"))
sample_balanced_data 函数遍历清洗后的全量数据cleaned_data ,按照科室放到dept_data里,再对每个科室的数据进行抽样。对采样完成的数据转换成Alpaca格式 ,并保存。sampled_data为采样数据集。
对采样的数据再抽取一部分,一部分为训练集(train_data) ,一部分为验证集(val_data),并保存。
2)SFT模型微调
python
from transformers import AutoModelForCausalLM, AutoTokenizer
    from peft import LoraConfig, get_peft_model
    from trl import SFTTrainer

    # 1. 加载模型
    print("CPU模式: float32加载 (约需3.2GB内存)")
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME, trust_remote_code=True)
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_NAME,
        dtype=torch.float32,
        trust_remote_code=True,
    )
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token

    # 2. 配置LoRA
    lora_config = LoraConfig(
        r=8,   #lora 秩,建议8,16,32,64,128
        lora_alpha=16,
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
        lora_dropout=0.05,
        task_type="CAUSAL_LM",
    )
    model = get_peft_model(model, lora_config) #lora的小模型
    # PEFT 注入的 LoRA 参数可能仍为 bf16;
    # Intel CPU 上 DNNL 后端不支持 bf16 反向传播,必须强制转 fp32
    model = model.to(torch.float32)
    model.print_trainable_parameters()

    # 3. 准备数据并格式化为带EOS的文本
    data_list = prepare_training_data()
    eos_token = tokenizer.eos_token or ""

    def formatting_func(examples):
        texts = []
        for inp, out in zip(examples["input"], examples["output"]):
            text = MEDICAL_PROMPT.format(inp, out) + eos_token
            texts.append(text)
        return {"text": texts}

    dataset = Dataset.from_list(data_list)
    dataset = dataset.map(formatting_func, batched=True)
    print(f"训练数据: {len(dataset)} 条")

    # 4. SFT训练
    train_kwargs = dict(
        per_device_train_batch_size=2, #每个设备的训练批次大小
        gradient_accumulation_steps=2, #梯度累加步数
        max_steps=10,                  #最大训练步数
        learning_rate=2e-4,            #学习率
        fp16=False,                    #是否使用 fp16 训练
        bf16=False,                    #是否使用 bf16 训练
        optim="adamw_torch",            #优化器
        use_cpu=True,
        output_dir="outputs_medical",
        report_to="none",
        logging_steps=1,              #日志记录步数
    )
    # trl 0.24+ 新版 API:dataset_* 与 packing 都搬进 SFTConfig;
    # SFTTrainer 的 tokenizer 参数改名为 processing_class;
    # max_seq_length 改名为 max_length
    from trl import SFTConfig
    sft_config = SFTConfig(
        **train_kwargs,
        max_length=512,
        dataset_text_field="text",
        dataset_num_proc=1,
        packing=False,
    )
    trainer = SFTTrainer(
        model=model,
        processing_class=tokenizer,
        train_dataset=dataset,
        args=sft_config,
    )

    trainer.train()
Step 1:预训练模型加载,得到model 和 tokenizer
Step 2:配置lora,通过get_peft_model创建Lora的小模型,最开始这个小模型为空
Step 3:加载数据,读取数据集
Step 4:SFTTrainer设定好参数,开始训练
3)效果的验证
python
# 5. 测试推理
    test_questions = [
        "我最近总是感觉头晕,应该怎么办?",
        "感冒发烧应该吃什么药?",
        "高血压患者需要注意什么?",
    ]
    model.eval()
    for q in test_questions:
        prompt = MEDICAL_PROMPT.format(q, "")
        inputs = tokenizer(prompt, return_tensors="pt")
        with torch.no_grad():
            outputs = model.generate(
                **inputs,
                max_new_tokens=128,
                temperature=0.7,
                top_p=0.9,
                do_sample=True,
            )
        response = tokenizer.decode(outputs[0], skip_special_tokens=True)
        if "### 回答:" in response:
            answer = response.split("### 回答:")[-1].strip()
        elif "### 回答:" in response:
            answer = response.split("### 回答:")[-1].strip()
        else:
            answer = response
        print(f"Q: {q}")
        print(f"A: {answer[:200]}")
        print()

    # 6. 保存LoRA模型
    save_dir = "lora_model_medical"
    os.makedirs(save_dir, exist_ok=True)
    model.save_pretrained(save_dir)
    tokenizer.save_pretrained(save_dir)
    print(f"LoRA模型已保存: {save_dir}")
先把输入转化成token,生成答案后再把Token转为文字回答。这里保存了微调后的模型lora_model_medical,下次加载模型时就可以加载这个模型 model = AutoModelForCausalLM.from_pretrained("lora_model_medical",.......
结果输出:
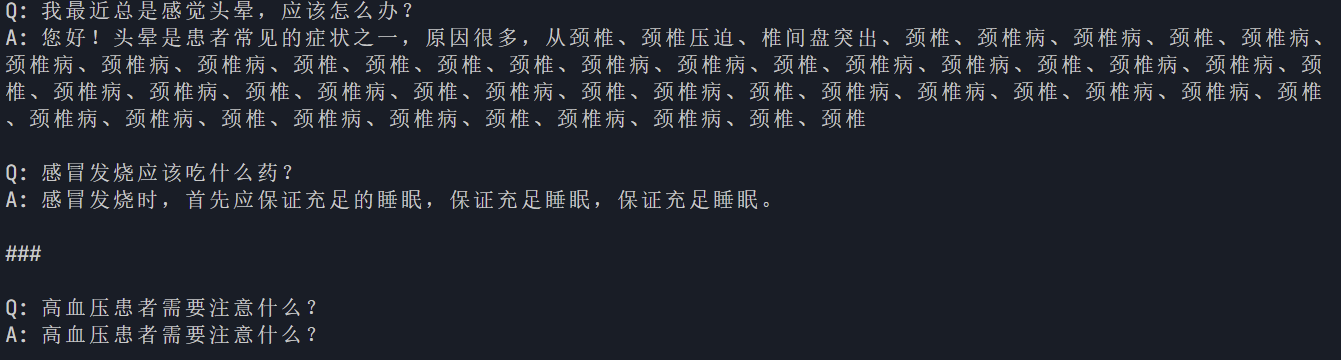
我这里只用了1000多条数据,跑了10轮,感觉训练结果不好。可以加大数据量或者加大训练轮数来看看。
GPU版本补充
上面用CPU版本的代码说明了模型微调的流程,这里再补充一下GPU版本的流程:
python
def load_model():
    """使用Unsloth加载模型,4bit量化"""
    from unsloth import FastLanguageModel
    model, tokenizer = FastLanguageModel.from_pretrained(
        model_name=MODEL_NAME,
        max_seq_length=MAX_SEQ_LENGTH,
        dtype=None,
        load_in_4bit=True, #4bit量化,0.8B模型约需0.5GB显存
    )
    return model, tokenizer


def setup_lora(model):
    """配置LoRA适配器,使用unsloth梯度检查点"""
    from unsloth import FastLanguageModel
    model = FastLanguageModel.get_peft_model(
        model,
        r=LORA_R,
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                        "gate_proj", "up_proj", "down_proj"],
        lora_alpha=16,
        lora_dropout=0,
        bias="none",
        use_gradient_checkpointing="unsloth",
        random_state=3407,
        use_rslora=False,
        loftq_config=None,
    )
    return model

//step 3:准备数据

def train_sft(model, tokenizer, dataset):
    """使用SFTTrainer训练,SFTConfig优先,回退到TrainingArguments"""
    from unsloth import is_bfloat16_supported
    bf16_val = is_bfloat16_supported()
    fp16_val = not bf16_val

    train_kwargs = dict(
        per_device_train_batch_size=BATCH_SIZE,
        gradient_accumulation_steps=GRAD_ACCUM,
        warmup_steps=5,
        max_steps=MAX_STEPS,
        learning_rate=LR,
        fp16=fp16_val,
        bf16=bf16_val,
        logging_steps=1,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir=OUTPUT_DIR,
        report_to="none",
    )

    from trl import SFTTrainer
    try:
        from trl import SFTConfig
        sft_config = SFTConfig(
            **train_kwargs,
            max_seq_length=MAX_SEQ_LENGTH,
            dataset_text_field="text",
            dataset_num_proc=2,
            packing=False,
        )
        trainer = SFTTrainer(
            model=model,
            processing_class=tokenizer,
            train_dataset=dataset,
            args=sft_config,
        )
    except ImportError:
        from transformers import TrainingArguments
        training_args = TrainingArguments(**train_kwargs)
        trainer = SFTTrainer(
            model=model,
            tokenizer=tokenizer,
            train_dataset=dataset,
            dataset_text_field="text",
            max_seq_length=MAX_SEQ_LENGTH,
            dataset_num_proc=2,
            packing=False,
            args=training_args,
        )


    trainer.train()

#==========================================
#数据验证
test_questions = [
        "我最近总是感觉头晕,应该怎么办?",
        "感冒发烧应该吃什么药?",
        "高血压患者需要注意什么?",
    ]
    for q in test_questions:
        ans = generate_response(model, tokenizer, q)
        print(f"  Q: {q}")
        print(f"  A: {ans[:300]}...")
        print()
大家看下流程是一样的:
**Step 1(load_model):**预训练模型加载,得到model 和 tokenizer。区别是CPU是用Transformers加载的,而GPU是用UnSloth加载的
**Step 2(setup_lora):**配置Lora,通过get_peft_model创建Lora的小模型
**Step 3:**准备数据,和上面CPU版本代码一样
Step 4(train_sft):与上面CPU版本代码传参基本一致
结果输出:
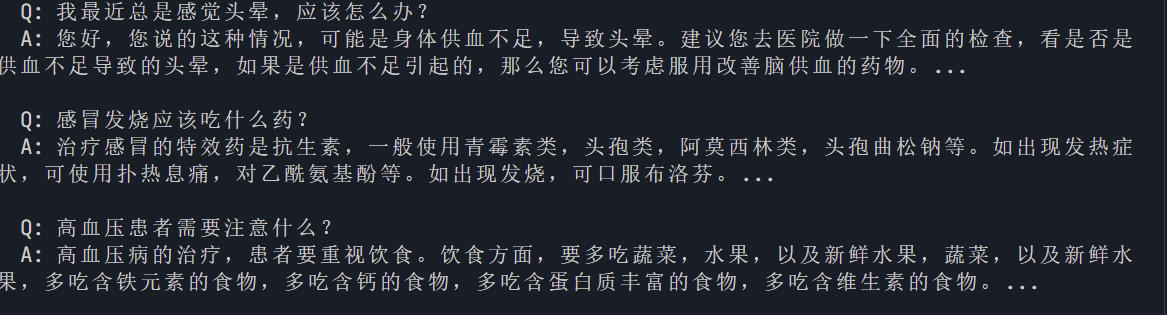
这次跑了100轮,效果比上面CPU版本跑10轮的效果好多了。使用一下我们训练出来的模型:
python
MEDICAL_PROMPT = """你是一个专业的医疗助手。请根据患者的问题提供专业、准确的回答。

### 问题:
{}

### 回答:
{}"""


def load_model():
    """使用Unsloth加载模型,4bit量化"""
    from unsloth import FastLanguageModel
    model, tokenizer = FastLanguageModel.from_pretrained(
        model_name="lora_model_medical_GPU",
        max_seq_length=2048,
        dtype=None,
        load_in_4bit=True,
    )
    return model, tokenizer

def generate_response(model, tokenizer, question, max_new_tokens=256):
    """推理前调用for_inference,张量置于cuda"""
    # 禁用torch dynamo编译:unsloth为Qwen3.5生成的编译缓存里,
    # _alloc_from_pool算子在torch 2.11 inductor下会抛
    # "output must not be the same as input"RuntimeError。
    # 仅在推理路径禁用,不影响训练时的unsloth加速编译。
    import torch._dynamo
    torch._dynamo.config.disable = True

    from unsloth import FastLanguageModel
    FastLanguageModel.for_inference(model)

    prompt = MEDICAL_PROMPT.format(question, "")
    # Qwen3.5是多模态模型,tokenizer实为Qwen3VLProcessor,
    # 第一个位置参数默认是images;必须用text=关键字显式指定文本输入,
    # 否则Processor会把字符串当图像路径走PIL解码而抛ValueError
    inputs = tokenizer(text=[prompt], return_tensors="pt").to("cuda")

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            temperature=0.7,
            top_p=0.9,
            use_cache=True,
            do_sample=True,
        )

    response = tokenizer.decode(outputs[0], skip_special_tokens=True)
    if "### 回答:" in response:
        answer = response.split("### 回答:")[-1].strip()
    elif "### 回答:" in response:
        answer = response.split("### 回答:")[-1].strip()
    else:
        answer = response
    return answer

if __name__ == "__main__":
    model, tokenizer = load_model()

    q = "孩子肥胖懒惰,应该怎么办?"
    ans = generate_response(model, tokenizer, q)
    print(f"  Q: {q}")
    print(f"  A: {ans[:300]}...")
结果输出:
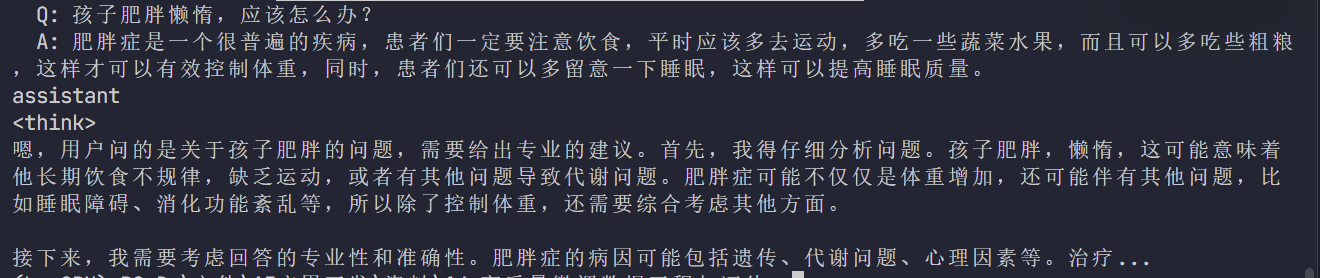
GPU和CPU版代码的对比:
| 组件 | GPU版 | CPU版 |
|---|---|---|
| 基座模型 | Qwen3.5-0.8B (4bit量化) | Qwen3.5-0.8B (float32) |
| 微调框架 | Unsloth + trl | transformers + peft + trl |
| LoRA rank | r=16 | r=8 |
| 训练步数 | 100步 | 10步 |
| 序列长度 | 2048 | 512 |
| batch配置 | 2 x 4 (梯度累积) | 1 x 2 |
| 显存/内存 | 约2-4GB显存 | 约3.2GB内存 |
**知识补充:**TRL(Transformer Reinforcement Learning)是Hugging Face 推出的 库,用于大语言模型的训练和微调。主要功能包括:
• SFTTrainer:监督微调(SFT),用指令数据训练模型
• DPOTrainer/ RLHFTrainer:偏好对齐(DPO、RLHF 等)
• SFTConfig:配置SFT 训练参数(学习率、batch、序列长度等)
TRL 基于transformers 和peft,支持LoRA、4bit 量化等,是Hugging Face 生态里做LLM 微调的核心工具。