搭一个 AI 对话工作台 AChat:从 0 到可用的完整记录(一)
这是这个系列博客的第一篇。我用 AI 编程助手协作,从零搭建了一个可本地部署、可扩展的 AI 对话 Web 应用 AChat 记录一下过程中的设计决策与技术踩坑。虽然代码极大部分的使用了 AI 辅助,但是作为记录的博客,我还是愿意亲手码字,只有这样实现一遍总结一遍,才可以巩固知识点。
开源地址 :https://gitee.com/A_gua/achat(分支:
develop)
一、为什么要做这个项目
主流 AI 对话产品(ChatGPT、Kimi、DeepSeek 网页版......)已经做得非常好,我希望能够临摹一个类似的demo,想通过做一个完整项目,了解 LLM 应用开发流程 :流式协议、RAG、Function Calling、向量库......于是有了 AChat。
这篇文章记录第一阶段:骨架初始化 + 对话打通 + 配置面板 + 性能统计 + 代码块增强。
二、技术选型:为什么不选别的
首先因为我现在主要的技术栈是 Java + Vue3 ,初衷是希望根据当前的技术栈来选型。但是结合网络上和现实朋友的建议,一致认为 Python 在 AI 相关的相性更好,而且作为一个 demo 来说,选用更轻的组件明显更方便一些,所以这个项目选用了以下内容:
| 层 | 选型 | 理由 |
|---|---|---|
| 前端 | React 18 + Vite + TypeScript + TailwindCSS | 生态大、AI 协作生成质量稳 |
| 状态 | Zustand | 一个 create() 搞定,不需要 Redux 那套仪式 |
| 后端 | Python 3.10+ + FastAPI | AI 生态;原生 async;SSE 支持好 |
| LLM 接入 | OpenAI SDK(协议兼容层) | 一套代码对各种国产端点兼容 |
| 对话存储 | SQLite + SQLAlchemy(async) | 零服务、单文件、够用 |
| 向量库 | ChromaDB(PersistentClient) | pip install 即用的嵌入式向量库,不用起服务 |
| 文档分片 | langchain-text-splitters | 目前只打算借用它的 RecursiveSplitter,不引入整套 LangChain 链 |
| 配置 | 本地 YAML + Pydantic 校验 | 人可读可改,类型安全,gitignore 隔离 |
| 流式协议 | SSE(sse-starlette) | 比 WebSocket 轻,比裸 fetch stream 规范 |
三、项目结构
AChat/
├── backend/                    # Python FastAPI 后端
│   ├── app/
│   │   ├── main.py             # 入口:路由挂载 + 静态资源 + SPA fallback
│   │   ├── config.py           # YAML 配置加载(Pydantic 校验 + lru_cache 单例)
│   │   ├── config_writer.py    # 配置写入器:原子写 + 备份 + 热重载
│   │   ├── api/                # chat / conversation / knowledge / config / tools
│   │   ├── core/               # LLMClient 封装、SSE 工具、Prompt 模板
│   │   ├── plugins/            # 插件系统:base + 4 个内置插件
│   │   ├── rag/                # chunker / embedder / vectorstore / retriever
│   │   └── models/             # SQLAlchemy ORM + Pydantic Schema
├── frontend/                   # React + Vite + Tailwind
│   └── src/
│       ├── components/         # ChatWindow / MessageBubble / CodeBlock / Settings / ...
│       ├── stores/             # Zustand
│       └── services/           # API 客户端(含 SSE 解析器)
├── config/
│   ├── config.example.yaml     # 示例配置(入库)
│   └── config.yaml             # 真实配置(.gitignore 排除)
├── scripts/start.py            # 一键启动脚本
└── data/ # 运行时数据(.gitignore 排除)核心设计原则:密钥永不出本机 。config.yaml 从第一天起就在 .gitignore 里,仓库只有 config.example.yaml 模板。前端设置面板写的每个 Key 都只落盘到本地 YAML。
四、核心实现与踩坑
4.1 项目初始化:一次性生成骨架
第一阶段几乎没有手写代码,我只需要把需求描述清楚(功能列表、"Key 存本地"、"单端口启动"),让 AI 生成了整个骨架,其中 AI 在初始化时给了几个后面一直受益的决策:
- FastAPI 同时 serve 前端
dist/,加 SPA fallback 路由(非/api路径一律回index.html),单端口 8765 完成全部服务。 - 配置加载用
@lru_cache单例 +reload_config()配对,为后来"配置面板热生效"埋下完美的伏笔。 - 插件基类
BasePlugin+@register注册器 :所有能力(联网搜索/文档解析/图片生成/图像识别)实现统一execute()接口、返回统一{ok, data, error}结构,还能to_tool_spec()输出 OpenAI Function Calling 格式为后续 Agent 化留好了口子。
4.2 踩坑:8080 端口被 Windows 系统占用
默认端口本想用 8080,结果启动报 [WinError 10013]。然后Get-NetTCPConnection -LocalPort 8080 一查:被系统服务占用(其实这情况在 Windows 上很常见,往往是 IIS/SSRS 之类在监听)。
然后我就把项目默认端口改成了 8765 ,同时 config.example.yaml 里写清楚改端口的地方,前端 Vite dev 代理同步更新。
4.3 SSE 流式对话接口
后端事件协议设计得很简单:
event: start
data: {"conversation_id": "...", "message_id": "...", "model": "...", "prompt_tokens": 16}

event: delta
data: {"content": "逐"}

event: end
data: {"done": true, "message_id": "...", "stats": {...}}

event: error
data: {"message": "..."}
LLMClient.chat_stream() 里对 OpenAI SDK 的 stream=True 响应逐 chunk 取 delta.content,异常时降级为一个 error 事件的文本 而不是让生成器直接崩溃,来保证 SSE 通道永远善终(end 或 error 必有一个)。
数据库侧有个小技巧:流开始前先插入一条空的 assistant 占位消息并 commit ,流结束后再按 message_id 把完整文本和统计 update 回去。这样即使前端刷新/断连,消息记录也不会丢。
4.4 重大踩坑:Network 里一切正常,UI 却永远"正在生成"
接通第一个真实模型(商汤 SenseNova)后尴尬的事发生了:浏览器 Network 面板能看到完整的 SSE 响应流,每个 delta 事件都在正常返回,但页面永远停在三个点的加载动画。
抓包看原始字节,真相浮出:
event: start\r\ndata: {...}\r\n\r\nsse-starlette 的默认行分隔符是 \r\n (W3C SSE 规范推荐),所以事件与事件之间是 \r\n\r\n。而前端解析器是按 \n\n 分割 buffer 的,永远匹配不到,所有事件堆在 buffer 里一条都没被处理。
在更早的测试里,因为全用的虚假占位 API Key,LLM 调用直接失败,SSE 就只有 start/error/end 三条事件、没有 delta,UI 看起来"正常报错",掩盖了解析器根本没工作的事实。
修复(同时兼容两种分隔符 + 处理流结束时 buffer 残留):
typescript
// 规范化换行:\r\n → \n,再按 \n\n 切分事件
buffer = buffer.replace(/\r\n/g, '\n').replace(/\r/g, '\n')
const events = buffer.split('\n\n')
buffer = events.pop() || ''   // 最后一段可能不完整,留到下轮

// ...流 done 之后,buffer 里可能还剩一个未以空行结尾的完整事件,补处理一次教训:流式功能一定要用真实上游端到端验证。mock 一个"失败场景"就等于没测。
4.5 设置面板:把 YAML 配置变成可视化操作
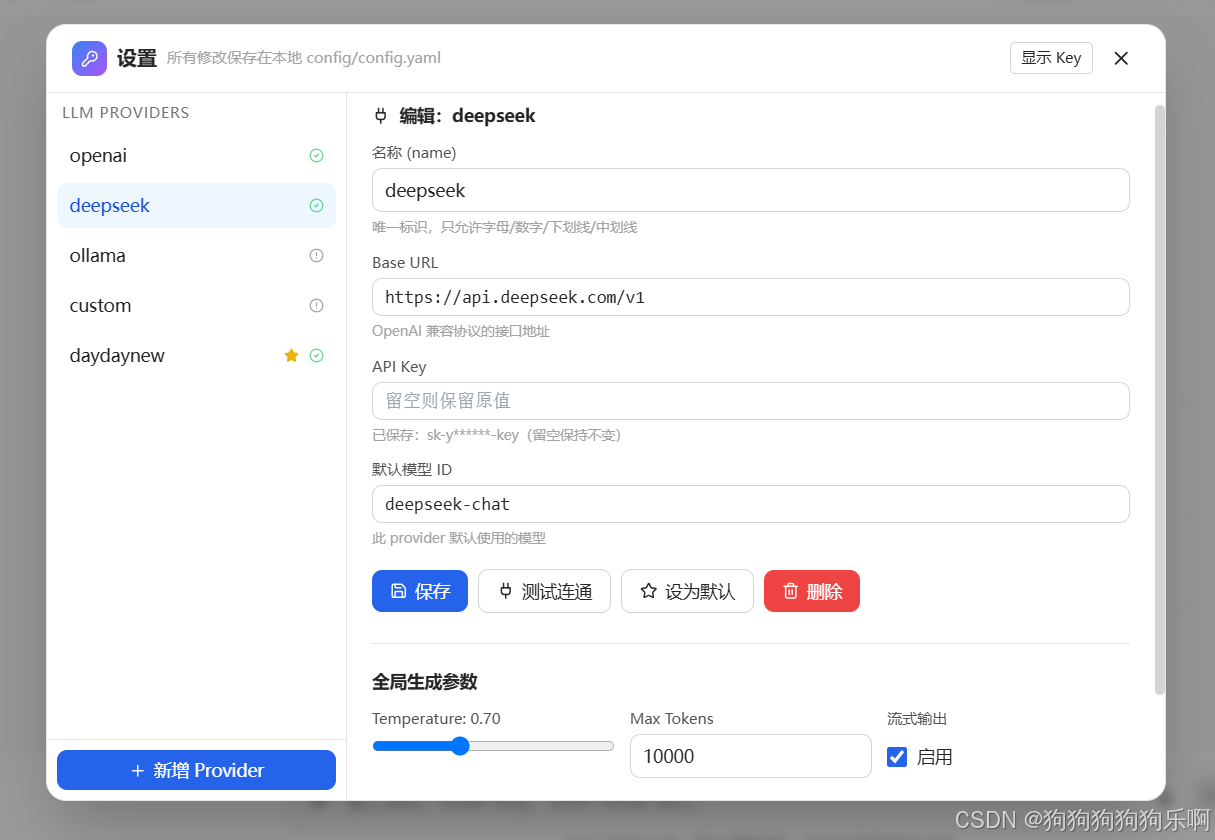
灵感来自 cc-switch,既然我要支持N家 OpenAI 兼容端点,来回手改 YAML 太原始了。就在后端做了一组 /api/config/* RESTful 接口 + 一个 config_writer 模块:
python
def save_raw(data: dict, *, backup: bool = True) -> None:
    # 1. 先备份现有文件 → config.yaml.bak
    # 2. 写入临时文件 config.yaml.tmp
    # 3. os.replace 原子替换(要么完全成功要么完全没发生,不会留下半截 YAML)
    # 4. reload_config() 清掉 lru_cache ------ 下次请求即读到新配置
provider 名称用正则 [A-Za-z0-9_-]{1,32} 白名单校验(防 YAML 注入);删除默认 provider 时自动把默认切到剩余的第一个;列表接口默认对 API Key 脱敏(sk-y******-key),点「显示 Key」才返回明文,虽然是本机应用存储,但是依然做了脱敏。
前端是左列表 + 右表单的弹窗,内置 8 个常用预设一键填充(OpenAI / DeepSeek / 通义 / Kimi / 智谱 / Ollama ......),保存成功后顺手刷新顶部模型下拉框 。
4.6 连通性测试
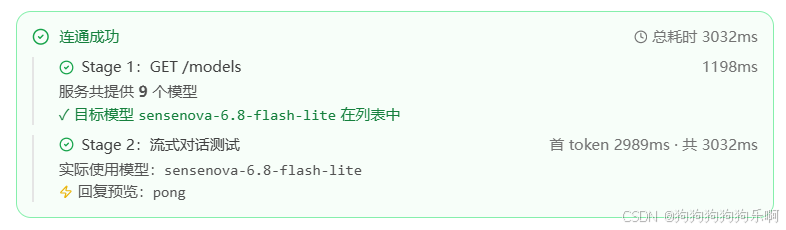
最初的"测试连通"按钮:非流式发一条 ping、max_tokens=8、无超时。实测 SenseNova 16 秒才返回,且 reply 是空字符串 (8 个 token 全被 thinking 吃掉)。基本上等于点了没反应,所以重构为双阶段测试:
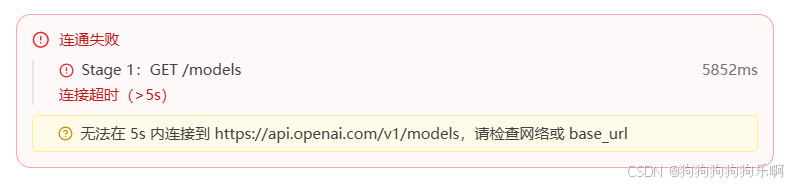
Stage 1: GET {base_url}/models          ← 只验证 URL + Key,通常 <1s
  ├─ 200 → 顺手拿到模型列表,检查目标 model ID 在不在里面
  ├─ 401/403 → API Key 无效,直接短路返回
  ├─ 404 → 该服务没实现 /models,标记"跳过",不算失败
  └─ timeout / refused → 5s 上限,直接失败返回

Stage 2: 流式对话                        ← 收到首 token 即算成功
  ├─ prompt 换成明确的 "Reply with exactly one word: pong"
  ├─ asyncio.wait_for(timeout=8s)
  └─ 累计 12 字符就主动 break,不等完整回复
效果对比:
| 场景 | 旧版 | 新版 |
|---|---|---|
| 配置全部正确 | 16s | 1~3s(首 token 即回) |
| URL 写错 | 卡 16s+ | <1s(stage1 拒连) |
| Key 写错 | 等完整往返 | <1s(stage1 返回 401) |
| 模型 ID 写错 | 超时 | stage1 直接提示「模型不在列表中,可用:xxx...」 |
前端配了一个分阶段诊断面板:每个 Stage 一条时间线,绿 ✓ / 红 ✗ / 灰 ? 三态,附耗时和 hint 智能提示。错误信息的质量决定工具的好用程度 ,从"连接失败"到"URL/Key 正确,但 gpt-4-turbo 不在服务返回的 27 个模型中,可用例如 sensenova-6.8-flash-lite",实际上是有本质的区别的。
4.7 性能统计:不装 tiktoken 怎么算 tokens
在用 Cherry Studio 的时候我就觉得想要每条回复显示:首字 XXms、总耗时、tokens x t/s 这些非常好用,可以快速判断是 API 上游问题,还是 demo 本身有问题。前两个基本是纯计时问题;但是 token 数的计算我不想引入 tiktoken(包体积 + 非 OpenAI 自家模型不准),直接改用经验公式,后续如果有需要精细计算的情况下,再视情况引包:
python
def estimate_tokens(text: str) -> int:
    # CJK 汉字/中文标点 ≈ 1.5 tokens/字
    # 其他字符        ≈ 0.28 tokens/字符(英文约 4 char/token)
    cjk = sum(1 for c in text if is_cjk(c))
    return int(cjk * 1.5 + (len(text) - cjk) * 0.28)
实测对照主流 BPE tokenizer 误差 ±20%(Hello world→3,你好,世界→7),展示用途足够。
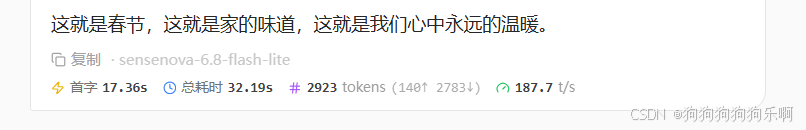
统计数据的流转路径:
后端 event_stream 计时 → end 事件携带 stats JSON → 前端 onEnd 写入 message
                                              ↓
                          messages 表新增 stats 列(JSON 字符串)持久化
                                              ↓
                    历史会话加载时 parse,老对话也看得到当时性能数据
数据库轻量迁移 值得一提:SQLite 的 create_all 不会给已存在的表加列。我的做法是启动时查一次 PRAGMA table_info(messages),缺列就 ALTER TABLE ADD COLUMN ------ 对单人项目,这种手写迁移比引入 Alembic 轻快得多。
4.8 代码块三连:复制、运行、以及不抖动的滚动
代码块渲染接管 :是通过 react-markdown 的 components={``{ pre: CodeBlock }} 完全接管的代码块,头部显示语言名(40+ 缩写映射)+ 行数 + 复制按钮。
难点在拿原始代码文本 :rehype-highlight 处理后的 children 全是 <span> 语法高亮碎片,直接取 textContent 容易混入渲染噪声。解法是写一个 extractText() 递归遍历 React 元素树拿纯文本,复制出来的永远是干净的源代码。
html运行预览 :语言为 html 或内容以 <div、<!DOCTYPE 等开头的代码块,给它多加一个绿色「▶ 运行」按钮,弹出 70vw × 70vh 模态框,可以直接预览单个 html 的小玩意儿:
tsx
<iframe
  srcDoc={html}
  sandbox="allow-scripts allow-modals allow-forms allow-popups"
  //  关键:不给 allow-same-origin
/>
allow-scripts 让 JS 能跑;故意不给 allow-same-origin 是因为 iframe 里的代码不要能够摸到父页面的 localStorage/cookie/DOM,AI 生成的代码再怎么折腾也出不了沙箱。模型经常只给 <div>...</div> 片段,预览器会自动包一层完整 HTML 骨架(charset/viewport/中文字体回退),所见即所得。关法给了三个:右上角的 ✕、点遮罩、按 Esc。
滚动抖动修复:在生成长代码片段时流式回复含代码块就会导致页面疯狂抖动,查下来主要是三个原因叠加:
- 每个 delta 都触发一次
scrollIntoView({ behavior: 'smooth' }),平滑动画不断被新动画打断重走; - 每次内容更新,highlight.js 重新着色导致代码块高度重排;
- 无脑跟随底部,用户想往上翻看历史直接被"拽"回来。
修复方式为:
流式期间  → behavior: 'auto'(瞬时,没有动画可打断)
非流式    → behavior: 'smooth'(观感)
滚动请求  → requestAnimationFrame 节流合并
自动跟随  → 仅当用户距底部 < 80px 时生效;否则显示「↓ 回到底部」悬浮按钮(流式时带脉冲蓝点)
五、阶段性小结与数据
| 提交 | 内容 | 规模 |
|---|---|---|
feat |
项目骨架初始化 | 54 files / +8139 行 |
feat(settings) |
可视化配置面板 | 10 files / +1098 行 |
feat(chat+config) |
性能统计 + 双阶段测试 + SSE 修复 | 11 files / +624 行 |
feat(ui) |
滚动修复 + 代码块复制/运行 | 4 files / +385 行 |
感觉 AI 协作开发的真实体验是瓶颈不在写代码上,而是在于把需求说清楚 + 端到端验证 + 踩坑后的决策修正。上面每一个"坑",都是验证环节发现的,不是编码环节。
六、系列后续预告
- RAG 知识库:文档解析 → 分片策略 → Embedding 选型 → ChromaDB 召回调优 → 上下文注入的 Prompt 设计
- 插件系统与 Function Calling:让模型自己决定何时联网搜索、何时生成图片
- 多模态与语音:图片理解、TTS 朗读回复、Web Speech 语音输入
- 部署与工程化:Docker 化、打包成桌面单文件、对话导出与统计面板
想先看代码? 仓库在这里:https://gitee.com/A_gua/achat(develop 分支)。README 和提交历史里有更细的变更记录。
觉得有用的话,点个 ⭐ 就是最大的支持。