Hello,大家好,我是 Ivan。
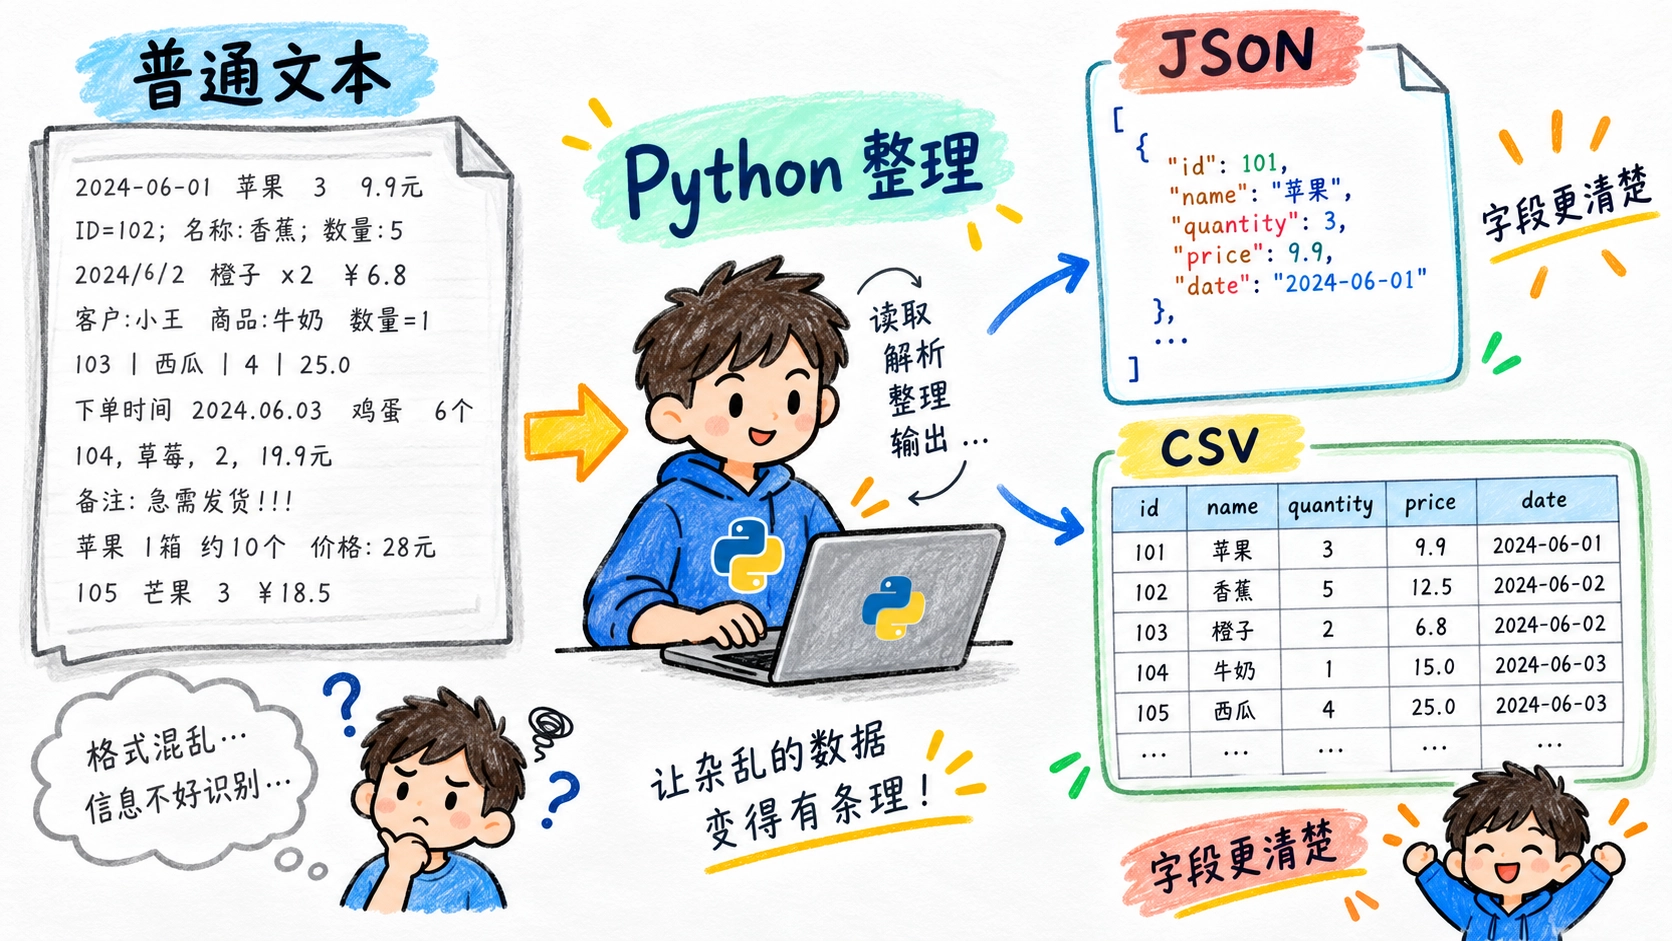
前面我已经讲过怎么读取和写入文件。不过,当时保存的大多是普通字符串。如果要记录一批商品,每件商品都有名称、价格、库存和分类,继续自己拼接文本,后面读取时还要重新拆分,字段稍微多一点就容易乱。
这时候可以换成 JSON 或 CSV。它们都能把数据按照固定格式保存下来,程序再次读取时,也知道哪一部分对应哪个字段。这一章我们就用一组商品数据,把 JSON、CSV 和数据序列化的常见操作写一遍。
一、为什么需要结构化数据
先看一组 Python 商品数据:
python
products = [
    {"id": "P001", "name": "键盘", "price": 299, "stock": 12},
    {"id": "P002", "name": "鼠标", "price": 129, "stock": 0},
    {"id": "P003", "name": "显示器", "price": 1599, "stock": 5},
]
如果直接把它写成普通文本,可能会变成:
P001 键盘 299 12
P002 鼠标 129 0
P003 显示器 1599 5
人能大概看懂,但是程序还要约定每一列的顺序,并处理商品名称中可能出现的空格。以后再增加分类、品牌或者备注,原来的解析代码也要跟着改。
JSON 会保留字段名称:
json
{
  "id": "P001",
  "name": "键盘",
  "price": 299,
  "stock": 12
}
CSV 更接近表格:
id,name,price,stock
P001,键盘,299,12
P002,鼠标,129,0
P003,显示器,1599,5
两种格式的用途不完全相同,后面会分别讲。
二、什么是序列化和反序列化
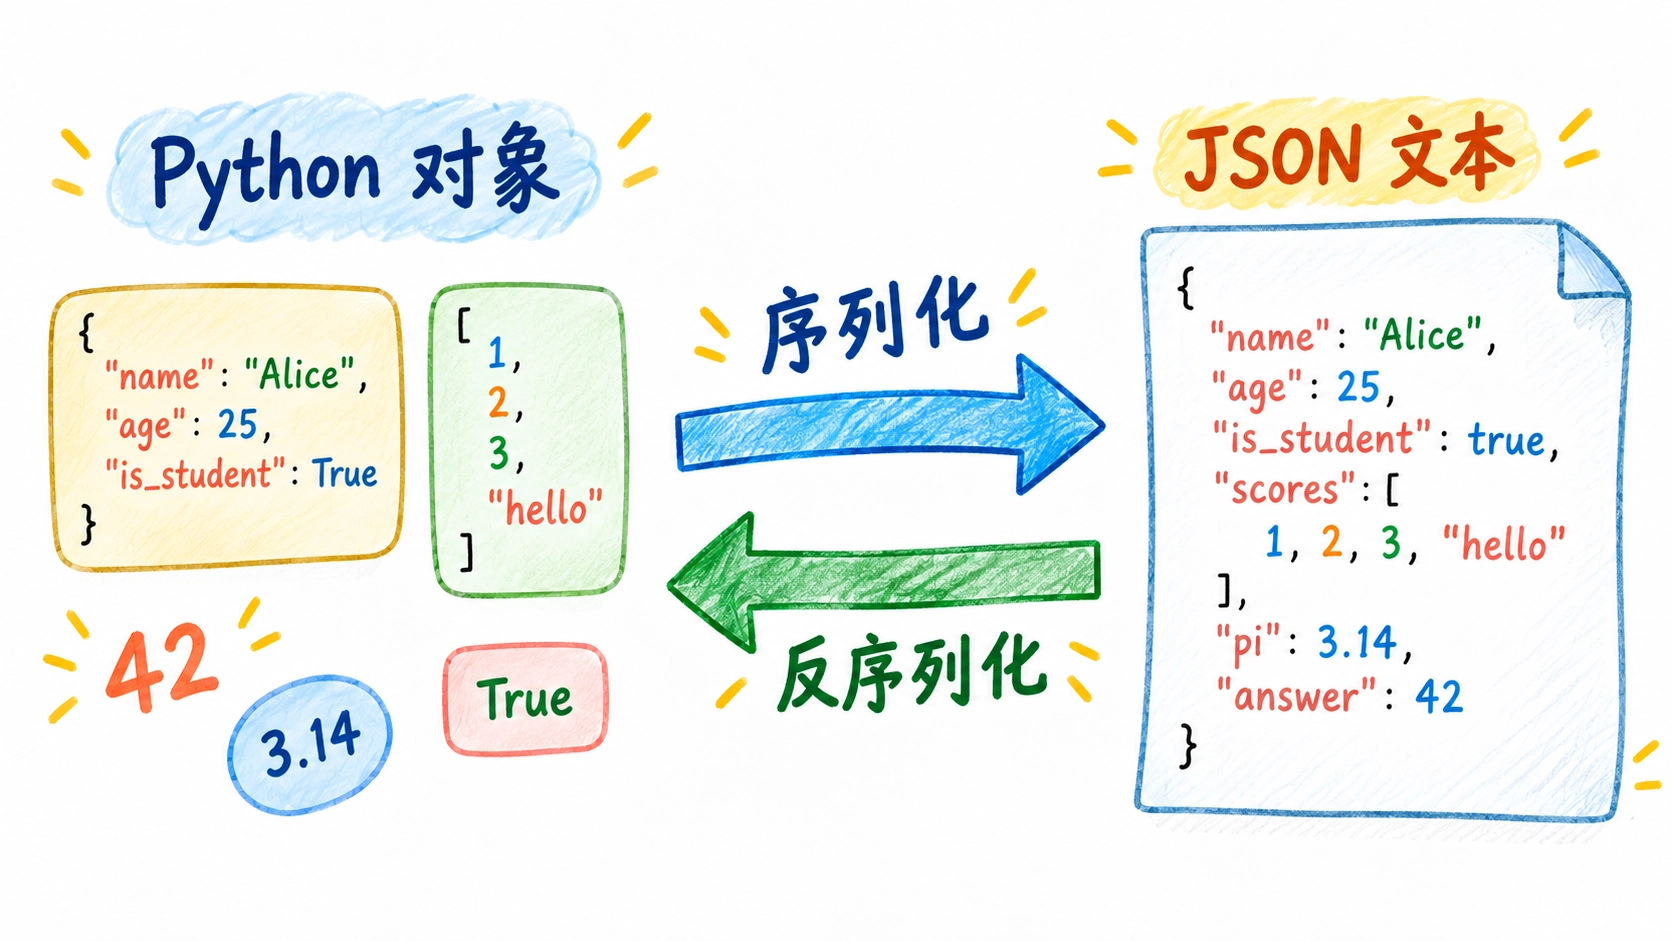
列表和字典存在于 Python 程序的内存中,文件里保存的则是文本或字节。把 Python 对象转换成可以保存、传输的数据格式,这个过程叫作序列化。
程序重新读取文件,再把其中的内容还原成列表或字典,就是反序列化。
Python 对象 → JSON 文本 → 写入文件
读取文件 → JSON 文本 → Python 对象
序列化以后,数据可以保存到磁盘,也可以通过网络发送给其他程序。很多接口返回的内容就是 JSON,因为浏览器、Python、Java 和其他语言都能处理它。
三、JSON 的基本结构
JSON 中常见的是对象和数组。对象使用花括号,数组使用方括号:
json
{
  "name": "Ivan",
  "age": 20,
  "skills": ["Python", "Java"],
  "active": true
}
对象中的数据按照键值对保存,键必须使用双引号包起来。数组中可以继续放字符串、数字、对象或者其他数组。
JSON 看起来和 Python 的字典、列表很像,不过它们不是同一种语法。下面几个地方要注意:
Python       JSON
True         true
False        false
None         null
Python 可以使用单引号表示字符串,JSON 字符串必须使用双引号。
四、Python 类型与 JSON 类型
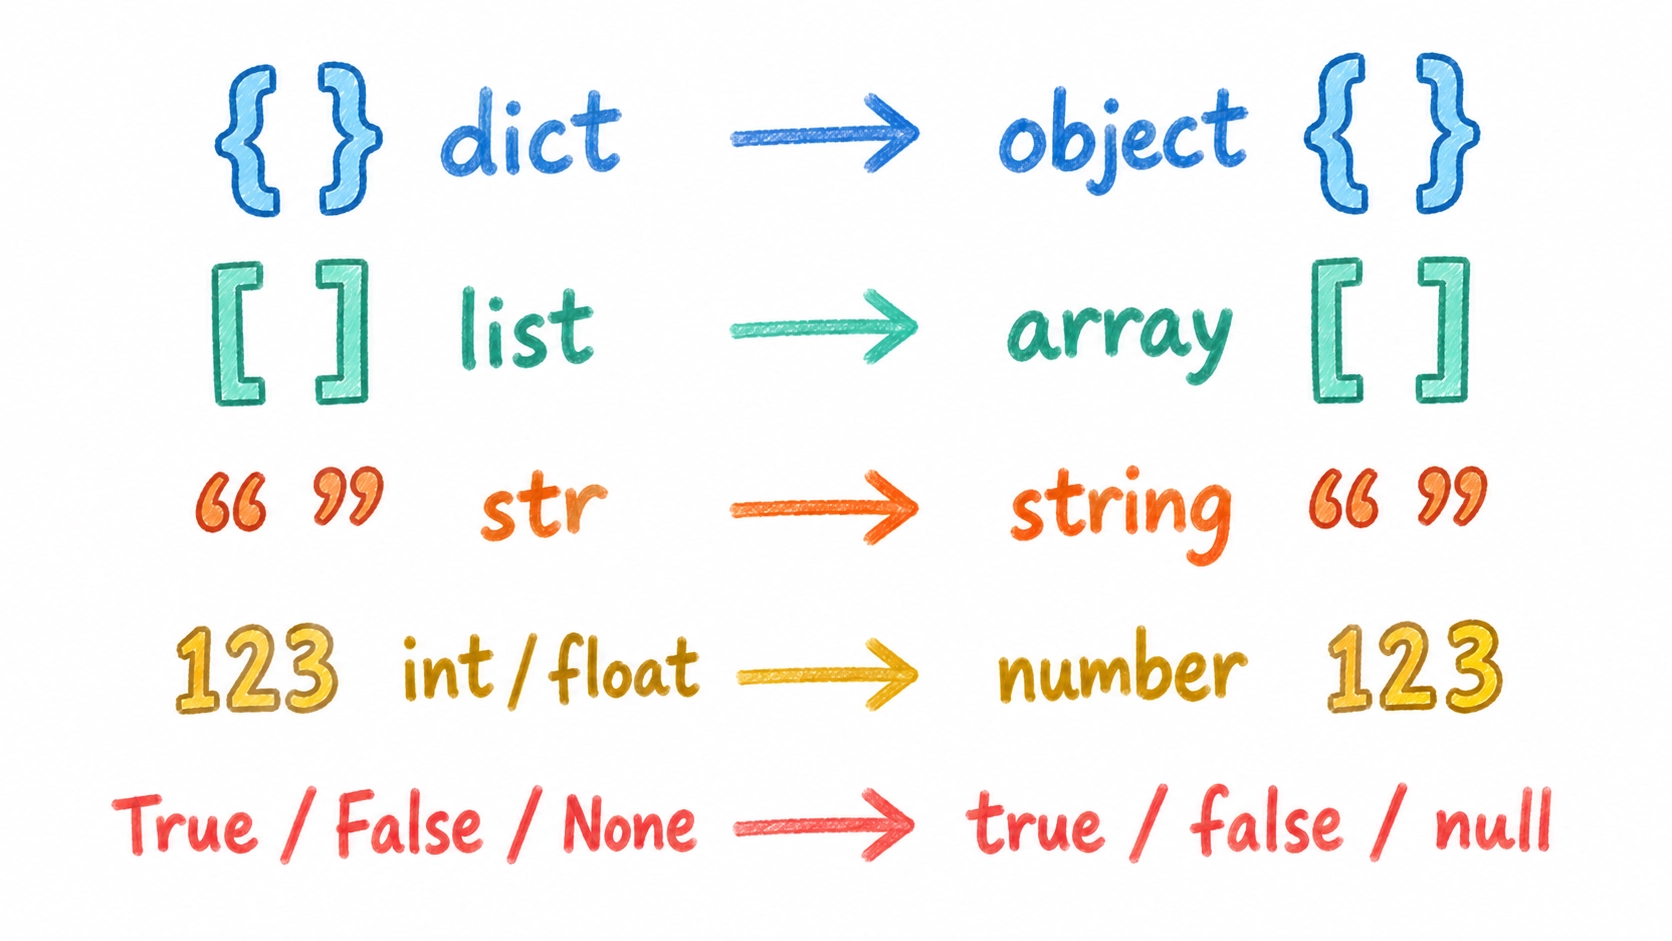
使用 json 模块转换数据时,常见类型会按照下面的关系处理:
| Python 类型 | JSON 类型 |
|---|---|
dict |
object |
list、tuple |
array |
str |
string |
int、float |
number |
True、False |
true、false |
None |
null |
需要留意的是,元组保存到 JSON 后会变成数组,再读取回来时得到的是列表:
python
import json

data = (10, 20, 30)

json_text = json.dumps(data)
result = json.loads(json_text)

print(json_text)
print(result)
print(type(result))
输出结果是:
[10, 20, 30]
[10, 20, 30]
<class 'list'>
JSON 本身没有元组类型,所以读取时无法恢复成原来的元组。
五、使用 dumps 把对象转换成字符串
Python 标准库中的 json 模块可以处理 JSON:
python
import json

product = {
    "id": "P001",
    "name": "键盘",
    "price": 299,
    "stock": 12,
}

json_text = json.dumps(product)

print(json_text)
print(type(json_text))
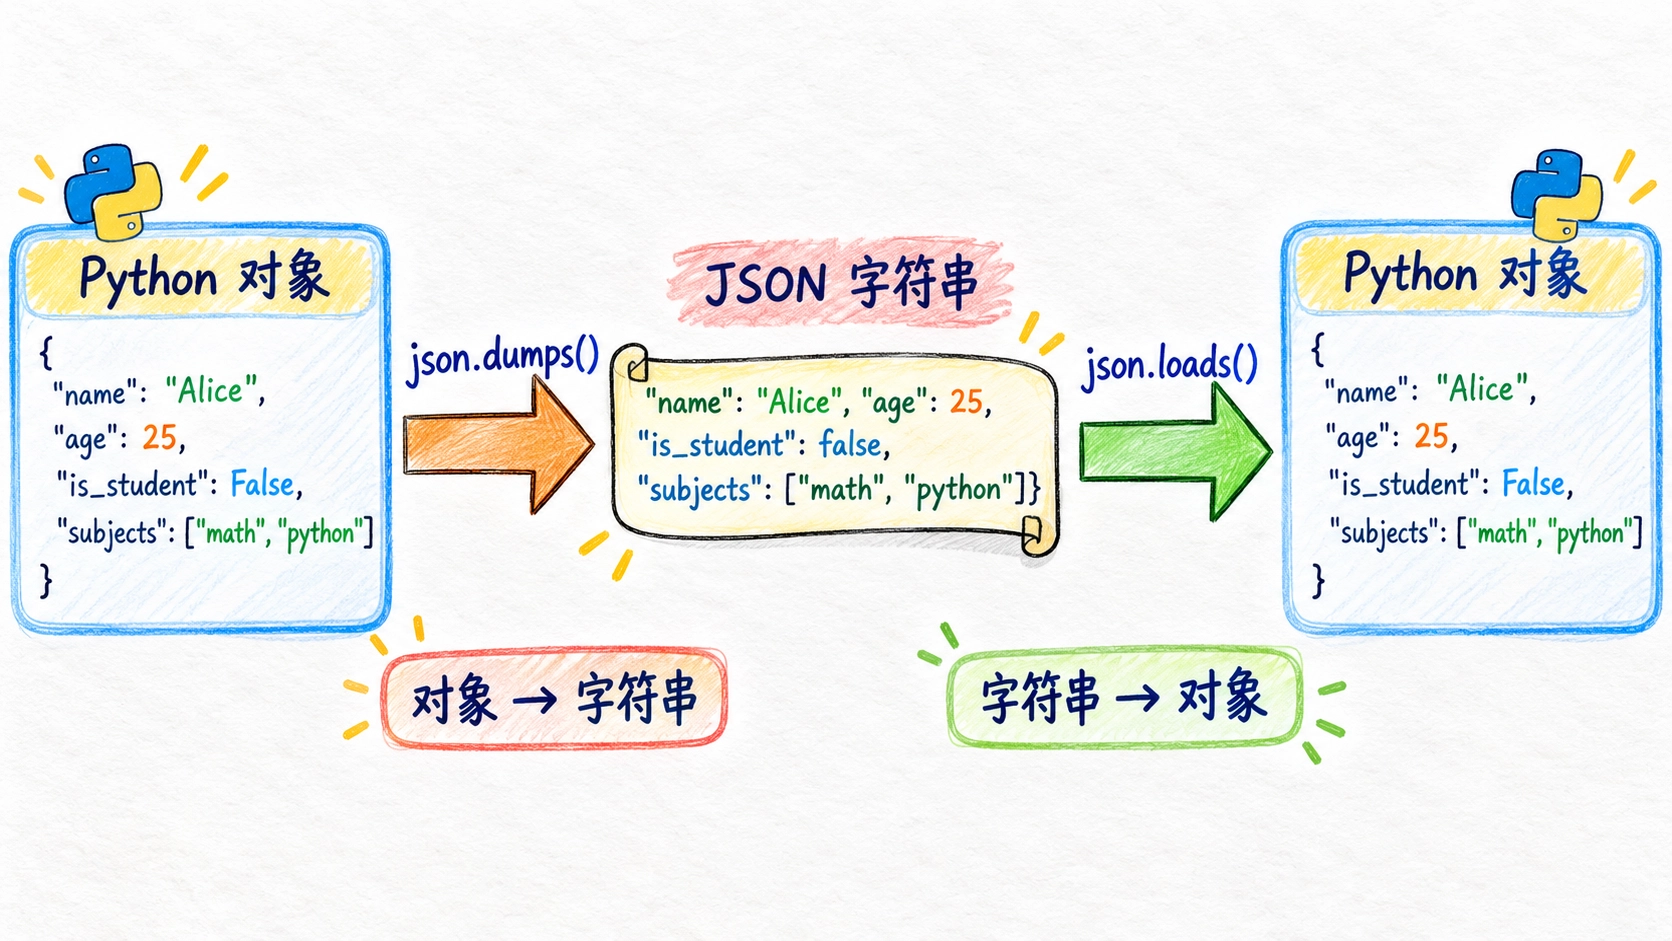
json.dumps() 接收一个 Python 对象,返回 JSON 字符串。这里的结果类型是 str,还没有写入文件。
默认情况下,中文会被转成 Unicode 转义字符:
{"name": "\u952e\u76d8"}想直接看到中文,可以设置 ensure_ascii=False:
python
json_text = json.dumps(
    product,
    ensure_ascii=False,
)

print(json_text)
如果还想让结构更容易阅读,可以加上缩进:
python
json_text = json.dumps(
    product,
    ensure_ascii=False,
    indent=2,
)

print(json_text)
输出会变成:
json
{
  "id": "P001",
  "name": "键盘",
  "price": 299,
  "stock": 12
}
六、使用 loads 把字符串转回对象
json.loads() 负责处理反方向的转换:
python
import json

json_text = '''
{
  "id": "P001",
  "name": "键盘",
  "price": 299,
  "stock": 12
}
'''

product = json.loads(json_text)

print(product)
print(type(product))
print(product["name"])
运行结果是:
{'id': 'P001', 'name': '键盘', 'price': 299, 'stock': 12}
<class 'dict'>
键盘
方法名末尾的 s 可以理解成 string。dumps() 得到字符串,loads() 读取字符串。后面要讲的 dump() 和 load(),直接接收文件对象。
七、把 JSON 写入文件
先准备项目目录:
data_demo/
├─ main.py
└─ data/
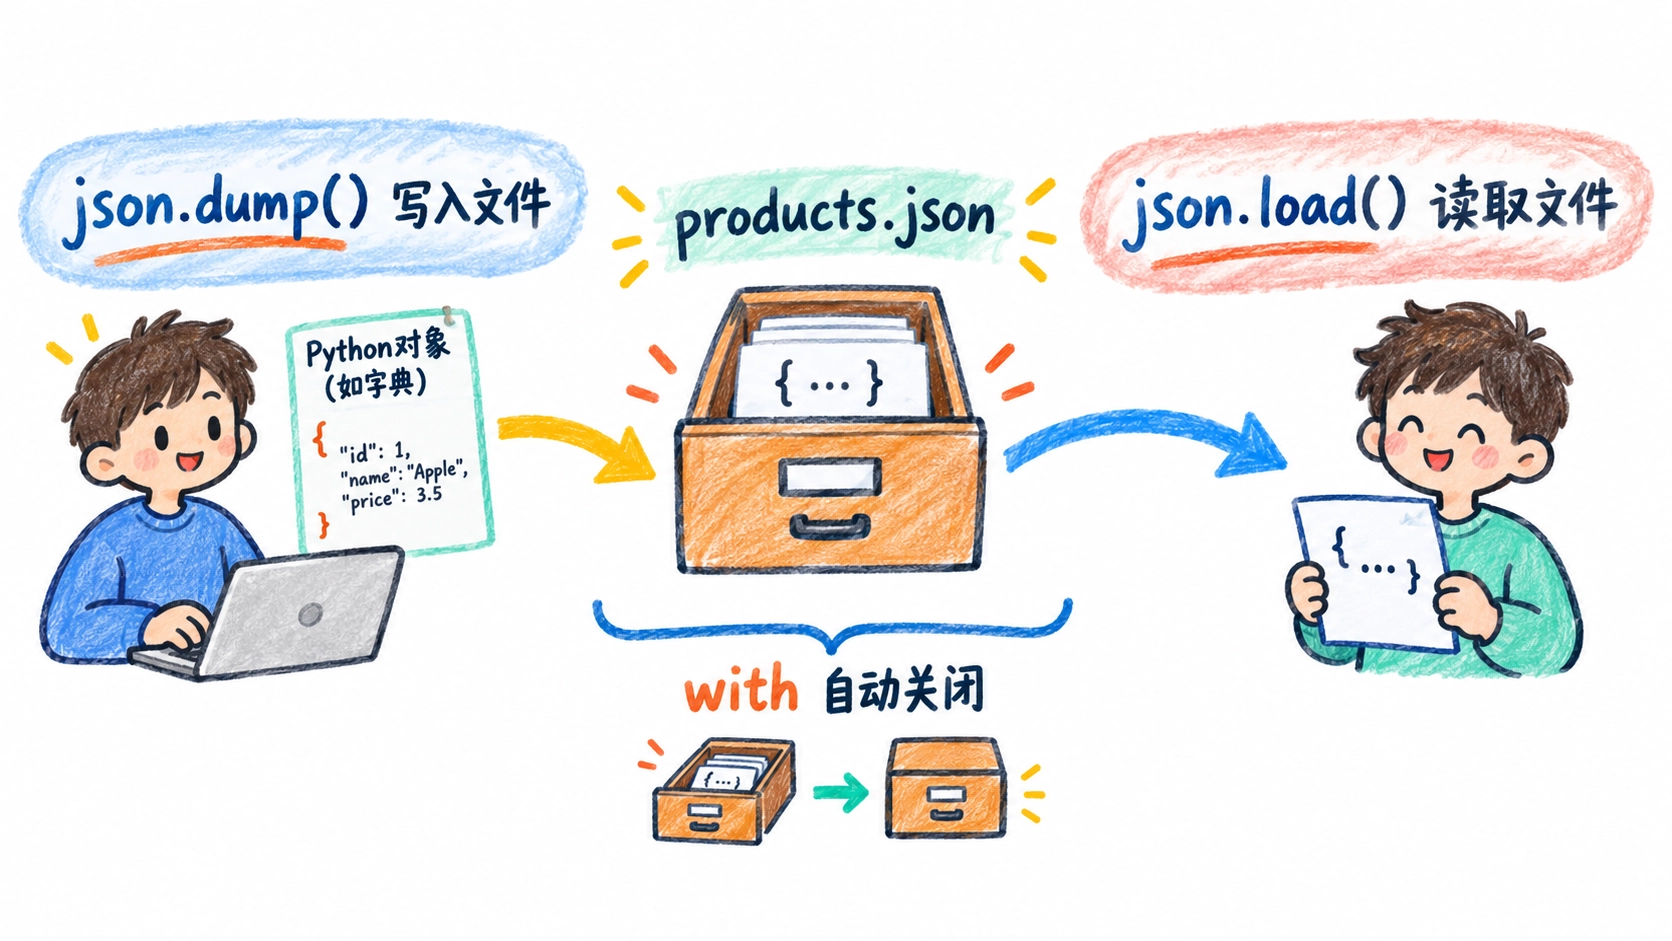
使用 json.dump() 把商品列表写入文件:
python
from pathlib import Path
import json

products = [
    {"id": "P001", "name": "键盘", "price": 299, "stock": 12},
    {"id": "P002", "name": "鼠标", "price": 129, "stock": 0},
    {"id": "P003", "name": "显示器", "price": 1599, "stock": 5},
]

base_dir = Path(__file__).resolve().parent
data_dir = base_dir / "data"
data_dir.mkdir(exist_ok=True)

json_path = data_dir / "products.json"

with json_path.open("w", encoding="utf-8") as file:
    json.dump(
        products,
        file,
        ensure_ascii=False,
        indent=2,
)这里的第二个参数是文件对象。json.dump() 会完成对象到 JSON 文本的转换,并把结果写入 products.json。
因为打开文件时使用了 "w",重复运行会覆盖原文件。配置和数据快照通常可以这样保存;如果需要保留每次历史记录,就要生成不同文件名,或者改用更合适的存储方式。
八、从 JSON 文件读取数据
读取刚才生成的文件,可以使用 json.load():
python
from pathlib import Path
import json

base_dir = Path(__file__).resolve().parent
json_path = base_dir / "data" / "products.json"

with json_path.open("r", encoding="utf-8") as file:
    products = json.load(file)

for product in products:
    print(product["name"], product["price"])
输出结果是:
键盘 299
鼠标 129
显示器 1599
json.load() 会读取文件并完成反序列化。JSON 最外层是数组,所以这里得到列表;数组里的每个对象会变成字典。
九、处理嵌套 JSON
JSON 可以保存多层结构,接口返回结果里经常会看到这种数据:
json
{
  "code": 200,
  "message": "success",
  "data": {
    "total": 2,
    "items": [
      {
        "id": "P001",
        "name": "键盘"
      },
      {
        "id": "P002",
        "name": "鼠标"
      }
    ]
  }
}
读取以后,按照字典和列表的层级访问:
python
result = json.loads(json_text)

items = result["data"]["items"]

for item in items:
    print(item["name"])
层级多的时候,可以把中间结果保存到变量里。全部写成一长串下标虽然能运行,但是后面排查缺少字段的问题会比较麻烦。
十、JSON 不能直接保存哪些对象
JSON 支持的类型有限。集合、日期、Path 对象和自己定义的类,不能直接交给 json.dumps():
python
import json

product = {
    "name": "键盘",
    "tags": {"办公", "外设"},
}

json.dumps(product, ensure_ascii=False)
运行时会出现:
TypeError: Object of type set is not JSON serializable保存前需要转换成 JSON 支持的类型:
python
product["tags"] = list(product["tags"])

json_text = json.dumps(
    product,
    ensure_ascii=False,
)
日期也可以先转换成字符串:
python
from datetime import datetime

created_at = datetime.now()

data = {
    "created_at": created_at.isoformat(),
}再次读取时,created_at 还是字符串。如果程序需要日期对象,还要使用 datetime.fromisoformat() 转回去。
十一、JSON 常见格式错误
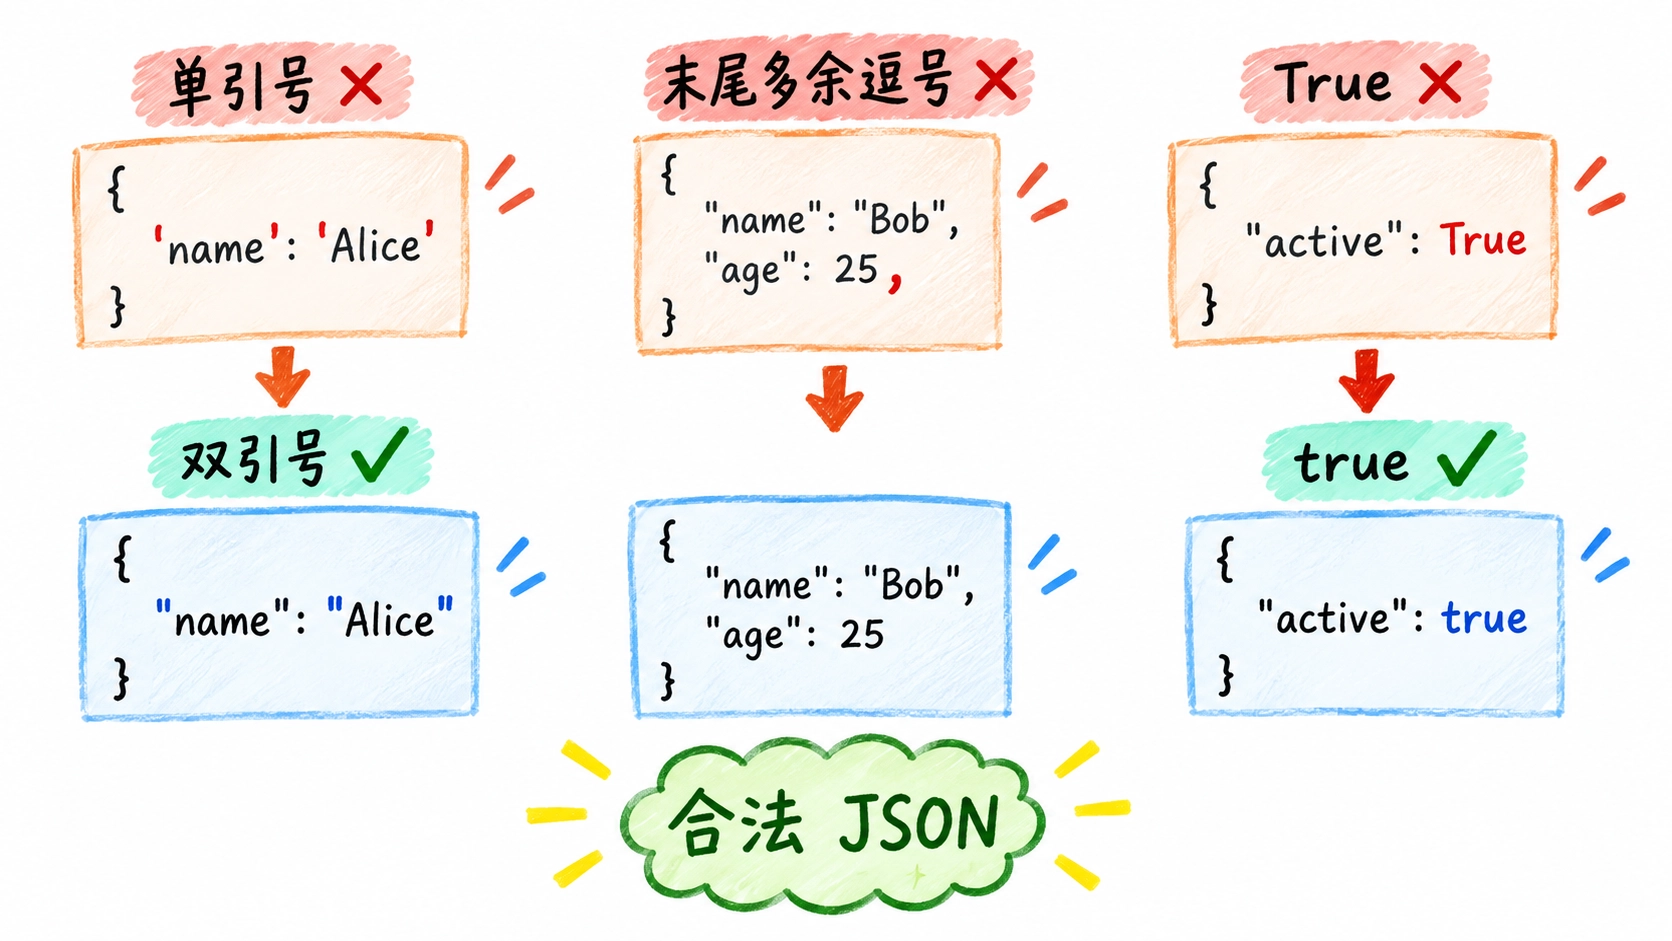
下面这段内容看起来像字典,但是它不是合法 JSON:
{
  'name': '键盘',
  'price': 299,
  'active': True,
}
这里有三个问题:字符串使用了单引号,布尔值写成了 Python 的 True,最后一个字段后面还保留了逗号。
合法 JSON 应该写成:
json
{
  "name": "键盘",
  "price": 299,
  "active": true
}格式有问题时,json.loads() 或 json.load() 会抛出 JSONDecodeError。可以使用 Python 自带的命令检查文件:
bash
python -m json.tool data/products.json文件格式正确时,终端会输出整理后的 JSON;有错误时,会显示大概的行号和列号。
十二、CSV 是怎么保存数据的
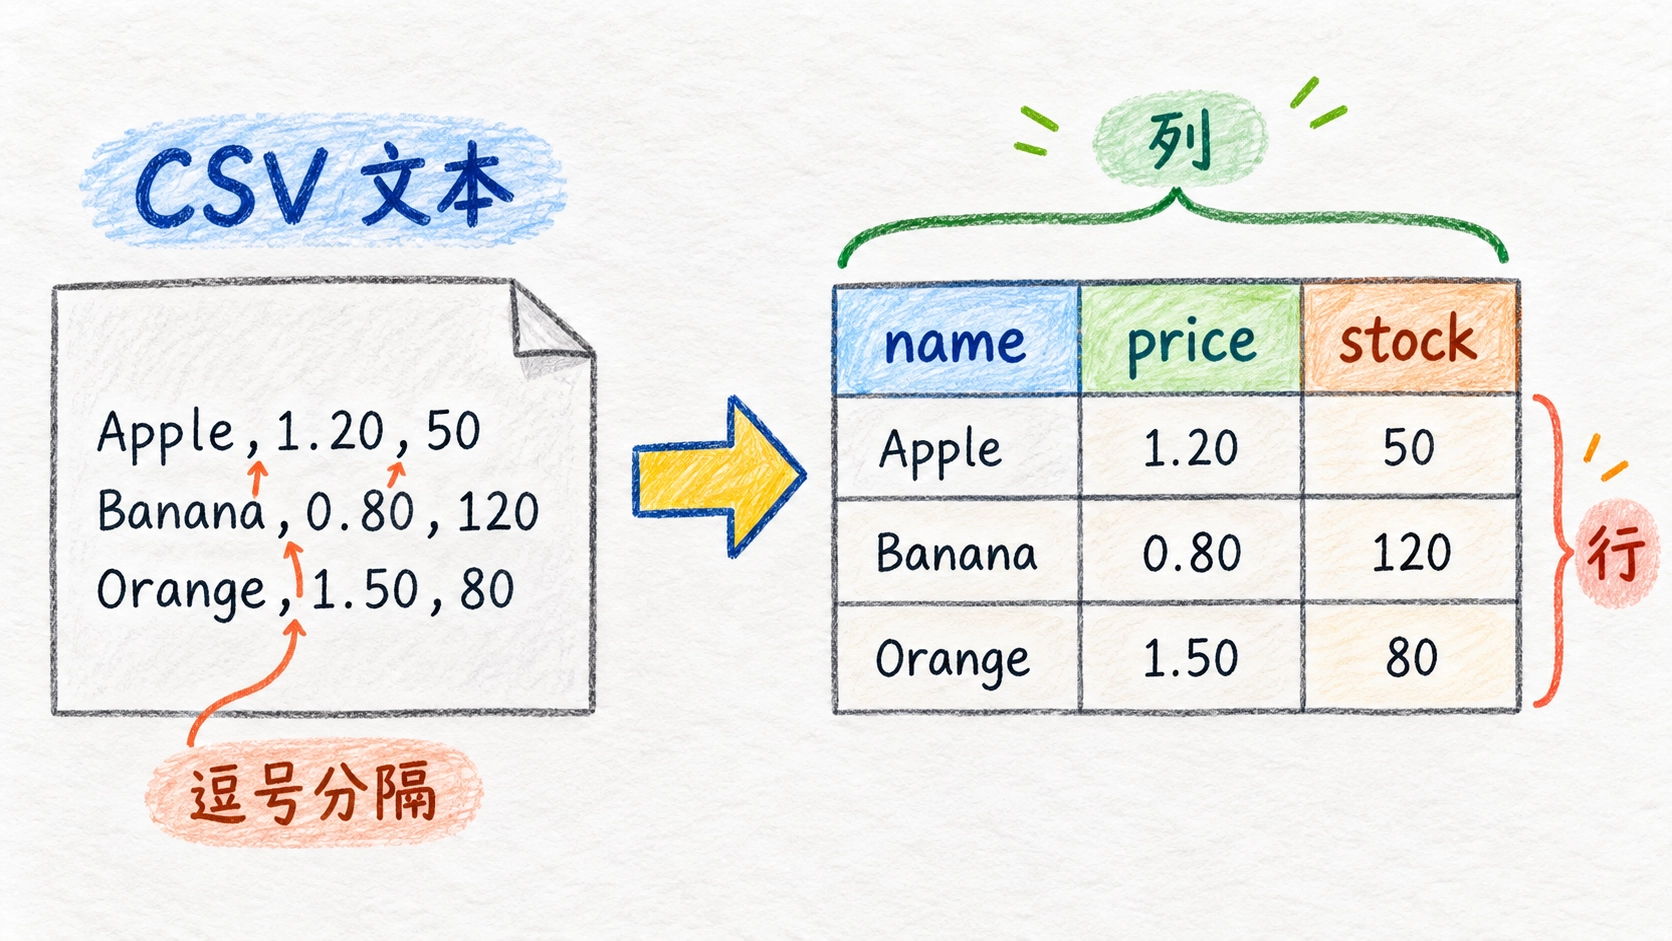
CSV 的全称是 Comma-Separated Values,也就是逗号分隔值。它按行保存记录,第一行通常是表头:
id,name,price,stock
P001,键盘,299,12
P002,鼠标,129,0
P003,显示器,1599,5
每一行是一条商品记录,每一列对应一个字段。CSV 很适合保存结构相同的批量数据,也能直接用表格软件查看。
CSV 不适合自然表达多层嵌套。商品还有多个标签、不同规格和详细参数时,硬塞进一个单元格会越来越难处理,这类数据通常更适合 JSON。
十三、使用 csv.reader 读取文件
Python 标准库提供了 csv 模块。先准备一个 products.csv:
id,name,price,stock
P001,键盘,299,12
P002,鼠标,129,0
P003,显示器,1599,5
使用 csv.reader() 读取:
python
from pathlib import Path
import csv

base_dir = Path(__file__).resolve().parent
csv_path = base_dir / "data" / "products.csv"

with csv_path.open("r", encoding="utf-8", newline="") as file:
    reader = csv.reader(file)

    for row in reader:
        print(row)
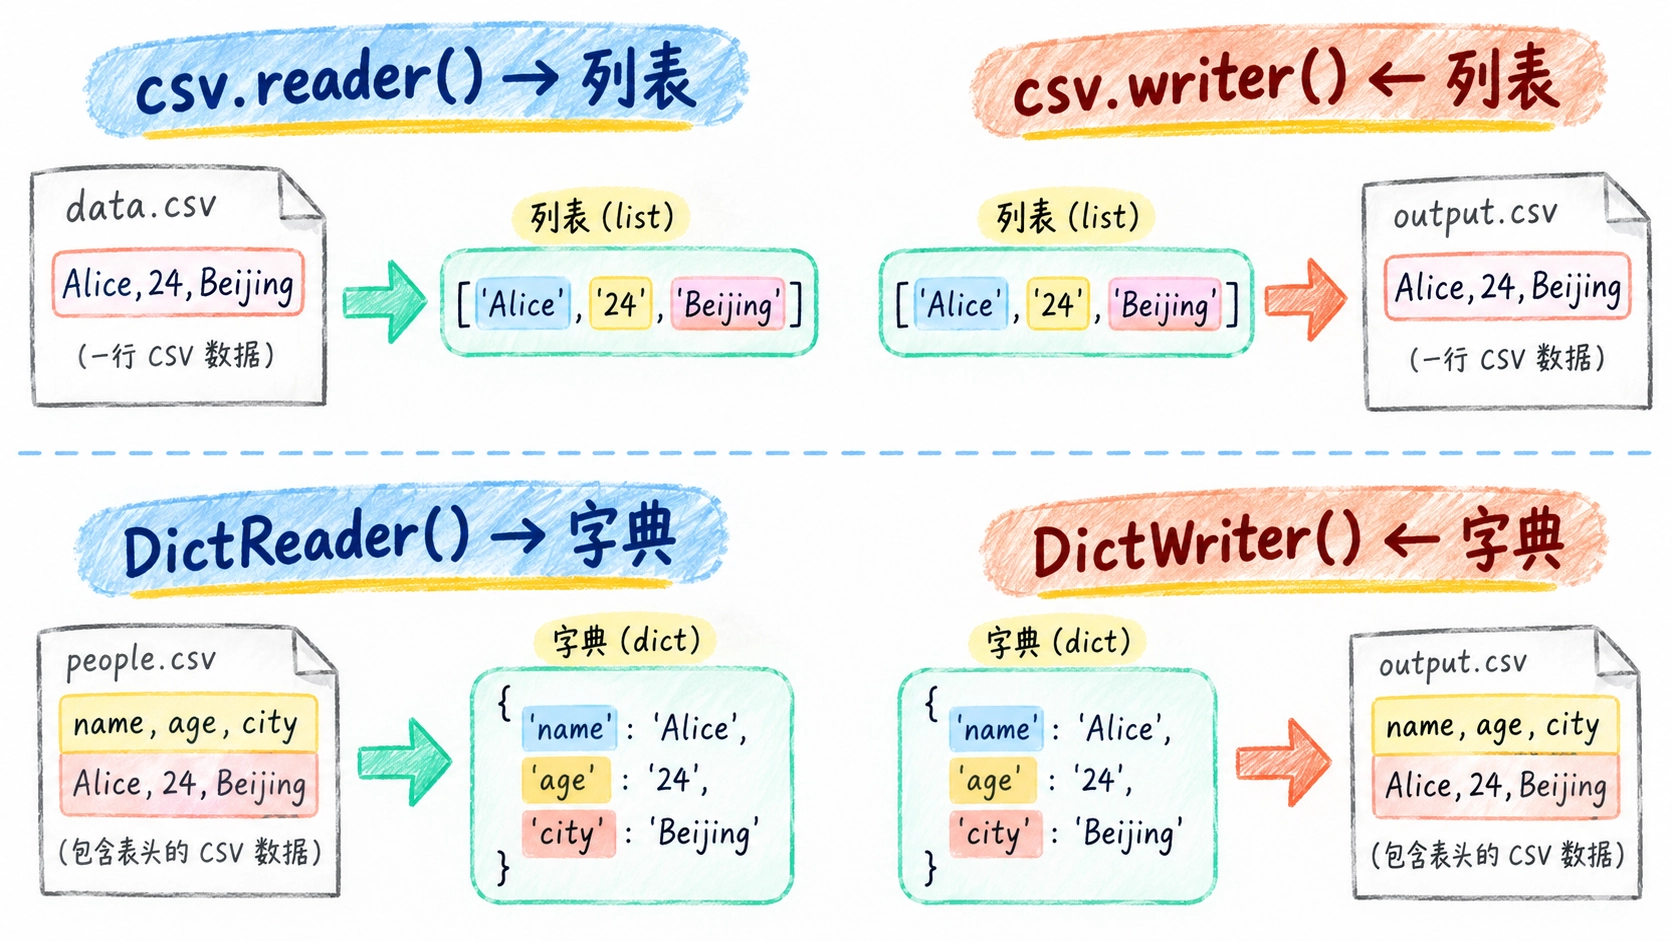
每一行都会变成列表:
['id', 'name', 'price', 'stock']
['P001', '键盘', '299', '12']
['P002', '鼠标', '129', '0']
['P003', '显示器', '1599', '5']
CSV 读取出来的内容默认都是字符串。后面要计算价格和库存时,需要自己转换类型:
python
price = float(row[2])
stock = int(row[3])
打开 CSV 文件时建议加上 newline="",让 csv 模块自己处理换行。Windows 上写入文件时,这个参数也能避免出现多余空行。
十四、使用 csv.writer 写入文件
csv.writer() 接收一行列表,再把它写成 CSV:
python
from pathlib import Path
import csv

products = [
    ["P001", "键盘", 299, 12],
    ["P002", "鼠标", 129, 0],
    ["P003", "显示器", 1599, 5],
]

csv_path = Path("data/products.csv")

with csv_path.open("w", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)

    writer.writerow(["id", "name", "price", "stock"])
    writer.writerows(products)
writerow() 写入一行,writerows() 可以一次写入多行。这里的 "w" 仍然会覆盖原文件。
如果某个字段中本身带有逗号,csv 模块会自动加上引号:
python
writer.writerow([
    "P004",
    "键盘,鼠标套装",
    399,
    8,
])
文件中会得到:
P004,"键盘,鼠标套装",399,8这也是不建议自己使用 line.split(",") 解析 CSV 的原因。字段中出现逗号、引号或换行时,手动切分很容易出错。
十五、使用 DictReader 按字段读取
csv.reader() 得到的是列表,访问价格要写 row[2]。列一多,很难记住每个位置对应什么字段。
CSV 带有表头时,可以使用 DictReader:
python
from pathlib import Path
import csv

csv_path = Path("data/products.csv")

with csv_path.open("r", encoding="utf-8", newline="") as file:
    reader = csv.DictReader(file)

    for product in reader:
        print(product["name"], product["price"])
每一行会变成字典,键来自第一行表头:
python
{
    "id": "P001",
    "name": "键盘",
    "price": "299",
    "stock": "12",
}
这里的价格和库存依然是字符串,只是访问方式从位置下标变成了字段名。
十六、使用 DictWriter 写入字典
商品数据本来就是字典时,使用 DictWriter 更方便:
python
from pathlib import Path
import csv

products = [
    {"id": "P001", "name": "键盘", "price": 299, "stock": 12},
    {"id": "P002", "name": "鼠标", "price": 129, "stock": 0},
    {"id": "P003", "name": "显示器", "price": 1599, "stock": 5},
]

fieldnames = ["id", "name", "price", "stock"]
csv_path = Path("data/products.csv")

with csv_path.open("w", encoding="utf-8", newline="") as file:
    writer = csv.DictWriter(
        file,
        fieldnames=fieldnames,
    )

    writer.writeheader()
    writer.writerows(products)
fieldnames 决定字段和列的顺序,writeheader() 写入表头,writerows() 写入多条字典数据。
如果字典里有 fieldnames 之外的字段,默认会报错。需要哪些列,最好在写入之前明确整理好。
十七、CSV 中文打开乱码怎么办
使用代码读取 CSV 时,统一写 encoding="utf-8" 就可以了。但是,有些版本的 Excel 直接打开 UTF-8 CSV,可能无法正确识别中文。
需要把文件交给 Excel 使用时,可以写成 utf-8-sig:
python
with csv_path.open(
    "w",
    encoding="utf-8-sig",
    newline="",
) as file:
    writer = csv.DictWriter(
        file,
        fieldnames=fieldnames,
    )

    writer.writeheader()
    writer.writerows(products)
utf-8-sig 会在文件开头加入编码标记,Excel 通常可以据此识别 UTF-8。后面如果这个 CSV 只交给程序处理,普通的 UTF-8 就够了。
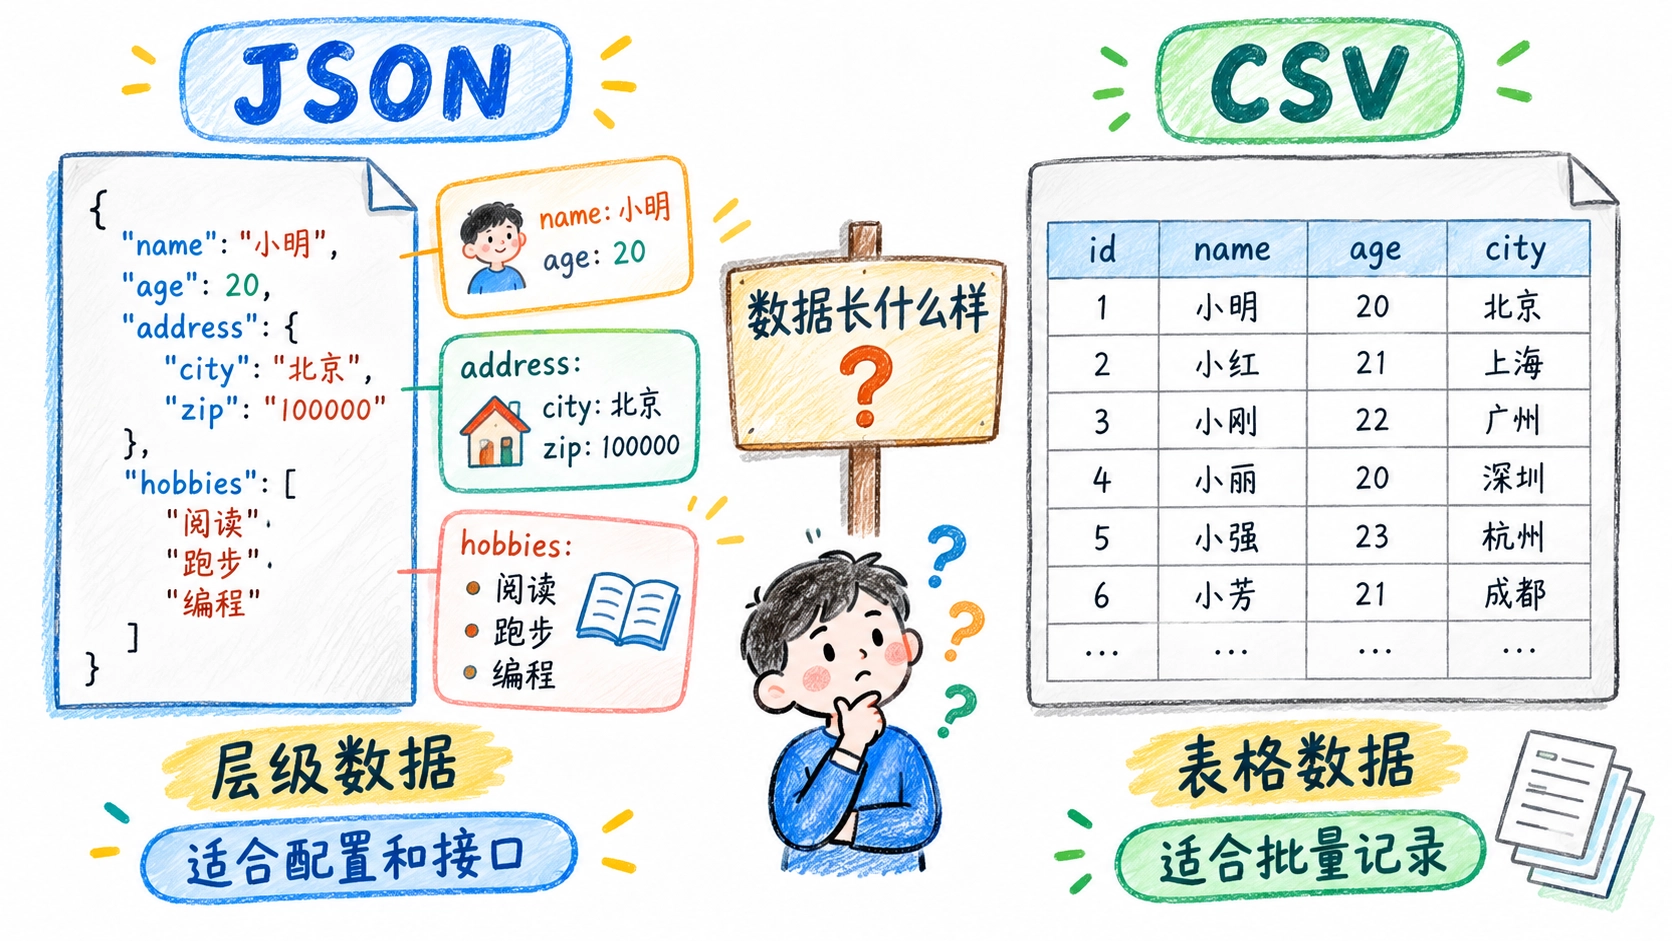
十八、JSON 和 CSV 怎么选
JSON 能保存嵌套对象和数组,字段也会保留类型。配置文件、接口数据以及层级较多的内容,经常使用 JSON。
CSV 适合结构一致的表格数据。每一行字段相同,数据量又比较大时,CSV 查看和处理都很方便。
| 使用场景 | 更适合的格式 |
|---|---|
| 保存程序配置 | JSON |
| 接口请求和返回数据 | JSON |
| 保存包含嵌套列表的数据 | JSON |
| 导出商品、订单和用户表格 | CSV |
| 交给表格软件查看 | CSV |
| 和数据分析工具交换批量记录 | CSV |
格式没有固定的高低之分,主要看数据本身长什么样,以及接下来要交给谁使用。
十九、pickle 可以保存更多 Python 对象
JSON 只能处理有限的数据类型。如果只在 Python 程序内部保存对象,还可以使用 pickle:
python
from pathlib import Path
import pickle

products = [
    {"name": "键盘", "price": 299},
    {"name": "鼠标", "price": 129},
]

file_path = Path("data/products.pkl")

with file_path.open("wb") as file:
    pickle.dump(products, file)
读取时使用二进制模式:
python
with file_path.open("rb") as file:
    products = pickle.load(file)

print(products)
pickle 保存的是 Python 专用二进制格式,其他语言通常不能直接使用,文件内容也不方便人工查看。
更重要的是,不要加载来源不明的 .pkl 文件。恶意构造的 pickle 数据可能在反序列化时执行代码。自己项目内部的临时缓存可以考虑使用,接口传输、公开文件和用户上传内容不要使用它。
二十、综合示例:生成库存报表
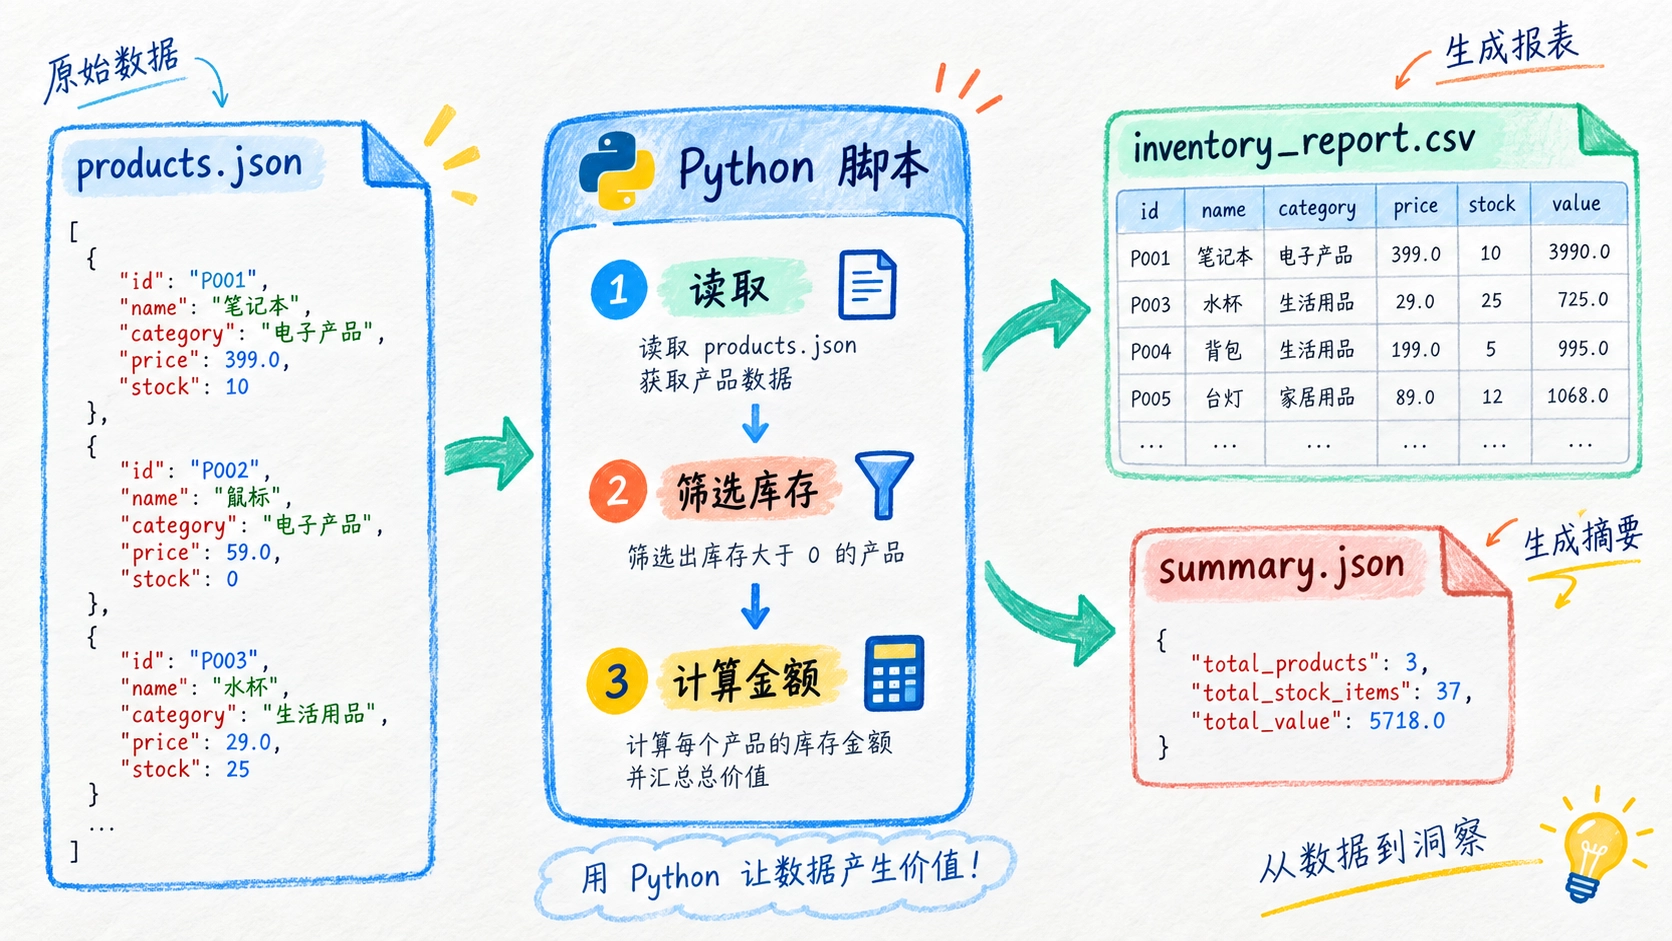
现在把 JSON 和 CSV 连起来。程序会从 products.json 读取商品,筛选有库存的记录,计算库存金额,再生成 inventory_report.csv 和 summary.json。
项目结构如下:
data_demo/
├─ report.py
├─ data/
│  └─ products.json
└─ output/
products.json 中准备下面的数据:
json
[
  {
    "id": "P001",
    "name": "键盘",
    "category": "电脑外设",
    "price": 299,
    "stock": 12
  },
  {
    "id": "P002",
    "name": "鼠标",
    "category": "电脑外设",
    "price": 129,
    "stock": 0
  },
  {
    "id": "P003",
    "name": "显示器",
    "category": "电脑外设",
    "price": 1599,
    "stock": 5
  }
]
在 report.py 中写入:
python
from pathlib import Path
import csv
import json

base_dir = Path(__file__).resolve().parent
data_file = base_dir / "data" / "products.json"
output_dir = base_dir / "output"

output_dir.mkdir(parents=True, exist_ok=True)

with data_file.open("r", encoding="utf-8") as file:
    products = json.load(file)

available_products = []

for product in products:
    if product["stock"] <= 0:
        continue

    product["inventory_value"] = round(
        product["price"] * product["stock"],
        2,
    )
    available_products.append(product)

csv_file = output_dir / "inventory_report.csv"
fieldnames = [
    "id",
    "name",
    "category",
    "price",
    "stock",
    "inventory_value",
]

with csv_file.open(
    "w",
    encoding="utf-8-sig",
    newline="",
) as file:
    writer = csv.DictWriter(
        file,
        fieldnames=fieldnames,
    )
    writer.writeheader()
    writer.writerows(available_products)

summary = {
    "source_count": len(products),
    "available_count": len(available_products),
    "total_stock": sum(
        product["stock"]
        for product in available_products
    ),
    "total_value": round(
        sum(
            product["inventory_value"]
            for product in available_products
        ),
        2,
    ),
}

summary_file = output_dir / "summary.json"

with summary_file.open("w", encoding="utf-8") as file:
    json.dump(
        summary,
        file,
        ensure_ascii=False,
        indent=2,
    )

print(f"CSV 报表:{csv_file}")
print(f"汇总数据:{summary_file}")
products.json 负责保存原始商品数据。程序读取以后,把库存为 0 的商品排除,再为剩余商品增加 inventory_value 字段。
详细记录写进 CSV,方便用表格软件查看;统计结果写进 JSON,后续程序可以继续读取。两种格式放在同一个案例里,用途上的区别会更明显。
二十一、练习
练习一:保存用户信息
创建一个包含姓名、年龄和技能列表的字典,使用 json.dump() 保存到 user.json,再读取回来并打印技能列表。
练习二:处理不支持的类型
在字典中加入一个集合和一个日期对象,观察 json.dumps() 的报错,再把它们转换成 JSON 支持的类型。
练习三:检查 JSON 文件
准备一个包含单引号、末尾逗号和 True 的错误 JSON 文件。使用 python -m json.tool 找到问题,再把它改成合法 JSON。
练习四:统计 CSV 数据
使用 csv.DictReader() 读取商品 CSV,把价格转换成 float,库存转换成 int,统计所有商品的库存总数。
练习五:导出筛选结果
从 CSV 中筛选价格大于 500 的商品,使用 DictWriter 写入 expensive_products.csv,并保留原来的表头。
练习六:完成 JSON 与 CSV 转换
读取一个由字典列表组成的 JSON 文件,把它转换成 CSV。再读取生成的 CSV,把数据重新整理成列表,并写入新的 JSON 文件。
写 JSON 和 CSV 时,代码通常不会很长。容易出错的地方还是数据类型、编码和字段结构。保存之前先确认数据中有没有集合、日期或者自定义对象,读取 CSV 后也要记得把需要计算的字段转成数字。