后端面试高频题:"什么是一致性哈希?为什么需要它?"用取模哈希把数据分到多台服务器上不行吗?节点增减时为什么会全量迁移?本文从问题出发,一步步推导出一致性哈希的设计思路,最后给出完整代码实现。
问题:取模哈希的痛点
假设有 3 台缓存服务器,用 hash(key) % 3 决定数据存哪台:
key-001 → hash(key-001) = 12345 → 12345 % 3 = 0 → 服务器 A
key-002 → hash(key-002) = 67890 → 67890 % 3 = 2 → 服务器 C
key-003 → hash(key-003) = 11111 → 11111 % 3 = 1 → 服务器 B
现在加一台服务器,变成 4 台:
key-001 → 12345 % 4 = 1 → 服务器 B(原来在 A)
key-002 → 67890 % 4 = 2 → 服务器 C(没变)
key-003 → 11111 % 4 = 3 → 服务器 D(原来在 B)几乎所有数据的位置都变了!每增加或减少一台服务器,约 (n-1)/n 的数据需要迁移(n 是原来的节点数)。
3 台 → 4 台:约 75% 数据迁移
10 台 → 11 台:约 90% 数据迁移
100 台 → 101 台:约 99% 数据迁移
节点越多,增减节点的影响越大。对于有 100 台缓存的系统,加一台机器导致 99% 的缓存失效------相当于缓存雪崩。
一致性哈希的核心思想
1997 年,MIT 的 Karger 等人在论文《Consistent Hashing and Random Trees》中提出了一致性哈希算法。
核心思想:把服务器和数据都映射到同一个哈希环上。
         [0]
        /   \
       /     \
[2^32-1]     [1]
   |          |
   |   哈希环  |
   |          |
[2^32-2]     [2]
       \     /
        \   /
         ...
哈希环的范围是 0 到 2^32 - 1(即 uint32 的取值范围)。
第一步:把服务器放到环上
对服务器的标识(IP 或 ID)计算哈希,映射到环上的某个位置:
服务器 A: hash("192.168.1.1") → 位置 10000
服务器 B: hash("192.168.1.2") → 位置 50000
服务器 C: hash("192.168.1.3") → 位置 90000

哈希环:
0 ────A(10000) ────B(50000) ────C(90000) ──── 2^32-1
第二步:把数据映射到环上
对数据的 key 计算哈希,也映射到环上:
key-001: hash("user:1001") → 位置 20000
key-002: hash("user:1002") → 位置 60000
key-003: hash("user:1003") → 位置 95000
第三步:顺时针找最近的服务器
数据落在环上的位置后,顺时针找到的第一个服务器,就是存储这个数据的服务器:
key-001 在 20000 → 顺时针下一个是 B(50000) → 存在服务器 B
key-002 在 60000 → 顺时针下一个是 C(90000) → 存在服务器 C
key-003 在 95000 → 顺时针下一个是 A(10000) → 存在服务器 A(绕了一圈)
节点增减的迁移量
增加一台服务器
加一台服务器 D,哈希位置在 70000:
0 ────A(10000) ────B(50000) ───D(70000)───C(90000) ──── 2^32-1哪些数据需要迁移?只有落在 50000-70000 之间的数据,从服务器 B 迁移到服务器 D。
迁移量 = 环上 B-D 区间的数据量 ≈ 总数据量 × 1/4 = 25%对比取模哈希的 75% 迁移量,一致性哈希只迁移了约 1/n(n 是节点数)。
减少一台服务器
服务器 B 挂了:
0 ────A(10000) ──────────────C(90000) ──── 2^32-1原来存在 B 上的数据(10000-50000 区间),现在顺时针落到 C 上。只有 B 上的数据需要迁移,约 1/3 的数据量。
迁移量对比
| 方案 | 3 → 4 台 | 10 → 11 台 | 100 → 101 台 |
|---|---|---|---|
| 取模哈希 | 约 75% | 约 90% | 约 99% |
| 一致性哈希 | 约 25% | 约 9% | 约 1% |
节点越多,一致性哈希的优势越明显。100 台集群加一台机器,只需要迁移约 1% 的数据。
虚拟节点:解决数据倾斜
一致性哈希有个问题:如果服务器数量少(比如 3 台),哈希落点可能分布不均匀,导致某台服务器压力特别大。
极端情况(3 台服务器哈希落点很近):
0 ─────A──B──C──────────────────────────────── 2^32-1
        ↑  ↑  ↑
        三个节点挤在一起

结果:C 到 A 之间的区间最大,A 服务器承载大部分数据解决方案:虚拟节点(Virtual Node)。
每台物理服务器对应多个虚拟节点,虚拟节点均匀分布在环上:
物理服务器 A → 虚拟节点 A-001, A-002, A-003, ..., A-100
物理服务器 B → 虚拟节点 B-001, B-002, B-003, ..., B-100
物理服务器 C → 虚拟节点 C-001, C-002, C-003, ..., C-100

环上有 300 个节点,均匀分布:
0 ─A001─B050─C023─A078─B012─C099─...(均匀散布)─ 2^32-1
虚拟节点越多,分布越均匀。通常每个物理服务器对应 100-200 个虚拟节点就足够均匀了。
虚拟节点还有一个好处:增减服务器时,数据从多台服务器迁入/迁出,压力分散。
代码实现
用 Python 实现一个带虚拟节点的一致性哈希环:
python
import hashlib

class ConsistentHash:
    def __init__(self, replicas=100):
        """
        replicas: 每个物理节点的虚拟节点数
        """
        self.replicas = replicas
        self.ring = {}        # {hash值: 物理节点名}
        self.sorted_keys = []  # 排序后的哈希值列表,用于二分查找

    def _hash(self, key):
        """计算 key 的哈希值,返回 32 位整数"""
        h = hashlib.md5(key.encode('utf-8')).hexdigest()
        # 取前 8 个十六进制字符 = 32 位
        return int(h[:8], 16)

    def add_node(self, node):
        """添加一个物理节点"""
        for i in range(self.replicas):
            # 虚拟节点的 key = 节点名#编号
            vnode_key = f"{node}#{i}"
            h = self._hash(vnode_key)
            self.ring[h] = node
        # 重新排序
        self.sorted_keys = sorted(self.ring.keys())

    def remove_node(self, node):
        """移除一个物理节点"""
        for i in range(self.replicas):
            vnode_key = f"{node}#{i}"
            h = self._hash(vnode_key)
            if h in self.ring:
                del self.ring[h]
        self.sorted_keys = sorted(self.ring.keys())

    def get_node(self, key):
        """获取 key 所属的物理节点"""
        if not self.ring:
            return None

        h = self._hash(key)

        # 二分查找:找到第一个 >= h 的位置
        left, right = 0, len(self.sorted_keys)
        while left < right:
            mid = (left + right) // 2
            if self.sorted_keys[mid] >= h:
                right = mid
            else:
                left = mid + 1

        # 如果找到了,就是这个节点
        # 如果没找到(超出末尾),绕回第一个节点
        idx = left if left < len(self.sorted_keys) else 0
        return self.ring[self.sorted_keys[idx]]
使用示例
python
# 初始化:3 台服务器,每台 100 个虚拟节点
ch = ConsistentHash(replicas=100)
ch.add_node('server-A')
ch.add_node('server-B')
ch.add_node('server-C')

# 分配 1000 个 key,看分布
from collections import Counter
distribution = Counter()
for i in range(1000):
    node = ch.get_node(f"key-{i}")
    distribution[node] += 1

print(distribution)
# Counter({'server-A': 342, 'server-B': 331, 'server-C': 327})
# 分布相当均匀

# 加一台服务器
ch.add_node('server-D')
distribution2 = Counter()
for i in range(1000):
    node = ch.get_node(f"key-{i}")
    distribution2[node] += 1

print(distribution2)
# Counter({'server-A': 258, 'server-B': 249, 'server-C': 253, 'server-D': 240})

# 计算迁移量
migrated = sum(1 for i in range(1000)
               if ch.get_node(f"key-{i}") != 'server-C')  # 简化统计
# 约 25% 的 key 迁移了,符合预期
实际应用场景
| 场景 | 产品/项目 | 说明 |
|---|---|---|
| 分布式缓存 | Memcached 客户端 | 客户端实现一致性哈希,决定 key 存哪台 |
| 分布式存储 | Redis Cluster、Cassandra | 数据分片路由 |
| 负载均衡 | Nginx consistent_hash 模块 | 按 IP 或 URL 哈希到后端服务器 |
| CDN | 内容路由 | 相同内容路由到相同边缘节点 |
| 分布式数据库 | DynamoDB、Couchbase | 数据分区 |
在线理解
理解一致性哈希的基础是理解哈希映射。可以在 盘子工具站哈希计算工具 上做这种练习------
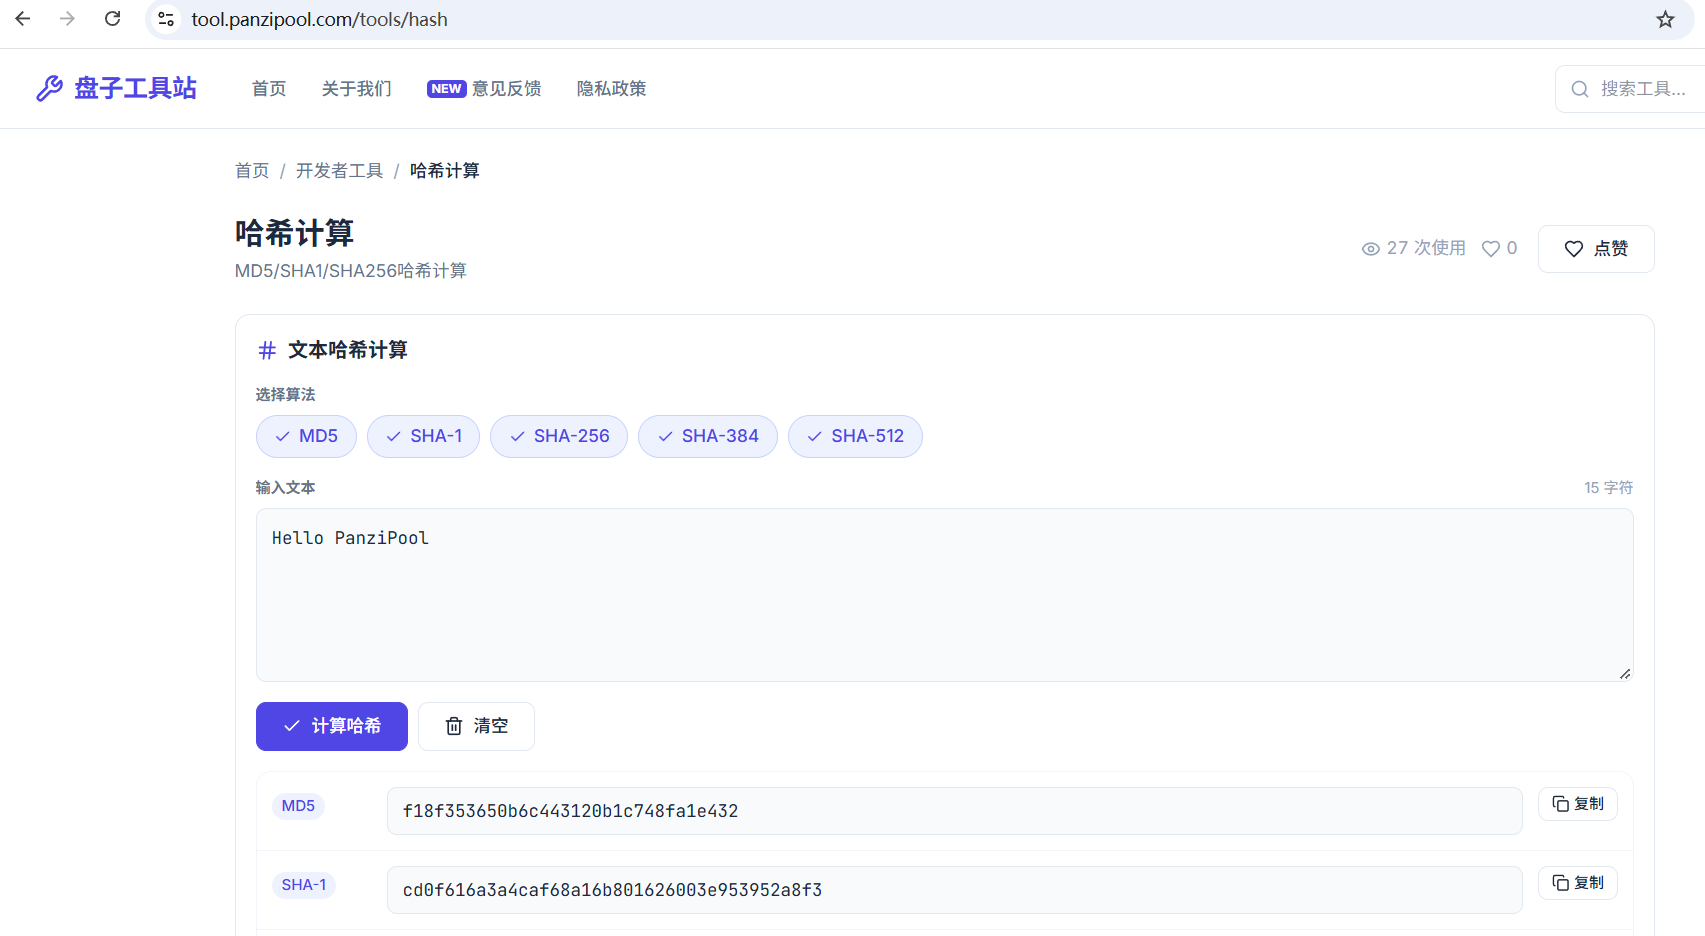
- 输入几个服务器名(
server-A、server-B、server-C),分别计算它们的 MD5 值,取前 8 位十六进制字符转换成整数------这就是它们在哈希环上的位置 - 输入几个数据 key(
user:1001、user:1002),同样算哈希取前 8 位------这是数据在环上的位置 - 手动模拟:每个数据 key 顺时针找最近的服务器,看它落在哪个节点上
- 再加一个服务器
server-D,重新分配,看有多少数据需要迁移
这个手动模拟能帮你建立对一致性哈希的直觉。工具同时输出五种算法的结果,你可以试试用不同算法计算节点位置,观察分布的均匀性差异。所有计算在浏览器本地完成,不上传服务器。