📑课程信息
- 领域:IT基础设施 / 企业技术培训
📖知识精讲
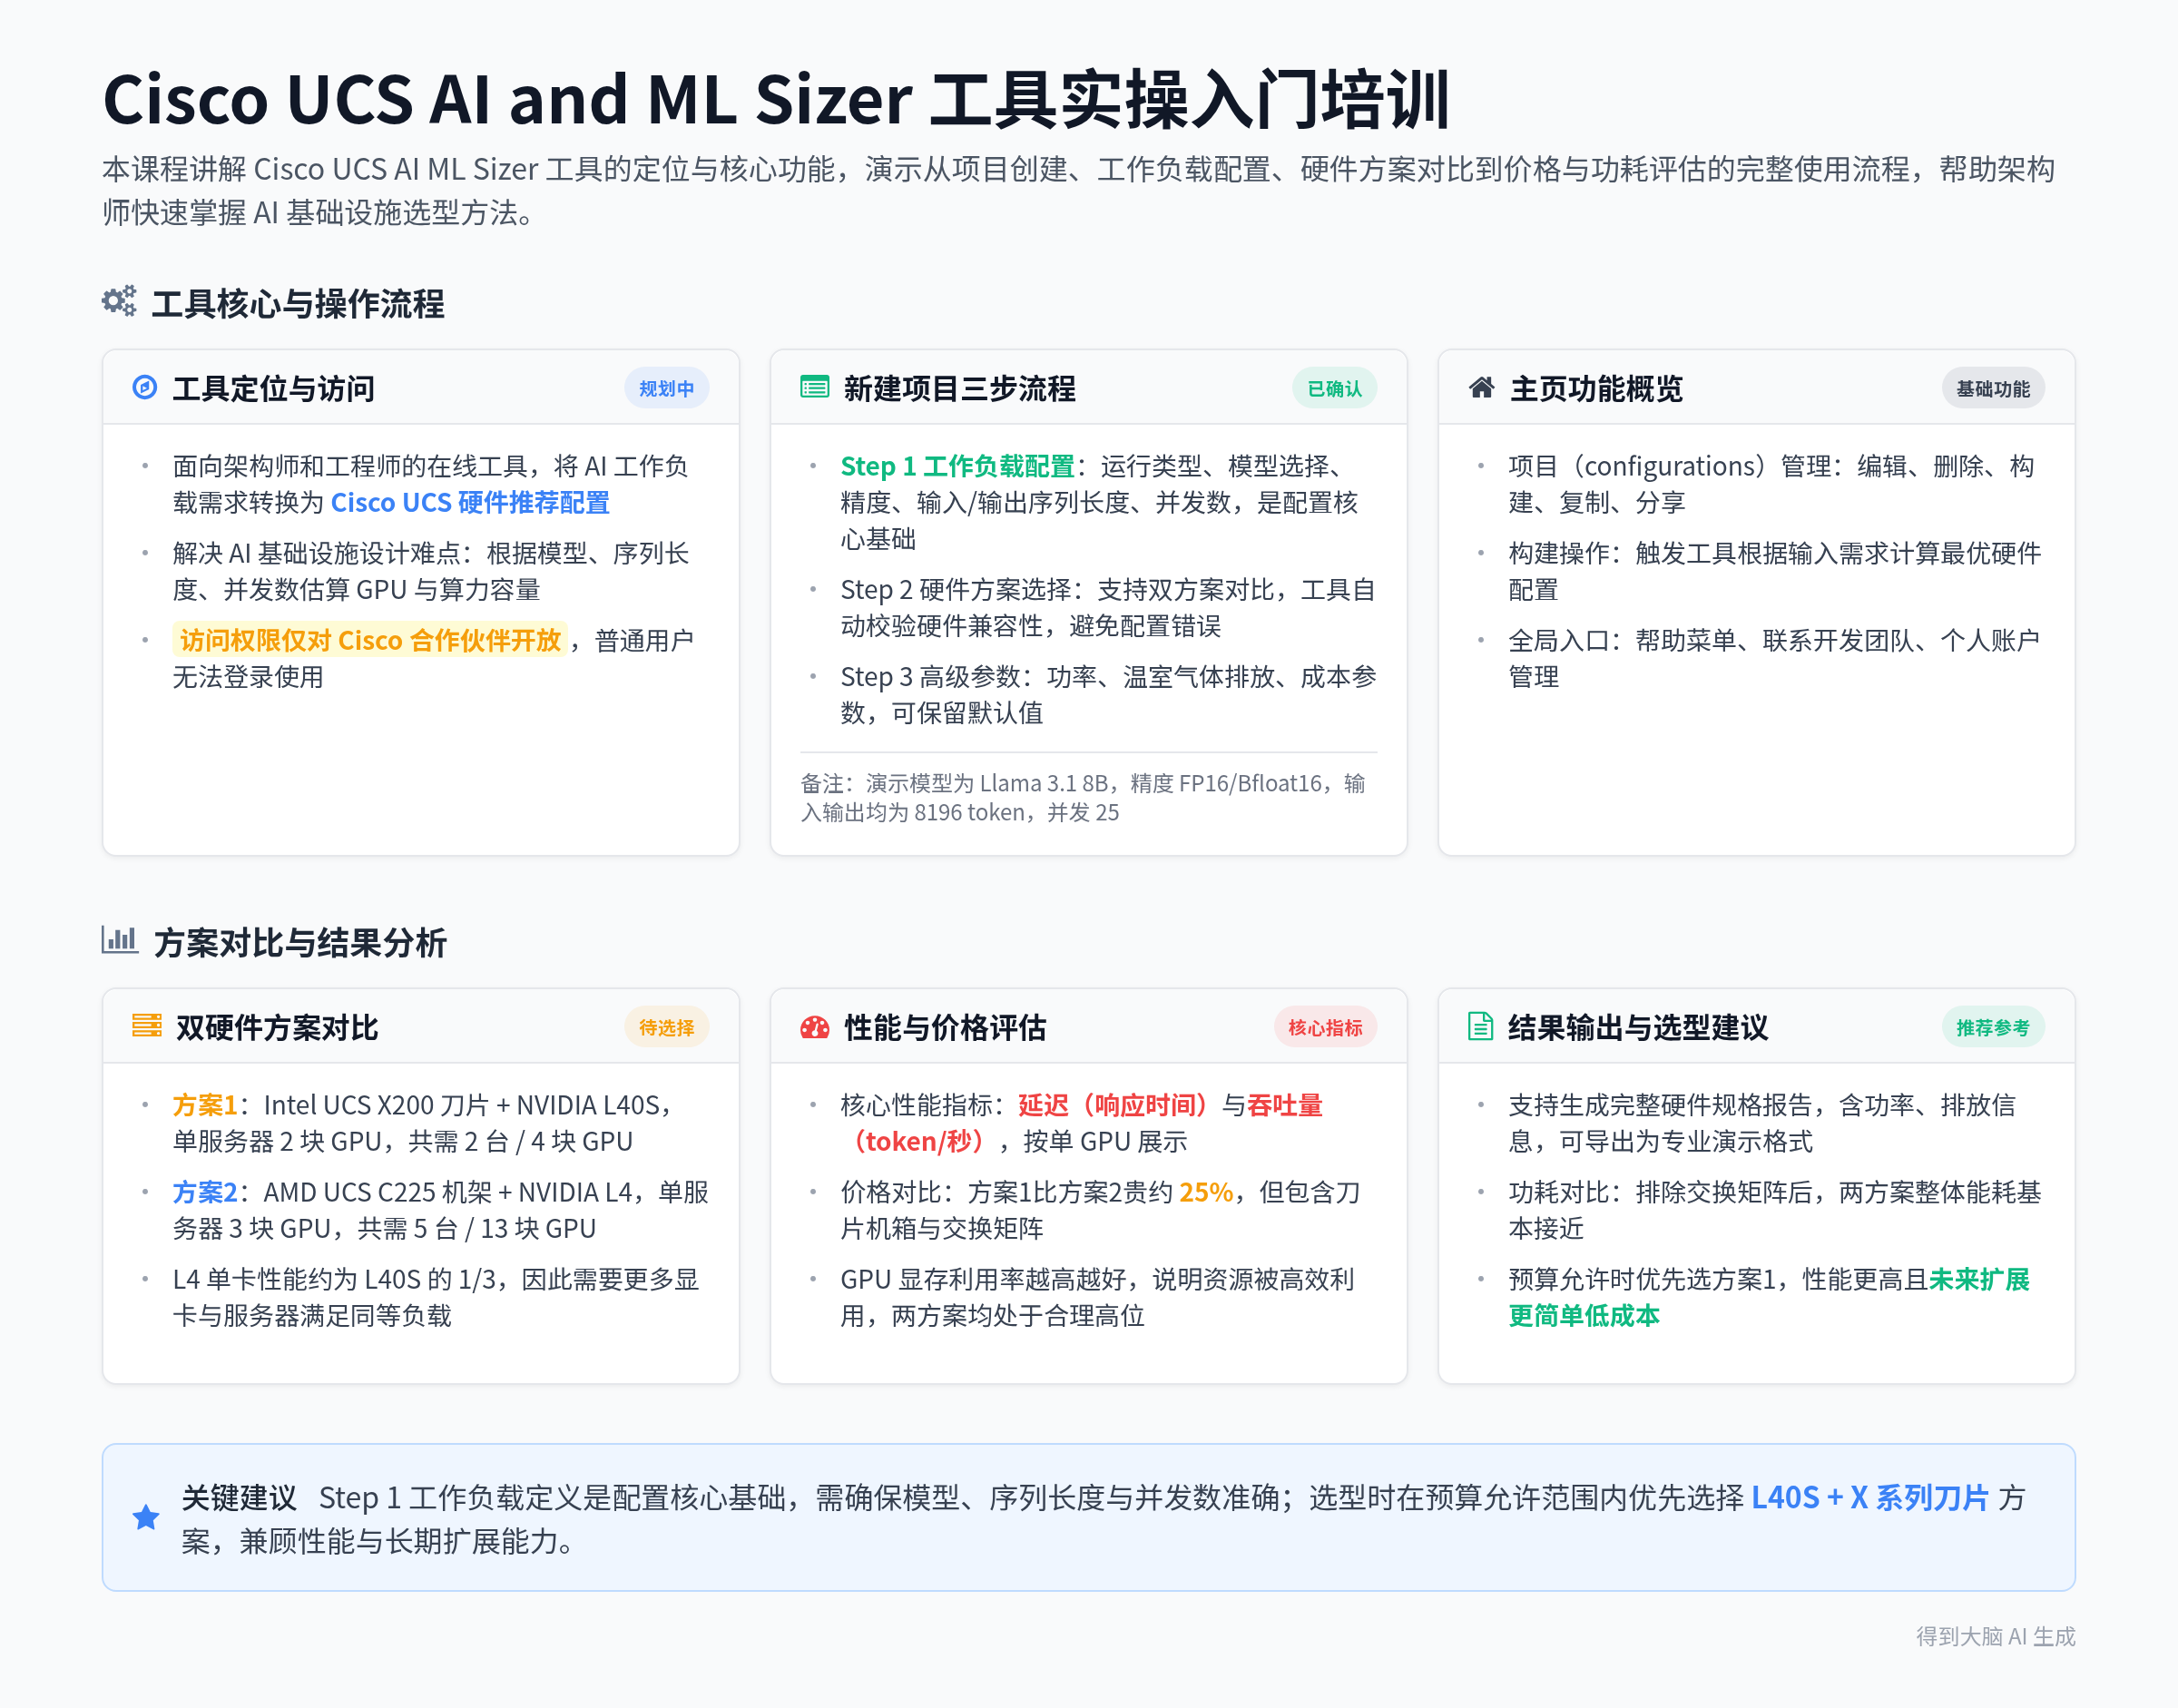
Cisco UCS AI and ML Sizer工具的实操让我们解了工具的定位与功能,演示了从项目创建到配置对比、价格估算的完整使用流程,总结了工具的应用价值。
Cisco UCS AI ML Sizer工具概述
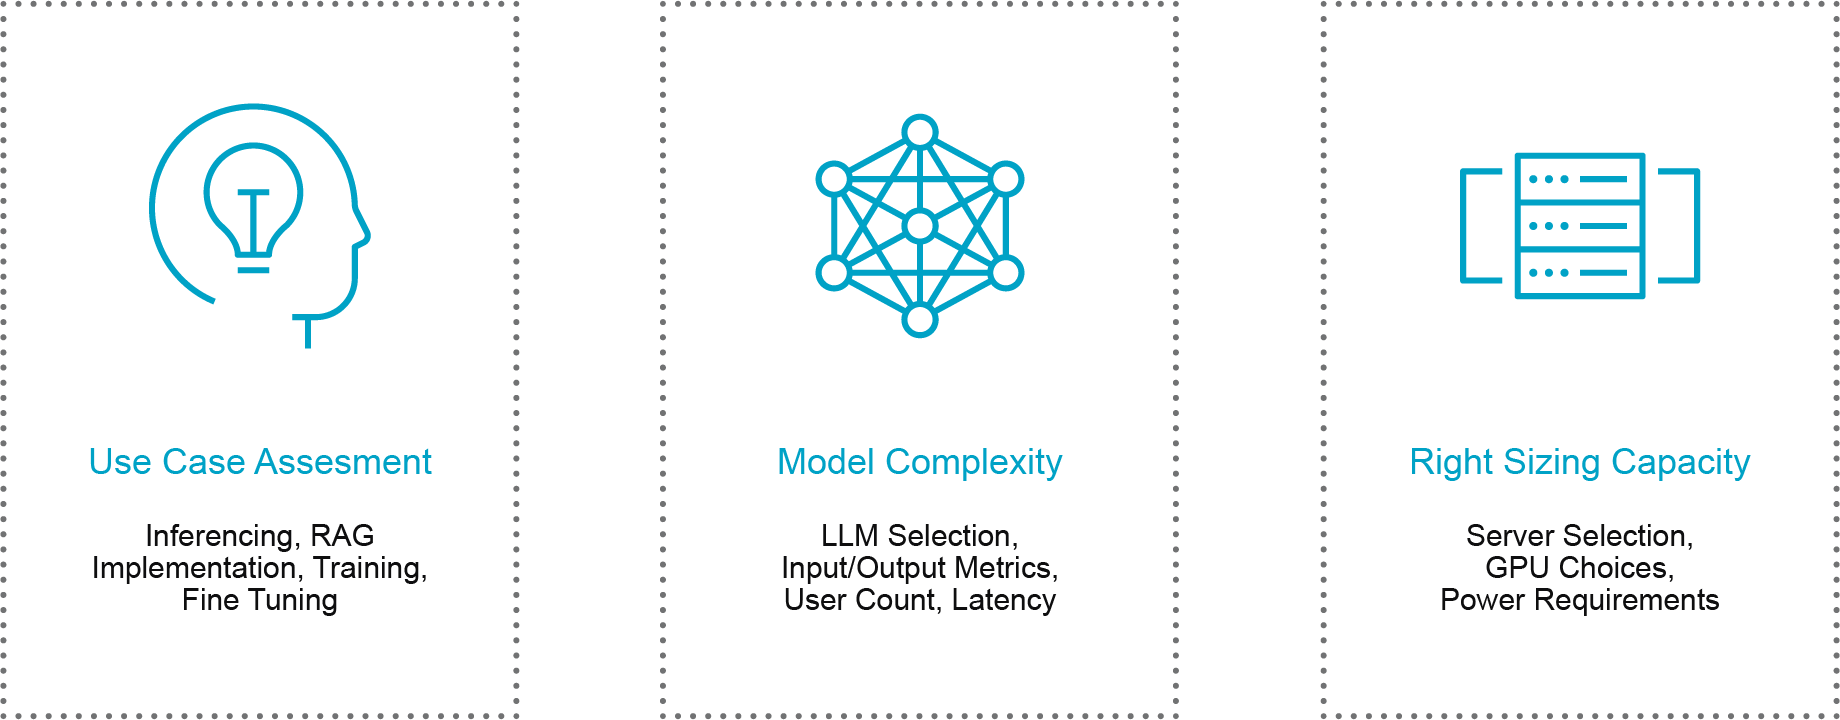
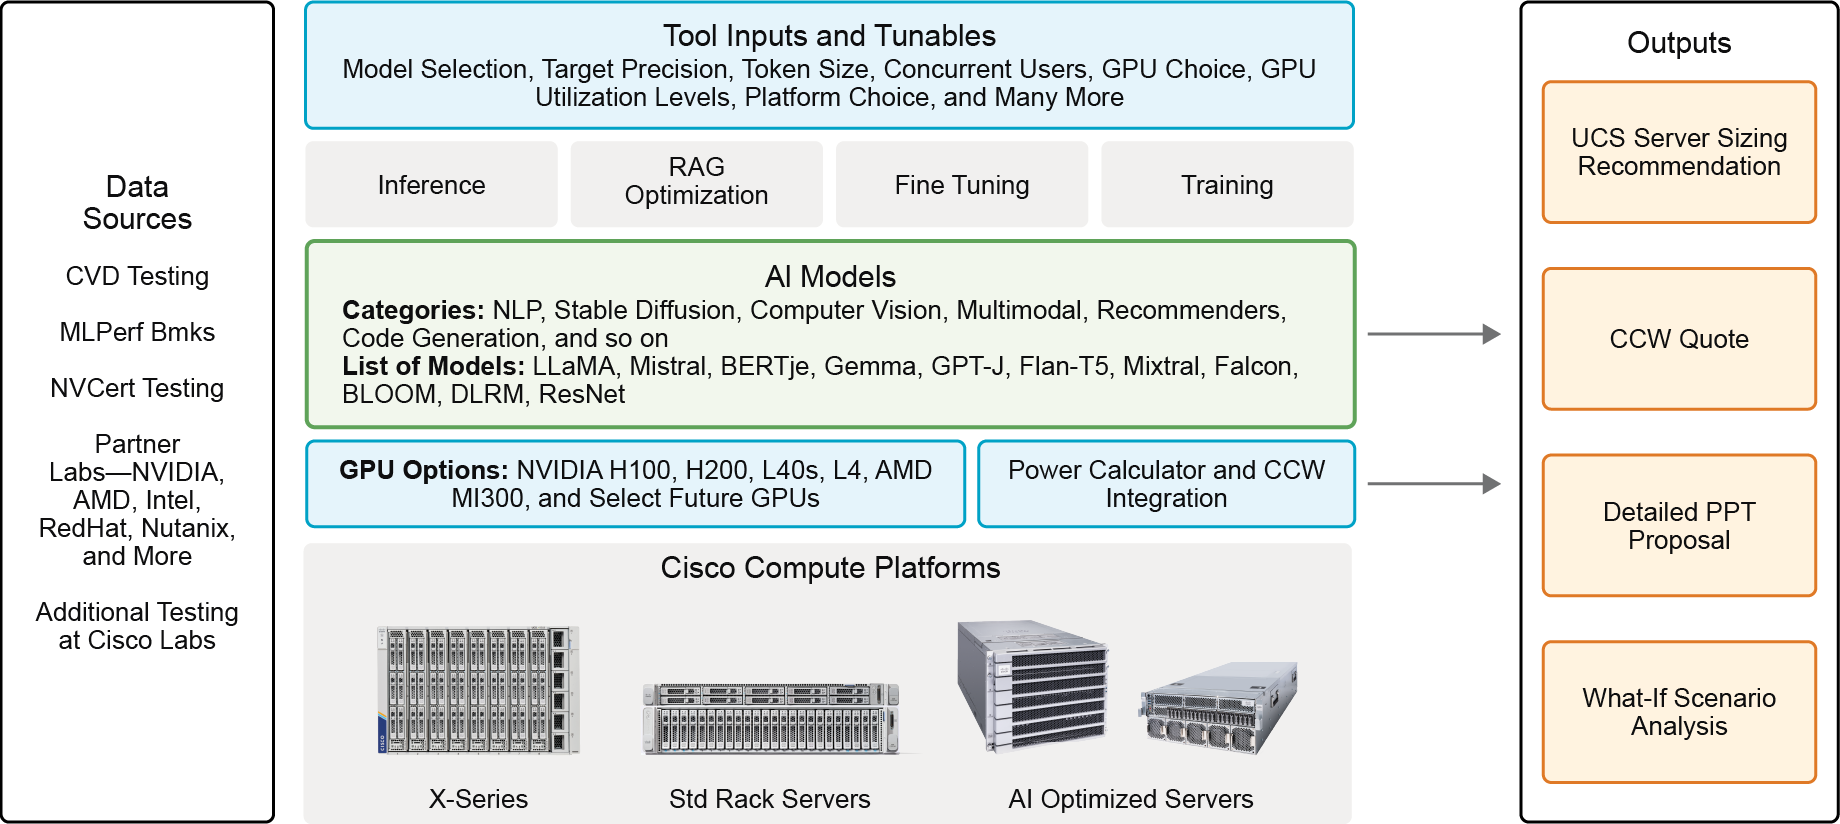
- 工具定位与核心作用:AI基础设施设计中最困难的任务是根据AI工作负载(如大语言模型、输入输出序列长度、并发用户数)估算所需GPU与算力容量。本工具是面向架构师和工程师的在线工具,可基于Cisco UCS平台,将工作负载要求(训练/推理、数据集规模、GPU/CPU需求)转换为推荐硬件配置,保证AI项目的算力、内存、存储、网络的平衡匹配,连接业务需求与合适的硬件方案。
- 访问权限说明:🚩重点:工具访问权限仅对Cisco合作伙伴开放,不支持普通用户登录使用。
工具主页功能说明
-
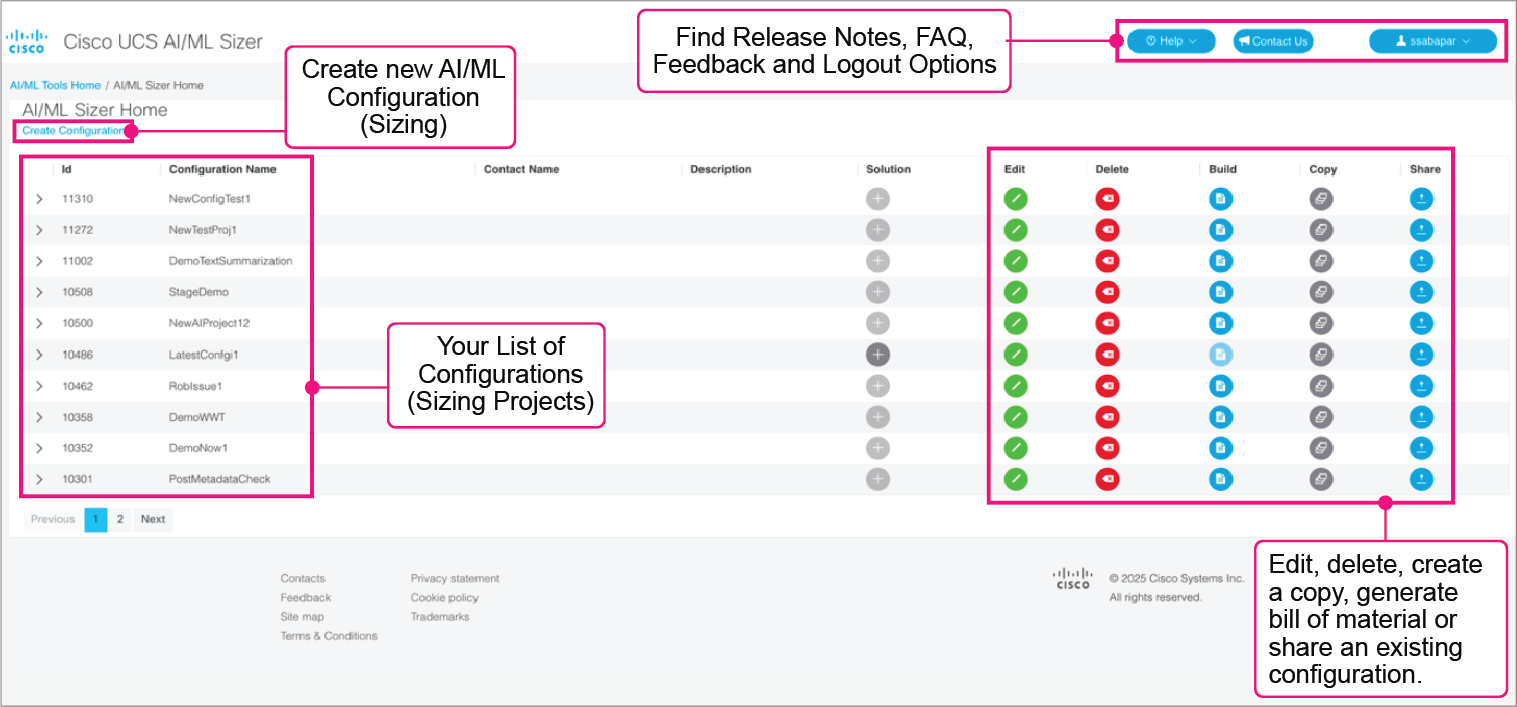
现有项目管理 :主页可查看所有已有项目(工具中称为
configurations),支持对项目进行以下操作:-
编辑、删除:操作逻辑直观无需额外说明
-
构建:触发工具根据输入需求计算最优硬件配置
-
复制:复制现有项目生成新项目
-
分享:将项目分享给其他Cisco工作人员
-
- 全局功能入口:主页还支持访问帮助菜单、通过「联系我们」按钮给工具开发团队发消息、通过右上角按钮管理个人账户。
新建项目操作流程
-
基础信息填写 :点击「Create Configuration」链接新建项目,在弹出窗口填写必要信息:配置名称、客户联系人电话、客户单位名称、项目描述,填写完成后点击下一步即可进入项目主配置页。
-
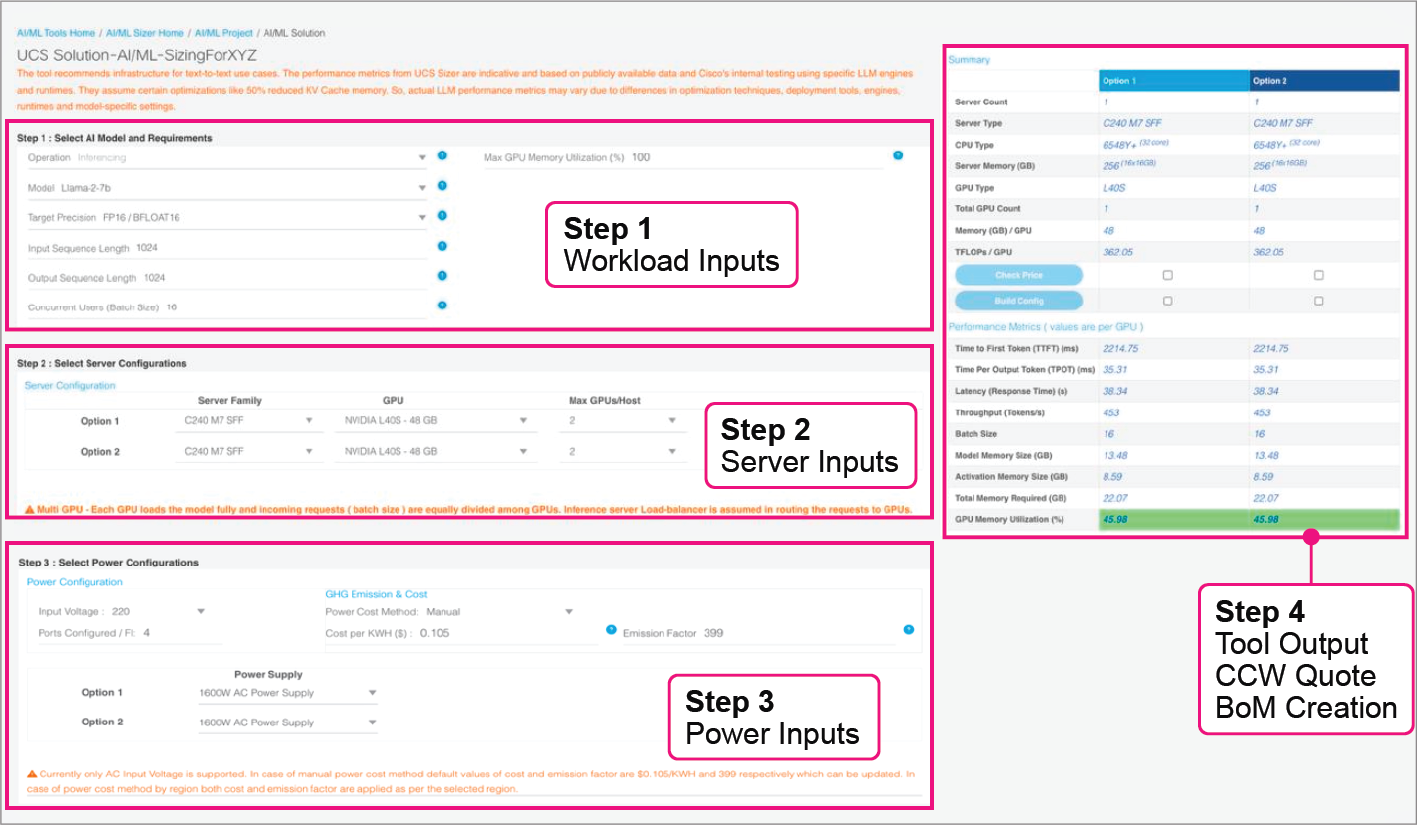
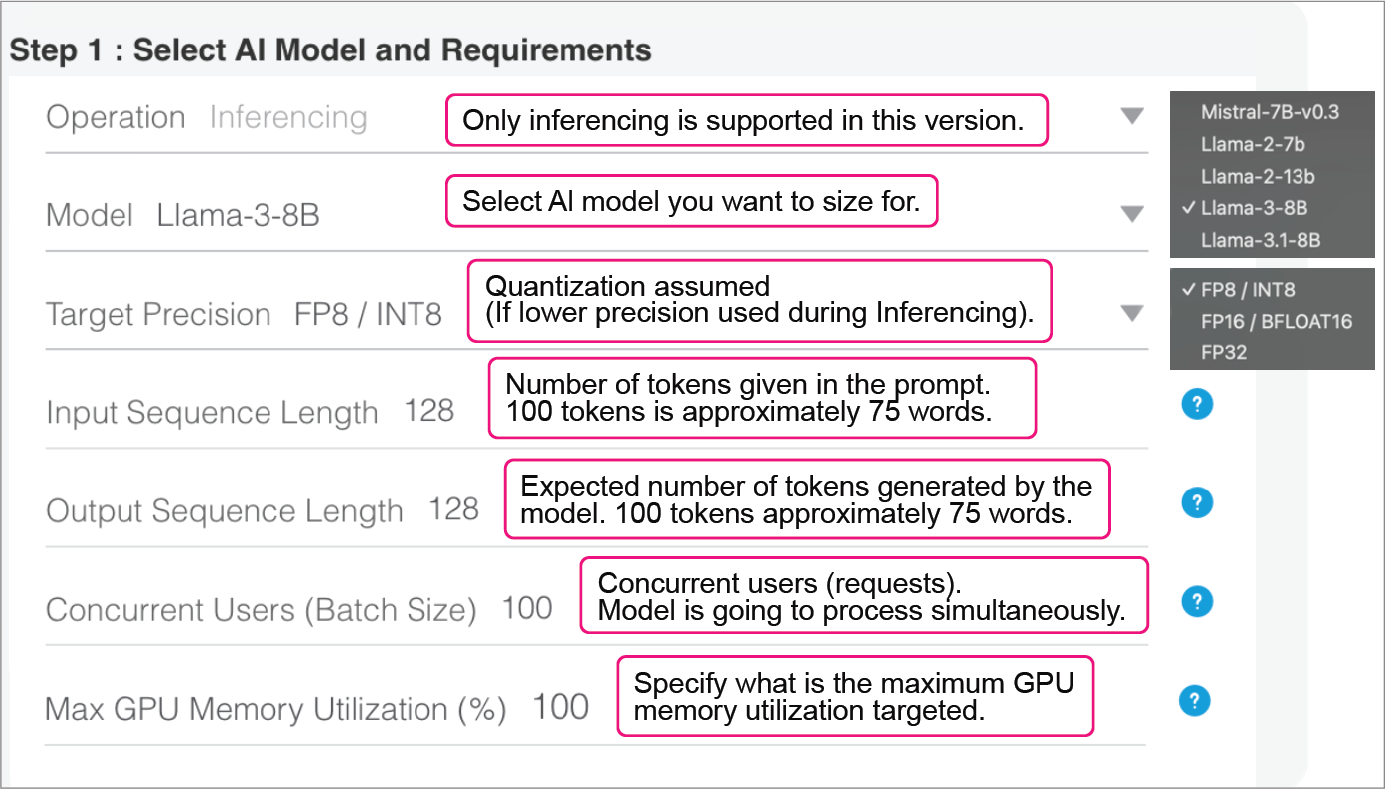
Step 1:配置AI工作负载需求:🚩重点------此步骤为整个配置流程的核心基础,决定最终硬件方案的匹配结果,需要填写的参数如下:
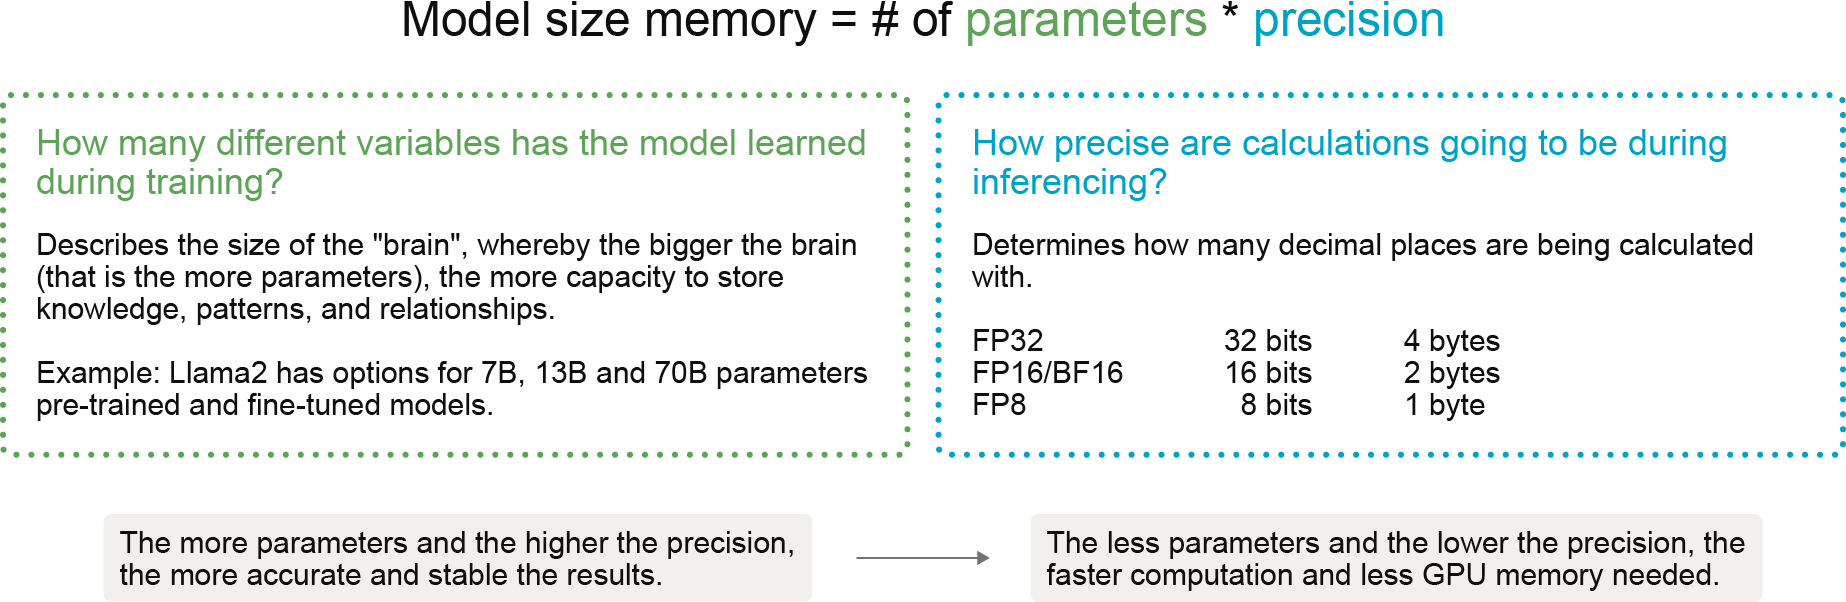
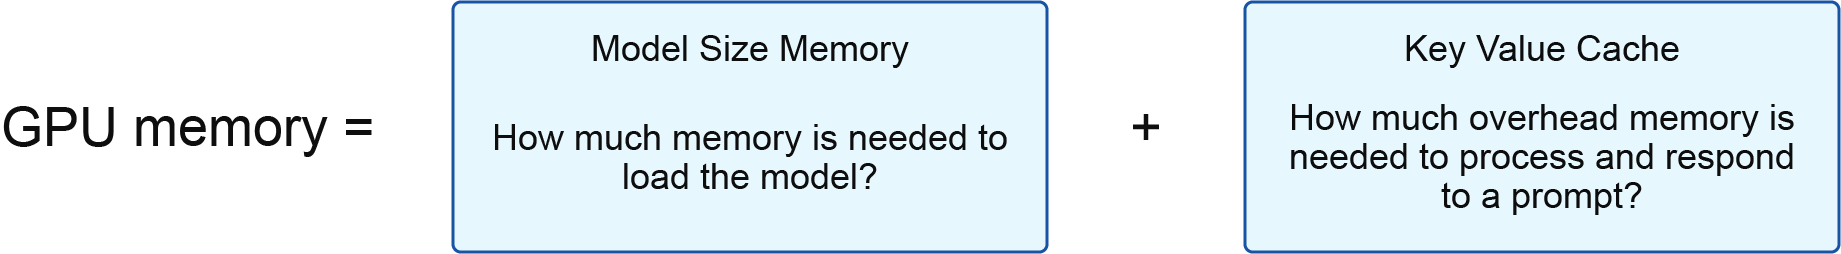
参数项 说明与本次演示配置 运行类型 目前仅支持推理(inferencing),暂不支持训练 模型选择 从支持列表中选择模型,本演示选择Llama 3.1 8B:属于中等规模大语言模型,模型越大能力越强,GPU消耗也越高 目标精度 精度越高准确率越高,但占用更多GPU显存,精度选择取决于业务场景;本次演示选择FP16/Bfloat16,适配需求 输入序列长度 即用户提示词的长度,以token为单位,通用换算规则:100 token≈75单词;本演示配置为8196 token,约合6000单词 输出序列长度 即模型生成内容的长度,同样以token为单位,本演示需要生成长代码,因此也配置为8196 token 并发用户/批次大小 模型需要同时处理的最大并发请求数,本演示配置为25 -
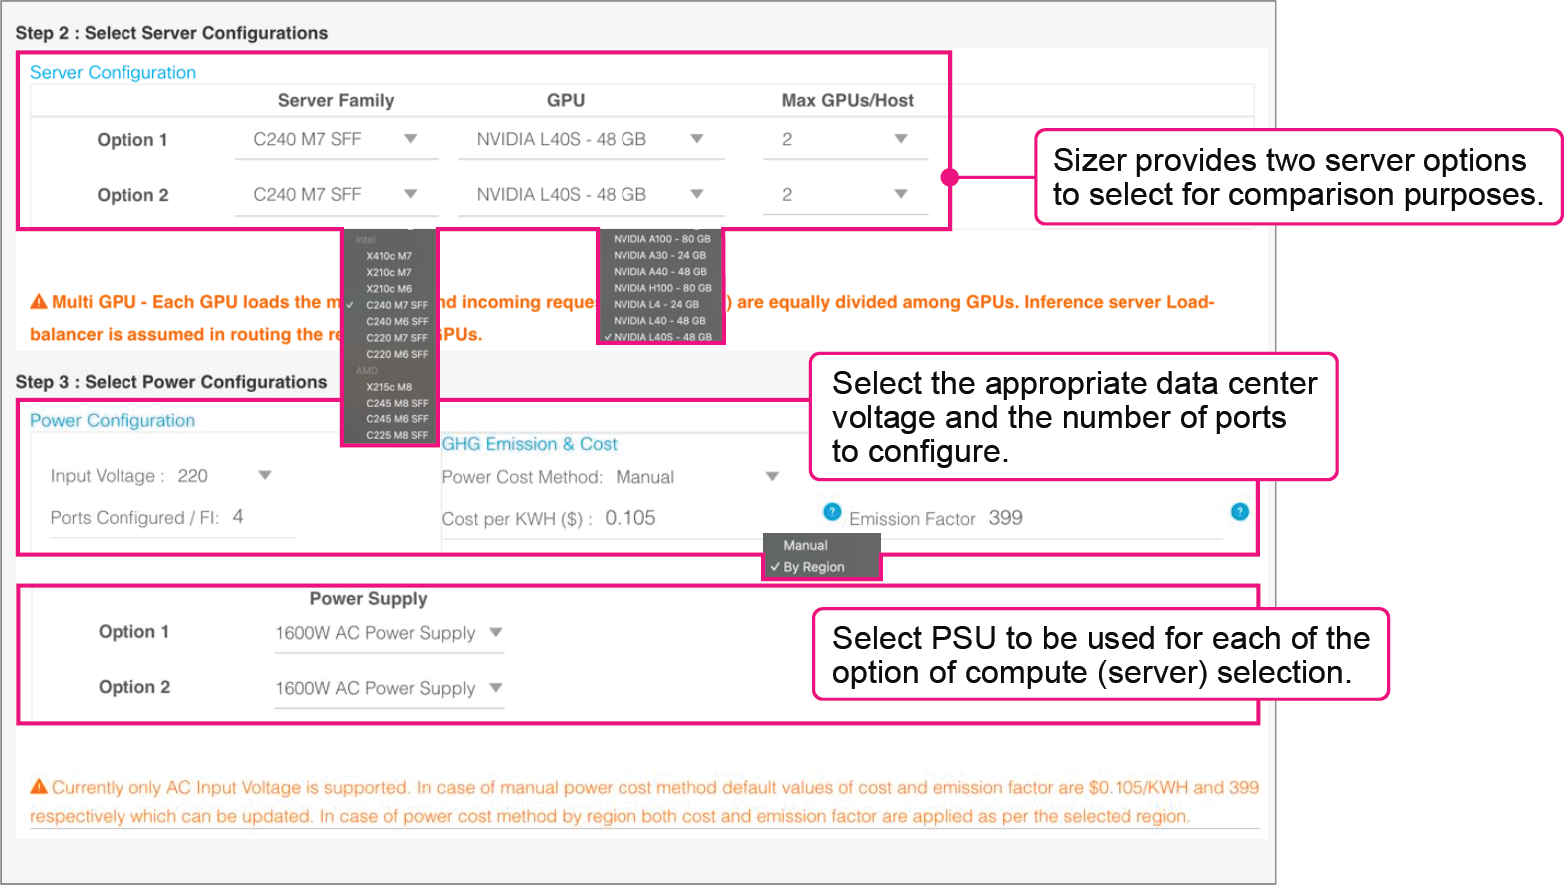
Step 2:选择偏好硬件配置:工具提供两个配置方案,支持不同硬件的能力与性价比对比:
-
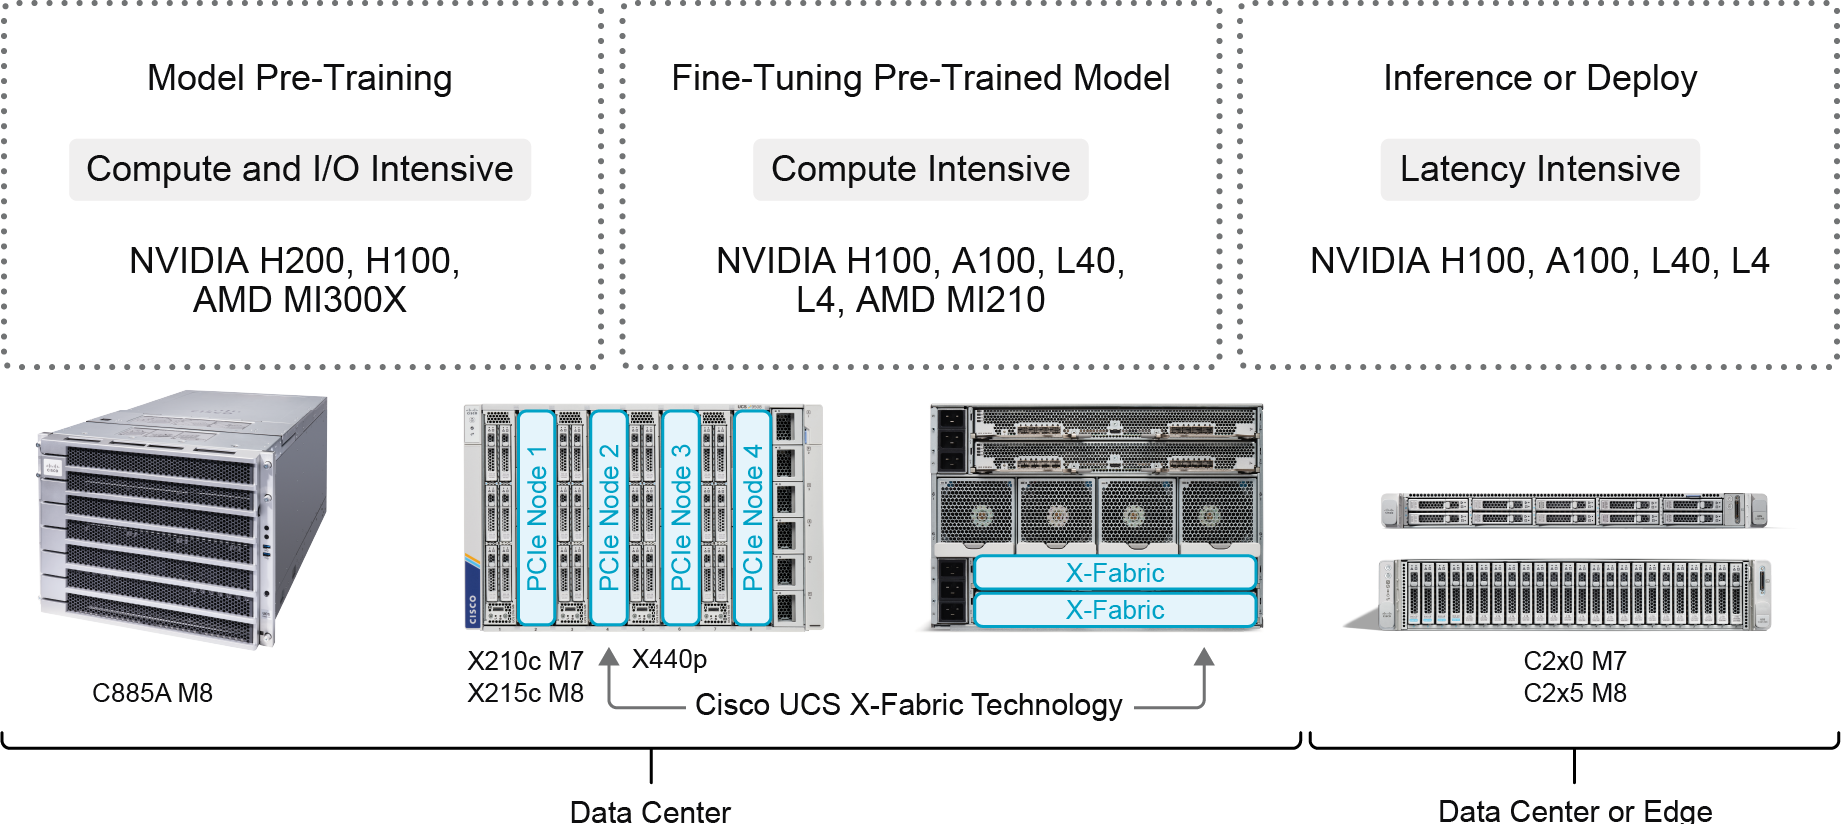
方案1:Intel架构UCS X200 10c M8刀片服务器,搭配NVIDIA L40S GPU,每服务器最大配置2块GPU;
-
方案2:AMD架构UCS C225 M8机架服务器,搭配NVIDIA L4 GPU,每服务器最大配置3块GPU;
🚩重点:工具会自动校验硬件兼容性,无法选择不支持的硬件组合,避免配置错误。
-
-
Step 3:自定义高级参数:可自定义功率配置、温室气体排放、成本参数,本次演示保留默认值即可。
配置结果分析与输出
-
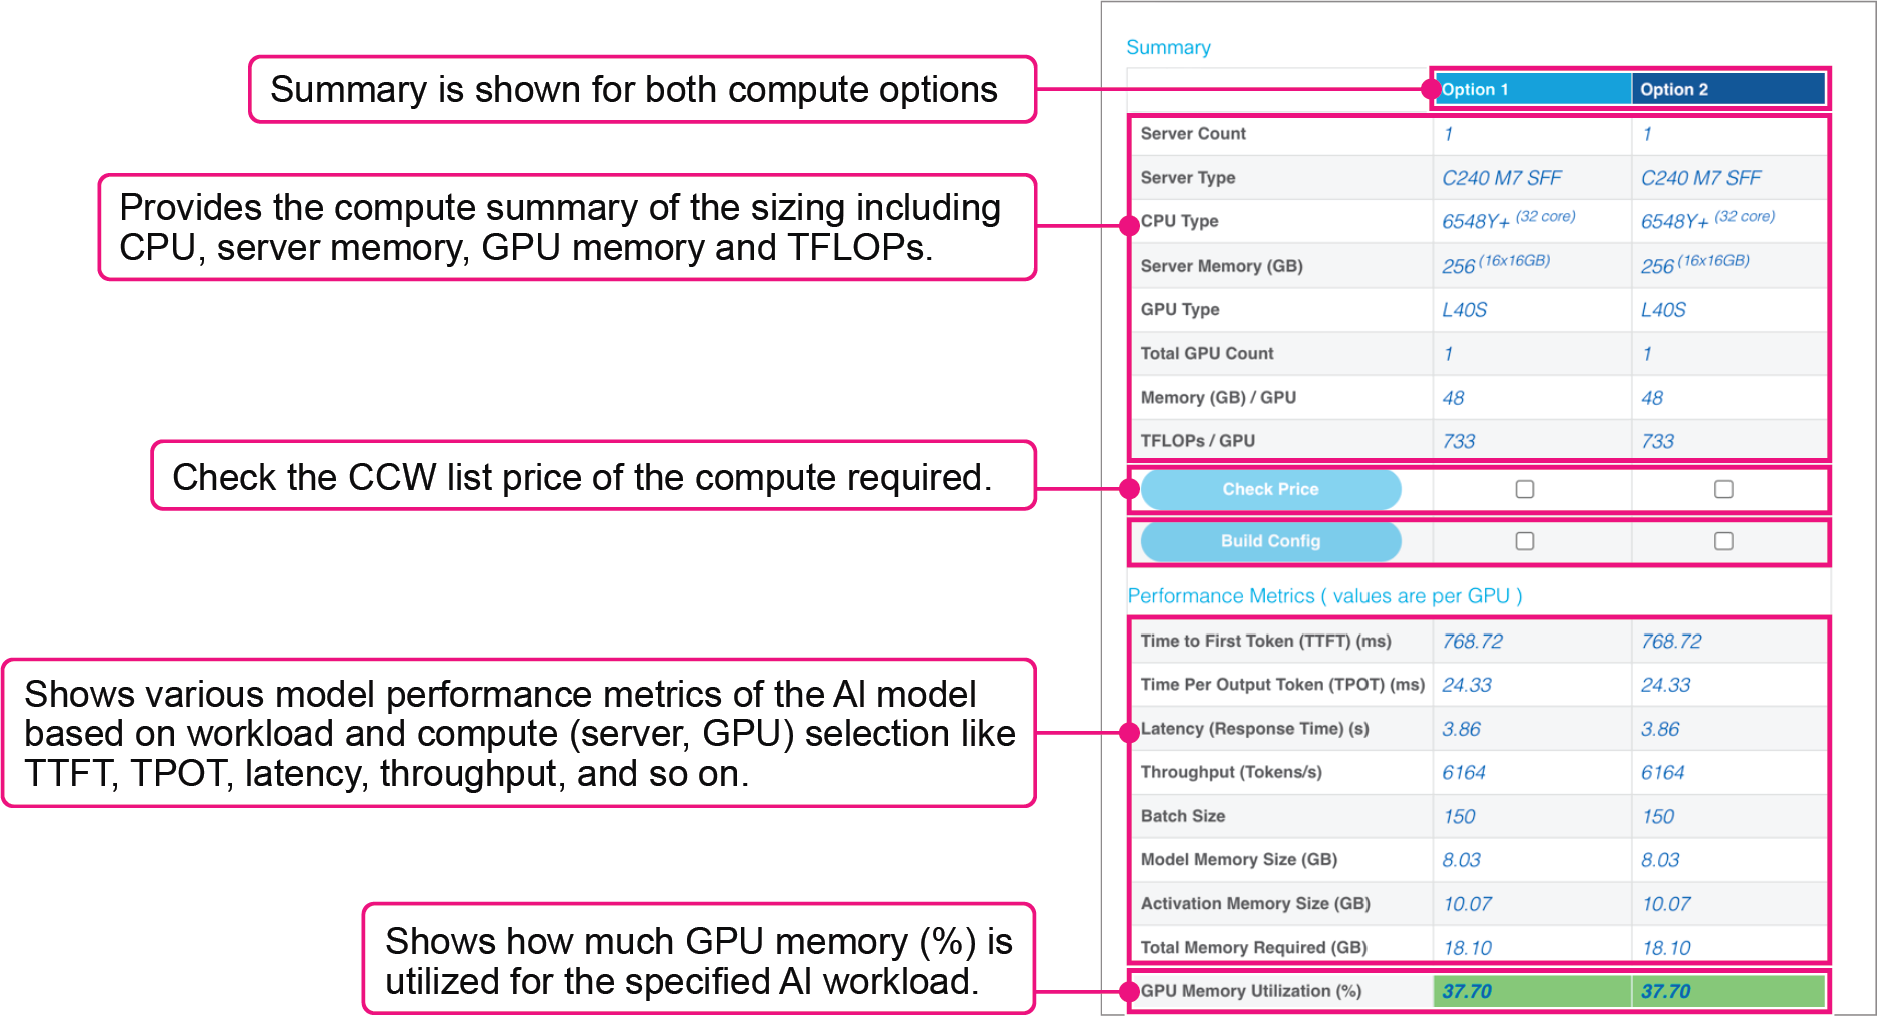
自动计算结果展示:完成配置后工具会自动在页面右侧计算并展示结果:
-
上方区域:服务器配置与能力汇总,展示算力、GPU等信息;本次演示的结果为:方案1需要2台UCS X系列服务器,共4块GPU;方案2需要5台UCS C系列服务器,共13块GPU------符合GPU性能差异:L4性能弱于L40S,因此需要更多显卡与服务器;
-
下方区域:性能指标(指标按单GPU展示),核心指标为延迟(响应时间)和吞吐量(token/秒),本次演示中方案2性能明显低于方案1,符合L4单卡性能仅为L40S的1/3的特性。
-
-
🚩重点:GPU利用率越高越好,说明GPU资源被高效利用,本案例两个方案的GPU显存利用率都处于高位,属于合理配置。
-
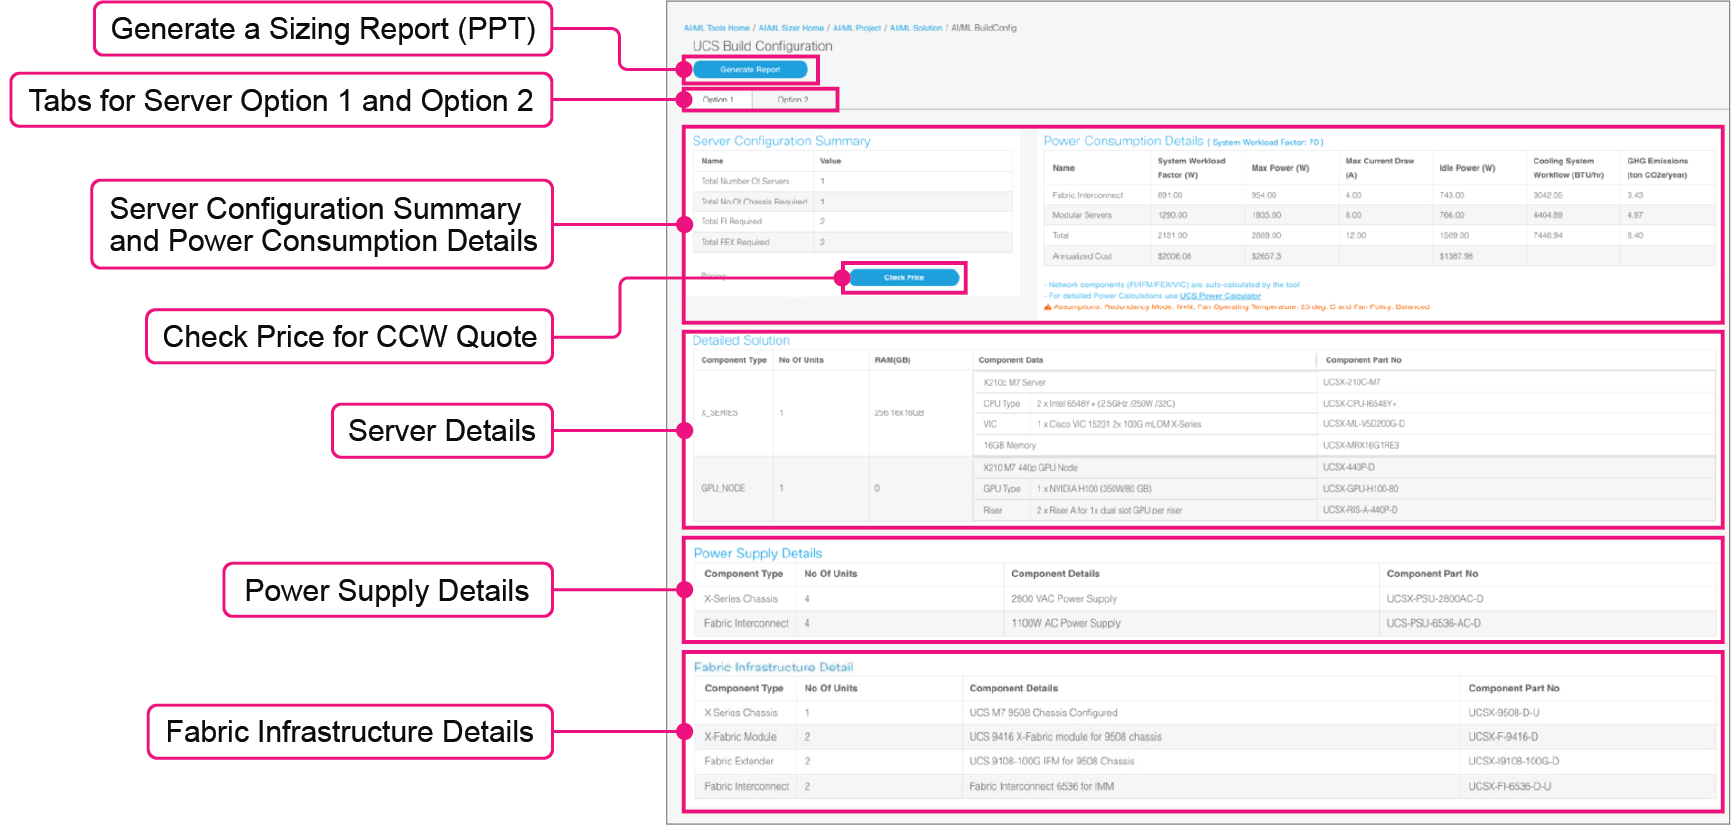
生成详细报告:勾选两个方案后点击「Build Config」按钮,再点击「Generate Report」即可生成完整的硬件规格文档(含功率要求、排放信息),可输出为专业演示格式的报告。
-
价格与扩展能力对比:回到AI ML方案主页,勾选两个方案后点击「Check Price」即可获取价格,本次演示结果为:方案1比方案2贵约25%,但方案1包含X系列刀片机箱与交换矩阵,未来扩展更简单低成本,因此如果预算允许,方案1是更优选择。
-
功耗对比:排除方案1额外的交换矩阵功耗后,两个方案的整体功耗基本接近。
🖍️ 重点速览
🚩 考点重点
-
工具访问权限:仅对Cisco合作伙伴开放,不支持普通用户使用;
-
核心配置步骤:Step1工作负载需求定义是整个流程的基础,直接影响最终硬件匹配结果;
-
工具特性:自动校验硬件兼容性,避免不支持的配置错误;
-
核心性能指标:评估方案的核心指标是延迟(响应时间)和吞吐量(token每秒);
-
GPU利用率判定:GPU利用率越高越好,说明资源被高效利用。
💡 核心概念
-
Cisco UCS AI ML Sizer:面向架构师的在线AI基础设施规划工具,可将AI工作负载需求转换为匹配的Cisco UCS硬件推荐配置。
-
Token换算规则:100 tokens ≈ 75 单词,用于估算输入输出序列长度对应的文本量。
✨ 课堂金句
-
更大的模型能力更强,但也会消耗更多GPU资源。
-
GPU内存利用率高,是好事,因为你希望高效使用GPU。
-
工具帮你在性能、可扩展性和成本效率之间找到平衡。
📝运维实操演示
🎯 课程总结
🔍 AI/ML基础概念与分类
-
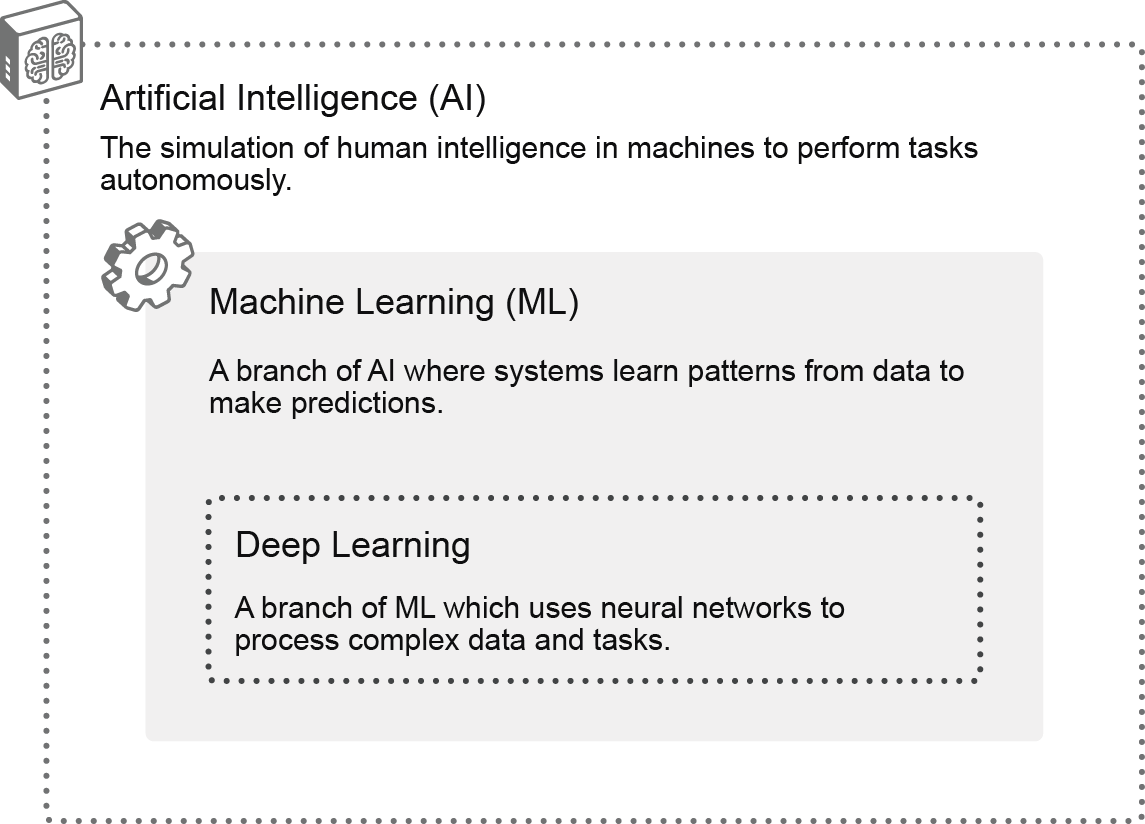
人工智能(AI) :模拟人类认知功能(视觉感知、语音识别等)的机器智能,核心特征是从数据中学习并随时间优化性能,区别于传统基于固定规则的软件系统。
-
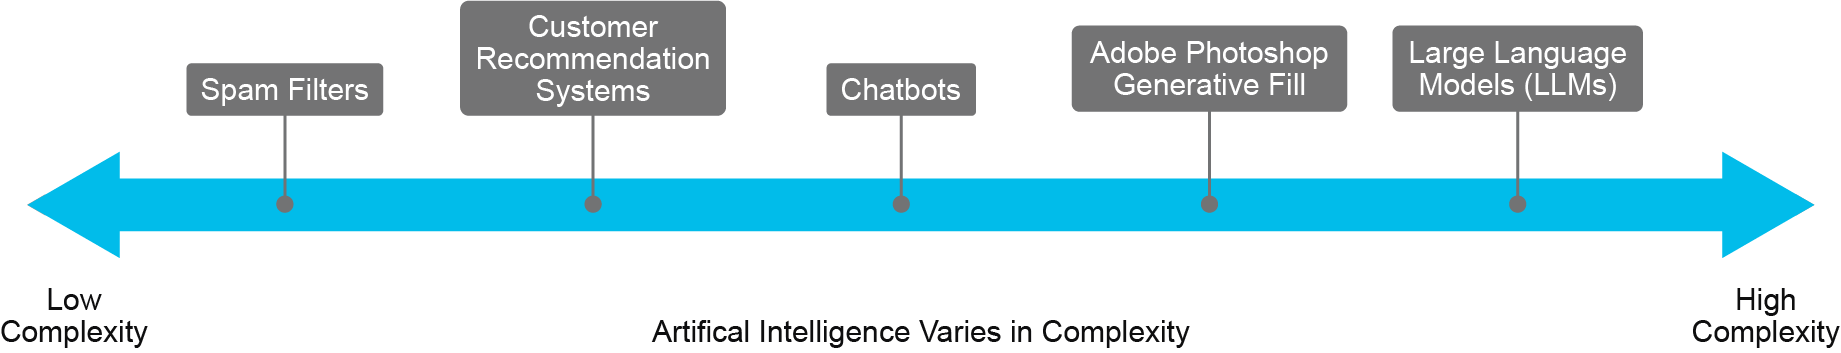
复杂度谱系:从低到高依次为垃圾邮件过滤器→客户推荐系统→聊天机器人→Adobe Photoshop生成填充→大型语言模型(LLMs)。
-
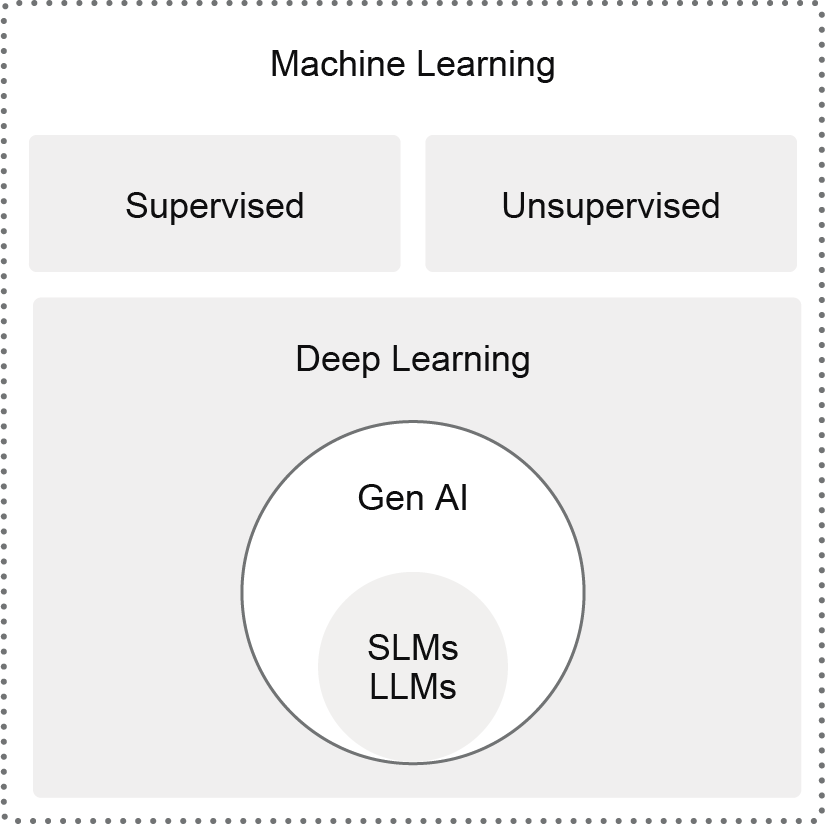
核心分支关系:
graph TD
  AI[人工智能] --> ML[机器学习]
  ML --> DL[深度学习]
  DL --> GenAI[生成式AI]
  GenAI --> SLMs[小型语言模型]
  GenAI --> LLMs[大型语言模型]
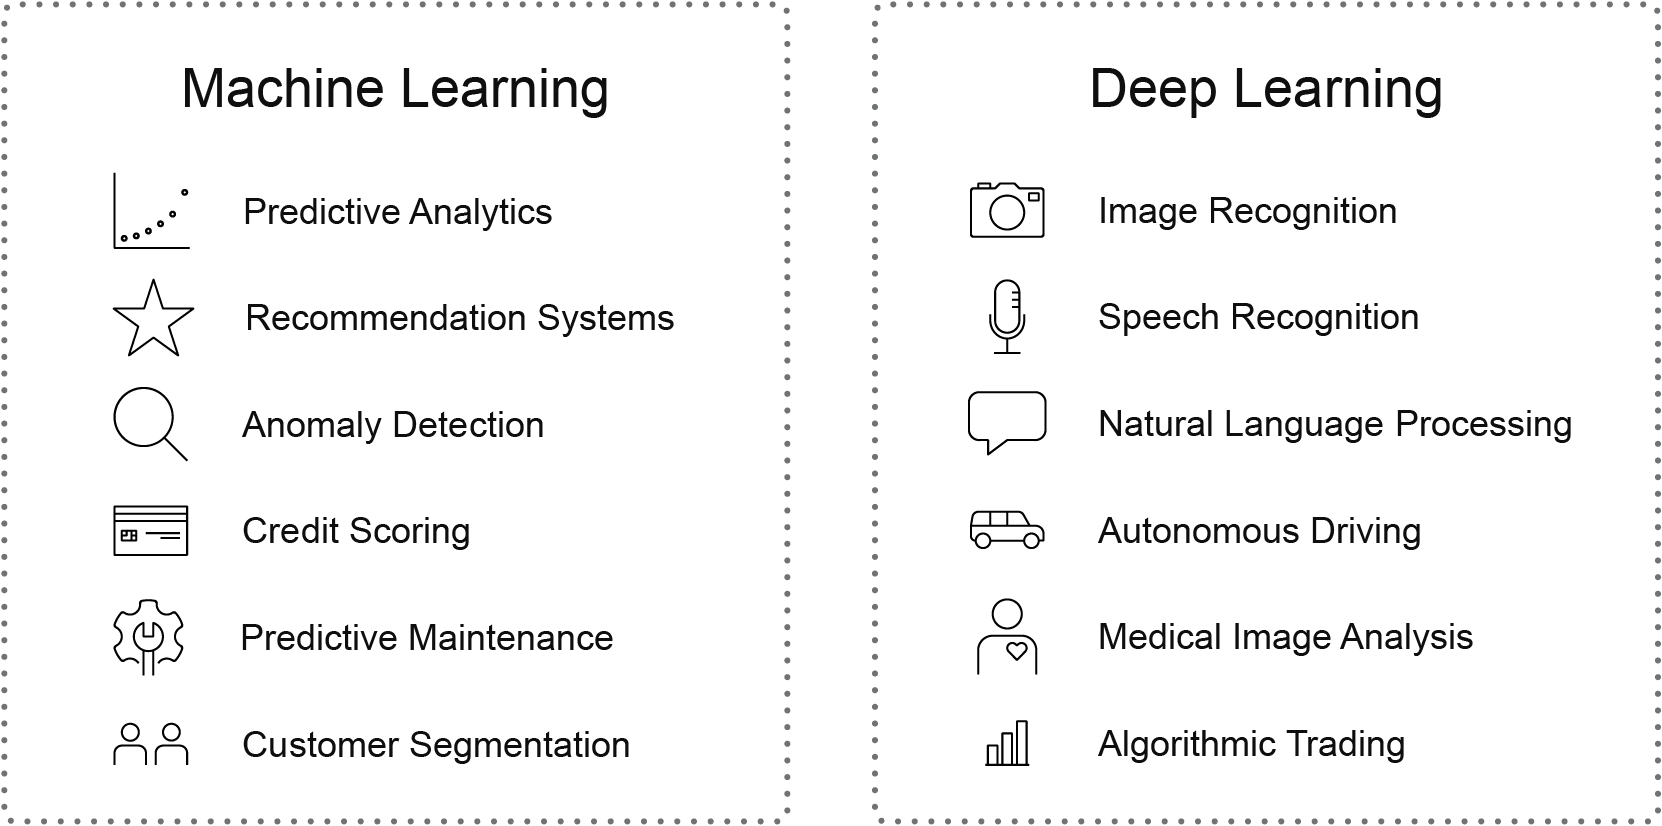
📊 机器学习(ML)vs 深度学习(DL)
| 维度 | 机器学习 | 深度学习 |
|---|---|---|
| 技术核心 | 统计方法+人工特征工程 | 多层神经网络自动特征提取 |
| 数据依赖 | 适用于小数据集 | 需海量标注数据 |
| 计算需求 | 可在CPU运行 | 依赖GPU/TPU并行计算 |
| 代表应用 | 预测分析、异常检测、信用评分 | 图像识别、语音识别、自然语言处理、自动驾驶 |
| 典型案例 | 垃圾邮件过滤器(基于已知模式分类) | 图像中识别猫(自动发现特征如耳朵、胡须) |
✨ 生成式AI与语言模型
-
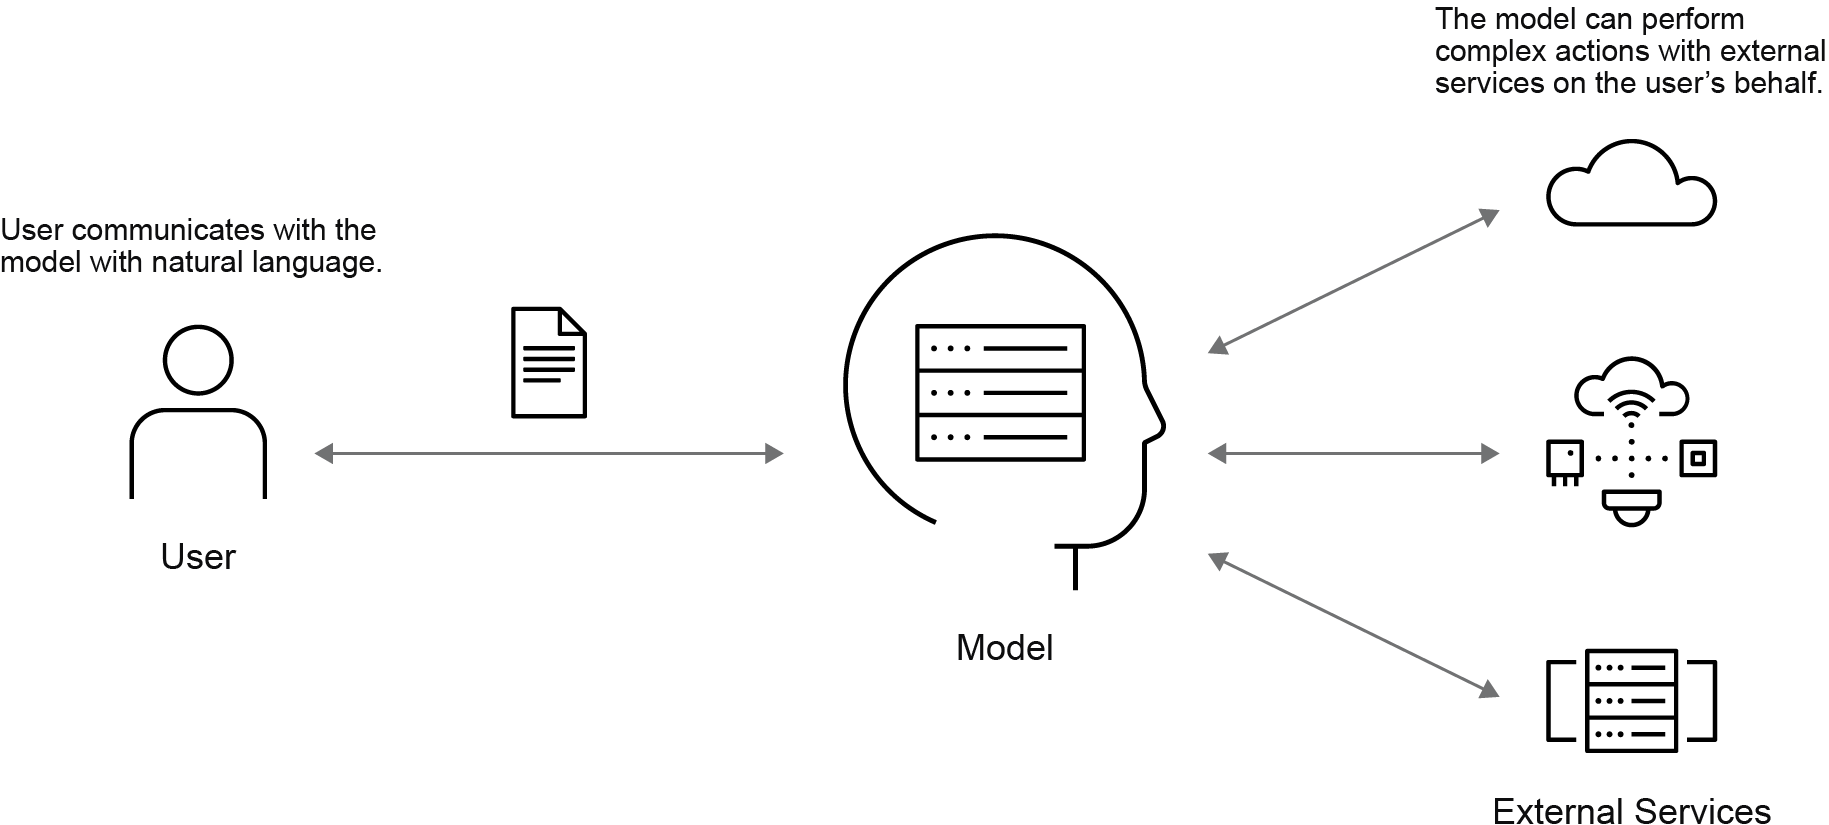
生成式AI(GenAI):通过学习数据模式生成新内容(文本、图像、音乐等),核心技术为神经网络与机器学习,例如ChatGPT(文本生成)、Photoshop生成填充(图像编辑)。
-
语言模型分类:
-
小型语言模型(SLMs):参数少(数百万级)、轻量高效,适用于特定任务(如客服聊天机器人),通过知识蒸馏、剪枝等技术从LLM压缩而来;
-
大型语言模型(LLMs):参数数十亿级(如GPT-3.5有1750亿参数),需海量数据训练,支持复杂任务(内容生成、翻译、多步推理),依赖高算力环境。
-
⚙️ AI/ML工作负载与资源需求
-
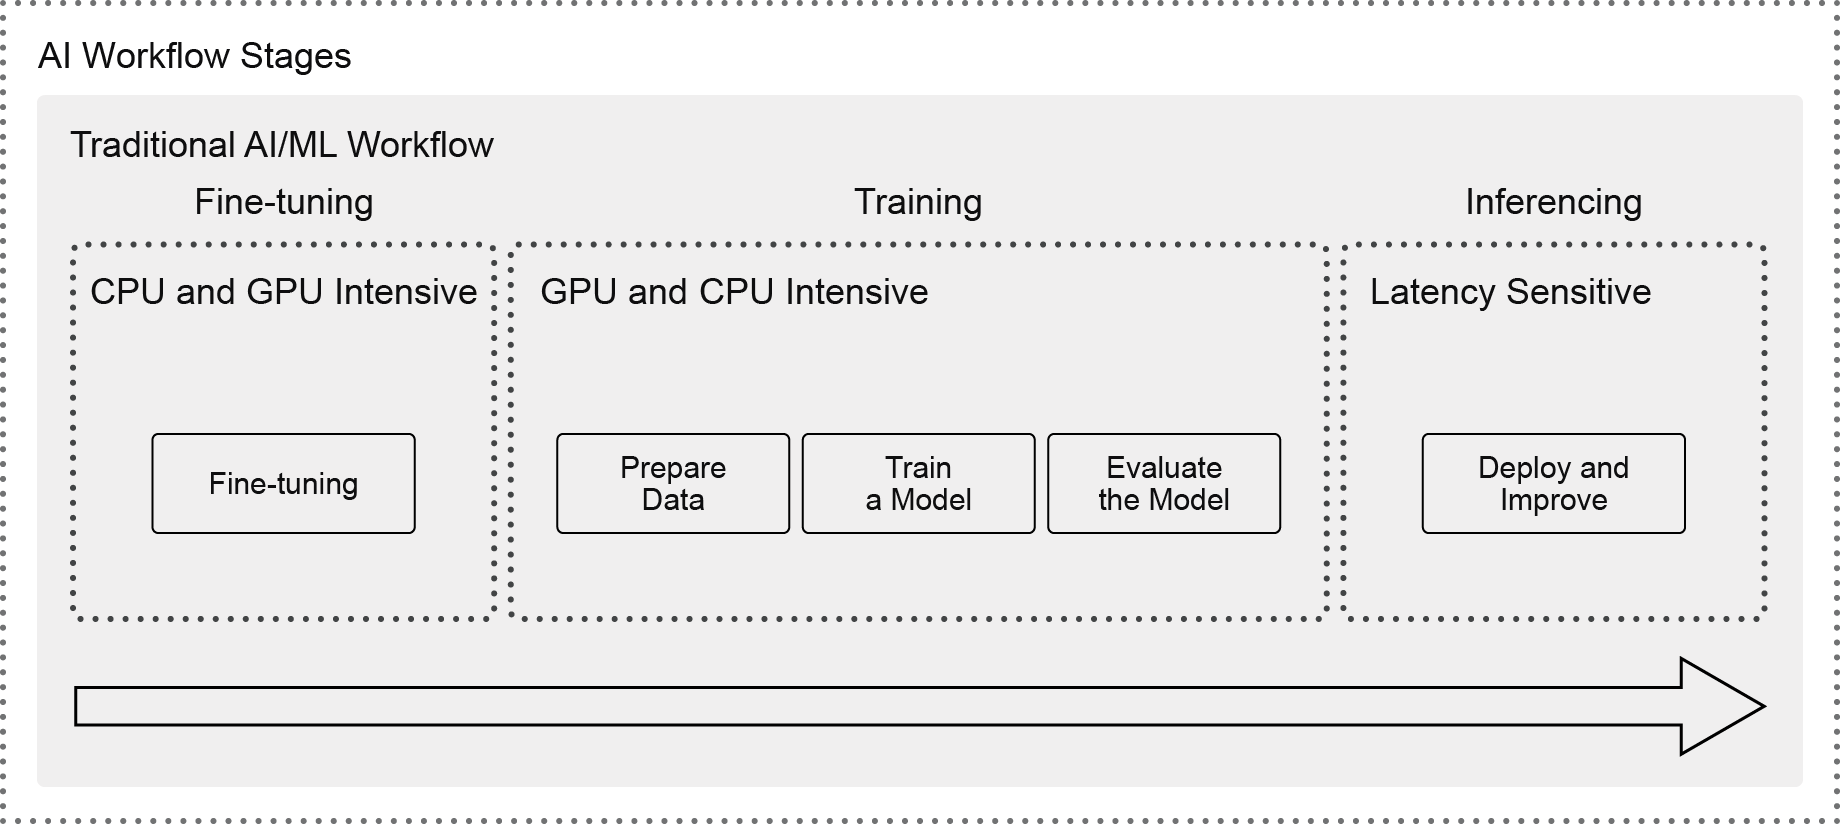
生命周期阶段:
-
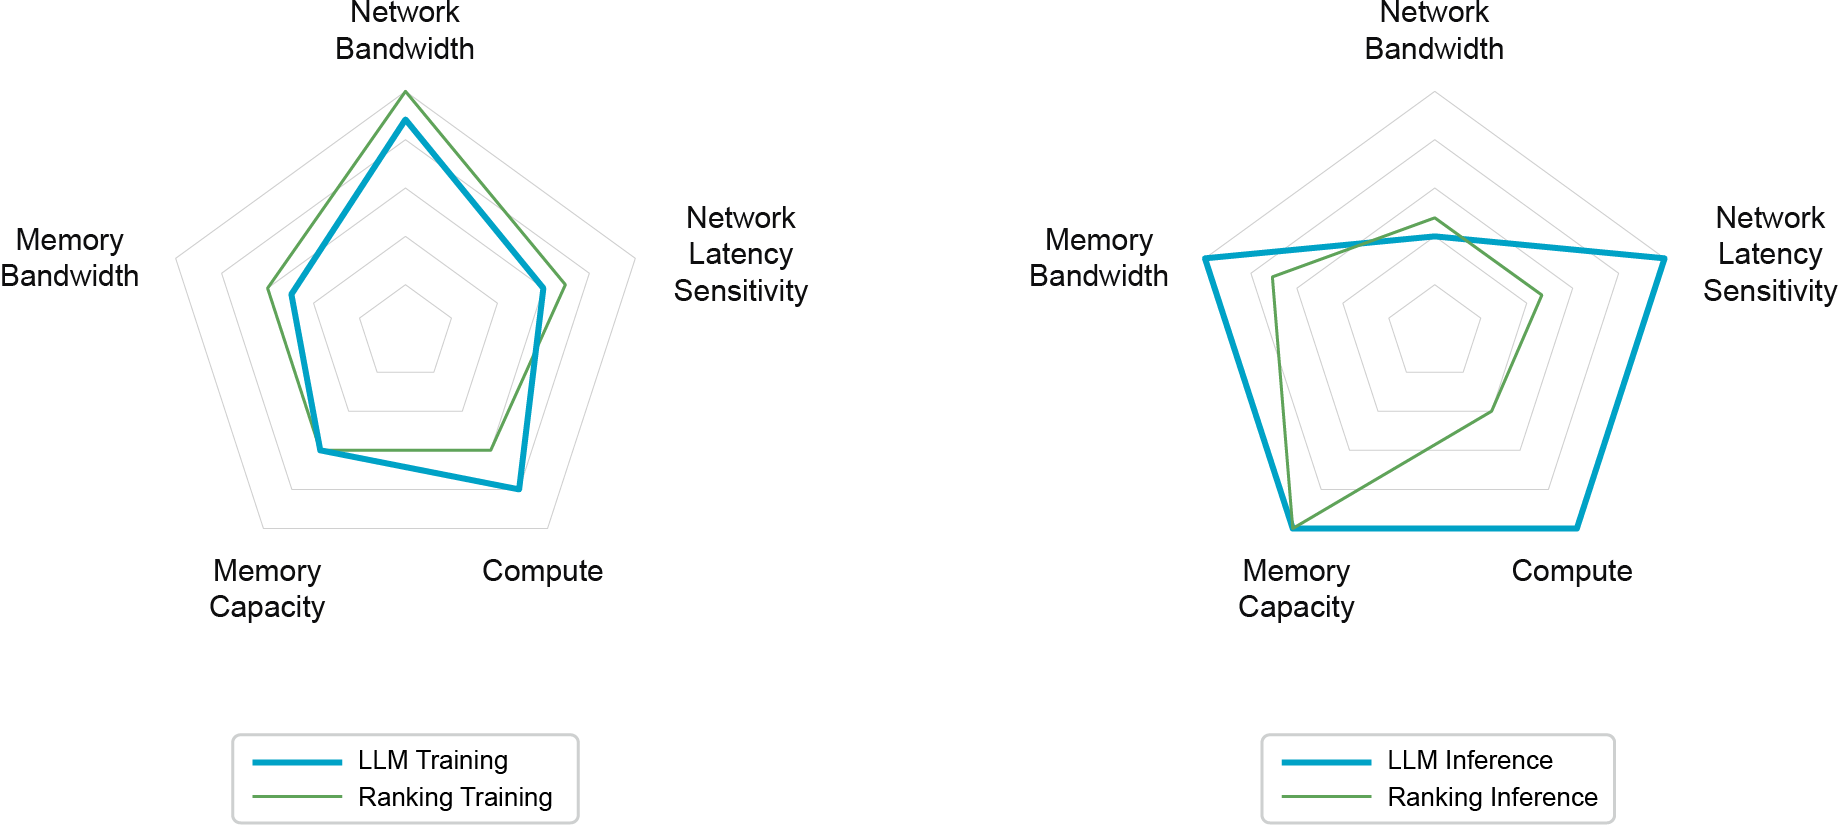
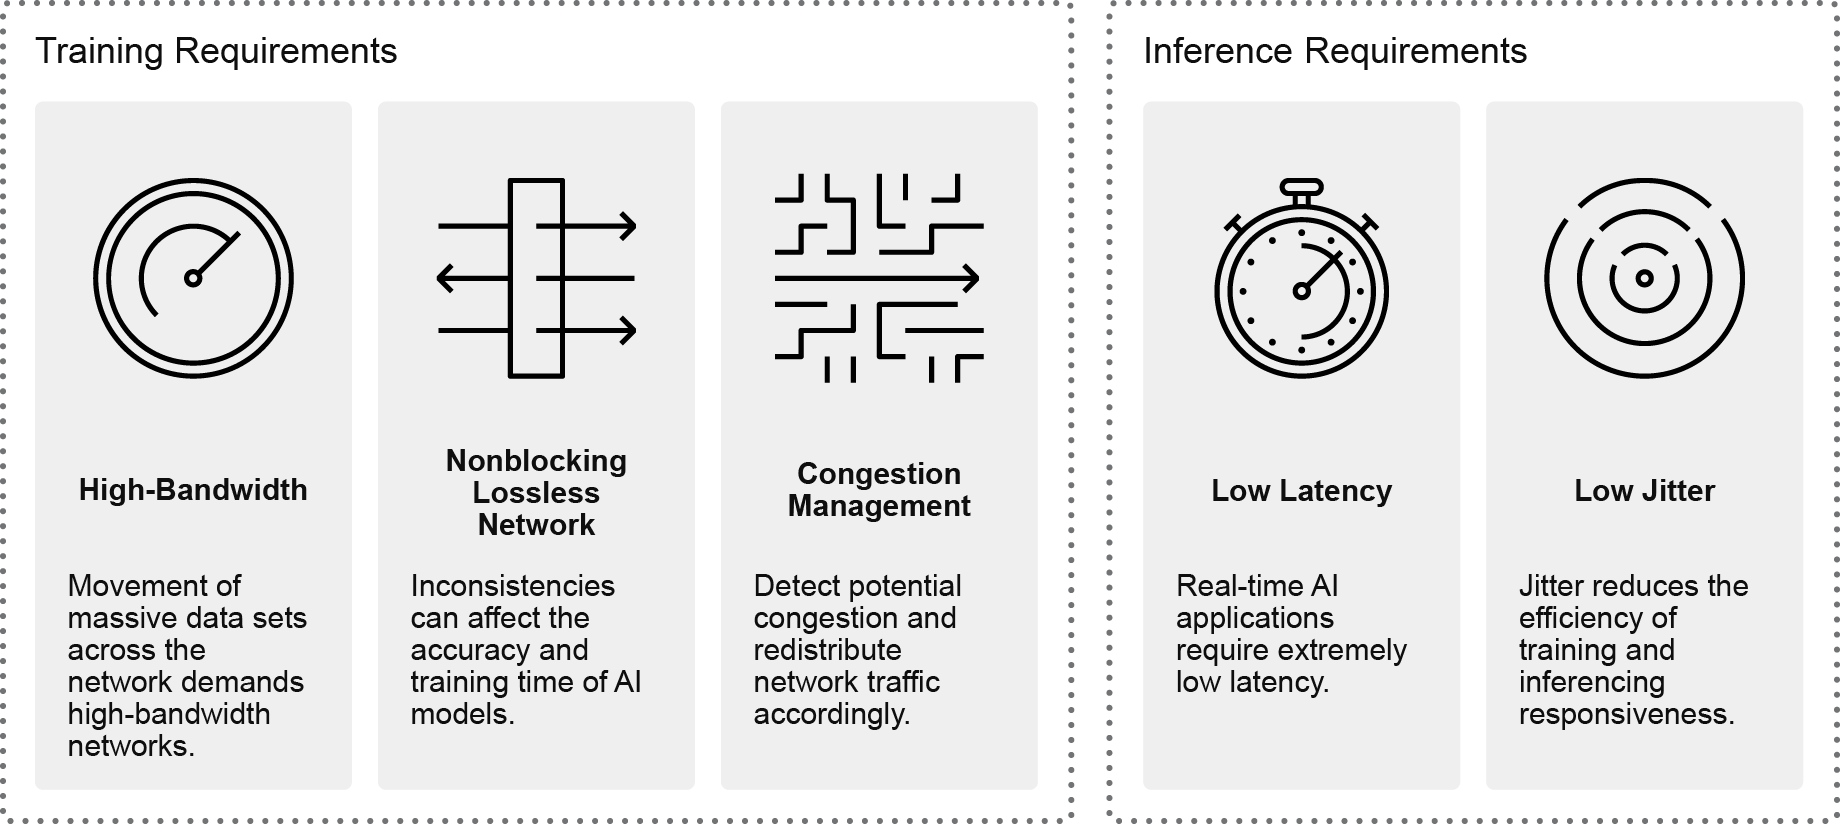
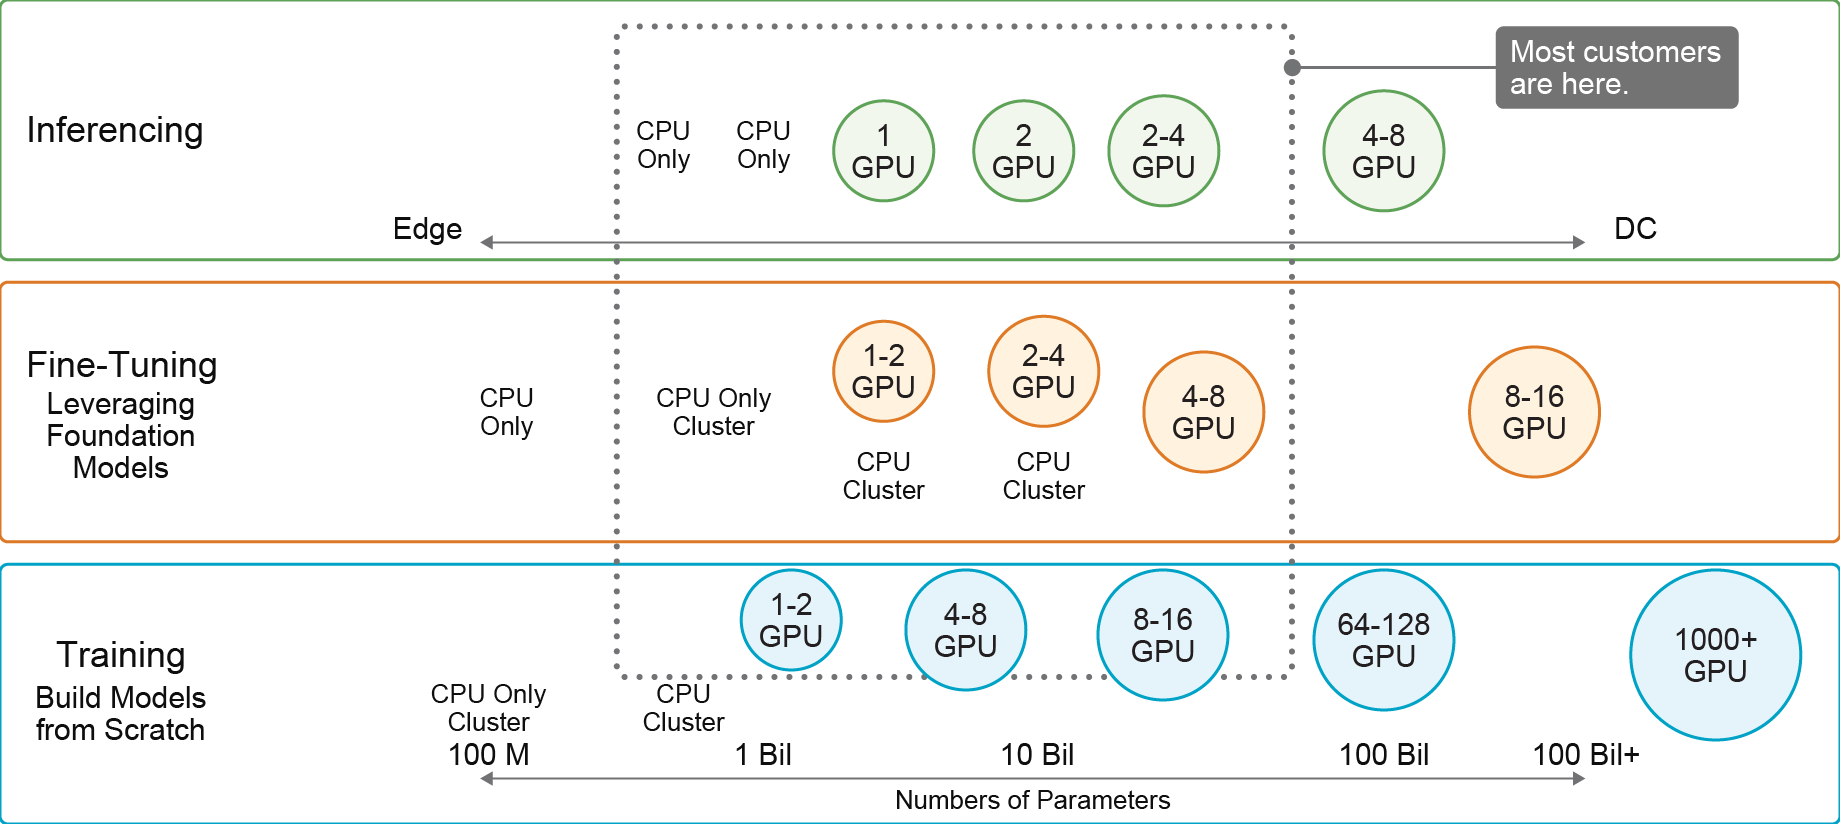
训练:最耗资源,以GPU为主(并行矩阵运算),CPU辅助数据预处理,需高吞吐量存储与网络;
-
微调:与训练资源类型相同,但数据量更小,计算强度更低;
-
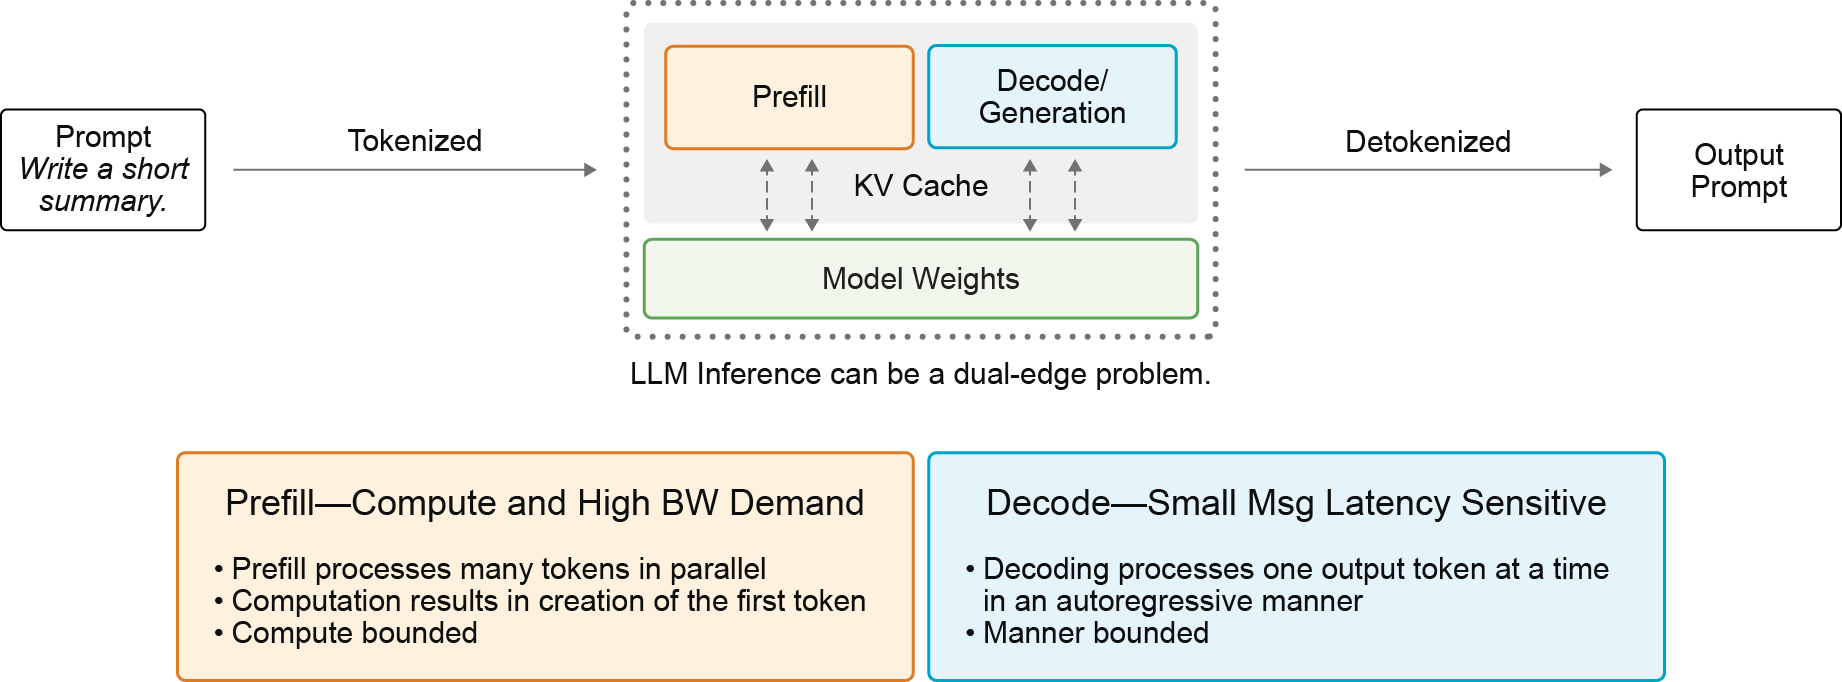
推理:低延迟敏感,可在GPU或带AI扩展的CPU运行,批量推理时需关注吞吐量。
-
-
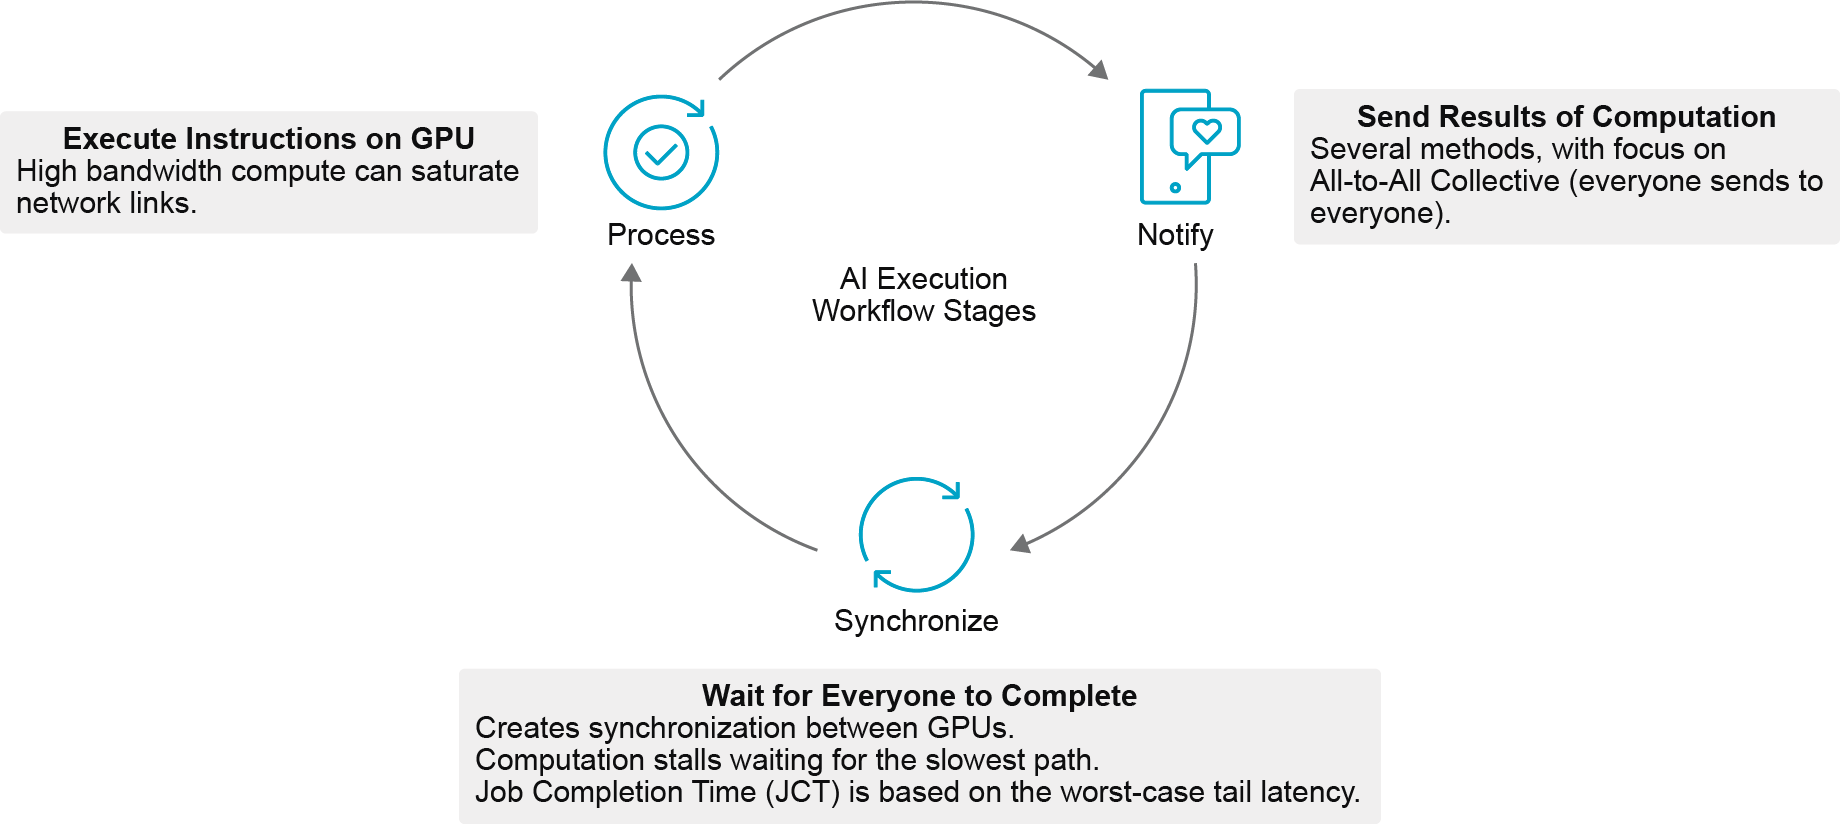
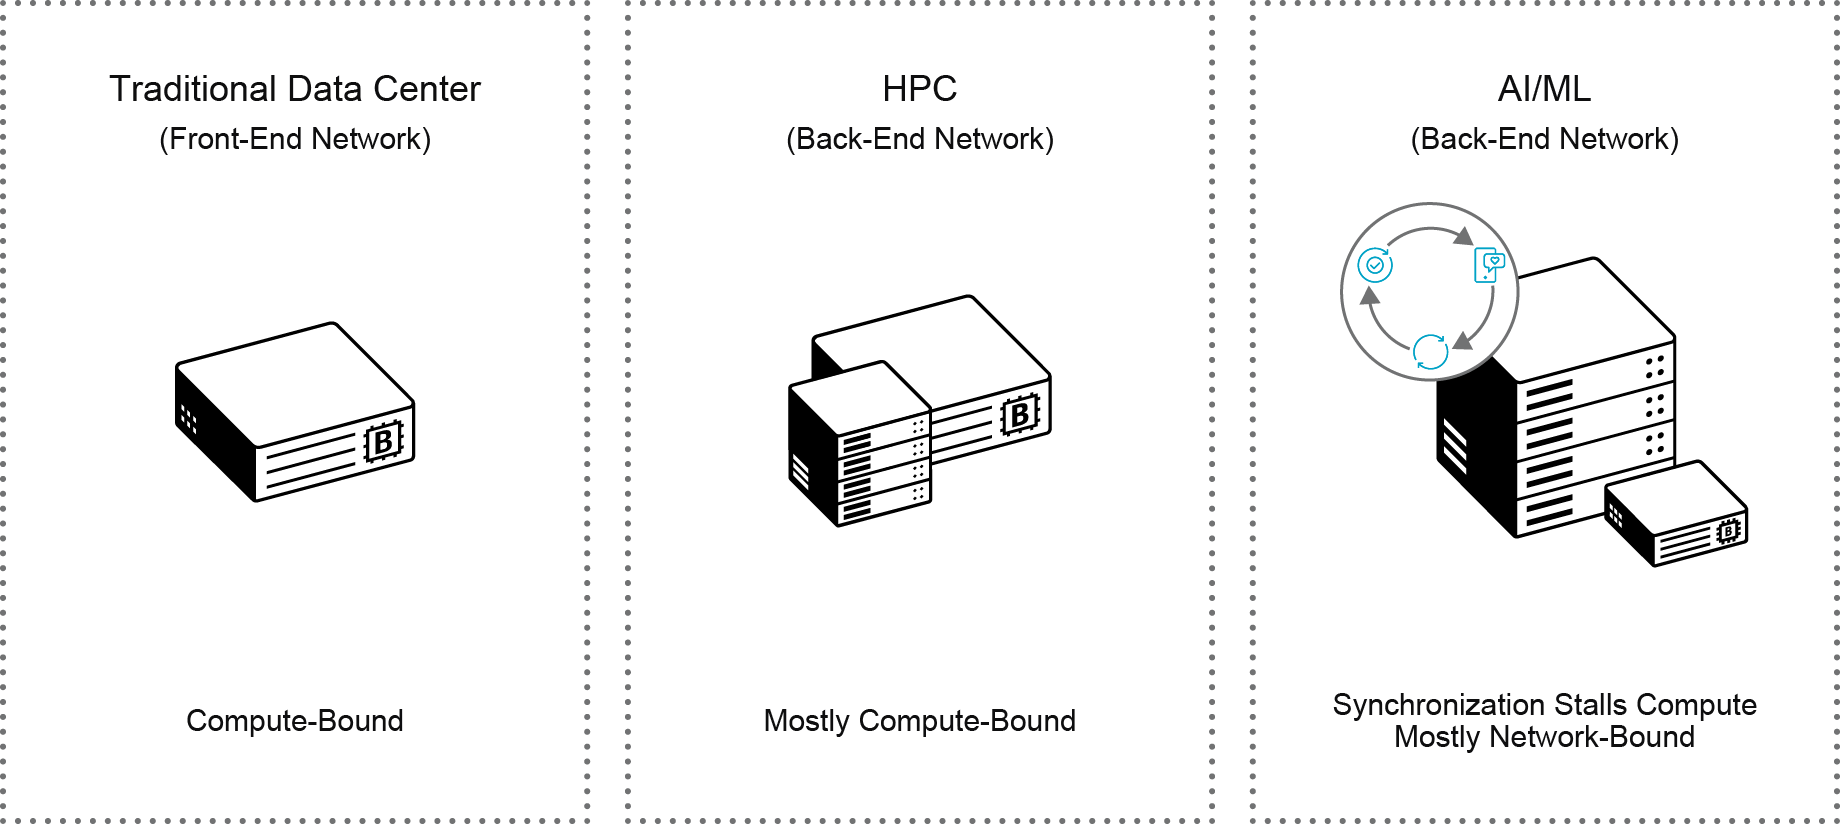
网络需求:分布式训练需高带宽低延迟网络,支持GPU间数据同步(如All-to-All通信模式),推理阶段需负载均衡以处理并发请求。
-
硬件选择:GPU适合并行计算密集型任务(训练/微调),CPU适合轻量级推理或传统ML算法(如决策树)。