Diogo Almeida 的身份本身就值得标注:OpenAI InstructGPT 论文的共同作者,ChatGPT 背后的 RLHF 方法奠基者之一。他现在的判断是,过去几年我们把太多资源押注在 System 2 模型上,而企业真正缺的是 System 1。
System One 与 System 2 的工程分界
Kahneman 的二系统理论被 AI 行业借用后,语义已经泛化。这里的 System 1 不是认知科学意义上的直觉,而是工程分类:快速、结构化、可预期的决策单元。System 2 则是 LLM 的典型形态------多轮推理、逐 token 生成、输出字符串后再解析。
Almeida 的核心论点是,企业里 80% 的 AI 调用场景不需要自然语言输出,只需要 Choice、Score、Route、Escalate 这类带概率的结构化判断。你已经在代码里定义了 schema,为什么还要让模型吐一段文字再祈祷解析不失败?
更准确地说,这不是效率优化问题,是范式问题。自回归模型的本质是序列生成,它的输出空间是语言。你要用它做结构化决策,等于绕路。
技术机制:并行采样与 RLCD
Jev 的架构已经脱离标准 transformer 自回归模式。它的核心机制是 parallel sampler:一次请求同时评估所有可能的输出维度,返回预定义 schema 内的值加校准概率。
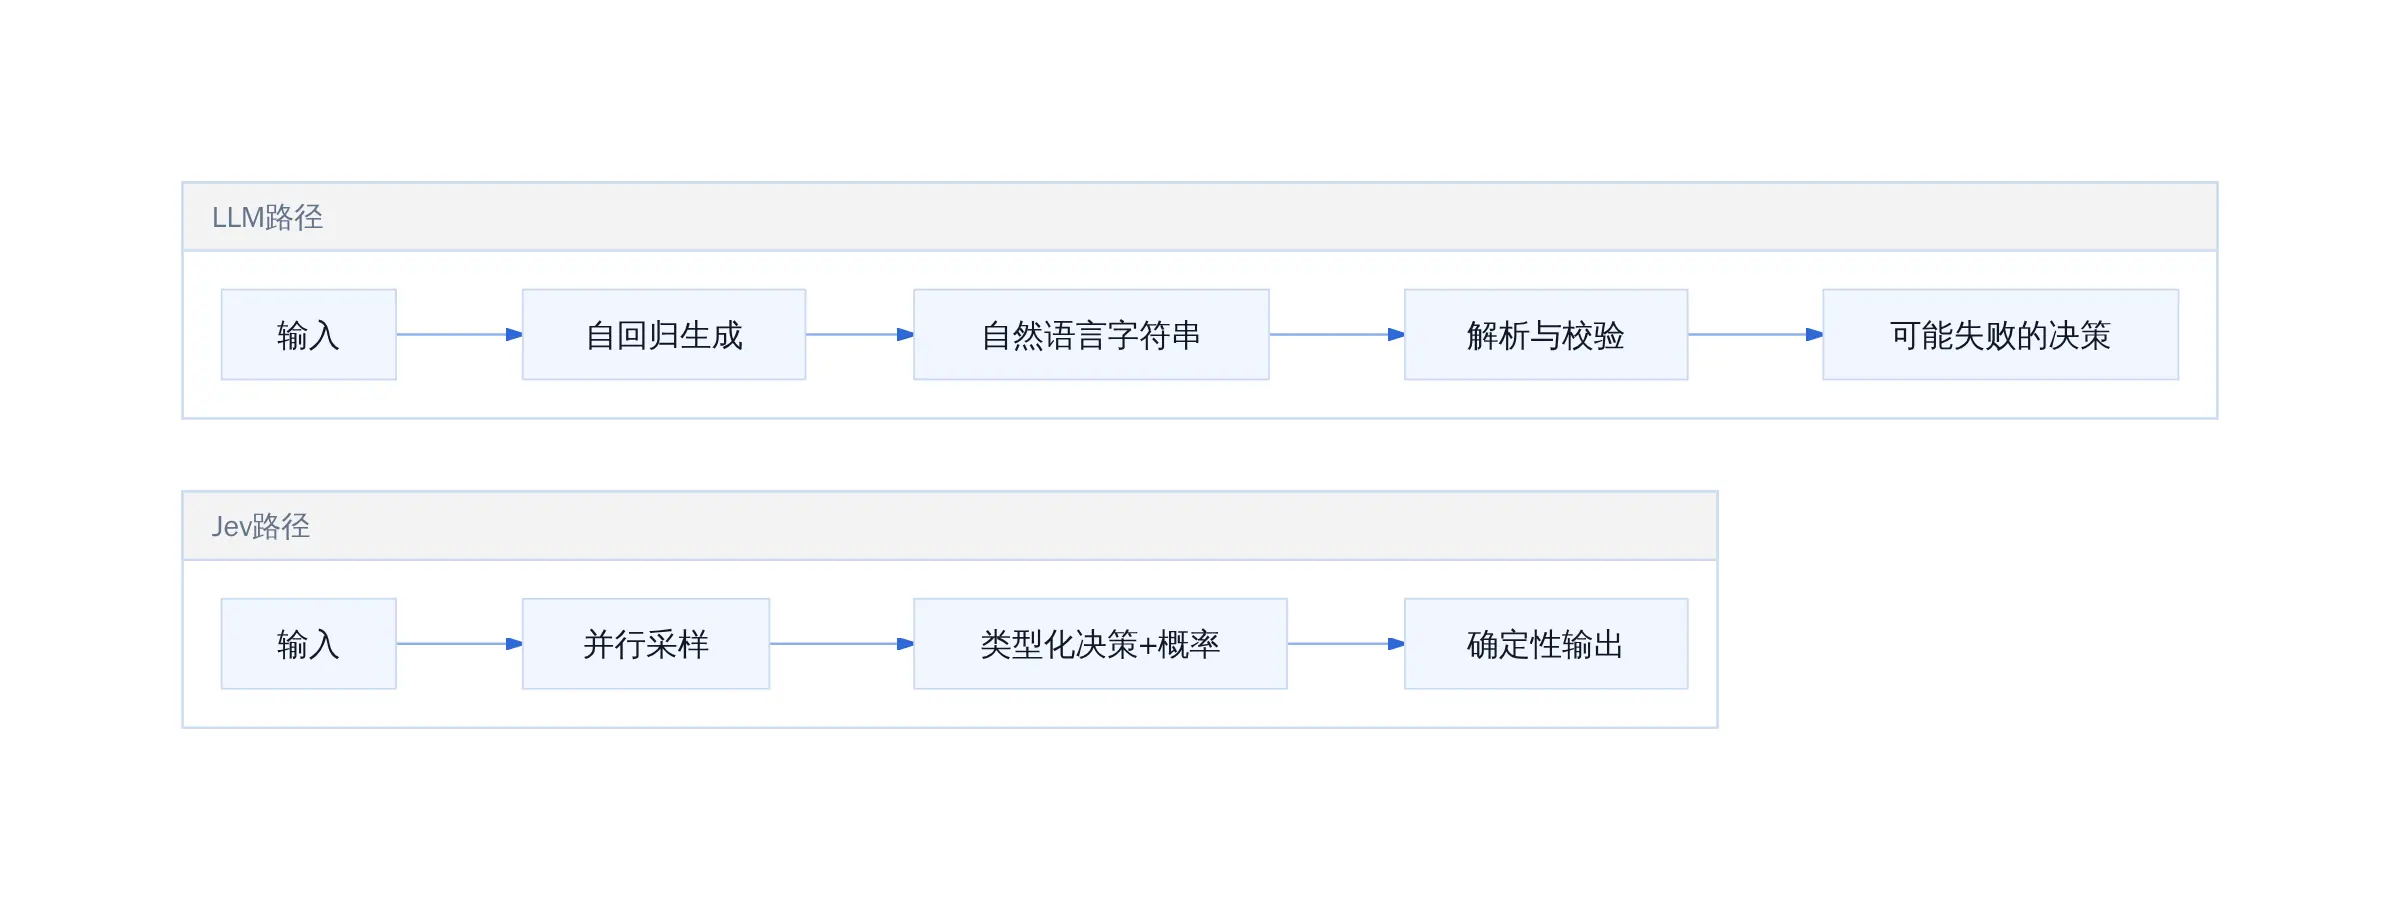
Jev 与 LLM 输出路径对比
延迟方面,TypeSafe 自报数据是 70-500ms,比同样规模小模型快一个数量级。输出免费,输入按 $0.042/MTok 计费------这个定价策略本身就传递了一个信号:他们不想靠 output token 赚钱,想靠决策量大规模铺开。
训练方法是 RLCD(Reinforcement Learning from Calibrated Decisions),区别于 RLHF 从人类偏好学习。RLHF 优化的是「让人满意」,RLCD 优化的是「决策正确且置信度可校准」。Almeida 在访谈中明确表示,RLHF 的缺陷在于它让模型过度自信,这也是为什么模型能一本正经地胡说八道。
不过,公开可核验的校准指标目前仍然有限。TypeSafe 没有完整公布 ECE、Brier Score 或可靠性图表。这是否意味着他们的校准声明需要打个问号?坦白讲,是的。但在没有反证之前,至少先接受他们的产品定位:Jev 不是通用模型,是专用决策层。
杰文斯悖论:越便宜,用得越多
Jev 的名字来自经济学家 William Stanley Jevons。他观察到一个反直觉现象:蒸汽机效率提高后,煤的总消耗量反而上升,因为应用边界扩展了。
TypeSafe 把这个逻辑直接映射到智能领域:当一次决策的成本下降一个数量级,企业的决策频率会上升一个数量级。今天只有核心节点调用 AI 判断,明天可能对每一封邮件、每一个 Agent 输出、每一次操作都做风险评分。
这意味着计价单位会从「每百万 token」变成「每次决策多少钱」。这个转换本身就是一次产品范式迁移。
行业启示与可执行建议
从从业者角度看,Jev 的出现传递了几个可执行的判断。
第一,如果你正在构建 Agent 系统,优先考虑将路由、分类、评分、风险判断等任务从 LLM 中剥离,交给专用决策模型。不要为了「看起来智能」而让 GPT-4o 去判断一封邮件是否该回复。
第二,引入 Jev 这类模型的前提是:你的决策任务可以被结构化定义。如果你的任务本质上是开放探索,需要生成新思路,那还是得用 System 2 模型。
第三,价格不是唯一优势,延迟也不是。真正值得看重的是「结构化输出零解析成本」和「校准概率」这两点。前者减少工程复杂度,后者让模型知道自己的边界。
最后,Almeida 在访谈中反复强调一点:Jev 不是 God 模型,它解决不了你需要创造性输出的问题。它是一个组件,不是一个替代品。
在 X 条件下,比如高频、低容错、结构化输出要求的决策场景,应该优先部署 System One 模型;当条件变为开放探索、需要推理链或创造性输出时,切换回 LLM。这不是技术路线之争,是任务匹配问题。
核心差异:Jev 与 LLM 的范式分叉
Diogo Almeida 在访谈中明确区分了 System One 和 System 2 的适用场景。主流 LLM 属于 System 2------逐 token 自回归生成,延迟数秒,但擅长开放-ended 推理。Jev 选择完全不同的路径:并行采样(parallel sampler),一次性评估所有可能输出,延迟 70--500ms,且输出是类型化的 Choice / Score / Noul 带置信度,而非字符串。
这种设计带来一个工程红利:类型错误率理论上为 0%。LLM 需要下游解析验证,偶尔产生格式幻觉;Jev 在架构层面消除了这一环节。
类型安全的代价是放弃生成能力
训练方法 RLCD(Reinforcement Learning from Calibrated Decisions)是另一条分歧线。RLHF 优化的是人类偏好,容易出现过度自信和讨好倾向。RLCD 直接优化决策校准------模型需要学会说「我不确定」,而不仅仅是选最高概率项。不过 RLCD 的具体奖励函数和系统概率校准指标(如 ECE、Brier Score)目前未完整公开。
性能边界的诚实评估
访谈中未回避性能对比。Jev 在多数决策任务上与 Sonnet、Terra 接近,但弱于最强的 Astra、Opus。发票处理场景差距最大:Jev 61.8% vs Sol 79.1%。这组数字说明什么?TypeSafe 自身也承认,这证明的是「在选定决策任务上以低一个数量级的价格打出有竞争力成绩」,不等于等于旗舰智能。
更准确的判断是:Jev 解决的是 80% 日常决策场景,代价是放弃最后 20% 极端复杂任务的处理能力。这在生产环境里其实是理性选择。
mermaid
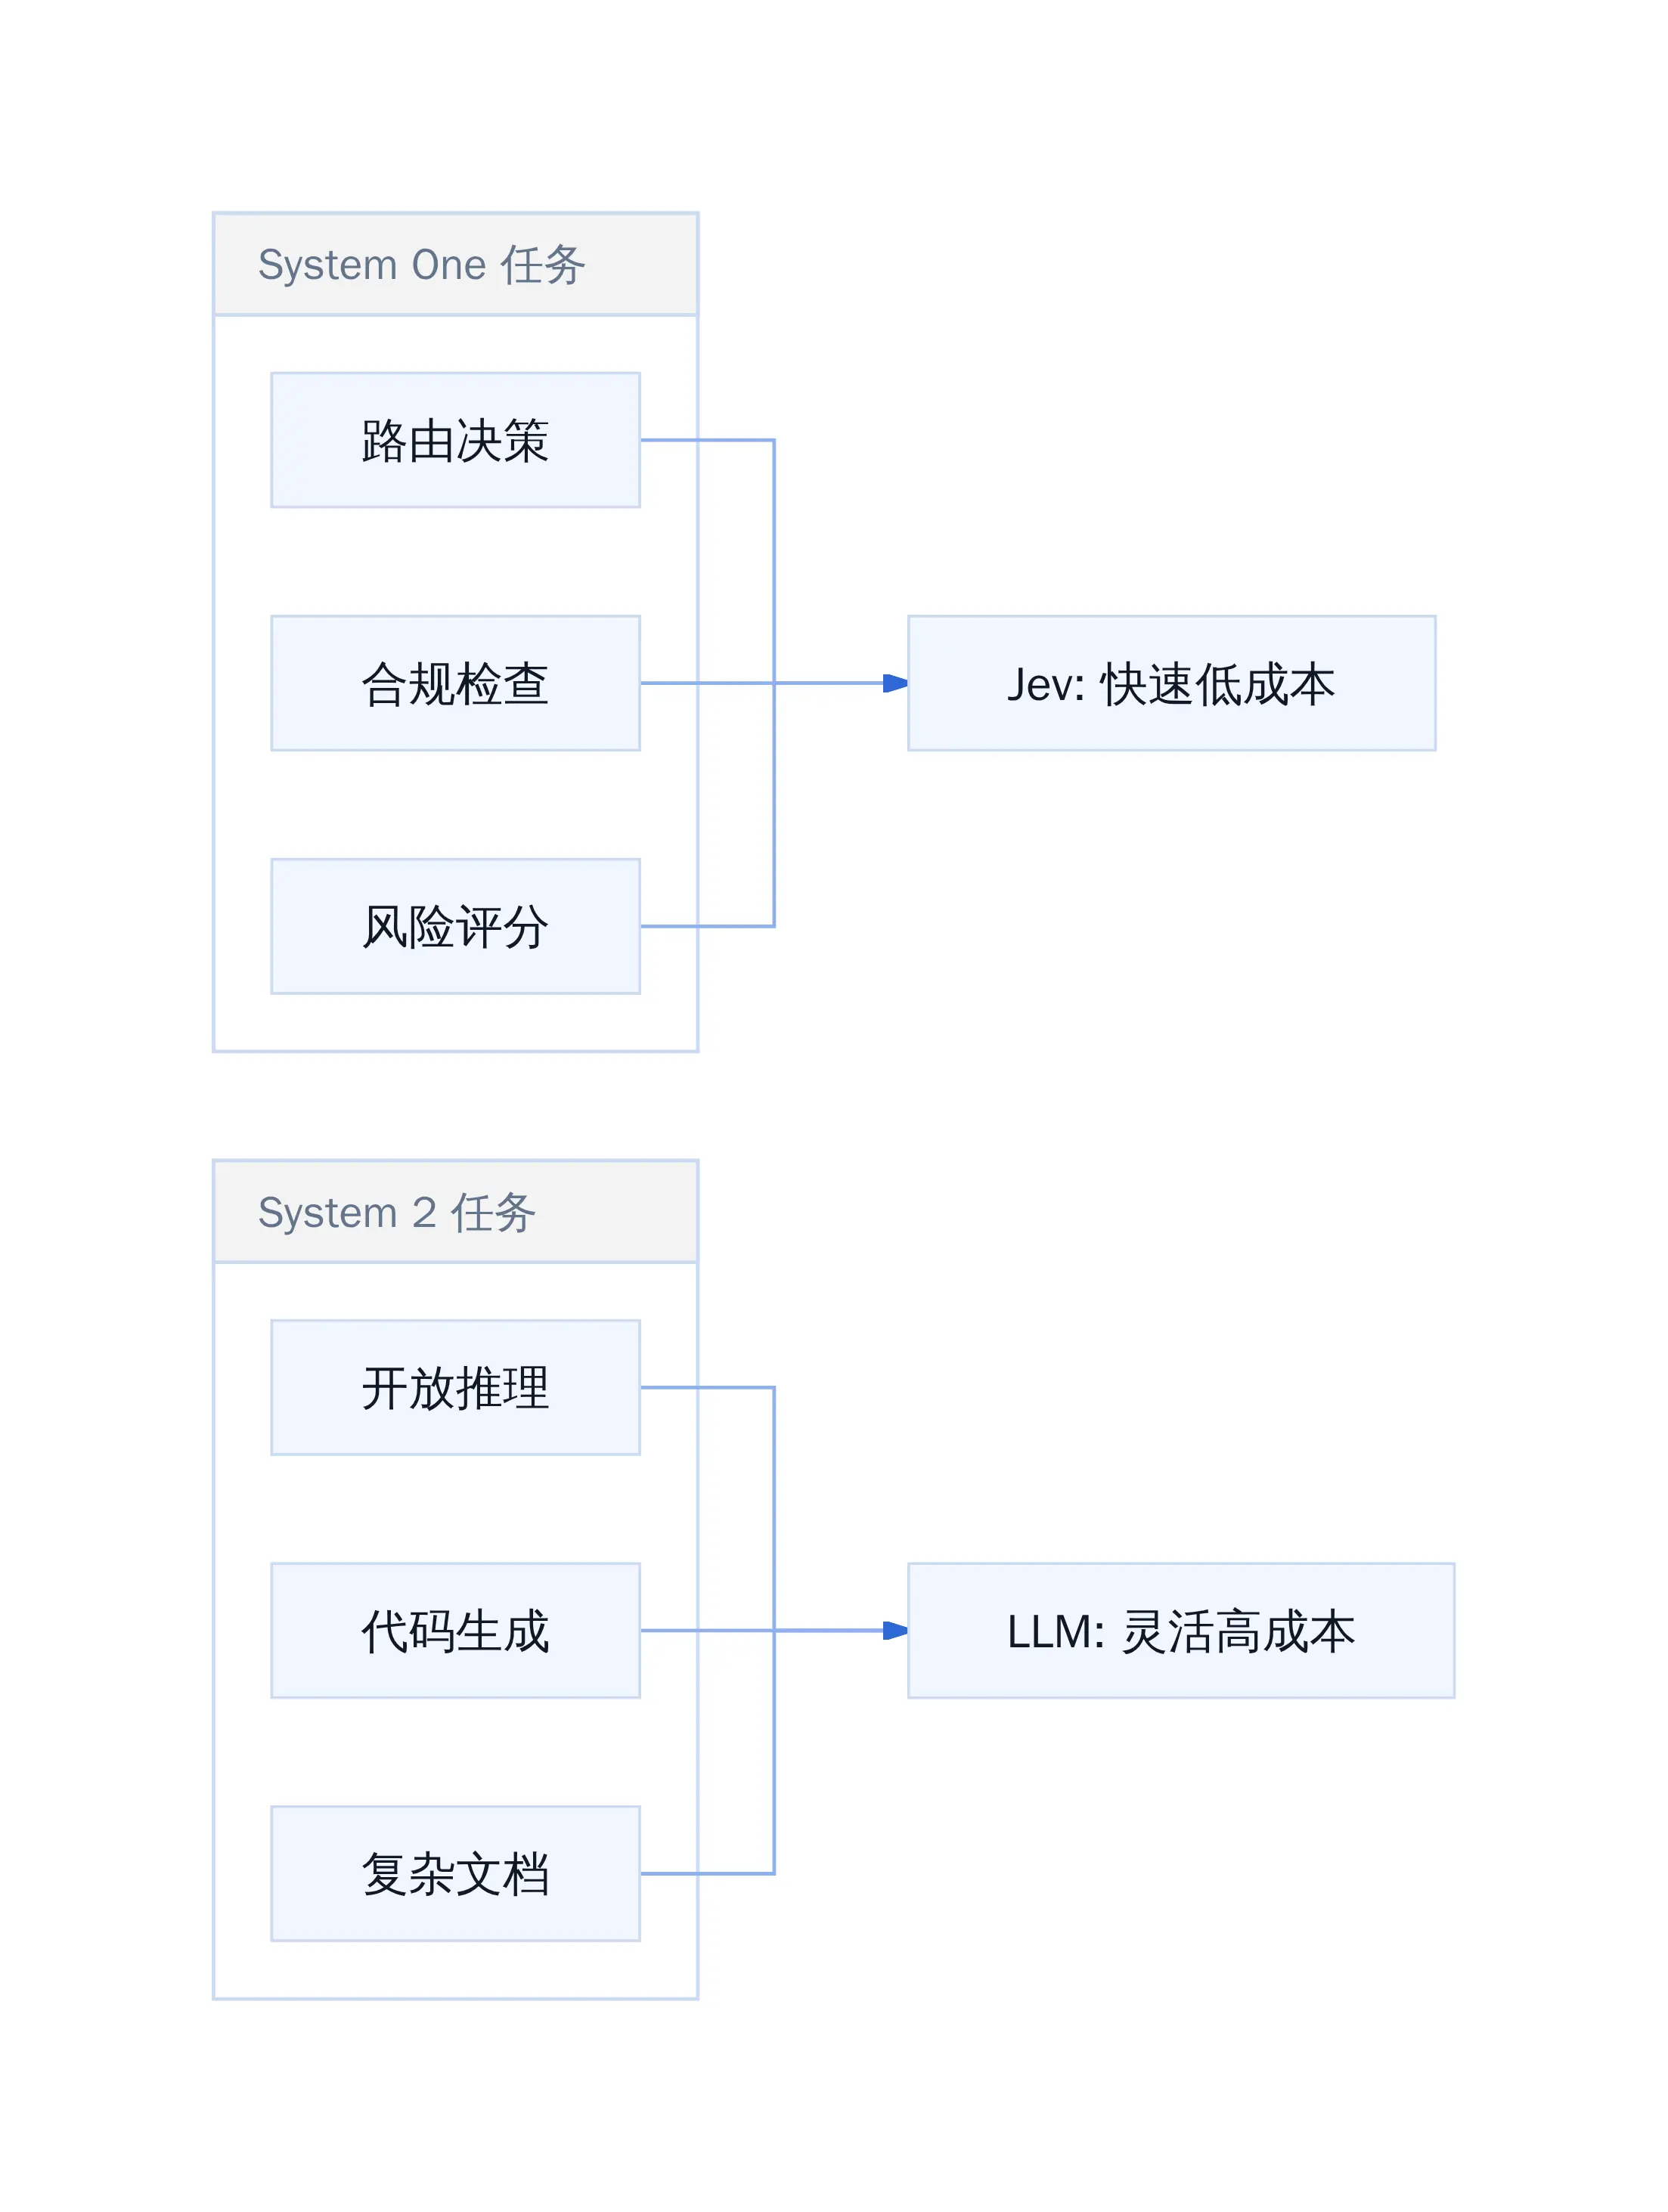
Jev 与 LLM 的适用边界
企业落地的工程取舍
访谈中最有价值的部分是工程角度的权衡讨论。Diogo 指出过去几年企业把越来越多任务交给通用大模型,但对某些判断任务来说这属于杀鸡用牛刀。
杰文斯悖论在这里再次显现:决策成本每下降一个数量级,调用频率会上升一个数量级。今天一次 AI 判断贵,企业只在关键节点调用;明天便宜 100 倍,系统可能对几乎所有东西多问一遍------这封邮件要不要回?这次操作有没有风险?Agent 输出合不合格?
这就引出一个架构问题:Jev 不是要替换 LLM,而是与 LLM 形成混合栈。
System One + System 2 的分工
具体落地有三条路径:一是把 Jev 放在 Agent 循环的决策节点,处理高频低复杂度判断;二是用 Jev 做预筛选,便宜任务交给 Jev,复杂任务转 LLM;三是直接在 API 层用 Jev 替代需要结构化输出的现有 LLM 调用。
风险边界也很清晰:当输入分布发生偏移、或任务超出预定义的答案空间时,Jev 的校准置信度可能失效。这类场景需要回到 LLM 或人工判断。
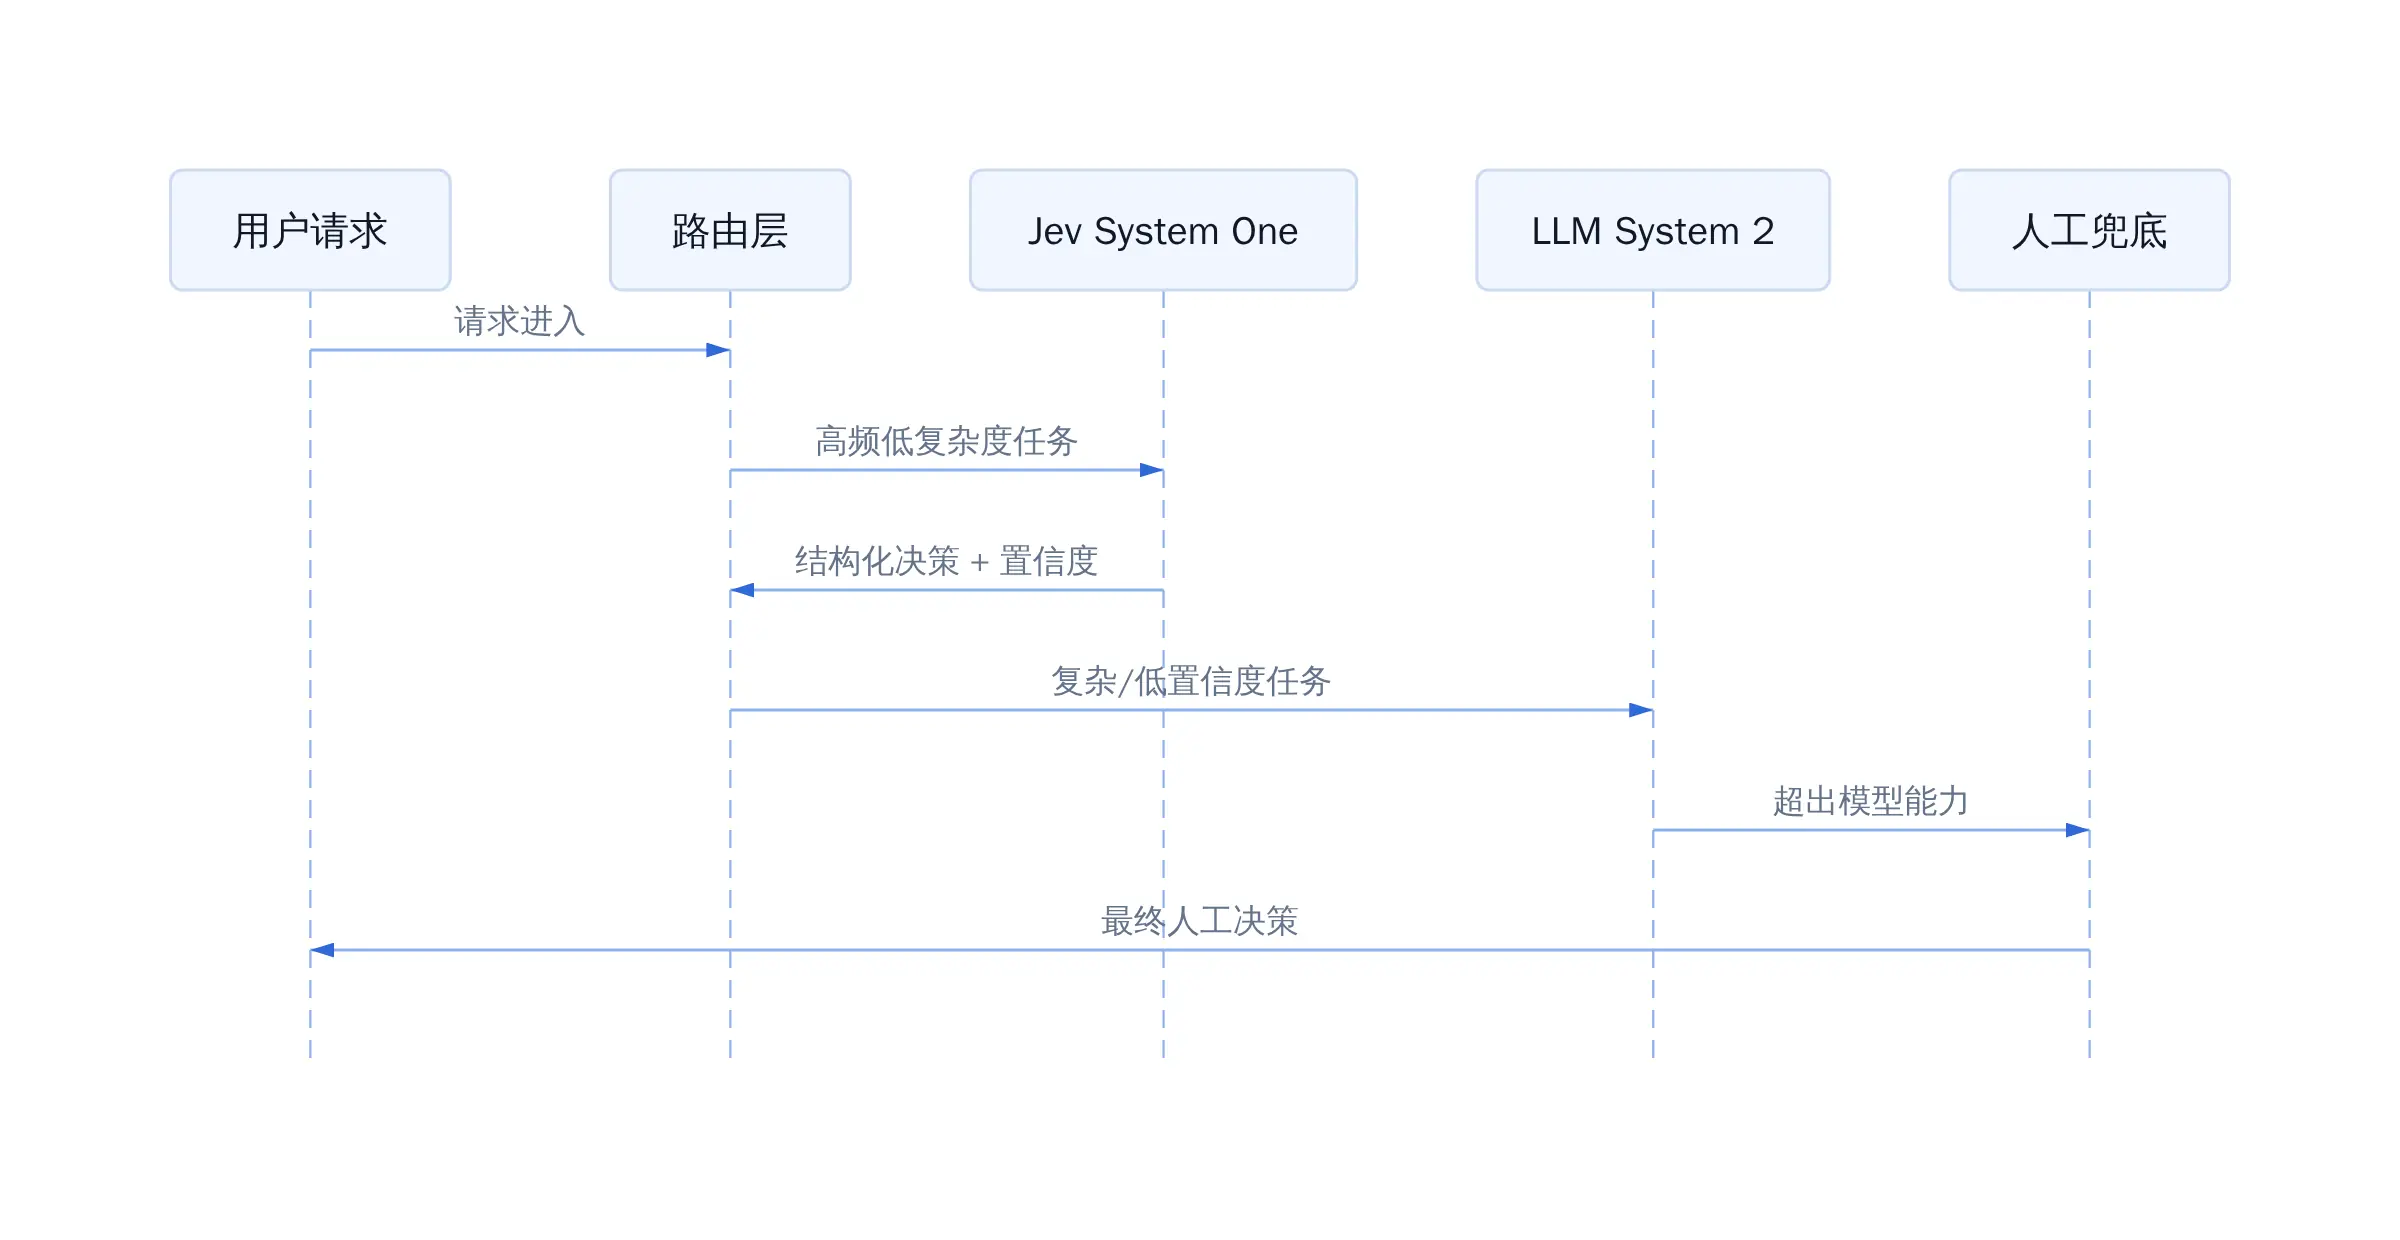
混合架构决策流
从经验看,适合现在就考虑 Jev 的场景包括:客服工单分类、文档路由、简单风控、Agent 输出校验。不适合的场景:需要创造性推理、长链推理、或未定义答案空间的任务。
更狠的是,定价单位会从「每百万 token」转向「每次决策多少钱」。这会让决策智能的经济学逻辑彻底重算。
Diogo 在访谈里反复被追问同一个问题:Jev 到底是什么,它和现有的 LLM 到底差在哪。他的回答很直白------Jev 不是更强的通用模型,它是专门为「需要快速、可靠、结构化判断」的场景单独造的模型。它不生成文本,只返回预定义格式里的 Choice、Score 或 No-Output,并附带经过校准的概率值。
这听上去像工程优化,但 TypeSafe 把它包装成了「System One 模型」,有意和 ChatGPT 为代表的 System 2 类模型拉开距离。System 2 擅长逐步推理、写作、代码生成,代价是延迟高、成本高、结果不可核验------你需要靠 parser 去捞结构化字段,还得祈祷它没幻觉。System One 则走另一条路:在输入进来时一次性并行产出所有候选决策,延迟落在 70 到 500 毫秒区间,输出直接可消费。
工程师看到延迟从秒级降到毫秒级
这种路线的核心支撑是并行采样加 RLCD(Reinforcement Learning from Calibrated Decisions)。RLCD 与 RLHF 最大的区别在于优化目标。RLHF 优化的是「让人满意」,结果模型倾向于讨好标注者、过度承诺、出现过度自信。RLCD 优化的是「决策本身在真实环境里的校准质量」,也就是说模型输出的概率要能在统计上反映真实命中率。这在自动化场景里更关键------Agent 不需要讨好人,它需要在没有人在 loop 的时候做出靠谱的选择。
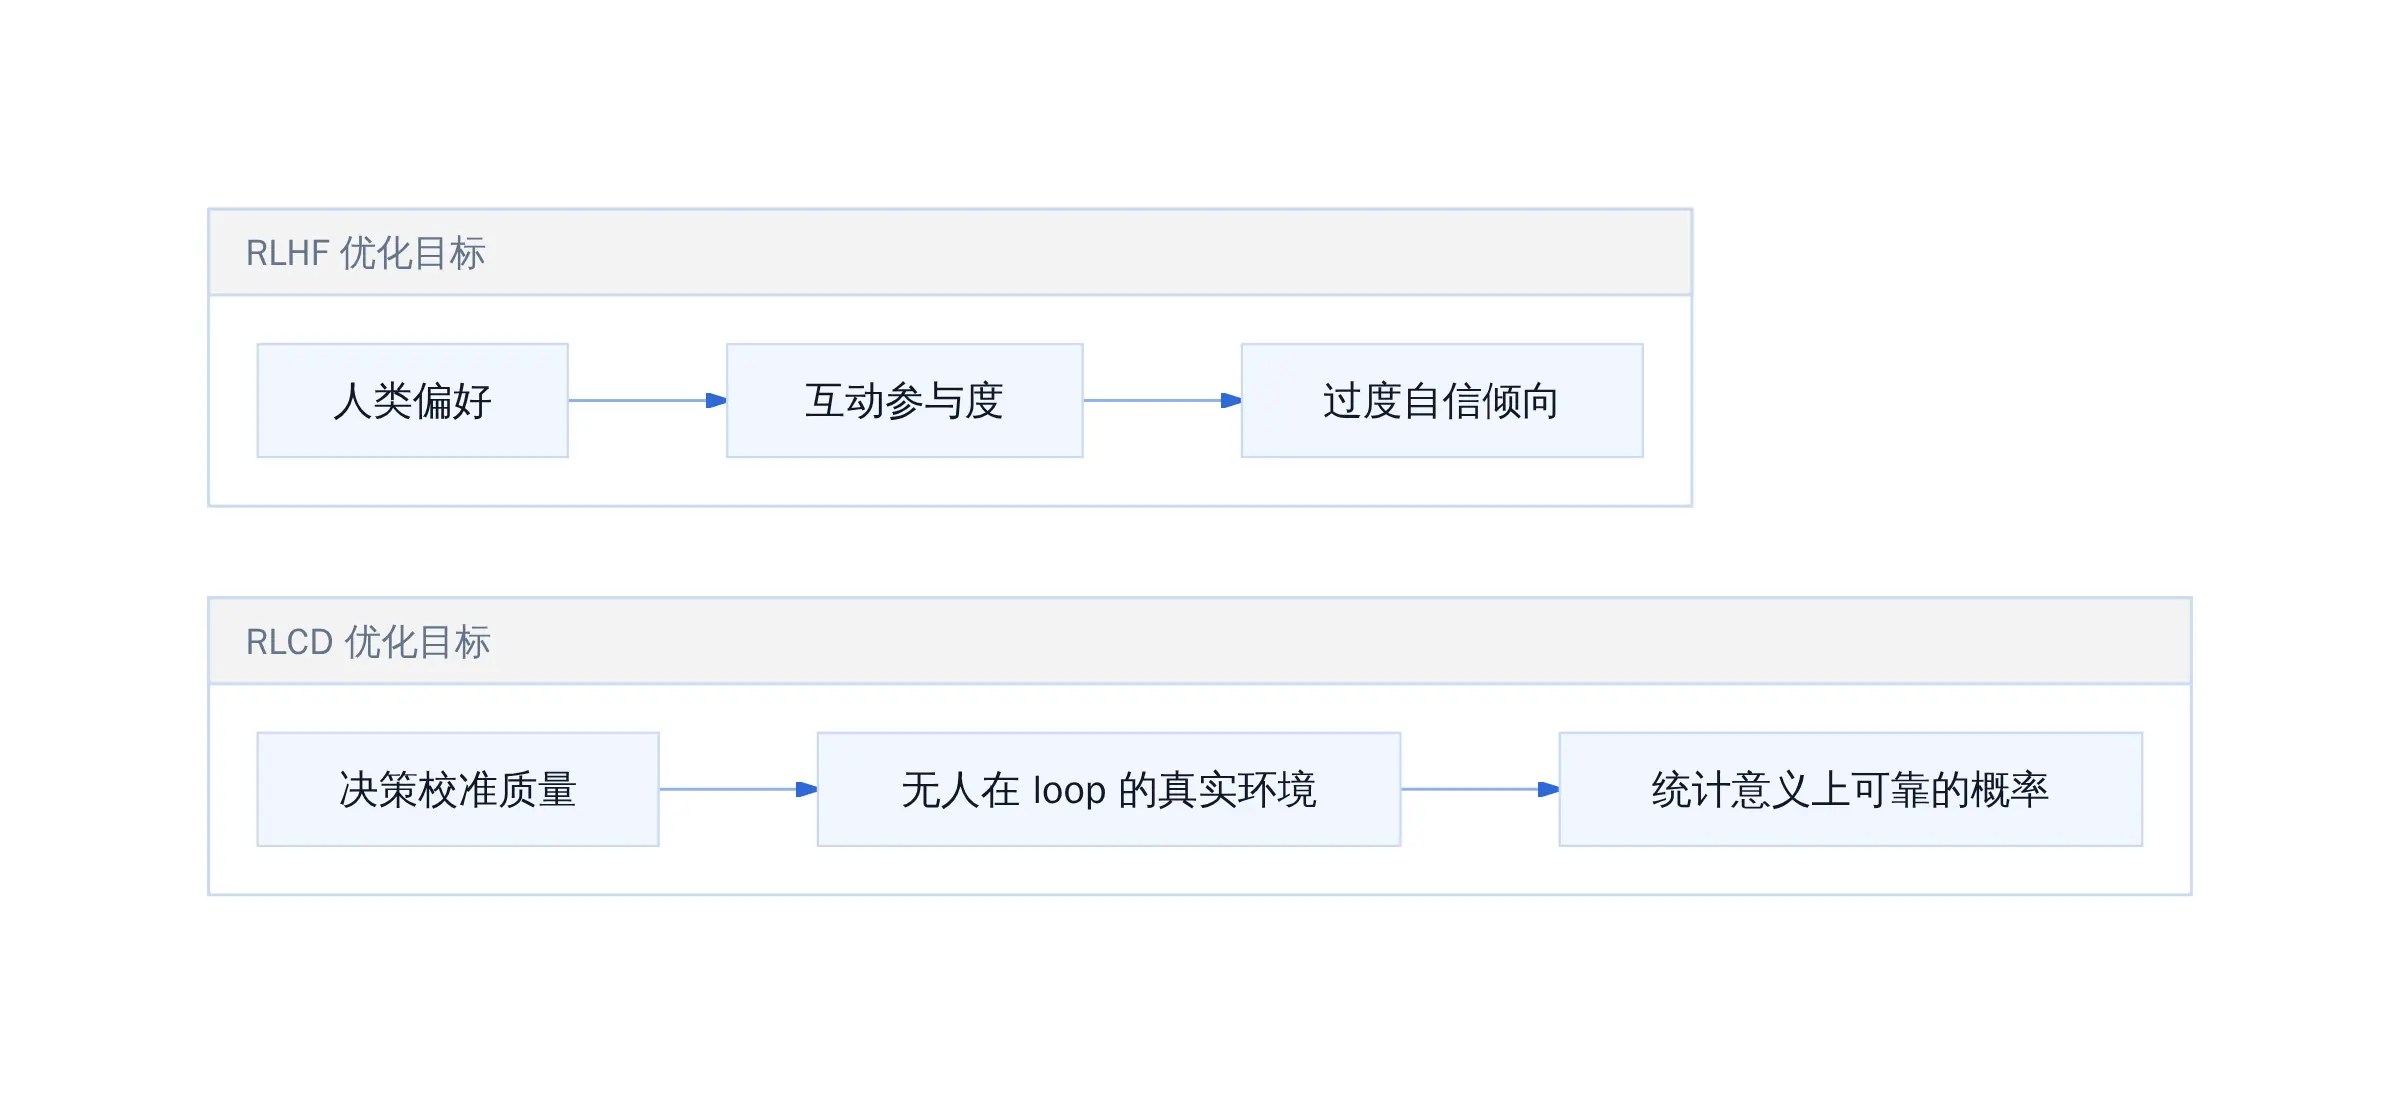
RLHF 与 RLCD 优化目标的对照
但访谈里也有一个绕不开的质疑:TypeSafe 目前没有公开完整的 ECE、Brier Score 或可靠性图表,也没有系统展示 Jev 在输入分布偏移后的校准稳定性。换句话说,「校准」目前更像是一个方向性承诺,还不是能逐项核验的工程指标。
这种坦诚反而说明 TypeSafe 对自己产品的边界有清晰认知------他们不想假装自己是全能模型,而是直接把「校准是否到位」作为后续迭代的重点。对企业而言,这意味着现阶段引入 Jev 需要做灰度验证,不能直接盲信它的概率输出。
这位前 OpenAI 研究员在访谈里反复被追问同一个问题:Jev 到底是什么,它和现有的 LLM 到底差在哪。他的回答很直白------Jev 不是更强的通用模型,它是专门为「需要快速、可靠、结构化判断」的场景单独造的模型。它不生成文本,只返回预定义格式里的 Choice、Score 或 No-Output,并附带经过校准的概率值
这听上去像工程优化,但 TypeSafe 把它包装成了「System One 模型」,有意和 ChatGPT 为代表的 System 2 类模型拉开距离。System 2 擅长逐步推理、写作、代码生成,代价是延迟高、成本高、结果不可核验------你需要靠 parser 去捞结构化字段,还得祈祷它没幻觉。System One 则走另一条路:在输入进来时一次性并行产出所有候选决策,延迟落在 70 到 500 毫秒区间,输出直接可消费。
工程师看到延迟从秒级降到毫秒级
System One 的工程分界
Diogo 在访谈中最核心的判断是:过去几年我们把越来越多任务交给了通用大模型,但对某些任务来说,这有点杀鸡用牛刀。真正在软件系统里跑着的决策流程------路由、评分、分类、风险阈值判断------这些任务并不需要你写一段完整的推理链条,它们只需要你给出一个带置信度的答案。
Jev 的技术机制建立在一个简单观察上:串行生成和并行判定的计算图完全不同。主流 LLM 是 autoregressive 的,每个 token 依赖前一个 token,所以输出长度和延迟呈线性关系。Jev 的并行采样器在单次查询里同时评估所有候选输出,这意味着延迟基本固定,和输出维度无关。
更关键的是训练目标。TypeSafe 用的 RLCD(Reinforcement Learning from Calibrated Decisions)和传统 RLHF 有本质区别。RLHF 优化的是人类偏好,结果是模型越来越会讨好你------同意你的观点、避免冒犯你、甚至为荒谬的请求找理由。RLCD 优化的是校准度:模型输出的概率值要和实际准确率对齐。一个输出 90% 置信度的判断,真实准确率应该接近 90%,而不是嘴上说 90% 实际只有 60%。
这种校准难度很高。Diogo 在访谈里坦承,截至目前 RLCD 的具体训练方法、奖励函数以及更系统的概率校准指标都还没有完整公开。看不到完整的期望校准误差(ECE)、Brier 分数和可靠性图表,也没有系统展示模型在领域变化、输入分布偏移之后的表现。
但这恰恰是 Jev 路线的价值所在:如果开发者真的可以花两个小时在一个小参数模型上做出类似的结构化并行判断,说明这类能力可能根本不需要一个昂贵、复杂、无所不能的大模型才能实现。
落地判断:什么时候该用,什么时候不该用
在以下条件下推荐 Jev:任务输出空间预定义且有限;需要批量处理大量简单决策;延迟敏感,要求在毫秒级返回结果;校准度比绝对准确率更重要------你需要知道模型有多大把握,而不只是它认为什么是对的。
当任务需要创造性输出、推理链条长、类别空间开放或输入分布频繁变化时,Jev 不适合。这种情况下,继续用 LLM 或考虑其他方案。
TypeSafe 的路线本质上是对 AI 自动化 Gap 的一个回答:模型在聊天上已经 superhuman,但企业自动化依然卡在那些最普通、最平凡、数量最大的决策上。不是因为技术不够强,而是因为技术方向错了。
如果你正在设计一个需要高吞吐、低延迟、结构化输出的系统,Jev 的路线值得评估。如果你还在为聊天机器人找更好的 prompt,这条路帮不上忙。
参考文献
- Jev: System One models for Prod, not God --- with Diogo Almeida | Latent.Space
- Introducing System One Models & Jev --- TypeSafe AI Blog
- What's Next After RLHF? --- Diogo Almeida | AI Engineer Podcast
- Jev: TypeSafe's System One Model Explained --- DataCamp
- 什么是 Jev?TypeSafe AI 的 System One 模型 --- Eigent
延伸入口
- 原文归档:tobemagic.github.io/ai-magician...
- 公众号:计算机魔术师