- 不装软件、不上传、不注册,拖进来就看
- 我们为什么把解析器全搬到浏览器里,以及为此踩过的坑
- 纯前端文件预览器的工程账本:从 RealVideo 到大文件,从跨源隔离到 120 KB 首屏
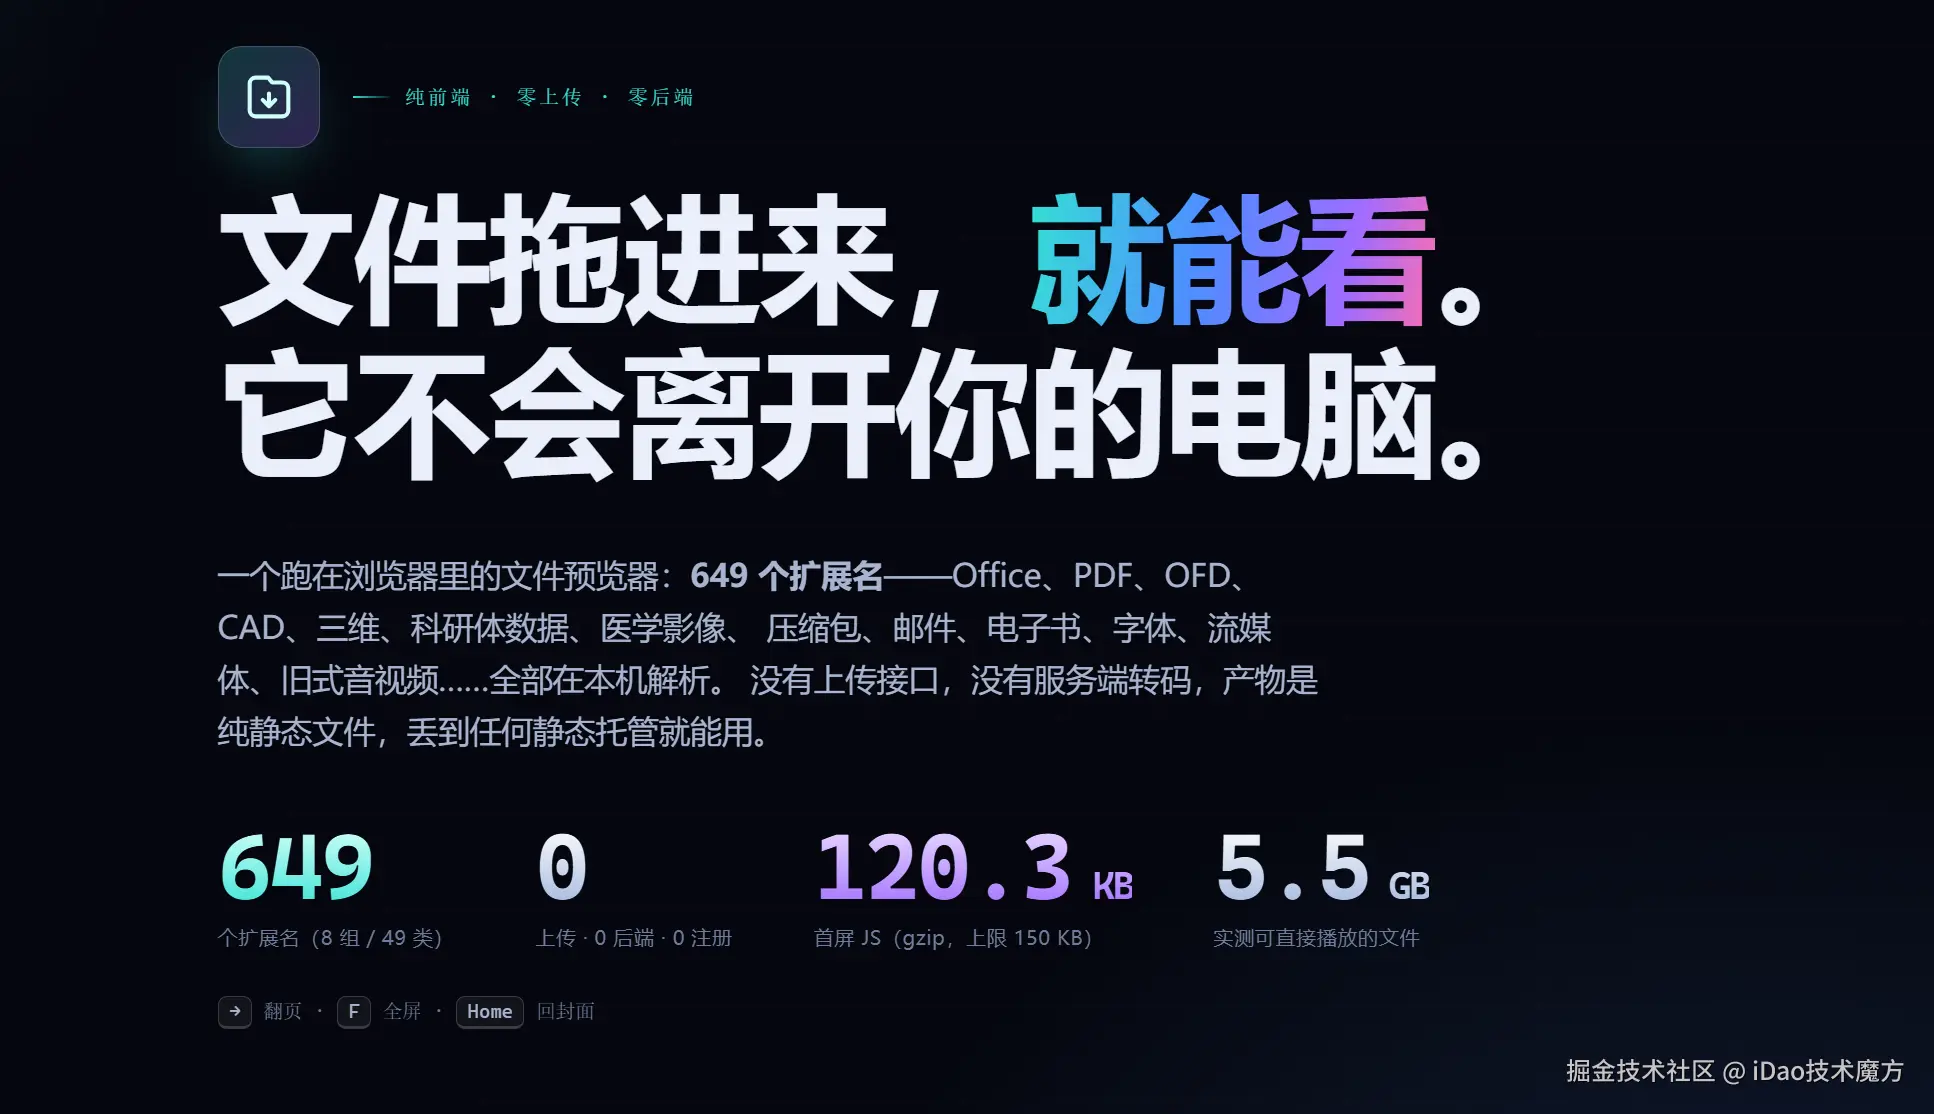
一个跑在浏览器里的文件预览器:649 个扩展名------Office、PDF、OFD、CAD、三维、科研体数据、医学影像、 压缩包、邮件、电子书、字体、流媒体、旧式音视频......全部在本机解析。 没有上传接口,没有服务端转码,产物是纯静态文件,丢到任何静态托管就能用。
一、先讲一个特别具体的场景
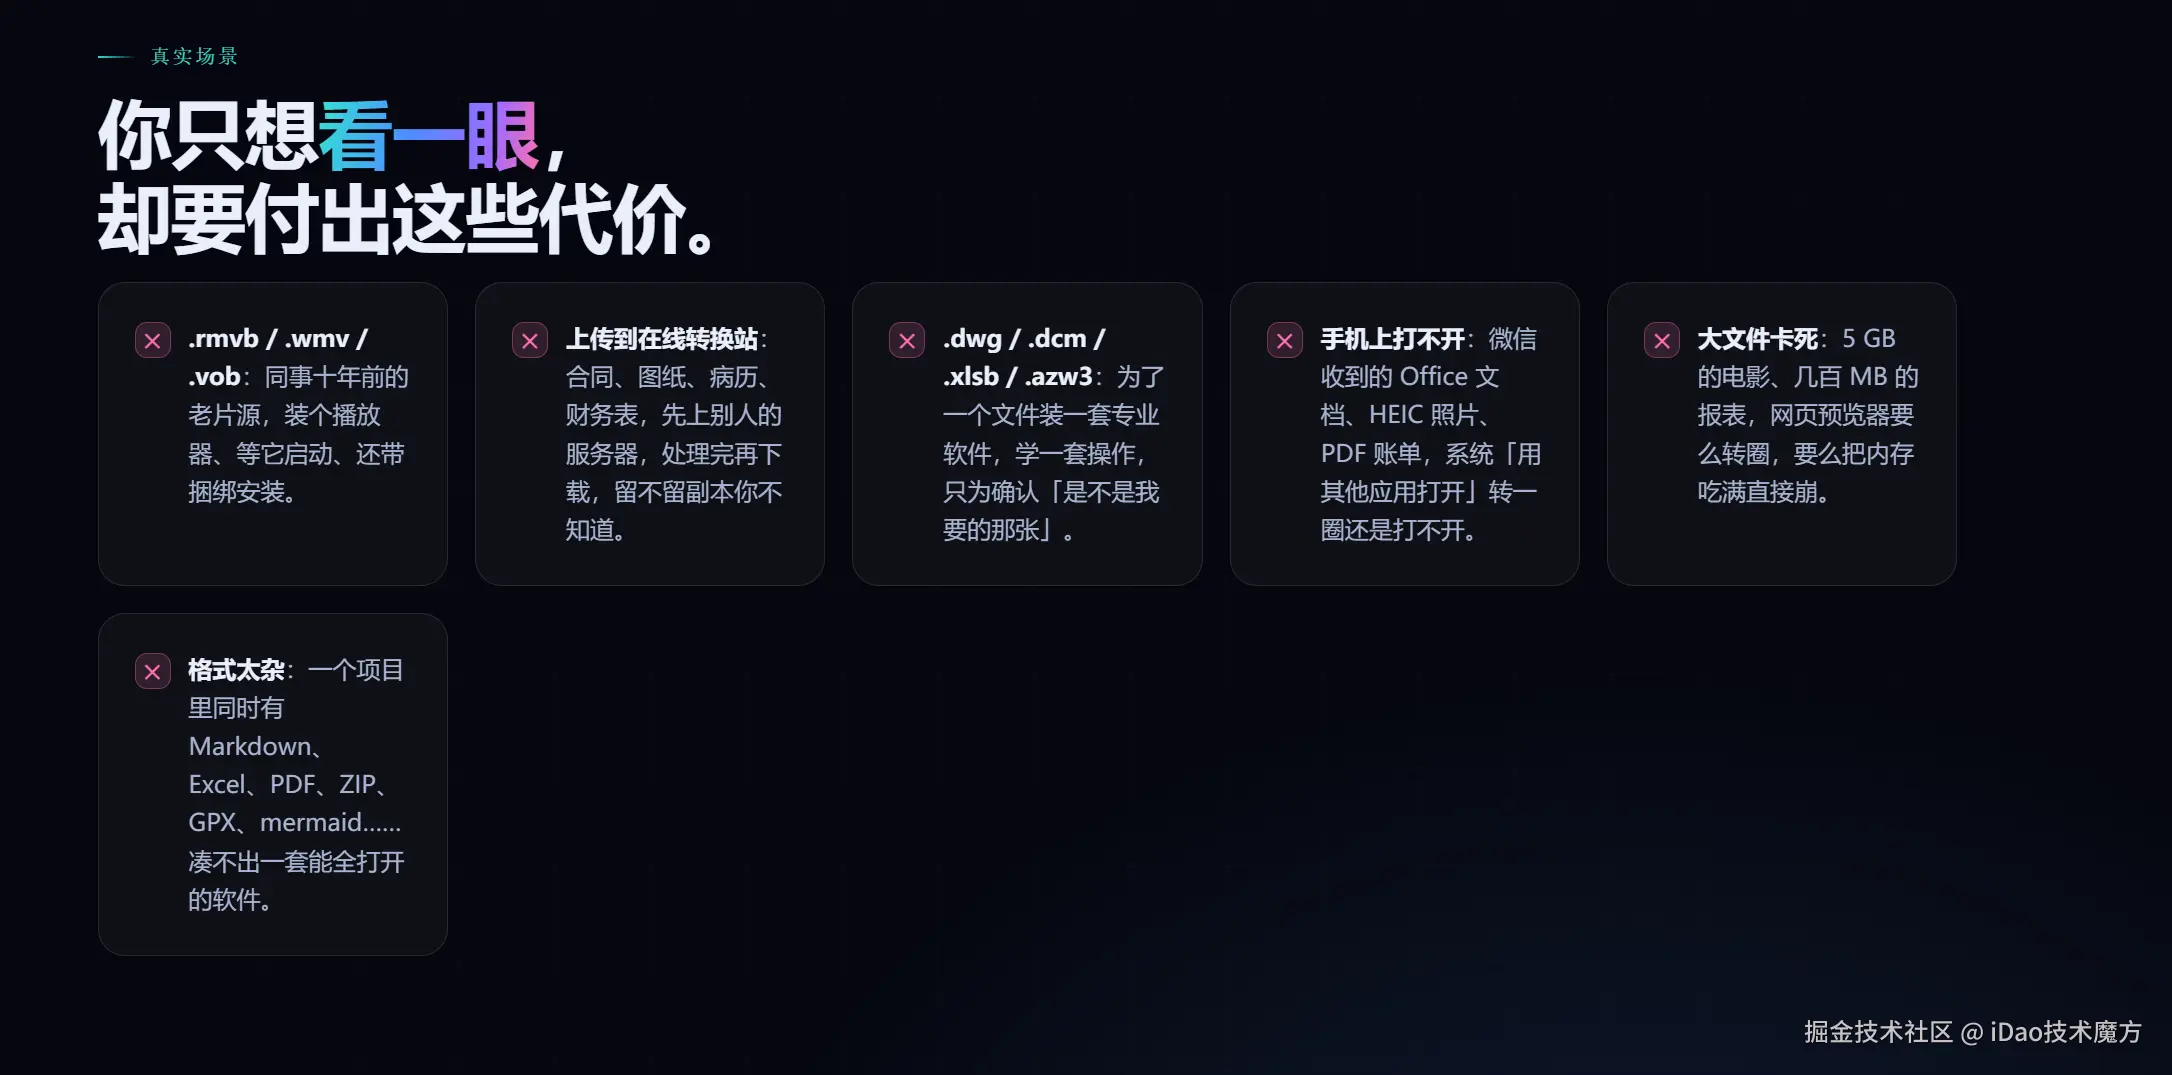
上午十点,同事在群里甩来一个 .rmvb------十年前的老片源,说「你看下这段有没有问题」。 中午,甲方发来一张 .dwg 图纸,问「这个标注对不对」。 下午,医院那边给了个 .dcm,你只想确认一下是不是我要的那张片子。 晚上,财务丢来一个 .xlsb,说「这个月的表,你看一眼」。
这四件事的共同点是:你只想看一眼。
但为了「看一眼」,通常的路径是这样的:先找个能打开的软件(RealPlayer?CAD?DICOM Viewer?Excel 能读 xlsb 吗?),装上、破解、等它启动;或者更省事------把文件传到某个在线转换站,等它转完再下载。前者是十几分钟的安装与学习成本,后者是把你手里的东西交出去。
如果是工作文件,「传到别人的服务器上」这一步基本是不能接受的:合同、图纸、病历、财务表,没有一个适合扔进一个不知道谁在运营的转换站。而且在线转换站的处理方式往往是「上传 → 服务端转码 → 下载」,你的文件在别人磁盘上停多久、留不留副本、被不被抓去训练,你都不知道。
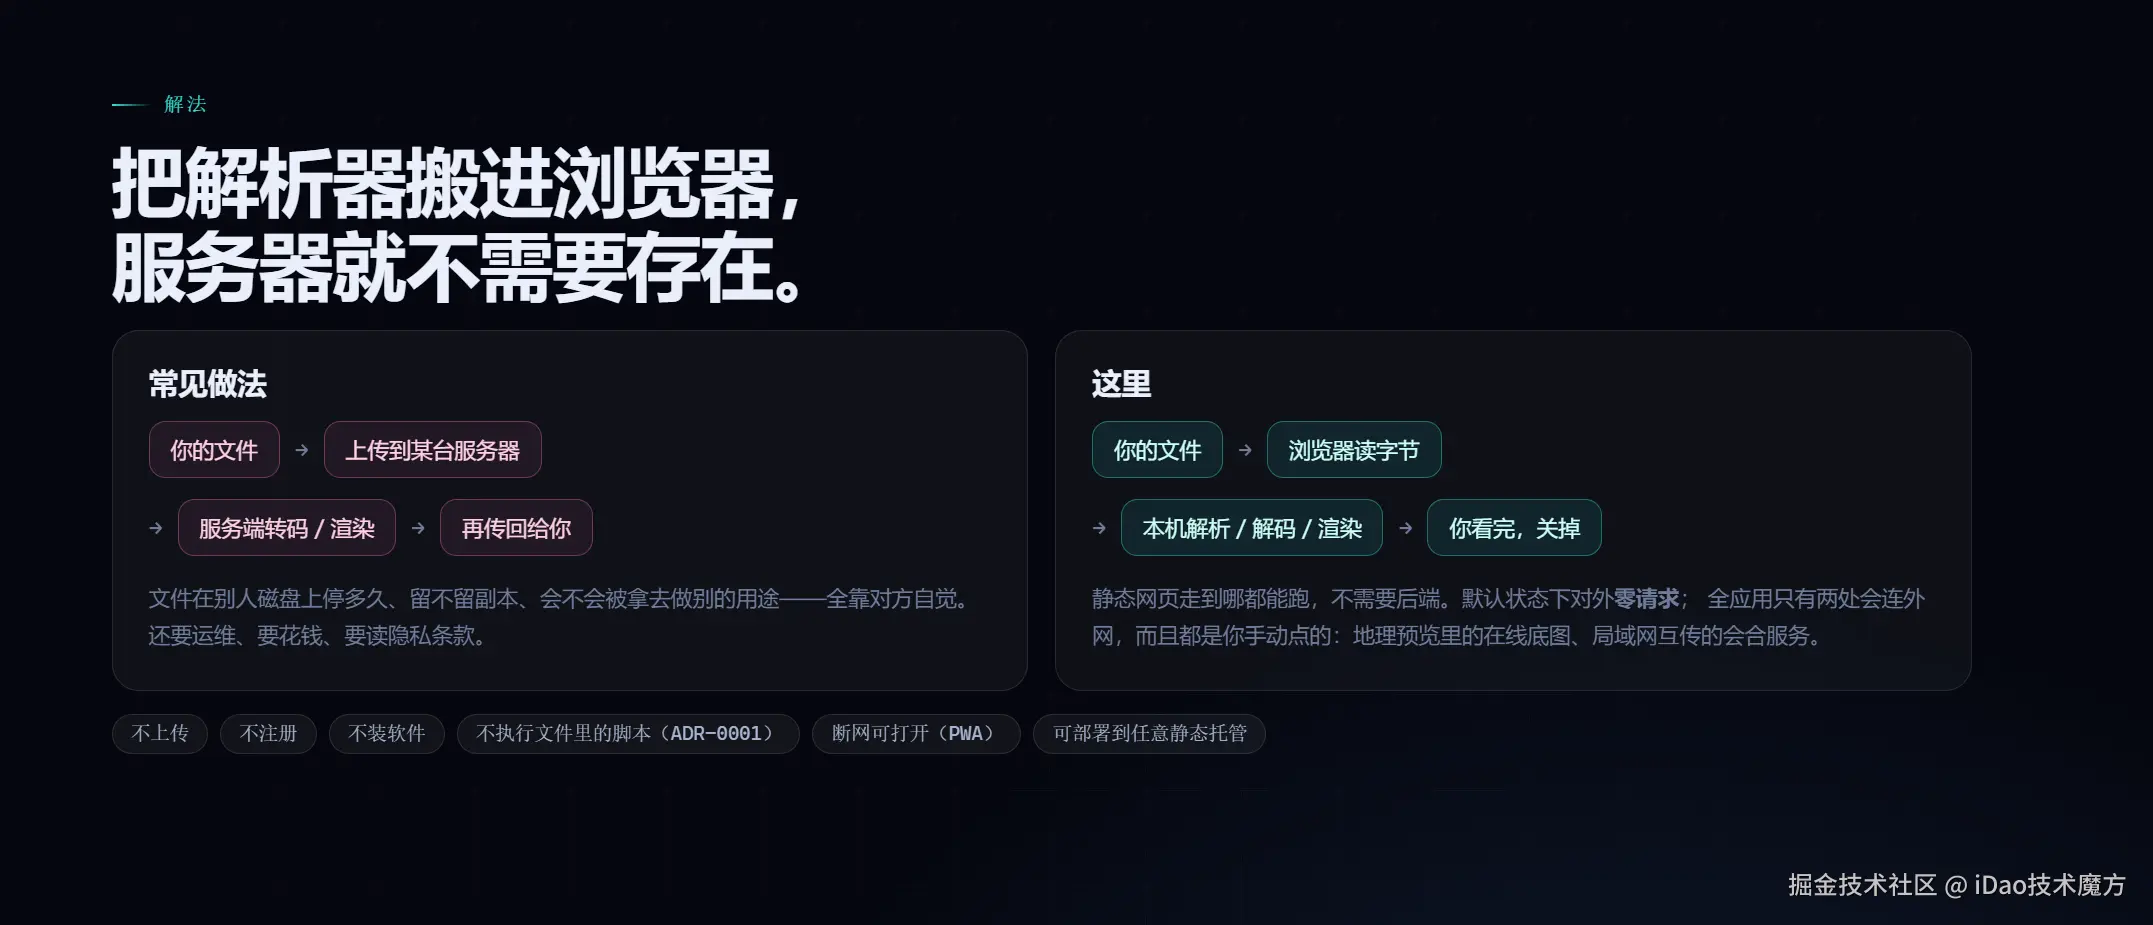
我想要的东西其实非常简单:一个网页,把文件拖进去,直接看。文件不上传,不留痕,看完关掉。
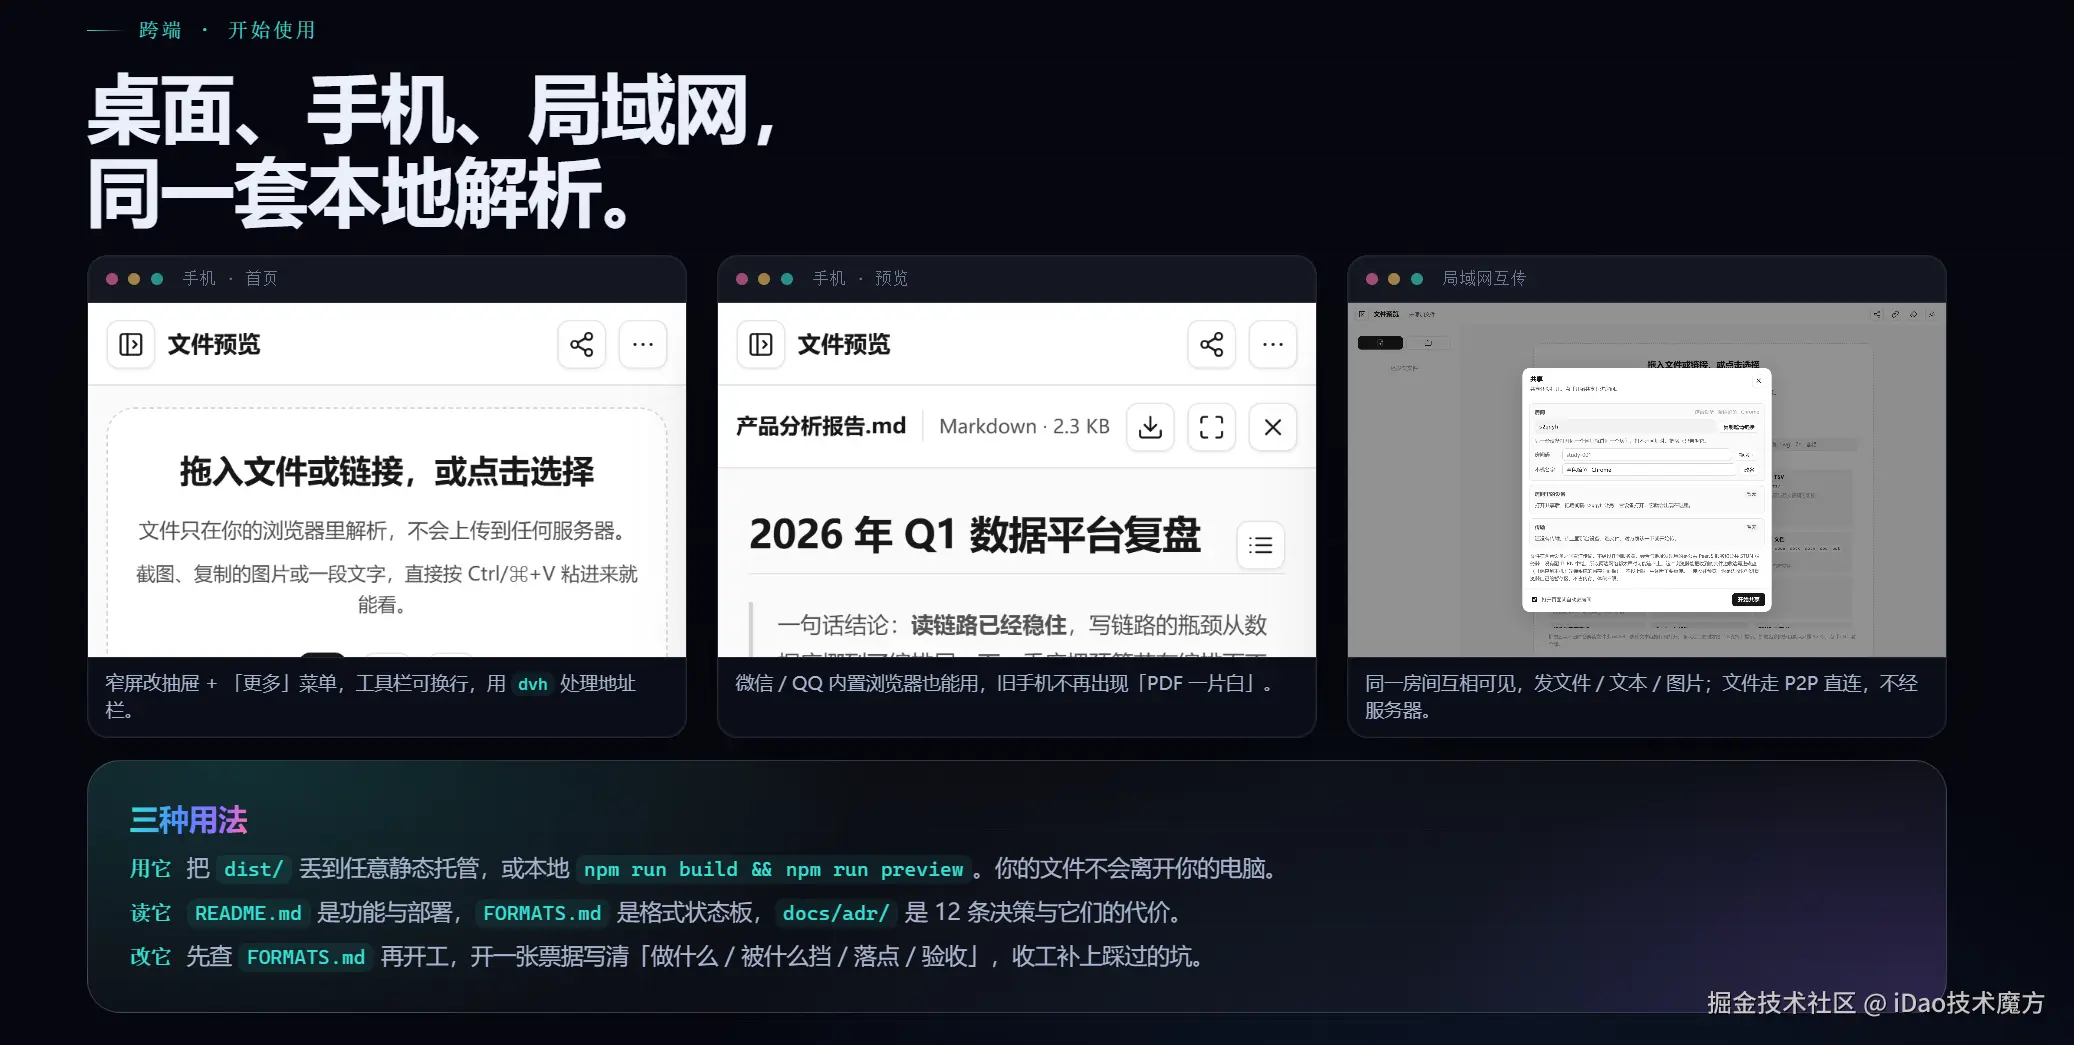
这就是这个项目的全部动机。它现在的形态是一个纯静态网页,dist/ 丢到任何静态托管上就能跑,没有后端、没有数据库、没有上传接口。
二、红线先划好:零后端
技术选型之前先把红线划清楚,因为它决定了后面所有的取舍。
- 文件不上传。所有解析都在浏览器里完成。这条不是「尽量」,是硬约束------一旦有一个「实在解不了就传上去转」的兜底,整个隐私承诺就塌了。
- 不装服务端。产物是纯静态文件,不提供任何 API,不内置任何网关。SMB / FTP 这类浏览器碰不到的协议,我们只告诉用户「请通过网关转成 http(s)」,不会自己搭一个。
- 不执行用户文件里的任何东西 。文档里的脚本、宏、SVG 里的 JS、HTML 里的
<script>,一律不跑(这条后来变成了 ADR-0001,是整个安全模型的地基)。 - 能不用后端服务就不用 。唯一一处例外是局域网互传的会合服务:WebRTC 需要一个信令通道,我们用了公共 PeerJS 云(
0.peerjs.com),代价是部分 NAT 下连不上------但文件本身走 P2P 直连,不经过任何服务器,连的只是「谁和谁在同一个房间」这点元信息。
红线划完,问题就变成了:浏览器到底能解析多少东西?
答案是:比你想象的多得多,前提是你愿意自己写。
三、649 个扩展名是怎么铺开的
先看规模。首页空状态里不再是「Markdown / 图片 / PDF...」几个标签,而是把支持的格式按类别完整列出来------8 个分组、49 个条目、645 个扩展名(样例库校验时是 649 个,因为同一个扩展名挂在多个家族里会重复计数)。
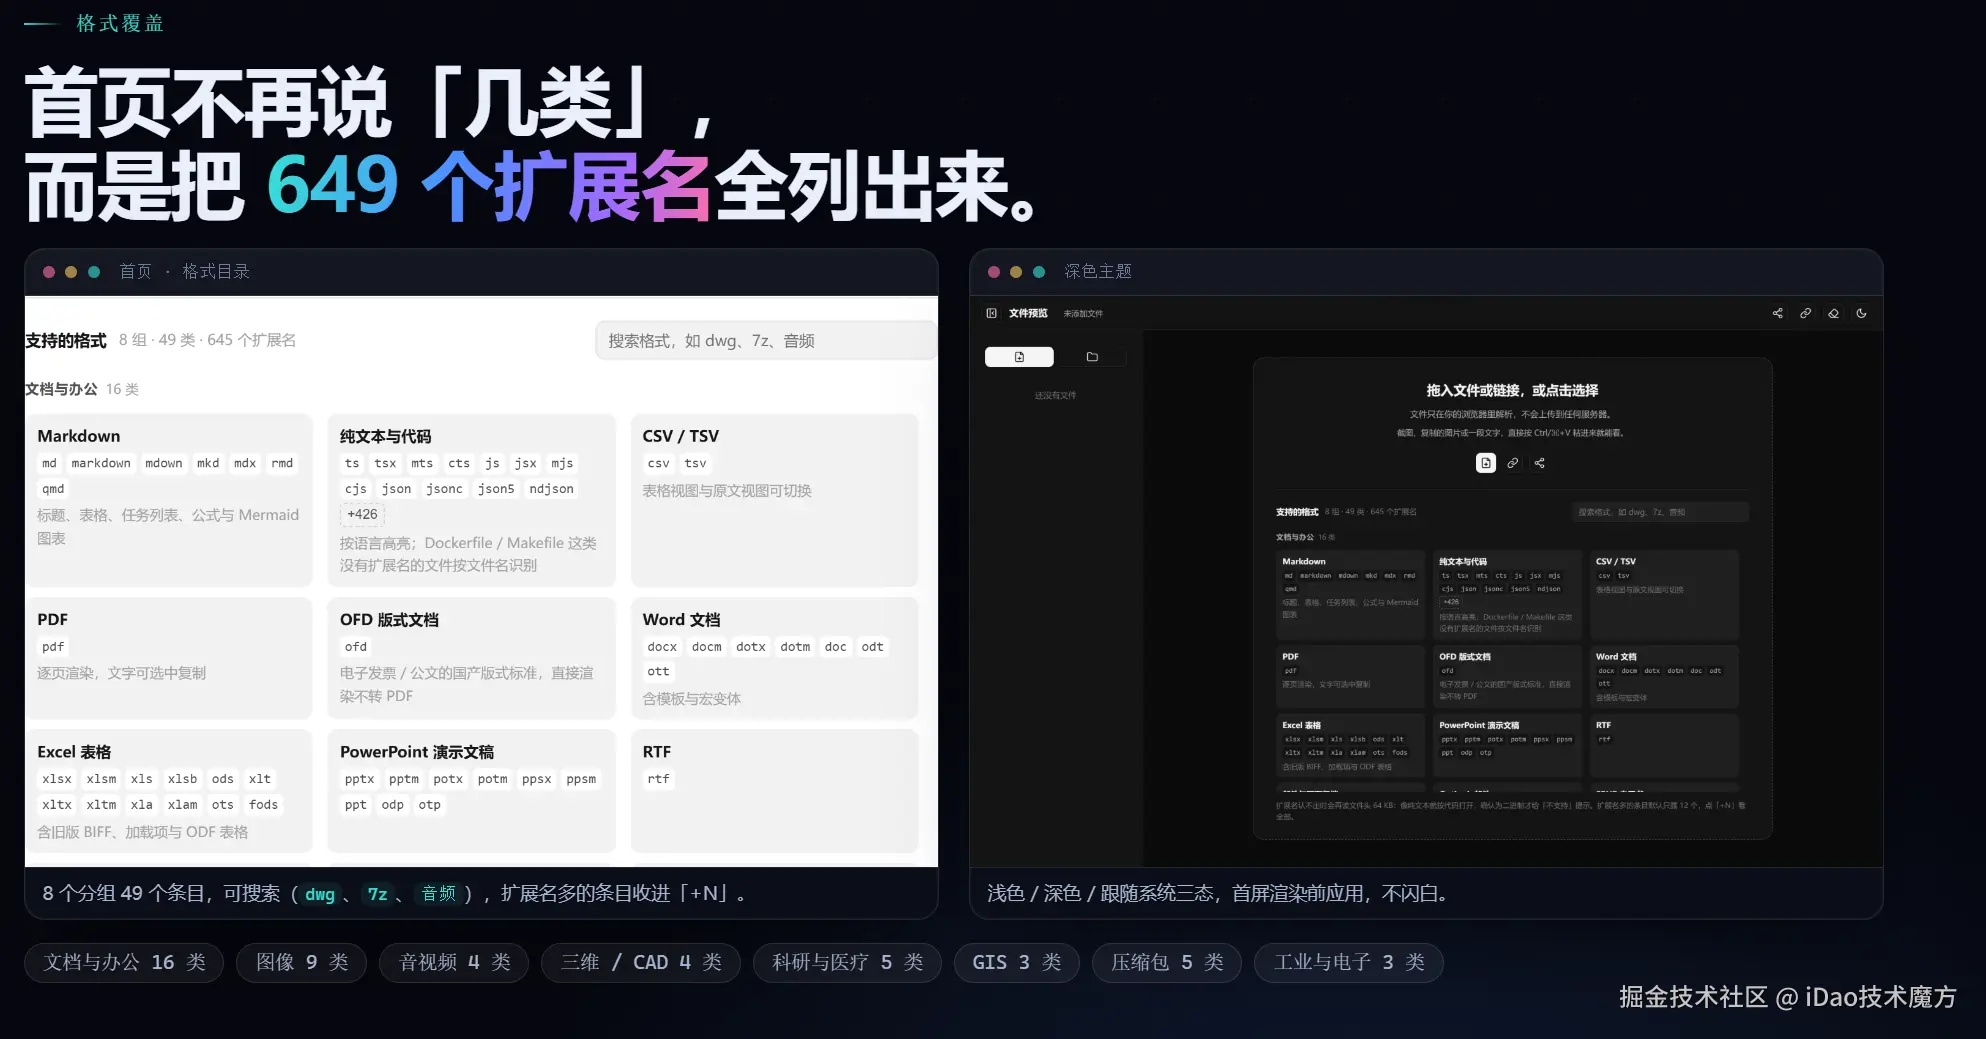
这件事能成立,靠的是一条很朴素的工程纪律:扩展名只有一个事实来源。
src/lib/fileKind.ts 里的 EXTENSION_SETS 是唯一的定义处:首页格式目录(src/lib/formatCatalog.ts)从它展开,样例库生成脚本(scripts/make-format-fixtures.mjs)从它展开,格式状态板 FORMATS.md 里的 ✅ 清单也从它展开。所以「加了扩展名却忘了加样例」「首页说支持但实际不认识」这类漂移会立刻暴露------npm run check:formats 会告诉你 649 个扩展名里缺哪几个样例,直接退出码 1,可以挂 CI。
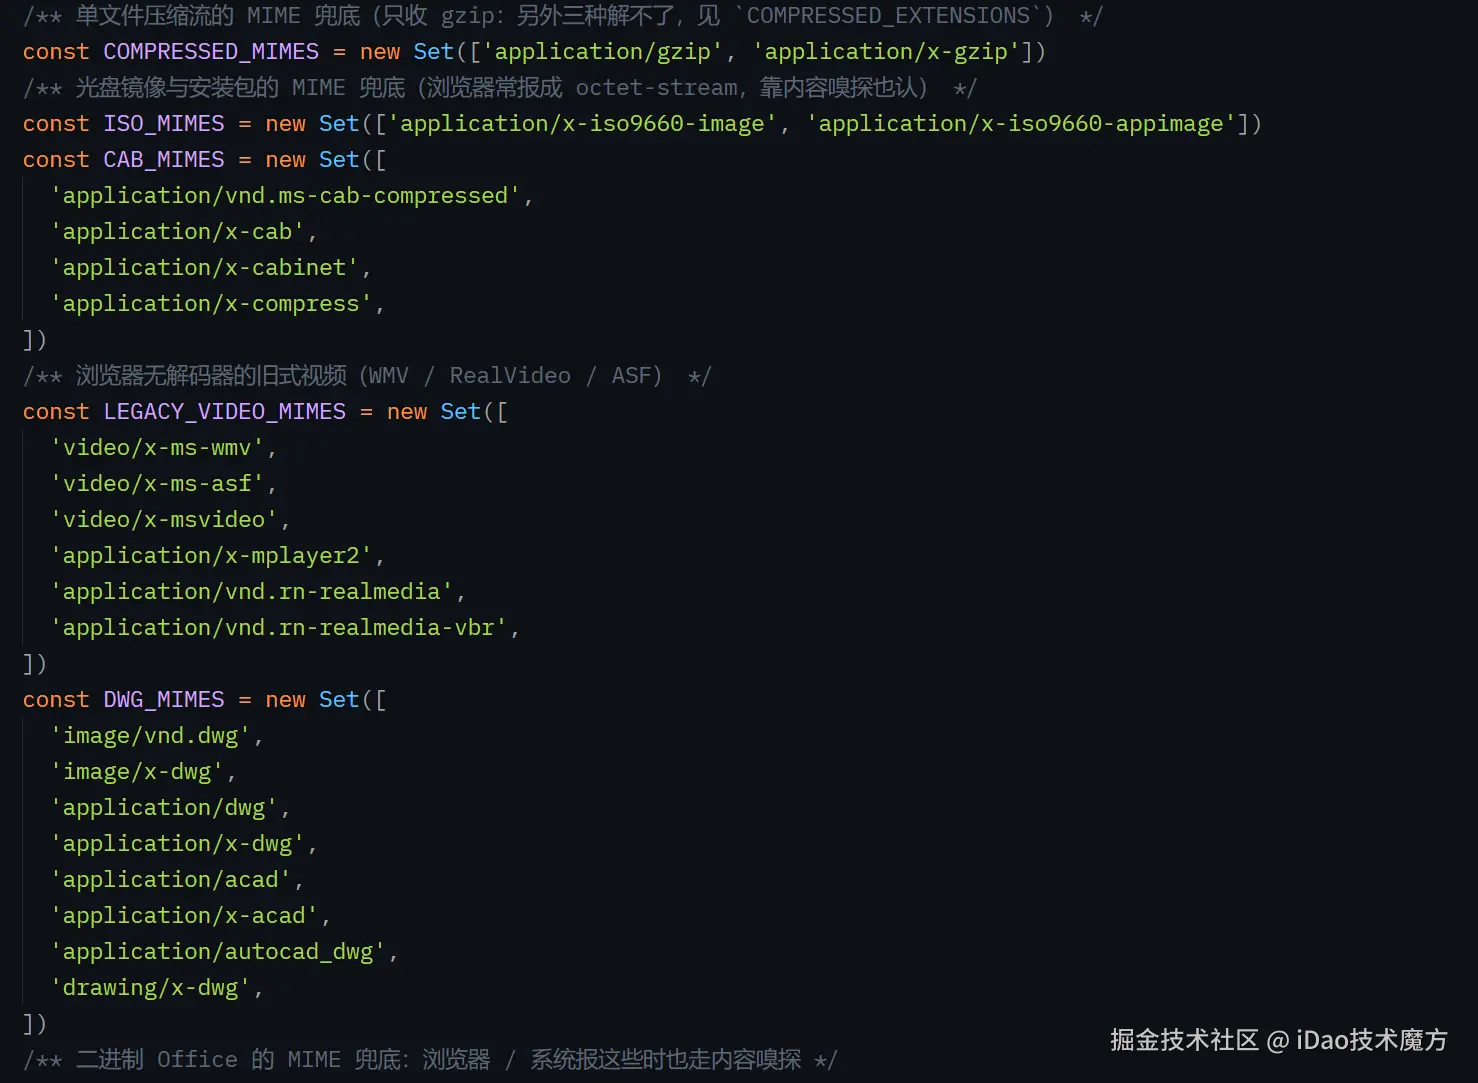
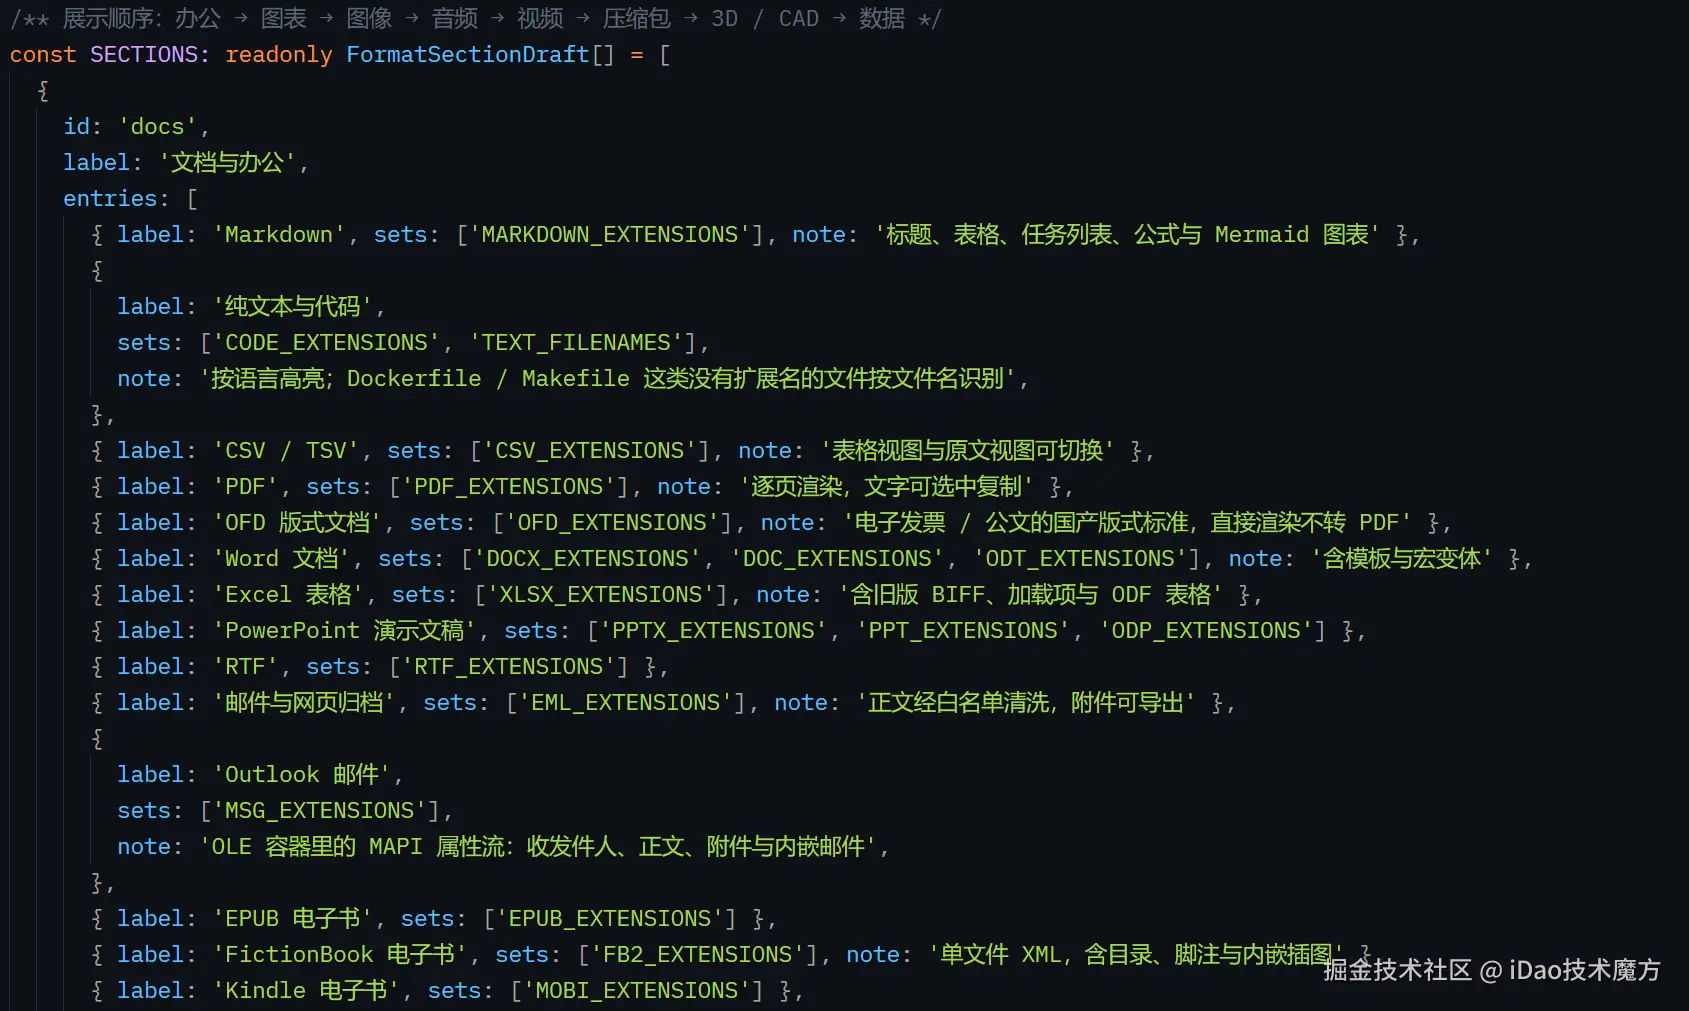 样例库本身也有意思:每个扩展名一份
sample.<ext>,生成方式分四种------手写纯文本、脚本里现造二进制(PNG / GIF / ICO / GLB / MIDI / OLE 复合文档头 / ZIP 容器)、调本机 ffmpeg 生成图片与音视频、以及从 e2e/samples/ 里拷贝真实文档。「有真实文件」和「能过测试」是同一件事,这是格式类项目最容易被拖垮的地方,所以一开始就上了机器校验。
格式覆盖大致分这么几层,越往下越费劲:
- 浏览器原生就行的:常见图片、常见音视频、纯文本。这层几乎是白送的。
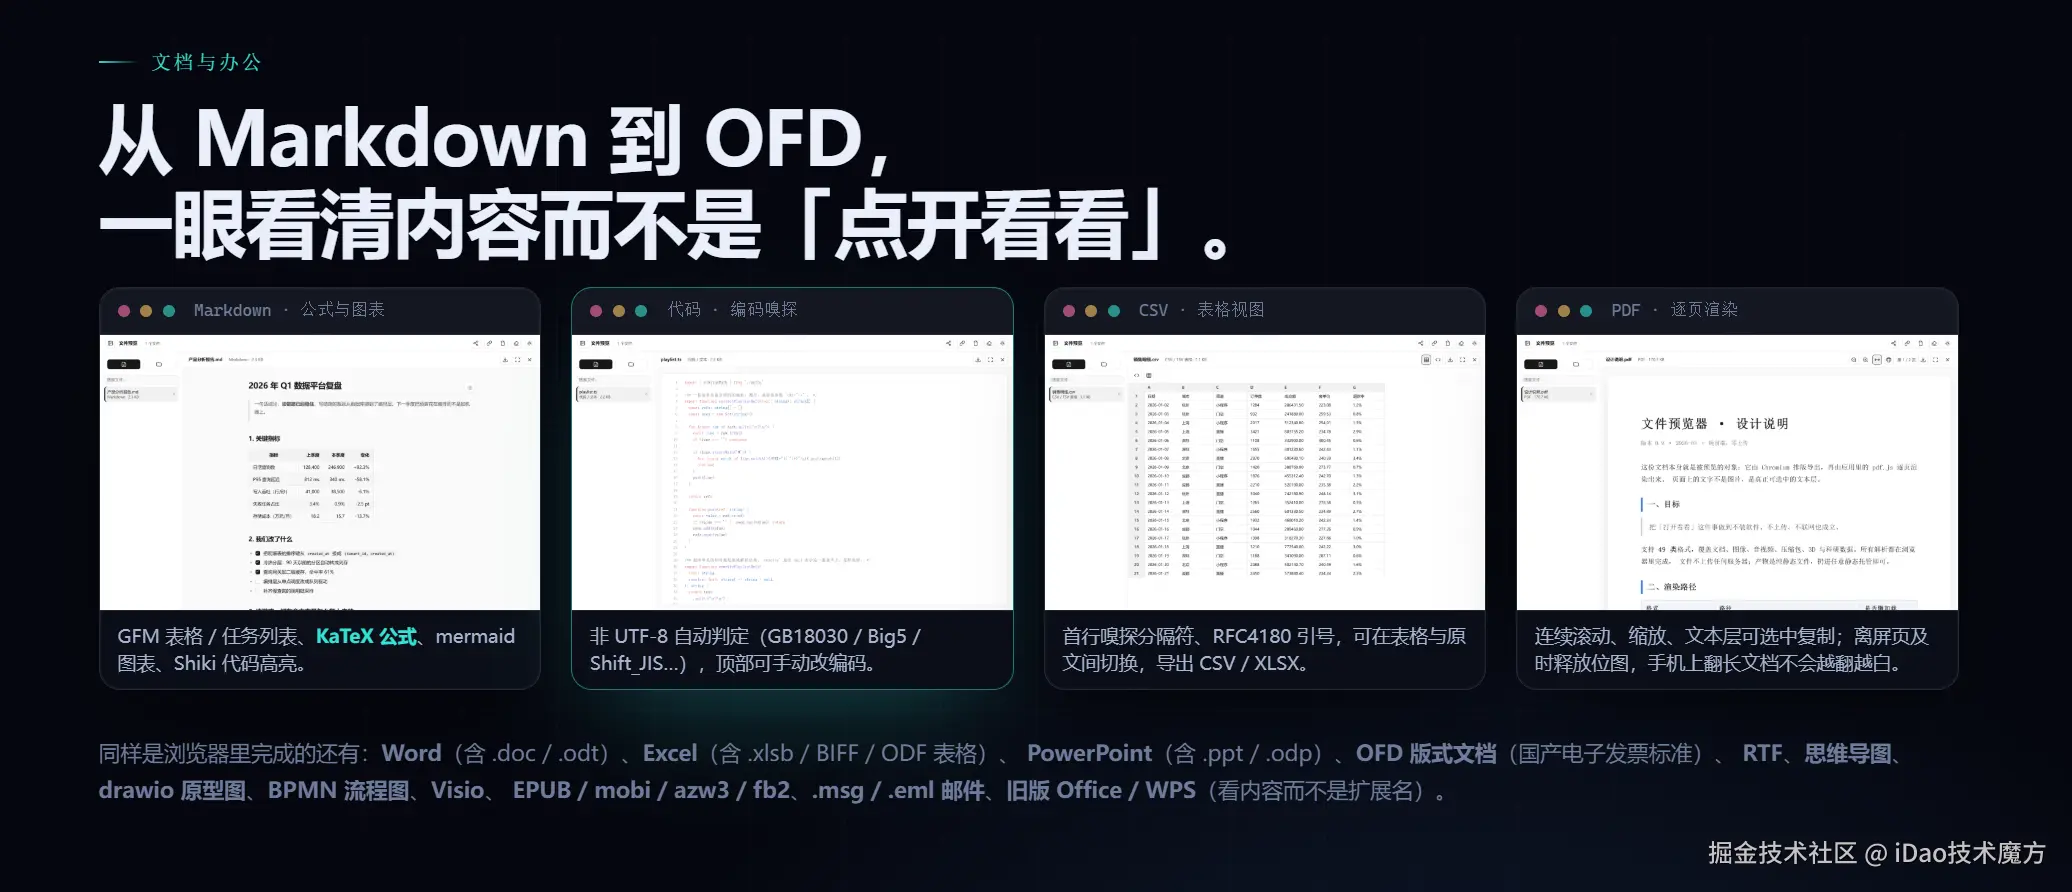
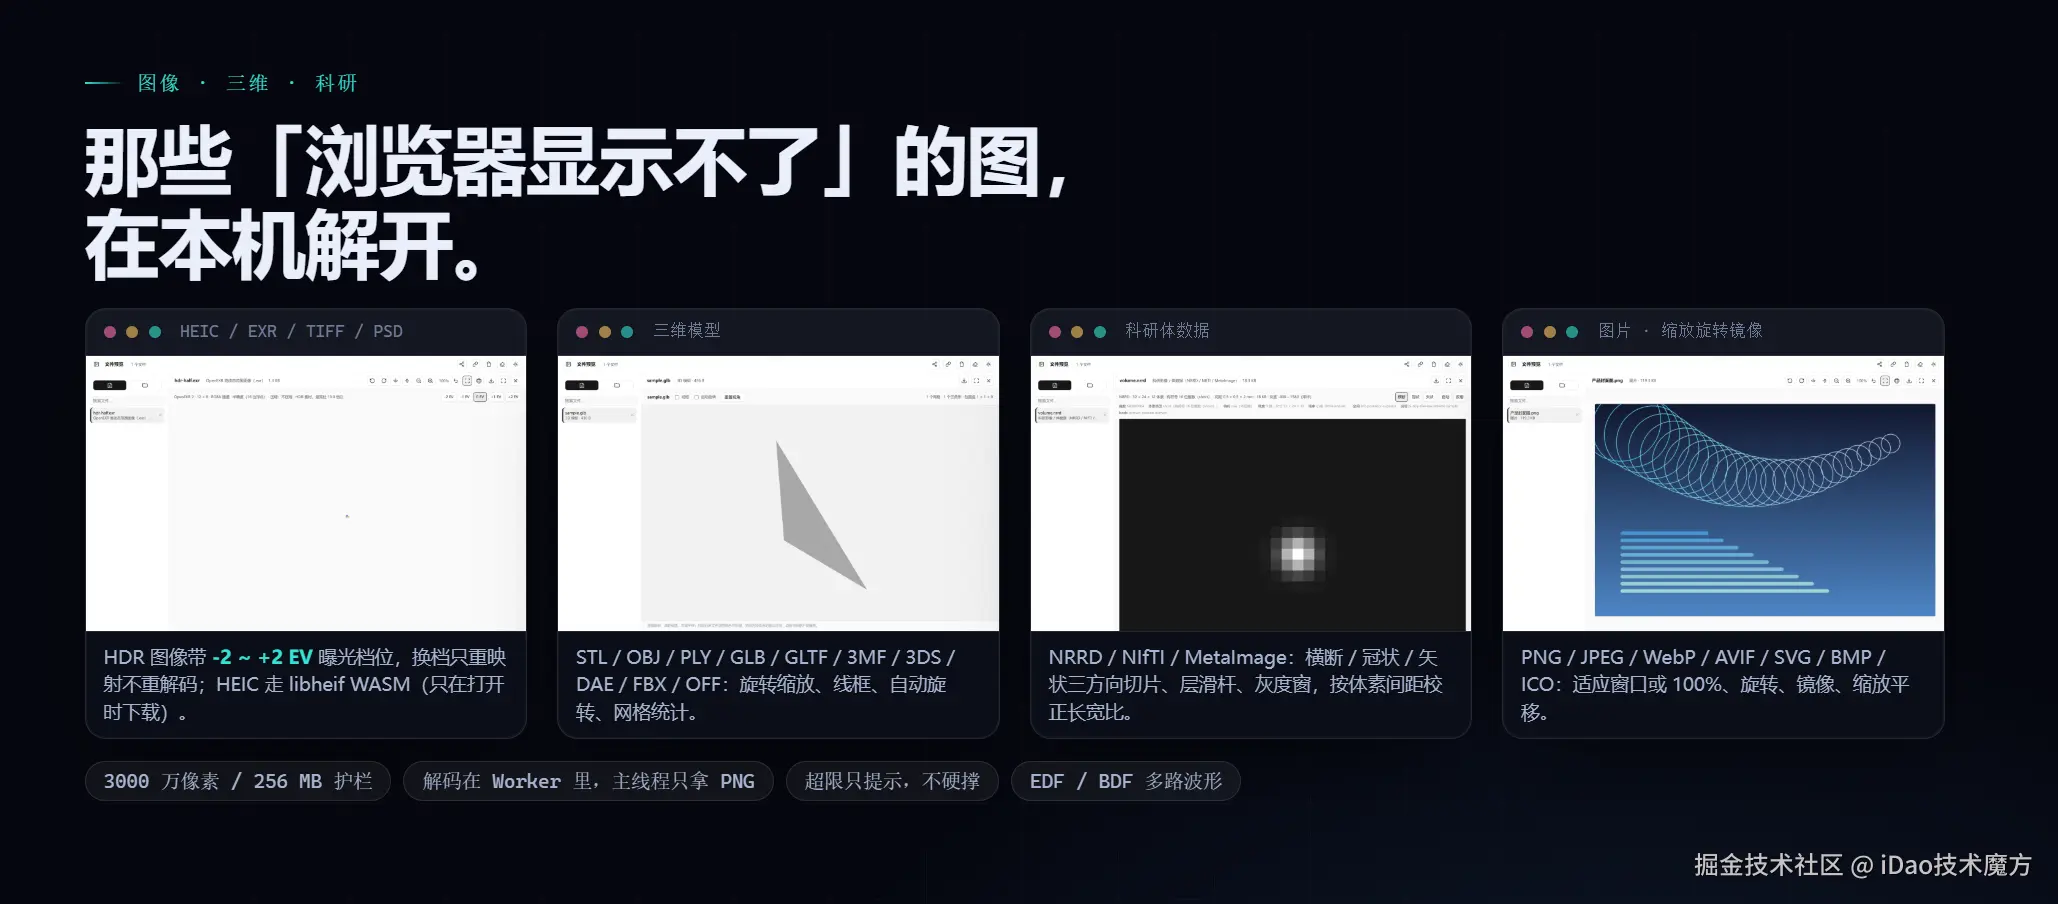
- 有成熟库的:PDF(pdf.js)、docx(docx-preview)、xlsx(SheetJS)、EPUB、字体、3D(three.js + 各种 Loader)、DICOM(dicom-parser)、PSD(ag-psd)、DXF、mermaid......
- 要自己写解析器的 :Outlook 的
.msg(OLE / CFB 容器 + MAPI 属性流)、BPMN、drawio(含 deflate + base64 的图)、Visio、mobi / azw3(PalmDB + MOBI 头)、Shapefile(二进制几何 +.dbf属性表)、WKT / KML / GPX、EDF 生理信号、NRRD / NIfTI / MetaImage 体数据、OpenEXR 的色调映射...... - 要 WASM 的 :OFD(国产版式文档)、
.dwg(libdxfrw)、RAR / 7z / ISO / CAB(libarchive)、HEIC(libheif)、旧式 Office(x2t 转换内核)、旧式媒体(VLC / ffmpeg)。
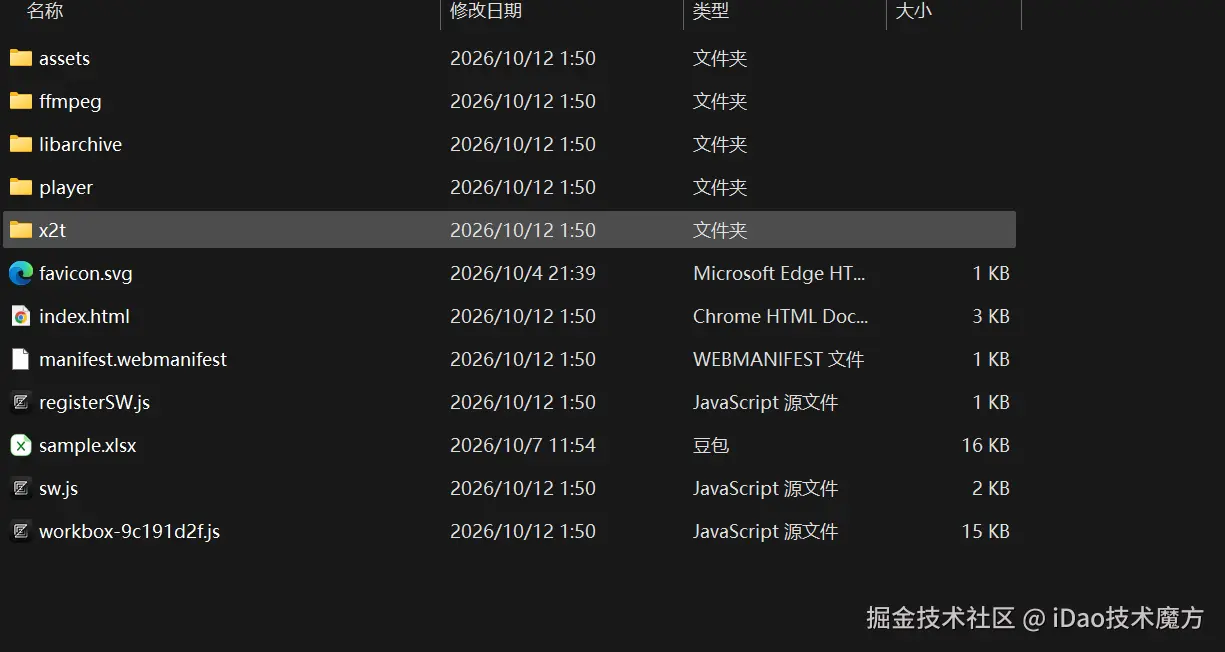
- 明确不做的 :
.wmf/.emf(无纯前端解析器,渲染器体量远超收益)、加密归档、带 DRM 的电子书。不做就明说------选中给「暂不支持」的卡片和原因,而不是空白或转圈。
这些取舍逐条记在 12 条 ADR 里(docs/adr/),包括为什么 OFD 的渲染器要拆包引源码、为什么 mermaid 要放进沙箱 iframe、为什么 PWA 只预缓存应用壳。每一条决策都写了「为什么不是另一种做法」,因为半年后最容易忘的就是这个。
四、三个真正的硬骨头
格式数量是体力活,下面这三块是真需要动脑子的。
4.1 旧式媒体:为什么不能「转封装」了事
先分清两件事:
- FLV / MPEG-TS :容器很冷门,但里面的编码通常是 H.264 / AAC------浏览器认。所以只要把容器壳换掉(transmux 成 fMP4)喂给 MSE,就能播,不用重新编码 ,解码走硬件,CPU 占用低。这是
mpegts.js干的活。 .rm/.rmvb/.wmv/.asf/.vob:容器后面的编码本身就陌生------RealVideo、VC-1 / WMV、MPEG-2。浏览器里没有这些解码器,转封装也救不了,必须真的把画面解出来再编一遍。
第二种情况只有两条路:
路一:直接用浏览器播放。 单开一个 /player/ 窗口,里面是 VLC 4 的 wasm 构建(libvlc-wasm,自带解码器,引擎 25.9 MB,只在要用它时才下载)。本地文件交接过去,边下边播、能拖进度、不转码。
这条路看起来简单,其实是整个项目最拧巴的一段,因为 libvlc-wasm 要 SharedArrayBuffer,而 SharedArrayBuffer 要求文档处于跨源隔离 (cross-origin isolation)状态------也就是要 Cross-Origin-Opener-Policy: same-origin + Cross-Origin-Embedder-Policy: require-corp 两条响应头。三条硬约束随之而来(ADR-0010):
- 隔离只能在顶层文档生效 。同源 iframe 的
crossOriginIsolated跟着父文档走,所以「在内容区里嵌一个 iframe 偷偷隔离」是不成立的,必须弹窗。 - 主应用不能带这两条头 。主应用要加载远程图片 / 音视频(走
no-cors),一旦整站带上COEP: require-corp,这些请求在 Safari 上会直接失败。所以隔离头只属于/player/这棵子树。 - 弹窗带了 COOP 之后
window.opener === null,父窗口和它彻底断开,只能用BroadcastChannel交接:开窗 → 等hello→ 等ready→ 发open+File对象 → 收state确认在播。
配不了响应头的托管方(比如 GitHub Pages)怎么办?页面里带了一个 coi-serviceworker.js,它在 /player/ 这个 scope 里注册一个 Service Worker,自己给自己补上这两条头,代价是首次打开会自动刷一次;15 秒内隔离没建立起来就报错,退回转码路线,不会一直等。
还有一个真实的 bug 值得记一笔 :这个交接在 React 的 StrictMode 下会挂------开发模式下组件挂载两次,第一次卸载时的 cleanup 把交接 abort() 掉了,用户看到的是弹窗停在「等主应用把文件送进来...」,一个没人接的孤儿窗口。修法很土但很对:把 cleanup 里的 abort 推迟到下一个宏任务(setTimeout(..., 0)),让第二次挂载有机会接管;配套给播放器页加了 20 秒看门狗,真的没人来时直接告诉用户「把文件拖进来也能播」,而不是干等。这类坑不写下来,下次重构一定会再踩一遍。
路二:在浏览器里转码。 内容区右侧工具条上有个按钮,点了之后 ffmpeg.wasm(单线程内核,30.7 MB,GPL-2.0-or-later)在 Web Worker 里把整段解码再编成 H.264 / AAC 的 MP4,转完直接交给 <video>,产物可下载。三点代价如实写在界面上:首次要下 30.7 MB 内核、速度通常慢于实时、超过 300 MB 直接拦下并给出本机 ffmpeg 命令。
这里有个判断标准值得一提:转码成败只看退出码与产物是否完整,不看日志文本。 老片源常有损坏,ffmpeg 会打出字面带 error 的 warning(比如 rv40 的 concealing ... errors in B frame),但那不算失败;只要转出的 MP4 完整就照样播,并在界面上注明「源文件有损坏,后面可能不完整」。按日志文本判错的做法会让一堆本来能看的片子被误判。
顺带说:.wma / .ape / .alac / .amr / .ac3 / .dts 这些旧式音频和旧式视频同形,所以是同两条路------VLC 内核认得纯音频(页面把引擎收成 1px,换上一套暂停 / 进度 / 时间面板),或者整段转成 AAC 的 M4A。
4.2 流媒体:本地 .m3u8 为什么不能直接丢给 <video>
远程 HLS 交给 hls.js 就行,麻烦在本地文件。你从别处下载了一部剧,index.m3u8 加一堆 segment-000.ts,一起拖进来------<video src="index.m3u8"> 能播吗?
在 Chrome / Firefox 上不能。 只有 Safari 原生认 HLS;hls.js 走的是 XHR 取分片,而相对路径的本地文件根本没法通过 XHR 拿到(file: 协议被挡,只有 blob: / data: 可用)。
所以做法是:先在「同一批拖进来的文件」里按相对路径把分片找齐 (拖文件夹、或者清单和分片一起多选),把它们重写成一份新的、分片地址指向 blob URL 的清单,再把这份清单交给 hls.js。找不齐就不播,退回地址清单,并点名缺哪几个 ------「找不到它指向的 2 个地址(segment-7.ts、segment-8.ts),把整个文件夹拖进来、或把分片和清单一起选中,就能直接播放」。比沉默地转圈有用得多。寻址规则也照 HTTP 的来:剥掉 ?query / #frag、decodeURIComponent、处理 ./ 与 ../、跳出根目录就算找不到;master playlist 会递归解一层 variant。
这里踩了一个 React 的坑,值得单说。找出同批文件的那份列表来自 App:
tsx
siblings={files.filter((file) => file.id !== selected.id)}每次 App 重渲染,这都是一个新数组 。如果解析逻辑把它当依赖,那么 onLoaded → reportMetadata → App 重渲染 就会重跑解析、revoke 掉旧的 blob URL,结果是视频从头开始播 。修法是用内容指纹当依赖(每个同伴的 path + size 拼成一个字符串),再用 ref 取当前列表------既不会因为新数组实例而重解析,也不会因为用了旧闭包而找不到文件。
其他几个细节也都是被真实文件逼出来的:
.ts和 TypeScript 源码撞名 :靠 188 字节(M2TS 是 192)包里第一个字节是不是0x47同步字节来区分。- 直播判定 :本地文件永远按点播处理;地址是
ws(s)://(FLV over WebSocket 推流)或 HEAD 拿不到Content-Length就按直播处理。直播模式不做整段缓冲、不支持拖动,工具条多一条延迟 / 缓冲 / 已播时长的状态条,外加一个「低延迟」开关(mpegts.js落后超过 1.5 秒就跳到边沿前 0.5 秒,代价是画面跳帧;hls.js则改成允许 1.5 倍速悄悄追上,不跳画面)和「跳到直播边沿」。
4.3 大文件:5.5 GB 的电影能拖进来吗
能。但「能」的理由可能和你想的不一样------不是因为我们做了分片流式播放,而是因为浏览器本来就够用。
我们做了实测(不是估算):用 ffmpeg -stream_loop 60 -i src30.mp4 -c copy -movflags +faststart 拼了一个 5.5 GB / 1830 秒 / 1080p 的非分片 MP4(moov 在前、真字节),拖进应用:
- 340 ms 出画面,
duration正确读到 1830; - 拖到第 1827 秒只用 29 ms ,而且解出满帧(2073600 / 2073600 个高亮像素),
readyState4; - JS 堆从 10.8 MB 涨到 11 MB------几乎没动;渲染进程 RSS 从 48 MB 涨到 300 MB(解码 + 预读,这是浏览器的正常开销)。
12 GiB 的稀疏文件同样正常。原因很朴素:应用对本地文件用的是 URL.createObjectURL(file),blob URL 走的是 range 读盘------浏览器按需从磁盘取字节,不会把 5.5 GB 读进内存。我们唯一做的「优化」是嗅探格式时只读文件头:
ts
const head = new Uint8Array(await file.slice(0, SNIFF_BYTES).arrayBuffer())顺带发现了一个反直觉的反例:把同一部片子用「在 moov 与媒体数据之间垫盒子」的方式挪到 2 GiB,2 GiB 就放不出来了 (卡片报「网络请求失败」,<video> 直接被卸载)。原因不是体积,而是挪位破坏了分片 MP4 里 trun / tfhd 的 data-offset(相对 moof 起点的偏移)与 mfra 里的绝对偏移。文件结构比文件大小更容易让播放器翻车。
有一条改动的起因就不是「能不能放」,而是「别把自己拖死」:持久化层原本会把本地文件内容(Blob)一起写进 IndexedDB,上限 500 MB 按 LRU 淘汰。把一个 5.5 GB 的文件丢进去会怎样?我们给 IDBObjectStore.put 打了桩,结果是:put 调用进去了、90 秒都不回调也不报错 (Chromium 真在拷数据),就算写完了也会被容量检查当作「单条超预算」删掉------白拷一份 GB 级数据,还把整个 store 的事务堵在那里 。修法是写库前先算内容体积,超过容量直接跳过;put / 淘汰逻辑都包 try/catch 静默失败。
这条经验后来直接喂给了局域网互传的接收侧:「接收并预览」不再把字节攒在内存里,而是在安全上下文(https / localhost)里边收边写进浏览器自己的暂存区 OPFS:
js
const stored = await handle.getFile()                 // 磁盘背书的 File
const file = new File([stored], name, { type: mime }) // Chromium 零复制,1 ms、堆不动
实测 512 MB 流式写 OPFS 用 1317 ms(约 390 MB/s),整个过程的 JS 堆稳定在 10 MB;收完把那个 File 交给预览器即可,体积不限。拿不到 OPFS 的环境(局域网 http、老浏览器)自动退回内存模式,上限照旧并在接收卡上直说。代价是配额:localhost 源实测只有约 6.5 GB,真写不下会报「临时空间不够」。
五、一次「先不做」的反向调研:WebTorrent 边下边播
需求侧很自然的一个念想是:能不能直接贴 magnet 链接边下边播?我们花了一轮做了可行性探针,然后决定先不做------过程比结论更有价值。
探针做的事很朴素:在 Chromium 里裸实现 WebSocket tracker announce(20 字节二进制 info_hash、peer_id),拿到 peer 后开 5 个 RTCPeerConnection + DataChannel,看有多少 peer 真的能连上。结果是:
| 种子 | tracker 返回 | 我们实际拿到 |
|---|---|---|
| sintel(webtorrent 生态自己的片子) | complete 21 / incomplete 18 | answer 4,DataChannel open 2 |
| bunny(公共种子) | 44 个 peer | answer 0 |
| ubuntu 镜像 | incomplete 1 | 0 |
链路是通的(能发现 peer 并连上,靠 STUN 打洞成功),瓶颈在 swarm 的构成:公网种子上的 peer 绝大多数是 TCP / uTP 客户端,只有 WebRTC peer 才可能被浏览器连上。也就是说,除了 webtorrent 圈子里那几部演示片,普通种子在浏览器里大概率是「找得到人、连不上」。
真要做得再加两条工程:Service Worker 提供 Range 请求(否则 <video> 无法 seek),IndexedDB 存块 + 清理策略。收益不明确、成本不小,所以记在票据里,先不做。「调研后不做」也是一条要写下来的结论,否则半年后有人再问一遍,又要花一轮。
六、工程纪律:门禁与文档
一个单人主导、格式又多又杂的项目,最怕的不是写不出来,而是改坏了自己不知道。所以这个仓库的门禁比代码本身更值得说:
- 类型 :
tsc --noEmit必须干净。 - 单元 / 组件测试:107 个文件、1028 条通过(vitest + @testing-library)。
- 端到端:Playwright 真实浏览器 159 条通过(其中 3 条是这个环境里既有的、与功能无关的失败,基线里就记着)。
- 体积预算 :
node scripts/check-budget.mjs卡首屏 JS 上限 150 KB------目前 120.3 KB (gzip)。这条能成立是因为所有重解析库都拆成独立 chunk、只在真正预览对应格式时才import():mermaid、pdf.js、three.js、ffmpeg.wasm、libvlc-wasm 等等,一个都不进首屏。 - 格式覆盖 :
npm run check:formats校验 649 个扩展名每个都有样例。 - 文档 :12 条 ADR + 一份格式状态板
FORMATS.md(✅ / 🚧 / ⬜ / ⛔ 四态,每行都写落点与「还差什么」)+ 一份进度文件,开工先读、收工更新。每个任务先开一张票据(写清「要做什么 / 被什么挡住 / 背景与决策 / 落点 / 验收」),做完补「Comments」记下踩过的坑。
这套东西听着繁琐,但它带来的好处很直接:改动格式支持后,FORMATS.md、首页格式目录、样例库、e2e 四处的漂移会被机器抓住,而不是等用户来报。
也顺便记几个具体的坑,它们都是门禁帮忙暴露的:
- PDF 预览整块坏掉,可能只是少传了一个文件。 渲染 worker 原本是单独的
assets/pdf.worker.min-*.mjs:托管方漏传它、或者把它当成未知类型返回(MIME 不是 JavaScript,模块脚本会被浏览器拒收),PDF 就报Setting up fake worker failed,而其它格式毫发无伤。现在 worker 源码直接内联进 JS、运行时用 blob URL 起一个模块 worker,不再有单独的.mjs请求。 - 旧手机上 PDF 一片白 :pdf.js 6 直接调用
Promise.withResolvers()(Chrome 119 / Safari 17.4 起才有),比它自带 legacy 构建里垫的还新。入口处自己垫了一层(src/lib/compat.ts,只在缺失时安装);真缺 API 时预览会说「浏览器版本太旧」并给出原始报错,而不是含糊地说「网络请求失败」------错误分类本身是功能。 - 交互动词的层级 :
清除应用数据这种不可撤销的动作必须有确认弹窗,把要清的东西逐条列出来(Service Worker 注册含/player/那层隔离垫片、Cache Storage 离线资源、localStorage设置、OPFS 暂存区、IndexedDB 预览项),清完自动重新加载------因为注销 Service Worker 只是「不再接管新请求」,当前这次加载仍然被它控制着。 - CSS 的一个小陷阱 :手机端「更多」菜单被侧栏抽屉盖住,调菜单自己的
z-index没用------因为顶栏带了backdrop-filter,它自己形成了一个层叠上下文 ,菜单里写的z-index: 20只是那个上下文内部的序号。修法是把整个顶栏抬到抽屉之上。
七、现在它是什么样
- 拖进来、粘贴链接、
Ctrl+V截图 / 一段文字、URL 参数深链接都能进列表;侧栏是目录树,支持搜索与←/→切换;桌面与移动端各自适配。 - 12 类场景的一手体验:Markdown 带公式与 mermaid、代码高亮与编码嗅探、CSV / Excel / dBase 表格视图、PDF 逐页渲染与文字可选、图片旋转镜像缩放、HEIC / EXR 高动态范围、PSD 图层、字体、3D 模型、体数据三视图、DICOM 影像与标注叠加、Shapefile / KML / GPX 地图(可选在线底图,默认不联网)、压缩包「文件树 + 就地预览」、邮件、电子书、思维导图、drawio、BPMN、CAD、Office 全系(含 WPS / 旧版 OLE 文档)、流媒体与直播、旧式音视频。
- 可安装(PWA)、断网可打开(只预缓存应用壳)、主题三态、可撤销操作、全屏、无障碍(skip link、焦点环、
aria-live、prefers-reduced-motion降级)。 - 局域网互传:同一房间的设备互相看得见,发文件 / 文本 / 图片,对方点一次确认就收到;文件走 WebRTC 直连,接收侧「接收并预览」边收边写 OPFS、体积不限,「保存到本机」边收边写盘。
八、不做什么
明确不做的,都写在文档里,而不是留个空白:
.wmf/.emf图元(无纯前端解析器);- 加密归档的口令输入(只说明「已加密」);
- DRM 电子书的内容(只给元数据与封面);
.tar.zst(libarchive 的 WASM 构建只把 zstd 读滤镜实现成调外部zstd -d,浏览器里起不了进程)------给一张说清原因和本机解法的卡片;- 任何第三方 CORS 代理 。远程链接能不能读,取决于对方站点有没有
Access-Control-Allow-Origin;读不了就明确区分 CORS / 混合内容 / 404 / 超时,并给「在新标签页打开原链接」,而不是绕过去。 - 图表 / SmartArt / 动画的还原(只留占位提示)。
九、几句话总结
这个项目里没有特别尖端的技术,有的是把「看一眼」这件事做到没有摩擦的耐心:649 个扩展名一个一个配样例,转码成败按退出码判而不是按日志判,本地 m3u8 的分片要按相对路径找齐并把缺失的名字念出来,5.5 GB 的电影要实测拖到 1827 秒确认只花 29 ms,弹窗交接被 StrictMode 掐断这种坑要写进 ADR 免得下次再踩。
如果你只想用它:打开网页,把文件拖进去。 如果你想读它:README.md 是功能与部署,FORMATS.md 是格式状态板,docs/adr/ 是 12 条决策与它们的代价。 如果你想改它:先读 FORMATS.md,再开一张票据,然后跑门禁。
你的文件不会离开你的电脑。这是这个项目唯一不变的设计目标。
原创技术博客 · 开源项目分享 · AI全栈创作社区 idao.fun