Java 8.0 是Java语言发展史上的一个分水岭。是 Java 自 5.0 以来最具革命性的版本,标志着 Java 正式迈入函数式编程时代,重塑了语言范式、API 设计与运行时机制。不仅改进了开发者的工作效率,还强化了语言本身的功能。
一、语言语法特性
1. Lambda 表达式 (Lambda Expressions)
Lambda 表达式本质上是一种简洁、可传递的匿名函数。它不依赖于类的定义,无需显式声明方法名、访问修饰符、返回类型或 throws 子句,仅需关注"参数 → 函数体"的核心逻辑。
Lambda 表达式标志着 Java 正式迈入函数式编程(Functional Programming)的新纪元。
Lambda 表达式合法使用的前提是目标类型必须是函数式接口(Functional Interface)。函数式接口是指仅包含一个抽象方法(SAM, Single Abstract Method)的接口(可包含多个 default/static 方法)。这些接口类上面都有@FunactionalInterface这个注解,接口包路径为java.util.function。比如:Function系列接口、Consumer系列接口、Predicate系列接口。
java
// 1. 定义函数式接口
@FunctionalInterface
interface IntegerMath {
    int operation(int a, int b);
}Lambda表达式都语法:(parameter - list) -> { expression - or - statements }。
- ()中的parameter-list是以逗号分隔的参数。你可以指定参数的类型,也可以不指定。
- {}中的expression-or-statements为Lambda的主体,可以是一行语句,也可以多行。
less
// 无参数,必须保留空括号
() -> System.out.println("Hello")

// 单个参数,类型可省略,且括号也可省略。
a -> System.out.println(a)

// 多参数,类型可省略,但括号必须保留,如果函数体只有一条语句,大括号 {} 和 return 关键字均可省略。
(a, b) -> a + b
集合遍历与行为传递。Lambda 允许我们将"行为(代码逻辑)"作为参数传递,而不是仅仅传递值。
typescript
List<String> players = Arrays.asList("Nadal", "Djokovic", "Federer");

// 传统写法(匿名内部类):
players.forEach(new Consumer<String>() {
    @Override
    public void accept(String player) {
        System.out.println(player);
    }
});

// Lambda 写法:
// 1. 标准 Lambda
players.forEach(player -> System.out.println(player));

// 2. 结合方法引用(进一步简化)
players.forEach(System.out::println);
集合排序。
java
//传统写法:
Integer[] numbers = {1, 8, 3, 9, 2};
Arrays.sort(numbers, new Comparator<Integer>() {
    @Override
    public int compare(Integer o1, Integer o2) {
        return o1 - o2;
    }
});

// Lambda 写法:
Arrays.sort(numbers, (o1, o2) -> o1 - o2);
结合 Stream API 进行声明式数据处理。Lambda 与 Stream API 构成了 Java 8 处理数据的黄金搭档,使代码从"怎么做(命令式)"转变为"做什么(声明式)"。
scss
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8);

// 传统循环:逻辑嵌套深,可读性差
// Stream + Lambda:逻辑如流水线般清晰
Optional<Integer> result = numbers.stream()
    .filter(n -> n % 2 == 0)  // 过滤偶数
    .map(n -> n * 2)          // 乘以2
    .filter(n -> n > 5)       // 过滤大于5的数
    .findFirst();             // 取第一个满足条件的数
使用Lambda表达式重要注意事项:
- 变量捕获:Lambda 表达式可以访问外部的局部变量,但该变量必须是事实上不可变的(即 final 或等效 final);
- 访问限制:Lambda 表达式不能访问接口的默认方法;
- this 关键字:在 Lambda 表达式中,this 指向的是外部类的实例,而非 Lambda 自身。
2. 方法引用 (Method References)
当 Lambda 表达式仅仅用于调用一个已经存在的方法时,可以将该方法的名字作为变量来传递使用。
方法引用使用双冒号 :: 运算符来分隔类名/对象名和方法名。
方法引用的四种类型: (1)引用静态方法,语法:ContainingClass::staticMethodName。 Lambda 等价形式:(args) -> ClassName.staticMethodName(args)
typescript
import java.util.function.BiFunction;

public class MethodReferencesExamples {
    // 一个静态方法,用于拼接两个字符串
    public static String appendStrings(String a, String b) {
        return a + b;
    }

    public static <T> T mergeThings(T a, T b, BiFunction<T, T, T> merger) {
        return merger.apply(a, b);
    }

    public static void main(String[] args) {
        // 使用 Lambda 表达式
        mergeThings("Hello ", "World!", (a, b) -> a + b);

        // 引用静态方法,等价于 (a, b) -> MethodReferencesExamples.appendStrings(a, b)
        mergeThings("Hello ", "World!", MethodReferencesExamples::appendStrings);
    }
}
(2)引用特定对象的实例方法,语法:containingObject::instanceMethodName。 Lambda 等价形式:(args) -> containingObject.instanceMethodName(args)
typescript
import java.util.function.BiFunction;

public class MethodReferencesExamples {
    // 一个实例方法,用于拼接两个字符串
    public String appendStrings2(String a, String b) {
        return a + b;
    }

    public static <T> T mergeThings(T a, T b, BiFunction<T, T, T> merger) {
        return merger.apply(a, b);
    }

    public static void main(String[] args) {
        MethodReferencesExamples myApp = new MethodReferencesExamples();

        // 引用特定对象 myApp 的实例方法,等价于 (a, b) -> myApp.appendStrings2(a, b)
        mergeThings("Hello ", "World!", myApp::appendStrings2);
    }
}
(3)引用特定类型的任意对象的实例方法,语法:ContainingType::methodName。 Lambda 等价形式:(obj, args) -> obj.methodName(args)。
当 Lambda 表达式的第一个参数是方法的调用者,其余参数作为方法参数时,就可以使用这种引用。也就是说,引用的是参数(类型为 ContainingType)的实例方法。
arduino
import java.util.Arrays;
import java.util.List;

public class ArbitraryObjectExample {
    public static void main(String[] args) {
        List<String> names = Arrays.asList("peter", "anna", "mike");

        // 使用 Lambda 表达式,第一个参数 s 是 toUpperCase 的调用者
        names.stream()
            .map(s -> s.toUpperCase())
            .forEach(s -> System.out.println(s));

        // 引用 String 类型的任意对象的 toUpperCase 实例方法
        // String::toUpperCase 等价于 s -> s.toUpperCase()
        names.stream()
            .map(String::toUpperCase)
            .forEach(System.out::println);
    }
}
(4)引用构造器,语法:ClassName::new。 Lambda 等价形式:(args) -> new ClassName(args)
java
import java.util.Arrays;
import java.util.List;
import java.util.stream.Collectors;

class Person {
    private String name;
    public Person(String name) {
        this.name = name;
    }
    @Override
    public String toString() {
        return "Person{name='" + name + "'}";
    }
}

public class ConstructorExample {
    public static void main(String[] args) {
        List<String> names = Arrays.asList("Alice", "Bob", "Charlie");

        // 使用 Lambda 表达式,将字符串转换为 Person 对象
        List<Person> people1 = names.stream()
                                    .map(name -> new Person(name))
                                    .collect(Collectors.toList());

        // 引用构造器,等价于 name -> new Person(name)
        List<Person> people2 = names.stream()
                                    .map(Person::new)
                                    .collect(Collectors.toList());
        System.out.println(people2);
    }
}
使用方法引用注意事项:
- 并非所有 Lambda 都能转换:只有当 Lambda 表达式的函数体仅仅是调用一个已有方法,且不包含其他额外逻辑时,才能使用方法引用;
- 无类型不匹配:方法引用本质上是一个 Lambda 表达式,它本身没有类型,其类型由上下文(目标类型)决定;
- 遵循里氏替换原则:被引用方法的参数列表和返回值,必须与目标函数式接口的抽象方法兼容。
3. 接口默认方法与静态方法 (Default & Static Methods)
在接口中引入的默认方法(Default Methods)和静态方法(Static Methods)。
- 默认方法(Defender Methods / Virtual extension methods):使用 default 关键字声明,必须提供方法的具体实现(即方法体)。它提供了方法的默认实现,实现类可以选择直接继承、重写,或者不重写。
- 静态方法(Static Methods):使用 static 关键字声明,必须提供方法的具体实现(即方法体)。它属于接口本身,不能被实现类继承或重写,主要用于在接口中提供工具类方法。
在 Java 8 之前,接口中只能包含抽象方法。如果为了增加新功能而在接口中添加新方法,所有实现该接口的类都必须被迫重写这些方法,这会导致严重的兼容性问题。局限性:接口一旦发布,就几乎无法在不破坏所有实现类的情况下进行扩展。默认方法和静态方法的引入,主要是为了在不破坏现有实现类的前提下,允许接口进行平滑升级。
(1)默认方法。
typescript
// 定义一个包含默认方法的接口
public interface MyInterface {
    // 抽象方法,实现类必须实现
    void existingMethod(String input);

    // 默认方法,提供默认实现
    default void newDefaultMethod() {
        System.out.println("这是接口新增的默认方法实现。");
    }
}

// 实现类1:可以不改动任何代码,自动获得 newDefaultMethod 的默认实现
public class MyClass1 implements MyInterface {
    @Override
    public void existingMethod(String input) {
        System.out.println("MyClass1 实现: " + input);
    }
    // 无需重写 newDefaultMethod,直接继承默认实现
}

// 实现类2:也可以选择覆盖默认方法,提供自己的实现
public class MyClass2 implements MyInterface {
    @Override
    public void existingMethod(String input) {
        System.out.println("MyClass2 实现: " + input);
    }

    @Override
    public void newDefaultMethod() {
        System.out.println("MyClass2 覆盖了接口的默认方法,提供了新的行为。");
    }
}

// 测试
public class Test {
    public static void main(String[] args) {
        MyClass1 obj1 = new MyClass1();
        obj1.existingMethod("Hello"); // 输出: MyClass1 实现: Hello
        obj1.newDefaultMethod();      // 输出: 这是接口新增的默认方法实现。

        MyClass2 obj2 = new MyClass2();
        obj2.existingMethod("World"); // 输出: MyClass2 实现: World
        obj2.newDefaultMethod();      // 输出: MyClass2 覆盖了接口的默认方法,提供了新的行为。
    }
}
(2)静态方法。
typescript
public interface UtilityInterface {
    // 静态方法,提供通用工具功能
    static String getStaticMessage() {
        return "这是一个来自接口的静态工具方法。";
    }

    // 接口中仍可以有默认方法和抽象方法...
    default void printMessage() {
        System.out.println(UtilityInterface.getStaticMessage());
    }
}

public class MyClass implements UtilityInterface {
    // 实现类无需对静态方法做任何事,也无法重写它
    // 只需要实现接口中的抽象方法(本例中没有)
}

public class TestStatic {
    public static void main(String[] args) {
        // 静态方法通过接口名直接调用
        String msg = UtilityInterface.getStaticMessage();
        System.out.println(msg); // 输出: 这是一个来自接口的静态工具方法。

        // 下面的代码是错误的,无法通过编译
        // ❌ 错误! 实现类无法继承接口的静态方法
        // MyClass obj = new MyClass();
        // obj.getStaticMessage();
    }
}
核心规则:
- 解决"菱形继承"问题。如果一个类实现了多个接口,且这些接口中包含签名完全相同的默认方法,编译器将无法决定使用哪一个(即菱形问题)。此时,实现类必须显式重写该方法,否则编译报错。
- 类优先原则 (Class Precedence)。如果类(或其父类)中已经定义了一个与接口默认方法签名相同的方法,那么类的方法优先级高于接口的默认方法。接口的默认方法会被自动忽略。
注意事项:
- 不能重写 Object 类的方法:接口中的默认方法不能重写 java.lang.Object 中的方法(如 toString(), equals(), hashCode())。因为 Object 是所有类的基类,其方法始终具有最高优先级,定义这样的默认方法毫无意义且会引起混淆。
- 访问权限:默认方法和静态方法默认都是 public 的,声明时不需要(也不允许)加 private 或 protected。
- 不可被 final/synchronized 修饰:默认方法不能被声明为 final(因为需要允许子类重写)或 synchronized。
4. 重复注解 (Repeating Annotations)
重复注解允许开发者直接在同一个程序元素上多次应用相同的注解类型,使代码更加简洁、直观。重复注解本质上仍然依赖于"容器注解(Container Annotation)"。编译器在编译阶段会自动将多个重复的注解打包到一个容器注解中。
在 Java 8 之前,如果需要在同一个元素(如类、方法)上多次使用同一个注解,开发者必须将这些注解包裹在一个"容器注解"中。这种方式不仅代码冗长,而且增加了访问嵌套注解的复杂度。
less
// Java 8 之前的变通写法
@Schedules({
    @Schedule(dayOfMonth="last"),
    @Schedule(dayOfWeek="Fri", hour="23")
})
public void doPeriodicCleanup() { ... }

// 在 Java 8 及之后,使用重复注解,你可以直接这样写,代码的可读性会更好
// Java 8 的重复注解写法
@Schedule(dayOfMonth="last")
@Schedule(dayOfWeek="Fri", hour="23")
public void doPeriodicCleanup() { ... }
定义重复注解的步骤。要创建一个可重复的注解,需要按照官方规范进行声明,这也是理解其原理的关键。
步骤一:声明可重复的注解类型。使用 @Repeatable 元注解来标记该注解是可重复的,并指定它的 value 值指向一个容器注解类。
java
import java.lang.annotation.Repeatable;

// 使用 @Repeatable 元注解,并指定容器注解为 Schedules.class

@Repeatable(Schedules.class)
public @interface Schedule {
    String dayOfMonth() default "first";
    String dayOfWeek() default "Mon";
    int hour() default 12;
}
步骤二:声明容器注解类型。容器注解本身必须有一个名为 value 的元素,其类型是一个数组,数组的组件类型就是那个可重复的注解类型。
scss
// 容器注解,其 value 元素类型为 Schedule 数组
public @interface Schedules {
    Schedule[] value();
}
步骤三:使用重复注解。
less
@Schedule(dayOfMonth="last")
@Schedule(dayOfWeek="Fri", hour="23")
public void doPeriodicCleanup() { ... }
通过反射获取重复注解。对于重复注解的读取,Java 反射 API 也做了相应的增强。AnnotatedElement 接口提供了新的方法来方便地获取它们:
getAnnotationsByType(Class<T>):专门用于获取重复注解,获取指定类型的所有注解(包括容器注解内部的)。getDeclaredAnnotationsByType(Class<T>):获取直接声明在元素上的指定类型注解。
less
import java.lang.reflect.Method;

public class TestRepeatableAnnotation {
    @Schedule(dayOfMonth="last")
    @Schedule(dayOfWeek="Fri", hour="23")
    public void doPeriodicCleanup() {}

    public static void main(String[] args) throws NoSuchMethodException {
        Method method = TestRepeatableAnnotation.class.getMethod("doPeriodicCleanup");

        // 使用 getAnnotationsByType 直接获取所有 Schedule 注解
        Schedule[] schedules = method.getAnnotationsByType(Schedule.class);
        for (Schedule schedule : schedules) {
            System.out.println("dayOfMonth: " + schedule.dayOfMonth() +
                               ", dayOfWeek: " + schedule.dayOfWeek() +
                               ", hour: " + schedule.hour());
        }
    }
}
使用重复注解注意事项:
- 容器注解不可省略:即使你在代码中只写了一次 @Schedule,你也必须定义对应的容器注解 @Schedule,否则编译器会报错。
- 不能同时存在:你不能在同一个元素上既使用重复注解(@Schedule),又手动使用它的容器注解(@Schedule),这会导致编译错误。
- 保留策略:如果希望重复注解在运行时可用,可重复注解和它的容器注解都必须声明 @Retention(RetentionPolicy.RUNTIME)。
5. 类型注解 (Type Annotations)
允许开发者在代码中任何使用类型(Type Use)的地方添加注解,打破了传统注解只能用于"声明(Declarations)"的限制。
在 Java SE 8 之前,注解只能应用于声明(如类、方法、字段)。
为了支持这一特性,Java 8 在 java.lang.annotation.ElementType 枚举中新增了两个枚举值:
- ElementType.TYPE_USE:表示注解可以应用于任何使用类型的地方。
- ElementType.TYPE_PARAMETER:表示注解可以应用于泛型类型参数的声明处(如:
class MyClass<@MyAnnotation T> { ... })。
less
// 一个自定义注解,可同时应用于类型使用和类型参数
@Target({ElementType.TYPE_USE, ElementType.TYPE_PARAMETER})
@interface MyAnnotation { ... }什么是"任何使用类型的地方"?简单来说,就是凡是在代码中写下了一个类型,你都可以给它加上注解。例如:
- 对象创建(new):
new @Interned MyObject(); - 变量声明与局部变量:
@NonNull String name = "Java 8"; - 类型强制转换(cast):
myString = (@NonNull String) str; - implements 子句:
class UnmodifiableList<T> implements @Readonly List<@Readonly T> { ... } - throws 子句:
void monitorTemperature() throws @Critical TemperatureException { ... } - 泛型类型参数:
List<@NonNull String> strList; - 类型变量绑定:
class Folder<F extends @Existing File> { ... } - 数组维度:类型注解可以精确区分"数组本身"和"数组元素"的约束。
scss
// 注解在数组元素类型前:表示数组中的元素不可为 null
@NonNull String[] arr1;

// 注解在数组类型后:表示数组引用本身不可为 null
String @NonNull [] arr2;
使用类型注解注意事项:
- 区分类型注解与声明注解:修饰方法的返回类型(如 public @NonNull String getName())是类型注解;而修饰方法本身的声明(如 @Deprecated public String getName())是声明注解。两者位置不同,作用也不同。
- 需要配套工具支持:仅仅在代码中写上 @NonNull 或 @Readonly 并不会自动产生任何效果。你必须引入并配置相应的类型检查框架(如著名的 Checker Framework),在编译阶段配合这些注解进行严格的静态代码分析,才能真正发挥类型注解的威力。
- 反射获取:类型注解在运行时可以通过 Java 反射 API(如 AnnotatedType、getAnnotatedReturnType() 等)进行读取和处理。
6. 改进的类型推断 (Improved Type Inference)
Java 编译器在更广泛的上下文中,利用表达式的目标类型来推断泛型方法的类型参数。它是 Java 编译器的一种能力,能够根据方法调用及其对应的声明,自动确定该调用适用的类型参数,从而减少开发者在代码中显式指定泛型类型的冗余。
在 Java 8 中,编译器可以利用 addAll 方法的参数目标类型(Collection<? extends String>)来推断 Arrays.asList() 的 T 类型就是 String,因此代码可以顺利编译。
arduino
// 在 Java SE 7 及更早版本,以下代码会编译失败
List<String> stringList = new ArrayList<>();
// 编译器无法推断 Arrays.asList() 的泛型参数 T,会报错
stringList.addAll(Arrays.asList());

// Java 7 必须显式指定类型参数(类型见证)
stringList.addAll(Arrays.<String>asList());
(1)方法调用上下文中的推断。 在 Java 7 中,编译器只能在赋值语句的左侧进行类型推断(如 List<String> list = new ArrayList<>();)。到了 Java 8,推断能力被扩展到了方法的参数传递场景。
typescript
// 一个泛型方法,接收一个 List<T> 和两个 T 类型的参数
static <T> List<T> addToList(List<T> list, T a, T b) {
    list.add(a);
    list.add(b);
    return list;
}

public static void main(String[] args) {
    // Java 8 中,无需显式指定任何类型,编译器能自动推断
    List<String> strList = addToList(new ArrayList<>(), "Hello", "World");
    List<Integer> intList = addToList(new ArrayList<>(), 1, 2);
    List<Number> numList = addToList(new ArrayList<>(), 1, 2.0); // 推断为 Number

    // 1、根据 addToList 方法的参数(如 "Hello" 和 "World")推断出泛型 T 是 String。
    // 2、根据 new ArrayList<>() 所在的位置(作为 List<T> 参数传入),推断出这里需要创建一个 ArrayList<String>
}
(2)链式调用中的类型推断。 Java 8 的编译器还能在链式调用中"传递"类型信息,如下这种链式调用在 Java 7 中编译失败:
javascript
Map<String, Object> map = Collections.synchronizedMap(new HashMap<>());在 Java 8 中,编译器可以沿着调用链追踪类型:
- 它先看到赋值语句左侧的目标类型是 Map<String, Object>;
- 然后向右分析,发现 Collections.synchronizedMap() 方法期望一个 Map 参数;
- 最终,编译器能够推断出 new HashMap<>() 需要被推断为 HashMap<String, Object>,从而使整个链式赋值编译通过。
Java 8 的改进类型推断让编译器变得更加"聪明"。可以无缝支持函数式编程:强大的类型推断是 Lambda 表达式、方法引用以及 Stream API 能够保持代码优雅、不臃肿的底层基石。
css
// Java 8 之前,需要显式声明参数类型
Comparator<Integer> comp1 = (Integer a, Integer b) -> a.compareTo(b);

// Java 8 中,参数类型可以由编译器推断
Comparator<Integer> comp2 = (a, b) -> a.compareTo(b);
7. 方法参数反射 (Method Parameter Reflection)
允许在运行时获取方法或构造器参数(形式参数)的真实名称,而不再是无意义的 arg0、arg1 占位符。
在 Java 8 之前,通过反射机制只能获取方法的名称、返回类型和修饰符等信息,但无法直接获取方法的参数名称(通常只能得到 arg0, arg1 这样的占位符)。Java 8 引入了 java.lang.reflect.Parameter 类来解决这一痛点。
java.lang.reflect 包下新增了 Executable 抽象基类(Method 和 Constructor 的父类),并提供了以下关键方法:
int getParameterCount():获取该构造器或方法的形参个数。Parameter[] getParameters():获取该构造器或方法的所有形参,返回一个 Parameter 数组。Parameter 类提供了大量获取参数元信息的方法:String getName():获取形参名称。boolean isNamePresent():判断该类的 .class 文件中是否包含了该参数的真实名称信息(这是安全获取参数名的前置检查)。Class<?> getType():获取形参类型。Type getParameterizedType():获取带泛型的形参类型。int getModifiers():获取修饰该形参的修饰符。boolean isVarArgs():判断该参数是否为可变参数。
arduino
// 1、定义目标类
public class Person {
    private String fullName;

    public Person(String fullName) {
        this.fullName = fullName;
    }
    // fullName 是形参 (形式参数)
    public void setFullName(String fullName) {
        this.fullName = fullName;
    }
}

// 通过反射获取构造器和方法的参数名称
import java.lang.reflect.Method;
import java.lang.reflect.Parameter;
import java.lang.reflect.Constructor;
import java.util.Arrays;

public class ParameterReflectionDemo {
    public static void main(String[] args) throws NoSuchMethodException {
        // 1. 获取构造器的参数
        Constructor<Person> constructor = Person.class.getConstructor(String.class);
        System.out.println("=== 构造器参数 ===");
        for (Parameter p : constructor.getParameters()) {
            System.out.printf("  参数名: %s, 类型: %s, isNamePresent: %s%n",
                p.getName(), p.getType().getSimpleName(), p.isNamePresent());
        }

        // 2. 获取普通方法的参数
        Method method = Person.class.getMethod("setFullName", String.class);
        System.out.println("\n=== 方法参数 ===");
        for (Parameter p : method.getParameters()) {
            System.out.printf("  参数名: %s, 类型: %s, isNamePresent: %s%n",
                p.getName(), p.getType().getSimpleName(), p.isNamePresent());
        }
    }
}
注意
-
如果编译时没有加 -parameters,调用 p.getName() 将返回类似 arg0、arg1 的默认名称,且 isNamePresent() 会返回 false:
javac -parameters -d . MethodParameterTest.java
-
如果你使用 Maven 构建,需要在 pom.xml 中配置 maven-compiler-plugin:
xml
<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>3.1</version>
    <configuration>
        <source>1.8</source>
        <target>1.8</target>
        <compilerArgument>-parameters</compilerArgument>
    </configuration>
</plugin>
二、新增API/包
1. Stream API (java.util.stream)
允许开发者以类似 SQL 查询的流水线方式对数据进行过滤、映射、排序和聚合,彻底告别了传统 for 循环中冗长且易错的命令式代码。
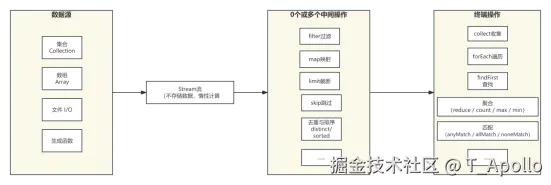
本质特征:
- 无存储(No Storage):Stream 本身不存储数据,它仅作为数据的计算管道(Pipeline),关注数据处理的流水线操作,数据来源于集合、数组或 I/O 通道等数据源。
- 函数式与不可变性(Functional & Immutable):Stream 的操作不会修改源数据,而是返回一个新的流对象。例如,对集合进行 filter 操作会生成一个新的 Stream,而非修改原集合。
- 惰性计算(Lazy Evaluation):中间操作不会立即执行,只有在触发终端操作时,整个流水线才会被实际计算,这支持了短路优化(Short-circuiting)并极大提升了性能。
- 一次性消费(Consumable):Stream 只能被消费一次,一旦执行了终端操作,该流对象就会失效,重复调用会抛出异常。
Stream API 的操作被严格划分为三大类:创建流、中间操作(Intermediate Operations)和终端操作(Terminal Operations)。
rust
List<String> names = Arrays.asList("Alice", "Bob", "Charlie", "David", "Edward");

// 场景一:过滤 + 转换 + 收集
// 筛选出名字长度大于 3 的字符串,转为大写,并收集为新的
List List<String> result = names.stream()
                .filter(name -> name.length() > 3)    // 中间操作:过滤
                .map(String::toUpperCase)             // 中间操作:映射为大写
                .collect(Collectors.toList());        // 终端操作:收集结果

// 场景二:分组统计
// 按字符串长度进行分组,并统计每组的数量
Map<Integer, Long> lengthCountMap = names.stream()
                .collect(Collectors.groupingBy(
                    String::length, // 分组依据
                    Collectors.counting() // 统计数量
                ));

// 场景三:数值计算与短路操作
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);
// 求和
int sum = numbers.stream().mapToInt(Integer::intValue).sum();
// 查找第一个大于 3 的数(满足条件后立刻停止遍历,即短路优化)
Optional<Integer> first = numbers.stream()
                .filter(n -> n > 3)
                .findFirst();
注意
- NullPointerException:当流中可能包含 null 元素时,在进行 map 或 filter 等操作前,建议先使用
.filter(Objects::nonNull)进行空值过滤,避免运行时异常。
2. 函数式接口包 (java.util.function)
包含了一系列通用的函数式接口,为 Lambda 表达式和方法引用提供了标准化的"目标类型"(target types)。
java.util.function 包中最基础、最常用的接口可以归纳为四种"函数形状"(function shapes)。
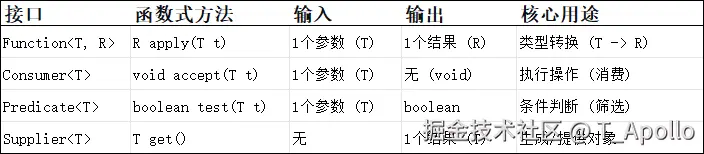
(1)Function<T, R>(转换型)作用:接收一个 T 类型的参数,返回一个 R 类型的结果。
arduino
// 将字符串转换为它的长度
Function<String, Integer> lengthFunc = s -> s.length();
System.out.println(lengthFunc.apply("Java 8")); // 输出: 6
(2)Consumer(消费型)作用:接收一个 T 类型的参数,但不返回任何结果(void)。
rust
// 打印字符串
Consumer<String> printer = s -> System.out.println("消费: " + s);
printer.accept("Hello"); // 输出: 消费: Hello
(3)Predicate(断言/判断型)作用:接收一个 T 类型的参数,返回一个 boolean 值。
rust
// 判断字符串长度是否大于 3
Predicate<String> isLong = s -> s.length() > 3;
System.out.println(isLong.test("Java")); // 输出: true
(4)Supplier(供给型)作用:不接收任何参数,但返回一个 T 类型的结果。
scss
// 生成一个随机数
Supplier<Double> randomSupplier = () -> Math.random();
System.out.println(randomSupplier.get()); // 输出: 0.xxxxx
命名规范:
- 多参数变体:通过添加前缀来表示参数个数,如:
BiFunction<T, U, R>(双参数)、BiConsumer<T, U>、BiPredicate<T, U>。 - 同类型操作符:当输入和输出类型相同时,使用
UnaryOperator<T>(单参数)和 BinaryOperator<T>(双参数),它们是 Function 和 BiFunction 的特殊化。 - 基本类型特化:为了避免频繁的装箱/拆箱,提供了一系列针对 int、long、double 的特化接口,如:
IntPredicate、LongConsumer、ToIntFunction<T>。
3. 新的日期和时间 API (java.time)
全新日期与时间 API,旨在全面取代旧有的 java.util.Date 和 java.util.Calendar 类。彻底终结了旧版 java.util.Date 和 java.util.Calendar 存在的线程不安全、设计混乱、易出错、功能不完整等痛点。
核心特征:
- 不可变性(Immutable):java.time 包下的所有核心类都是不可变的(类似于 String)。这意味着它们是天生线程安全的,任何修改操作(如加一天、减一小时)都会返回一个新的对象,原对象保持不变。
- 清晰性(Clear):严格区分概念,将"日期"、"时间"、"日期时间"、"时间戳"和"时区"进行了严格的语义划分,避免了概念混淆。
- 可扩展性(Extensible):设计允许开发者通过 java.time.temporal 和 java.time.chrono 包扩展自定义的日历系统或时间计算逻辑。
(1)本地日期与时间(无时区概念)。
- LocalDate:仅包含日期(年、月、日),不包含时间和时区。
- LocalTime:仅包含时间(时、分、秒、纳秒),不包含日期和时区。
- LocalDateTime:日期与时间的组合,同样不包含时区信息。
ini
// 1. 获取当前日期和时间
LocalDate today = LocalDate.now(); // 例如: 2026-09-06
LocalTime nowTime = LocalTime.now(); // 例如: 22:30:00
LocalDateTime nowDateTime = LocalDateTime.now(); // 例如: 2026-09-06T22:30:00

// 2. 构造指定的日期时间
LocalDate specificDate = LocalDate.of(2026, Month.DECEMBER, 25); // 2026-12-25
LocalTime specificTime = LocalTime.parse("08:15:30"); // 08:15:30

// 3. 日期时间的加减计算(返回新对象,原对象不变)
LocalDate nextWeek = today.plusDays(7); // 7天后的日期
LocalTime prevHour = nowTime.minusHours(1); // 1小时前的时间
(2)时间戳(Instant)。表示时间线上的一个精确点(时间戳),精确到纳秒。
ini
// 获取当前时间戳
Instant now = Instant.now();

// Instant 与旧版 Date 的互相转换
Date oldDate = new Date();
Instant instant = oldDate.toInstant(); // Date -> Instant
Date convertedDate = Date.from(instant); // Instant -> Date
(3)带时区的日期时间(ZonedDateTime)。在 LocalDateTime 的基础上加入了完整的时区信息。适用于需要处理跨国业务或跨时区转换的场景。
ini
// 1. 获取特定时区的当前时间
ZonedDateTime shanghaiTime = ZonedDateTime.now(ZoneId.of("Asia/Shanghai"));

// 2. 时区转换(保持同一时刻,转换为纽约时间)
ZonedDateTime newYorkTime = shanghaiTime.withZoneSameInstant(ZoneId.of("America/New_York"));
(4)时间间隔(Duration 与 Period)。
- Duration:用于计算两个"时间点"之间的间隔,以秒和纳秒为单位(适用于 Instant, LocalTime 等)。
- Period:用于计算两个"日期"之间的间隔,以年、月、日为单位(适用于 LocalDate)。
less
// 计算时间间隔(Duration)
Duration duration = Duration.between(LocalTime.parse("09:00"), LocalTime.parse("17:30"));
System.out.println(duration.toHours()); // 输出: 8 (小时)

// 计算日期间隔(Period)
Period period = Period.between(LocalDate.of(2026, 1, 1), LocalDate.of(2026, 9, 6));
System.out.println(period.getMonths()); // 输出: 8 (月)
(5)格式化与解析(DateTimeFormatter)。替代了旧版线程不安全的 SimpleDateFormat,它是线程安全的,专门用于日期时间的格式化和字符串解析。
ini
// 1. 自定义格式化输出
DateTimeFormatter formatter = DateTimeFormatter.ofPattern("yyyy年MM月dd日 HH:mm");
String formatted = LocalDateTime.now().format(formatter); // 例如: "2026年09月06日 22:30"

// 2. 字符串解析为对象
LocalDateTime parsed = LocalDateTime.parse("2026年09月06日 22:30", formatter);
4. Optional 类 (java.util.Optional)
Optional 类是一个容器类,旨在更优雅地处理程序中可能存在的空值(null)问题。作为一种方法返回类型,明确表示"可能不存在结果",从而帮助开发者编写更健壮的代码,有效缓解和减少 NullPointerException(空指针异常)的发生。
(1)创建 Optional 实例,提供了三种静态方法来构造 Optional 对象:
Optional.of(value):传入一个非 null 的值。如果传入 null,会直接抛出 NullPointerException。Optional.ofNullable(value):最常用。允许传入 null,如果为 null 则返回一个空的 Optional。Optional.empty():返回一个空的 Optional 实例。
vbnet
Optional<String> opt1 = Optional.of("Hello");
Optional<String> opt2 = Optional.ofNullable(null); // 返回空 Optional
Optional<String> emptyOpt = Optional.empty();
(2)检查值是否存在。
isPresent():如果值存在,返回 true;否则返回 false。ifPresent(Consumer<T> action):如果值存在,则执行指定的 Consumer 操作;否则不执行。
kotlin
Optional.ofNullable(getExternalData())
        .ifPresent(data -> processData(data));
(3)获取值与提供默认值。
get():如果值存在则返回,否则抛出 NoSuchElementException。不推荐直接使用,因为存在风险。orElse(T other):如果值存在则返回,否则返回传入的默认值 other。orElseGet(Supplier<? extends T> other):如果值存在则返回,否则触发 Supplier 生成默认值。推荐用于默认值生成成本较高的场景(懒加载)。orElseThrow(Supplier<? extends X> exceptionSupplier):如果值存在则返回,否则抛出由 Supplier 提供的自定义异常。
ini
String val1 = opt2.orElse("Default Value");
String val2 = opt2.orElseGet(() -> "Lazy Default Value");
String val3 = opt2.orElseThrow(() -> new IllegalArgumentException("Value is missing"));
(4)转换与过滤(链式调用的核心)
map(Function):如果有值,对其执行映射函数。如果返回值不为 null,则创建包含该返回值的 Optional,否则返回空 Optional。filter(Predicate):如果有值且满足给定的predicate过滤条件,则返回包含该值的 Optional;否则返回空的 Optional
rust
// 链式安全访问,避免多层 if-null 嵌套
String city = Optional.ofNullable(user)
            .map(User::getAddress)
            .map(Address::getCity)
            .filter(c -> c.length() > 3)  // 过滤掉长度小于等于3的城市
            .orElse("Unknown City");
注意
- 严禁作为字段或方法参数:不要将 Optional 用作 Java Bean 的实例域(字段)、构造器参数或方法参数。因为 Optional 没有实现 Serializable 接口,不可序列化,且作为参数会增加不必要的复杂度和降低可读性。
- 慎用 get() 和 isPresent():大量使用 isPresent() 配合 get() 会退化成普通的 if-null 判断,失去了 Optional 链式调用的优雅性。应优先使用 orElse、map 和 ifPresent。
5. Base64 编解码支持 (java.util.Base64)
用于进行 Base64 编码和解码,提供了标准的、内置的解决方案。java.util.Base64 类提供了三种不同类型的编码器和解码器,以满足不同场景下的数据转换需求:基本编码(Basic)、URL 安全编码(URL Safe)和 MIME 编码。
java.util.Base64 提供了六个静态方法来获取对应的编码器/解码器。
- getEncoder() / getDecoder():获取 Basic 型的编码器/解码器。
- getUrlEncoder() / getUrlDecoder():获取 URL 安全型的编码器/解码器。
- getMimeEncoder() / getMimeDecoder():获取 MIME 型的编码器/解码器。
(1)基本编码器 (Basic Encoder)。
使用标准的 Base64 编码规则。输出仅包含字母、数字、+ 和 /,不会添加任何换行符。如果长度不足,使用 = 进行填充。
适用场景:常规的文本数据编码、HTTP 请求头中的敏感信息传递等。
ini
import java.util.Base64;
import java.nio.charset.StandardCharsets;

String originalString = "Hello, Java 8 Base64!";
byte[] originalBytes = originalString.getBytes(StandardCharsets.UTF_8);

// 基本编码
String basicEncoded = Base64.getEncoder().encodeToString(originalBytes);
System.out.println("基本编码: " + basicEncoded);

// 基本解码
byte[] decodedBytes = Base64.getDecoder().decode(basicEncoded);
System.out.println("基本解码: " + new String(decodedBytes, StandardCharsets.UTF_8));
(2)URL安全编码器 (URL Safe Encoder)
专为 URL 和文件名设计。它将标准 Base64 中的 + 替换为-,将 / 替换为_ ,并且输出中不包含 = 填充符。
适用场景:URL参数传递、文件命名、Token生成等,避免 URL 解析时产生歧义。
ini
import java.util.Base64;
import java.nio.charset.StandardCharsets;

String originalInput = "https://example.com?param=value with spaces & special+chars/";

// 编码
String encodedString = Base64.getUrlEncoder()
                .encodeToString(originalInput.getBytes(StandardCharsets.UTF_8));
System.out.println("URL Encoded: " + encodedString);
// 输出: URL Encoded: aHR0cHM6Ly9leGFtcGxlLmNvbT9wYXJhbT12YWx1ZSB3aXRoIHNwYWNlcyAmIHNwZWNpYWwrY2hhcnMv

// 解码
byte[] decodedBytes = Base64.getUrlDecoder()
                .decode(encodedString);
String decodedString = new String(decodedBytes, StandardCharsets.UTF_8);
System.out.println("URL Decoded: " + decodedString);
// 输出: URL Decoded: https://example.com?param=value with spaces & special+chars/
(3)MIME编码器 (MIME Encoder)
专为 MIME 消息(如电子邮件附件)设计。输出格式友好,每行最多包含 76 个字符,并使用 \r\n 作为行分隔符。解码时会忽略所有不在字母表中的字符,包括换行符。
适用场景:邮件发送、多部分消息体构建等。
java
import java.util.Base64;
import java.nio.charset.StandardCharsets;

// 构造一个长字符串
String longInput = "This is a very long string that will be used to demonstrate the MIME Base64 encoding. "
    + "It contains multiple sentences and should be long enough to span several lines when encoded. "
    + "The MIME encoder will wrap the output into lines of no more than 76 characters.";

// 编码
String encodedString = Base64.getMimeEncoder()
            .encodeToString(longInput.getBytes(StandardCharsets.UTF_8));
System.out.println("MIME Encoded:\n" + encodedString);
// 输出将会被自动换行,每行最多76个字符

// 解码(MIME 解码器会自动忽略换行符)
byte[] decodedBytes = Base64.getMimeDecoder().decode(encodedString);
String decodedString = new String(decodedBytes, StandardCharsets.UTF_8);
System.out.println("MIME Decoded:\n" + decodedString);
// 输出应与 originalInput 完全相同
注意
- 安全性误区:Base64 仅仅是编码(Encoding),不是加密(Encryption)。任何人都可以轻易将其解码还原。切勿使用 Base64 来存储密码等高度敏感信息,应使用哈希算法(如 BCrypt)或对称/非对称加密。
- 处理 null:向 Base64 类的方法传入 null 参数会抛出 NullPointerException。
6. 新的 javadoc 功能
对 Javadoc 工具进行了多项重要更新,使其在可编程性、内容检查、文档结构和标签语义等方面都更加强大。
(1)DocTree API 与 Javadoc Access API,让开发者能以编程方式更深入地操作 javadoc 注释。
- DocTree API (com.sun.source.doctree):允许你将 javadoc 注释解析为抽象语法树(AST),从而可以遍历和访问注释中的每一个结构元素(如 @param 标签、{@code} 内联标签等)
kotlin
import com.sun.source.doctree.DocTree;
import com.sun.source.doctree.ParamTree;
import com.sun.source.util.DocTreeScanner;
import com.sun.source.util.DocTrees;

// ... 在 Doclet 中
public class CustomDoclet {
    public static boolean start(RootDoc root) {
        DocTrees trees = root.getDocTrees();
        for (ClassDoc classDoc : root.classes()) {
            for (MethodDoc methodDoc : classDoc.methods()) {
                // 获取方法注释的 DocTree
                DocCommentTree docTree = trees.getDocCommentTree(methodDoc);
                if (docTree != null) {
                    // 使用 DocTreeScanner 遍历所有 DocTree 节点
                    docTree.accept(new DocTreeScanner<Void, Void>() {
                        @Override
                        public Void visitParam(ParamTree node, Void p) {
                            // 处理 @param 标签
                            System.out.println("参数: " + node.getName());
                            return null;
                        }
                    }, null);
                }
            }
        }
        return true;
    }
}- Javadoc Access API (javax.tools 包扩展):允许你在 Java 应用程序内部直接调用 javadoc 工具,而无需启动一个新的进程。这使得将文档生成集成到构建工具或 IDE 插件中变得更加容易和高效。
java
import javax.tools.DocumentationTool;
import javax.tools.ToolProvider;
import java.io.File;
import java.util.Arrays;

public class RunJavadoc {
    public static void main(String[] args) {
        DocumentationTool tool = ToolProvider.getSystemDocumentationTool();
        // 设置源文件路径和输出目录等
        Iterable<? extends File> files = Arrays.asList(new File("src/main/java/MyClass.java"));
        DocumentationTool.DocumentationTask task = tool.getTask(null, null, null,
                MyClass.class, Arrays.asList("-d", "docs"), files);
        task.call(); // 执行 javadoc
    }
}
(2)新增文档标签:@apiNote, @implSpec, @implNote。
- @apiNote (API Notes):用于提供关于 API 的附加说明、设计意图或使用示例。
- @implSpec (Implementation Specification):用于描述默认方法(Default Methods)的实现规范。它告诉子类开发者如果重写该方法需要遵守什么契约。
- @implNote (Implementation Notes):用于说明当前特定实现的细节(如性能特征、线程安全性等),这些信息可能在不同版本或不同厂商的实现中有所不同。
php
/**
 *
 * @apiNote 使用此类时,请注意线程安全问题。
 * @implSpec 子类必须实现 {@link #doWork()} 方法。
 */
public class MyClass {
    /**
     * 执行某项操作。
     *
     * @implNote 当前实现是同步的,未来版本可能会优化为异步。
     */
    public void doWork() {
        // ...
    }
}
(3)动态方法过滤功能 (Dynamic Filtering)。
在类的方法列表中,新增了多个选项卡(Tabs),例如:
- 静态方法 (Static)
- 实例方法 (Instance)
- 抽象方法 (Abstract)
- 具体方法 (Concrete)
- 已弃用的方法 (Deprecated)
用户点击这些选项卡时,页面会通过内嵌的 JavaScript 动态过滤并显示对应类型的方法,极大地提升了在庞大类中查找文档的效率。
7. 并发工具增强 java.util.concurrent
对 java.util.concurrent 包进行了一次重大增强,引入了 CompletableFuture 为异步编程带来了范式级的改变,新增了更高效的读写锁 StampedLock 和高性能计数器 LongAdder 等工具。
(1)CompletableFuture:声明式异步编程的基石。
- 非阻塞:通过回调(thenApply, thenAccept 等)替代了 Future.get() 的阻塞等待。
- 异常处理:提供了 exceptionally、handle、whenComplete 等方法,能优雅地处理异步流程中的错误。
- 异步执行:提供 runAsync(无返回值)和 supplyAsync(有返回值)方法,默认使用 ForkJoinPool.commonPool(),也支持传入自定义线程池。
- 可组合:可以将多个异步任务通过 thenCompose、thenCombine、allOf 等方法灵活地组合起来。
java
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;

public class CompletableFutureDemo {
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        // 1. 启动一个异步任务,模拟耗时计算
        CompletableFuture<Integer> future = CompletableFuture.supplyAsync(() -> {
            try {
                Thread.sleep(1000); // 模拟耗时操作
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            return 20;
        });

        // 2. 链式调用:当 future 完成后,对其结果进行转换和消费
        CompletableFuture<Void> resultFuture = future
                .thenApply(result -> result * 2)          // 将结果乘以 2
                .thenAccept(finalResult ->                // 消费最终结果
                        System.out.println("计算结果: " + finalResult)
                )
                .exceptionally(ex -> {                    // 异常处理
                    System.err.println("发生异常: " + ex.getMessage());
                    return null;
                });

        // 等待整个异步流程执行完毕
        resultFuture.get();
    }
}
(2)StampedLock:支持乐观读的高性能锁。引入的一种新型读写锁机制,旨在替代传统的 ReadWriteLock,在读多写少的场景下提供更好的并发性能。提供三种模式:
- 写锁 (Writing):writeLock() 方法获取独占锁,返回一个票据(stamp)。与 ReentrantReadWriteLock 类似,获取写锁时,所有读锁和乐观读都会失败。
- 读锁 (Reading):readLock() 方法获取共享锁,返回一个票据。这是一种悲观读锁,会阻塞写锁的获取。
- 乐观读 (Optimistic Reading):tryOptimisticRead() 方法返回一个票据。它不会阻塞写锁,因此性能极高。
java
private final StampedLock sl = new StampedLock();
private double x, y;

// 写操作:使用写锁
void move(double deltaX, double deltaY) {
    long stamp = sl.writeLock();
    try {
        x += deltaX;
        y += deltaY;
    } finally {
        sl.unlockWrite(stamp);
    }
}

public double distanceFromOrigin() {
    // 1. 尝试获取乐观读锁(不阻塞,返回一个票据)
    long stamp = sl.tryOptimisticRead();

    // 2. 将共享变量读取到局部变量中
    double currentX = x, currentY = y;

    // 3. 验证票据是否依然有效(期间是否有其他线程获取了写锁)
    if (!sl.validate(stamp)) {
        // 4. 如果无效,说明数据被修改过,退化为获取悲观读锁
        stamp = sl.readLock();
        try {
            currentX = x; currentY = y;
        } finally {
            sl.unlockRead(stamp);
        }
    }

    // 5. 使用安全的局部变量进行计算
    return Math.sqrt(currentX * currentX + currentY * currentY);
}
(3)LongAdder 与 LongAccumulator:高并发下的计数器,专为高并发场景下的统计(如计数、求和)而设计。
- LongAdder:内部会动态维护一个变量集合(Cell数组),让不同的线程更新不同的 Cell,从而大幅减少 CAS 自旋竞争,显著提升吞吐量。
- LongAccumulator:它是LongAdder的泛化版本。它允许你提供一个 LongBinaryOperator 函数来定义如何累积值,而不仅仅是简单的加法。
ini
LongAdder counter = new LongAdder();

// 多线程并发累加(内部自动分段,减少竞争)
counter.increment();
counter.add(10);

// 获取当前总和(非原子快照,适用于统计场景)
long total = counter.sum();

// 获取总和并重置(常用于周期性统计,如每分钟统计一次请求数)
long snapshot = counter.sumThenReset();
(4)ConcurrentHashMap 的大幅增强。
- 批量数据操作:新增了 forEach、search 和 reduce 等系列方法,支持对映射中的元素进行并行的遍历、查找和规约操作。
- 原子性的 compute 方法:增强了 compute、computeIfAbsent、computeIfPresent 等方法,用于原子性地更新键值对。 -其他方法:还增加了 mappingCount()(返回映射数量,类型为 long)和 newKeySet()(创建一个由 ConcurrentHashMap 支持的线程安全 Set)等实用方法。
javascript
// ❌ 错误示范:高并发下使用 HashMap 或 synchronizedMap
Map<String, Integer> map = new HashMap<>(); // 线程不安全
Map<String, Integer> syncMap = Collections.synchronizedMap(new HashMap<>()); // 性能差

// ✅ 优化做法:高并发场景使用
ConcurrentHashMap Map<String, Integer> concurrentMap = new ConcurrentHashMap<>();
8. 并行数组排序 (Parallel Array Sorting)
提供 parallelSort() 方法,旨在充分发挥多核处理器的性能优势,显著加速大型数组的排序操作。
在 Java 8 之前,Arrays.sort() 采用的是传统的串行排序算法(如双轴快速排序或 TimSort)。当面对海量数据时,单核处理成为性能瓶颈。
parallelSort() 的核心算法是并行-归并排序 (Parallel Sort-Merge),并深度结合了 Fork/Join 框架。将大数组不断拆分为子数组,分配给线程池中的多个线程并行排序,最后再将排好序的子数组合并。对于这些子数组的排序,最终会调用 Arrays.sort() 方法来完成。Arrays.sort() 本身使用的是双基准快速排序(Dual-Pivot Quicksort) 算法。
(1)全量并行排序。对整个数组进行升序并行排序。支持所有基本数据类型(如 int\[\], double\[\])以及实现了 Comparable 接口的对象数组。
ini
// 1. 对 int 数组进行并行排序
int[] numbers = {22, 89, 1, 32, 19, 5};
// 使用并行排序
Arrays.parallelSort(numbers);

System.out.println(Arrays.toString(numbers));
// 输出: [1, 5, 19, 22, 32, 89]


// 2. 对 String 数组(对象数组)进行并行排序
String[] fruits = {"banana", "apple", "pear", "orange"};
Arrays.parallelSort(fruits);

System.out.println(Arrays.toString(fruits));
// 输出: [apple, banana, orange, pear](2)指定范围并行排序。仅对数组中[fromIndex, toIndex)范围内的元素进行并行排序,其余元素保持原位。
ini
int[] numbers = {22, 89, 1, 32, 19, 5};

// 仅对索引 1 到 4(即 89, 1, 32, 19)进行并行排序
Arrays.parallelSort(numbers, 1, 5);

System.out.println(Arrays.toString(numbers));
// 输出: [22, 1, 19, 32, 89, 5]
(3)使用自定义比较器(Comparator)。对于对象数组,可以通过传入 Comparator 来自定义排序逻辑。
ini
import java.util.Arrays;
import java.util.Comparator;

String[] words = {"banana", "Apple", "pear", "Orange"};

// 使用自定义比较器,按字符串长度降序排序
Arrays.parallelSort(words, Comparator.comparingInt(String::length).reversed());

System.out.println(Arrays.toString(words));
// 输出: [banana, Orange, Apple, pear]
// 长度分别为6, 6, 5, 4
注意
- 数据量陷阱:不要对小数组使用并行排序。对于小型数据集,串行排序通常更快。因为并行排序涉及线程创建、任务拆分和合并的开销,数据量太小会导致这些开销远超排序本身的收益。
- 避免嵌套并行:尽量不要在并行流(parallelStream)或其他并行任务内部再次调用 parallelSort(),这会导致严重的线程饥饿和性能断崖式下降。
- 原地排序:与 Arrays.sort() 一样,parallelSort() 是原地排序(In-place sort),会直接修改传入的数组。如果需要保留原数组,请提前使用 clone() 或 System.arraycopy() 进行拷贝。
9. HashMap 性能优化
(1)链表转红黑树。
在 Java 8 之前,HashMap 处理哈希冲突的方式是在同一个哈希桶(bucket)中使用链表(Linked List) 存储所有冲突的键值对。这意味着在最坏情况下(所有键的哈希值都相同),查找一个元素的时间复杂度会退化到 O(n)。
Java 8 对此进行了根本性的改进:当单个桶(Bucket)中的链表长度超过阈值(默认为 8)时,且数组总长度大于等于 64 时,链表会转换为红黑树(Red-Black Tree),将查询时间复杂度降至 O(log n)。
适用范围:这项改进应用于 HashMap、LinkedHashMap 以及 ConcurrentHashMap。
(2)初始容量与负载因子。
HashMap 的性能主要受两个参数影响:初始容量(Initial Capacity) 和负载因子(Load Factor)。
- 负载因子 (Load Factor):衡量哈希表在容量自动增加之前可以达到的"满"的程度。默认值 0.75 在时间和空间成本之间提供了良好的平衡。不建议轻易修改。
- 初始容量 (Initial Capacity):哈希表创建时的桶数量。默认初始容量为 16。当元素数量超过:容量 × 负载因子(即 12 个),会触发 resize() 扩容操作。扩容会将容量翻倍,并重新计算所有元素的位置(Rehash),这是一个极其消耗性能的操作。
ini
// ❌ 错误示范:默认容量16,存入10000个元素会触发多次扩容
Map<String, Object> badMap = new HashMap<>();

// ✅ 优化做法:预估元素数量,避免频繁扩容
// 建议容量 = 预期元素数量 / 负载因子 + 1
// 预期存储 100 个键值对,负载因子使用默认的 0.75
// 理想容量 = 预期元素数 / 负载因子 + 1 = 100 / 0.75 + 1 ≈ 134
int expectedEntries = 100;
float loadFactor = 0.75f;
int initialCapacity = (int) (expectedEntries / loadFactor) + 1;

// 创建一个针对大量数据优化的 HashMap
Map<String, String> optimizedMap = new HashMap<>(initialCapacity, loadFactor);

// 模拟添加 100 个元素
for (int i = 0; i < expectedEntries; i++) {
    optimizedMap.put("Key" + i, "Value" + i);
}
(3)哈希算法与位运算优化。
引入了扰动函数:hash = (h = key.hashCode()) ^ (h >>> 16),让高位也参与运算,减少哈希碰撞。同时,由于数组长度始终是 2 的幂次方,定位下标时使用位运算:index = hash & (table.length - 1) 代替了低效的取模运算。
(4)扩容机制与尾插法优化。
JDK 1.7 在并发扩容时使用"头插法",会导致链表反转甚至形成环形链表,引发 CPU 100% 的死循环问题。JDK 1.8 改为了尾插法,彻底解决了死循环问题,同时优化了数据迁移算法。
三、工具与虚拟机更新
1. Nashorn JavaScript 引擎 (jjs)
它是由 Java 语言开发的 JavaScript 引擎,是 JDK 8 中内置的唯一 JavaScript 引擎,无需额外安装即可使用。允许开发者在 JVM 上无缝运行 JavaScript 代码,并实现 Java 与 JavaScript 之间的深度互操作。
jjs 是用于启动 Nashorn 引擎的命令行工具,可以执行脚本文件或进入交互式 Shell。
shell
# 执行脚本文件
jjs script.js

# 进入交互式 Shell
jjs
jjs> print('Hello');
(1)在 Java 中调用 JavaScript。
java
import javax.script.ScriptEngine;
import javax.script.ScriptEngineManager;

public class NashornJavaDemo {
    public static void main(String[] args) throws Exception {
        // 1. 创建脚本引擎管理器
        ScriptEngineManager manager = new ScriptEngineManager();

        // 2. 获取 Nashorn 引擎实例
        ScriptEngine engine = manager.getEngineByName("nashorn");

        // 3. 执行 JS 代码并获取返回值
        Integer result = (Integer) engine.eval("10 + 2");
        System.out.println("JS 计算结果: " + result); // 输出: 12

         engine.eval("print('Hello from JavaScript!');");

         // 4. 执行 JavaScript 文件
         engine.eval(new FileReader("script.js"));

         // 5. 调用 JavaScript 函数
         engine.eval("function greet(name) { return 'Hello, ' + name + '!'; }");
         Invocable invocable = (Invocable) engine;
         Object result = invocable.invokeFunction("greet", "Java");
         System.out.println(result); // 输出: Hello, Java!
    }
}
(2)在 JavaScript 中调用 Java。
go
// 1.使用 Java.type() 获取 Java 类
var ArrayList = Java.type('java.util.ArrayList');
var list = new ArrayList();
list.add('Hello');
list.add('World');
print(list); // 输出: [Hello, World]

// 2.实现 Java 接口
var Runnable = Java.type('java.lang.Runnable');
var r = new Runnable(function() {
    print('Running from JavaScript!');
});
r.run(); // 输出: Running from JavaScript!
注意
需要特别注意,Nashorn 引擎和 jjs 工具已在 JDK 11 中被标记为"弃用"(Deprecated),并最终在 JDK 15 中被完全移除。
2. 类依赖分析器 (jdeps)
用于分析 Java 类文件(.class 或 .jar)的静态依赖关系,用于在包级别或类级别显示 Java 类文件的依赖关系。它是一个静态分析工具,它通过解析字节码来推断依赖关系,因此分析结果可能无法覆盖运行时通过反射等动态方式产生的依赖。
bash
# 1. 分析单个类的依赖
$ jdeps com/example/Main.class
com.example.Main -> java.base/java.io
com.example.Main -> java.base/java.util

# 2. 打印 JAR 包的依赖摘要
$ jdeps -summary myapplication.jar
myapplication.jar -> java.base
myapplication.jar -> java.logging

# 3. 生成 DOT 格式文件,用于可视化依赖图
$ jdeps -dotoutput ./deps myapplication.jar

# 4. 检测 JDK 内部 API 使用
jdeps -jdkinternals myapplication.jar

# 5. 输出所有类级别的依赖/详细类级别依赖
jdeps -verbose myapplication.jar

# 6. 生成模块描述符
jdeps --generate-module-info ./modules myapplication.jar
3. JVM 诊断命令工具 (jcmd)
是 JDK 提供的一个多功能命令行工具,用于向运行中的 Java 虚拟机(JVM)发送诊断命令请求。jcmd 的核心用途是故障排除和诊断,核心特征:
- 本地运行限制:必须在与目标 JVM 相同的机器上运行,且执行用户需与 JVM 进程用户一致。
- 进程定位:支持通过进程 ID(PID)或主类名(Main-class)来定位目标 JVM。
- 动态命令:支持查看帮助、内存分析、线程转储、GC 操作、JFR(Java Flight Recorder)控制等多种诊断命令。
shell
# 列出本机所有 Java 进程的 PID、主类及启动参数
$ jcmd -l

# 查看指定进程支持的所有 jcmd 命令
$ jcmd <pid> help

# 打印所有线程的堆栈跟踪
$ jcmd <pid> Thread.print
# 打印所有线程的调用栈,-l 选项会附带锁的附加信息
$ jcmd <pid> Thread.print -l > threaddump.log

# 显示堆及元空间的使用信息
$ jcmd <pid> GC.heap_info
# 生成堆转储文件
$ jcmd <pid> GC.heap_dump /tmp/heap.hprof

# 查看 JVM 启动参数
$ jcmd <pid> VM.flags
# 打印完整的 HotSpot 和 JDK 版本 ID
$ jcmd <pid> VM.version
# 打印 JVM 的启动命令行
$ jcmd <pid> VM.command_line
4. Java Mission Control 性能诊断套件 (jmc)
是一个面向 HotSpot JVM 的全新 JDK 性能分析和诊断工具平台,其核心设计目标是最大限度地减少传统分析工具通常带来的性能开销。
JMC 是一个为生产环境而生的高级诊断工具链。它通过 JFR 以极低开销捕获详尽的运行时事件,再借助 JMC 图形化界面对这些数据进行多维度的可视化分析(如代码、内存、GC、线程与 IO 等预配置标签页)。
shell
# 直接启动 JMC
$ jmc

# 启动时打开一个已保存的 Flight Recording 文件
$ jmc -open /path/to/recording.jfr

# 启动时覆盖 JVM 参数(例如增加 JMC 自身的内存)
$ jmc -vmargs -Xmx2g
5. 移除永久代 PermGen
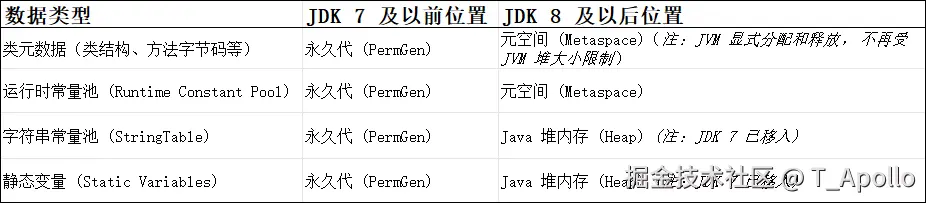
核心是用位于本地内存(Native Memory)的元空间(Metaspace)取代了原先位于Java堆中的永久代(PermGen)。
JDK 7 及以前,类元数据(Class Metadata)、常量池、静态变量等存储在 JVM 堆内存中一块被称为"永久代"的固定区域。由于它的大小需要在启动时通过 -XX:MaxPermSize 固定,且无法动态扩展,在大量使用动态代理、反射或频繁热部署的现代应用(如Spring框架)中,极易触发java.lang.OutOfMemoryError: PermGen space错误。为了解决永久代的固有限制,JDK 8 将方法区的实现从 JVM 堆内存中剥离,改为使用操作系统的本地内存(Native Memory)。
JVM 参数与代码配置说明:
ini
# ❌ JDK 7 及之前的配置
java -Xms2g -Xmx2g -XX:PermSize=256m -XX:MaxPermSize=512m -jar app.jar

# ✅ JDK 8+ 的等效配置
java -Xms2g -Xmx2g -XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m -jar app.jar


# JDK 8 推荐的标准 JVM 启动参数组合
java -Xms2g -Xmx2g \
     -XX:MetaspaceSize=256m \
     -XX:MaxMetaspaceSize=512m \
     -jar my-application.jar
调优建议:
- 由于调整元空间大小需要 Full GC,这是一个非常昂贵的操作。建议将 MetaspaceSize 和 MaxMetaspaceSize 设置为相同的值,并设置得比初始值大,以避免运行期动态调整带来的性能损耗
- 虽然元空间默认没有上限(受限于系统物理内存),但如果存在类加载器泄漏(ClassLoader Leak),或者动态生成的类过多且未被卸载,元空间依然会持续增长,最终抛出
java.lang.OutOfMemoryError: Metaspace。 - 在 Docker 等容器环境中,由于元空间使用的是宿主机本地内存,如果不设置 MaxMetaspaceSize,JVM 可能会消耗超出容器内存限制的本地内存,导致容器被 OOMKill。因此,在容器化部署时,务必显式配置 -XX:MaxMetaspaceSize。