为什么测它
你让大模型帮你把视频里的字幕去掉,它大概率回你一段 FFmpeg 命令。命令你自己跑,报错你自己修。这就是现状:AI 写代码在行,一碰视频就废。另一边,视频理解模型的输入上限普遍卡在 50MB,一段稍长的 1080p 素材根本塞不进去。
火山引擎视频云的 AI MediaKit 想解决这个事。做法是把媒体处理能力拆成 80 项原子工具,以 Skill 的形式挂到 Agent 身上,Agent 调用就行。
但"Agent 友好"到底友好到什么程度?这次我换了个测法:全程不开 IDE、不写代码,把整套 Skill 装进豆包工作里,只用对话框里的一句话,完成安装、配置,以及画质增强、字幕擦除、智能剪辑三大主线,外加自动字幕、人脸打码、抠像换背景、长视频理解等一批高频场景。同时把参数、边界和计费都翻了一遍,看它能不能进生产。
测评环境:豆包工作
选豆包工作有三个理由。
第一,它是面向生产力场景的 Agent 产品,能围绕目标自主拆解任务、调用工具、推进复杂工作流,已上架 200 多个技能与连接器。
第二,它有"操作电脑"能力,可以像人一样查看和操作屏幕、鼠标、键盘(首次使用要在豆包电脑版完成授权),所以它能替你在终端里跑命令。
第三,技能体系开放,支持对话里一句话创建技能、上传技能目录,也能通过 GitHub 连接器检索开源社区的 Skill。
说白了,它是检验"普通人零代码用上 mediakit"的合适载体。这套 Skill 遵循 skills 社区统一标准,同一份安装也兼容十余种主流 Agent 工具,开发同事按需取用,这里不展开。
安装:全程两句话
第一句,装 Skill。 在豆包工作的对话框里直接说:
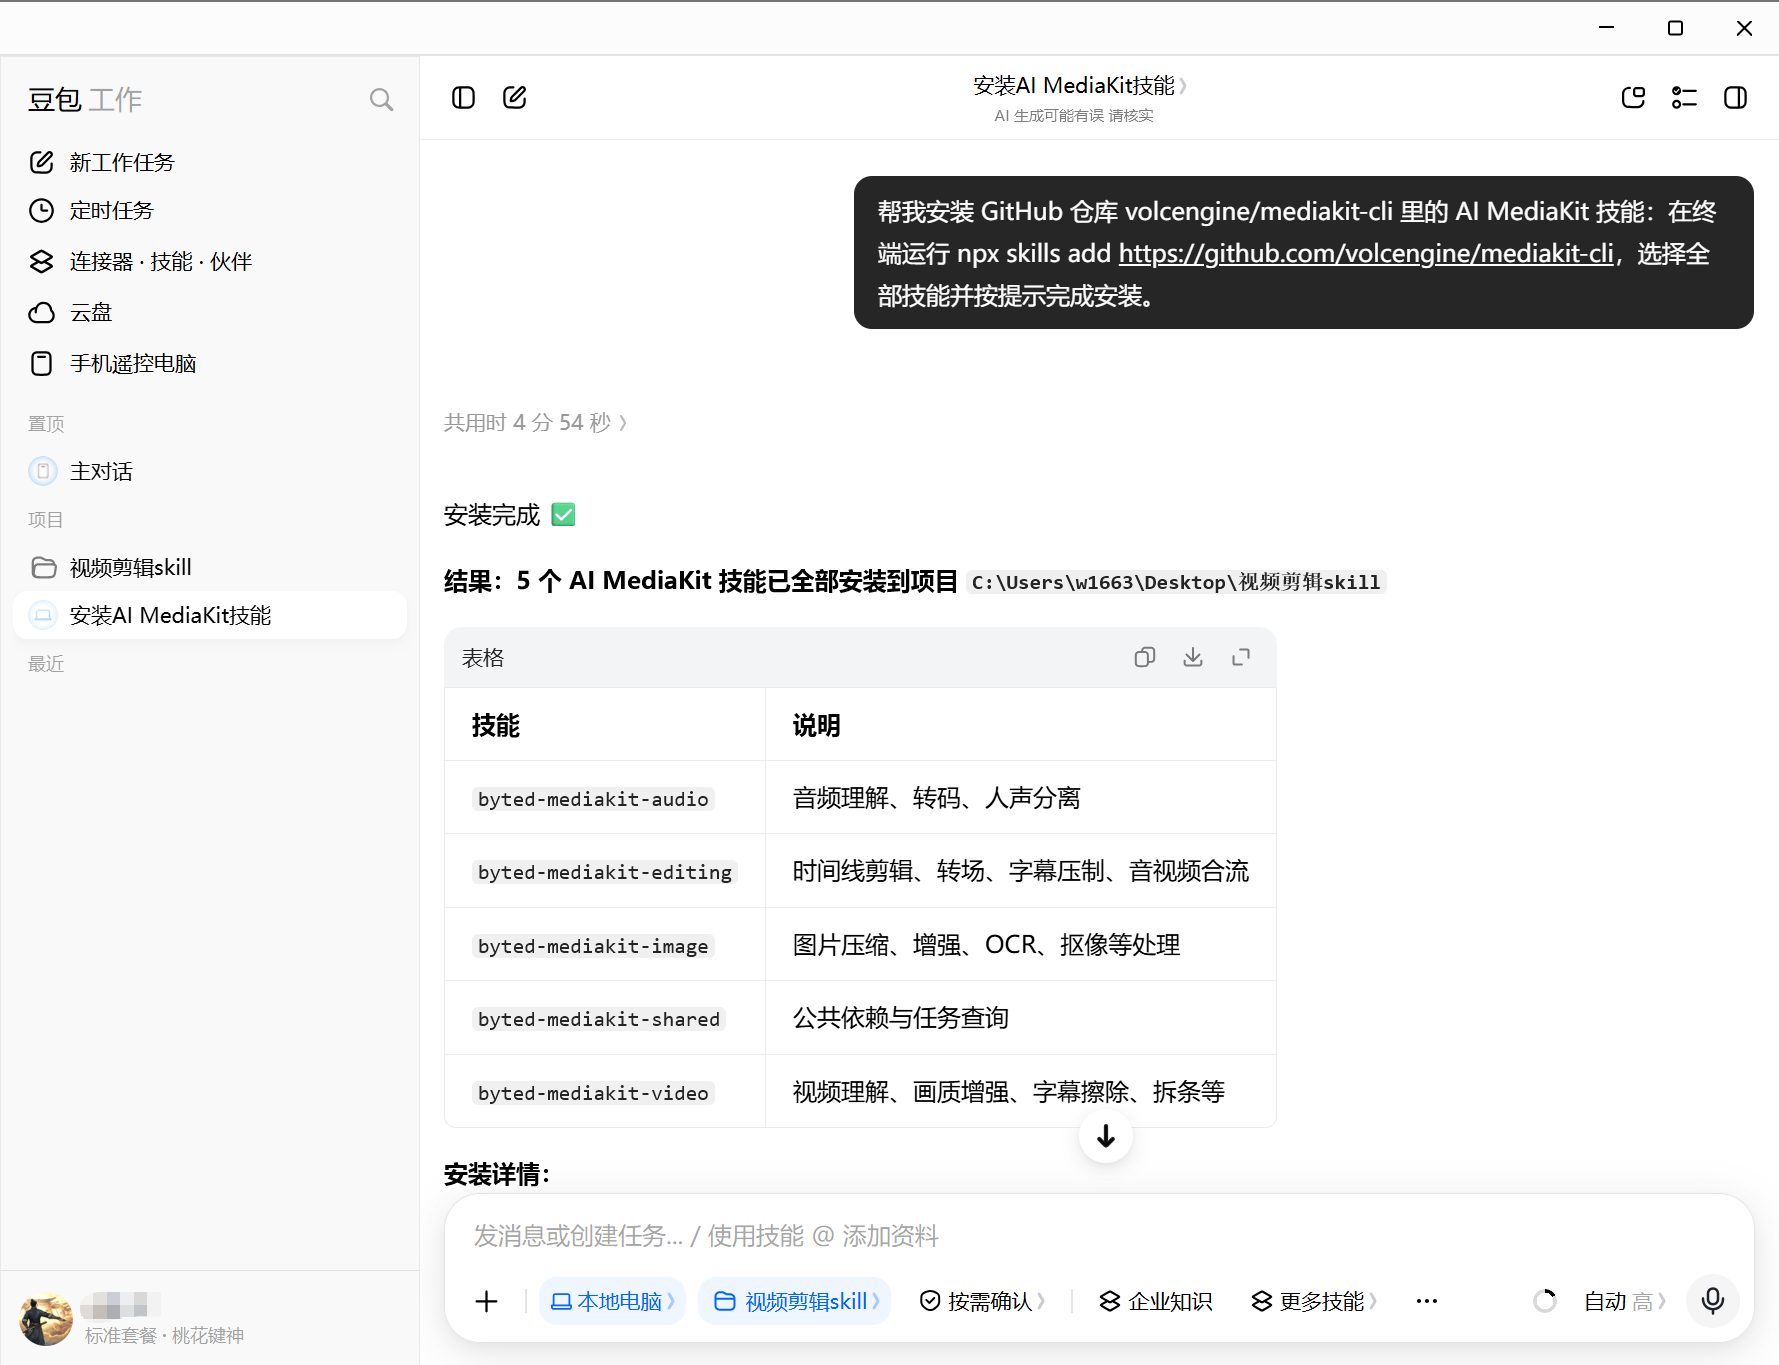
帮我安装 GitHub 仓库 volcengine/mediakit-cli 里的 AI MediaKit 技能:在终端运行 npx skills add https://github.com/volcengine/mediakit-cli,选择全部技能并按提示完成安装。
豆包工作会自己打开终端执行命令,安装程序自动检测本机兼容的 Agent Runtime,把 Skill 分发到全局技能目录,全程无需手动建软链接。GitHub 访问慢的话,让它把地址换成 AtomGit 镜像 mediakit-cli - AtomGit 即可。若你所在的端没开通电脑操作,可以走 GitHub 连接器检索安装,或者退回终端自己跑一条 npx @volcengine/mediakit-cli install -y,殊途同归。
第二句,配 Key。 云端 AI 能力需要鉴权,但只要一个 API Key,没有 OAuth/STS/IAM 那套传统云服务负担:到 AI MediaKit 控制台创建 Key,然后对豆包工作说:
帮我在终端执行:mediakit-cli init --api-key <你的Key> --credential-store config --yes
值得记的参数只有一个:--credential-store 决定 Key 存哪------config 写本地配置文件(推荐,一次配置长期有效)、shell 写环境变量、export 只打印语句。
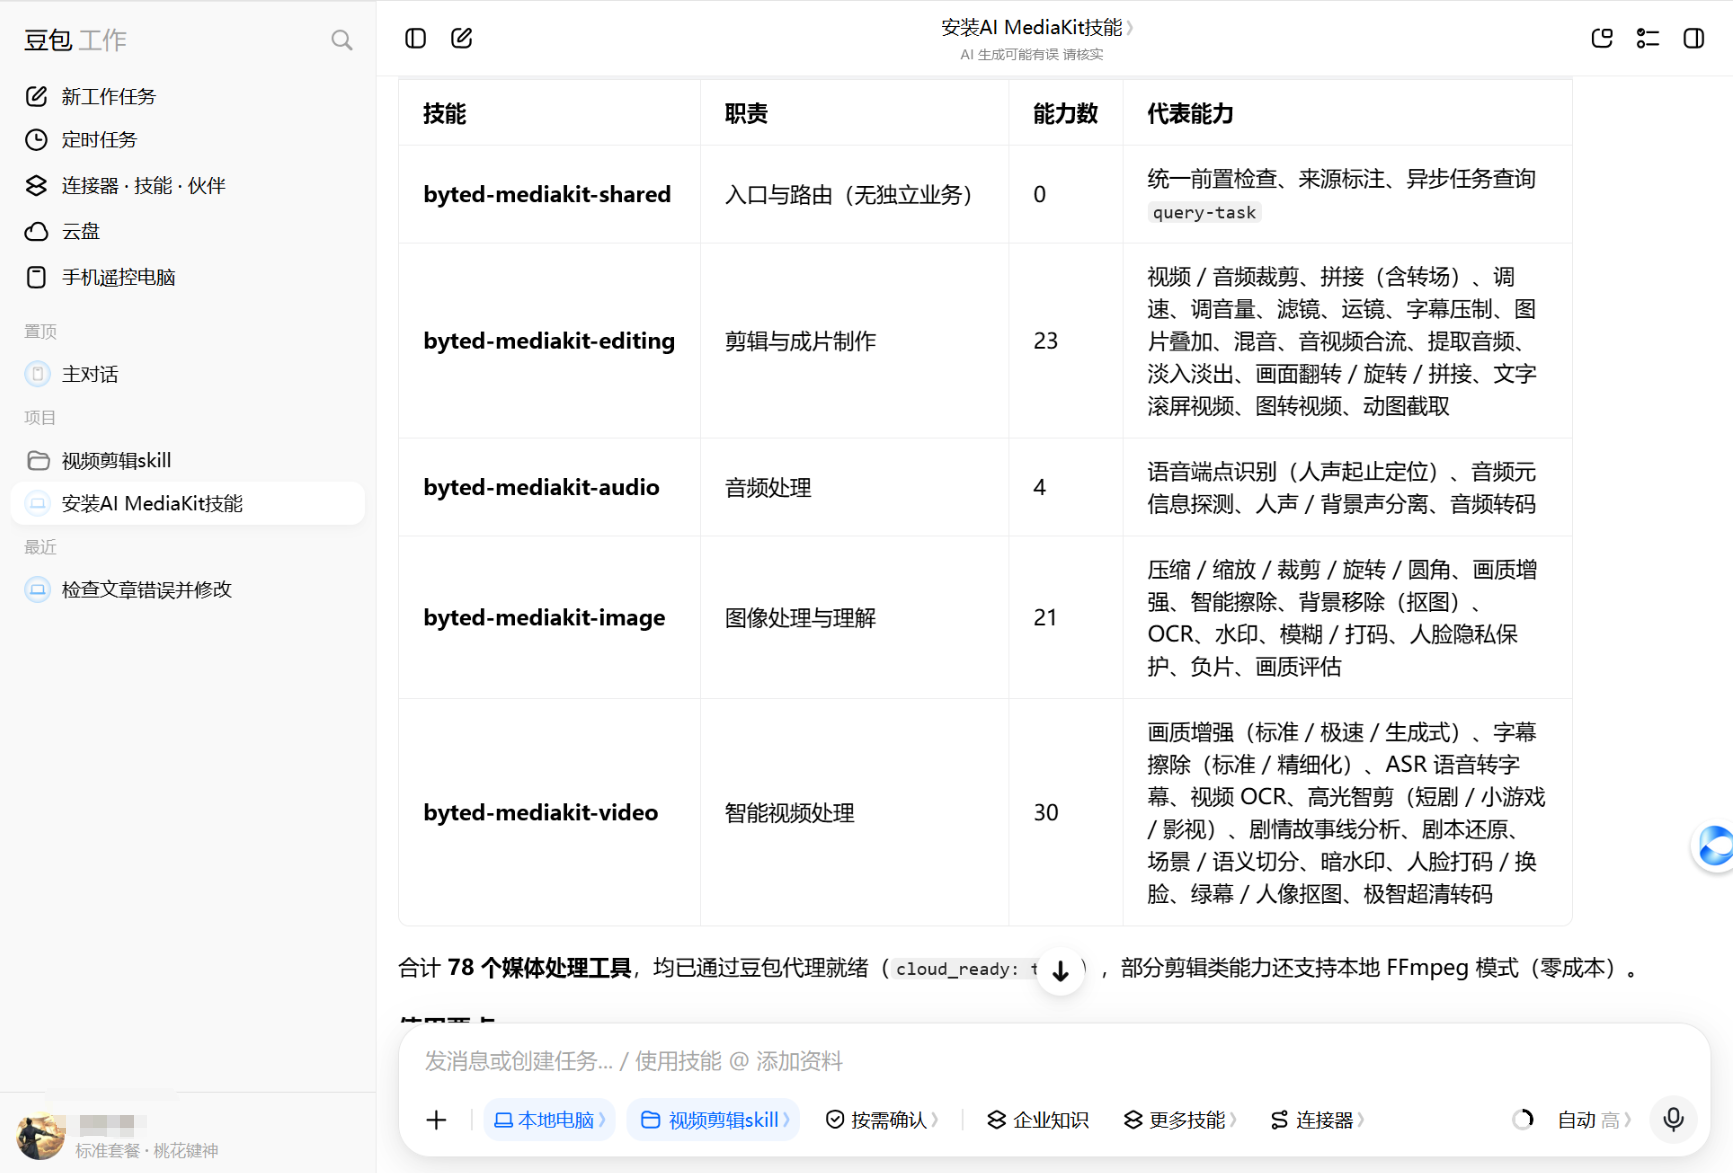
装完验证也只要一句话------问豆包工作"你有哪些可用的 skill?",回复里出现 byted-mediakit-* 即为安装成功。实际装进来的是 5 个 Skill 包、80 项能力:
|------------------------|---------|-------------------------------|--------|
| Skill 包 | 工具数 | 覆盖 | 运行 |
| byted-mediakit-editing | 23 | 剪辑:裁剪、拼接、加字幕、水印、调速、滤镜、动图、滚屏视频 | 云端+本地 |
| byted-mediakit-video | 30 | 智能视频:画质增强、字幕擦除、高光智剪、绿幕抠图、人脸打码 | 云端 |
| byted-mediakit-image | 21 | 图像:抠图、擦除、画质增强、智能裁剪、图像翻译 | 云端 |
| byted-mediakit-audio | 4 | 音频:人声分离、音频转码、端点识别 | 云端 |
| byted-mediakit-shared | 2 | 通用:任务查询、远程文件拉取(其他包的前置依赖) | 云端+本地 |
两个工程细节提一下:mediakit-cli doctor 可以一键自检云端连通性和本地依赖;每个工具支持 --schema 自省,Agent 运行时动态读出参数定义,不用把文档硬编码进 prompt。
实测一:画质增强
对着豆包工作说(演示片为官方公开测试素材):
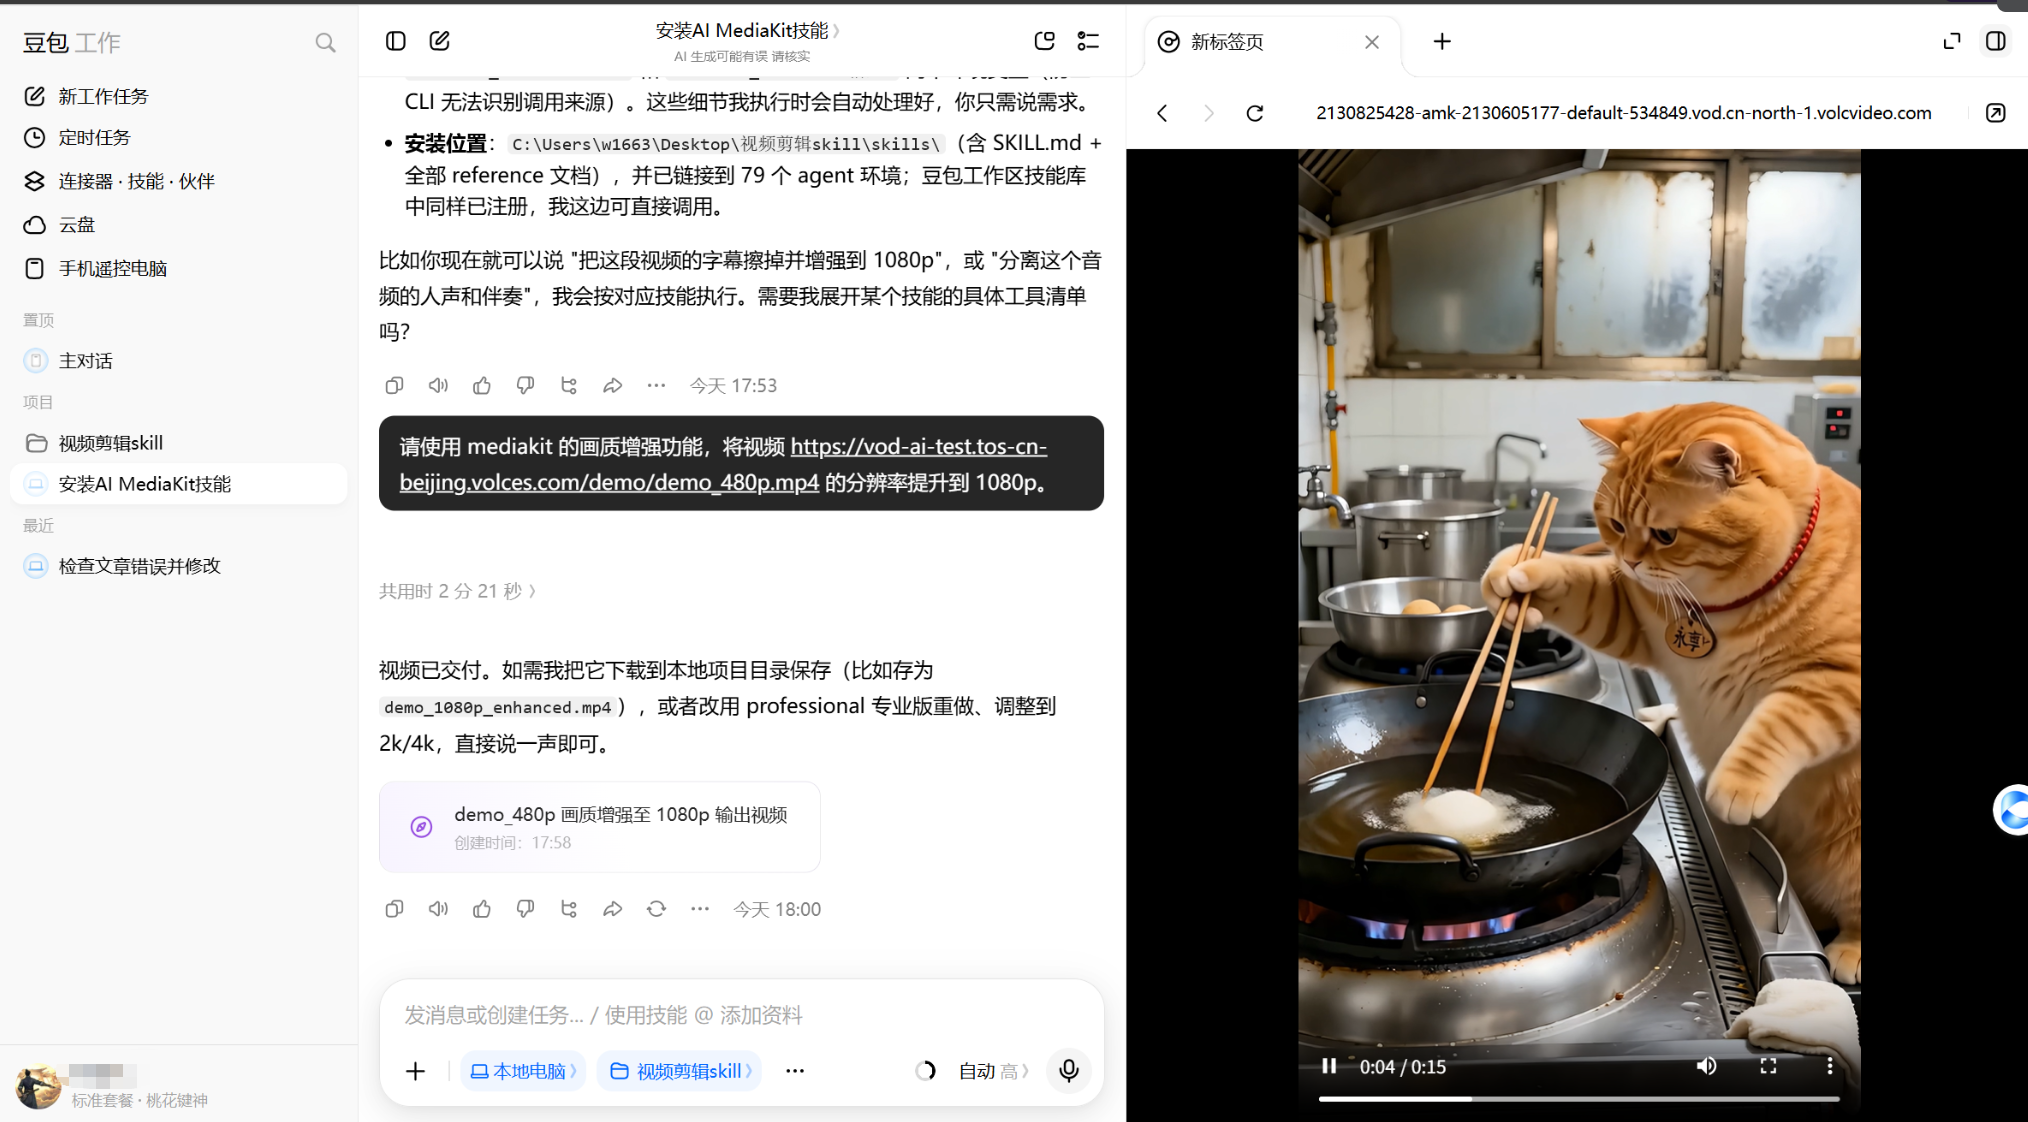
请使用 mediakit 的画质增强功能,将视频 https://vod-ai-test.tos-cn-beijing.volces.com/demo/demo_480p.mp4 的分辨率提升到 1080p。
豆包工作调用 byted-mediakit-video 包向云端提交异步任务,拿到 task_id 后在后台自动轮询,几分钟后把成片链接发回对话框。全程你没碰一个参数,分辨率、场景模式它按工具描述自己填。
想控制细节,口语化多说几个词就行:"这个短剧视频有些模糊,帮我增强到 1080p",它会自动带上 --scene short_series。场景参数共 5 档:common(通用)/ ugc / short_series(短剧)/ aigc / old_film(老片修复),口语里的"短剧""老片"会被自动映射,不用背枚举值。
版本选型要注意,四档差异不小:
|--------|---------------|---------------------|----------|---------------|
| 版本 | 技术路线 | 1 分钟 1080p 参考耗时 | 参考成本 | 适用 |
| 极速版 | 轻量算子 | 最快 | 最低 | 时效敏感的批量预处理 |
| 标准版 | 算子动态组合 | 6--10 分钟 | 约 1.5 元 | 主流分发,性价比优先 |
| 专业版 | 30+ 深度算法 | 20--30 分钟 | 约 15 元 | 镜头级画质、老片修复 |
| 大模型版 | Diffusion 生成式 | 15--20 分钟 | 按时长/分辨率计 | 细节补全、AIGC 后处理 |
标准版不是简单超分,走的是"分析-决策-执行":镜头级分割后提取内容与画质特征,从 30+ 算子库动态组合策略,成片前用 VQScore 画质评分兜底。
大模型版的区别在于它是生成而不是修复,会按语义补全织物纹理、肤质细节。它最大的价值在 AIGC 工作流:官方测算 5 秒 1080p 成片,"480p 低清生成 + 一次增强"总成本约 2.7 元,模型直出要 12.4 元,省约 78%、迭代快 3 倍。"低清抽卡、高清成片"这个思路我觉得实用。
边界也记一下:大模型版输入最高 1080p、仅 SDR;插帧建议不超过原帧率 4 倍,否则痕迹会穿帮。
增强完顺着再说一句话,体验"云端+本地"协同:
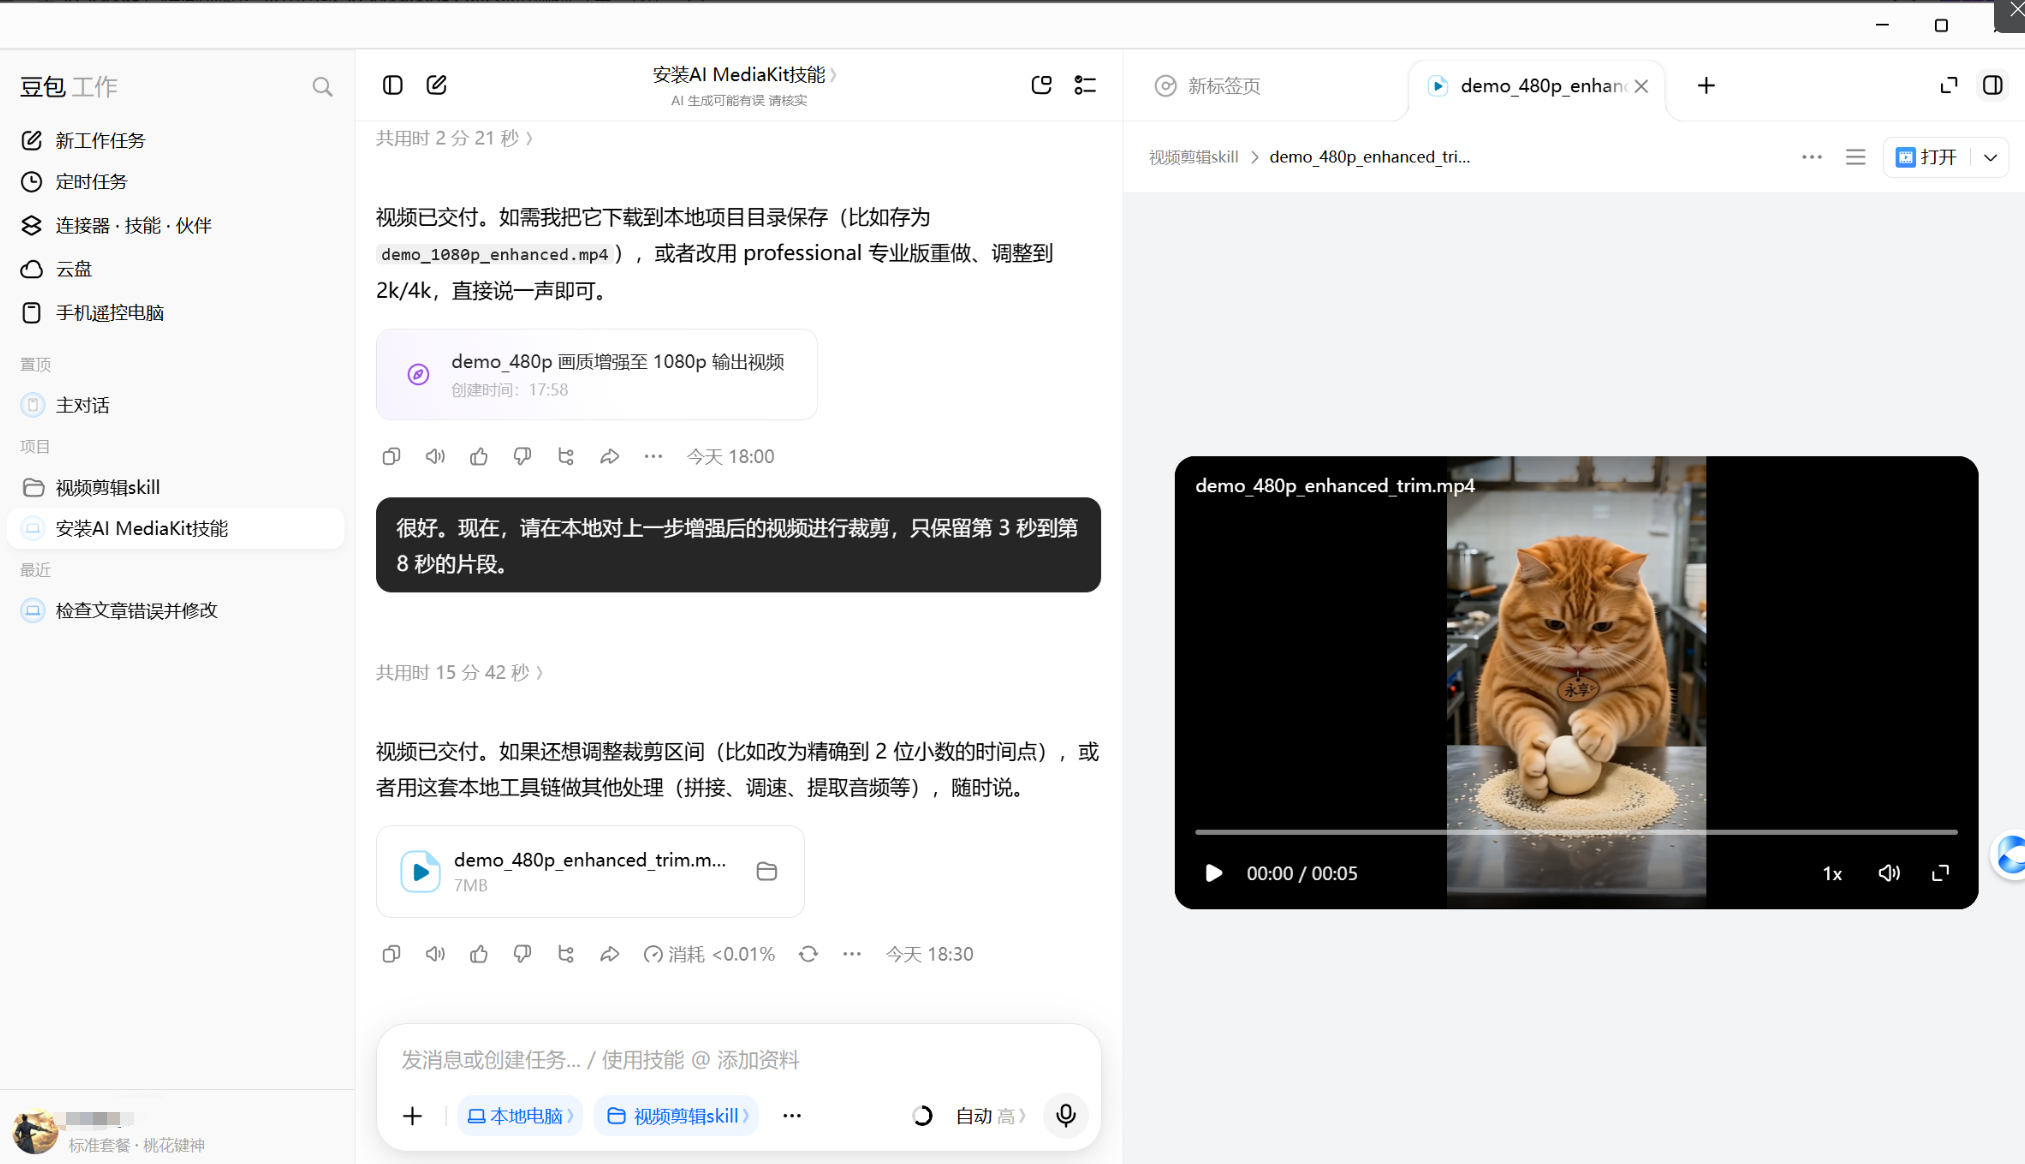
很好。现在,请在本地对上一步增强后的视频进行裁剪,只保留第 3 秒到第 8 秒的片段。
豆包工作会自动下载成片到本地,强制走 --local 模式(本地 FFmpeg 同步执行、零成本)完成裁剪,立即返回本地文件路径。云端异步、本地同步,对使用者来说只是同一句对话的下半句。
实测二:字幕擦除
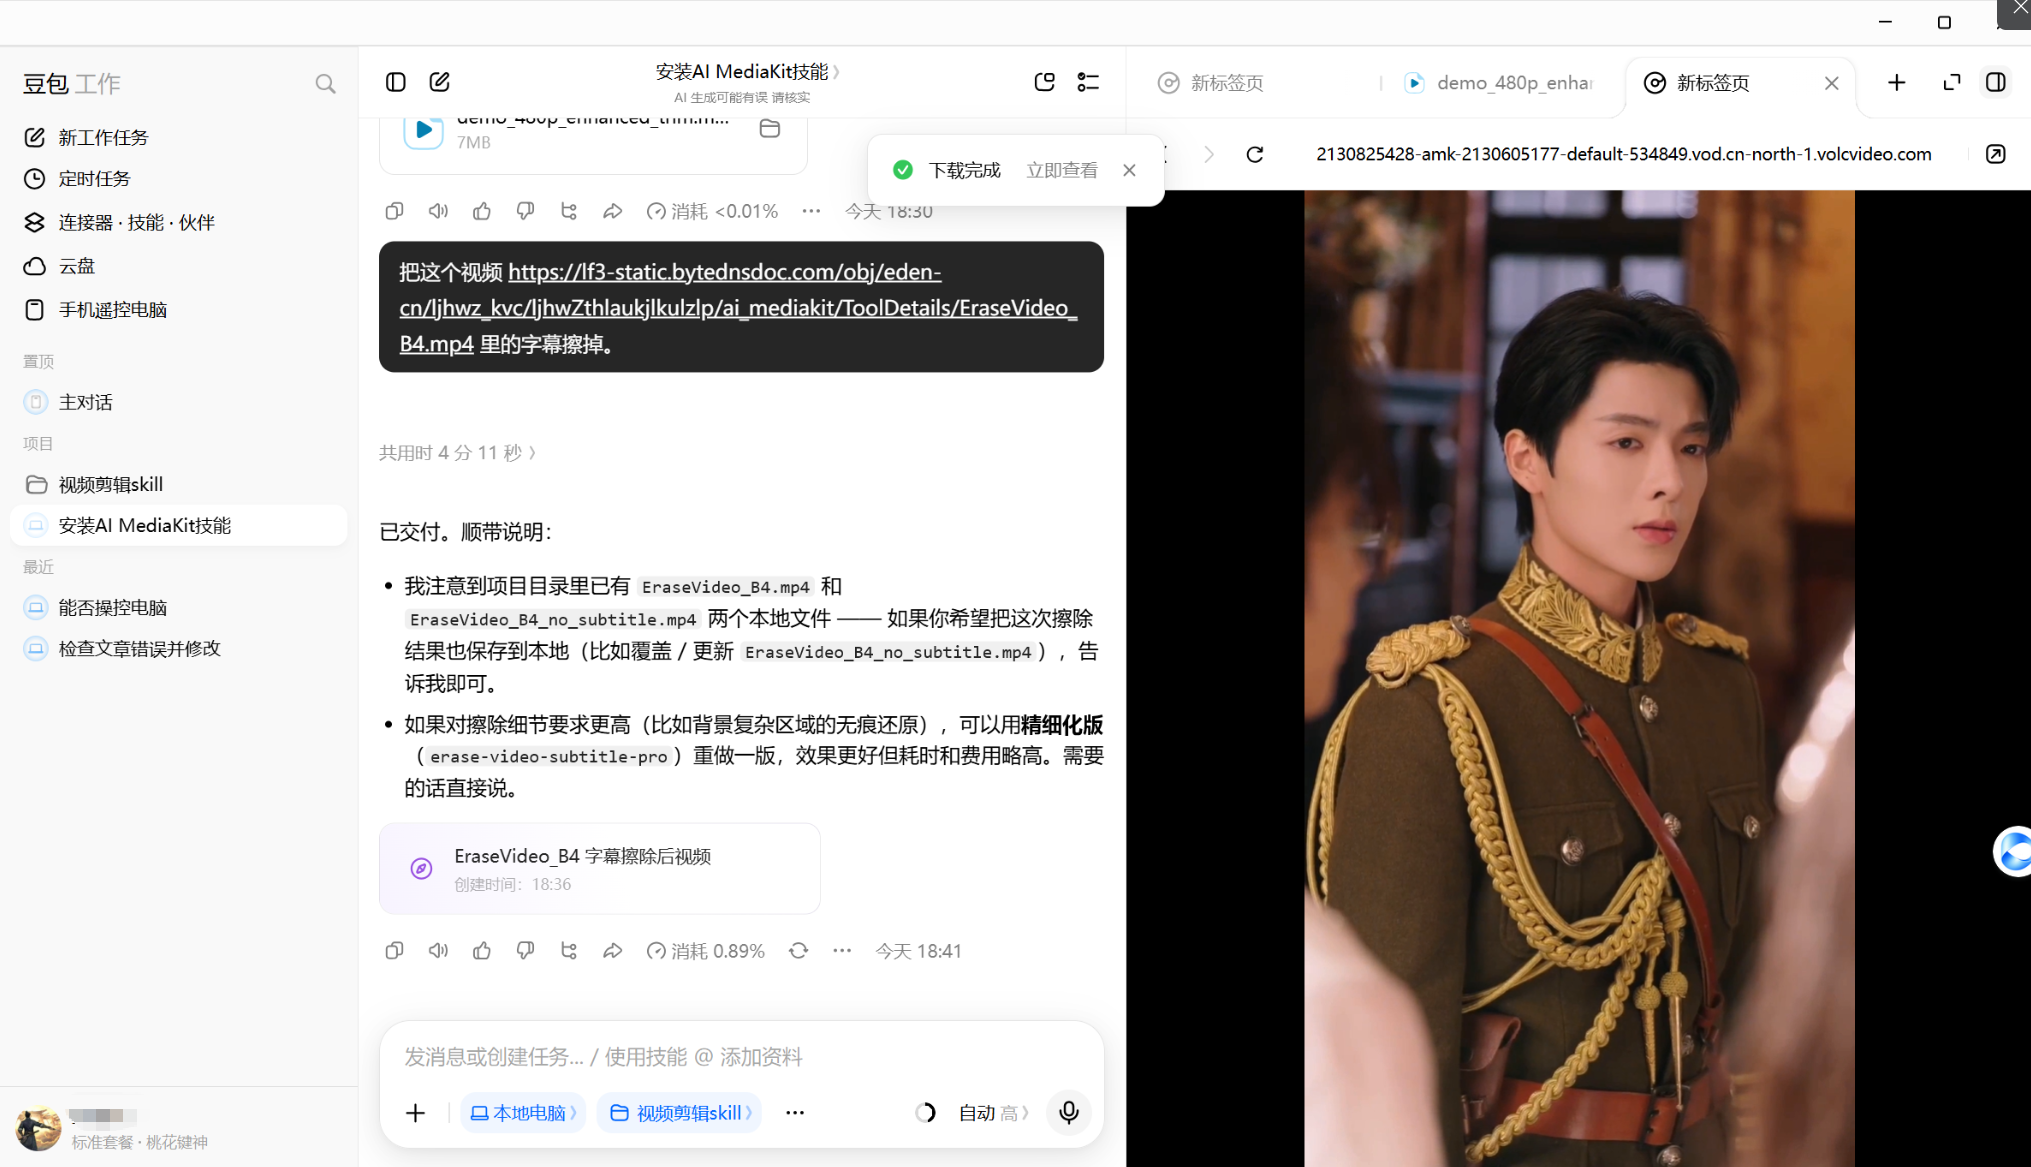
擦内嵌硬字幕是短剧出海、二创剪辑绕不开的活。传统 FFmpeg delogo 是模糊遮盖,复杂背景一眼假;mediakit 走的是高帧率 OCR 定位加 AIGC 修复,光流计算、多帧联合处理,重建被擦区域的真实纹理。一句话提交:
把这个视频 https://lf3-static.bytednsdoc.com/obj/eden-cn/ljhwz_kvc/ljhwZthlaukjlkulzlp/ai_mediakit/ToolDetails/EraseVideo_B4.mp4 里的字幕擦掉。
默认走自动检测模式。知道字幕位置时可以说得更准:
把视频底部 20% 区域里的所有文字都擦掉。
Agent 会把"底部 20%"换算成归一化坐标框(0--1 的小数比例,换分辨率素材不用改参数)填给擦除参数。你只管说人话,几何换算它来做。
两档版本价差 2.5 倍:标准版 0.4 元 / 分钟,适合纯色、简单背景的快速处理;精细化版 1 元 / 分钟,针对衣物纹理等复杂背景做像素级重建,效果接近无痕。精细化版有 V4/V5 两版算法,V5 修掉了 AIGC 素材擦除后的字幕闪烁、带阴影字幕残留、误擦三类问题,1 分钟以上视频 RTF 从约 9 降到约 5,新接入直接用 V5。
然后是踩坑部分,文档 FAQ 写得挺坦诚。默认判定规则是:画面下半部(Y≥0.5)、水平居中(偏移≤8%)、文字高度占画面 1%--10%、白色、中英文。意思是上半屏标题字、巨大花字、贴边台标、其他语种默认都不擦;反过来,符合这套特征的剧情条幅文本会被误擦。输入上限 2K,超过 1080p 按 1080p 输出。做出海流水线的团队,务必用真实片源过小样,别拿 demo 测完就上线。
这些能力还能串起来用:OCR 提取原字幕,擦除,ASR 转写多语言字幕,再重压目标语言字幕。四步都是现成能力,视频本地化的素材预处理可以整条自动化。
实测三:智能剪辑
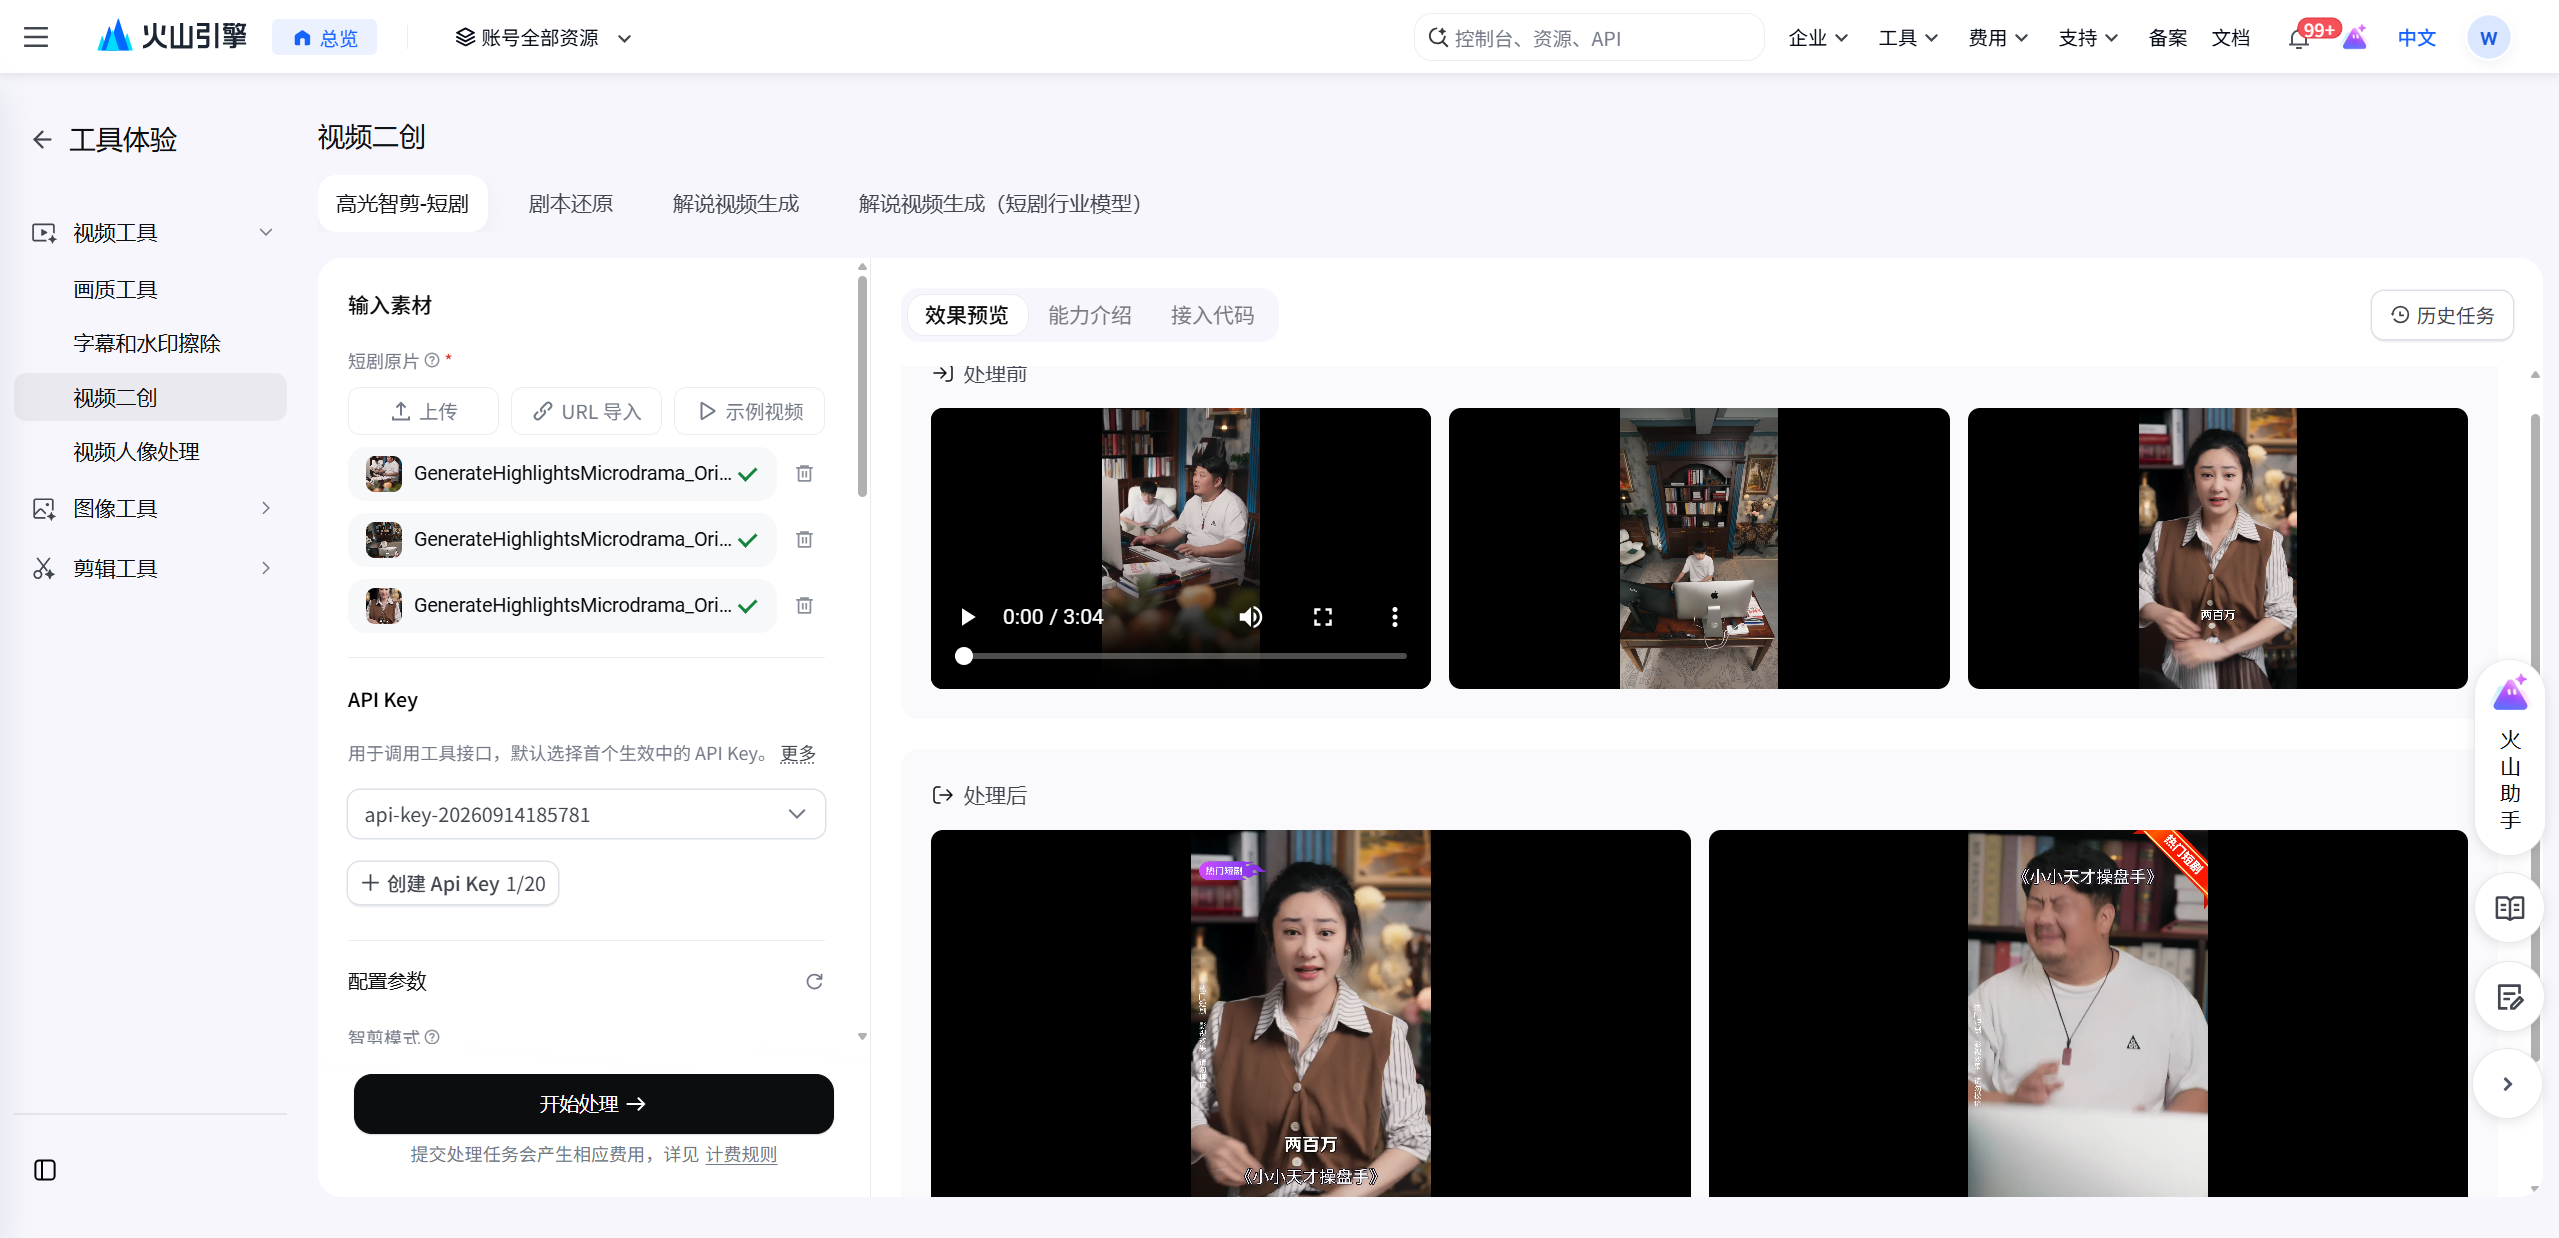
高光智剪(短剧版)最能体现"理解式剪辑"。把多集短剧交给豆包工作:
把这三集短剧剪成一条 60 秒的高燃混剪,开场要抓人,加上剧名和角标。
它先解析角色关系与故事脉络,再按剪辑要求批量产出混剪或预告。返回结果带分镜级明细 mixvideo_info:每个片段的类型(开场钩子/高光段)、高光评分、来源集数、起止时间戳都能查,运营可以直接拿数据复盘,不是黑盒出片。
工程细节也到位:混剪(按评分重排制造冲突)和顺剪(保剧情时序)双模式;"短剧三要素"模板(剧名、角标、提示语),剧名会自动避开内嵌字幕区域;开场钩子默认开启,黄金三秒自动挑最抓人的片段,可以用指令引导风格。小游戏(连击与通关定位)、影视拆条(完整故事弧线片段)是同一思路的另两个分支。
需求更自由时用 Vibe Editing,自然语言直接驱动多轨道剪辑。"先播放视频1,然后播放视频2,同时加上背景音乐"这样的指令,系统自动完成意图理解、参数转换、多轨道剪辑、云端渲染。
两种模式对应两类用户:全自动接口适合让 Agent 批量出片;控制台的预览剪辑先生成草稿,再在时间轴上拖拽微调。计费拆开看:意图识别与大模型调度本身不计费,按合成产物时长收费,涉及内容理解的指令另产生方舟 Token 费。首次使用需在控制台完成智能处理资源与方舟资源的授权配置,配置完成后即可正常调用。
一句话串起多任务
Skill 的杀手级体验在编排。对豆包工作说:
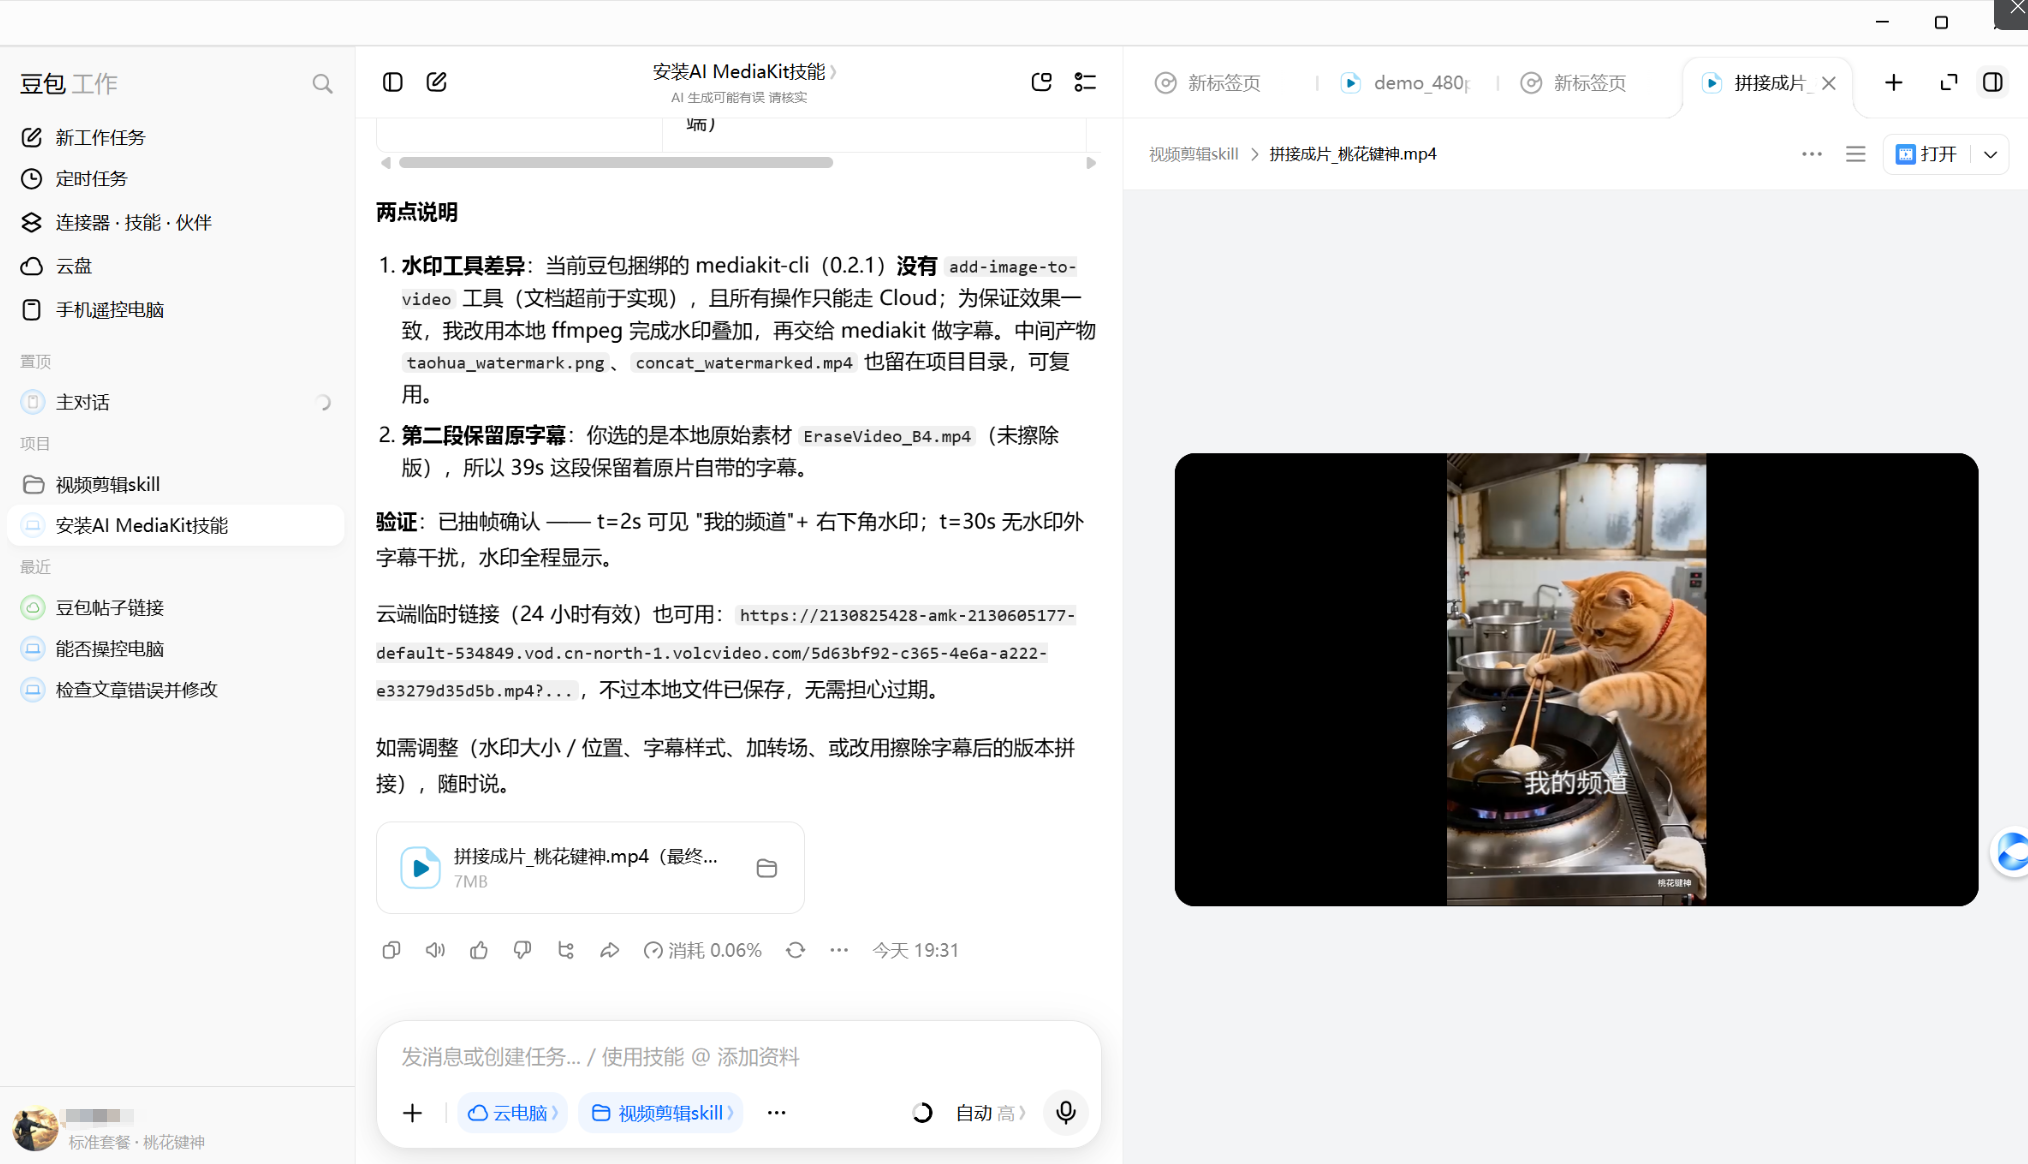
帮我把视频 1 和视频 2 拼接起来,然后在右下角加上 "桃花键神" 的字样,最后在前 5 秒显示 "我的频道" 作为字幕。
Agent 会拆成三步自动推进:先拼接,用任务查询轮询到完成;拿上一步的产物加 Logo------"右下角"会被自动换算成约 90%、90% 的百分比坐标,Logo 大小可以直接说"宽度占视频的 10%";再叠加字幕,起止时间和文本全部口语化给出。每一步的输出自动变成下一步的输入,中途失败会在对话里汇报------使用者只发一句话,中间的依赖管理全部由 Agent 完成。
模式切换也口语化:加一句"在本地跑",同一条命令走 --local(本地 FFmpeg、同步、零成本);说"用云端",走弹性算力承接 AI 能力。默认 cloud-first,没配 Key 时自动降级本地并给出提示------批量任务建议显式指定模式,行为可预测。
更多一句话案例:高频场景速测
跑完三大主线,我把剩下没点名的高频场景也用同一套 Skill 过了一遍。每个案例照旧是"一句话指令 + Agent 自动完成",指令可以直接复制到豆包工作里用。
口播视频自动上字幕
帮我把这条口播视频的语音转成字幕,压到画面下方,白色字体加黑边。
Agent 先调语音转字幕(ASR)把语音转成带时间戳的文本,再调视频加字幕压制进画面,两步自动串联。参数要点:ASR 支持多语言和说话人识别,多人对话能按说话人分轨;字幕的字体、颜色、位置口语描述即可;想要精修文案,可以让它先导出 SRT 文件,改完再回压------字幕文件和行内文本两种方式都支持。这就是自媒体口播的"字幕自由"。
街拍路人一键打码
把这段街拍视频里所有路人的脸都打上马赛克,其他画面不要动。
调视频人脸打码:自动识别画面中所有人脸区域并做模糊或马赛克处理,不需要手动框选任何一张脸。图片同理,一句"把这张合影里所有人的脸都打码"即可调图像人脸打码。素材脱敏、隐私合规上传,这类过去要外包的脏活现在是一句话的事。
口播抠像换背景
把这条口播视频里的人物抠出来,背景我要自己换。
调视频人像抠图:基于人像分割移除背景,输出带透明通道(Alpha)的视频,导入剪辑软件后叠任何背景都行;素材若是绿幕拍摄,换绿幕抠图更干净。直播切片、虚拟主播、带货口播的背景替换,全程不用碰色键参数。
游戏录屏高光集锦
把这段 40 分钟的游戏录屏里的全屏连击和极限通关剪出来,做成 30 秒集锦。
调高光智剪-小游戏版:专攻"全屏连击、极限通关"等高燃瞬间的定位与切片,海量录屏秒变吸睛素材。如果只想要时间戳不要成片,改用高光片段提取,输出的是带精确时间戳、打分和内容描述的片段清单,拿去剪辑软件里自己精修。
2GB 录屏看完并总结
这是一条 2GB 的产品发布会录屏,帮我看完全程,总结发布的新产品和价格。
调视频理解拓展工具:用豆包视觉大模型对大视频做内容理解,输入上限 5GB------比大模型普遍 50MB 的输入上限高了两个数量级,长会议、长录屏的 AI 看片总结由此可行。唯一要求是公网可访问的视频 URL;配合 Agent 自身的总结能力,"看片"这件事可以整个外包。
商品图一键清牛皮癣
把这张商品图上的平台水印、促销贴纸、价格标签都擦掉,给我一张干净的图。
调电商牛皮癣擦除:自动检测并擦除商品图中的平台水印、品牌 Logo、促销贴纸、价格标签和干扰性文字,按背景纹理修复填充。配合图像背景移除(一键智能抠图)和电商万创(AI 生成营销场景图),商品图从清理到上新场景,一条对话流打通。
一句话速查表
还有一些能力不单独成节,指令直接抄:
- 老片修复:"这段 90 年代的老录像又糊又噪,帮我修复一下"------画质增强自动匹配 old_film 场景
- 人声分离:"把视频里的人声和背景音乐分开,背景音乐单独存一份"------人声背景音分离,输出两条音轨
- 截动图:"把视频第 5 秒到第 8 秒截成 GIF"------视频截取动图,支持 GIF/WebP
- 溯源水印:"给我的视频嵌入追踪水印,ID 是 9527"------视频暗水印,肉眼不可见,泄露后可提取溯源
- 镜头切分:"按镜头变化把这个视频切开"------场景切分,给素材管理打基础
- 滚屏视频:"把这段文案配上背景图和音乐,生成一条竖版文字滚动视频"------文字滚屏,9:16 成品
工程化观察
跑完三条线,生产接入相关的点集中说一下。云端任务全部异步处理,大模型版因采用 Diffusion 生成式修复,1 分钟素材约需 15---20 分钟,业务侧可通过轮询或事件回调获取结果,长任务推荐使用回调;结果链接有效期 24 小时,建议及时下载保存;不同版本价差较大(专业版约为标准版 10---20 倍),建议先用小样确认效果、成本和耗时,再选定默认版本;字幕擦除有语言、位置、尺寸适用范围,接入前建议用真实片源验证效果。
总评
这次测评的结论分两层。
对普通人:在豆包工作里从安装到出片,全程两三句话,"帮我装这个 Skill""把这个视频增强到 1080p""把字幕擦掉",每一步 Agent 都能自主完成并交付结果,技术门槛确实没有了。
对工程侧:--schema 自省、语义化工具描述、单 Key 鉴权、云端本地同一命令面,把"给 Agent 用的工具"做到了协议层。官方称能降低 tool-calling 幻觉率,从接口设计看这个判断可信。使用提示:云端任务为异步处理,更适合批量和离线场景,不适合对实时性要求极高的场景;部分能力有语言和分辨率适用范围;Vibe Editing 需提前完成授权配置。
适合谁:想让豆包工作直接处理视频的普通用户和内容团队、短剧出海和二创流水线、AIGC 工作流搭建者,以及要批量处理商品图的电商运营。视频理解输入上限从 50MB 拉到 5GB 这一条,对做长视频分析的人尤其值钱。一句话总结:AI MediaKit 把视频处理从"工程师的命令行"变成了"普通人的对话框",配合豆包工作,这句话能真正落地。