Complete telomere-to-telomere genome assembly of Guazuma ulmifolia uncovers evolutionary mechanisms, drought adaptation, and flavonoid biosynthesis
毛可可端粒到端粒完整基因组组装揭示其进化机制、干旱适应及类黄酮生物合成途径
本文报道首个毛可可(Guazuma ulmifolia)端粒到端粒(T2T)参考基因组,可为可可野生近缘种的抗逆适应研究与抗逆育种提供核心基因组资源。
摘要
气候变化,尤其是干旱频发,对粮食安全构成重大威胁。解析作物野生近缘种环境适应性的基因组基础,可为提升作物抗逆能力提供宝贵资源。毛可可是可可(Theobroma cacao)的野生近缘种,具备重要生态与药用价值,目前尚缺乏高质量参考基因组。本研究报道了首个毛可可端粒到端粒(T2T)染色体水平基因组;基因组大小为 311.31 Mb,contig N50 达 35.19 Mb,BUSCO 完整性为 98.70%。重复序列占基因组的 27.43%,其中 LTR 反转录转座子为最主要类型。比较基因组分析表明,锦葵科物种间基因组大小差异与多倍化历史及转座子动态变化相关。祖先核型重建鉴定出 5 个该物种特有的染色体融合事件,这是毛可可区别于可可的特征。比较分析进一步发现,串联重复驱动了抗逆相关的 LEA 与 GST 基因家族扩张,提示该物种存在与胁迫响应相关的基因组特征。类黄酮生物合成相关基因的拷贝数整体保守,但呈现组织特异性表达模式,为次生代谢研究提供候选基因。综上,本研究构建了高质量 T2T 基因组资源,可用于锦葵科基因组演化、染色体结构及抗逆相关基因组特征的挖掘。
引言
气候变化,尤其是干旱强度提升、持续时间延长,对维持作物稳产与粮食安全构成巨大挑战(Dhankher & Foyer;Springmann 等)。解析作物野生近缘种环境适应性的基因组基础,有助于深入理解抗逆性状,并为后续作物改良拓展遗传资源。巧克力产业产值达数十亿美元,依赖亚马逊雨林原生种可可(Theobroma cacao )的果实供给。然而可可对干旱敏感,持续少雨会造成产量大幅下降,西非等主产区尤为突出(Gateau-Rey 等)。可可野生近缘种分布于多样生态位,是研究环境适应性基因组基础、挖掘作物抗逆遗传资源的优良材料。毛可可,俗称穆坦巴(mutamba)或瓜西莫(guácimo),是一种耐旱的可可野生近缘种,为半落叶乔木,广泛分布于新热带区较干旱的生物群落。毛可可传统分类归属于锦葵科梧桐亚科(Byttnerioideae)(Ahmed & Rahman;Alverson 等;Ibrahim 等;被子植物系统发育研究组)。不同于仅局限于雨林分布的物种,毛可可生长在季节性干旱林、热带稀树草原以及森林过渡生境,生态分布范围广。基于叶绿体基因ndhF (Richardson 等;Whitlock 等)以及 5 个 WRKY 基因(Borrone 等;BossaCastro 等)的分子系统发育分析一致表明,扁担木属(Guazuma )是可可属 - 亮籽树属分支的姊妹类群。近期系统发育基因组研究进一步显示,黑可可属(Herrania)嵌入可可属内部,现已归并至可可属(Colli-Silva 等),为梧桐亚科提供了分辨率更高的系统发育框架。扁担木属与可可属亲缘关系近、生态分布广,是研究基因组演化与环境适应的理想模型。尽管锦葵科基因组资源不断积累,但扁担木属的基因组数据仍然匮乏,限制了我们对其基因组演化、生态适应性以及在锦葵科内演化历史的认知。
锦葵科包含 243 属约 4225 个物种(被子植物系统发育研究组),物种多样性高,兼具重要经济价值与生态适应性(Das 等;Raj 等;Walker)。该科包含多种经济作物与资源植物,例如可可(T. cacao )(De Souza 等;Nieves‐Orduña 等)、亚洲棉(Gossypium arboreum )(De Lima 等)、榴莲(Durio zibethinus )(Ketsa),在农业、药学与食品工业中意义重大。测序技术的发展,已经获得多个锦葵科物种的染色体水平基因组组装结果,包括黄麻(Corchorus capsularis )(Zhang 等)、可可(Argout 等)、亚洲棉(Li 等)以及木棉(Bombax ceiba)(Shao 等)。这些基因组资源揭示锦葵科物种基因组大小差异巨大(234--2676 Mb),染色体数目变化范围广(2n = 14--92),体现锦葵科基因组经历了动态演化。多倍化、染色体重排以及转座子(TE)活动,是塑造锦葵科不同支系基因组大小变化与基因组多样性的关键因素(Oliver 等;Vicient & Casacuberta)。但锦葵科各类群基因组资源分布不均衡,梧桐亚科等研究较少的类群尤为欠缺,制约了对基因组演化、类群特有基因组特征的系统性分析。因此扩充锦葵科物种基因组采样,有助于更全面解析类群演化关系、染色体演化以及与环境适应相关的基因组特征。
除生态价值外,毛可可还具备传统药用价值(Francis;Kumar & Gurunani)。在墨西哥、巴西、危地马拉等地区的民族药学实践中,其叶片、茎皮、果实和根的提取物被用于治疗腹泻、咳嗽以及胃肠道和心血管疾病(de Araújo Neto & Bergemann de Aguiar;de Jesus Santana 等;Lopes 等)。植物化学研究发现,原花青素二聚体、三聚体等酚类物质是主要次生代谢物,具备抗氧化等生物活性(de Jesus Santana 等;Hör 等;Maldini 等;Puspitasari 等)。实验研究进一步证实其传统药效与植物化学成分相关(Dos Santos 等;Morais 等;Rafi 等),说明毛可可是研究次生代谢基因组基础的良好材料。但调控上述代谢特征的分子机制与遗传元件仍有待深入挖掘。
本研究整合 PacBio HiFi、ONT 超长读长以及 Hi-C 测序数据,构建毛可可首个端粒到端粒(T2T)染色体水平参考基因组。该基因组为解析锦葵科基因组演化、核型演化以及类群特有基因组特征提供重要资源。基于该组装结果,我们结合比较基因组学、转座子分析与祖先核型重建,还原毛可可的演化历史;同时通过全基因组鉴定与表达谱分析,解析抗逆与次生代谢相关基因家族的演化,包括干旱响应以及类黄酮生物合成相关基因。综上,本研究加深了对毛可可基因组演化和抗逆相关基因组特征的认识,为后续功能研究提供基础资源。
材料与方法
植物材料及核酸提取
毛可可样品采集于中国华南植物园(北纬 23°09′52.20″,东经 113°21′09.36″)(图 1A)。选取单株毛可可幼嫩叶片用于基因组 DNA 提取;同时采集同一植株的叶片、茎和果实组织用于转录组测序。所有采集的组织用铝箔包裹,液氮快速冷冻,置于−80℃保存,等待核酸提取。使用诺唯赞 FastPure 植物基因组 DNA 提取试剂盒(DC104-01)提取毛可可幼叶基因组 DNA;使用诺唯赞 FastPure 通用植物总 RNA 提取试剂盒(RC411-01)提取总 RNA。采用 NanoDrop 2000 分光光度计(Thermo Fisher Scientific)与 Qubit 3.0 荧光计(Life Technologies)检测 DNA 与 RNA 的浓度和纯度;利用 1% 琼脂糖凝胶电泳验证核酸完整性。仅通过质控、完整性良好的样品用于后续文库构建与测序。
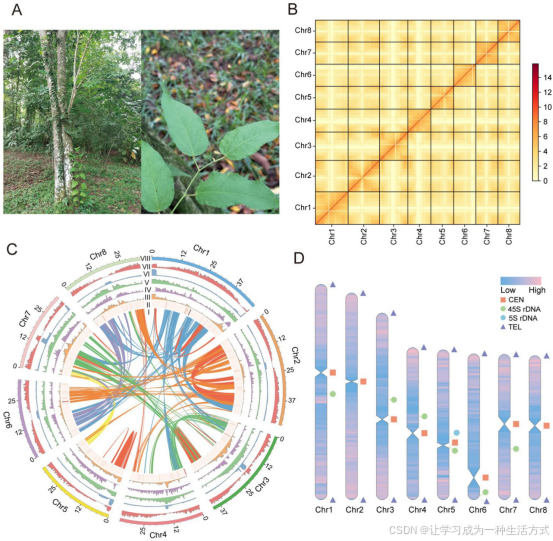
毛可可及其 T2T 基因组组装概览。A:毛可可成年植株及其叶片。B:毛可可基因组 Hi-C 互作热图。C:毛可可基因组结构圈图。由内向外依次为:I,染色体间基因共线性;II,串联重复序列密度;III,转座子覆盖度;IV,Gypsy 转座子丰度;V,Copia 转座子丰度;VI,GC 含量;VII,基因密度;VIII,染色体位置。D:毛可可基因组上基因密度、端粒、着丝粒、45S rDNA 与 5S rDNA 的染色体分布。
DNA 与 RNA 测序
为估算毛可可基因组大小,采用 Illumina 短读长测序获取高覆盖度数据。使用 Nextera DNA Flex 文库制备试剂盒(美国 Illumina 公司),按照说明书流程,以高纯度基因组 DNA 构建 Illumina 测序文库。经过 DNA 片段化、接头连接、PCR 扩增与文库纯化,构建插入片段 300--500 bp 的文库用于测序。文库在 Illumina HiSeq X 平台进行双端 150 bp(PE150)测序,获得高质量短读长数据,用于基因组大小评估。
为得到高连续性基因组序列,采用 PacBio DNA Template Prep Kit 1.0 与 SMRTbell Express Template Prep Kit 2.0 构建 20 kb HiFi SMRTbell 文库。使用安捷伦 12 K DNA 芯片(Agilent Technologies)检测文库质量,Qubit 荧光定量仪(Invitrogen)测定文库浓度。文库在 PacBio Revio 平台测序,获得高质量长读长序列,用于基因组从头组装。
为获取超长、高连续性基因组序列,武汉贝纳科技有限公司采用 SQK-LSK114 连接测序试剂盒(英国 Oxford Nanopore Technologies)构建测序文库。使用 Short-Read Eliminator 试剂盒(Circulomics)对高分子量 DNA 进行片段筛选,富集大于 20 kb 的片段;再利用 NEBNext FFPE DNA 修复混合液与 NEBNext Ultra II 末端修复 /dA 加尾模块(New England Biolabs)完成末端修复与 dA 加尾。文库在 PromethION 平台(Oxford Nanopore Technologies)测序得到高质量超长读长,用于补充 PacBio HiFi 数据,进一步提升基因组组装连续性。
Hi-C 测序用于捕获全基因组染色质互作信息,辅助染色体水平组装。按照标准流程构建 Hi-C 文库,包含细胞固定、染色质酶切、末端标记、邻近连接与文库制备。文库在 Illumina HiSeq X 平台开展双端 150 bp(PE150)测序,获得 Hi-C 数据用于染色体层级 scaffold 构建。
采集叶片、茎、果实组织开展转录组测序,为基因预测与功能注释提供支撑。每种组织各构建 1 个生物学重复的 RNA-seq 文库。构建插入片段 300 bp 的转录组文库,在 Illumina HiSeq X 平台进行双端 150 bp(PE150)测序,获得高质量转录组数据。
基因组大小评估
利用 Illumina 短读长序列开展 K-mer 频率分析,评估毛可可基因组特征。使用 Jellyfish(v2.3.1)得到 K-mer 频率分布;采用 GenomeScope(v2.0.1)默认参数估算基因组大小、杂合率与重复序列含量。基于 K-mer 频率峰初步判断基因组复杂程度,为后续组装优化提供依据。
基因组组装
完整的 T2T 基因组组装流程见图 S1A。整合 PacBio HiFi 读长与 ONT 超长读长,使用 Hifiasm(v0.25.0)默认参数完成毛可可基因组主体组装,得到高连续性 contig 水平组装结果。利用 minimap2(v2.30),参数-ax asm5 --secondary=no进行序列自比对,识别并去除冗余 contig。通过 BLAST 比对 NCBI nt 数据库,鉴定细菌、叶绿体、线粒体等潜在污染序列,并借助 BlobTools(v1.1.1)过滤污染序列。
处理后的 contig 利用 Hi-C 数据锚定至染色体水平 scaffold。使用 HiC-Pro(v3.1.0)处理 Hi-C 读长,去除低质量、重复及无效读对;再使用 HapHiC(v1.0.3)完成染色体层级搭建,之后用 Juicebox(v2.20.0)可视化 Hi-C 互作图谱,人工检查校正。人工修正组装错误连接、染色体分配与 scaffold 方向,得到染色体水平基因组。利用 quarTeT(v1.2.5)的 GapFiller 模块,基于 ONT 超长读长填补剩余组装缺口;同时使用 quarTeT 完成端粒鉴定与染色体完整性评估。基于着丝粒重复序列特征,使用 CentIER(v2.0)预测候选着丝粒区域。采用 NextPolish(v1.4.1)结合 PacBio HiFi 读长对染色体水平基因组进行碱基水平抛光,共迭代 5 轮,直至结果收敛。每轮抛光后评估组装质量;当连续迭代对一致性准确性与组装完整性提升极小时,停止迭代,得到最终组装版本。
基因组组装质量评估
将 PacBio HiFi 读长、ONT 超长读长、Hi-C 读长、Illumina 短读长分别回比至最终基因组,minimap2(v2.30)用于长读长与 Hi-C 读长比对,BWA-MEM(v0.7.19)用于 Illumina 短读长比对。统计比对率、覆盖均一性与全基因组测序深度,验证 T2T 基因组组装的可靠性与完整性。采用 Merqury(v1.3)计算全基因组 QV 值评估序列一致性;利用 LTR_retriever(v2.9.0)计算 LTR 组装指数(LAI)评估重复区组装连续性。使用 BUSCO(v5.4.3)评估基因组完整性。此外,通过 BLAST 比对锦葵科已知 rDNA 序列,结合串联重复查找工具 TRF 鉴定 45S 和 5S rDNA 位点,进一步验证 T2T 组装完整性。
重复序列注释
使用串联重复查找工具 TRF(v4.09.1)检测串联重复序列,包含微卫星与卫星 DNA。随后运行 EDTA(v2.0.0),参数--sensitive 1 --anno 1,优先保留结构完整的转座子(TE),构建全面的转座子库。将该转座子库结合 Repbase 数据库(v26.05),使用 RepeatMasker(v4.1.6)鉴定同源转座子。同时利用 RepeatModeler(v2.0.5)构建物种特异性转座子库,并通过 TERL(v1.0)完成分类。基于重复注释结果,开展毛可可 Gypsy 与 Copia 转座子演化分析。使用 MAFFT(v7.526)做多序列比对,IQ-TREE2(v2.3.5)基于最大似然法构建系统发育树,1000 次自举检验评估分支支持度。
全长 LTR 反转录转座子插入时间估算:对每个元件 5' 端与 3' 端 LTR 序列计算 Kimura 双参数(K2P)距离,按公式\(T=K/(2r)\)估算插入时间。K 代表一对 LTR 间序列分化度;置换速率r取\(2.6\times10^{-9}\)替换 / 位点 / 年,该速率在棉花及其他锦葵科研究中已有应用。因暂无毛可可直接测定的替换速率,所得插入时间仅为近似值,主要用于不同 LTR 类群与物种间的相对比较。
基因结构预测
本研究采用整合从头预测、同源蛋白序列与 RNA-seq 证据 的复合策略开展基因注释。从头预测利用 AUGUSTUS(v3.5.0)、GlimmerHMM(v3.0.4)和 SNAP(v1.0),基于基因组序列特征训练得到基因模型。同源预测采用 GeMoMa(v1.9),以水稻、拟南芥、葡萄、可可以及Herrania umbratica的蛋白组作为参考蛋白集。基于 RNA-seq 的预测流程:使用 HISAT2(v2.2.1)将 RNA 测序读长比对至参考基因组,再通过 StringTie(v2.2.1)进行转录本组装;组装得到的转录本进一步使用 GeneMarkS-T(v5.1)处理。此外,利用 Trinity(v2.15.2)组装得到的 unigene 序列,通过 PASA(v2.5.3)纳入基因注释流程。使用 EVidenceModeler(v2.1.0)整合并优化全部基因模型,再通过 PASA(v2.5.3)对注释结果进行精细化校正,得到最终基因结构注释集。采用 BUSCO(v5.4.3)评估注释基因集的完整性。
基因功能注释
对预测得到的基因进行功能注释:使用 BLASTp(E 值 ≤ 1×10⁻⁵)比对多个数据库,包括 TrEMBL、Swiss-Prot、Pfam、GenBank 非冗余蛋白数据库(NR)、KOG、GO 以及 KEGG 数据库。
系统发育与演化分析
为阐明毛可可的系统发育地位,选取 15 个代表性植物物种:毛果杨、水稻、木棉、吉贝、黄麻、拟南芥、长蒴黄麻、榴莲、可可、亚洲棉、雷蒙德氏棉、毛可可、Herrania umbratica、木槿与葡萄。基因组序列下载自 NCBI 与 Phytozome v13 数据库。使用 OrthoFinder(v2.5.5)开展基因家族聚类,BLASTp 阈值设置 E 值 ≤ 1×10⁻⁵,用于划分同源基因簇。保守单拷贝同源基因的蛋白序列经 MAFFT(v7.526)多序列比对后,采用 IQ-TREE2(v2.3.5)构建系统发育树。基于物种树,使用 PAML(v4.10.7)的 MCMCtree 模块估算分化时间;分化时间约束来自 TimeTree 数据库,该数据库整合已发表分子系统发育研究与化石标定的分化时间。MCMCtree 分析设置两个标定点:亚洲棉与雷蒙德氏棉分化时间限定为 1.5--4.6 百万年前(Mya);水稻与拟南芥分化时间限定为 142.1--163.5 百万年前。标定点采用软边界,根节点最大年龄设为 200 百万年。采用独立速率宽松分子钟模型;总替换率伽马先验设置(形状 = 2,速率 = 20),分支速率变异伽马先验(形状 = 1,速率 = 10)。MCMC 分析预烧迭代 4000 次,之后每 100 次迭代采样,共采集 200000 个后验样本;设置两组不同随机种子独立运行 MCMC,得到一致的后验估计。采用后验均值和 95% 最高后验密度置信区间表征分化时间及其不确定性。基于 OrthoFinder 得到的基因家族矩阵与物种树,使用 CAFE(v5.0)评估基因家族的扩张与收缩。
密码子偏好性分析
基于注释的编码序列,对物种特有基因与核心基因开展密码子偏好性评估。计算密码子适应指数(CAI)用于评估密码子优化程度;计算密码子第三位 GC 含量(GC3),评估同义密码子第三位的碱基组成偏好。使用 CodonW(v1.4.2)默认参数计算 CAI。采用双侧 Mann--Whitney U 检验比较物种特有基因与核心基因之间 CAI 和 GC3 的差异。
比较基因组分析
利用 DIAMOND(v2.1.10;E 值 ≤1×10⁻⁵)比对同源基因,去除串联重复基因后使用 WGDI(v0.74)识别共线性片段;使用 JCVI(v1.0)可视化基因组间共线性。利用 PAML(v4.10.7)的 yn00 模块计算共线性基因对的同义替换率(Ks),并通过 WGDI 可视化 Ks 分布。全基因组加倍(WGD)发生时间按公式 \(T=Ks/(2r)\) 估算,同义替换速率 r 设置为 \(8.25\times10^{-9}\) 替换 / 位点 / 年。
基因演化模式分析
整合全基因组蛋白相似性搜索、基因顺序与共线性信息,使用 DupGen_finder(v1.0)推断基因重复类型。将重复基因对划分为全基因组加倍(WGD)、串联重复(TD)、邻近重复(PD)、转座重复(TRD)和分散重复(DSD)五类。DupGen_finder 采用默认参数:邻近重复最大间隔为 10 个基因;MCScanX 参数:匹配得分 = 50,空位罚分 =−1,最小共线性块大小 = 5,E 值 = 1e−5,最大空位 = 25,重叠窗口 = 5。基因重复类型分配优先级:WGD > TD > PD > TRD > DSD。使用 KaKs_Calculator(v2.0)内置 YN 模型计算重复基因对的 Ka、Ks 以及 Ka/Ks 比值。
祖先基因组重建
参照已发表流程重建锦葵科祖先基因组。为探究基因共线性关系,使用 DIAMOND(v2.1.10;E 值 ≤1×10⁻⁵)比对亚洲棉、木棉、长蒴黄麻、榴莲、雷蒙德氏棉、毛可可、Theobroma grandiflorum 、可可、黄麻、Herrania littoralis的蛋白编码序列;再利用 WGDI(v0.74)推断染色体映射关系与核型演化。
干旱响应及类黄酮生物合成相关基因鉴定
基于已报道的干旱响应与通路相关基因,采用 BLASTp(E 值 ≤1×10⁻⁵)与隐马尔可夫模型(HMM)筛选候选基因家族。为鉴定可可、毛可可、Theobroma grandiflorum 、Herrania umbratica中的谷胱甘肽 S - 转移酶(GST)基因,从 TAIR 数据库下载拟南芥蛋白序列作为参考,对四个物种的蛋白组进行 BLASTp 搜索;同时使用 Pfam 数据库中 GST 特征 HMM 模型(PF00043、PF02798),借助 HMMER(v3.0)在四个物种中识别 GST 家族成员。整合 BLASTp 与 HMMER 结果,去除冗余序列,得到非冗余、高可信度 GST 基因集。利用 JCVI(v1.0)开展微共线性分析,IQ-TREE2(v2.3.5)构建系统发育树;基于转录组数据,使用 TBtools(v2.155)绘制基因表达热图用于可视化。
结果
T2T 基因组组装与注释
毛可可为二倍体物种,染色体数目 2n=16。本研究共获得 50.72 Gb Illumina 干净读长用于基因组大小评估(表 S1)。预估基因组大小 322.20 Mb,重复序列占基因组 25.82%。整合 ONT 超长读长、PacBio HiFi 和 Hi-C 多平台测序策略,共得到 22.12 Gb ONT 数据(约 71.02× 覆盖度;表 S2)、41.52 Gb 高质量 PacBio HiFi 读长(约 124.11× 覆盖度;表 S3)以及 42.60 Gb Hi-C 数据(约 127.33× 覆盖度;表 S4)。Hi-C 数据成功将组装序列锚定至 8 条染色体(图 1B)。经抛光校正后,最终无缺口端粒到端粒(T2T)组装序列总长 311.31 Mb,共 8 条染色体,contig N50 达 35.19 Mb(表 1;表 S5)。Hi-C 互作图谱显示强烈的染色体内互作与清晰的对角互作信号,证明染色体水平组装准确(图 1B)。Illumina 短读长、ONT 超长读长、PacBio HiFi 读长与 Hi-C 读长比对率均超过 99%,进一步证实 T2T 组装高质量与高完整性(图 S1B)。组装高质量的佐证还有:BUSCO 完整性 98.70%(图 S1C),全基因组 QV 值 45.85(各染色体 QV 范围 45.03~45.95),LTR 组装指数 LAI 为 17.49,说明基因组组装完整性很高。基因共线性、基因密度、GC 含量与重复序列密度通过 Circos 圈图展示(图 1C,表 S6)。为进一步解析 T2T 组装的染色体结构,鉴定了端粒与候选着丝粒区域(图 1D)。以植物经典端粒重复基序(TTTAGGG/CCCTAAA)为检索序列,共检测到 16 个端粒重复阵列,8 条染色体两端均鉴定出端粒序列(表 S7)。根据候选着丝粒串联重复在染色体上的富集与分布特征,预测得到 8 个候选着丝粒区域,每条染色体各 1 个(表 S8)。此外,在组装染色体上注释得到 45S 和 5S rDNA 簇,完整展示各染色体上基因密度、端粒位置与着丝粒位置等染色体特征(图 1D)。
|--------------------------------|--------------------------|
| Genomic feature | G. ulmifolia |
| Assembly feature ||
| Estimated genome size (Mb) | 322.20 |
| Total assembly size (Mb) | 311.31 |
| Total contig number | 8 |
| Contig N50 length (Mb) | 35.19 |
| Maximum contig length (Mb) | 49.80 |
| Gaps | 0 |
| QV value | 45.85 |
| LAI | 17.49 |
| BUSCO (%) | 98.70 |
| GC content (%) | 36.44 |
| Hi-C assembly ||
| Number of pseudochromosomes | 8 |
| Genome annotation | |
| Number of protein-coding genes | 37,313 |
| Average gene length (bp) | 2961.25 |
| Repeat content | 27.43% |
毛可可基因组整合从头预测、同源预测与 RNAseq 证据,完成了全面的基因模型预测(表 S9)。基因组注释共得到 37 313 个蛋白编码基因,基因模型平均长度为 2 961.25 bp(表 1)。BUSCO 评估显示,毛可可蛋白编码基因集中完整 BUSCO 基因占比达 98.30%(图 S1C)。毛可可预测得到的蛋白编码基因中,97.75% 获得功能注释(表 S10)。
转座子特征
以 Repbase 数据库为参考,结合从头预测与同源比对 策略,系统鉴定毛可可及其他锦葵科物种基因组的重复序列。毛可可基因组重复序列占比为 27.43%(表 S11),包含 DNA 转座子、长末端重复反转录转座子(LTRRT)、SINE、LINE 以及 Helitron 滚环转座子(图 2A,表 1)。其中 LTRRT 占主导,占基因组的 17.11%;其次为 DNA 转座子,占 7.43%。LTR 类群内部,Copia 与Gypsy超家族占比最高,分别占基因组 6.16%、10.95%。DNA 转座子中,MULE 和 PIF/Harbinger 元件数量最多,分别占基因组 2.77%、1.64%(图 2A)。
将毛可可基因组 LTRRT 进一步划分为单 LTR(solo LTR) 和完整 LTR ,结果表明单 LTR 数量远高于完整 LTR(图 S2A);完整 LTR 优先富集在着丝粒与亚端粒区域(图 S2B)。染色体水平上,完整 LTR 在各条染色体上分布相对均一,而单 LTR 呈现染色体特异性分布模式(图 S2A),该特征在其他锦葵科物种中同样存在(图 S2C)。插入时间分析表明,完整 LTR 大多来源于较晚的插入事件;单 LTR 的插入时间显著早于完整 LTR(图 2B)。在含量最高的两大 LTR 超家族(Copia 、Gypsy )中,单 LTR 绝大多数来源于Gypsy 元件,来源于Copia 的数量很少(图 2C);与之不同,完整 LTR 中Copia 与Gypsy占比相近(图 S2D)。
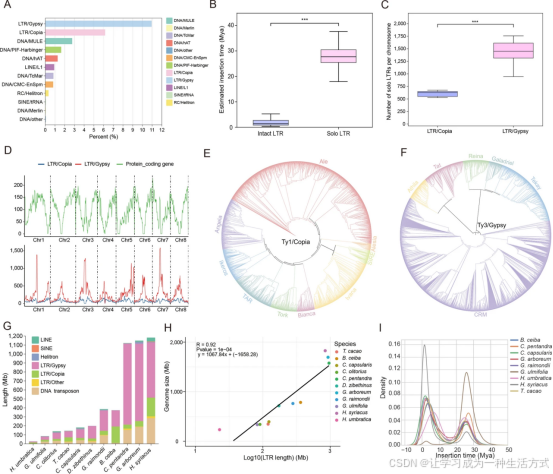
毛可可及其他 10 个锦葵科物种的转座子(TE)特征。A:毛可可基因组中转座子的分类及占基因组比例。B:完整 LTR(n=1801)与单 LTR(n=15845)的插入时间比较。双侧 Mann--Whitney U 检验评估统计显著性。C:来源于 LTR/Copia 与 LTR/Gypsy 的严格单 LTR 在染色体水平的拷贝数比较(n=8 条染色体配对观测;全基因组总计:Copia 来源 4512 个,Gypsy 来源 11333 个严格单 LTR)。双侧配对 Wilcoxon 符号秩检验评估统计显著性。两次比较的 P 值均经 Benjamini--Hochberg 法校正。星号表示校正后 P 值(Padj<0.05, **Padj<0.01,**Padj<0.001)。中线表示中位数,箱体表示四分位距,须线延伸至 1.5 倍四分位距。D:毛可可基因组中蛋白编码基因、LTR/Gypsy 和 LTR/Copia 元件的染色体分布与密度。E:毛可可基因组中 Ty1/Copia 亚类的系统发育分类。F:毛可可基因组中 Ty3/Gypsy 亚类的系统发育分类。G:11 个锦葵科物种不同转座子类别的基因组覆盖度比较。H:11 个锦葵科物种基因组大小与 LTR 总长度的相关性。I:9 个锦葵科物种 LTR 插入时间分布(百万年前)。
染色体分布分析显示,丰度最高的两类 LTR 反转录转座子(Gypsy 和 Copia)主要富集于非编码基因组区域,与蛋白编码基因分布明显分离(图 2D)。具体而言,蛋白编码基因密度高的区域重复序列分布稀疏,而 Gypsy 和 Copia 密度高的区域基因密度较低(图 2D)。为进一步划分 Gypsy 和 Copia 的谱系,提取反转录酶(RT)结构域序列构建系统发育树。在毛可可基因组中,Ty1/Copia 元件划分为 Ale、Angela、Ikeros、TAR、Tork、Bianca、Ivana、SIRE 和 Alesia 等亚类,其中 Ale 丰度最高,其次为 Ivana(图 2E)。Ty3/Gypsy 元件划分为 CRM、Tekay、Galadriel、Reina、Tat 和 Athila 等谱系,其中 CRM 最为普遍,其次为 Tekay(图 2F)。
为比较毛可可与其他锦葵科物种的转座子特征,系统鉴定并分类了 11 个锦葵科物种的转座子。11 个物种的转座子主要由 DNA 转座子、LINE、SINE、Helitron、LTR/Copia 和 LTR/Gypsy 组成。在 11 个锦葵科物种中,LTR/Copia 和 LTR/Gypsy 反转录转座子占主导地位,其次为 DNA 转座子(图 2G)。Pearson 相关性分析进一步显示,基因组大小与 LTR 含量呈强相关(Pearson r=0.92;图 2H)。包括毛可可在内的 9 个锦葵科物种,LTR 反转录转座子插入时间分布均在约 26 百万年前出现一个共有的峰值,该峰值在毛可可中尤为显著(图 2I,图 S2E)。多数其他锦葵科物种还存在较年轻的插入时间峰,基因组较大的物种如木槿尤为明显(图 2I)。这些近期插入峰主要与 Copia 和 Gypsy 反转录转座子相关(图 S2F)。
毛可可 的演化
为探究毛可可的演化起源,对 15 个物种的同源基因进行鉴定。基因家族聚类分析显示,15 个物种共包含 28098 个基因家族(477178 个基因),其中核心基因家族 7394 个(232802 个基因),物种特有基因家族 7334 个(34010 个基因),单拷贝基因家族 259 个(图 3A,表 S12)。在这些基因家族中,627 个为毛可可特有,包含约 4572 个基因。KEGG 功能分析显示,这些基因显著富集于 "脂肪酸生物合成"" 错配修复 ""花青素生物合成" 以及 "植物激素信号转导" 等通路(图 3B)。为进一步研究毛可可基因组中物种特有基因的演化与调控特征,将其组织特异性表达模式和密码子偏好性与核心基因进行比较。比较分析显示,物种特有基因的组织特异性指数(τ)显著高于核心基因(图 3C)。在密码子使用方面,物种特有基因的密码子适应指数(CAI)显著低于核心基因(图 3D)。同样,物种特有基因的密码子第三位 GC 含量(GC3)也显著低于核心基因(图 3E)。
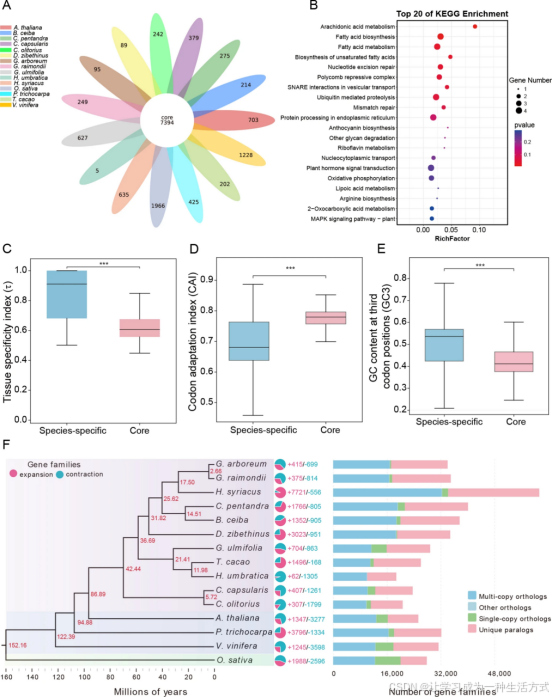
毛可可的基因家族演化与系统发育关系。A:15 个物种的基因家族聚类分析。B:毛可可物种特有基因(n=4572)富集程度排名前 20 的 KEGG 通路。采用超几何检验,基于全部已注释 KEGG 基因进行富集分析,并采用 Benjamini--Hochberg 法进行 FDR 校正(校正后 P<0.05)。C~E:物种特有基因与核心基因的组织特异性指数(τ)、密码子适应指数(CAI)、密码子第三位 GC 含量(GC3)比较。组织特异性指数分析仅保留至少在一个组织中存在可检测表达的基因;τ 分析样本量:物种特有基因 2386 个,核心基因 10362 个;CAI 与 GC3 分析样本量:物种特有基因 4572 个,核心基因 11502 个。图 C--E 中,中线代表中位数,箱体代表四分位距,须线延伸至 1.5 倍四分位距。采用双侧 Mann--Whitney U 检验结合 Benjamini--Hochberg FDR 校正评估统计学显著性。星号代表校正后 P 值(Padj < 0.001)。F:基于 15 个物种 259 个单拷贝同源蛋白序列串联构建的系统发育树,水稻作为外类群。红色数字为估算的分化时间(百万年前,Mya)。饼图展示各进化节点处扩张(红色)与收缩(蓝色)的基因家族数目。柱状图展示每个物种的多拷贝同源基因、其他同源基因、单拷贝同源基因及特有旁系同源基因的数量。
为阐明毛可可在锦葵科内的系统发育地位,利用 259 个单拷贝基因序列构建系统发育树(图 3F)。系统发育分析表明,在所选 11 个锦葵科物种中,黄麻与长蒴黄麻构成其余物种的姐妹分支,属于扁担木亚科(Grewioideae)(图 3F)。随后,毛可可、Herrania umbratica 和可可聚为一支,属于瓶木亚科(Byttnerioideae);木棉、榴莲、雷蒙德氏棉、吉贝、木槿、亚洲棉构成另一分支,包含锦葵科的木棉亚科、山芝麻亚科与锦葵亚科(图 3F)。在瓶木亚科内部,可可与Herrania umbratica 亲缘关系更近;可可 +Herrania umbratica 这一分支是毛可可分支的姐妹群(图 3F)。该拓扑结构与已发表的锦葵科多基因系统发育研究结果一致。基于物种系统发育树估算各物种分化时间,结果显示扁担木亚科大约在 42 百万年前与锦葵科其他谱系发生分化;约 37 百万年前,瓶木亚科与锦葵科其余分支发生分化(图 3F)。瓶木亚科内部,Herrania umbratica 与可可的共同祖先谱系约 21 百万年前与毛可可分化;Herrania umbratica和可可之间约 12 百万年前发生分化(图 3F)。
与其他物种相比,毛可可在演化历程中有 704 个基因家族发生扩张,863 个基因家族发生收缩。值得注意的是,扩张基因的组织特异性表达模式显著强于收缩基因(图 S3A),而二者 GC3 含量无显著差异(图 S3B)。对扩张基因家族的 KEGG 富集分析显示,其显著富集于次生代谢与胁迫响应相关通路,包括 "次生代谢产物生物合成"、"角质、木栓质与蜡质生物合成"、"不饱和脂肪酸生物合成" 以及 "异黄酮生物合成"(图 S3C)。在扩张基因中鉴定出大量关键转录因子(TF),包括 B3(25 个)、bHLH(4 个)、NAC(11 个)、MYB(6 个)、MADS(7 个)、MYB 相关(7 个)、C2H2(1 个)、C3H(1 个)(图 S3D)。
锦葵科物种全基因组加倍与比较基因组分析
为探究毛可可以及Herrania umbratica 、木棉、吉贝、榴莲、雷蒙德氏棉、黄麻、可可等代表性锦葵科物种的全基因组加倍(WGD)历史,开展同义替换率(Ks)与四简并位点颠换率(4DTv)分析。Ks 分析结果显示,8 个物种均保留古老核心真双子叶六倍化事件(γ 事件)的基因组印记,对应 Ks 峰值约 1.61--1.90。此外,黄麻、榴莲、雷蒙德氏棉、木棉、吉贝均存在 Ks≈0.20--0.55 的独立复制峰,与前人报道的谱系特异性全基因组加倍事件吻合。与之不同,基于 Ks 分布,Herrania umbratica、可可和毛可可未检测到明显的近期全基因组加倍峰(图 4A)。
进一步开展毛可可分别与可可、雷蒙德氏棉、木棉、吉贝、榴莲、Herrania umbratica、黄麻的两两 Ks 分析,结果与推断的系统发育关系一致(图 4B)。此外,4DTv 分析的分布模式与 Ks 结果吻合(图 S4A--B),进一步佐证锦葵科物种的全基因组加倍演化历史。
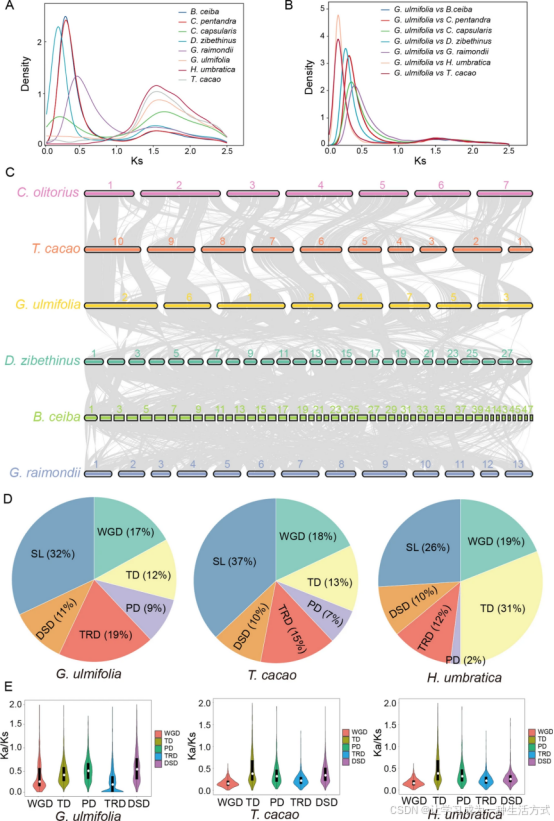
锦葵科物种的全基因组加倍与比较基因组分析。A:8 个锦葵科物种旁系同源基因对的 Ks 值分布。B:物种间两两比较的直系同源基因对 Ks 值分布。C:长蒴黄麻、可可、毛可可、榴莲、木棉、雷蒙德氏棉的全基因组共线性分析。染色体上方数字代表染色体编号。D:毛可可、可可、Herrania umbratica 中,不同重复类型基因及单拷贝基因(SL)的占比。E:小提琴图展示毛可可、可可、Herrania umbratica中 WGD、TD、PD、TRD、DSD 各类重复基因对的 Ka/Ks 比值。
为解析锦葵科物种基因组演化模式,本研究选取长蒴黄麻、可可、木棉、毛可可、榴莲、雷蒙德氏棉开展种间共线性分析。这些物种的染色体水平组装分别得到 7、10、48、8、28、13 条染色体(图 4C)。基因共线性结果显示:长蒴黄麻与可可、可可与毛可可、毛可可与榴莲、榴莲与木棉、木棉与雷蒙德氏棉之间,分别存在 13516、17929、28706、55881、47387 对同源基因(图 4C)。可可与毛可可之间存在大量高度保守的共线性区域。例如可可 6 号染色体与毛可可 4 号染色体存在大片段共线性;可可 9 号染色体与毛可可 6 号染色体存在大片段共线性(图 4C)。但部分染色体保守性较低,如可可 8 号染色体与毛可可 1 号染色体,存在不同程度的倒位与易位(图 4C)。
为进一步探究物种间共线性的变化规律,比较了长蒴黄麻 - 可可、可可 - 毛可可、毛可可 - 榴莲、榴莲 - 木棉、木棉 - 雷蒙德氏棉之间的共线性深度。结果显示:长蒴黄麻与可可、可可与毛可可之间的共线性深度为 1:1(图 S4C--D);毛可可与榴莲之间共线性深度为 1:3(图 S4E);榴莲与木棉之间为 3:5(图 S4F);木棉与雷蒙德氏棉之间为 5:5(图 S4G),与这些物种推断的谱系特异性多倍化历史一致。该共线性深度关系与 Ks、4DTv 分析揭示的基因组加倍模式相吻合。
通过毛可可、可可、Herrania umbratica 的种间比较,将基因重复模式分为 5 类(WGD、TD、PD、TRD、DSD),其余基因为单拷贝基因(SL)。毛可可中重复基因占蛋白编码基因总数的 67.6%(25240 个);可可为 63.3%,Herrania umbratica 为 73.8%(图 4D)。毛可可、可可、Herrania umbratica 的单拷贝基因占比分别为 32%、37%、26%。在重复基因中,毛可可的 TRD 来源基因占比最高(19%),而Herrania umbratica的 TD 来源基因占比显著更高(31%)。Ka/Ks 分析表明,所有物种中 TD 与 PD 基因对演化速率更高,而 WGD 基因对的 Ka/Ks 比值更低(图 4E)。值得注意的是,毛可可中 DSD 基因对 Ka/Ks 最高,TRD 基因对 Ka/Ks 最低(图 4E)。GO 富集分析显示不同重复类型存在明显功能偏好:WGD 来源基因富集于转录调控;TD 基因富集于次生代谢与氧化还原过程;TRD 基因富集于光合作用;DSD 基因富集于质体发育(图 S4I)。
为探究重复基因的保留模式,依据叶、茎、果实组织的表达谱,将重复基因对分为三类:高表达相关对(两个拷贝均表达,Pearson 相关系数 r≥0.7)、低表达相关对(两个拷贝均表达,但 r<0.7)、单拷贝表达对(仅检测到一个拷贝表达)。WGD 来源重复基因中,高表达相关对占比最高(62.9%),单拷贝表达对占比最低(35.5%)(图 S5A)。与之相比,TD、PD 来源重复基因中单拷贝表达对占比更高(分别为 58.6%、64.9%);TRD、DSD 来源重复基因的分布介于两者之间(图 S5A)。所有重复类型中,低表达相关对占比均很低,为 1.1%~2.6%(图 S5A)。低表达相关对中,81.3% 的表达模式符合潜在亚功能化,15.7% 归为潜在新功能化,其余属于其他表达分化模式(图 S5B)。所有重复类型中,潜在亚功能化占比最高;在 WGD 和 TD 来源重复基因中发生频率最高(分别为 88.6%、91.7%)(图 S5B)。潜在新功能化整体占比较低,在 TRD、DSD 来源低相关重复基因对中分别占 21.1%、32.1%(图 S5B)。
锦葵科物种核型演化
为解析毛可可基因组在锦葵科中的染色体演化历史,基于已发表数据重建祖先核型,结果显示锦葵科祖先核型包含 11 条原始染色体(图 5A)。为进一步阐明毛可可及其近缘物种的染色体演化,利用共线性分析将各物种染色体定位到祖先原始染色体上。系统发育分析表明,毛可可、可可、大花可可属于瓶木亚科,该谱系保留了相对保守的祖先染色体特征。该谱系中,可可属仅发生一次染色体融合事件,保留大量祖先核型特征;而毛可可经历了 5 次染色体融合,未检测到染色体断裂事件。榴莲发生一次全基因组三倍化(WGT)事件,Herrania littoralis发生一次全基因组加倍(WGD)事件,木棉发生一次全基因组多倍化(WGP)事件;上述物种均发生 10~30 次染色体融合与断裂事件(图 5A)。锦葵亚科代表物种雷蒙德氏棉与亚洲棉虽经历 WGP 事件,但仅含 13 条染色体,说明多次融合事件造成染色体大量减少。与之对比,未经历近期 WGD 的可可、毛可可、大花可可保留更多近似祖先的染色体构型(图 5A)。上述染色体重排模式与锦葵科代表性物种各自不同的多倍化历史相对应。
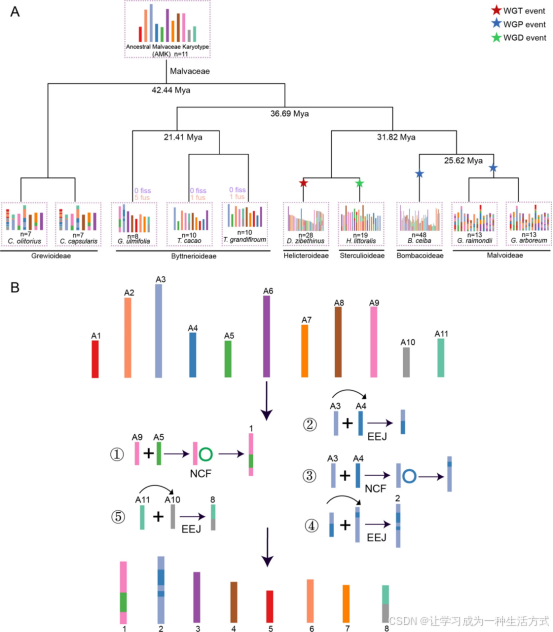
锦葵科重建祖先核型与毛可可染色体演化。A:11 条祖先染色体用不同颜色区分。下方展示所选 10 个锦葵科基因组相对于祖先核型的染色体构型。"fiss" 表示染色体断裂事件,"fus" 表示染色体融合事件。物种特异性演化事件以彩色星号标注:红星代表全基因组三倍化(WGT)事件,蓝星代表全基因组多倍化(WGP)事件,绿星代表全基因组加倍(WGD)事件。B:由锦葵科祖先核型演化形成现今毛可可染色体的重建过程。EEJ 代表端对端染色体融合,NCF 代表嵌套式染色体融合。
为深入探究毛可可染色体数目形成的机制,将其基因组与重建的锦葵科祖先染色体进行共线性比较分析。结果表明,毛可可保留了大量祖先染色体结构。例如,毛可可 3、4、5、6、7 号染色体分别对应祖先原始染色体 2、8、1、2、7,未发生显著断裂或融合事件(图 5B)。毛可可 1 号染色体推断由祖先 5 号与 9 号染色体发生一次嵌套式染色体融合(NCF)形成,使祖先染色体数目减少一条。毛可可 2 号染色体由祖先 4 号染色体通过 NCF 事件插入祖先 3 号染色体,随后连续发生两次端对端连接(EEJ)融合,形成 2 号染色体,并进一步使祖先染色体减少一条(图 5B)。此外,祖先 10 号与 11 号染色体通过一次 EEJ 事件融合,形成毛可可 8 号染色体,使祖先染色体数目再减一条(图 5B)。上述过程共同形成了现今毛可可含 8 条染色体的基因组。
毛可可 及其近缘种干旱相关基因家族比较分析
为解析毛可可中与干旱生理过程相关的基因家族,系统鉴定了参与主要干旱生理过程的基因,包括 ABA 生物合成、渗透胁迫调节、胁迫保护、活性氧清除以及气孔调节(图 6A)。具体而言,ABA 合成相关基因包括脱落醛氧化酶 3(AAO3)、玉米黄质环氧化酶(ZEP)、细胞色素 P450 单加氧酶(CYP707A1)、短链醇脱氢酶(ABA2)以及 9 - 顺式 - 环氧类胡萝卜素双加氧酶(NCED)。渗透胁迫调节相关基因包括脱水响应元件结合蛋白 2(DREB2)、III 类 SNF1 相关蛋白激酶 2(SnRK2)、PYR/PYL/RCAR(ABA 受体)、ABA 响应元件结合因子(AREB/ABF)以及 A 类 2C 型蛋白磷酸酶(PP2CA)。干旱胁迫保护相关基因包括晚期胚胎丰富蛋白(LEA)和热激蛋白(HSP)。活性氧清除由谷胱甘肽过氧化物酶(GPX)、谷胱甘肽还原酶(GR)、抗坏血酸过氧化物酶(APX)、脱氢抗坏血酸还原酶(DHAR)、过氧化氢酶(CAT)、谷胱甘肽 S - 转移酶(GST)以及超氧化物歧化酶(SOD)等基因介导。气孔调节由慢阴离子通道 1(SLAC1)和铝激活苹果酸转运蛋白(ALMT)等基因控制(图 6A)。
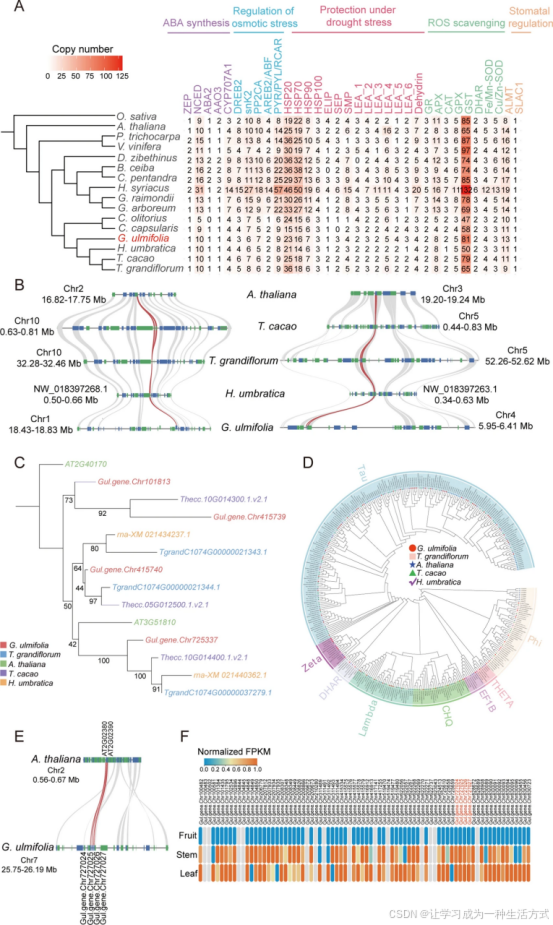
毛可可及其近缘物种干旱相关基因的比较分析。A:16 个物种中参与脱落酸(ABA)合成(紫色)、渗透胁迫调控(蓝色)、干旱胁迫保护(红色)、活性氧(ROS)清除(绿色)和气孔调控(橙色)通路的基因拷贝数。左侧展示物种间系统发育关系;方框内数字代表基因拷贝数,颜色随拷贝数升高逐渐转为红色。热图上方列出各通路对应的关键酶或蛋白。B:拟南芥、毛可可、可可、大花可可与Herrania umbratica 中 LEA5 基因的微共线性分析。红线代表 LEA5 基因的共线性,灰线代表侧翼基因的共线性区域。C:毛可可(红色)、大花可可(紫色)、拟南芥(绿色)、可可(蓝色)、Herrania umbratica (橙色)LEA5 基因的系统发育树。D:基于毛可可(圆形标记)、大花可可(方形标记)、拟南芥(星形标记)、可可(五边形标记)、Herrania umbratica(钩形标记)GST 蛋白序列构建的系统发育树;不同 GST 亚家族以不同颜色区分。E:拟南芥与毛可可 Zeta 亚家族基因的微共线性分析,红线代表共线性 GST 基因。F:毛可可 GST 基因在叶、茎、果实中的表达水平(彩图在线)。
在所选 16 个物种中,这些基因家族整体呈现较高的演化保守性(图 6A)。但部分锦葵科物种,如木槿、榴莲,因近期发生全基因组三倍化或全基因组加倍事件,基因拷贝数显著增多。与之相比,毛可可的基因拷贝数与未发生近期全基因组加倍的锦葵科物种基本相近,仅少数干旱相关基因家族存在拷贝数变异(图 6A)。为进一步阐明毛可可与其近缘种可可、大花可可、Herrania umbratica 在演化分化过程中关键基因的差异,开展比较基因组分析。干旱胁迫相关 LEA5 基因家族在毛可可中相比另外三个物种多 1 个拷贝(图 6A)。微共线性分析显示,相对于拟南芥 LEA5 基因(AT2G40170),可可中的直系同源基因发生串联重复,而Herrania umbratica 、大花可可与毛可可仅保留单拷贝(图 6B)。对于另一个 LEA5 基因(AT3G51810),大花可可与毛可可的直系同源基因为串联重复,而Herrania umbratica 和可可仅存在单拷贝(图 6B)。本研究在毛可可中共鉴定出 4 个 LEA5 直系同源基因,多于拟南芥(2 个)、可可(3 个)、大花可可(3 个)与Herrania umbratica(2 个)。系统发育分析证实这些基因与其他物种 LEA5 基因为同源基因(图 6C)。上述结果表明毛可可及其近缘物种间 LEA5 基因存在拷贝数与基因组排布差异,部分 LEA5 直系同源基因发生串联重复(图 6B--C)。
毛可可的 GST 基因家族成员数量多于多个近缘物种(图 6D)。参照拟南芥的分类体系,GST 基因家族分为 8 个亚家族:Tau、Zeta、DHAR、Lambda、CHQ、EF1B、Theta 和 Phi(图 6D)。在毛可可、可可、大花可可、Herrania umbratica 和拟南芥这 5 个物种中,Tau 亚家族成员数量最多;而 Theta 亚家族在各物种中均只含有 1 个成员(图 6D)。与拟南芥相比,锦葵科物种(毛可可、可可、大花可可、Herrania umbratica )的 CHQ 与 Phi 亚家族基因数目减少。毛可可 Tau 亚家族包含 50 个成员,与可可的 52 个接近,高于拟南芥、Herrania umbratica 和大花可可(图 6D)。值得注意,拟南芥、可可、大花可可、Herrania umbratica的 Zeta 亚家族均只有 2 个基因拷贝,而毛可可含有 6 个拷贝(图 6D)。微共线性分析显示,拟南芥的 2 个 Zeta 亚家族基因(AT2G02380、AT2G02390)为串联重复(图 6E)。毛可可中与拟南芥存在共线性的 Zeta 亚家族基因发生串联重复,使该共线性区域的基因拷贝数由 2 个增加至 4 个(图 6E)。表达模式分析表明毛可可 GST 基因存在组织特异性差异,总体在叶片与茎中表达水平更高(图 6F);但部分重复基因在检测的组织中几乎无表达或表达量极低(图 6F)。具体而言,毛可可 GST Zeta 串联重复基因(Gul.gene.Chr727024、Gul.gene.Chr727025、Gul.gene.Chr727026、Gul.gene.Chr727027)在叶、茎中表达相对较高(图 6F)。以上结果证明毛可可 GST Zeta 基因发生串联重复,并解析了其基因组排布与表达模式。
毛可可 类黄酮生物合成基因的比较分析
已有研究表明类黄酮与原花青素是毛可可重要的活性代谢物,因此本研究在 11 个锦葵科物种中开展比较基因组分析,鉴定并解析类黄酮生物合成相关基因。类黄酮生物合成通路的关键酶包括苯丙氨酸解氨酶(PAL)、肉桂酸 - 4 - 羟化酶(C4H)、4 - 香豆酸辅酶 A 连接酶(4CL)、查尔酮合酶(CHS)、查尔酮异构酶(CHI)、黄烷酮 3 - 羟化酶(F3H)、黄酮醇合酶(FLS)、二氢黄酮醇 4 - 还原酶(DFR)、花青素合酶(ANS)、花青素还原酶(ANR)以及无色花青素还原酶(LAR)。与其他锦葵科物种相比,毛可可中这类合成基因的拷贝数相对保守,与可可、Herrania umbratica等近缘物种相近(图 7A)。但木槿、榴莲、吉贝、雷蒙德氏棉、木棉等锦葵科物种的 PAL、4CL、CHS 基因拷贝数增多,与这些物种发生近期全基因组加倍事件相关;而毛可可等未经历近期全基因组加倍的物种,基因数目高度保守(图 7A)。为解析这些合成基因在毛可可中的演化模式,分析其基因重复类型。结果显示,来源于 WGD 和 TRD 的基因为主要重复类型,分别包含 8 个、7 个类黄酮合成基因;DSD 类型最少,仅鉴定到 1 个基因(图 7B)。其中 CHS 与 PAL 拷贝数最高:5 个 CHS 基因中,3 个来自 TRD,2 个来自 TD;4 个 PAL 基因中,3 个起源于 WGD,1 个来自 TD(图 7B)。
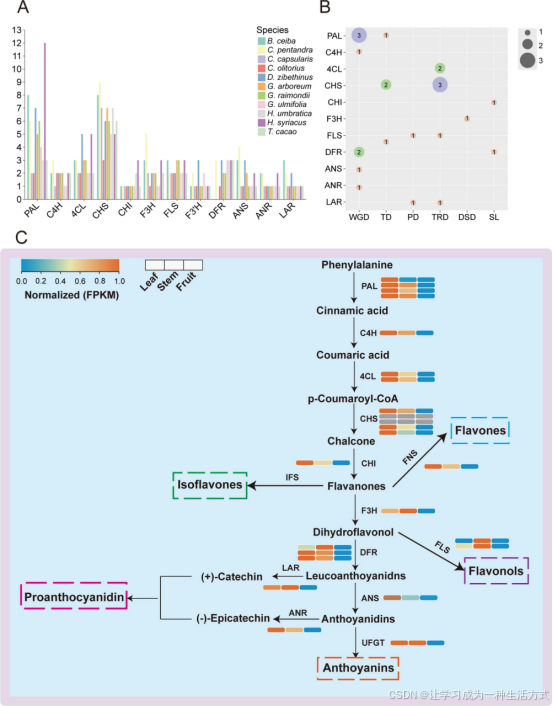
毛可可类黄酮生物合成基因的鉴定、重复模式与表达谱。A:11 个锦葵科物种中类黄酮生物合成基因的拷贝数。B:毛可可类黄酮生物合成基因的重复类型。C:毛可可类黄酮生物合成通路。热图展示类黄酮合成基因在叶、茎、果实组织中的表达水平;颜色由蓝(低表达)至红(高表达)渐变。
为解析毛可可类黄酮生物合成基因的表达模式,本研究重建类黄酮合成通路,并分析基因在叶、茎、果实组织中的表达量(图 7C)。所有基因在叶片或茎中表达水平更高,在果实中表达相对较低(图 7C)。上游通路中,PAL、C4H、4CL 基因在叶片中表达最高,茎部呈中等表达水平。下游通路中,黄酮合酶(FNS)、花青素合成关键基因(ANS、DFR)、表儿茶素合成基因(ANR)在叶片高表达;而黄酮醇合成关键酶基因(FLS)、(+)- 儿茶素合成基因(LAR)在茎中高表达(图 7C)。
讨论
本研究首次获得毛可可无缺口、端粒到端粒(T2T)水平的基因组组装序列,基因组大小 311.31 Mb,contig N50 为 35.19 Mb。BUSCO 完整度 98.70%、全基因组 QV 值 45.85、LAI 值 17.49,证实该组装具备高完整度与高准确性。本研究基于串联重复序列富集预测了候选着丝粒区域,但这些区域的功能身份仍需通过 CENH3 的 ChIP-seq 等实验手段验证。该基因组为毛可可的染色体演化、重复序列动态变化、基因家族分化,以及环境响应和特化代谢候选通路的比较基因组研究提供了基础。该基因组可用于探究与环境适应相关的基因组变异,可与近缘雨林物种可可进行对比。
相较于其他锦葵科物种,毛可可基因组偏小,远小于锦葵亚科多个物种,例如亚洲棉(1694.6 Mb)、雷蒙德氏棉(761.25 Mb)、吊灯花(1050.84 Mb);山芝麻亚科的榴莲(715.23 Mb)、梧桐亚科的Hibiscus littoralis (818.66 Mb)、木棉亚科的木棉(763.46 Mb)。但毛可可基因组大小与瓶木亚科物种相近,例如可可(341.70 Mb)、Herrania umbratica(234.04 Mb),同时也与扁担木亚科的黄麻(360.91 Mb)、长蒴黄麻(336.31 Mb)接近。上述对比表明毛可可紧凑的基因组处于锦葵科基因组大小的变化区间内,提示多倍化事件与重复序列动态变化可能是造成基因组大小差异的重要因素。
锦葵科物种基因组大小变异由多种演化过程共同塑造,包括多倍化、染色体重排与转座子(TE)动态变化。锦葵亚科、梧桐亚科、木棉亚科多个谱系发生过近期 WGD、WGT 或 WGP 事件,但毛可可未检测到近期全基因组加倍事件。除多倍化历史外,转座子动态变化是驱动基因组大小分化的另一重要因素。与基因组大小和转座子丰度相关的已有研究结论一致,毛可可转座子占比较低(27.43%),其中 LTR 反转录转座子为主要类型(图 2)。LTR 反转录转座子(尤其是 Gypsy 与 Copia 元件)广泛分布于植物基因组,在演化过程中得以保留。锦葵科各基因组中转座子丰度(尤其是 LTR 含量)与基因组大小显著相关,同时不同谱系存在转座子扩增与缺失的特异性模式。该相关性本身不能直接证明因果关系,但支持 LTR 含量变化是锦葵科基因组大小演化的重要组分。毛可可无近期多倍化事件,且重复序列占比偏低,这是其基因组较为紧凑的合理解释;不过重复序列获得与丢失各自的贡献占比仍有待进一步解析。
染色体层面,祖先核型重建进一步揭示了毛可可的基因组演化规律。祖先核型重建基于现存基因组推断,因此重建的演化路径仅代表基于现有基因组证据得到的最简约演化模型。与可可属物种(可可、大花可可)相比,毛可可经历更多染色体融合事件,未检测到染色体断裂(图 5),说明染色体融合事件塑造了毛可可的核型。与之不同,锦葵亚科、木棉亚科、山芝麻亚科、梧桐亚科物种在 WGD/WGT/WGP 事件后发生更为复杂的染色体重排。例如雷蒙德氏棉与亚洲棉在多倍化后发生大规模染色体重排,单倍型染色体数目缩减至 13 条。共线性分析进一步表明,毛可可 3、4、5、6、7 号染色体保留相对保守的祖先染色体片段;包括 NCF 嵌套染色体融合、EEJ 端对端融合在内的 5 次染色体融合事件,形成了当前 8 条染色体的核型(图 5)。综上,毛可可现存核型既保留祖先染色体结构,又存在谱系特异性的染色体融合事件。
系统发育基因组学分析明确了毛可可在锦葵科内的演化地位,同时表明瓶木亚科物种间基因组亲缘关系相对保守。瓶木亚科是锦葵科内部较早分化的谱系,比较分析显示该亚科近缘物种基因组结构较为保守(图 3F、图 5)。在该演化框架下,毛可可鉴定到的物种特有基因与扩张基因家族,为解析谱系特异性生物学功能提供基础。功能基因组分析显示,毛可可物种特有基因显著富集于次生代谢与胁迫响应通路,如花青素、脂肪酸生物合成通路。但这类富集结果仅代表潜在功能关联,不能直接作为适应性机制的证据。比较表达分析显示物种特有基因与扩张基因存在组织特异性表达,部分基因的表达模式提示其可能参与 NAC、MYB、B3 等转录因子构成的调控网络(图 S3D)。后续需要更多独立生物学重复的转录组数据,对这些组织水平表达模式做统计学验证。即便如此,本研究结果为毛可可环境响应与特化代谢的功能研究提供候选靶点。
在鉴定到的扩张基因家族中,LEA5 与 GST 家族值得重点关注,二者已知参与胁迫响应过程。毛可可 LEA5 家族扩张主要源于串联重复;LEA 蛋白已被证实可在脱水条件下保护细胞。同样,毛可可 GST 的 Zeta 亚家族拷贝数相比近缘物种显著增多,共 6 个拷贝,而近缘物种仅 2 个。微共线性分析证实串联重复驱动 LEA5 与 GST Zeta 两个家族的扩张(图 6E);多个 GST Zeta 重复基因在叶片与茎中表达量较高。上述特征表明串联重复驱动了毛可可 LEA5 与 GST Zeta 基因家族分化。但目前尚不能确定这些家族扩张是否提升抗旱能力:仅依靠拷贝数变异和表达差异无法证明其适应性意义,还需要干旱胁迫实验、群体水平分析、选择压力检验与体外功能验证,才能确认这些重复基因是否参与干旱响应。
类黄酮生物合成基因的比较分析进一步证明该毛可可基因组资源可用于次生代谢研究。毛可可类黄酮合成基因总拷贝数与瓶木亚科近缘物种(可可、Herrania umbratica)相近,与该物种不存在近期 WGD 事件的特征吻合。与之对比,多个锦葵亚科、木棉亚科、山芝麻亚科物种的 PAL、4CL、CHS 基因家族发生扩张,提示基因组加倍历史与后续基因保留模式的差异,造成类黄酮通路的谱系特异性分化。毛可可中,类黄酮合成基因(包括 PAL、CHS)主要由 WGD 与 TRD 重复产生,该模式与蒙古黄芪中的报道类似。组织特异性表达分析显示,多数类黄酮合成基因在叶、茎中转录丰度高于果实,FLS 与 LAR 在茎中高表达。已有植物化学研究在毛可可叶片中检测到类黄酮及其他抗氧化物质,该表达谱为后续研究该物种次生代谢提供候选基因与目标组织。已有报道证实原花青素是毛可可的活性物质,因此这些基因是解析次生代谢产物合成遗传基础的潜在分子靶点。但转录本丰度不能直接等同于基因表达与代谢物积累的因果关系,仍需代谢组检测结合生化验证,确认这些基因是否调控类黄酮含量与组分变化。
总体而言,本研究构建的无缺口 T2T 基因组组装,为解析毛可可基因组演化、染色体结构、胁迫相关基因家族与次生代谢奠定高质量基因组基础。本研究整合基因组演化、比较基因组与候选基因分析,挖掘关键基因组特征与候选位点,为后续功能研究提供起点。本研究并未直接阐明适应性机制,而是搭建了一套完整的基因组研究框架,用于探究抗旱性状与药用相关代谢通路。可可野生近缘种的遗传多样性日益受到重视,对其开展比较基因组研究,将进一步加深我们对锦葵科胁迫相关变异与适应性演化的理解。后续的比较转录组、胁迫处理实验、代谢组分析与功能验证,将阐明候选基因的生物学功能,进一步揭示锦葵科物种的演化与功能多样性。
结论
毛可可高质量无缺口端粒到端粒(T2T)参考基因组组装,为研究锦葵科基因组演化、染色体结构以及胁迫相关过程的候选基因组特征提供了宝贵资源。系统发育基因组学与比较基因组分析揭示了该物种谱系特异性的基因组重排、基因重复以及候选基因分化模式。通过与近缘可可属物种进行比较,为挖掘潜在参与环境适应与胁迫响应的基因组特征搭建了研究框架。包括 LEA、GST 以及类黄酮生物合成基因在内的胁迫相关与次生代谢相关基因家族发生扩张并存在表达分化,本研究仅鉴定出可供后续深入研究的候选位点,尚不能作为功能适应性的直接证据。本研究为锦葵科功能基因组学奠定了基因组基础,后续仍需开展胁迫处理实验、代谢组分析以及功能验证实验,以阐明这些候选基因的生物学功能与演化意义。