本文首发于我的博客:大模型的理解力,用户的解空间:Jev 如何填满一个空白象限 · 「东玄蟒」
你在生产代码里用 LLM 做过分类或路由吗?一次调用 3 到 329 秒,输出 token 比输入贵 5 倍,JSON 解析失败还得重试,问模型"你有多大把握"它永远回答"非常确定"。这篇文章拆解 2026 年 9 月发布的 TypeSafe AI Jev------一个不生成任何文字的模型------以及它背后的 System One Models 框架。目标:读完能在面试里把这条新路线讲清楚,包括原理、生态、质疑和机会。
问题从哪来
"模型聊天早已超人,自动化在哪?"------这是 TypeSafe 发布博客的第一句话,创始人 Diogo Almeida 的执念。他是 RLHF 的共同发明人之一,InstructGPT 与 ChatGPT 背后的训练方法就出自他手(TechCrunch 报道原话:ChatGPT broke Almeida's heart)。
他离开 OpenAI 时的判断是:问题的根源在于我们优化的是人类语言。人类语言适合对话,不适合软件消费------软件要的是类型安全、可校验、带不确定性的结构化输出。于是两年隐身之后,TypeSafe 给出第三条后训练路线:
- RLHF(人类偏好)→ 造就了聊天模型
- RLVR(可验证奖励)→ 造就了推理模型
- RLCD(校准决策)→ 造就了决策模型
官方的一句话定义值得原样记住:Jev 是一个 frontier-intelligence function call------unstructured state in, typed probabilistic decisions out。非结构化状态进,带类型的概率性决策出。
命名也各有出处:System One 来自卡尼曼《思考,快与慢》的"系统 1"------快、直觉、单步判断;Jev 来自经济学家 Jevons,取 Jevons 悖论------蒸汽机效率提升后煤的消耗反而上升。成本每降一个数量级,用例数量会涨得更多,命名即愿景。
API 长什么样
一个请求由两部分组成:state(被评判的内容,纯文本 / JSON 对象 / 文本数组)和 questions(问题字典)。三类问题原语,对应三种答案形状:
| 原语 | 回答什么 | 返回 |
|---|---|---|
| Choice | N 选一(工单路由到哪个组) | choice + 全选项 probabilities + confidence |
| Score | 在有序等级上打分(客户愤怒程度) | score(可落在两级之间)+ 分布 + confidence |
| Noul | 是非判断(消息里是否请求退款) | noul:一个 0 到 1 的概率,没有单独 confidence |
关键工程参数:输入 $42/Btok、输出免费 ;70--500ms 延迟;限流 250k tokens/s;单请求 64k 上下文;仅文本输入;主要训练语言是英语,CJK 精度目前更低------这是官方文档自己承认的。
三个设计点比参数更值得记:
一问一判断。 官方反复强调"问一个懂行的人一秒钟内能做的判断"。"分析这封邮件并决定最佳行动"不是好问题------那是 System 2 的活,该拆成原子问题再用代码组合权重。
同请求内所有问题并行评估。 加问题几乎不增加延迟,只多花几个 token。官方 cookbook 的数据:13 个问题合并成一次调用,比 13 次单独调用便宜 11.5 倍、快 9.6 倍,答案不变。这直接催生了 Speculative Fan-Out 模式------把"可能用到"的问题全部提前问,代码再决定用哪个答案。
instructions 里用反引号路径引用 state 字段。 比如 "Does ticket.messages[0].text request a refund?"------问题显式指向结构化状态的某一部分,避免模型自己猜上下文。
四个设计原理(面试核心区)
并行采样:快是结构性的,不是调参调出来的
自回归模型一次生成一个 token,每个 token 依赖前一个------一条串行链走到底。Jev 的输出空间在请求时就定义死了(N 个选项、M 个等级),模型对整个输出空间做一次前向,全部概率并行产出。这是 40--200 倍速度差的结构性来源:不是推理框架优化,是把"生成"这件事从任务里删掉了。
RLCD:校准本身作为训练目标
校准的定义:给 0.2 概率的答案,长期统计里真的该有 20% 命中;0.8 就该 80%。文档直指 RLHF 的两个副作用:偏好优化会奖励"听起来自信的幻觉"(sycophancy);还会引发 mode dropping------把分布压窄到单一风格上,模型对其他可能的输出概率衰减,偏好越强,概率分布越不可信。RLCD 把目标换成"概率与结果对齐",模型失去的是自由文本生成,换来的是概率的诚实。
Confidence 是概率分布的统计量,不是另一个模型输出
Choice/Score 的 confidence 由 probabilities 直接计算(文档交互示例里对三选项用的是 (N·峰值概率−1)/(N−1) 这种归一化峰值),分布越平坦 confidence 越低。官方明确说"你并未被锁定在我们的定义上"------完整的 probabilities 都给你了,你要更合适的度量可以自己算。这也是它和"问 LLM 要置信度"的本质区别:后者是让模型再生成一段关于自己的文字,前者是分布本身的数学性质。
零类型错误是构造性保证,不是"训练得好"
幻觉是生成器在开放词表上采样的固有属性。Jev 根本没有开放词表------它在你预先定义的选项集合上输出一个分布 (softmax over options),输出不可能落在集合之外,就像骰子不可能掷出 7。所以官方敢写"这在数学上不可能被证伪"。注意边界:"不会选错类型"不等于"不会选错选项"------所以才有 confidence,才有置信度门控:高置信自动执行、中置信复核确认、低置信转人工或换路。
三种软件架构的位置
官方把它放在第三种架构里:传统软件是简单原理组成的复杂决策树;LLM agent 是模型接管控制流、每圈都可能脱轨;AI-powered software 是代码持有工作流,模型只出现在需要"可编程常识"的窄缝里。Guard 框架的读者应该对这个定位很熟悉------这正是"模型即工具调用点、循环归属代码"的极端化。
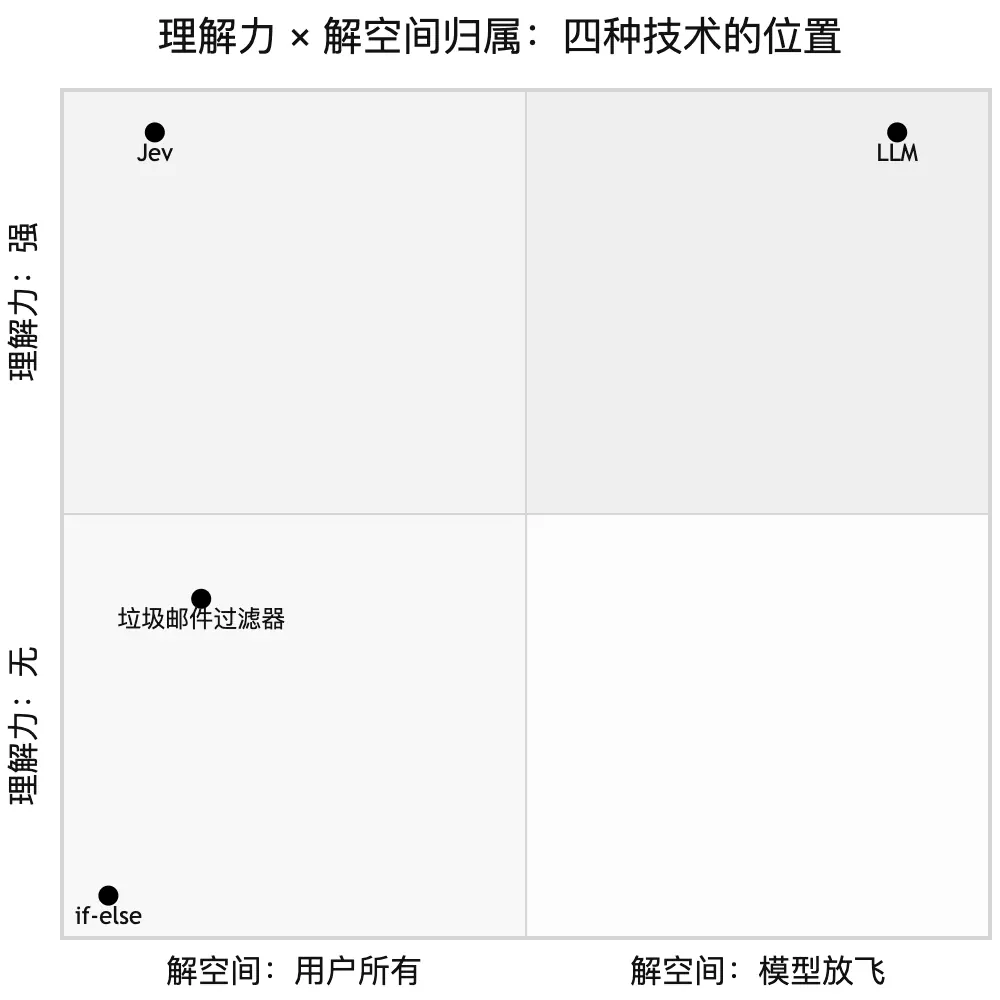
理解力 × 解空间:一张图看懂四种技术
前面四节讲的是 Jev 的零件。这一节讲我自己把零件串起来的那根线------想通它,前面所有"为什么"会同时塌缩成同一个答案。
四个我们熟悉的技术,其实只有两根轴:理解力 (能不能吃进没见过的自然语言)和解空间的归属(答案集合是谁定的)。
| 技术 | 理解力 | 解空间归属 | 输出形态 |
|---|---|---|---|
| if-else | 无------语言进不去它的世界 | 程序员写死 | 分支跳转 |
| 垃圾邮件过滤器(传统分类器) | 有,但有限 | 被训练数据焊死------选项跟着权重一起烧进模型 | 两个固定标签的概率 |
| Jev | 大模型级(encoder 的阅读力) | 每次请求的用户------选项是 HTTP 请求发出去那瞬间才出现的 | 用户定义的选项集合上的概率分布 |
| LLM | 最强 | 模型自己放飞------通过逐 token 组合可以拼出任何内容 | 自由文本序列 |
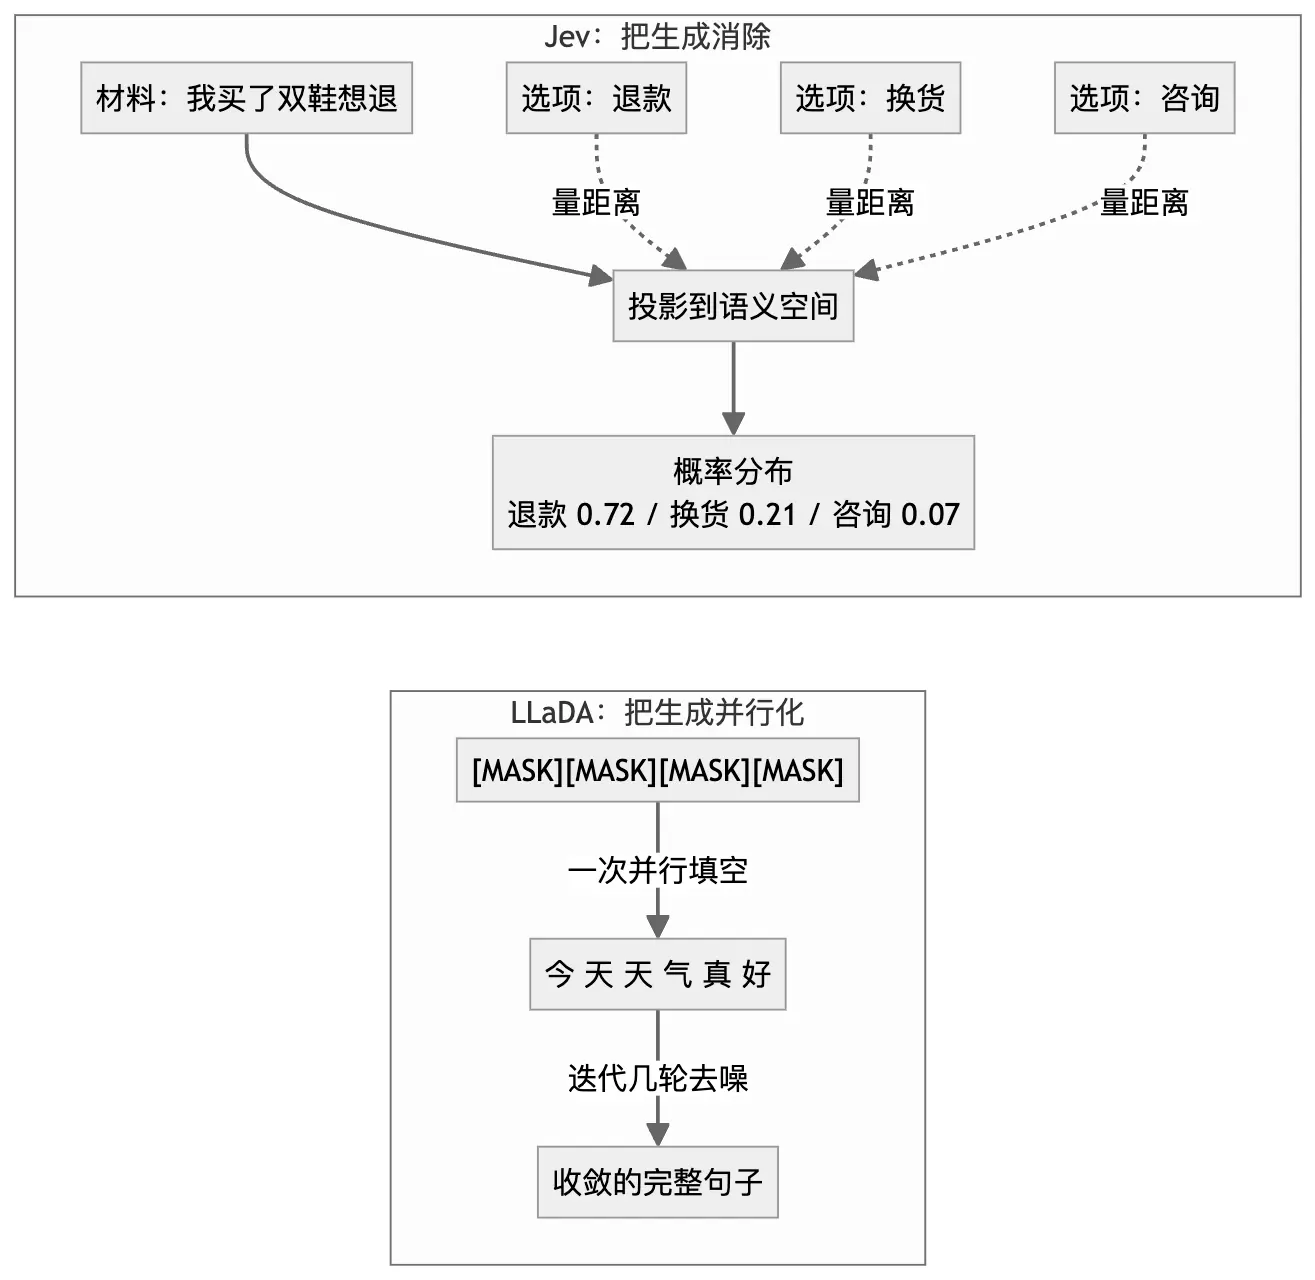
用一句话给 Jev 定位:大模型的理解力 + 用户自由决定的解空间。Jev 干的事,是把 state(材料)和每个选项都投影到同一个语义空间里量距离,距离近的选项分数高------"在用户的解空间中做投影"。
这句话一旦立住,前面所有结论自动成立:
- 为什么快 100 倍? 解空间是 3 个选项,输出就只有 3 个数------没有序列要生成,串行链长度从 312 步变 1 步
- 为什么输出免费? 3 个数不是 token 流,没有可计费的生成量
- 为什么零类型错误? 答案物理上被圈死在你的选项里,想错格式都没有那条通道
- 为什么 confidence 可算? 分布就摊在这 3 个数上,峰值多尖一眼看出,不用"问"模型有没有把握
- 为什么传统分类器换个选项就胡说八道? 它的解空间被训练时的数据焊死了,新选项投影不进它唯一认得的那几个孔------所以每个新业务都要重训;Jev 的选项跟着请求走,训练学的是"对任何给过来的映射当场算出来"这个通用能力,不是任何具体的映射
四层楼画成一张图,Jev 站的那个角落------强理解力 + 用户解空间------在它之前是个空白象限:if-else 和分类器是旧时代在理解力纵轴上的挣扎,LLM 是这个象限的错过(理解力够了,解空间扔了)。Jev 不是更聪明的模型,是第一个站进这个空象限的模型。
快的账本:省的是生成,不是理解
"一次前向"这四个字容易让人误会 Jev 连理解都省了。实际账本(HF 复刻项目 M4 Max 实测)值得摊开看:
| 串行步数 | 耗时 | |
|---|---|---|
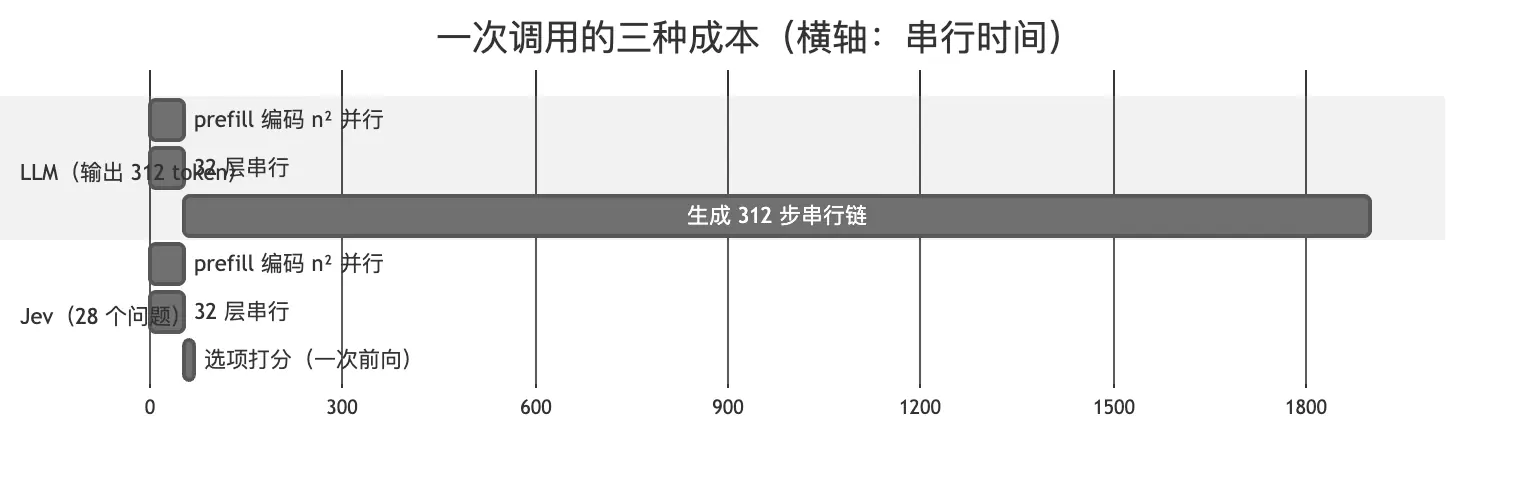
| 自回归 LLM 输出 312 token 的 JSON | 312 次前向 | 1900ms |
| Jev 风格:编码 state + 28 个字段打分 | 1 次前向(prefill 52ms + 打分 18ms) | 70ms |
两边读的是同一份材料,材料长,编码照样重------prefill 那 52ms 谁都躲不掉 。省掉的只有"把答案写成文字"那一段。所以 Jev 的延迟结构是:总耗时 ≈ 编码 state 的时间(随材料长度线性涨)+ 打分时间(选项再多也几乎不涨)。它的延迟天花板 = 你的输入长度,而输入长度是你可以控制的------这就是它敢做每帧一次的实时 agent 的原因。
串行到底是谁造成的?写作文不能跳着写,不是纸不够长,是第 51 个字的语义挂在前面 50 个字上------P(t₅₁|t₁...t₅₀) 的定义 里就含着前文。串行是"生成"这个动作的定义自带的,不是计算量问题;LLM 慢在"写答案"不在"读题",Jev 不是读得快,是压根不写。
而 LLaDA 那条扩散式路线和 Jev 的分界,同样落在这两根轴上:LLaDA 是把"生成"并行化------mask 填空,位置之间无因果依赖,整句同时出,但它仍然在造内容;Jev 是把"生成"消除------不造内容,只对既有假设分配信念。一个是 inference 加速,一个是任务改写。即便 Jev 底层真是 masked 扩散预训练(fork 旁证),扩散也只是它的训练遗骸 ,不是它的运行时------选项打分一次前向即终止,没有"逐步去噪"的对象。
n² 的账本:不串行,但昂贵
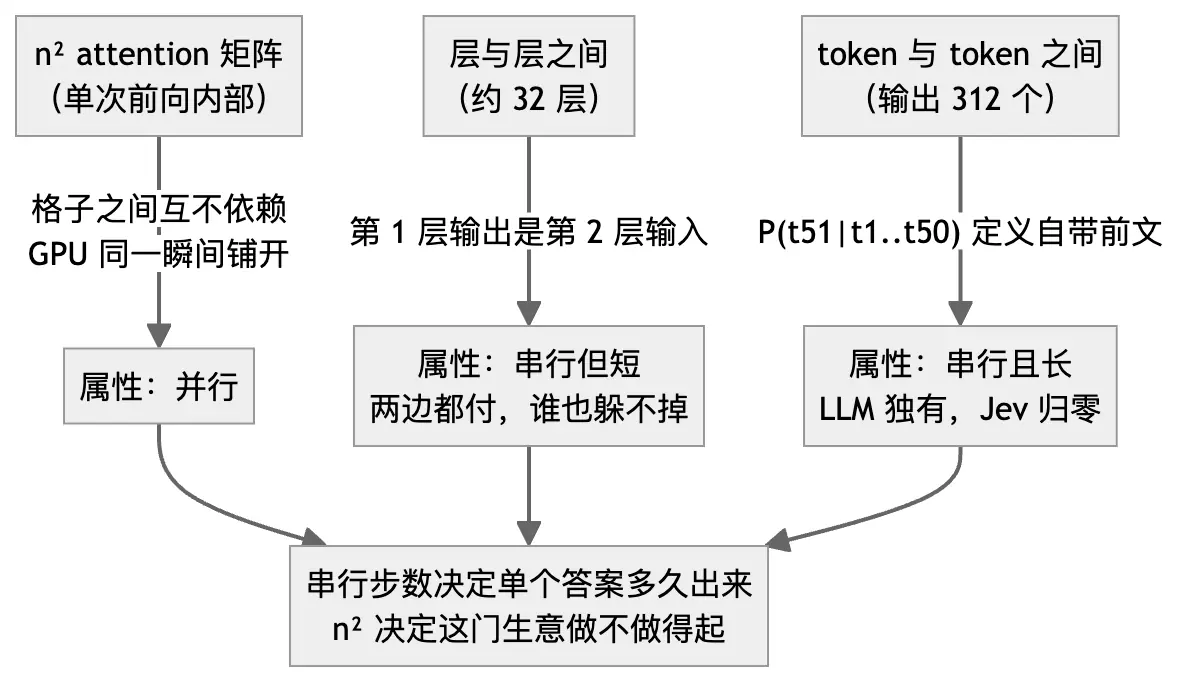
理解这层的钥匙是分清"算的顺序"和"等的顺序"。n 个 token 的 attention 矩阵有 n² 个"两两关系",但token_5 的分数不需要等待 token_9 的结果 ------scores59 和 scores95、scores1300 和 scores800012 彼此都不依赖。Q@K^T 这一亿个格子被 GPU 切成小块撒到几千个核上同时乘加。"从头到尾"说的是矩阵的形状,不是计算的时间顺序。
真正的串行只有两处,且 Jev 一处都不占便宜:
| 成本 | 量级 | 属性 | Jev vs LLM |
|---|---|---|---|
| 单次前向计算量 | n²(attention 矩阵) | 并行------GPU 同一瞬间铺开 | 相同,两边都付 |
| 层间串行 | 层数(约 32) | 串行但短 | 相同,两边都付 |
| token 间串行 | 输出长度(可到 312+) | 串行且长 | LLM 独有,Jev 归零 |
三种成本画在一条时间线上最直观------Jev 和 LLM 共享前两段,差别全在第三段:
所以 n² 的问题从来不是"慢"(串行),而是三个具体瓶颈:
- 显存墙------n=100k 时一层 attention 矩阵物化要 40GB,H100 才 80GB。FlashAttention 不是把 n² 计算变少,是不把整个矩阵物化到显存,边算边用,显存从 O(n²) 压回 O(n)
- 吞吐墙------工业并发下,每个请求都付自己的 n²,GPU 的 FLOPs 被摊薄,单请求延迟不涨但排队涨
- 成本墙------n² 是每 token 前向的乘加量,直接乘电费乘卡价
串行链决定"单个答案多久出来",n² 决定"这个生意做不做得起"。
这三种成本混在一起谈就会糊涂,拆开看就清楚了:
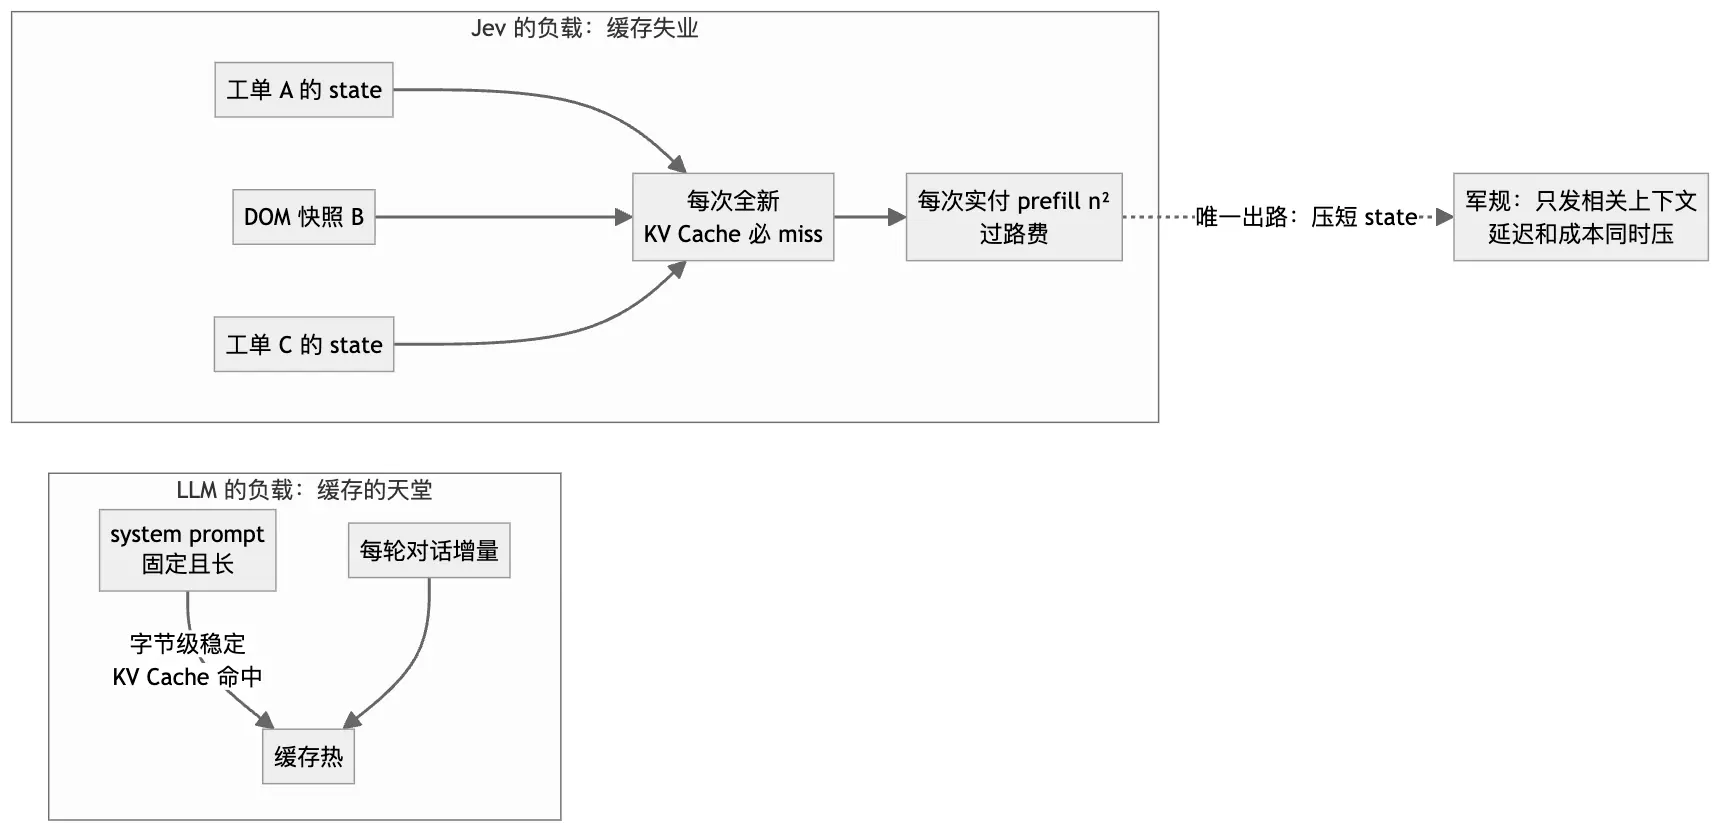
这里还有一层对 Jev 特别要命的账:KV Cache 在它的地盘上近乎失业 。LLM 世界的 system prompt 字节级稳定、缓存命中;Jev 世界的 state 每次请求都全新(每张工单、每帧 DOM 快照都不一样),缓存基本必 miss------prefill 的 n² 是它每次调用都实打实要付的过路费 ,没有任何捷径。所以官方文档把"只发相关上下文"列为头号军规,本质是在同时压延迟天花板和 n² 成本地板:state 越短,这门生意越赚。而 state 里什么是信号什么是噪声(模板、寒暄、系统日志),只有懂业务的人知道------这也是传统后端经验能直接平移进 Jev 时代的地方。
底层结构:官方没说的,社区在做什么
官方对架构守口如瓶。TechCrunch 的表述是"tight-lipped,外部观察者怀疑构建在开源权重 LLM 之上"。可查的旁证:typesafe-ai 组织 fork 了 LLaDA(人大 ML-GSAI 的扩散语言模型官方实现)和 vLLM;HN 评论区有高赞指出 vLLM 的一个 PR 支持"Jev 模式"的 DiffusionGemma,单次决策约 0.2s。扩散式语言模型天然就是并行解码器------这条社区推断(官方从未确认)目前证据链最完整。
三个开源项目让这条路线可以摸到:
jevlike (vinnylarouge,发布 1 天后出现,1k+ star)------独立实现的入门架构:每个选项编码为 query 向量 → 对上下文 token 做 attention 得到该选项专属的上下文向量 → 共享打分头算出分 → softmax 出分布。作者诚实标注:Wikispeedia 下一步点击预测上 26--29% 准确率(对照组 8%),8 选项场景一次前向比小 decoder 快约 100 倍,但未达到与 Jev 同等质量,也不是 Jev 的复刻。
Parallel Constrained Decoding(HF Space)------Apple Silicon + MLX + Qwen2.5-1.5B:对多字段 JSON schema 并行评估,M4 Max 上 5.6--7.0 倍加速、100% schema 有效、逐字段校准置信度。证明"并行受约束解码"用现成小模型就能做出来,差距在训练。
jev-ultrafast (browser-use 官方,10.5k star)------最能说明用途上限的例子:浏览器 agent 的动作空间做成"动态索引元素表"(每帧 DOM 快照产出编号控件列表),Jev 选操作和目标元素,小 LLM 只在 TYPE_TEXT 时生成文字。苏黎世→伦敦航班搜索 7.1 秒完成含打字和加载等待;浏览器协议调用从 1092 降到 101 次。模型的输出永远不变成选择器、坐标或可执行代码------执行器只认观察到过的 DOM 节点,这是结构化输出带来的安全性质。
学术谱系上它不是凭空出现的:GLiNER(双向编码器做零样本实体抽取,3.8k star)早已证明"编码器 + 选项打分"可以零样本结构化输出;LLaDA 系列(含 inclusionAI 的 2.0 版)证明扩散式 LM 可以并行生成。HN 上还有人贴出 2025 年 3 月的 arXiv 论文(PPO over 序列嵌入输出转化概率),自认"一年前就做了同构的事"。Jev 的增量不在点子,而在"通用零样本 + 概率校准 + 工程化 API"三件事同时做到------这正好是面试里"这想法早就有人做"质疑的标准答案。
市场验证与质疑清单
来自 TechCrunch 报道的真实案例:Vercel 用 Jev 替换 OpenAI 的命令安全分类器,快 5--18 倍且更准;Bryo AI 对比 Gemini 做邮件分类,Gemini 略准但贵 10--20 倍,其 CTO 最看重的反而是"唯一返回真实概率的模型"。Pi(Earendil)的 Armin Ronacher 给了两条用例------用 Jev 监控 LLM agent 轨迹防越狱(用 agent 监控 agent 太贵)、做模型路由的实时分诊;同时给了一句最锋利的批评:"它把幻觉问题部分外包给了用户"------0.5 概率是硬币,用不用这个答案是调用方的责任。
发布帖在 HN 拿到 1921 赞 504 评论,质疑集中在四处,面试时值得替面试官问出来:
- 没有论文、没有权重、没有 live demo------"RLCD 和并行采样没有任何技术支撑,全是营销词汇"。
- 对比口径------"70ms vs 329 秒"拿的是推理模型满档输出,拿纯分类小模型比差距没这么大。官方博客自己也承认"这些是我们预期里偏高端的数字"。
- Benchmark 全是自建的 workflow evals(参考答案是 GPT-6 Astra 与 Fable 5.1 的平均),官方另发一篇《Lies, Damned Lies, and Benchmarks》自陈立场:公共榜单已被 benchmaxx,他们选择公开 caveat 而不是刷榜。立场可以敬,验证只能靠第三方。
- 工程约束------64k 上下文、纯文本、英语主训、invite-only、单一供应商。
机会在哪
把用例分三层看:
替换层 :管道里已有的零样本分类、路由、抽取、打标,直接换成 Jev。收益是钱和速度(一到两个数量级),风险是精度------先跑 system-one-adapter-python(官方出的 LLM 后端 drop-in 对比器)做 A/B。
增强层 :给现有 LLM 系统当守门员。confidence-gated routing(置信度三段门控)、agent 轨迹监控、越狱检测、给 LLM 输出做校验打分------用决策模型看住生成模型,这是官方叙事里最符合工程直觉的一块。
新交互层:100ms 级 + 输出免费,让"每帧问一次模型"变成可承受的交互设计------jev-ultrafast 的浏览器 agent 是第一个完整演示。同样打开的还有实时 UI 决策、搜索式重排。
对我自己的场景(客服工单审核):工单分类路由(Choice)、申诉结果打分(Score)、退款请求识别(Noul)全部落在原生语区,且置信度门控天然对应"低置信转人工复审"的客服流程------这正是申请 waitlist 时填的用例。
面试速查卡
Q:Jev 和 LLM 的 JSON mode 有什么区别? 采样方式与约束位置都不同。JSON mode 仍是自回归逐 token 生成(语法约束采样,一条链走到底,中途偏一个 token 前功尽弃),概率分布只在词表上、不在你的 schema 上;Jev 是一次前向、直接在你的选项集合上输出分布。约束前者是"事后围栏",后者是"构造本身"。
Q:底层架构是什么?是 Transformer 吗? 官方未披露,但 Transformer 骨架基本确认(TechCrunch 报道口径 "transformer-based";社区复刻全部基于现成 Transformer 改造)。社区证据指向"开源权重的 encoder + 选项打分头 + 扩散式预训练 + RLCD"------真正的新东西不在骨架,在出口和训练目标。类比:LLM 的输出头投影到全量词表,Jev 的输出头投影到本次请求的选项集合;同一个主干,头开在哪决定了输出空间的形状。
Q:非自回归是 TypeSafe 发明的吗? 不是,这是一条十年的谱系:2017 NAT(ICLR 2018 最佳论文)为延迟首次提出并行解码 → 2018--2019 Mask-Predict 修补质量 → 2021 D3PM 把扩散搬上离散 token → 2024 SEDD 质量追平自回归 → 2025 LLaDA/Mercury 规模化 → 2026 Jev 产品化。四年一个台阶,每个台阶主语都不同(FAIR → Cornell → 人大/Inception → TypeSafe)。Jev 的原创主张只剩 RLCD 和通用决策 API 这两件事。
Q:n² 复杂度你怎么看?Jev 能躲开吗? 躲不开,但要看清它住在哪个维度:n² 是单次前向内部的并行计算量(GPU 同时铺开算),不增加串行步数;它贵在显存物化、吞吐摊薄、每 token 成本,不在"慢"。Jev 每次请求都是全新 state、KV Cache 必 miss,prefill 的 n² 是每次都要付的过路费------所以它的命门是 state 长度,官方"只发相关上下文"的军规就是在压这个。
Q:理解(编码)这一步 Jev 比 LLM 快吗? 不快,两边读同一份材料的 prefill 成本完全一样。Jev 省的只有"把答案写成文字"那一段(token 间串行链)。所以 Jev 的延迟天花板 = 输入材料长度------材料是调用方可控的,输出长度是模型方不可控的,这就是延迟主导权的转移。
Q:零幻觉怎么做到的? 幻觉是开放词表生成的属性,Jev 没有开放词表。但要立刻补一句:它仍可能选错选项,所以核心配套是校准概率与 confidence------"零类型错误"和"零错误"是两件事。
Q:为什么 RLHF 模型的置信度不可信? 偏好优化奖励讨喜与自信的表述,并造成 mode dropping(分布压窄),模型的文字概率声明与真实命中频率脱钩;RLCD 直接把"概率与结果对齐"当训练目标。
Q:它是 System 1,System 2 的任务怎么办? 拆。每个问题问"一秒钟判断",多因素判断拆成多个 Score 在代码里加权组合(Composite Scoring 模式),控制流始终归代码。
Q:这想法是不是早就有了? 单体技术上是的------GLiNER 的零样本抽取、LLaDA 的并行扩散生成、2025 年就有 RL 输出概率的工作。增量在"通用零样本 + 校准 + 产品化"三位一体,以及把定价压到输出免费。护城河更可能在 RLCD 训练数据与分布,而非架构。
Q:你会拿它做什么,怎么验证? 替换层跑 adapter A/B 看精度和成本;增强层先做 LLM 输出守门(风险低、收益明确);同时盯 CJK 精度和供应商集中度两个风险。
下一步
- waitlist 通过后先在 Playground 用中文工单样例实测 CJK 精度------这是官方承认的短板,也是自己场景的生死线
- 用 system-one-adapter-python 对比现有 LLM 分类管道的成本/延迟/准确率
- 想吃透架构的,读 jevlike 的 option-attention head 源码(一个周末的量),再看 LLaDA 理解扩散式并行解码
参考来源:发布博客 · 官方文档(AI primer、Primitives、Confidence、Models)· TechCrunch 报道 · HN 讨论帖 · Antibenchmaxxing · jev-ultrafast
关于我 :东玄蟒,个人博客记录 AI Agent 开发转型笔记。觉得有用的话,博客里还有整个精读系列。