MediaCrawler是 GitHub 上最受欢迎的社媒数据采集工具之一------截至 2026 年 9 月22日,65,470 个 Star,12,650 次 Fork,覆盖小红书、抖音、快手、B 站、微博、贴吧、知乎七个平台。
它的做法很朴素:打开一个真实浏览器,像普通用户一样访问网页,让网页自己完成该做的事,再把需要的数据拿回来。真实浏览器成了采集流程的一部分。这让它和传统爬虫很不一样。
爬虫和平台的"猫鼠游戏",它选择不当猫也不当鼠
做一个简单的背景说明,方便没有技术背景的读者理解后面的内容。
你在 App 或网页里刷到的每一条内容,背后都是你的浏览器向平台服务器要数据。平台为了防止数据被批量搬走,给每次"要数据"的请求加了一把锁------一串需要复杂计算才能得出的验证码式的参数,俗称"签名"。传统的爬虫做法是:工程师把平台的加密代码读明白,自己在程序里重新实现一遍,等于配一把万能钥匙。问题是平台可以随时换锁,而配钥匙的人要重新工作几天甚至几周。
MediaCrawler 的做法是干脆不配钥匙------它用 Playwright(一个可以用代码遥控真实浏览器的工具)打开网页,登录,然后直接在网页内部运行一小段 JavaScript 代码,问页面:"你的签名是多少?" 页面如实回答。因为签名本来就是网页自己要算的东西。
两条路线的差别:
| 传统"逆向"路线 | MediaCrawler 路线 | |
|---|---|---|
| 核心动作 | 读懂并重新实现平台的加密算法 | 直接使用网页自己算好的签名 |
| 平台更新加密时 | 算法失效,重新逆向 | 网页能打开,爬虫就能工作 |
| 需要的技能 | 逆向工程、密码学、抗代码混淆 | 会写简单的 JavaScript 即可 |
| 被风控识别的风险 | 高(伪装成浏览器,容易露馅) | 低(用的就是真实浏览器) |
需要说明:这两样技术本身都不是新发明,这个项目的价值在于把成熟的部件组合成了稳定的整体------并且把"组合"做成了一件任何人都能学会的事。
它的第二个聪明之处:蹭你自己的浏览器
这个项目默认启用一种叫 CDP(Chrome DevTools Protocol,可理解为浏览器自带的一个"远程遥控器"接口)的模式:不启动一个干净的、一看就是机器人的新浏览器,而是直接连接你电脑上日常在用的 Chrome,复用你真实的登录状态、Cookie 和扩展。
打个比方:别的爬虫是造假证混进小区,它是跟着你刷门禁进门。
不过这一段必须讲清楚边界,避免你兴冲冲装上却发现跑不起来。CDP 模式有三个现实限制:
-
只适合本机使用:需要你电脑上装有较新的 Chrome(README 要求 144 及以上版本,当然你可以修改为其他浏览器),并手动开启远程调试开关;
-
默认是有界面的:配置里无头模式(即不弹出浏览器窗口的后台运行方式)默认关闭,想静默运行需要自行修改配置;
-
不适合服务器部署:它是"一人一机一浏览器"的设计,想多账号并发、挂机跑在云端,得靠 IP 代理池(即用一批不同的网络出口轮换访问,避免同一个地址请求太频繁被平台盯上)和更重的工程方案------这正是后面会讲到的付费 Pro 版主打的能力。
七个平台,一张几乎全绿的能力表
支持的平台覆盖了中国互联网内容生态的主要角落:小红书、抖音、快手、B 站、微博、百度贴吧、知乎。以下是项目 README 中声明的能力矩阵:
| 平台 | 关键词搜索 | 指定帖子 ID | 二级评论 | 创作者主页 | 登录态缓存 | IP 代理池 | 评论词云 |
|---|---|---|---|---|---|---|---|
| 小红书 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 抖音 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 快手 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| B 站 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 微博 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 贴吧 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 知乎 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
两点提醒:这张表是项目方声明的功能清单,各平台的实际稳定性、字段完整度可能有差异,建议以自己的实测为准;对没有技术背景的读者来说,这张表的使用方式是------先在配置里填关键词,跑一遍小规模的测试抓取,确认拿到的数据够不够用,再放开量。
安装
执行git clone https://github.com/NanmiCoder/MediaCrawler.git(前提先安装git),再执行cd MediaCrawler进入项目,执行uv sync安装python虚拟环境及其依赖项(前提先安装uv)
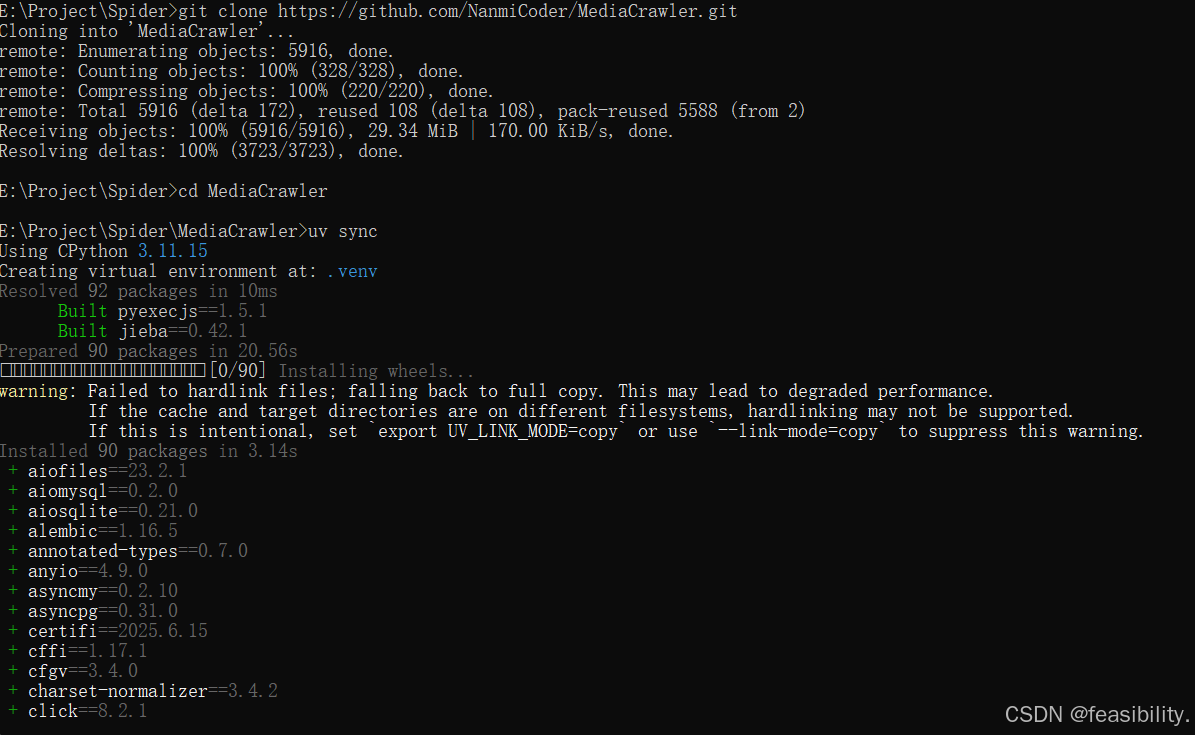
提示:如果没有安装uv,在win电脑的终端可以执行powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex",在mac或Linux电脑的终端可以执行curl -LsSf https://astral.sh/uv/install.sh | sh安装
执行.venv\Scripts\activate (win系统)或source .venv/activate (mac/Linux系统)激活虚拟环境
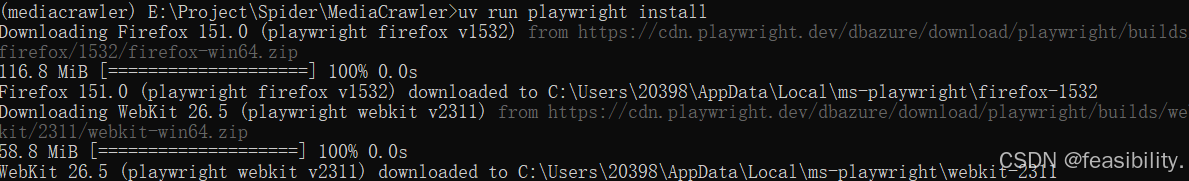
执行uv run playwright install安装playwright内置浏览器
执行uv run main.py --help可以查看操作不同平台的命令及参数作用
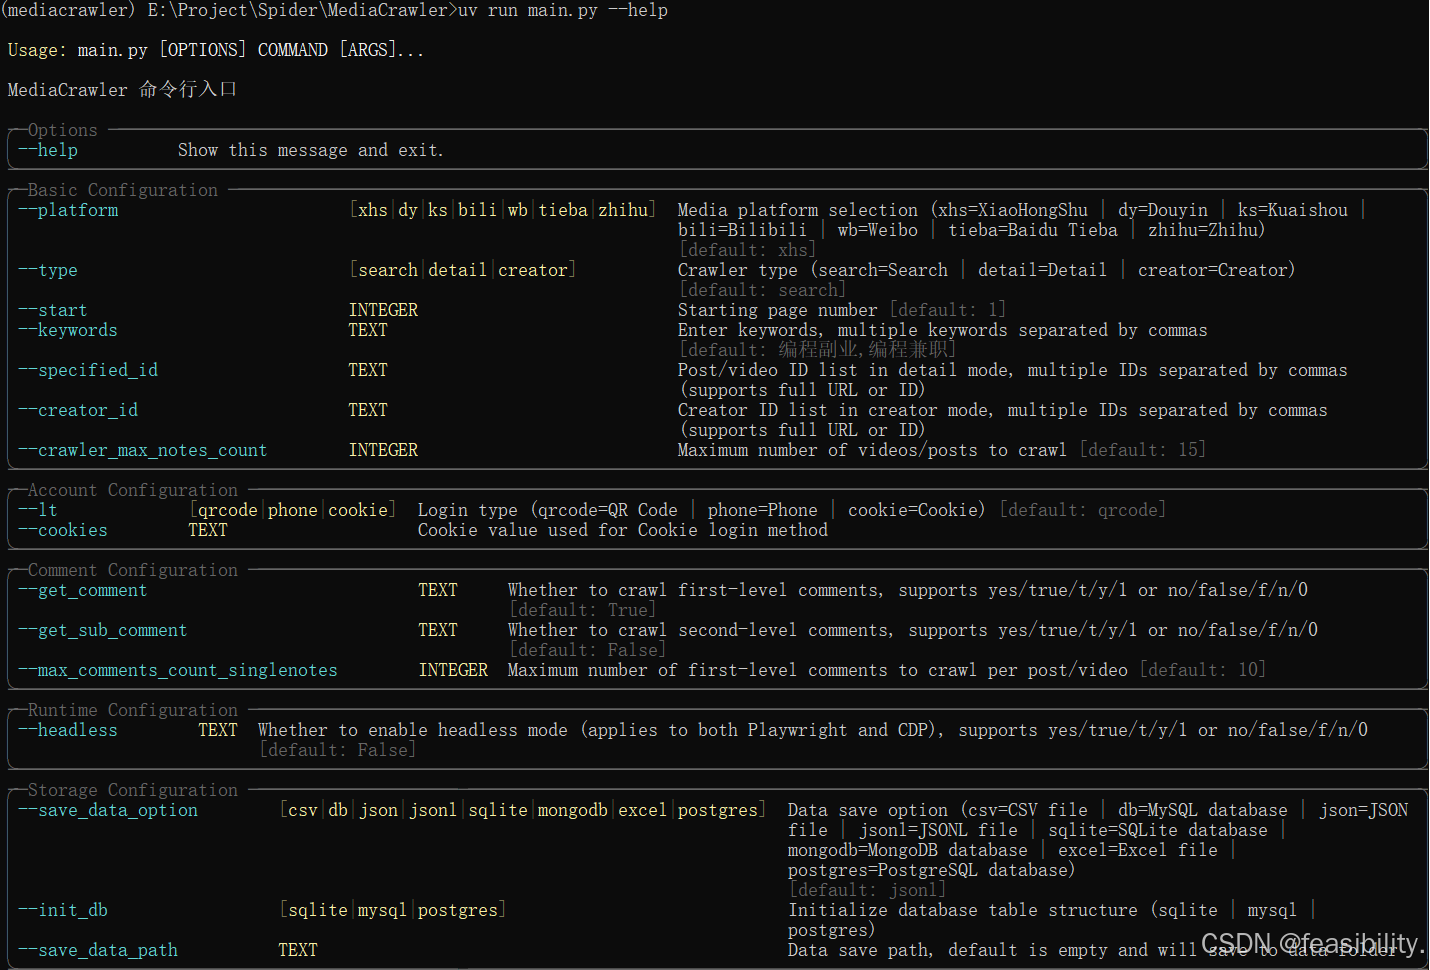
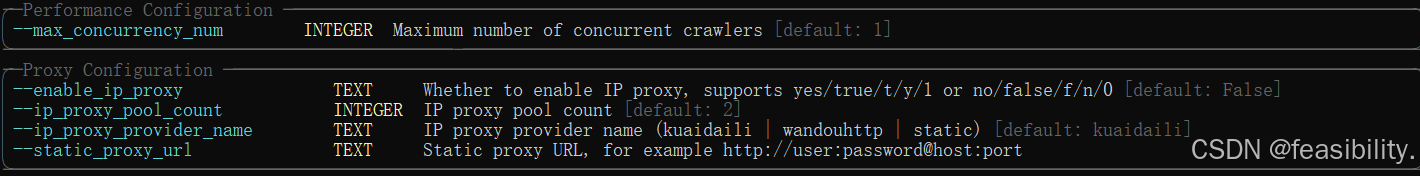
参数解释:
1)Options(基本选项)
| 参数 | 含义 |
|---|---|
--help |
显示帮助信息并退出 |
2)Basic Configuration(基本配置)
| 参数 | 含义 |
|---|---|
--platform |
选择目标平台:xhs(小红书)、dy(抖音)、ks(快手)、bili(B站)、wb(微博)、tieba(百度贴吧)、zhihu(知乎)。默认:小红书 |
--type |
爬虫模式:search(搜索)、detail(详情)、creator(创作者主页)。默认:搜索 |
--start |
起始页码,默认从第1页开始 |
--keywords |
搜索关键词,多个用逗号分隔。默认:编程副业,编程兼职 |
--specified_id |
详情模式下指定帖子/视频ID,多个用逗号分隔(支持完整URL或纯ID)。⚠️ 小红书须传带 xsec_token 的完整URL,纯 note_id 取不到数据,且 token 有时效须现取现用 |
--creator_id |
创作者模式下指定创作者ID,多个用逗号分隔(支持完整URL或纯ID)。⚠️ 知乎不支持此参数(arg.py 的 creator 分支无 zhihu,传了会被静默忽略);知乎抓创作者须改 config/zhihu_config.py 的 ZHIHU_CREATOR_URL_LIST |
--crawler_max_notes_count |
翻页阈值(非精确条数),各平台每页大小不同:xhs/bili(普通模式)/ks/zhihu=20条,dy/weibo/tieba(搜索)=10条。循环条件"已翻页数×每页大小 ≤ 该值",故翻页数=floor(值/每页大小)且至少1页。例:设30→xhs等只翻1页(约20条),但dy/weibo翻3页(约30条);想翻2页(xhs)需≥40。⚠️ 例外:bili的time_range模式把它当真实条数上限;tieba的按贴吧名模式把它当最大页码;tieba创作者模式当真实条数上限。默认:15(即1页) |
3)Account Configuration(账号配置)
| 参数 | 含义 |
|---|---|
--lt |
登录方式:qrcode(扫码)、phone(手机号)、cookie(Cookie)。默认:扫码 |
--cookies |
使用 Cookie 登录时填入的 Cookie 字符串值 |
4)Comment Configuration(评论配置)
| 参数 | 含义 |
|---|---|
--get_comment |
是否爬取一级评论,支持 yes/true/t/y/1 或 no/false/f/n/0。默认:True |
--get_sub_comment |
是否爬取二级评论(楼中楼),同上格式。默认:False(注意:一级与二级是独立开关,开二级不会关闭一级) |
--max_comments_count_singlenotes |
每条帖子/视频最多爬取多少条一级评论,默认:10 |
5)Runtime Configuration(运行时配置)
| 参数 | 含义 |
|---|---|
--headless |
是否启用无头模式(后台运行浏览器,不显示窗口)。默认:False(有界面) |
6)Storage Configuration(存储配置)
| 参数 | 含义 |
|---|---|
--save_data_option |
数据保存格式:csv、db(MySQL)、json、jsonl、sqlite、mongodb、excel、postgres。默认:jsonl |
--init_db |
初始化数据库表结构,支持 sqlite、mysql、postgres(裸 --init_db 默认 sqlite) |
--save_data_path |
自定义数据保存路径,留空则保存到默认 data 文件夹 |
7)Performance Configuration(性能配置)
| 参数 | 含义 |
|---|---|
--max_concurrency_num |
最大并发爬取数量,默认:1(单线程) |
8)Proxy Configuration(代理配置)
| 参数 | 含义 |
|---|---|
--enable_ip_proxy |
是否启用 IP 代理,防封禁。默认:False |
--ip_proxy_pool_count |
代理池中的代理数量,默认:2 |
--ip_proxy_provider_name |
代理提供商:kuaidaili(快代理)、wandouhttp(豌豆代理)、static(静态代理)。默认:kuaidaili |
--static_proxy_url |
静态代理地址,格式如 http://user:password@host:port |
9)平台专属注意事项(实测坑位)
| 平台 | 注意事项 |
|---|---|
| 通用 | 翻页阈值不是精确条数:见2) crawler_max_notes_count。各平台每页大小不同(xhs/bili/ks/zhihu=20,dy/weibo/tieba搜索=10),同一数值在不同平台翻出的页数不同:设30→xhs等只1页(约20条),dy/weibo却翻3页(约30条);想多翻页须按各自每页大小的倍数抬升。 |
| 小红书 | xsec_token 时效:detail/creator 的 URL 必须带 xsec_token,且有时效,不要复用旧链接,取不到数据就去浏览器重新复制。 |
| 知乎 | --creator_id 无效:命令行 creator 模式不支持知乎,须改 config/zhihu_config.py 的 ZHIHU_CREATOR_URL_LIST。 |
| 知乎 | 忽略 --max_comments_count_singlenotes:该"每帖评论数上限"在 xhs/dy/ks/weibo/bili/tieba 生效,但知乎 core.py 未使用该变量,传了无效。 |
| B站 | search 默认 BILI_SEARCH_MODE="normal"(与小红书相同,按页数阈值翻页,不受日期限制,可正常搜)。仅当把 BILI_SEARCH_MODE 改成 time_range / daily_limit_in_time_range 时,才受 START_DAY/END_DAY/MAX_NOTES_PER_DAY 约束,且此时 CRAWLER_MAX_NOTES_COUNT 变为真实条数上限而非页数阈值。 |
| tieba | 同参数多义:搜索模式=页数阈值(每页10);按贴吧名模式(get_specified_tieba_notes)=最大页码(page_number<=count,floor 提到30);创作者模式=真实条数上限。 |
| CDP | CDP 模式默认开启:config/base_config.py 中 ENABLE_CDP_MODE=True 且 CDP_CONNECT_EXISTING=True 时连的是你正在用的 Chrome,需先在地址栏进 chrome://inspect/#remote-debugging 勾选允许远程调试(Chrome≥144),看到 127.0.0.1:9222 才行;不想用可把 ENABLE_CDP_MODE 改 False 回落标准 Playwright。 |
采集小红书
想抓取某个主题的相关笔记及评论,可以参考执行uv run main.py --platform xhs --lt qrcode --type search --keywords "AI工具,创作" --crawler_max_notes_count 30 --get_sub_comment true,通过关键词'AI工具,创作'搜索小红书的内容,如果出现是否远程调试的弹窗,点击允许,出现二维码则用手机扫码登录
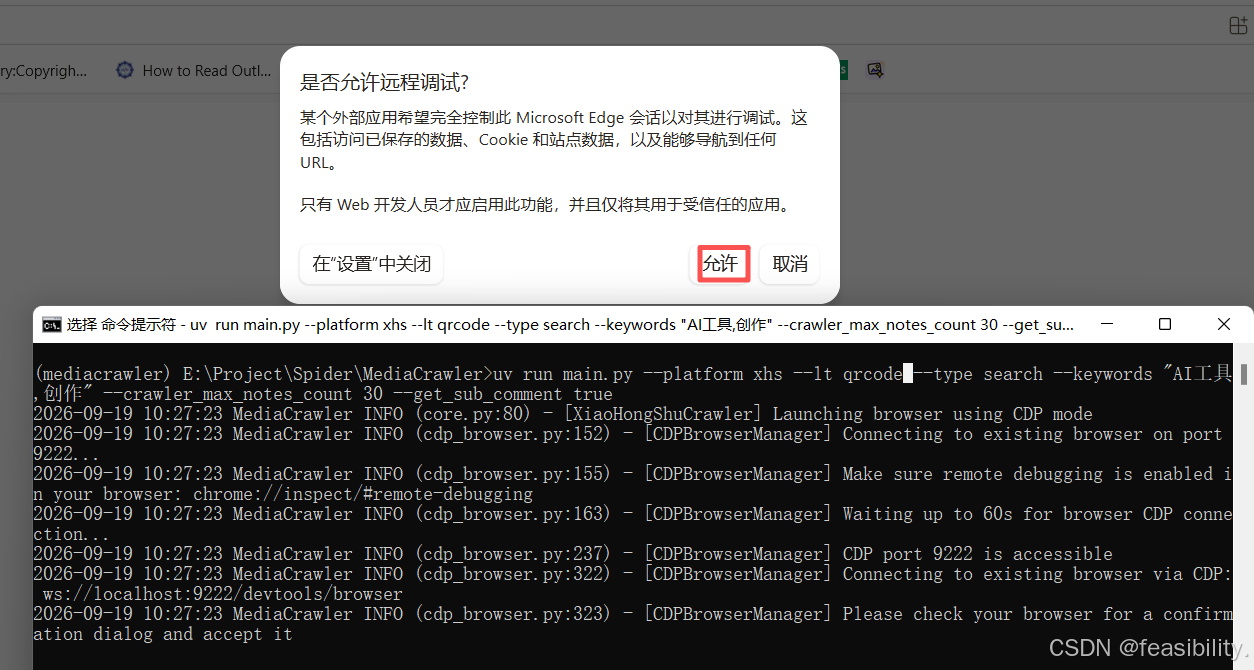
部分抓取过程
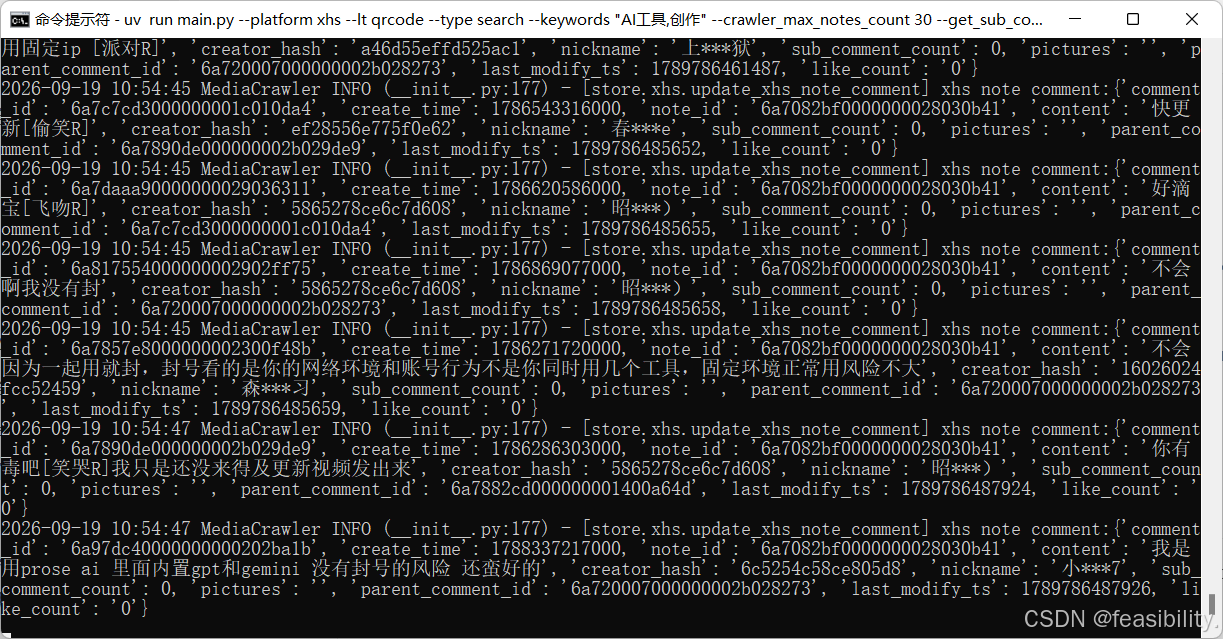
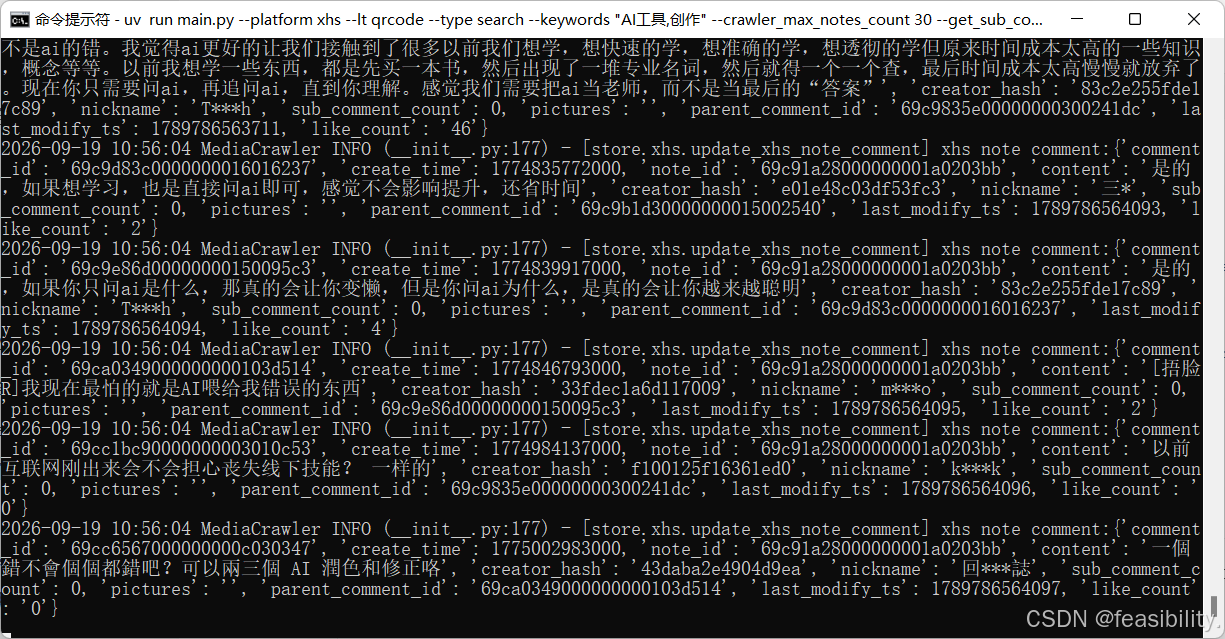
抓取结束后,会在项目的data\xhs\jsonl看到存储的数据,其中search_contents是搜索到的笔记,search_comments文件是笔记下的评论内容
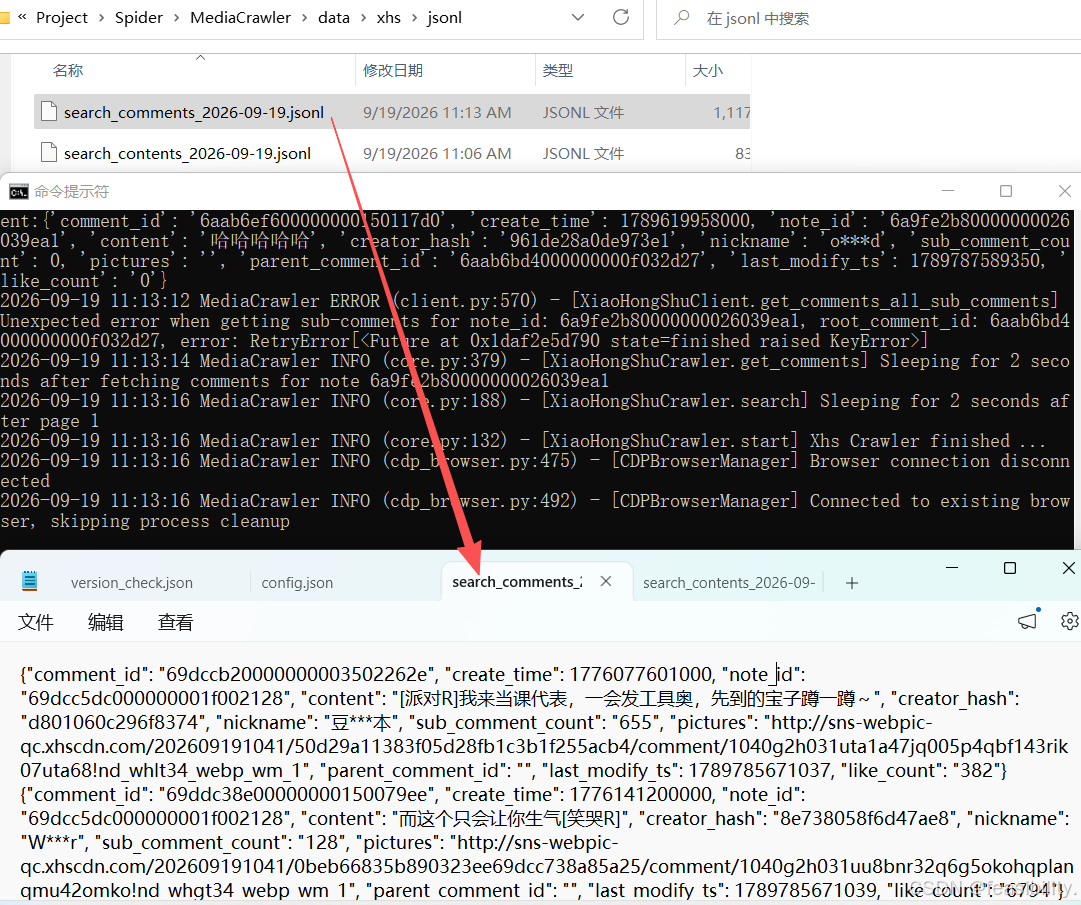
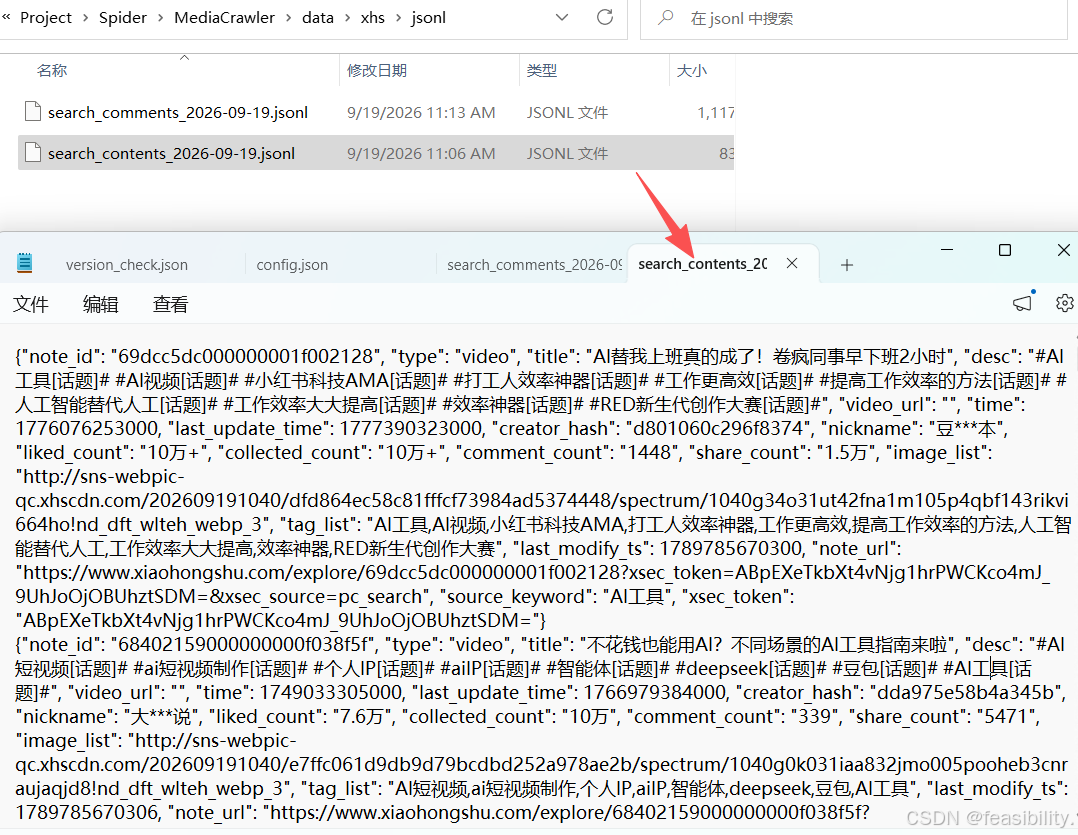
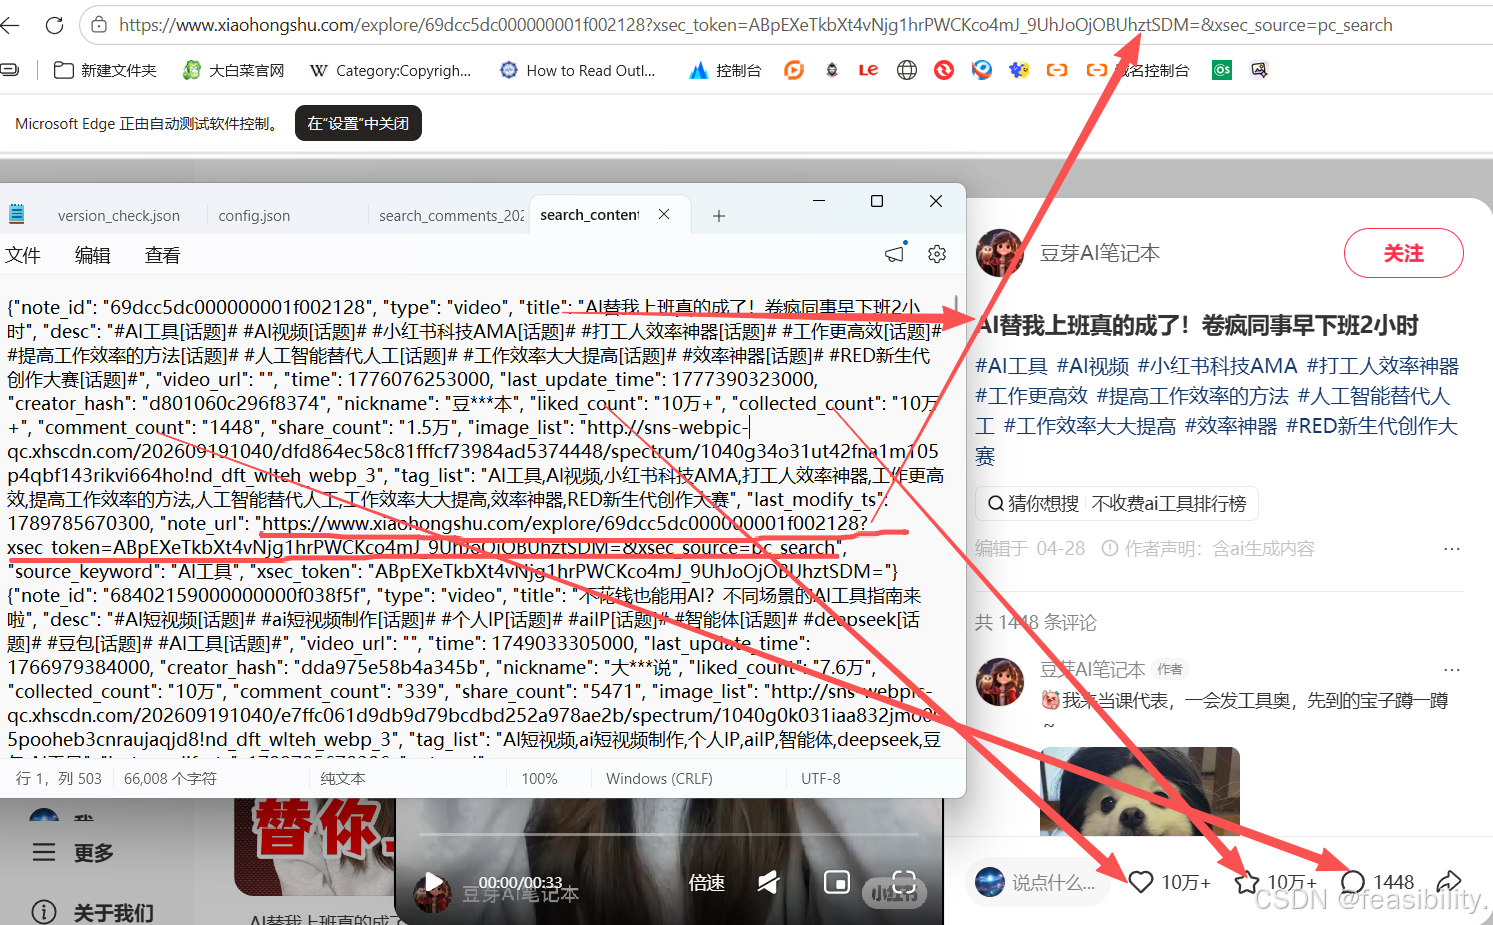
简单分析存储笔记文件的部分参数,note_id是笔记唯一标识,type是类型,比如video是视频,title是标题,desc是简介标签,note_url是笔记链接,liked_count是喜欢的人数, collected_count是收藏数,comment_count是评论数,share_count是分享数
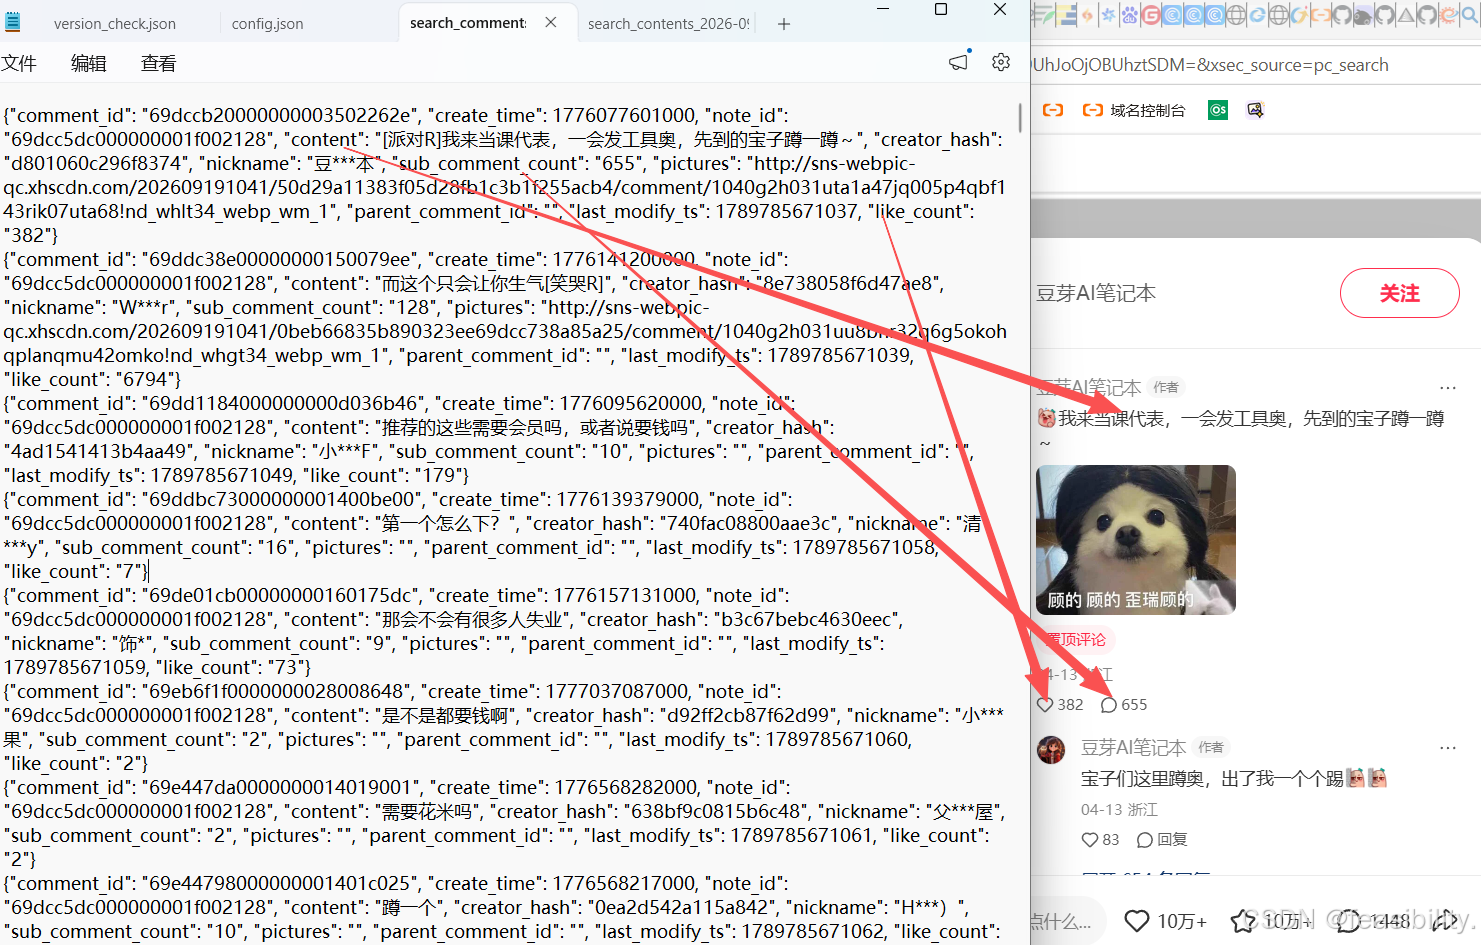
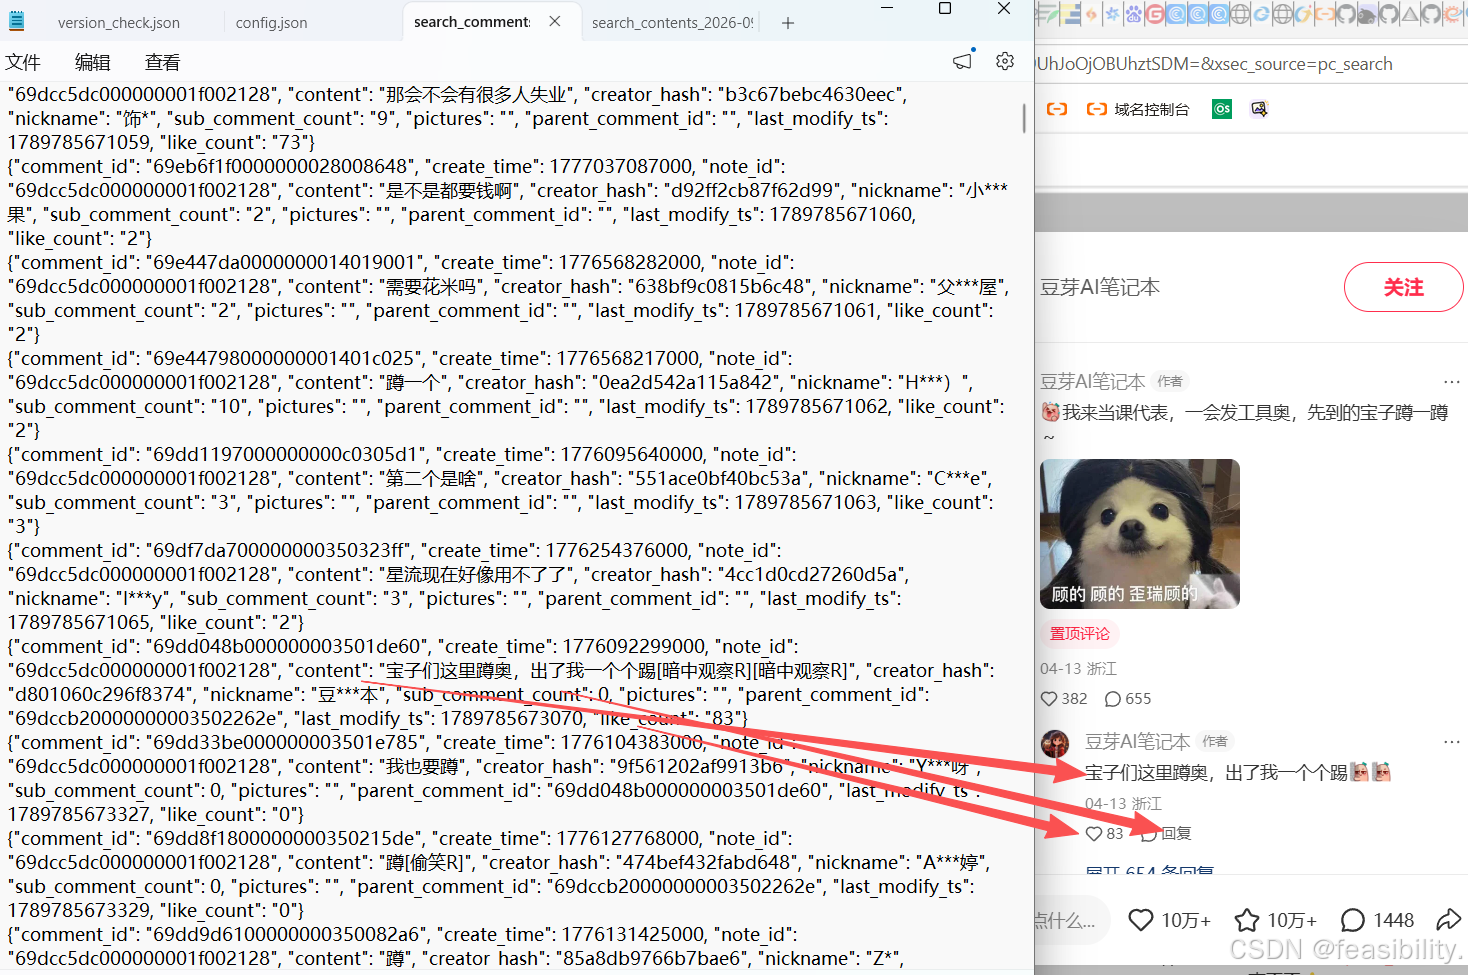
同样简单分析存储评论内容的参数,comment_id是评论的标识id,note_id是对应的笔记标识,content是评论内容,sub_comment_count是子评论数量,parent_comment_id是上一级评论的标识id,有parent_comment_id参数说明是这个评论不是一级评论
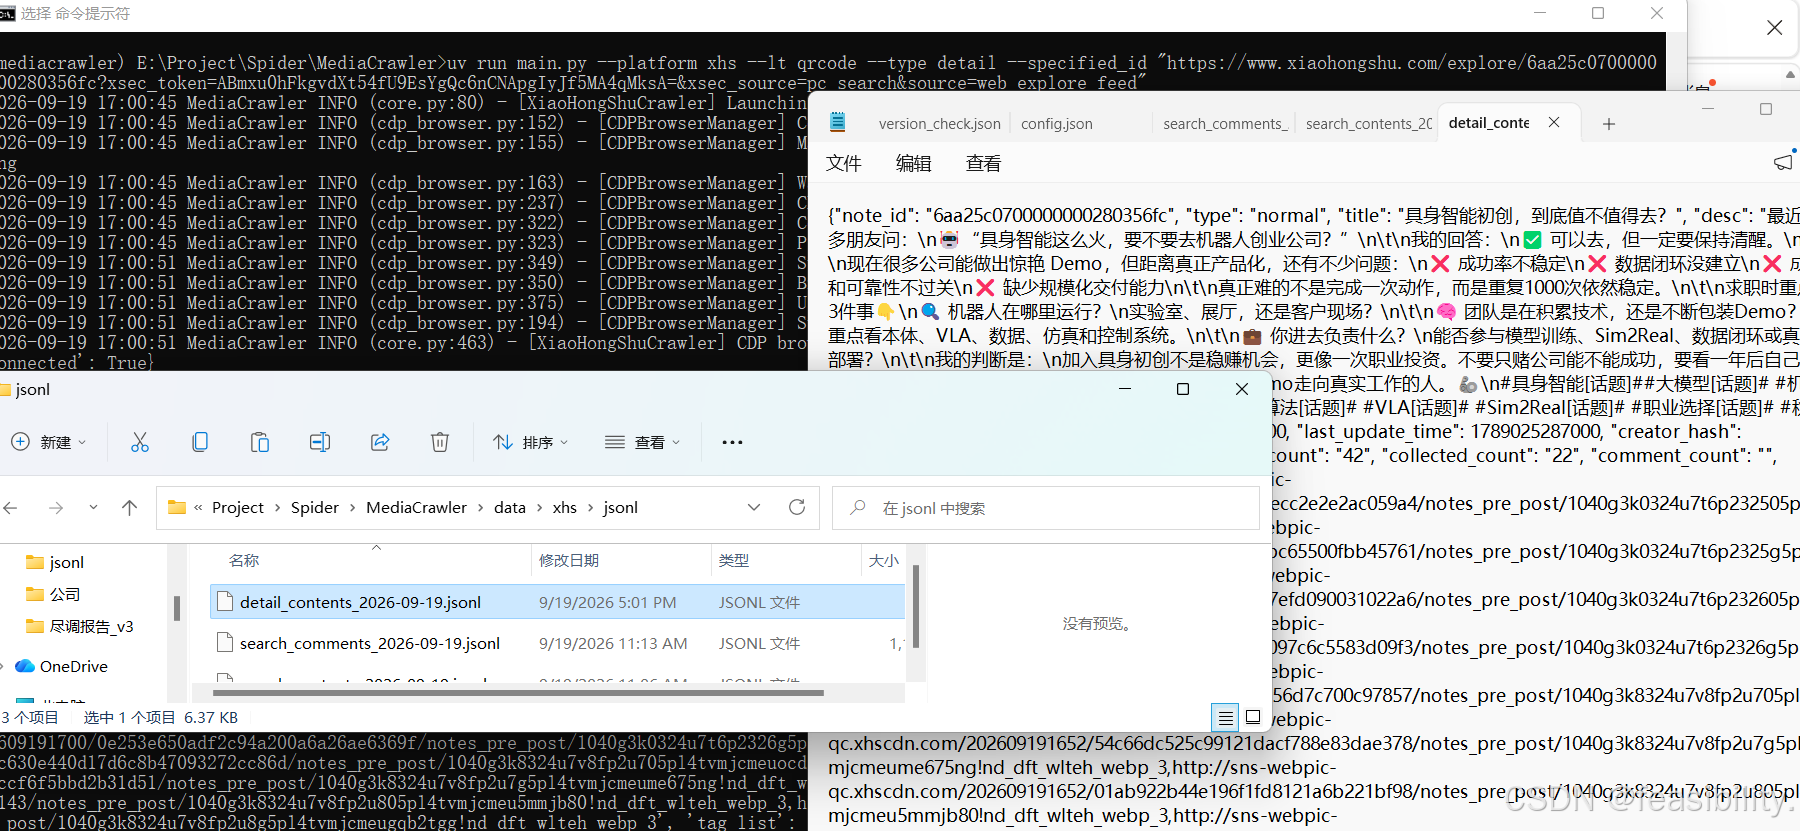
如果看到某个笔记不错,想抓取,可以执行uv run main.py --platform xhs --lt qrcode --type detail --specified_id "笔记链接",链接格式可以是https://www.xiaohongshu.com/explore/\<笔记id>?xsec_token=<具体xsec_token>&xsec_source=pc_feed
注意是英文引号否则可能报错,出现弹窗同样点击允许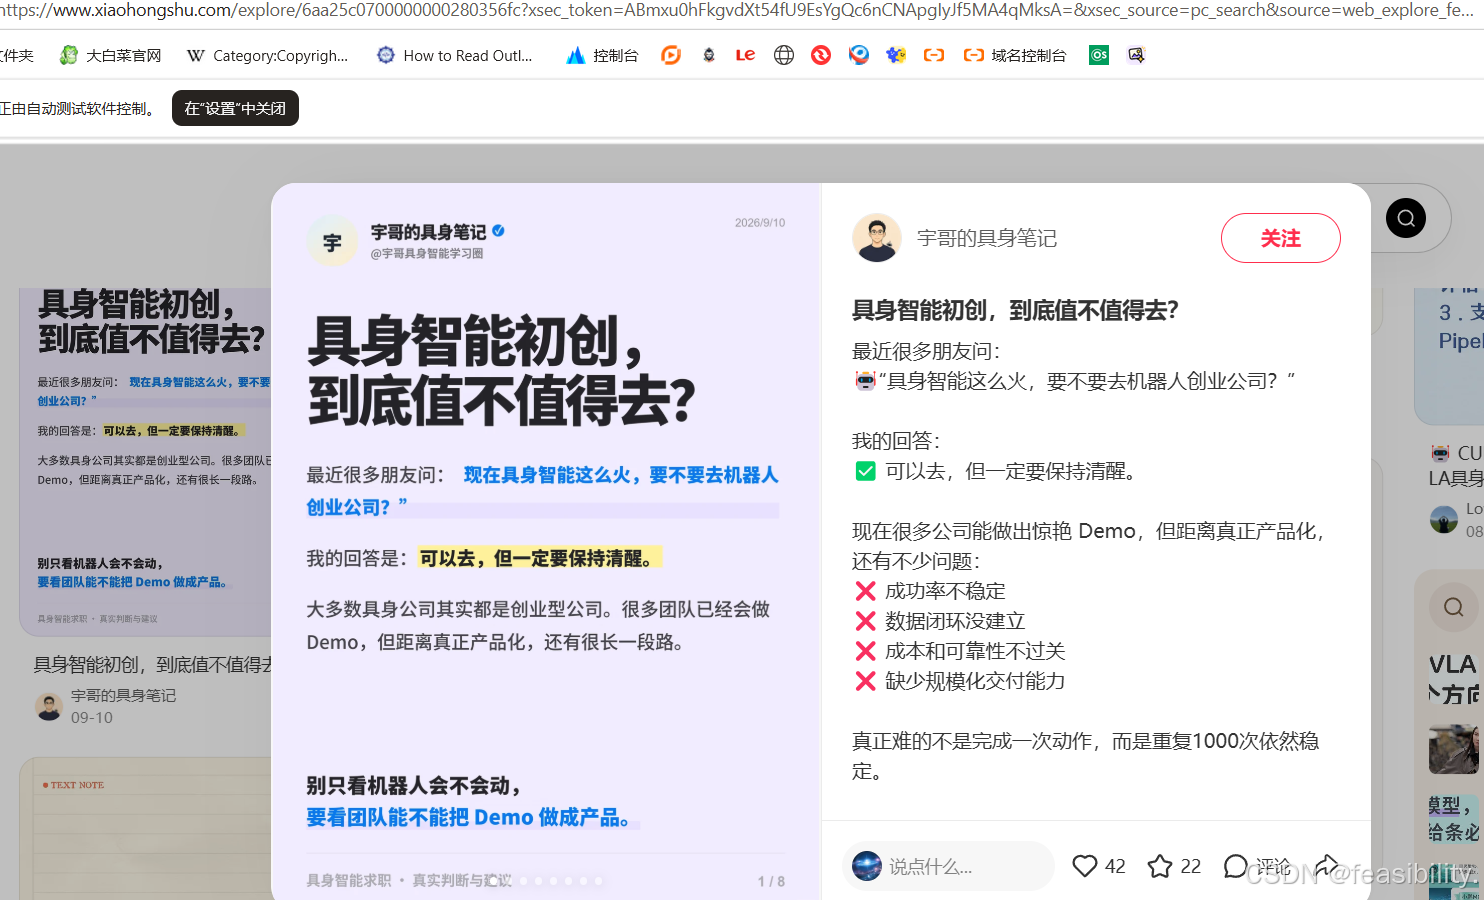
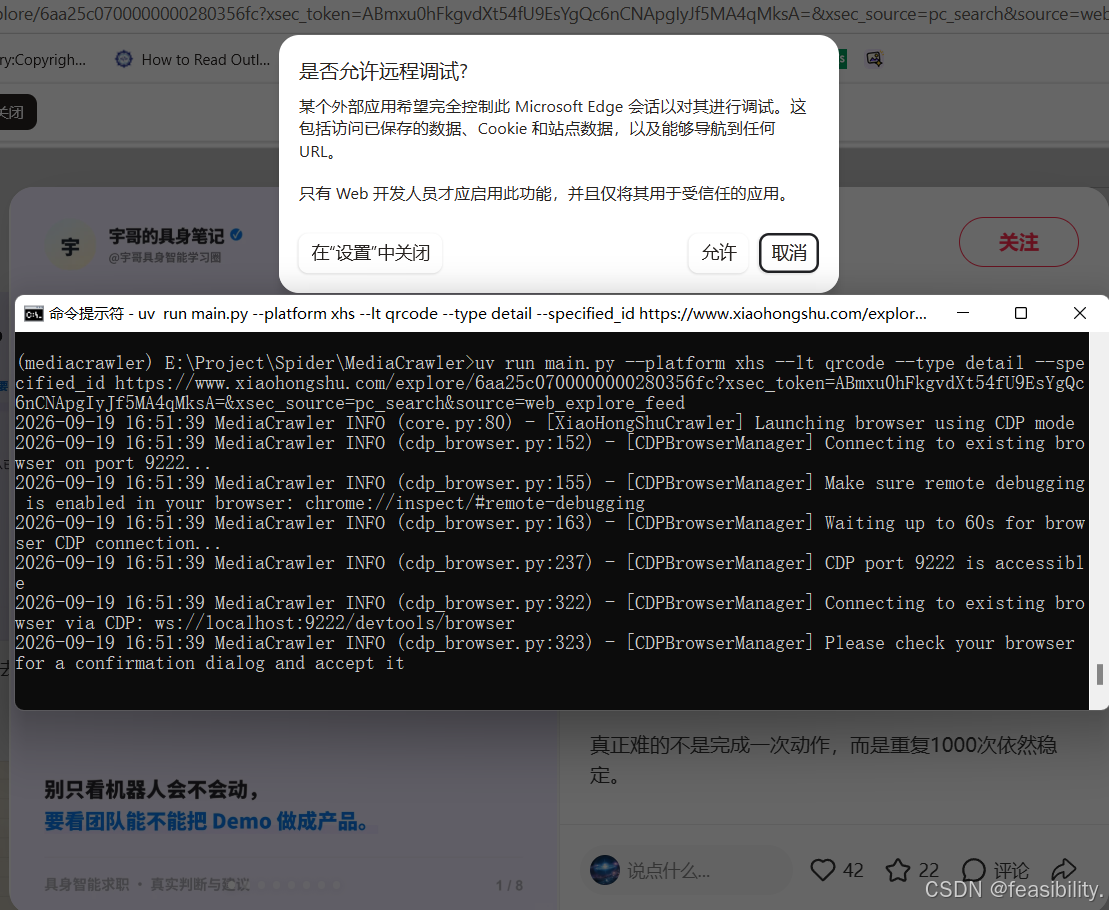
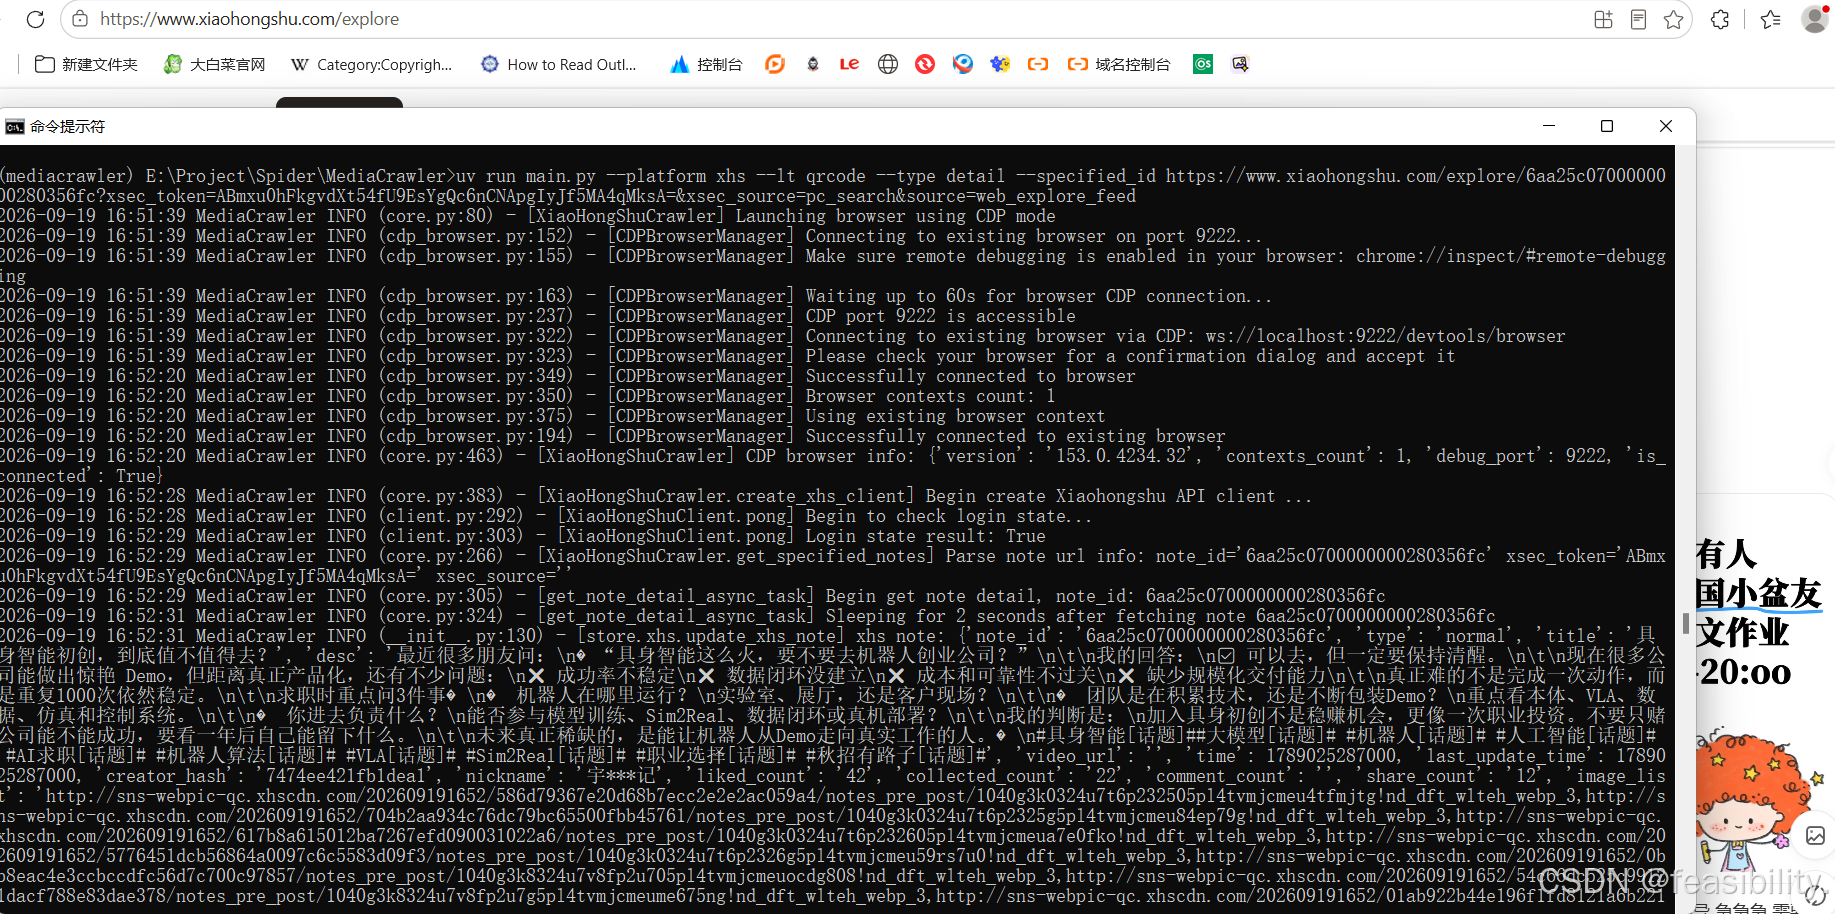
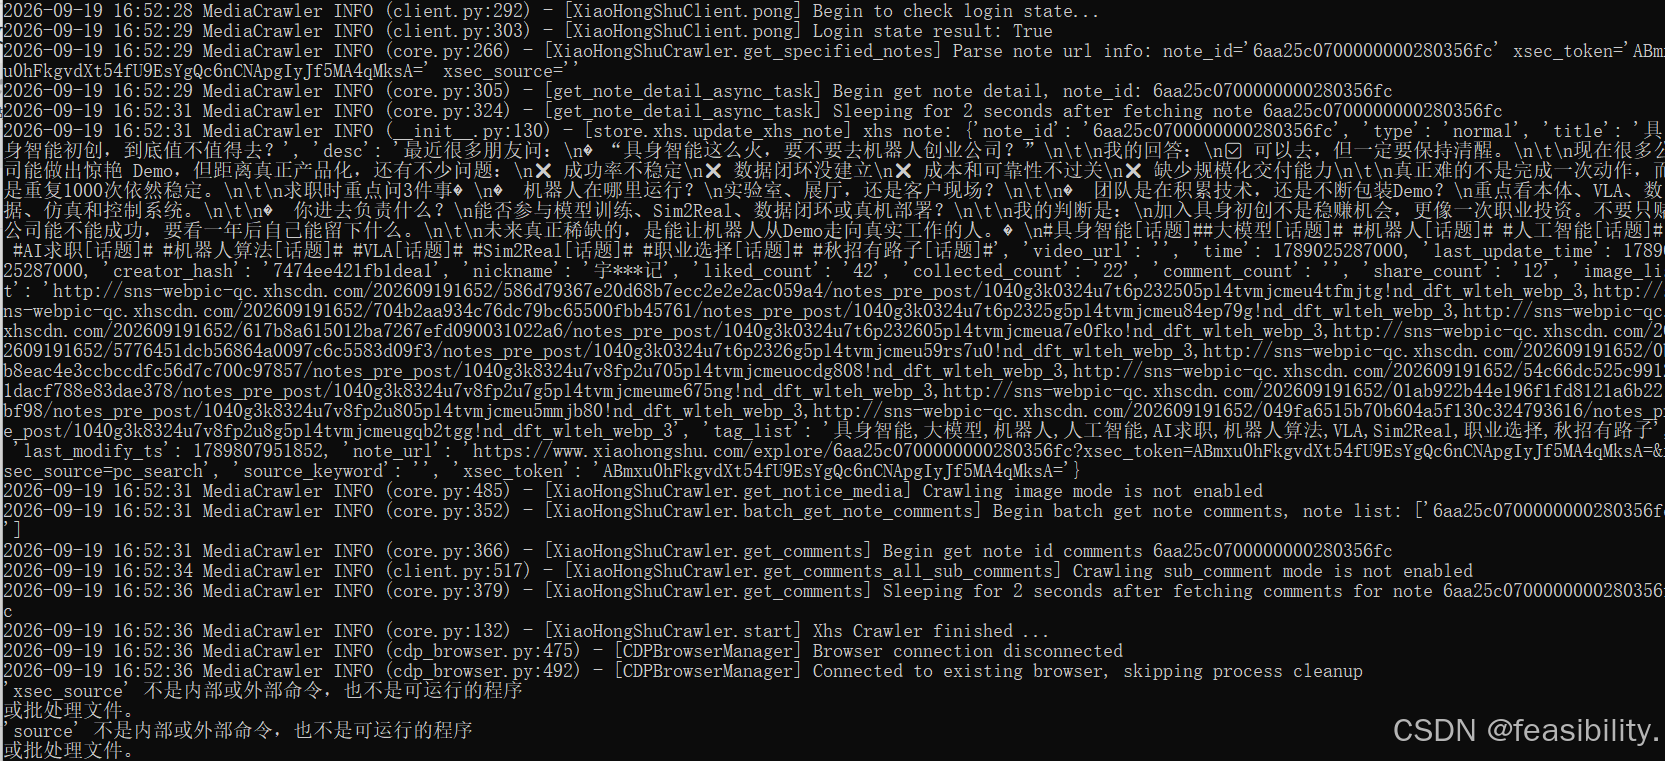
链接不加引号出现报错,末尾那两行 'xsec_source'/'source' 不是内部或外部命令 是 Windows cmd 把 URL 里的 & 当成命令分隔符报的错,这里刚好不影响采集
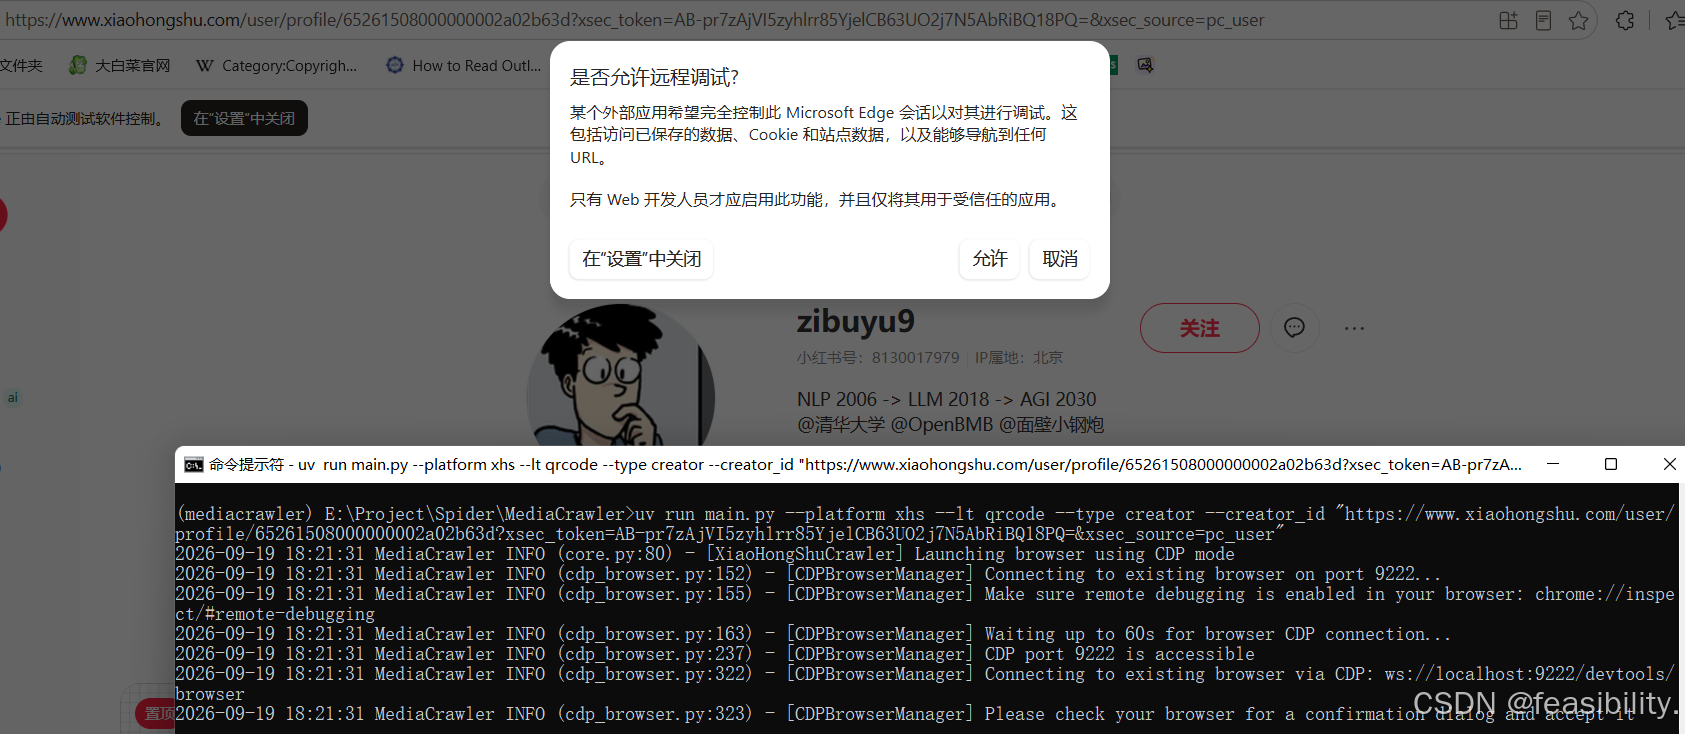
当看到某个博主的笔记不错,想抓取下来学习时,可以执行uv run main.py --platform xhs --lt qrcode --type creator --creator_id "https://www.xiaohongshu.com/user/profile/\<博主id>?xsec_token=<具体xsec_token>&xsec_source=pc_user"采集小红书博主主页全量
采集抖音
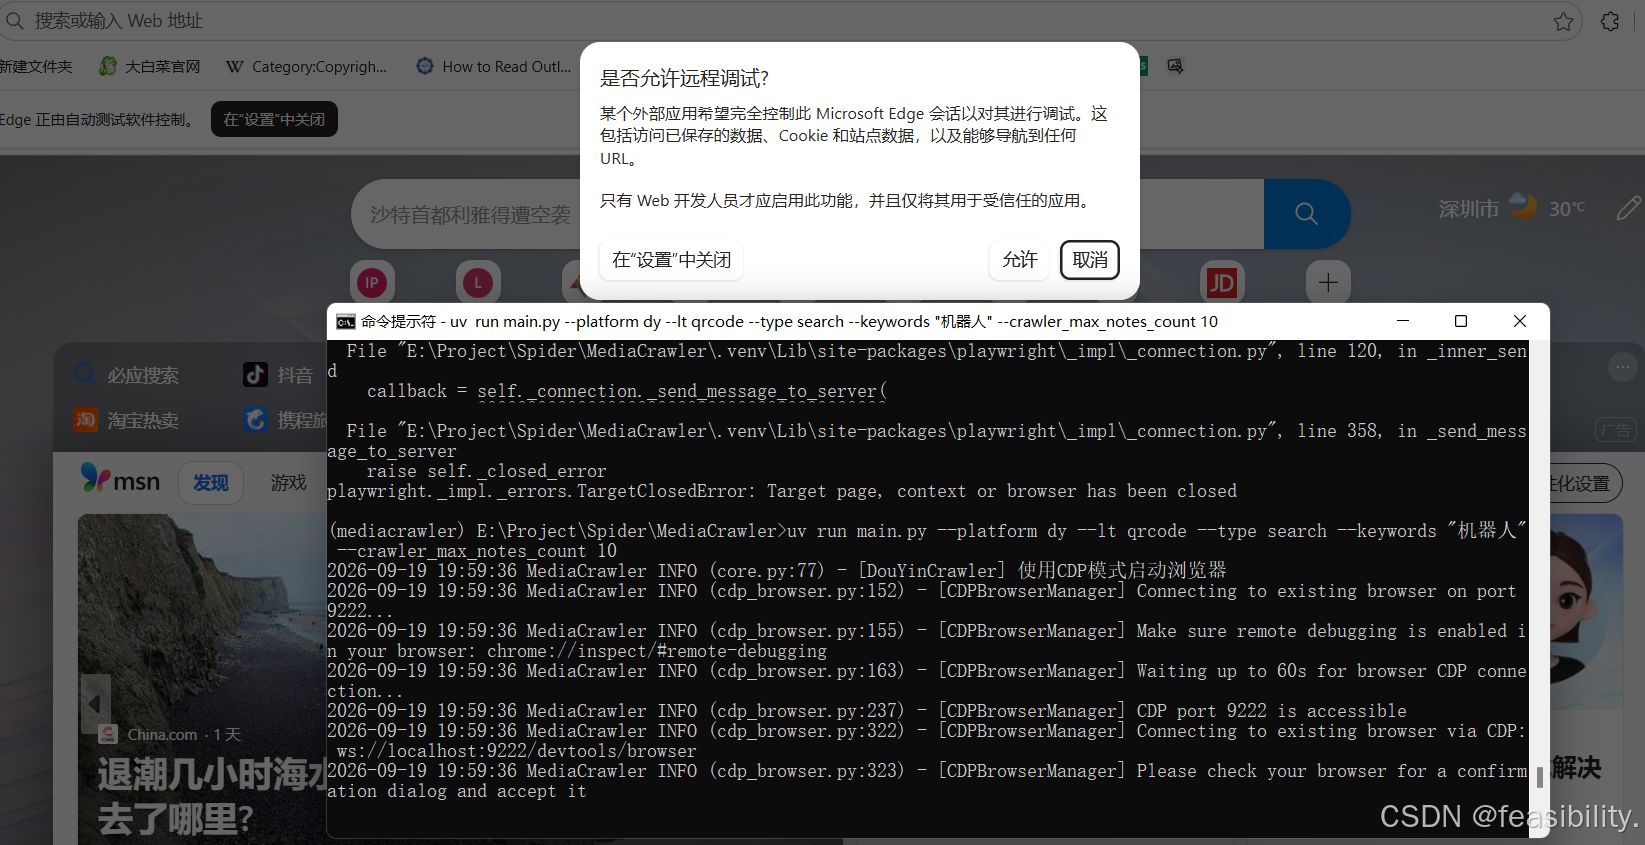
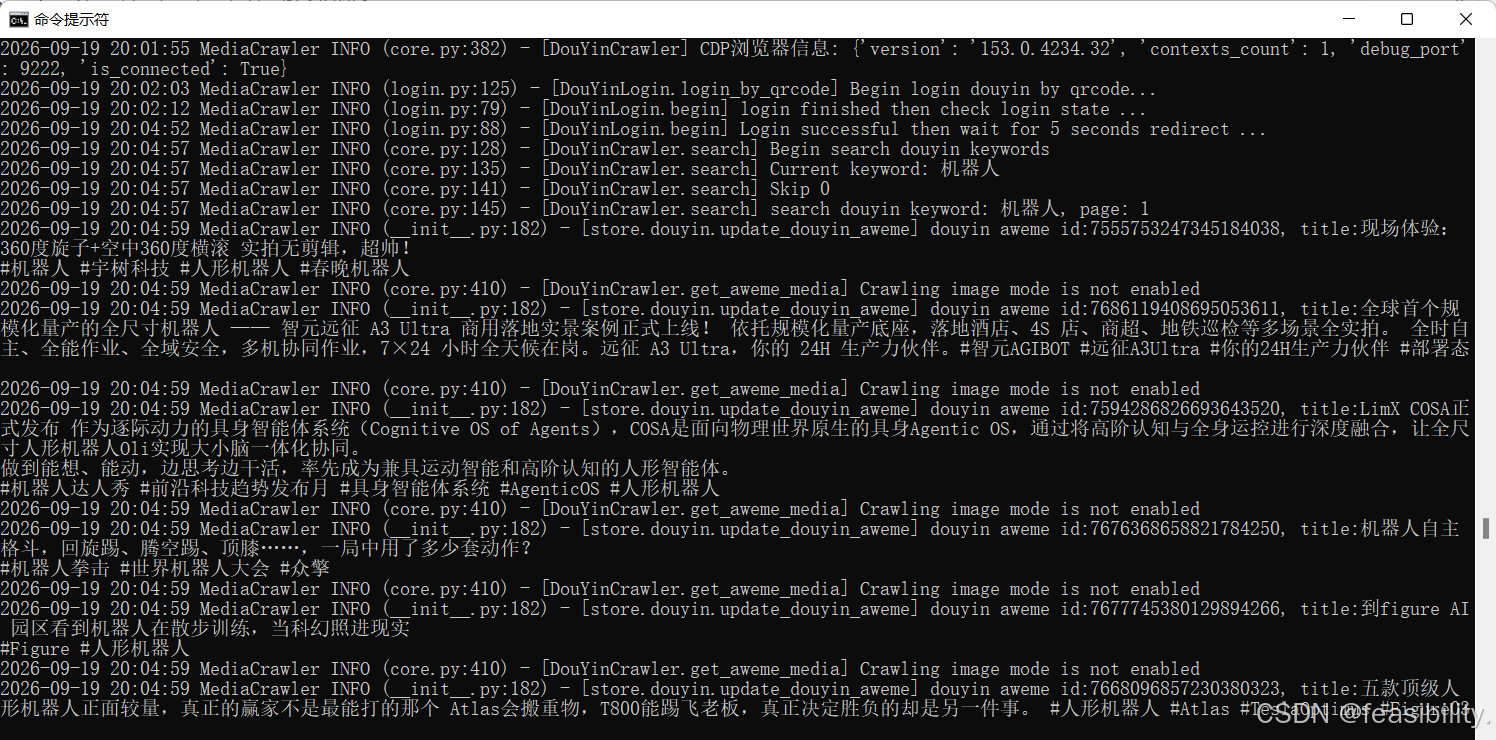
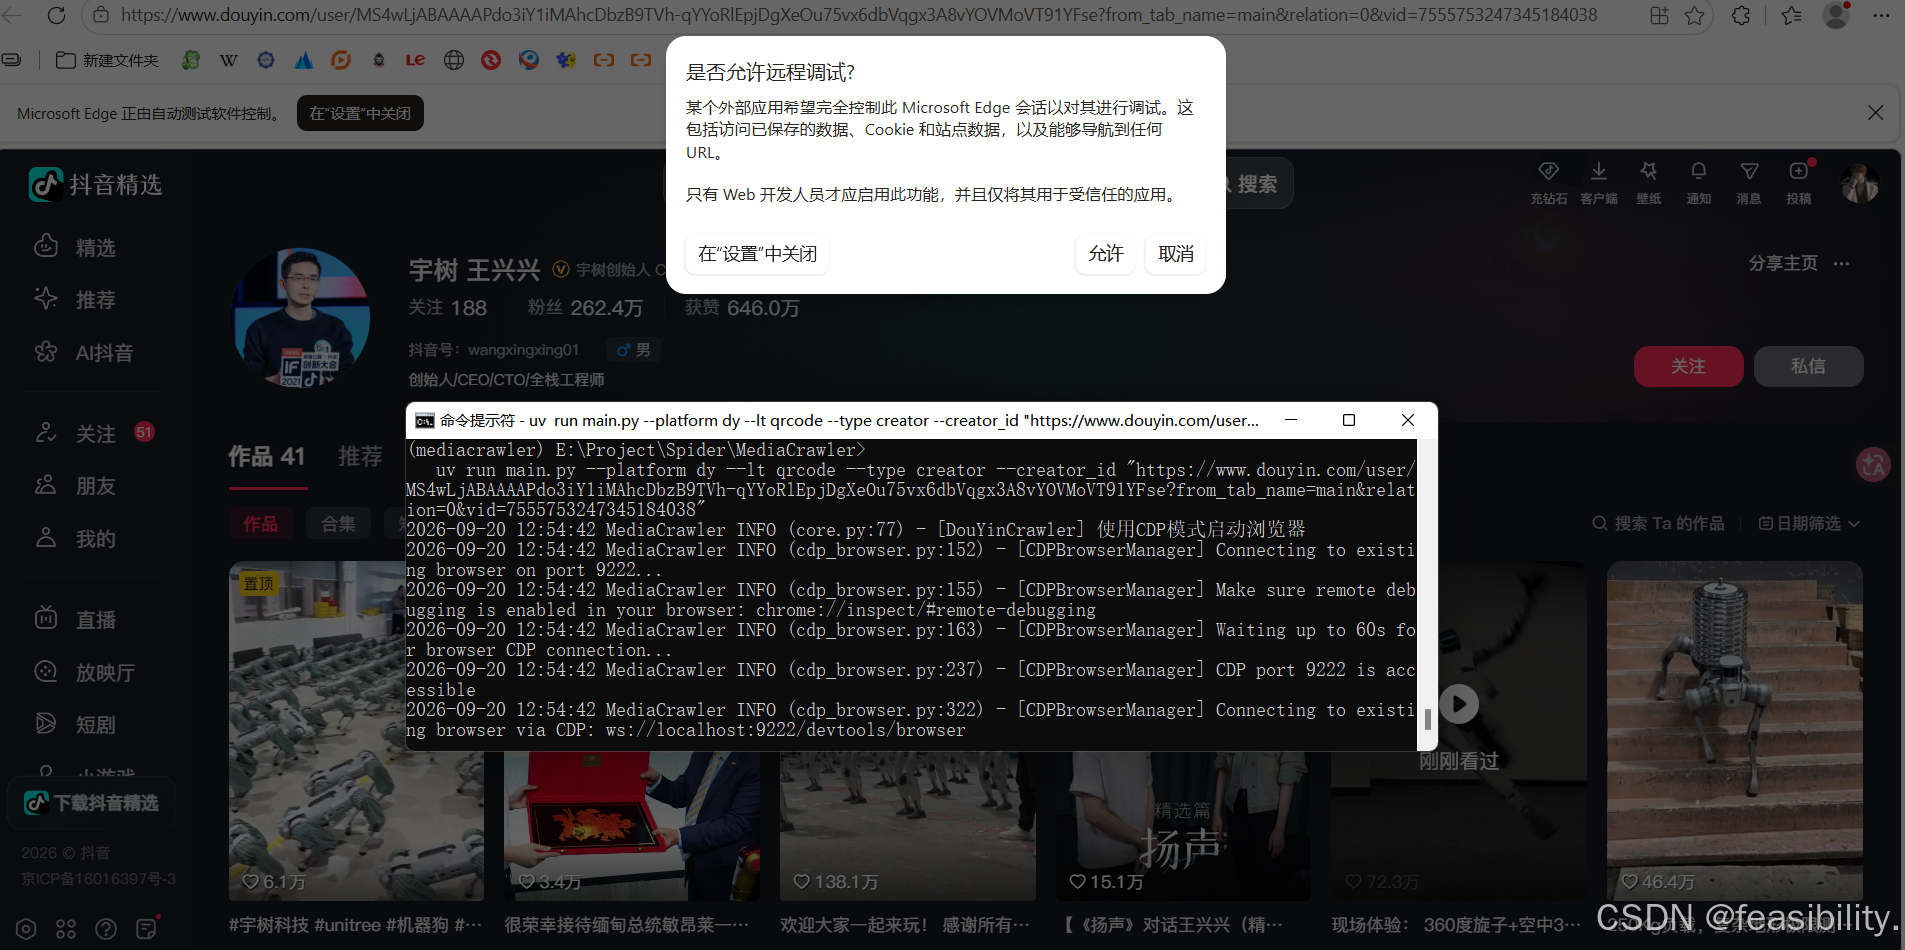
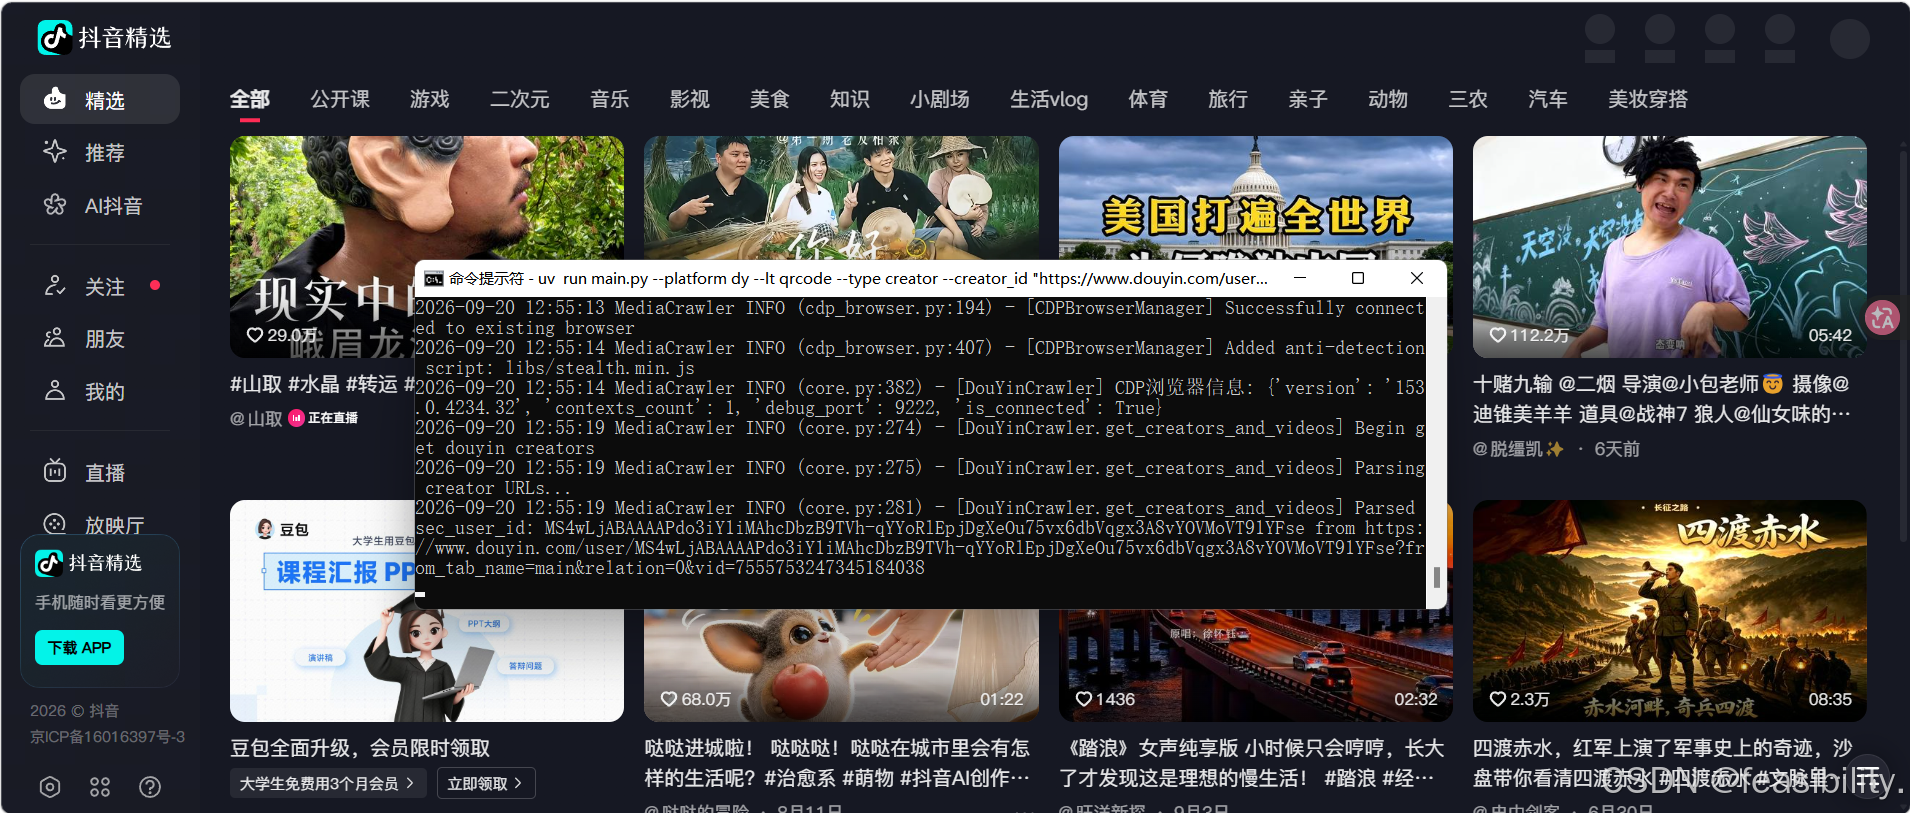
想抓取某个主题的相关视频内容及评论,执行uv run main.py --platform dy --lt qrcode --type search --keywords "机器人" --crawler_max_notes_count 10
扫码登录后可能还需要二次效验
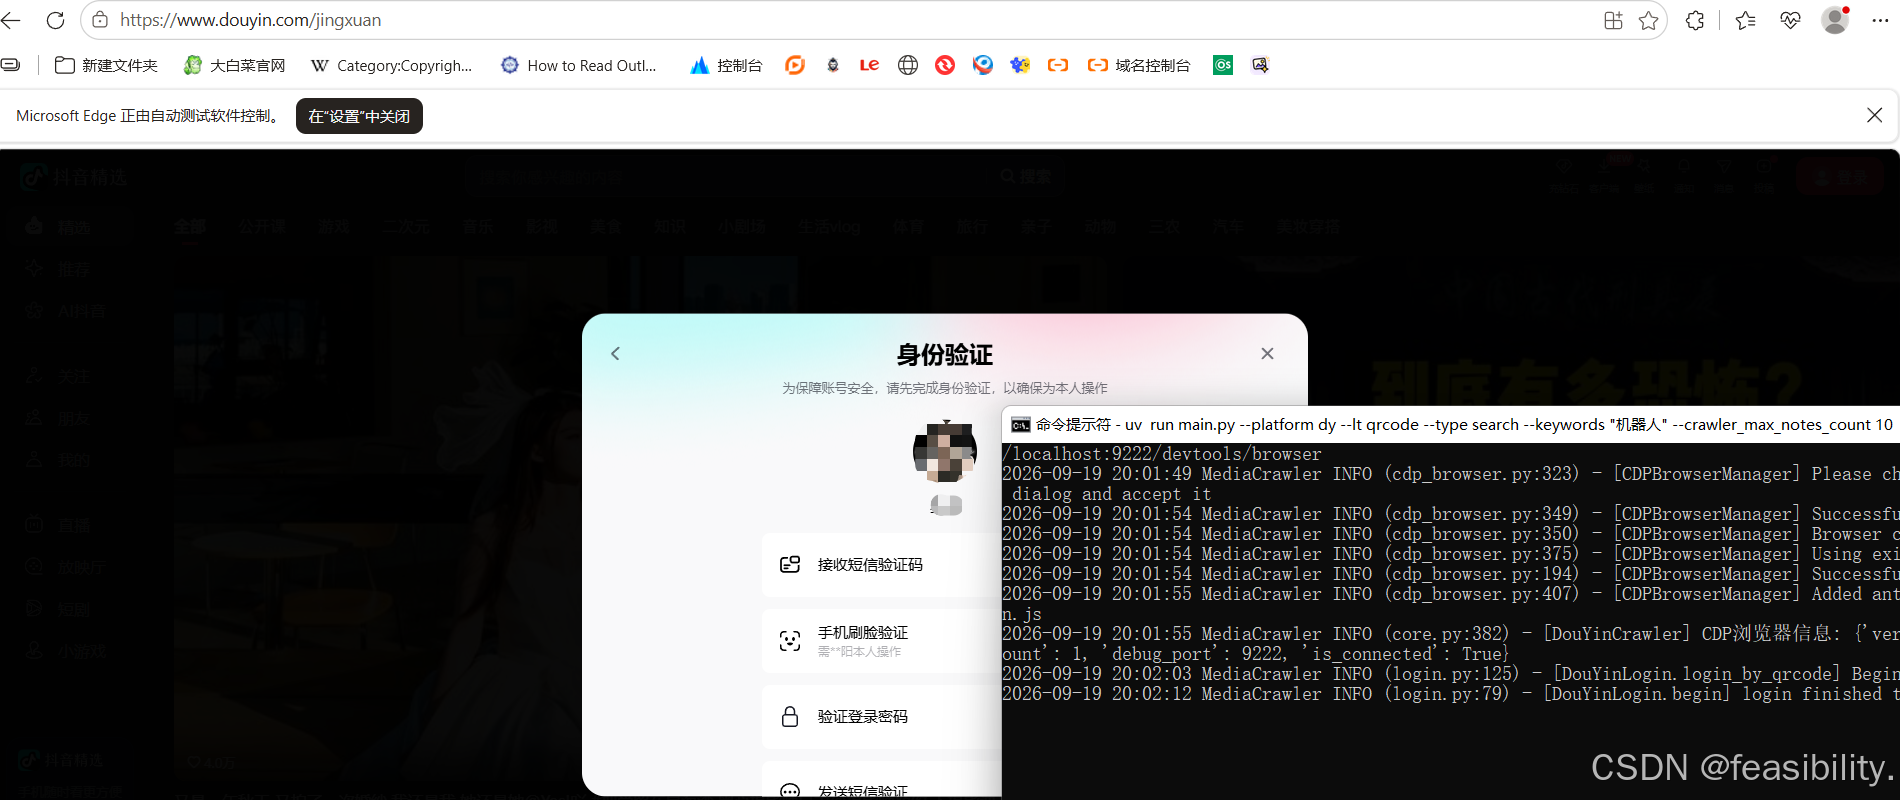
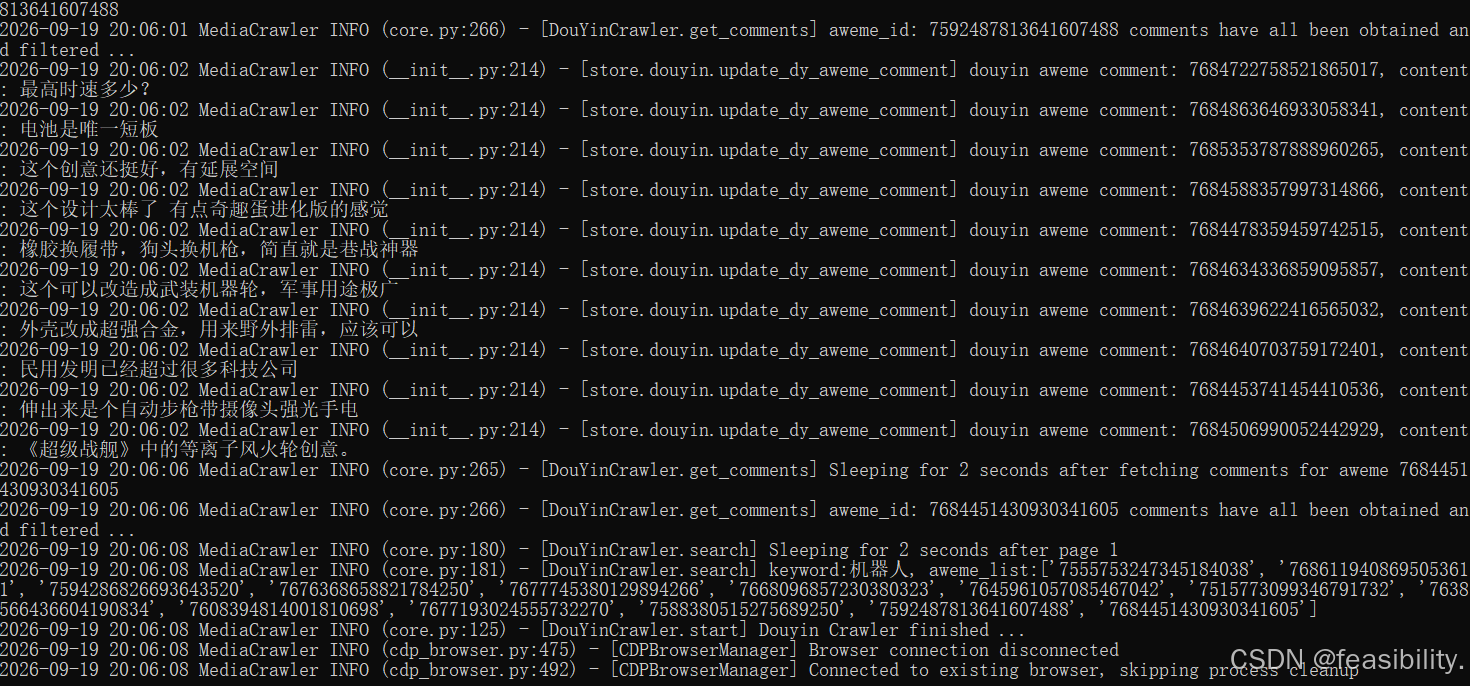
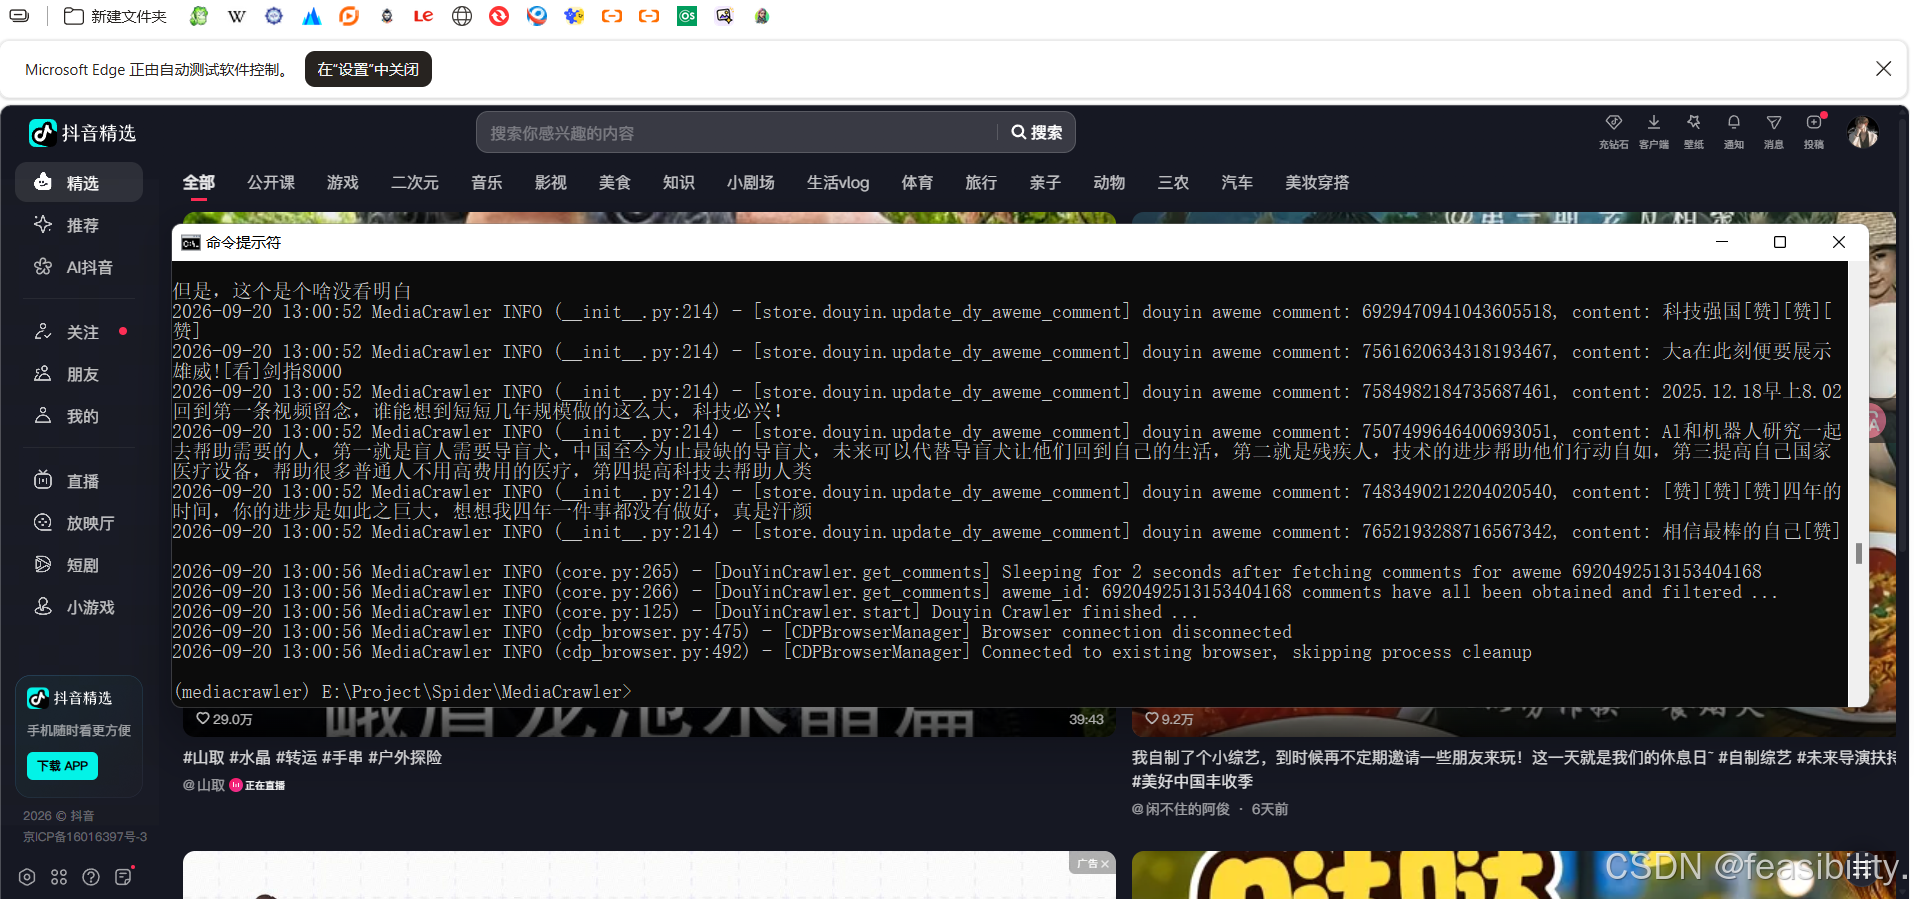
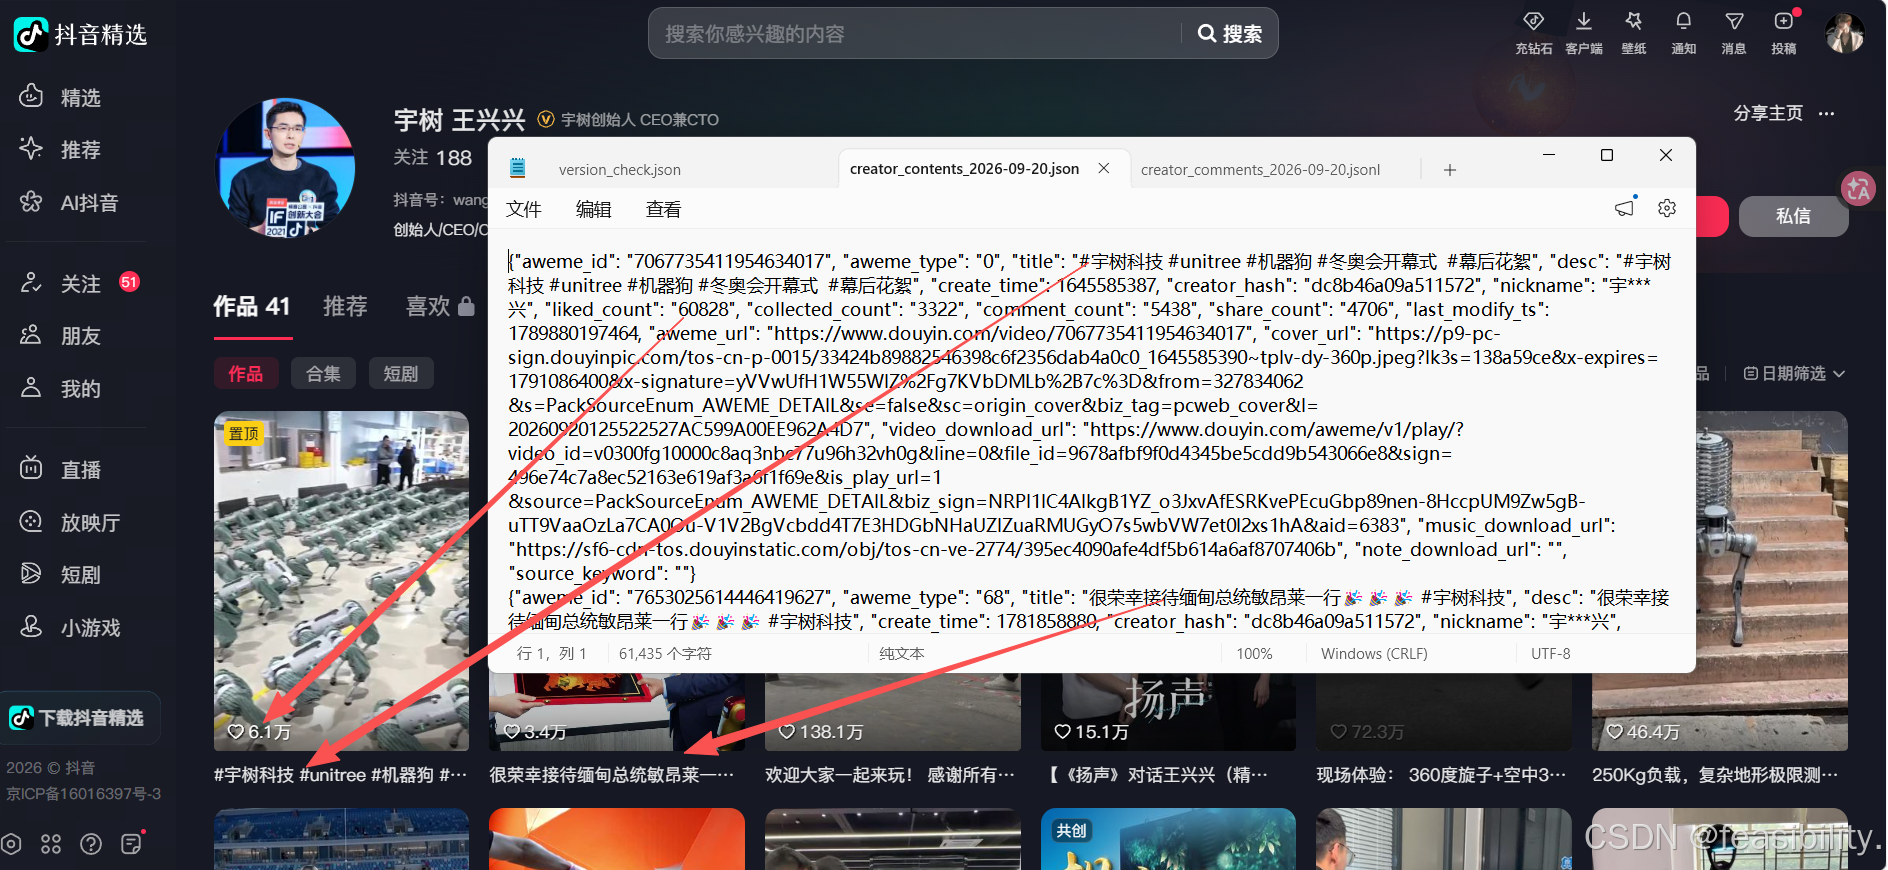
部分抓取过程,抓取结果默认放项目的data\douyin\jsonl
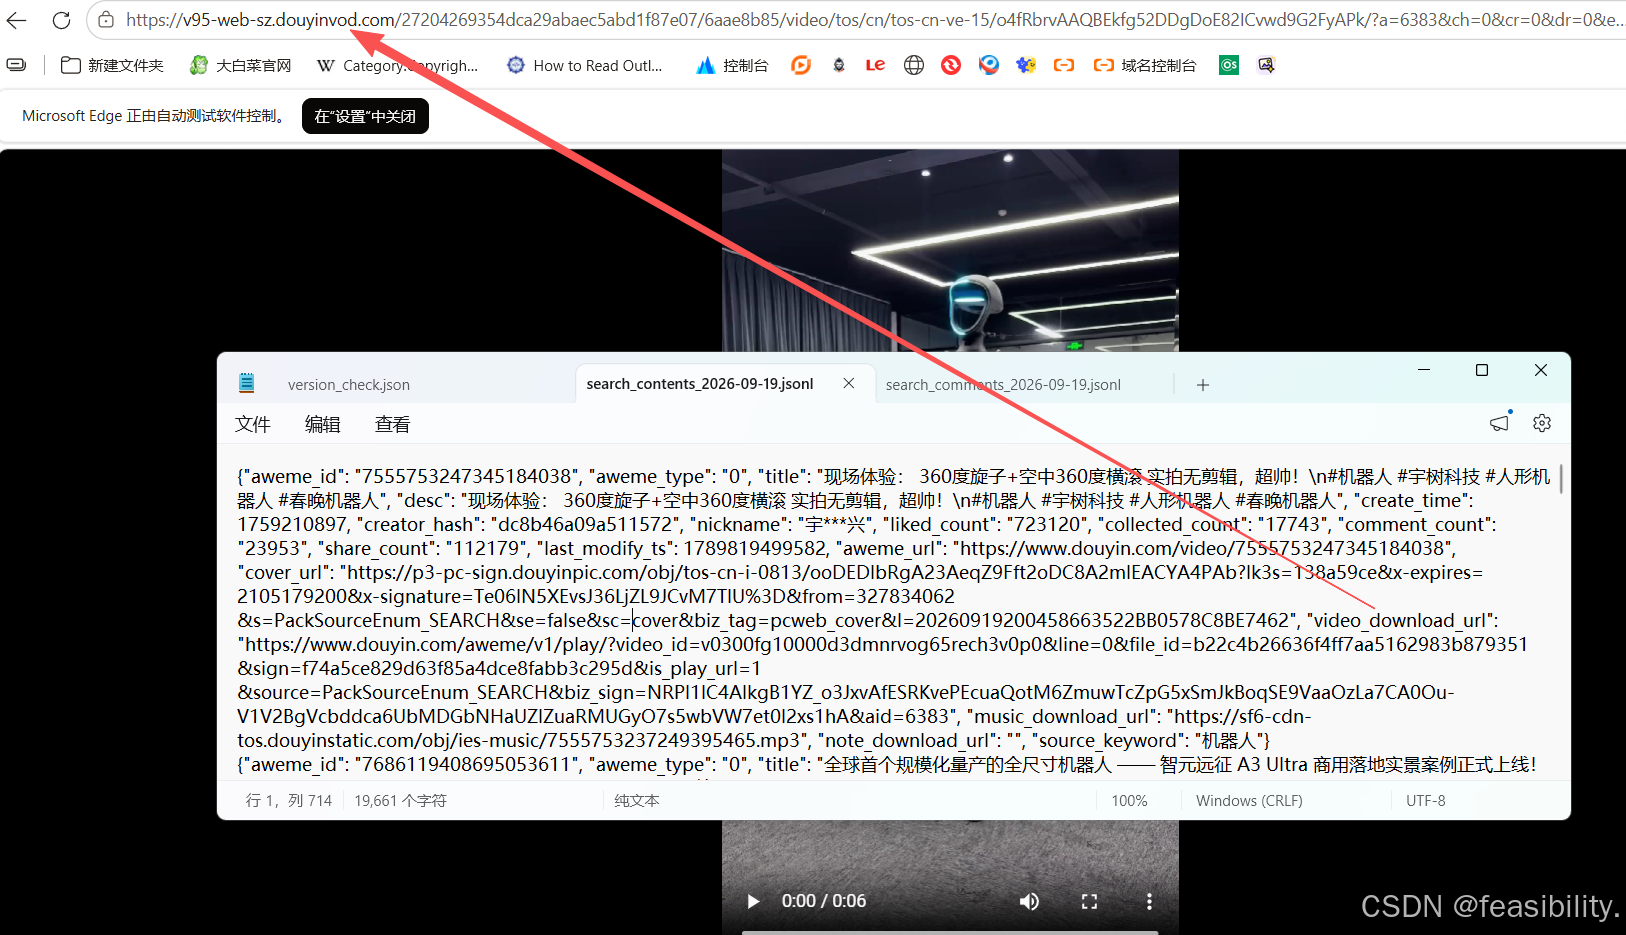
内容展示,参数和小红书差不多,简单分析其他参数,aweme_url是抖音视频链接,source_keyword是搜索关键词,video_download_url是视频下载链接,music_download_url是音乐链接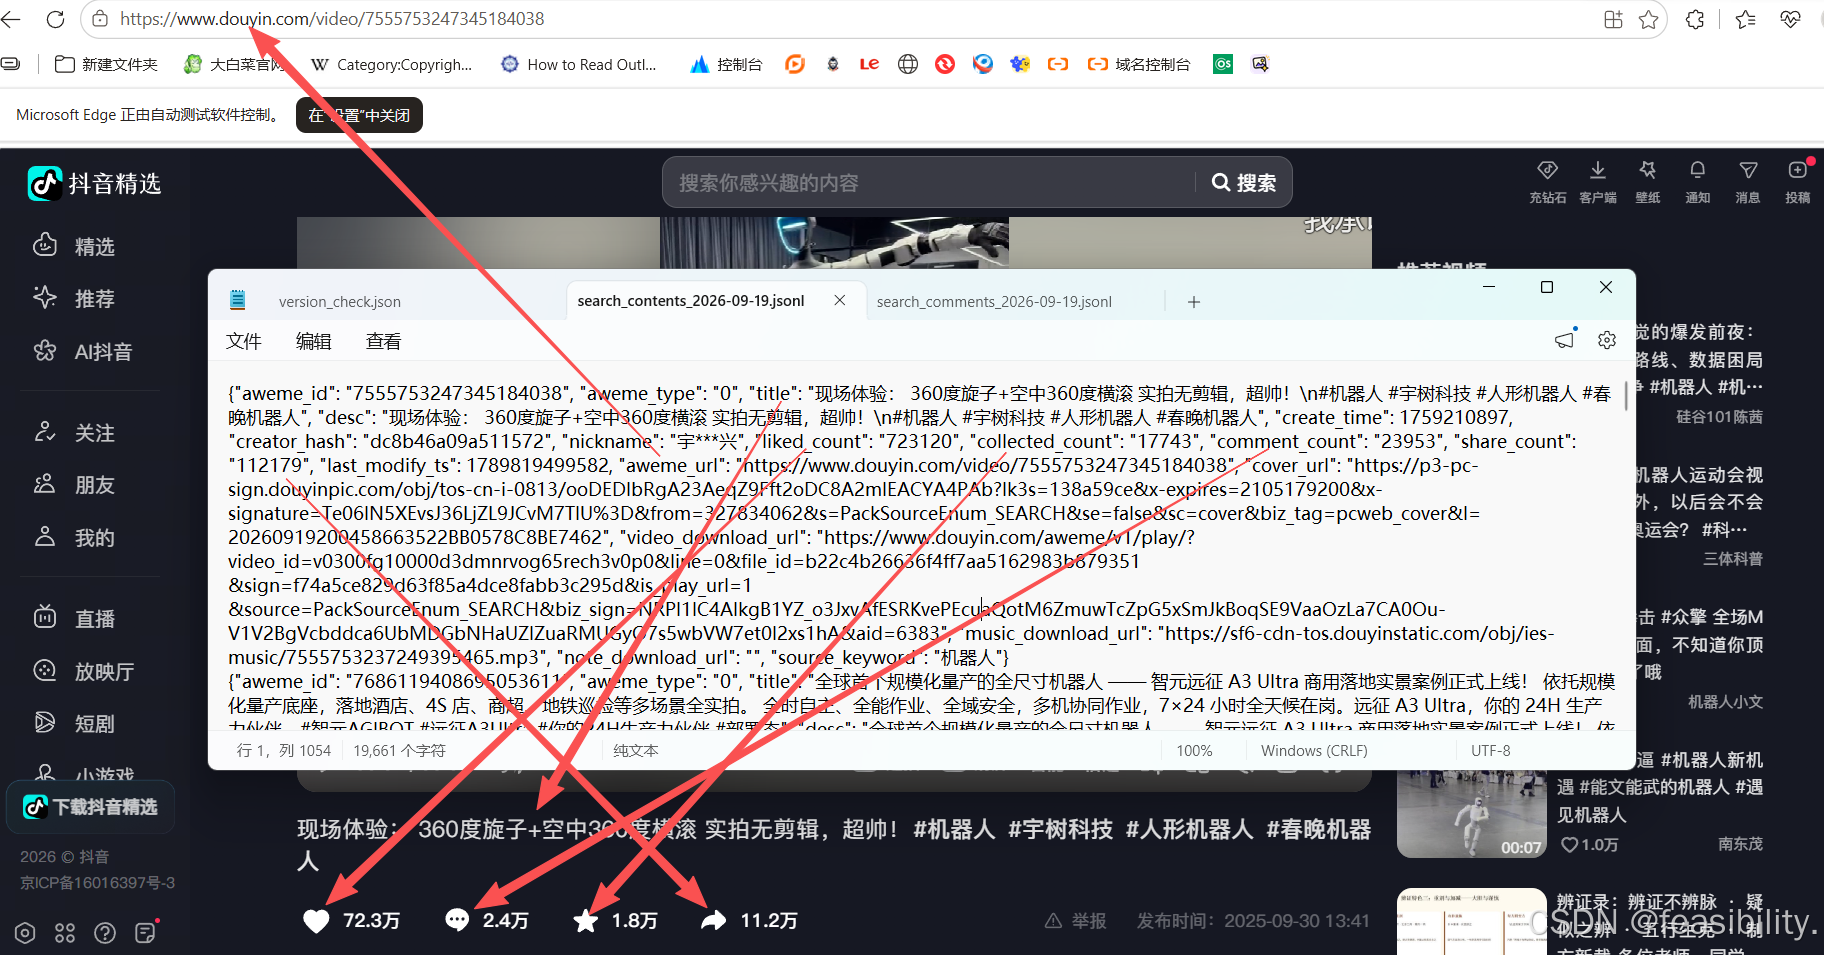
看到某个博主的内容不错,想分析,可以执行类似uv run main.py --platform dy --lt qrcode --type creator --creator_id "链接"
内容展示
采集微博
想抓取某个主题(如"人工智能")的相关视频内容及评论,参考执行uv run main.py --platform wb --lt qrcode --type search --keywords "具身智能" --crawler_max_notes_count 5
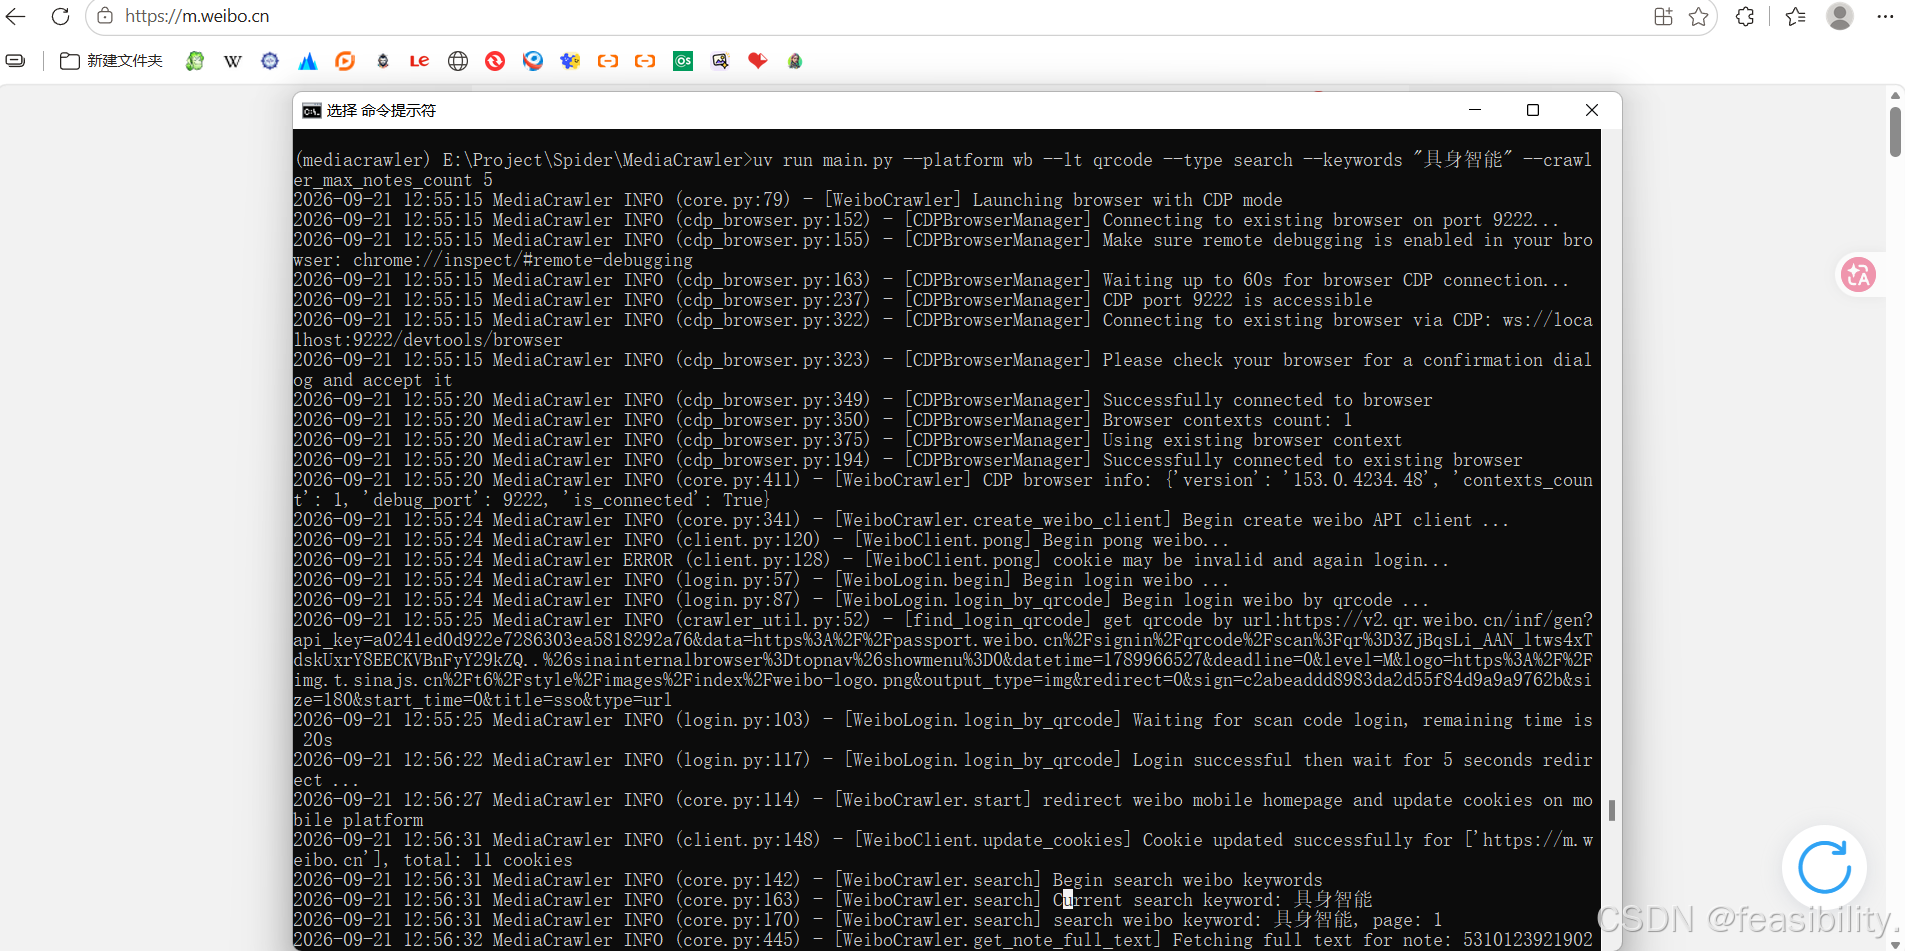
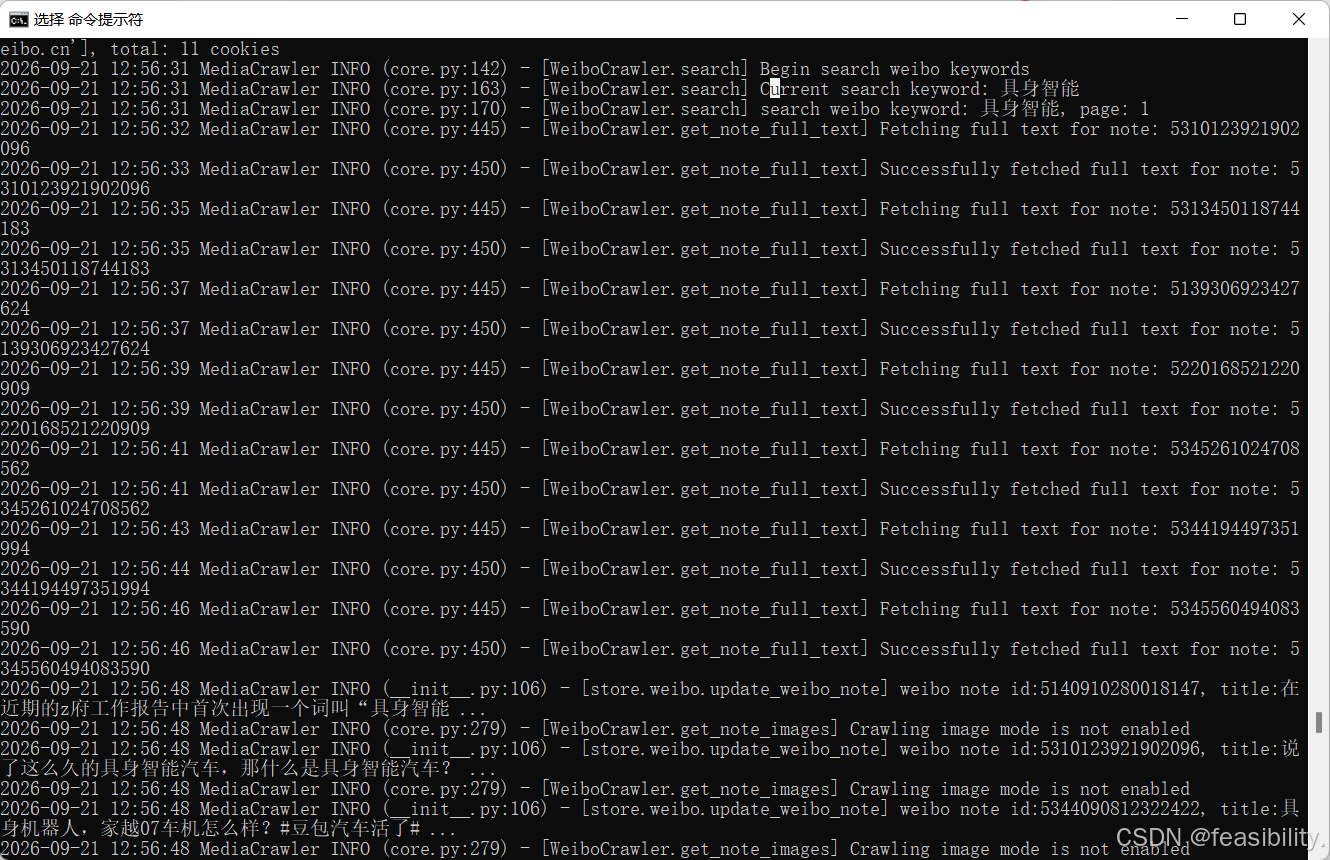
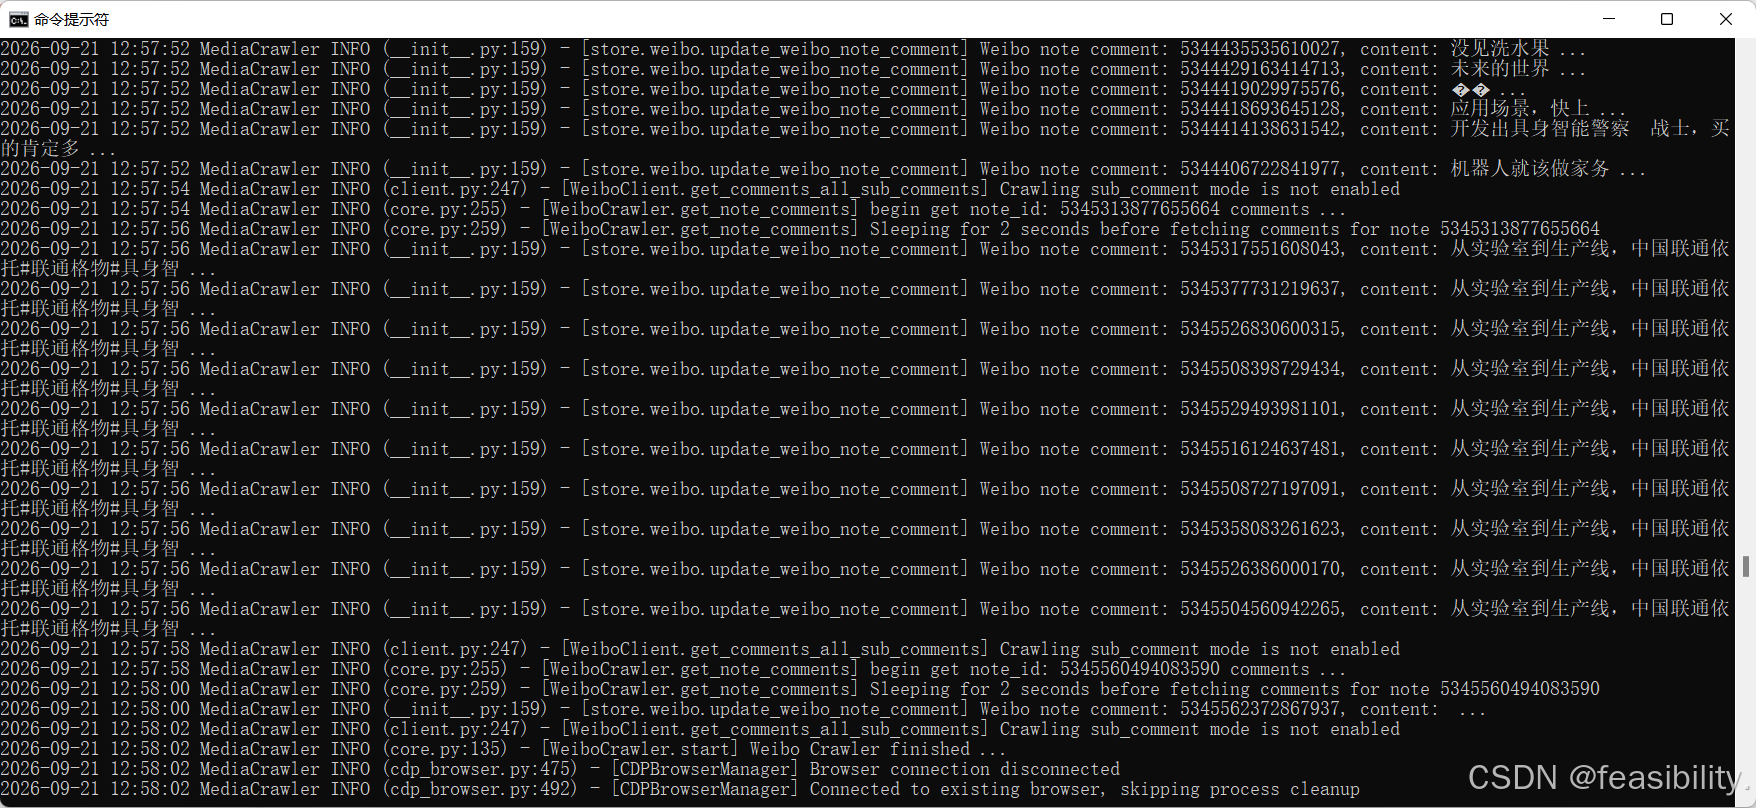
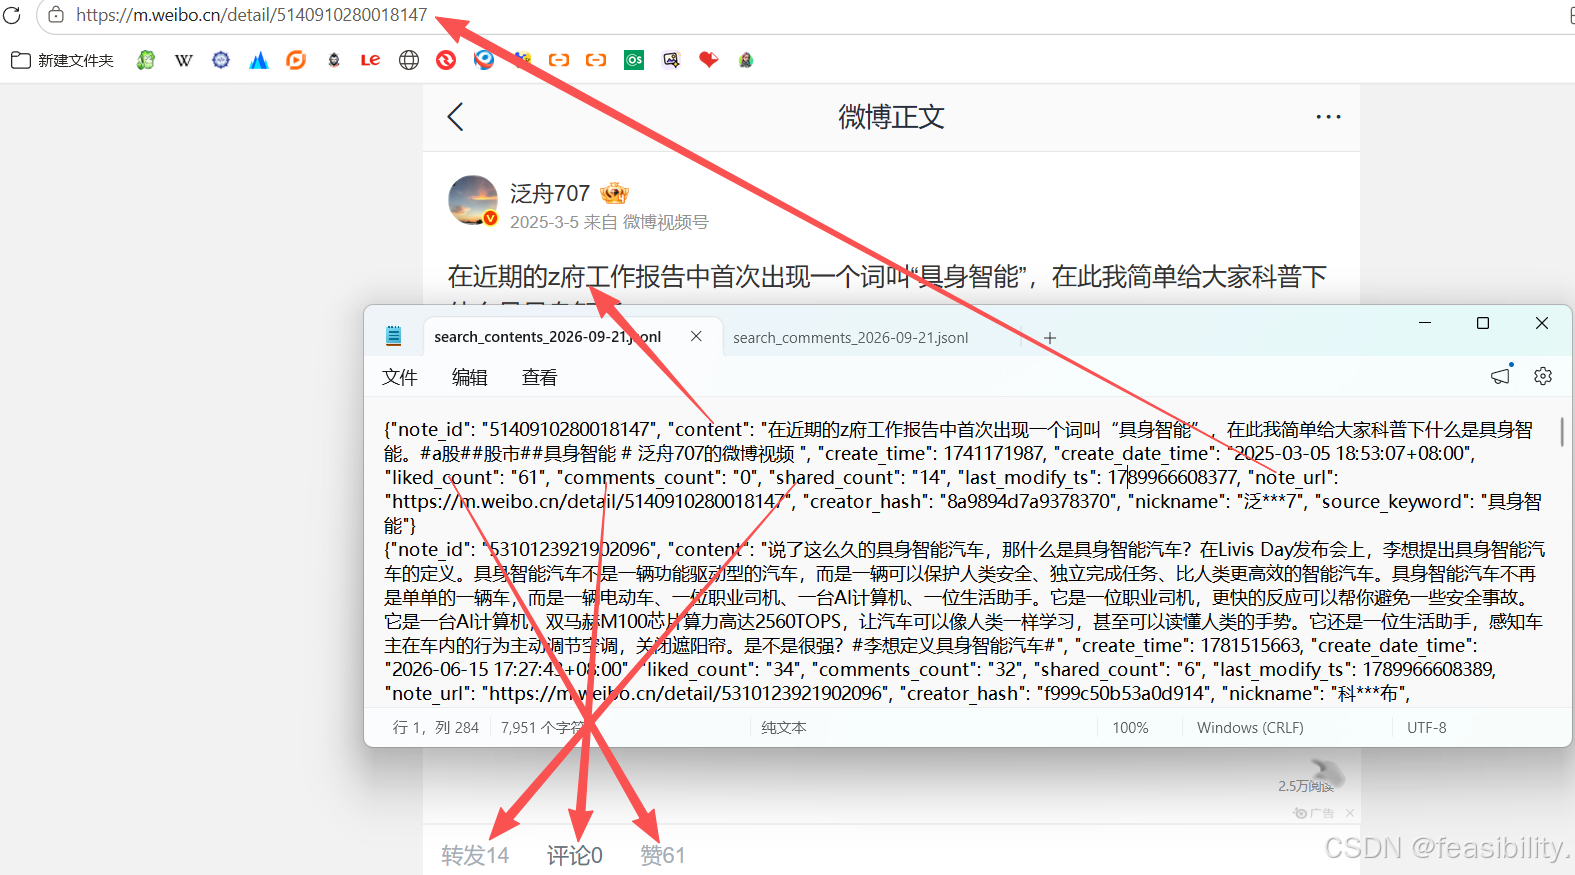
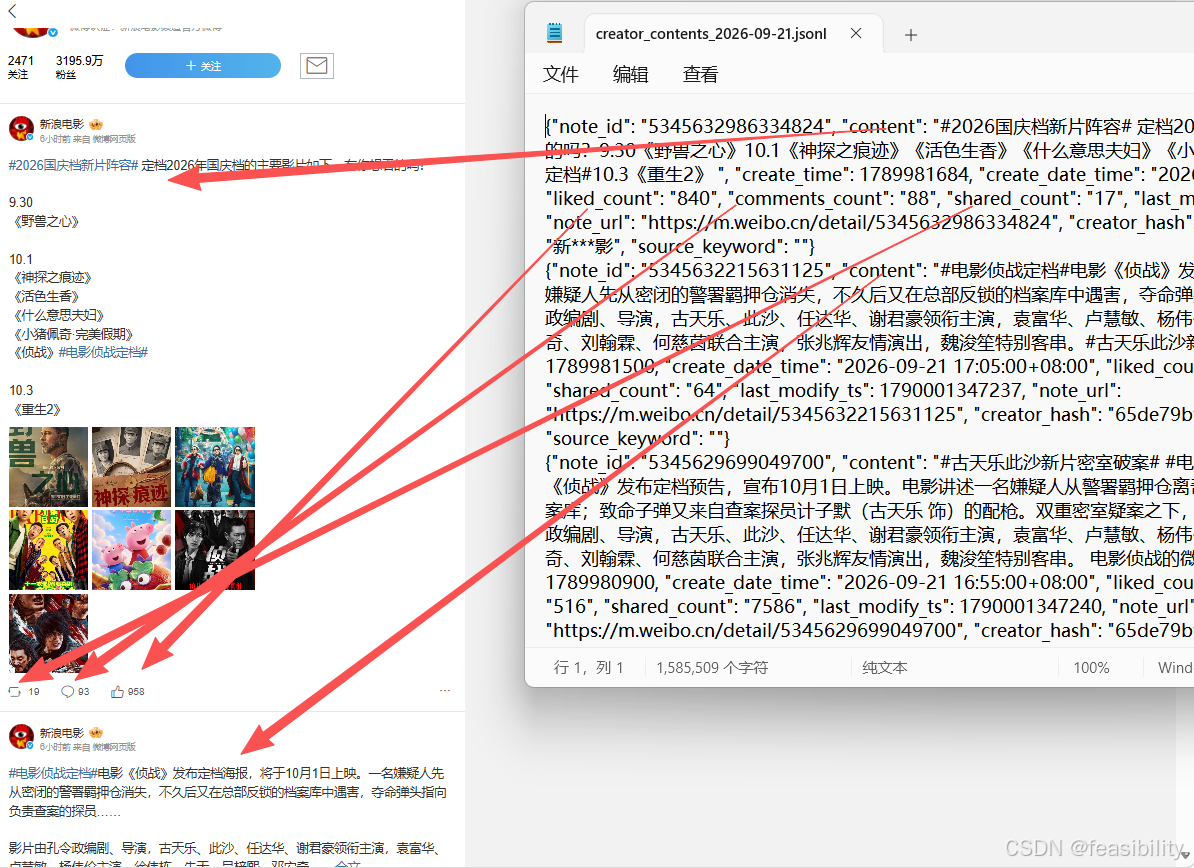
微博正文内容展示,参数和抖音差不多,其中note_url是抓到的微博内容链接
看到某个博主的内容不错,想分析,可以执行类似uv run main.py --platform dy --lt qrcode --type creator --creator_id "博主的uid",博主页链接是我https://m.weibo.cn/profile/\<uid>是,uid能连接"?"( ?后面是参数),creator_id 是支持多个uid用英文逗号分隔,注意如果博主发了很多微博正文会抓很久,可能会导致账号异常,建议数据抓得差不多时就按CTRL+C
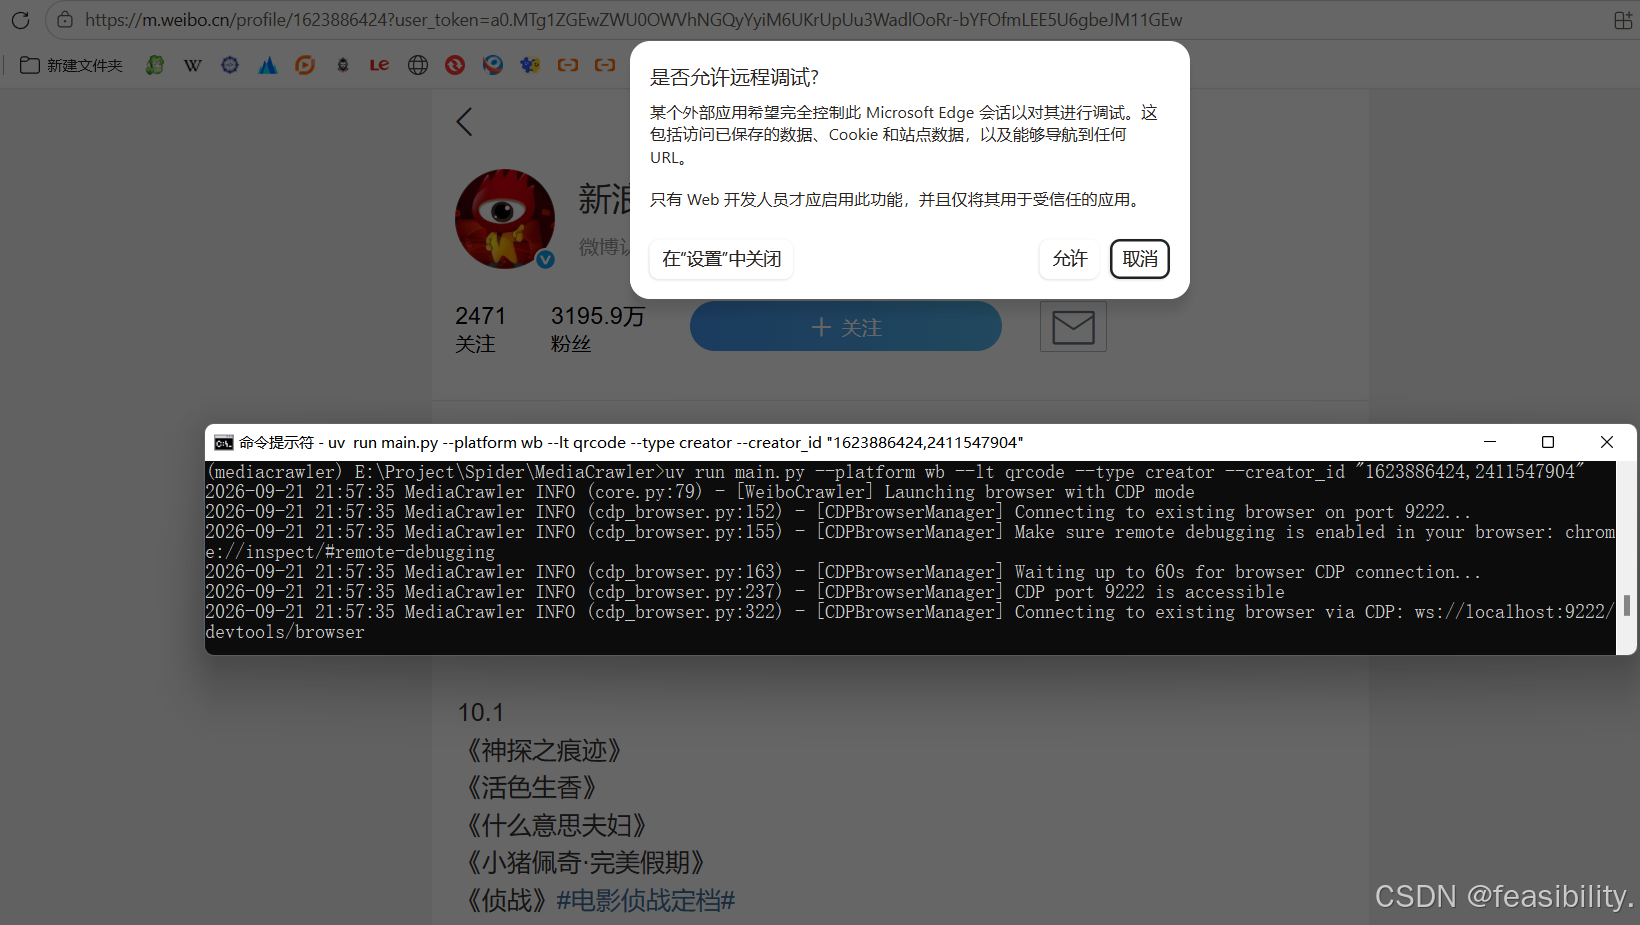
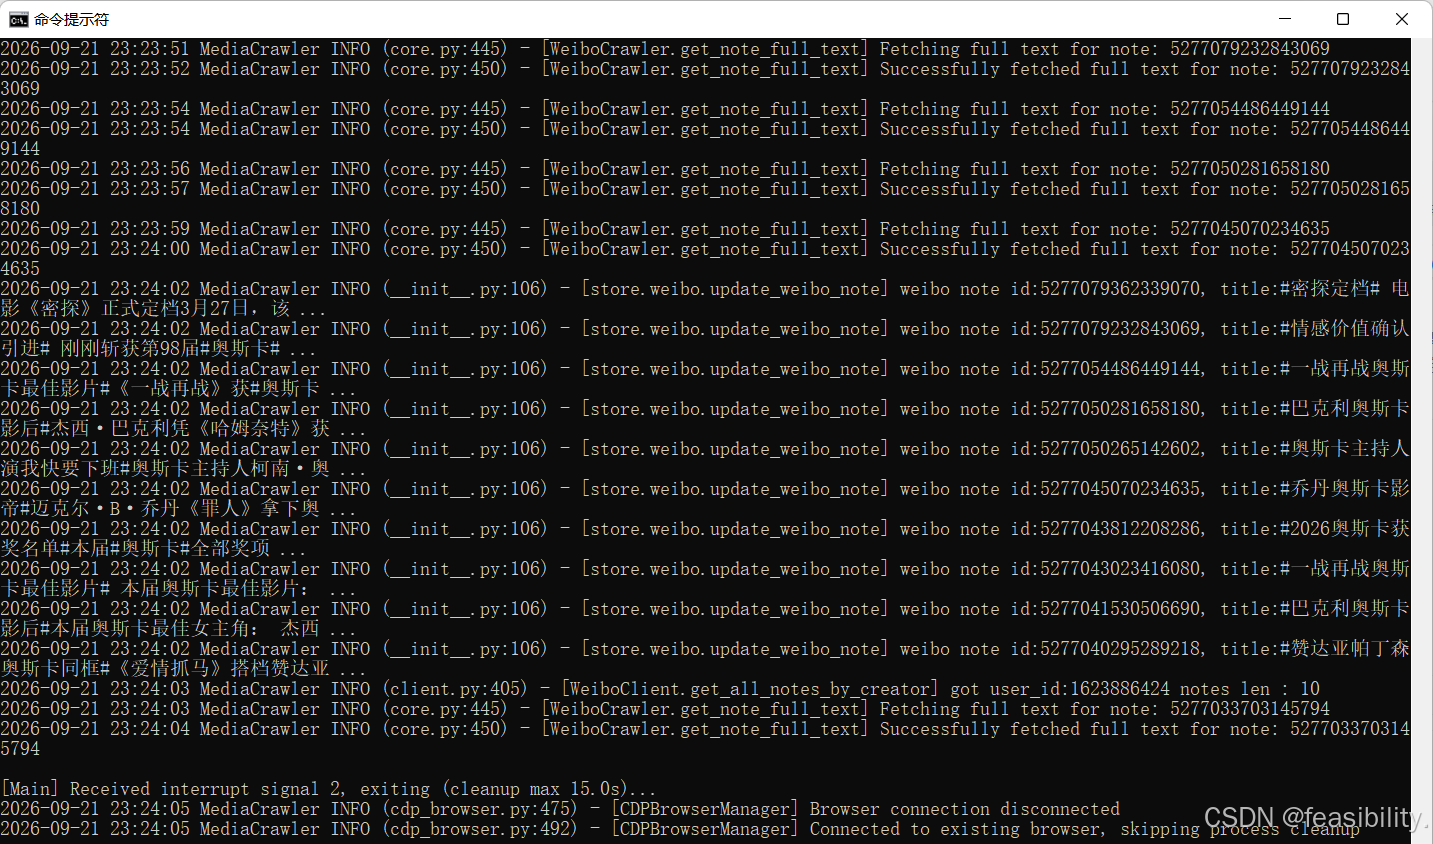
结果展示,分享数、点赞数和评论数对不上是因为有更多人在抓取这条微博正文之后进行分享、点赞和评论
采集bili
当打算采集b站关于某个关键词比如'自动驾驶'的内容时,执行uv run main.py --platform bili --lt qrcode --type search --keywords "自动驾驶" --crawler_max_notes_count 10,如果没出现二维码则手动通过短信验证码登录
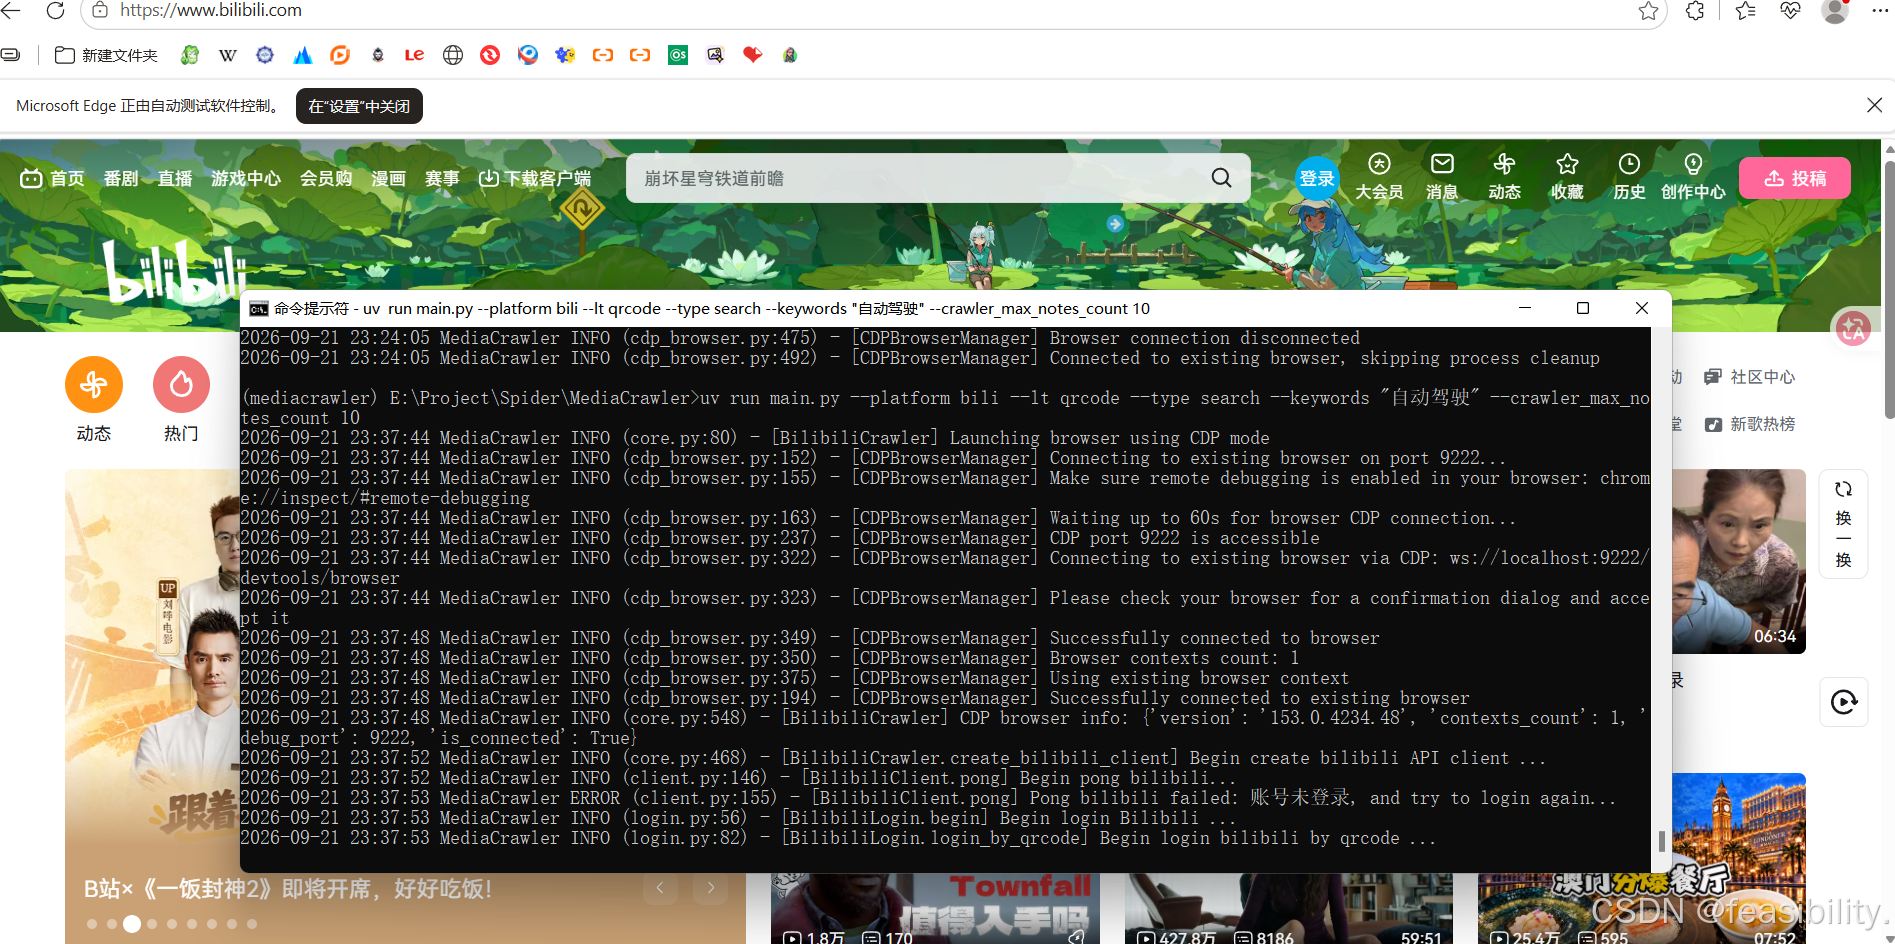
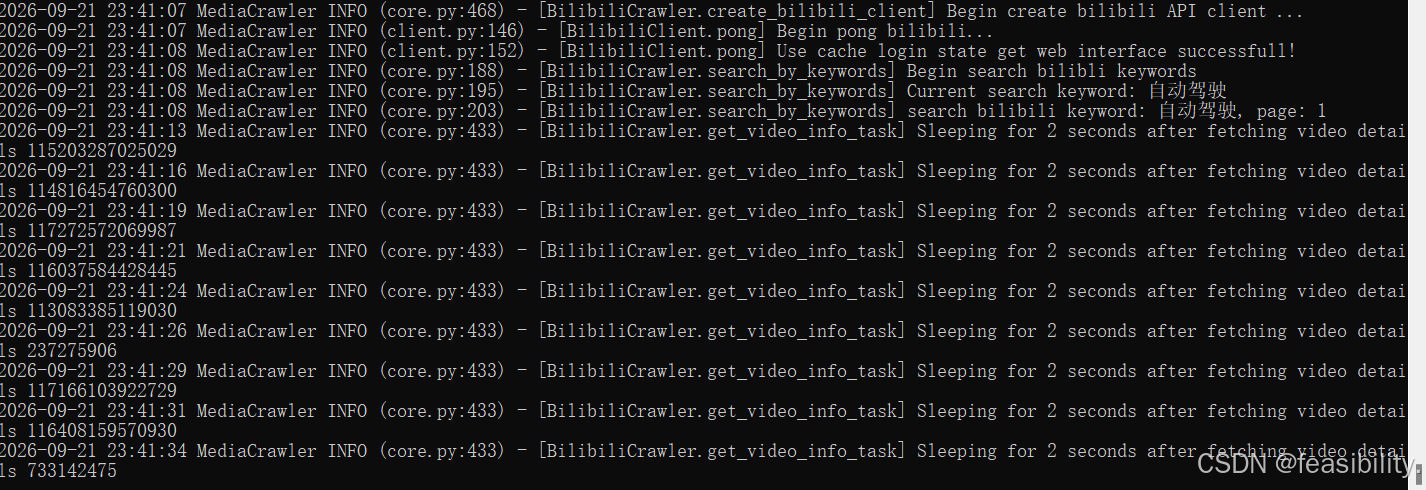
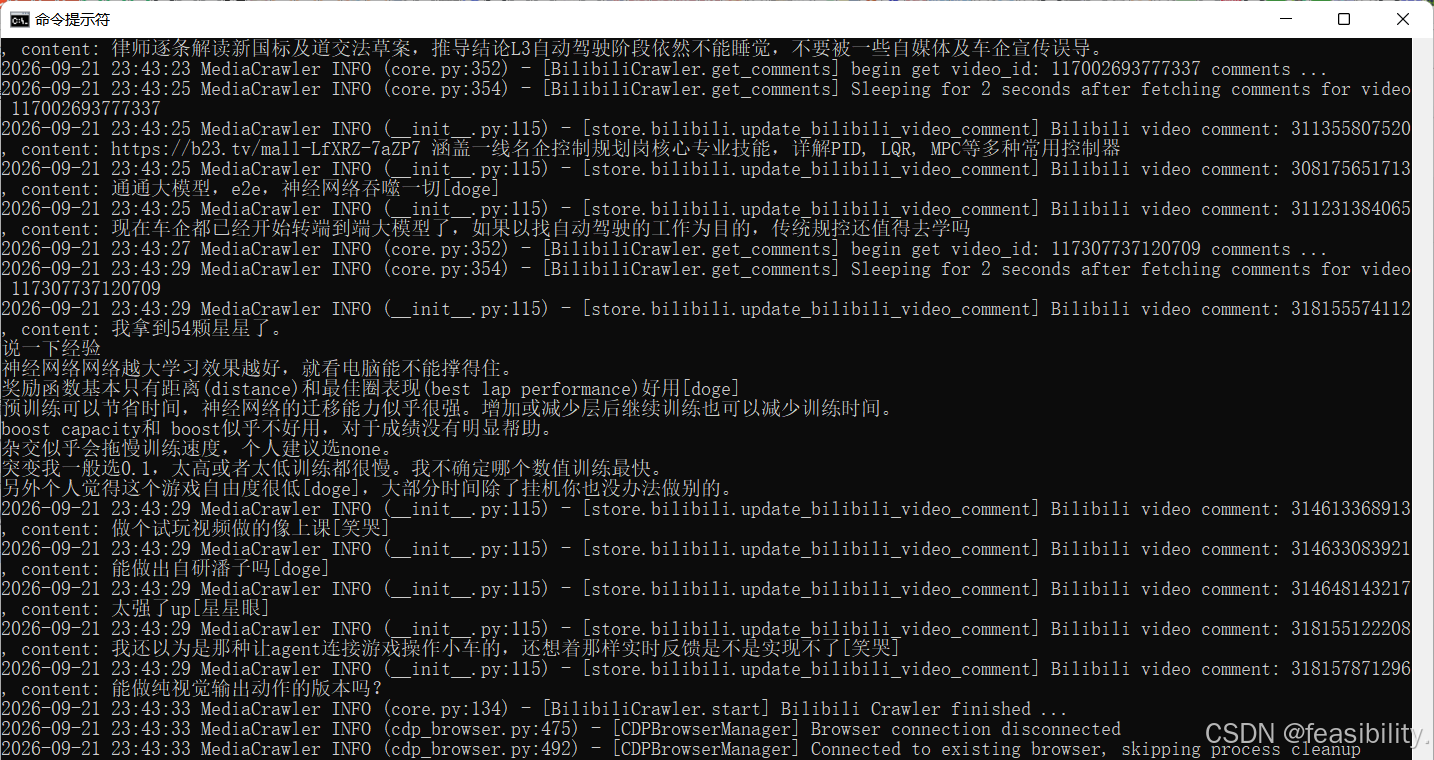
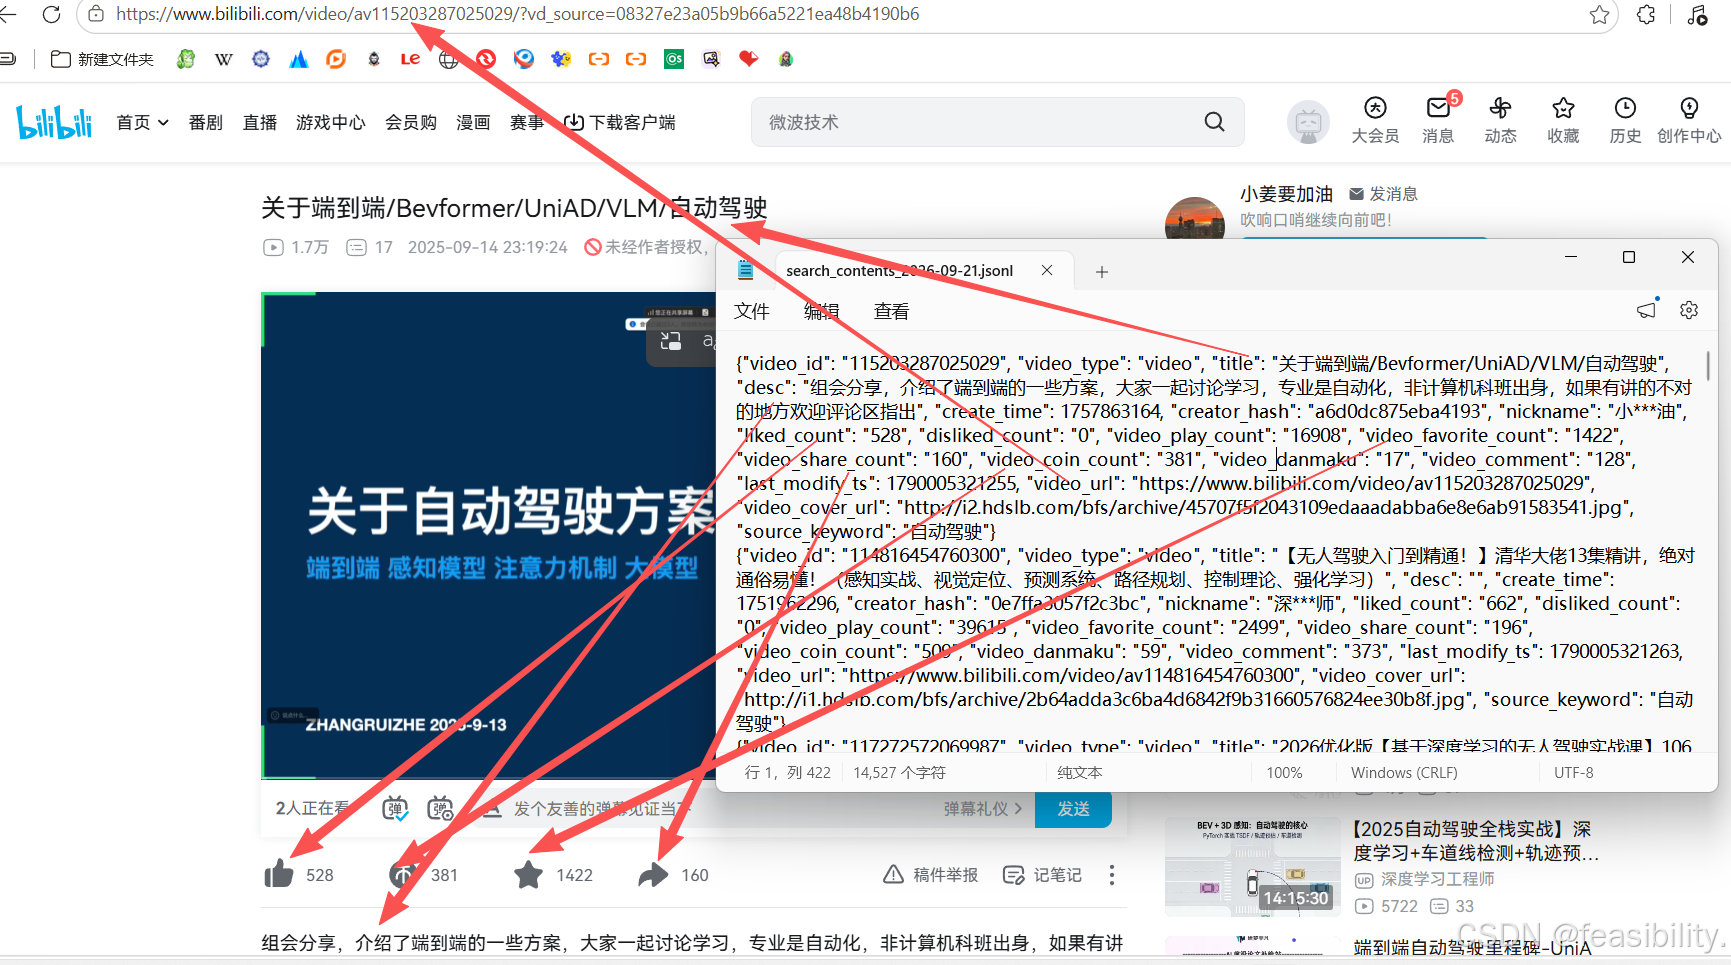
结果展示
不用碰命令行:给普通人准备的网页界面
传统爬虫工具的使用门槛常常不在爬虫本身,而在"改配置文件、敲命令"这一步。MediaCrawler 提供了一个网页版操作界面:选平台、选登录方式、填关键词,点按钮,日志和数据在页面上直接看、直接导出。
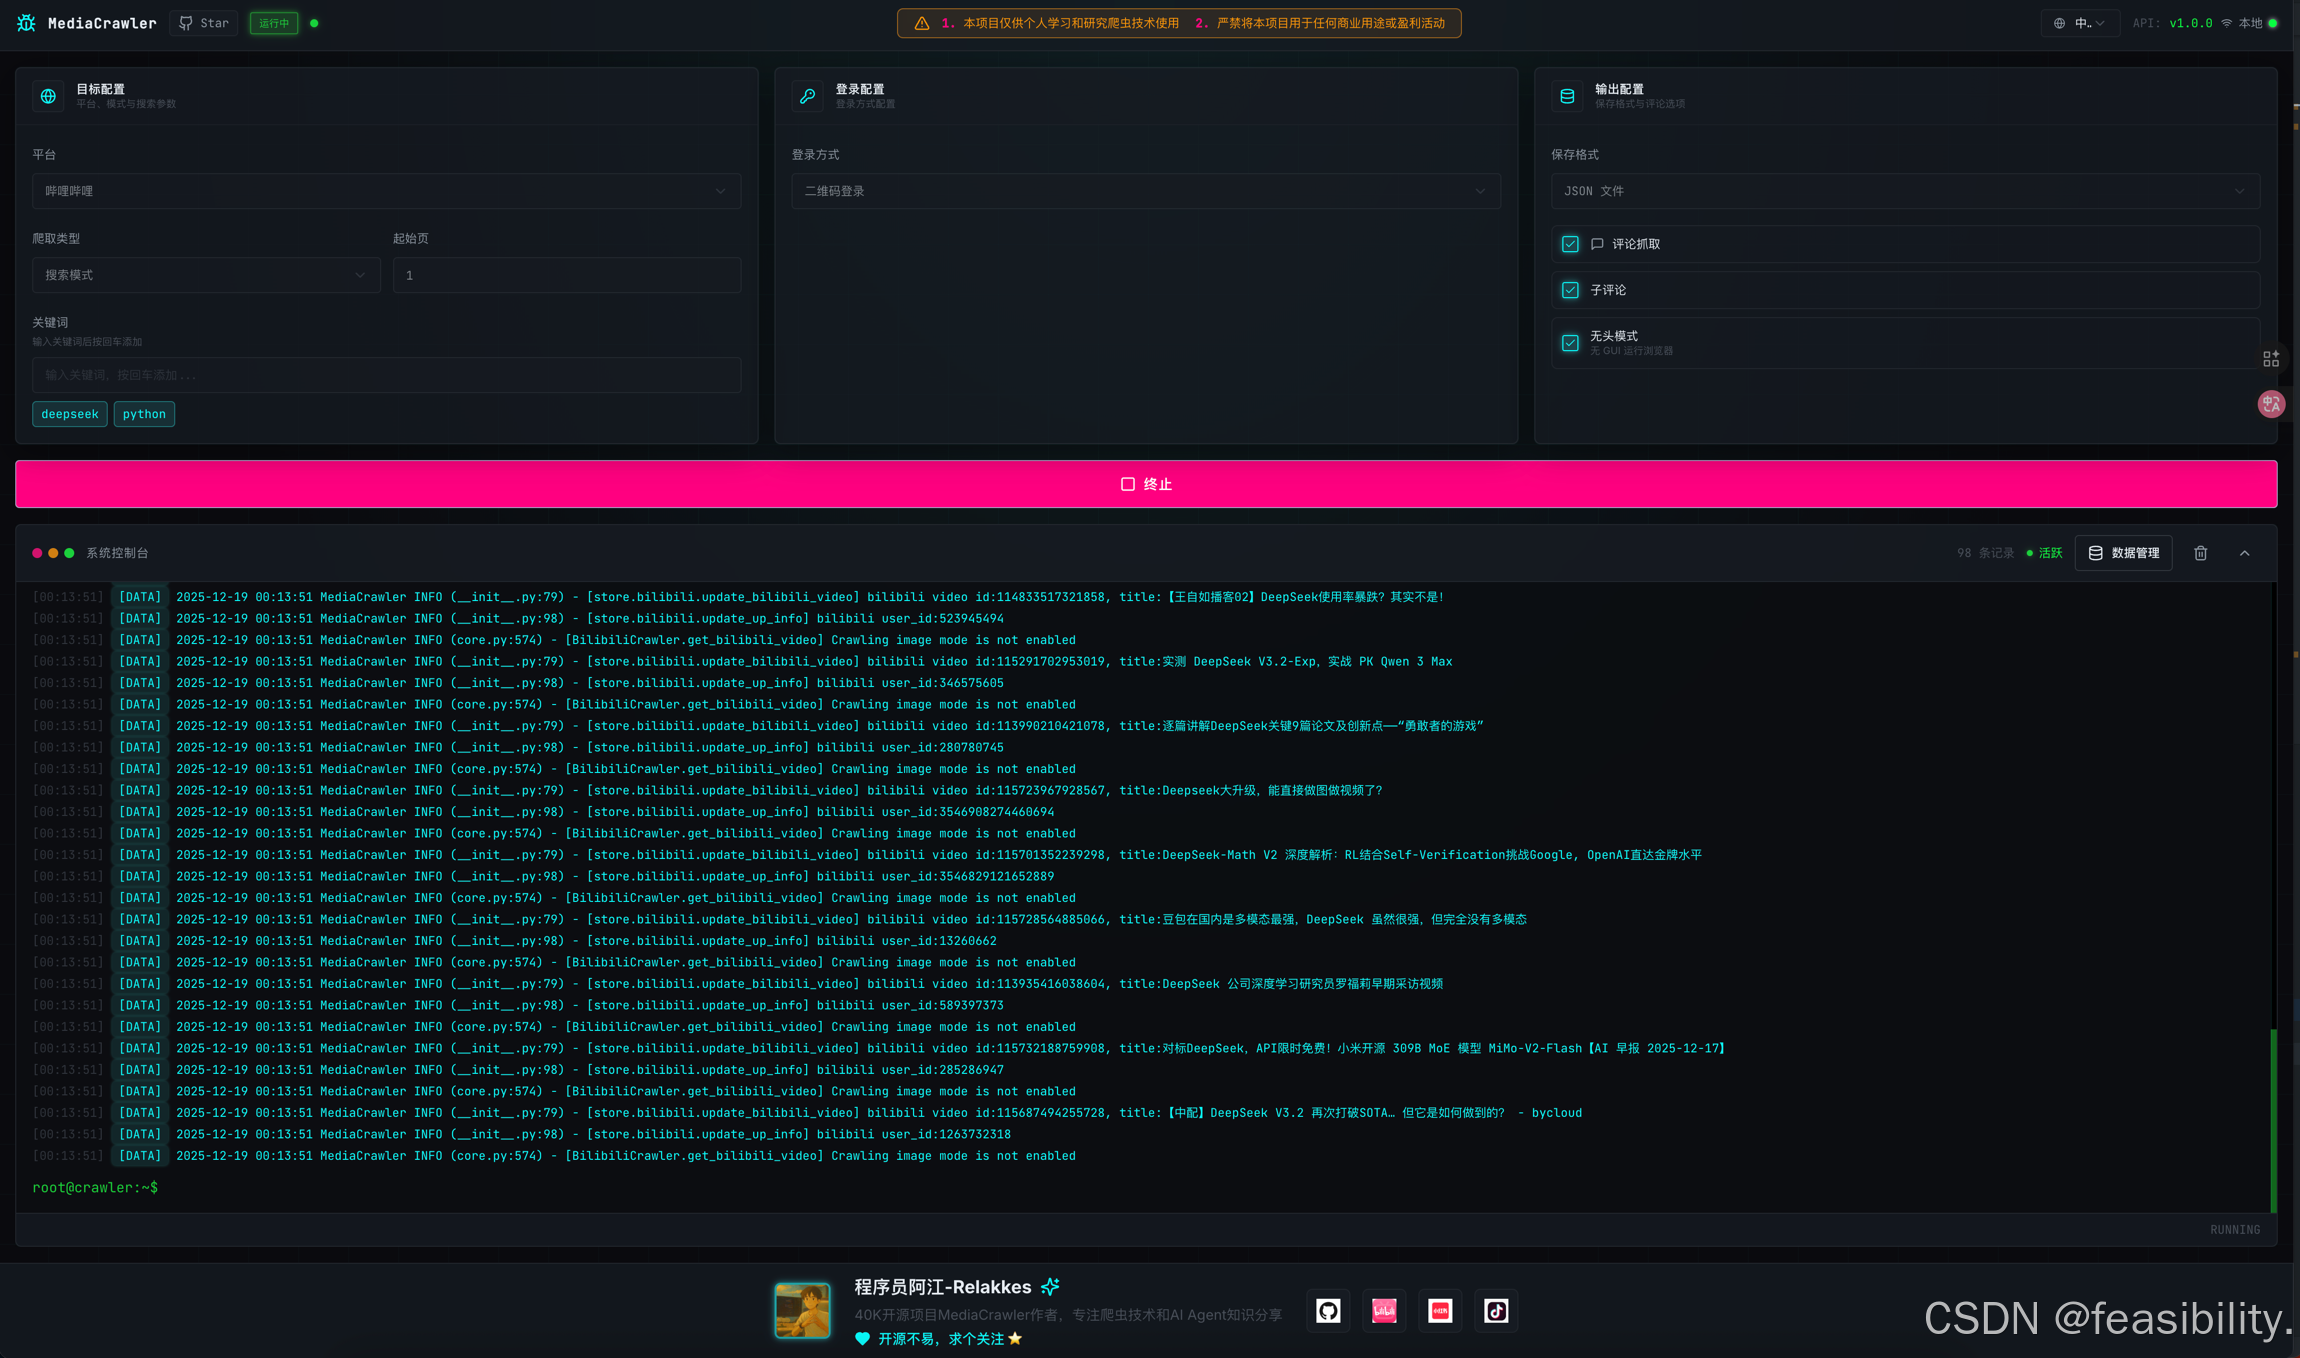
对完全不想写代码和记命令的人,这是整个项目里最值得关注的部分------它把"数据采集"从一项工程任务变成了一次表单填写。如果你是做市场调研、竞品分析、内容选题的运营或研究者,大概率用不到这个界面背后的任何代码。
执行cd webui然后执行安装依赖项可启动可视化界面
数据最后放在哪
爬下来的数据可以存成最常见的几种格式:Excel、CSV(表格文件)、JSON/JSONL(每行一条记录的文本格式,方便程序处理),也可以直接写入 MySQL、SQLite 这类数据库。视频、封面、图片等媒体文件会按帖子自动分文件夹存放;B 站在检测到 ffmpeg(一个音视频处理工具)时会用 DASH(一种把画面和声音分开传输、最后再合流的视频格式)下载最高画质并自动降级到实际可用的清晰度。
另外两个体现作者分寸感的细节:单个文件下载失败只记录日志、绝不中断整体任务;下载过程刻意不做并发加速,避免对平台服务器造成不必要的压力。
开源版与 Pro 版:同一作者的两种生意
作者 NanmiCoder 同时维护着付费的 MediaCrawlerPro。两者大致的分工:
| 维度 | 开源版 | Pro 版 |
|---|---|---|
| 适合谁 | 学习、研究、轻量个人使用 | 生产环境、规模化采集 |
| 运行方式 | 依赖 Playwright 浏览器自动化 | 官方宣称去除 Playwright 依赖,使用更简单 |
| 断点续爬 | 无 | 有(任务中断后从断点继续) |
| 多账号 + IP 代理池 | 基础 | 重点强化 |
| AI Agent 集成 | 无 | 支持 OpenClaw、Claude Code、Cursor 一键安装 |
补充:Pro 版是闭源的,去掉浏览器依赖之后签名如何生成,官方没有公开实现细节------这是它与开源版"不逆向"理念之间一个尚未被解释的张力点,有疑虑的话建议订阅前先向作者求证
本文仅供学习参考,不得用于违法犯罪
创作不易,禁止抄袭,转载请附上原文链接及标题