导读:Jev 并不是多模态模型,它也无法做到输出文章内容,它像一个专门做小决定的助手,比如老婆说这件衣服好看不?你问它结果,如果答案正确,恭喜你;如果答错了,AI 背锅,两全其美。
文章开始前,先给各位粉丝朋友道个歉,最近不是偷懒了,而是病得比较久,为了保命,停更了一段时间,见谅!
ok,回归正题,Jev 发布后,网上很快出现用它玩 Mario、控制浏览器、看代码、清理 AI 历史记录的例子,甚至还有拿来玩炒股的,不过很可惜,炒股的那位现已经哭晕在厕所了。其实官方文章并没有一句说"Jev 比 GPT 厉害",它很清楚地写着:很多时候,AI 并不需要写一大段答案,只需要替程序做个选择。
把选择单独处理,AI 系统会更快、更稳
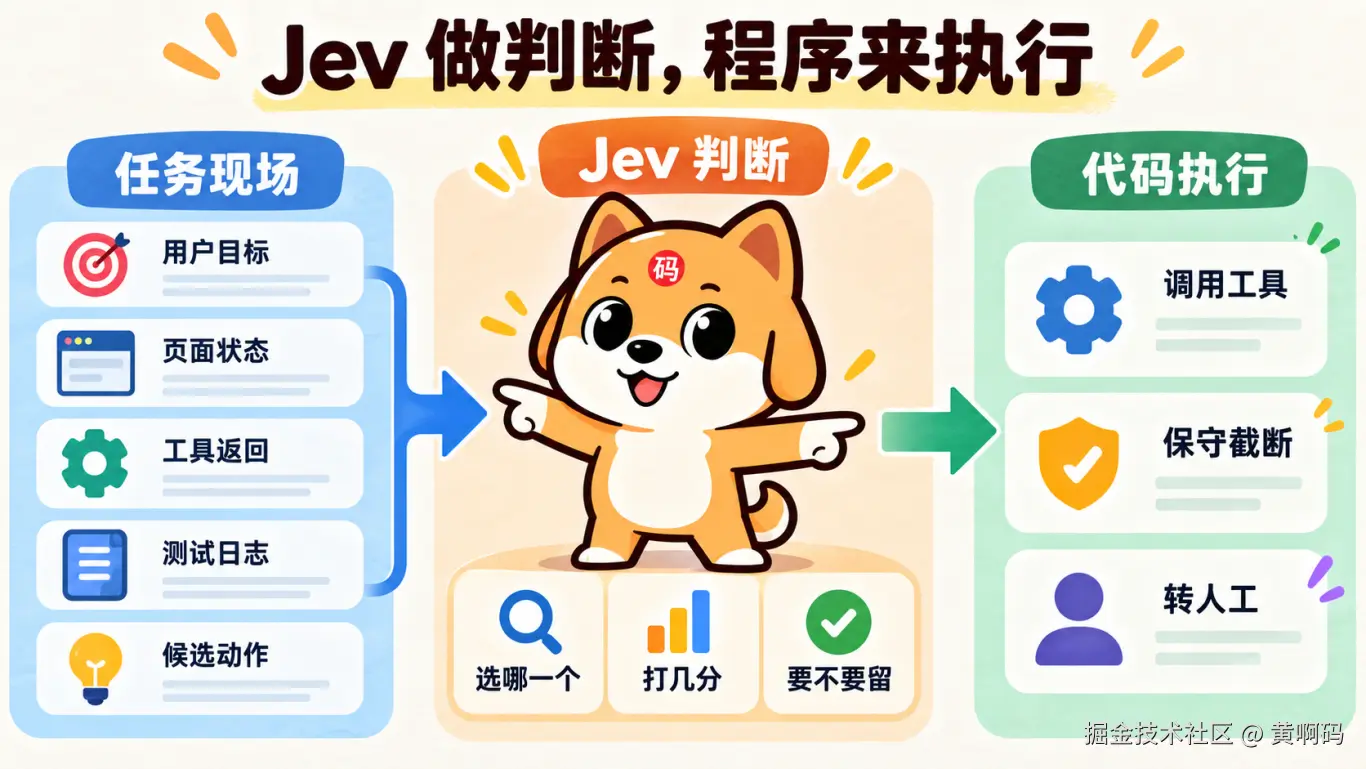
Jev 是什么:它只负责选
Jev 是 TypeSafe AI 发布的一种模型,它和聊天机器人不一样:不追求写一段漂亮的话,而是把答案限制成"这事有多大把握",你把目标、当前情况和候选做法给它,它给你一个程序能立刻使用的结果。
比如问"这段测试日志要不要留",普通聊天模型可能会写一段理由;Jev 只回 { noul: 0.89 }。程序看到 0.89超过自己定好的线,就保留;咋样,是不是非常舒服,跟你老板一样,我不管你加班多累,你只要把结果弄出来就好。
bash
if (keepResult >= 0.5) { keepFullResult(); }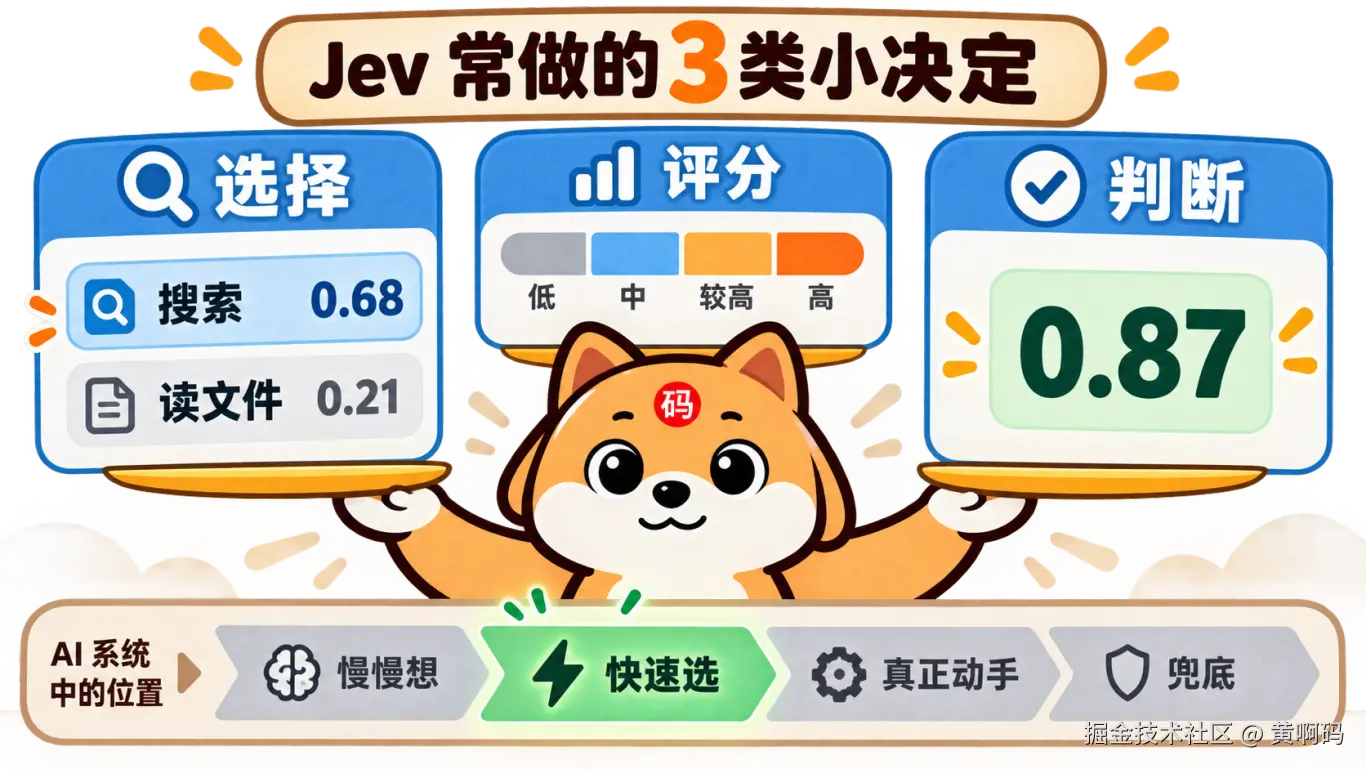
为什么 AI 助手需要一个"快速选择器"
文章用改 Bug 举例:先看问题、找代码、读文件、跑测试、看报错、再读文件、修改、再测试,每一步留下的文件、日志和搜索结果都会塞进 AI 的"聊天记忆"里,最后把它撑爆的,往往是这些又长又杂的工具返回。
简单来说就 3 个问题
-
**小选择却让大模型写大段话:**要不要留日志、该用哪个工具、要不要找人以及各种选择的时候,只要一个选项或一个数字就够了,无需长篇大论。
-
浓缩内容容易改坏线索:文件路径、报错码和参数这些细节,改写后很容易走样。
-
"我有八成把握"不能直接信:模型自己说的把握不等于现实准确率,要先拿自家数据试一段时间,再决定自动做事的标准。
fast-jev-compaction 是最重要和典型的例子,仓库地址如下:tamaratran/fast-jev-compaction, 它的原理咱们简单拆解一下:AI 写代码时,聊天记忆越来越长,哪些"用了什么工具、工具查到了什么"还值得保留?它不写代码,也不抢走 AI 助手的主控权。
黄啊码用一个简单的表格将其列出来:
bash
keepCall: 这次工具调用本身是否仍重要? keepResult: 这次工具结果全文是否仍需要保留?| 动作 | 条件 | 处理 |
|---|---|---|
| keep | keepResult ≥ threshold |
|
| 调用与结果完整保留 | ||
| drop_result | ||
| 结果低、调用高 | ||
| 保留调用,结果改为截断说明 | ||
| drop_call | ||
| 两者均低 | ||
| 调用与结果一起删除 | ||
啥?看不懂?看不懂就对了,说点人话就是:
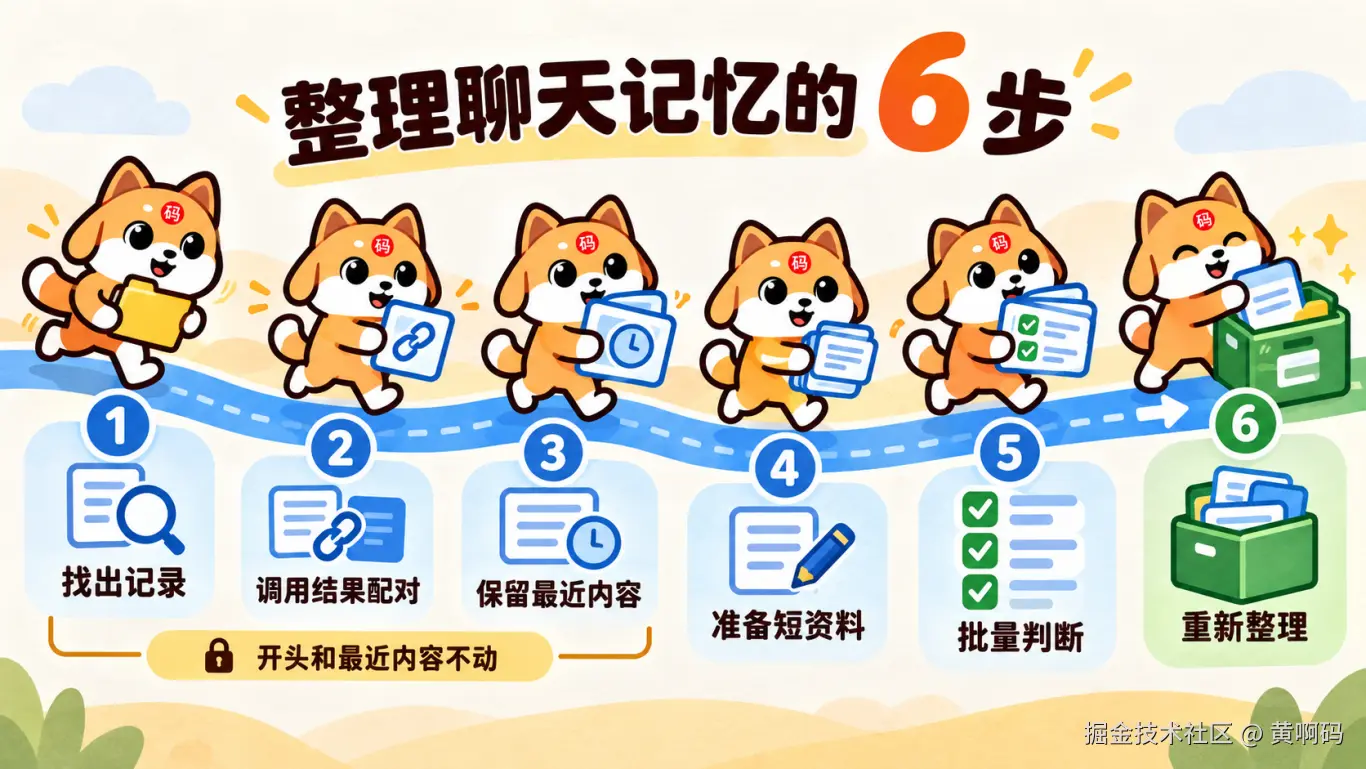
整个过程可以看成 6 步:找出历史里"调用工具"和"工具返回"的记录;把一问一答配起来;开头和最近几条不动;整理一份短资料给 Jev 看;让它判断每一条要不要留;最后重新拼出一份更短的聊天记忆。
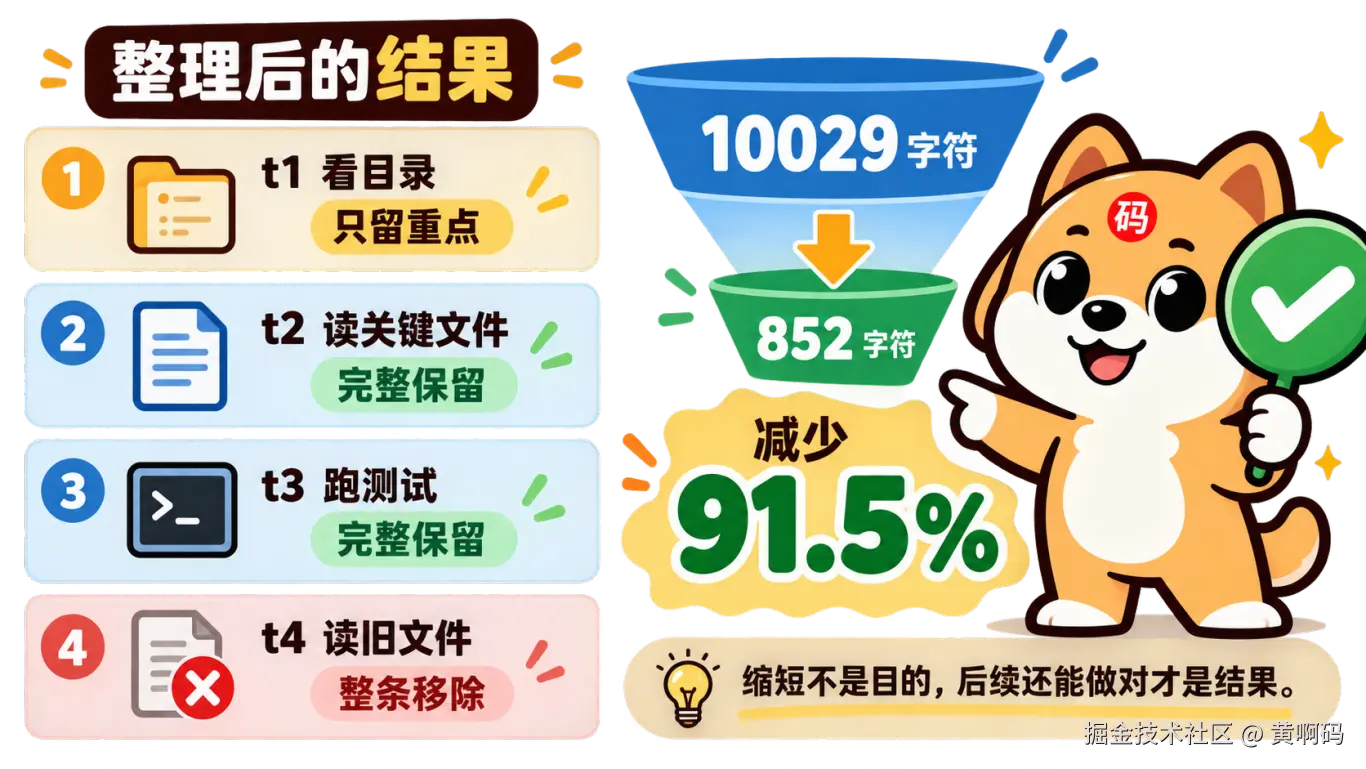
Demo 模拟"订单导出超时"的排查过程,一共用了 4 次工具:看很长的目录、读包含 getAuthToken 的关键文件、看带有超时和鉴权问题的失败日志,以及读一个和当前问题无关的旧文件。
测试结果是 11 项都通过,原本 10029 个字符的聊天记忆,最后只剩 852 个,少了 91.5%。四条工具记录中:两条完整留下,一条只留简短结果,一条无关记录删掉,比咱们经常说的概述内容或总结内容更有效。
什么时候该用 Jev 黄啊码觉得可以用三个问题来判断:可选答案是不是早就列好了?是不是每天要做很多次,属于高频动作?做错了能不能补救,有没有兜底机制?三题大多答"能",就适合 Jev。 反过来,如果需要写理由、要跨很多文件一步步推理,还是交给大模型,分类很稳定、又有很多标注数据时,普通分类器也不错。
两个容易误会的点:"不会乱说格式外的话"不等于"判断一定对";"它说有八成把握"也不等于现实里真有八成正确。正确做法是先在后台悄悄跑一段时间,不自动执行,看看自家数据里它说 0.8 时到底准不准,再定规则。
我们亲手做过的 3 个案例
前面的文章讲的是方法,下面把这套方法放回我们实际做过的项目里看,其实这里边的三个案例,至少有两个用代码就可以实现全自动了,但我没有这么做,而是采用 Jev 参与进而判断技术实现效果。
本地实现****边界已说明
案例 1:浏览器插件
**最初的问题:**只根据一句话猜坐标,常常点错;页面跳转以后仍拿旧页面做决定,也容易失效。
**后来怎么做:**把流程改成"读取整页 → Jev 从页面元素中选动作 → 浏览器代码执行 → 等页面稳定 → 重新读取",填写后还要把输入框的值读回来,确认真的填进去了。
本地实测****调用 Jev
案例 2:像素平台游戏
**最初的问题:**自动模式只会一直向右;靠固定时间跳,容易掉进缺口;只按跳跃键又没有向前速度。
**后来怎么做:**Jev 在落地、发现新平台或路线变化时,从"继续加速 / 准备跳 / 改选平台"中做低频选择;到点时触发 ArrowRight + Space,其余时间继续向右。
本地实现****低频请求
案例 3:贪吃蛇
**最初的取舍:**如果每移动一格都请求模型,既慢又没有必要。
**后来怎么做:**只有新食物出现时,请 Jev 给一次大方向;蛇每走一格之前,本地安全层都会过滤掉反向、撞墙和撞到身体的方向,再选离食物更近的安全方向。
网上已经出现了哪些 Jev 用法?
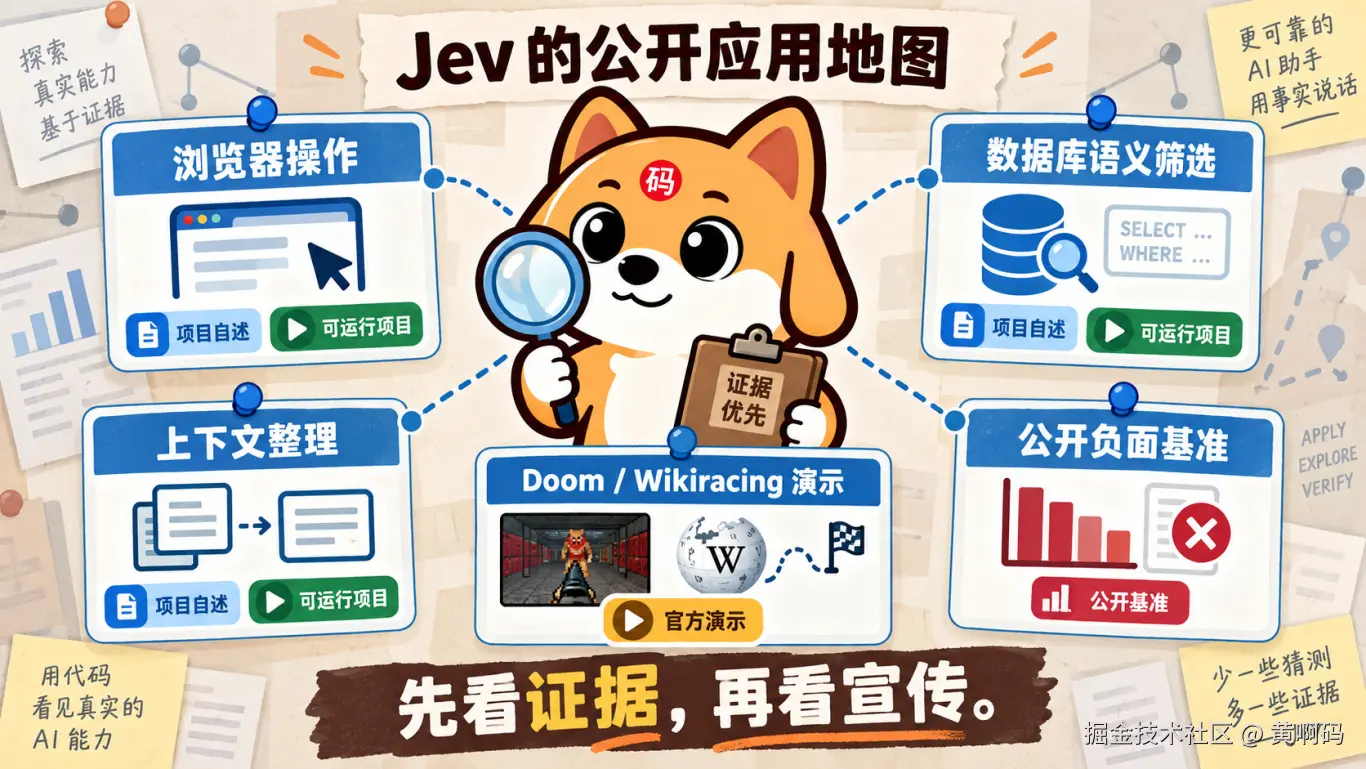
官方发布 **TypeSafe:System One Models 与 Jev**
官方把 Jev 定位成"把现场资料变成固定类型决定"的模型,并展示 Doom 与 Wikiracing:Doom 用文字化游戏状态做实时选择,Wikiracing 则从大量链接里选下一跳。官方也主动说明,这些是早期演示,Doom 用的不是画面识别,而且普通程序写的游戏机器人可能更强。
项目自述 **jev-browser:真实网页上的多步操作**
这个项目让 Jev 每一步从可点击、可输入、可选择的网页元素里挑动作,普通代码负责预算、恢复和停止。仓库称它做过 Wikipedia 跳转、填写但不提交联系表、读取价格等任务,同时也明确写着:这是早期软件,复杂网站仍会遇到问题。
可运行项目 **pg-jev:把"语义条件"放进 PostgreSQL 查询**
它把 Jev 包成数据库函数,可以用日常语言筛选、打分或分类数据行,例如找"客户很生气"的工单。仓库给出的自测也很有提醒意义:每批 1--20 行时结果最好,批量继续增大后准确率下降,所以最后把默认批量设为 20。
工程项目 **pi-fast-jev-compaction:整理编程助手的工具记录**
它把工具调用和结果配对,让 Jev 判断"调用要不要留""结果要不要原样留"。保留下来的内容不改写,最近消息固定不动,并且支持后台判断、缓存和失败回退。这正是前文重点讲的工程方向。
公开负面结果 **Held-out 基准:Jev 方案没有达到继续开发门槛**
这份预先设门槛的测试里,Jev 方案在事实检查上高于两个对照,但三种方案都只通过 4/8 个完整任务;项目因此停止继续做 Jev 重排器,保留本地检索和原生压缩。这不证明 Jev 对所有场景都无效,却证明"某次压缩率高"远远不够,最终还得看后续任务能否做对。
综合案例后,真正能落地的做法
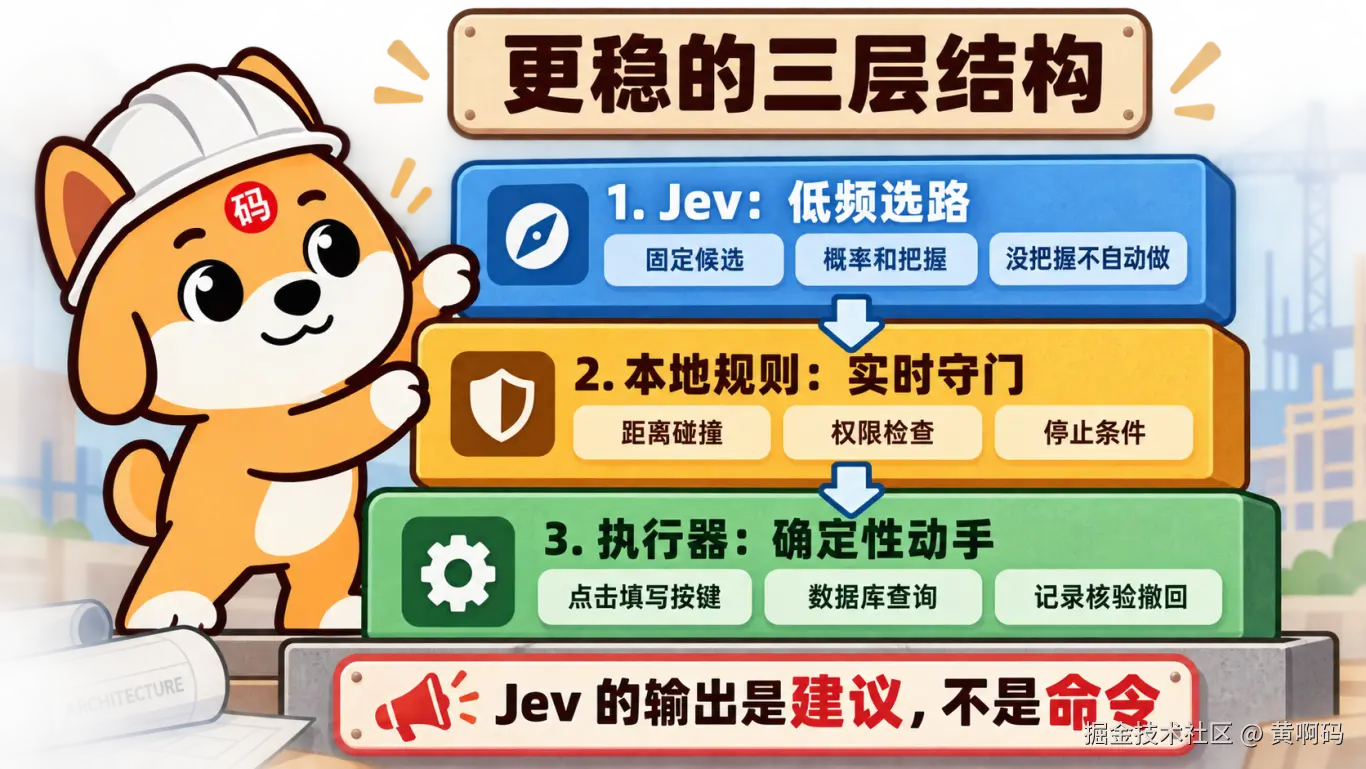
从这些案例中,我总结了一些小经验:我将其分为:三层分工:第一层负责理解模糊目标,第二层负责高频安全和精确控制,第三层才真正产生副作用。
先问 5 个问题,再决定是否接 Jev
-
**答案能不能提前列出来?**能列成几个候选,才适合 Choice;需要自由写作,就别硬塞给 Jev;
-
多久要决定一次?频繁都要决定的事情,优先写本地算法;而不是什么都要请求 Jev;
-
**有没有明确的本地安全规则?**能用代码逻辑梳理清楚的数据类型和必须明确清楚的规则,必须先写在代码里;
-
**做错后能不能恢复?**读取、排序诸如此类的可以放宽,提交表单、删数据、付款和改权限必须提高门槛或转人工;
-
**怎么证明它真的有用?**先在后台只记录、不执行;用真实任务统计完成率、误操作率、耗时和成本,再决定阈值。
感觉看上去黄啊码说了一堆枯燥的内容,其实已经够简单化了,技术本身就是枯燥的。
如果现在要做一个正式产品,先从"Jev 给建议、本地代码拦截、人工可接管"的影子模式开始,真实数据证明某一档置信度足够可靠,再逐步开放自动执行。
黄啊码想了想,估计有个场景立马会用上,未来半个月内,国产 Agent 的标题估计会赫然写着:经过多番优化和努力,我们的 Agent 执行效率实现了提升 N 倍的效果。哈哈哈,也罢,AI 的出现不就是为了提高效率吗?
OK,今天的分享就到此,我是黄啊码,码字的码,如果觉得我说得有道理,欢迎一键三连,如果觉得有异议,欢迎评论区指正,我们都是 AI 时代的共创者。