一、引言
很多团队第一次做数据质量治理时,会先接入表行数波动、字段空值率、主键重复率、枚举值异常等规则。短期看,这些规则确实能发现问题,但运行一段时间后,平台里经常堆满告警:有些没人认领,有些被反复忽略,有些修完几天后又复发。
质量治理失败的根源通常不是规则太少,而是规则没有进入生产链路。成熟的数据质量体系本质上是"规则化"和"运行化"的治理机制,而不是人工抽查。一个可运营的数据质量系统至少要回答五个问题:
| 问题 | 工程化答案 |
|---|---|
| 查什么 | 质量维度和规则模型 |
| 何时查 | 调度前、调度中、调度后、消费前 |
| 出问题怎么办 | 阻断、降级、告警、工单 |
| 谁负责修 | 表负责人、链路负责人、业务 Owner |
| 如何防复发 | 根因归类、规则调整、SLA 修订、复盘沉淀 |
二、质量维度
数据质量维度是规则设计的分类框架,包括准确性、完整性、一致性、及时性、唯一性等维度。在大数据场景中,可以把常用维度落成如下工程规则:
| 质量维度 | 关注问题 | 典型规则 | 常见指标 |
|---|---|---|---|
| 完整性 | 数据有没有缺 | 分区是否存在、行数是否为 0、关键字段非空 | 空值率、缺分区次数、缺字段次数 |
| 唯一性 | 数据有没有重复 | 主键唯一、联合键唯一、明细去重 | 重复率、重复行数、唯一值占比 |
| 及时性 | 数据是否按时到达 | T+1 表是否在 SLA 前产出、最新时间戳是否足够新 | 延迟分钟数、SLA 达成率 |
| 准确性 | 数据是否接近真实业务 | 金额非负、状态流转合法、指标与源系统对账 | 差异率、误差率、对账通过率 |
| 一致性 | 多处口径是否一致 | 汇总表与明细表一致、跨系统编码一致 | 对账差值、枚举不一致数 |
| 有效性 | 数据是否符合格式或取值域 | 日期格式、手机号格式、枚举值范围 | 非法值数量、格式错误率 |
质量维度不是越多越好,维度是为了让规则更容易管理,而不是为了堆概念。对于一张核心事实表,完整性、唯一性、及时性通常是第一优先级;对于指标宽表,准确性和一致性往往更关键。
三、规则配置
规则配置的核心目标是让质量检查从"写死在脚本里"变成"可配置、可复用、可审计"。一条工程化质量规则不应只包含 SQL 条件,还应该包含运行策略和处置策略:
diff
+------------------+
| 质量规则配置      |
+------------------+
| 规则ID            |
| 规则名称          |
| 质量维度          |
| 数据对象          |
| 校验字段          |
| 校验逻辑          |
| 阈值              |
| 运行时机          |
| 失败等级          |
| 是否阻断          |
| 责任人            |
| 告警渠道          |
| 工单策略          |
+------------------+
可以把规则配置抽象成如下模型:
vbnet
rule_id: dq_ads_order_amount_001
rule_name: 订单金额非负校验
dimension: accuracy
table: ads_order_summary_d
partition: dt=${bizdate}
check_sql: |
  SELECT COUNT(*) AS invalid_cnt
  FROM ads_order_summary_d
  WHERE dt='${bizdate}'
    AND pay_amount < 0
threshold:
  operator: "="
  value: 0
severity: P1
block_strategy: block_downstream
owner: data_team_order
alert:
  channels: [im, phone]
ticket:
  auto_create: true
  sla_minutes: 60
这类配置的好处是,规则平台可以统一解析,而不是让每个数仓开发在任务脚本中重复实现校验逻辑。
四、维度到规则
完整性规则最适合从数据到达和字段非空开始。比如 ODS 层检查分区是否存在,DWD 层检查关键业务字段是否为空,ADS 层检查指标结果是否为空。空字段规则会检查列中是否存在 null、空字符串或仅空格值,并且该规则会影响唯一值、格式匹配等其他规则的评分方式。
完整性规则示例

表级完整性
  ├─ 分区是否存在
  ├─ 分区行数是否 > 0
  └─ 今日行数是否偏离历史均值

字段级完整性
  ├─ 主键非空
  ├─ 业务日期非空
  └─ 核心指标非空
唯一性规则不应只看单字段主键。唯一性既可以校验单列唯一,也可以校验复合列唯一,复合列适合用于国家代码与证件号这类联合标识场景。
唯一性规则示例

单列唯一:
  order_id 不重复

联合唯一:
  user_id + event_id + event_time 不重复

业务实体唯一:
  country_code + certificate_no 不重复
及时性规则要区分"源系统时间"和"数据入仓时间"。freshness 的定义是:数据相对源系统或真实事件的新鲜程度,核心指标是数据生成或更新时间距离当前时间的间隔;官方也建议用最大时间戳、最小时间戳等方式检查数据是否足够新。
yaml
及时性判断

事件发生时间 event_time
        |
        v
采集进入消息队列 ingest_time
        |
        v
写入 ODS load_time
        |
        v
加工成 DWD process_time
        |
        v
产出 ADS publish_time
准确性规则通常要结合业务事实或可信来源,一致性规则常见于跨层对账和跨系统对账。比如 DWD 明细汇总后的订单金额,应与 ADS 指标表一致;离线 Hive 表的会员状态,应与实时画像或主数据系统保持一致。
五、执行链路
质量规则只有接入调度链路,才会真正影响生产。否则它只是一个旁路监控系统,发现问题后仍然依赖人工判断和人工转发。
推荐把数据质量校验分成四个执行点:
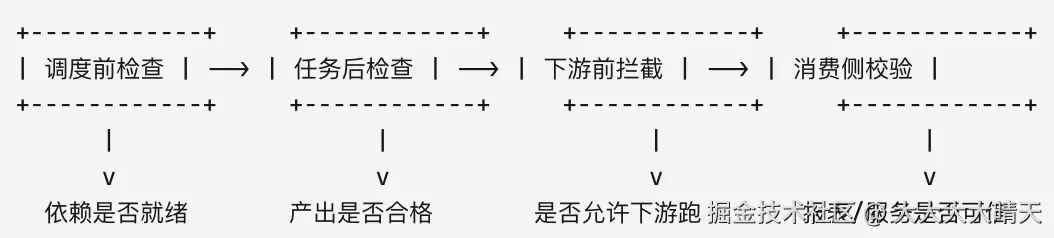
不同执行点适合不同规则:
| 执行点 | 适合规则 | 失败动作 |
|---|---|---|
| 调度前 | 上游分区存在、源表就绪、依赖延迟 | 等待、重试、提前告警 |
| 任务后 | 行数、空值、重复、枚举、金额范围 | 标记失败、阻断下游 |
| 下游前 | 核心表 SLA、核心指标对账 | 拦截高风险任务 |
| 消费侧 | 报表指标波动、API 数据新鲜度 | 降级展示、提示数据异常 |
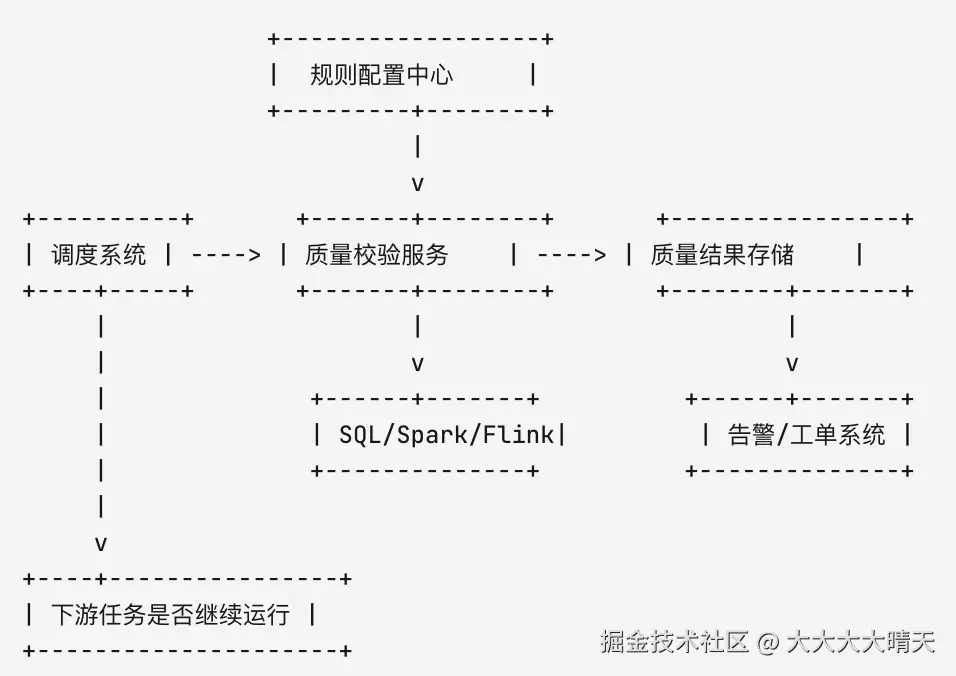
工程上,质量平台可以作为调度系统的一个插件。任务执行完成后,调度系统调用质量校验服务;质量服务读取规则配置,生成校验 SQL 或执行引擎任务;校验结果写入质量结果表,再由调度系统决定是否继续运行下游。
六、任务拦截
任务拦截是数据质量从"提醒"走向"治理"的关键。没有拦截机制,错误数据会继续扩散到下游,最终在报表、模型、接口或业务决策中暴露。
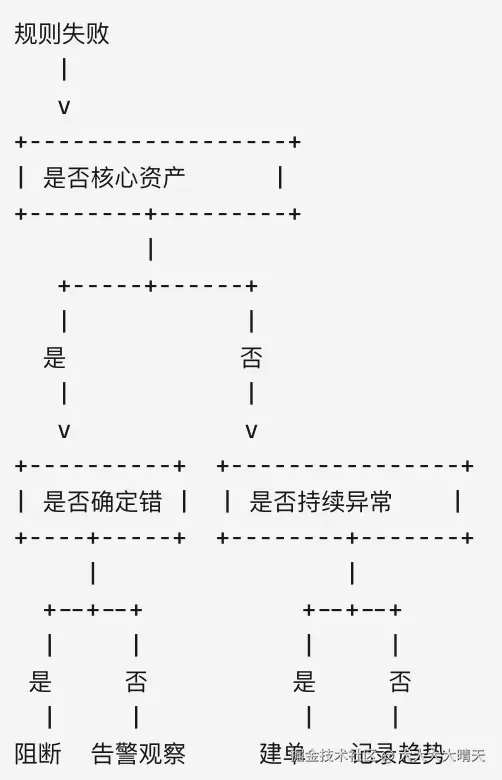
但拦截不能一刀切。质量规则应按照数据影响范围和业务容忍度设计不同策略:
| 失败等级 | 典型场景 | 建议动作 |
|---|---|---|
| P0 | 核心经营指标错误、资损风险、监管报送错误 | 阻断下游、电话告警、立即建单 |
| P1 | 核心 ADS 表缺分区、主键大面积重复 | 阻断核心下游、IM 告警、限时修复 |
| P2 | 非核心字段空值升高、枚举新增未登记 | 不阻断、告警、进入问题池 |
| P3 | 波动轻微、样本异常、低优先级资产 | 记录趋势、日报汇总 |
一个常见误区是把所有规则都设成强阻断。这样会导致数据平台频繁中断,最终业务方和研发都会倾向于关闭规则。更合理的方式是:核心链路强拦截,非核心链路弱拦截;确定性错误强拦截,趋势性风险先告警;影响面大的规则优先拦截,低价值规则只记录。
七、告警分级
告警分级的目标不是"通知更多人",而是让正确的人在正确时间收到正确严重程度的信息。告警太少会漏问题,告警太多会造成疲劳。
一条好的数据质量告警至少包含这些信息:
erlang
告警标题:ads_order_summary_d 支付金额对账失败
失败等级:P1
业务日期:2026-09-17
质量维度:准确性
失败规则:支付金额与 DWD 汇总差异率 <= 0.1%
实际结果:差异率 3.7%
影响范围:订单经营看板、GMV 日报
处理建议:优先检查 dwd_order_pay_detail_d 是否补数
责任人:订单数仓小组
工单链接:DQ-20260918-001
告警分级可以结合规则等级、资产等级、影响范围和历史表现动态计算:
scss
告警等级 = f(规则等级, 资产等级, 下游数量, SLA剩余时间, 历史复发次数)例如,同样是空值率异常,发生在临时分析表上可能只是 P3,发生在公司级核心指标表上就可能是 P1。如果一个问题连续三天复发,即使单次影响不大,也应该升级,因为它说明根因没有被解决。
八、问题工单
工单是连接"发现问题"和"真正修复"的桥。没有工单,告警只是一条消息;有了工单,问题才有状态、责任人、SLA 和关闭标准。
建议质量工单包含以下状态流转:
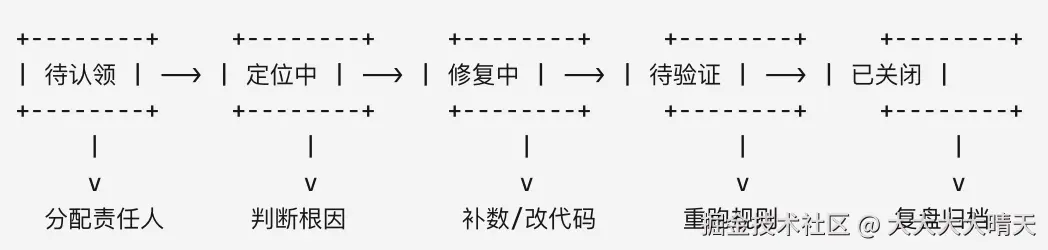
工单字段不要设计得太复杂,但必须能支撑复盘:
| 字段 | 作用 |
|---|---|
| 问题表 | 定位资产 |
| 业务日期 | 定位分区或批次 |
| 失败规则 | 明确质量问题 |
| 影响范围 | 判断优先级 |
| 责任人 | 避免无人处理 |
| 根因分类 | 支撑复盘统计 |
| 修复方式 | 记录补数、改逻辑、改规则 |
| 验证结果 | 防止"口头修复" |
| 复发标识 | 识别顽固问题 |
工单关闭不能只看"任务重跑成功"。更好的关闭标准是:失败规则已重新通过,受影响下游已重刷或确认不受影响,根因分类已填写,必要时已补充防复发动作。
九、复盘机制
复盘不是开会追责,而是让同类问题少发生。质量复盘最好围绕根因,而不是围绕现象。
常见根因可以分为五类:
| 根因类型 | 示例 | 防复发动作 |
|---|---|---|
| 源系统变更 | 字段含义变化、枚举新增 | 接入变更通知、增加 schema 规则 |
| 采集异常 | Kafka 积压、CDC 丢数据 | 增加采集延迟和断点监控 |
| 加工逻辑错误 | SQL 条件写错、口径变更遗漏 | 增加单元测试和对账规则 |
| 调度依赖错误 | 上游未完成就启动下游 | 修正依赖、增加前置检查 |
| 规则本身问题 | 阈值过严、业务例外未配置 | 调整阈值、增加白名单机制 |
一个可运营的质量闭环可以表示为:
lua
+----------+
| 定义规则 |
+----+-----+
     |
     v
+----------+
| 执行校验 |
+----+-----+
     |
     v
+----------+
| 失败拦截 |
+----+-----+
     |
     v
+----------+
| 分级告警 |
+----+-----+
     |
     v
+----------+
| 工单修复 |
+----+-----+
     |
     v
+----------+
| 复盘沉淀 |
+----+-----+
     |
     v
+----------+
| 优化规则 |
+----+-----+
     |
     +--------------------+
                          |
                          v
                      回到执行校验
规则不是终点,质量状态、问题处理和历史趋势才是运营抓手。
十、平台落地
从系统设计上看,一个数据质量平台可以分成六层:
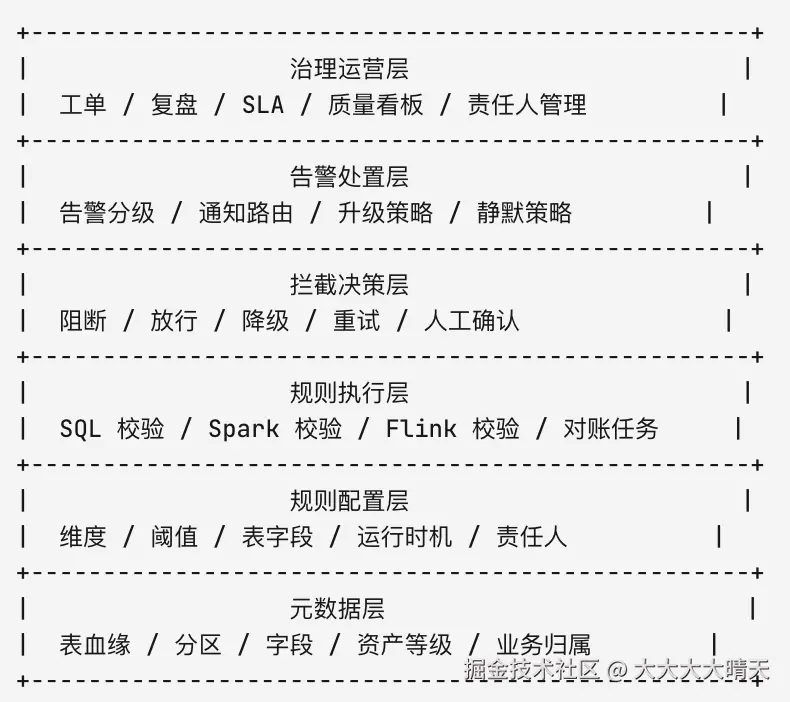
落地顺序建议从核心资产开始,而不是全量铺开。先选 20 到 50 张核心表,覆盖完整性、唯一性、及时性和准确性四类基础规则,再接入调度拦截和告警工单。等规则稳定后,再扩展到一致性对账、跨系统校验、消费侧质量提示和质量分评分估。
质量分数可以作为运营指标,但不能替代问题治理。维度分数和总体分数的计算方式:维度分数可按通过规则的记录数除以总记录数计算,总体分数可由各维度分数汇总得到;这类分数适合做趋势观察和治理评估,但具体修复仍然要回到失败规则和失败记录。
十一、实践案例
假设我们有一张订单日汇总表 ads_order_summary_d,它支撑经营日报、GMV 看板和管理层周报。它的质量规则可以这样设计:
| 规则 | 维度 | 阈值 | 失败等级 | 动作 |
|---|---|---|---|---|
| 当日分区必须存在 | 完整性 | 分区存在 | P1 | 阻断下游 |
| 行数不能为 0 | 完整性 | row_count > 0 | P1 | 阻断下游 |
| order_id 不重复 | 唯一性 | duplicate_count = 0 | P1 | 阻断下游 |
| 最新支付时间不晚于当前 2 小时 | 及时性 | max_pay_time >= now - 2h | P2 | 告警 |
| GMV 与 DWD 汇总差异率小于 0.1% | 准确性 | diff_rate <= 0.1% | P1 | 阻断下游 |
| 订单状态只允许合法枚举 | 有效性 | invalid_status = 0 | P2 | 建单 |
运行链路如下:
yaml
dwd_order_detail_d
        |
        v
质量规则 A:分区完整性
        |
        v
dws_order_user_d
        |
        v
质量规则 B:主键唯一性 + 金额非负
        |
        v
ads_order_summary_d
        |
        v
质量规则 C:GMV 对账 + 及时性
        |
        v
经营看板 / 日报 / API如果GMV 对账失败,系统应自动阻断经营看板刷新,生成 P1 告警并创建工单。责任人修复后,需要重跑对应分区,并再次执行对账规则。只有规则通过、下游刷新完成、工单记录根因后,问题才算真正关闭。