**摘要:**前端埋点会漏(JS 报错、广告拦截、SPA 未上报),服务端访问日志恰好能兜底------但日志聚合 PV/UV 的关键不在工具,而在口径:PV 怎么定义、UV 用什么去重(IP/Cookie/设备指纹)、时间窗口取多长。本文给出从日志格式到聚合管道的完整实现路径。
收藏提示 建议把本文收进收藏夹:写日志聚合管道前,先把「PV 口径、UV 去重键、时间窗口」三条定死;正文的 Nginx combined 格式解析与 ClickHouse 聚合 SQL 是现成的,照着搭能少返工好几轮。评论区欢迎交流你用的日志管道方案。
为什么用服务端日志算 PV/UV,而不是前端埋点?
**结论:**前端埋点覆盖「交互级」数据(点击、停留、转化),服务端日志覆盖「请求级」数据(每次 HTTP 访问)且不受 JS 加载失败影响。两者是互补关系:PV/UV 用服务端日志做底座,行为事件用前端埋点做扩展。
前端埋点有两个天然盲区:一是用户浏览器禁用 JS 或 JS 加载失败时,页面整段逻辑不执行,埋点全丢;二是内容类站点(文章、视频、搜索)只有请求没有复杂交互,前端埋点成本高收益低。服务端访问日志恰好不存在这两个问题------只要请求到了服务器,就会留下一行日志。
一个数据背景:根据 W3Techs 2026 年 8 月的统计,Nginx 与 Apache 仍然占据全球主要 Web 服务器份额(Nginx 约三成、Apache 约两成),绝大多数站点的访问日志都出自这两个软件的 access log。这意味着「从访问日志聚合 PV/UV」是一条几乎任何团队都能落地的通用路径,不依赖任何商业化 SDK。
日志格式与字段设计:从一行日志能算出什么?
**结论:**聚合 PV/UV 最少需要四类字段:请求时间、客户端标识(IP + UA + Cookie)、请求目标(URL/状态码)、响应字节。用 combined 格式输出,字段齐全且业界通用。
以 Nginx 的 combined 格式为例,一行日志长这样:
203.0.113.7 - - 09/Oct/2026:10:15:32 +0800 "GET /article/456-data-tracking HTTP/1.1" 200 4521 "https://example.com/" "Mozilla/5.0 (iPhone; CPU iPhone OS 17_5 like Mac OS X)" "uuid=9f3a2b7c-..."
从这行日志能派生出的指标:
| 字段 | 示例 | 可派生的指标 |
|---|---|---|
| 时间戳 | 09/Oct/2026:10:15:32 +0800 | PV 按分钟/小时/天聚合、高峰时段分析 |
| IP | 203.0.113.7 | IP 数(粗糙 UV 近似)、地域分析 |
| URL + 状态码 | GET /article/... 200 | PV(按页面)、404 监控、抓取分析 |
| Referer | https://example.com/ | 来源渠道(搜索/外链/直接) |
| UA | Mozilla/5.0 (iPhone...) | 端分布(移动/桌面)、机型占比 |
| Cookie(自定义) | uuid=9f3a2b7c-... | UV(访客标识,推荐口径) |
注意:ip 和 uuid 是两类完全不同的去重键。IP 会因 NAT、代理、动态分配而失真;uuid 是服务端种在 Cookie 里的稳定访客标识,才是 UV 的推荐口径。
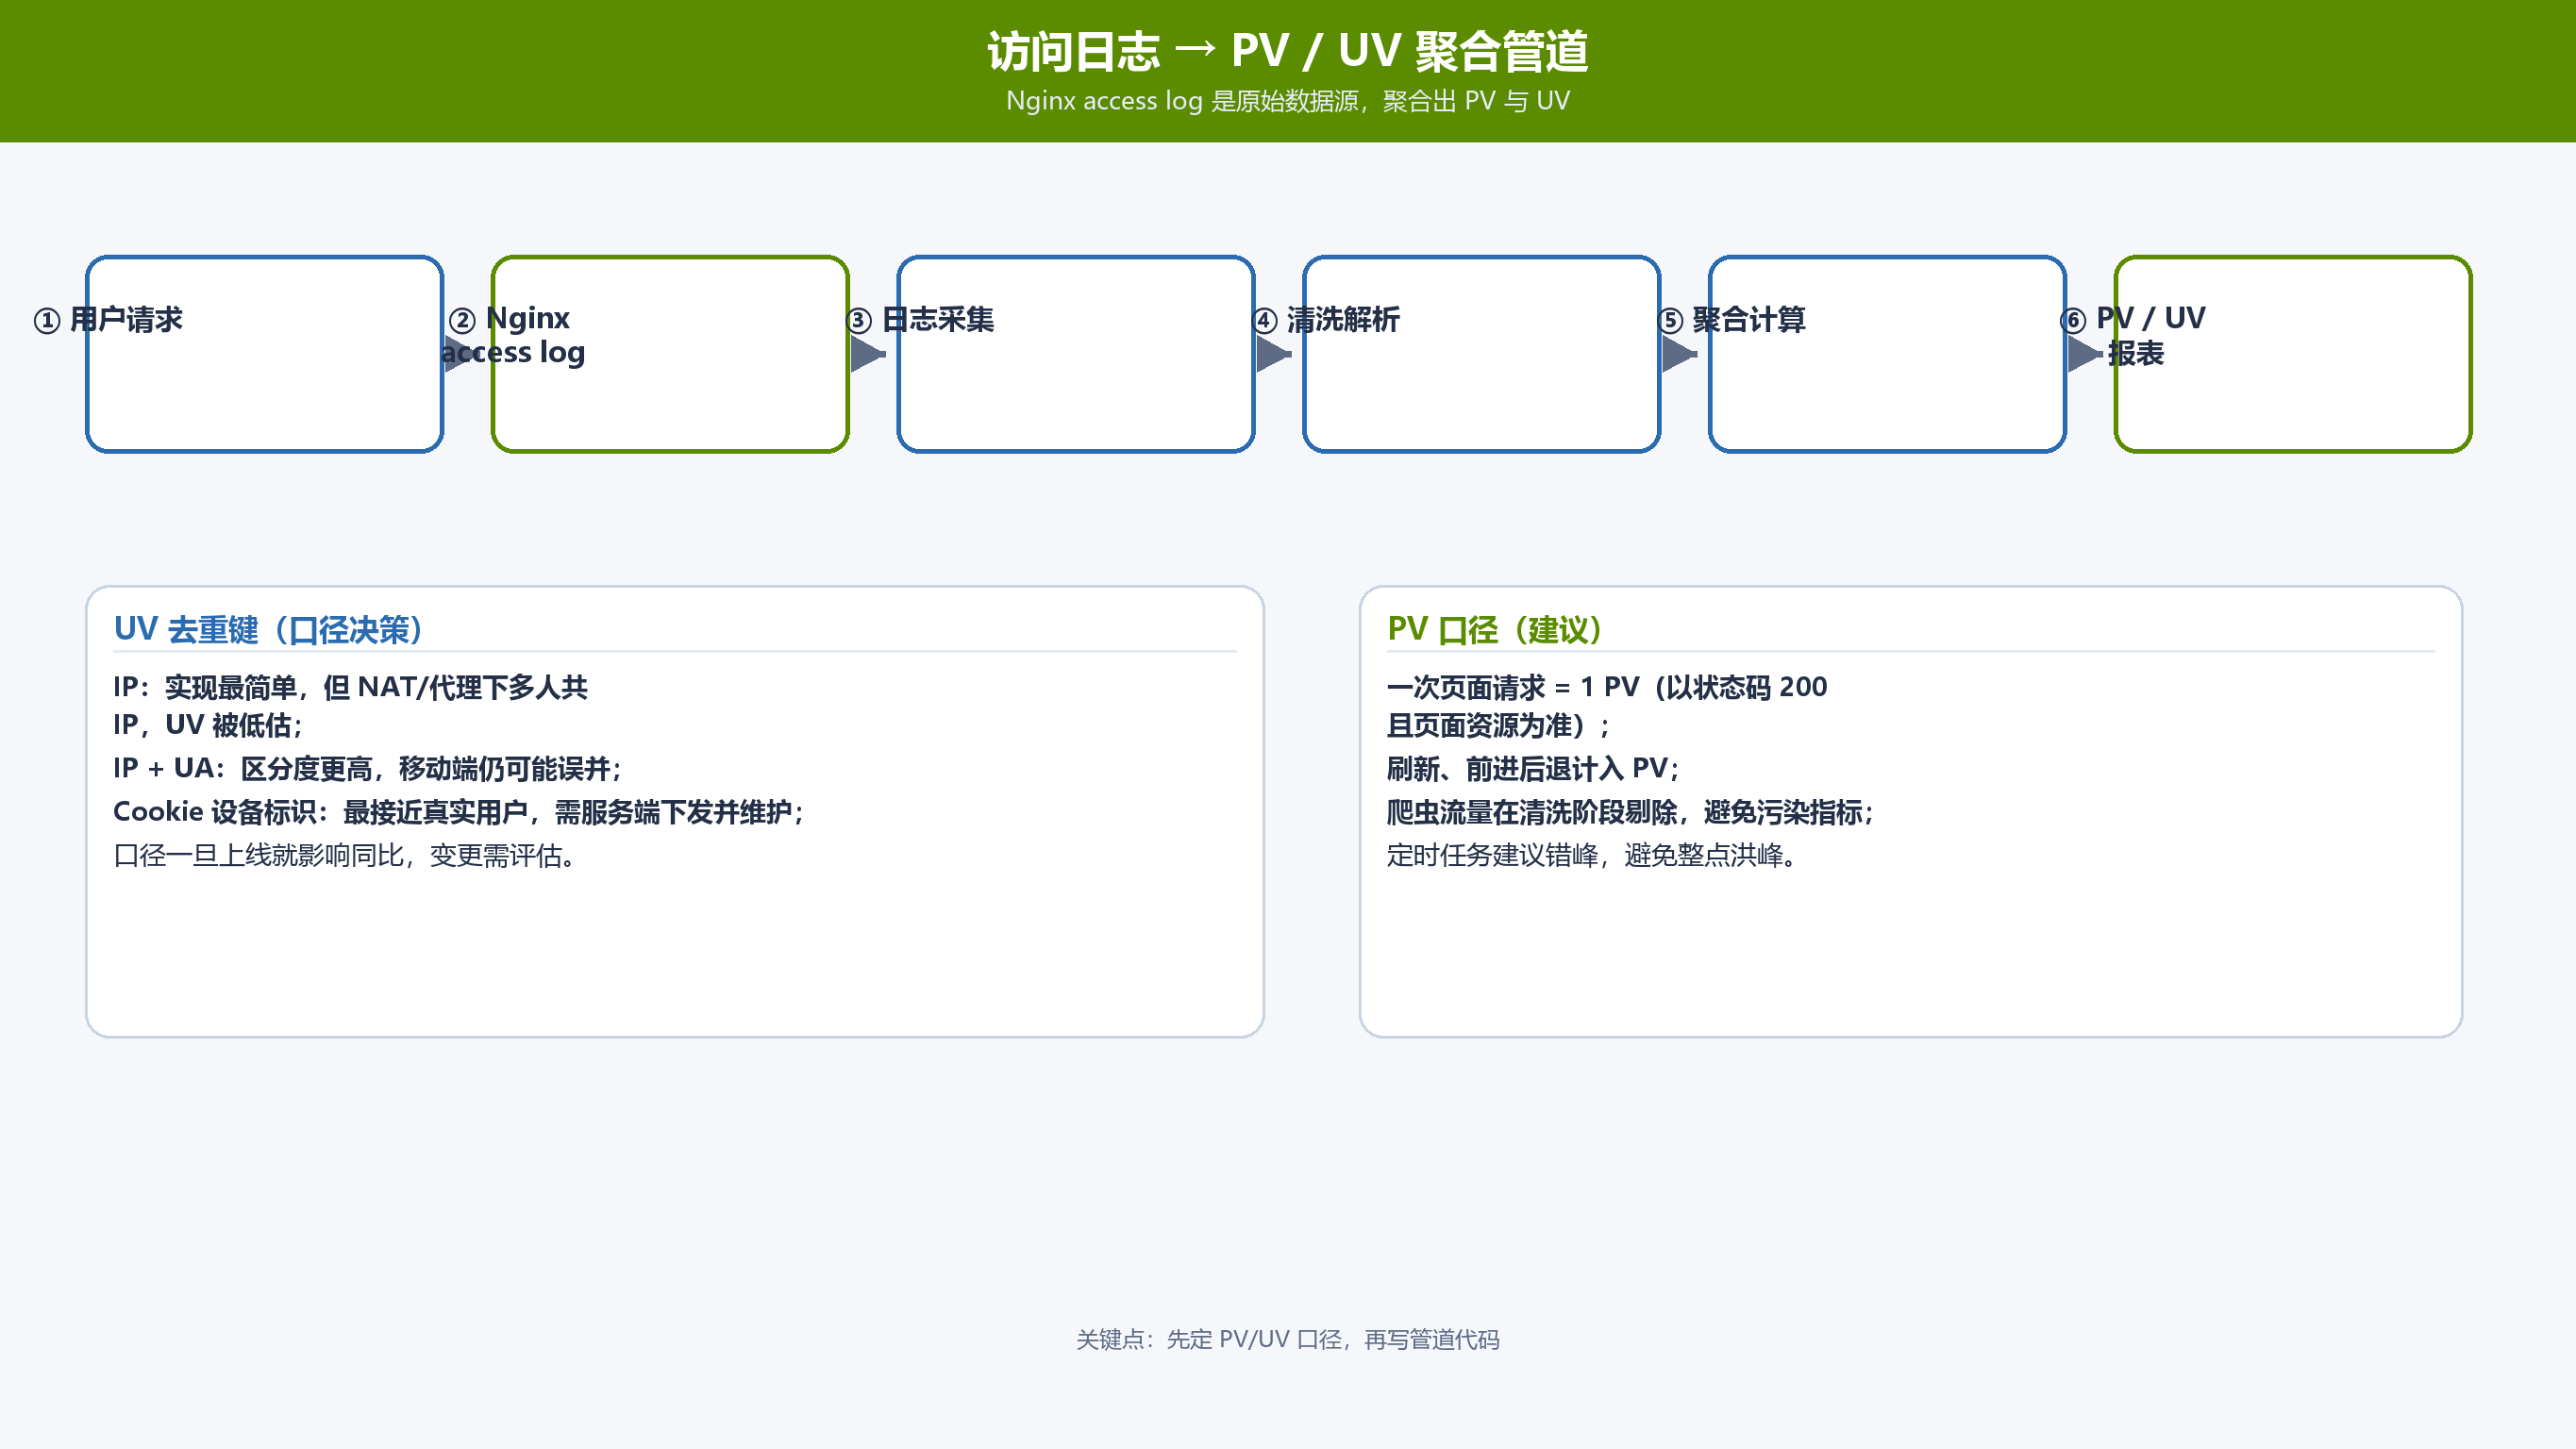 服务端访问日志 → PV/UV 聚合管道
采集与聚合的实现路径:实时还是离线?
**结论:**两条路径并存:实时管道(Filebeat/Kafka → 流计算)做监控与实时大盘,离线管道(定时任务 → 数仓)做 PV/UV 权威报表。实时求近似值,离线出精确值,两者口径对齐。
以中等规模站点(日 PV 千万级)为例,我推荐的分层是:
- **采集:**Filebeat 或 Fluent Bit 采集 access log,打上采集时间戳与节点标识,写入 Kafka;
- **清洗:**解析日志行 → 结构化字段(时间/IP/url/status/ua/cookie),丢弃静态资源行(.js/.css/.png,避免污染 PV);
- **聚合:**实时侧用 Flink/Spark Streaming 做窗口聚合(如 5 分钟粒度 UV 用 HyperLogLog 求近似);离线侧用定时 SQL 全量重算,UV 用精确去重;
- **输出:**写入指标存储(ClickHouse/Doris),供大盘与报表查询。
一个聚合 PV 与 UV 的 SQL 示例(示意代码):
-- 按天聚合:PV 用 count,UV 用 count(distinct uuid)
SELECT toDate(ts) AS day,
count() AS pv,
count(DISTINCT uuid) AS uv
FROM cleaned_logs
WHERE status = 200 AND is_page = 1
GROUP BY day;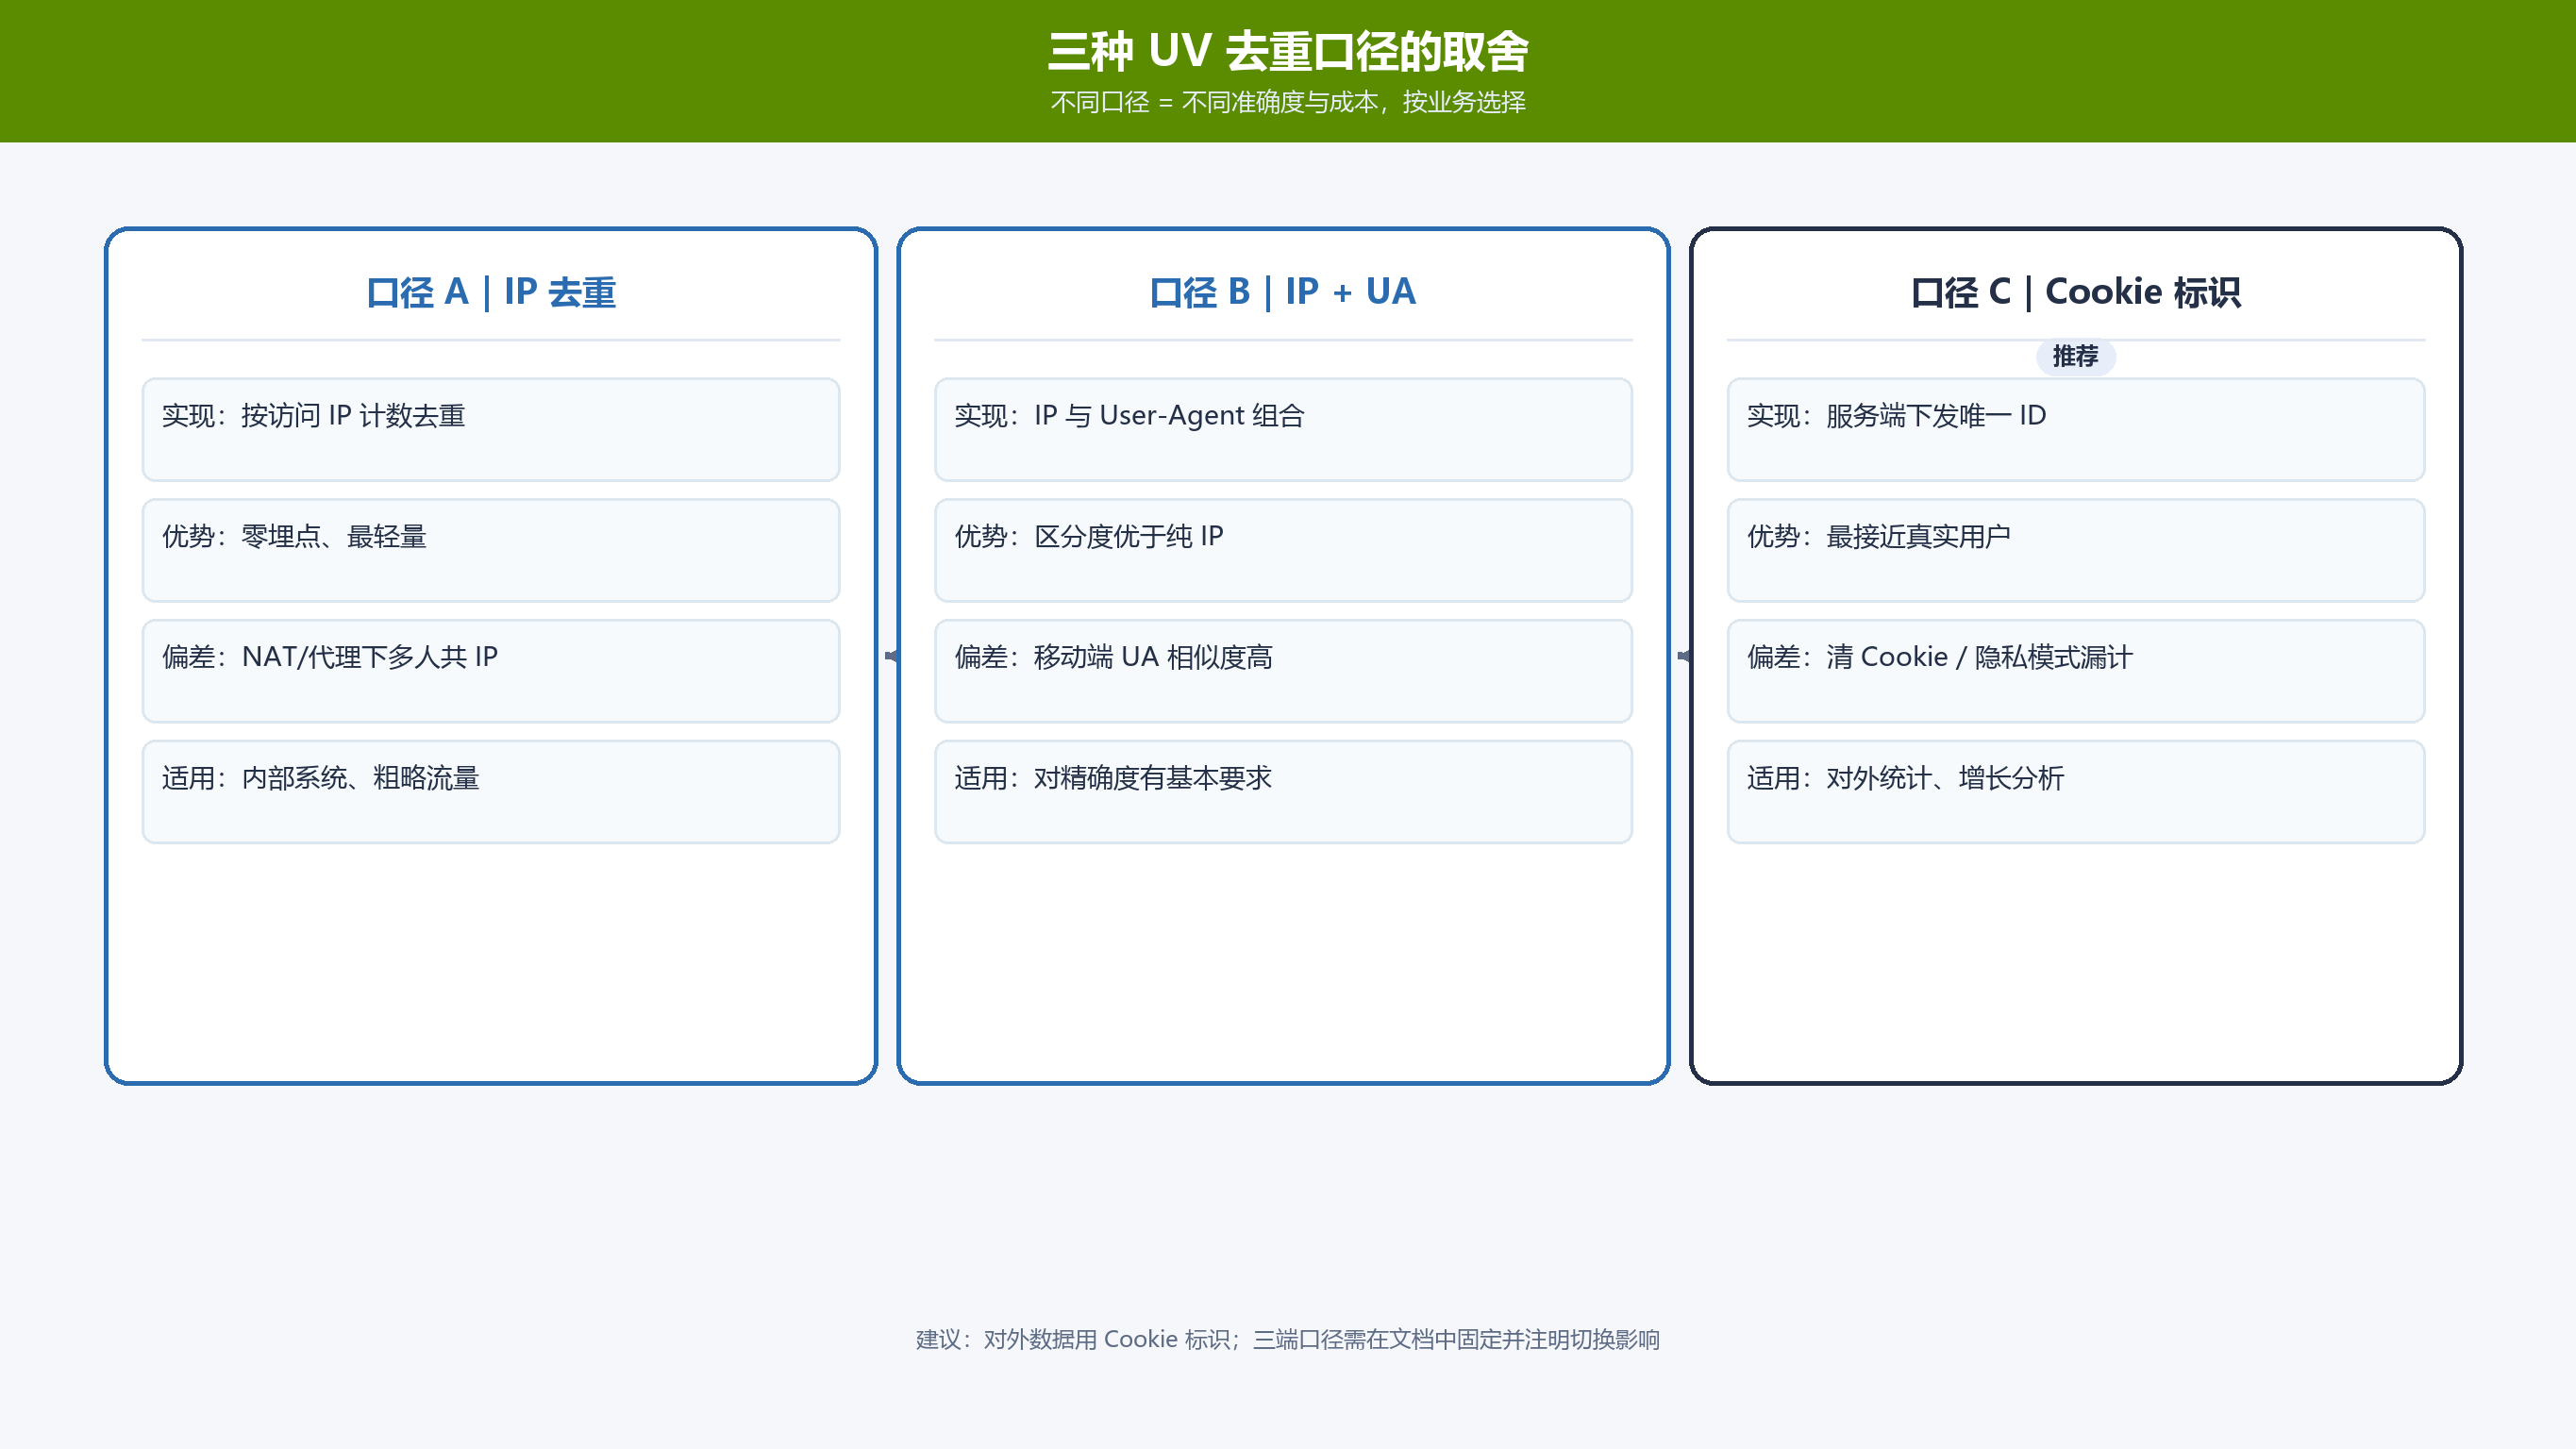 UV 去重口径四种方案对比
UV 去重口径的选择:IP / Cookie / 设备指纹
**结论:**推荐顺序:Cookie uuid 优先(稳定、成本低);无 Cookie 场景(爬虫、隐私模式)用 IP+UA 组合近似;设备指纹精度高但成本与合规成本也高,非必要不引入。
| 去重键 | 优点 | 失真来源 | 适用场景 |
|---|---|---|---|
| IP | 零成本、无需改代码 | NAT 多人共享、动态 IP 漂移、爬虫泛滥 | 粗糙大盘、防刷参考 |
| Cookie uuid | 稳定、业界主流 | 清 Cookie、隐私模式、跨设备 | 日常 UV 报表(推荐) |
| IP+UA | 比纯 IP 稍稳 | 同网段同机型用户会合并 | 无 Cookie 场景兜底 |
| 设备指纹 | 精度高、跨端可追踪 | 采集成本高、合规敏感 | 风控、付费分析 |
合规提醒:根据《中华人民共和国个人信息保护法》(2021 年 8 月 20 日通过、2021 年 11 月 1 日起施行),设备指纹等可识别设备的信息属于个人信息范畴,采集需要遵循告知同意等要求;而服务端种 uuid Cookie 属于常规统计分析,仍建议在隐私政策中说明。
指标口径与边界:PV、UV 到底怎么定义?
**结论:**口径必须先定死:PV=过滤静态资源后的 200 页面请求数;UV=同一 uuid 在统计窗口内去重后的访客数;窗口默认自然日,跨天任务各自独立计算。
- **PV 边界:**是否含刷新?含。刷新会新产生一次请求,这是业界默认;是否含爬虫?建议单独出「爬虫流量」指标与正常 PV 分开,避免被 SEO 爬虫刷高;
- **UV 边界:**窗口越长 UV 越大;跨天连续访问的用户会被两天分别计入(日口径)或一次计入(跨天口径)。报表必须标注口径,不能混用;
- **新老访客:**新访客=窗口内首次出现该 uuid;老访客=之前出现过。这个口径依赖历史表,建议离线管道维护「首现时间」维表。
验证与校准:怎么知道聚合结果是对的?
**结论:**三条校准路径:抽样人工核对原始日志、与前端埋点 PV 交叉对比、用已知流量(压测/活动页)反推误差。误差在 ±5% 内即可接受,超出要查管道。
- **抽样核对:**随机抽 100 条原始日志,人工与聚合明细对账,确认清洗规则(静态资源过滤、状态码过滤)没有误伤;
- **交叉对比:**同一时间段,服务端 PV 应 ≈ 前端埋点 PV(误差来自 JS 未加载、缓存命中);UV 应略有差异(口径不同),但趋势应一致;
- **已知流量反推:**发布一个高流量页面,用压测工具制造已知请求数,对比聚合结果,验证清洗与去重逻辑。
踩坑记录:CDN 命中导致 PV 严重偏低
**现象:**接入 CDN 后,服务端日志 PV 只剩原来的三分之一,业务质疑统计坏了。
**根因:**HTML 页面被 CDN 缓存,大量请求在边缘节点直接返回,源站 access log 只记录了回源请求。这不是 bug,是「源站日志只能统计回源流量」的边界。
**修复:**两种方案:开启 CDN 回源日志(边缘日志)与源站日志合并计算;或对页面禁用缓存只缓存静态资源。如果团队用的是带前端采集能力的全端分析平台,可以直接用它的访客数、浏览量做交叉参考,让「服务端回源口径」与「用户端真实口径」互相校准。
FAQ
Q1:PV 统计要不要过滤爬虫?
A:建议单独统计。Googlebot 等搜索引擎爬虫会显著拉高请求数,过滤后才是「真人 PV」;但爬虫数据对 SEO 监控有价值,不要直接丢弃。
Q2:SPA 应用的服务端日志还能算 PV 吗?
A:能,但只能算「首屏 HTML 请求」级别的 PV;路由切换不产生新请求(除非按路由懒加载)。要完整的页面级 PV 仍需要前端埋点补上报。
Q3:UV 一定要用 Cookie 吗?
A:Cookie 是性价比最高的稳定标识,但不是唯一。只要「同一访客在窗口内的多个请求能关联起来」就可以,服务端种 Cookie、LocalStorage+上报、登录态 ID 都是可行键。
Q4:实时 UV 用 HyperLogLog 会差多少?
A:HLL 在合理配置下误差通常在 1%~3%,用于实时大盘足够;权威报表仍建议离线精确去重,两个口径并存并标注。
Q5:日志量太大,聚合跑不动怎么办?
A:先做过滤与采样分级:全量落盘、聚合只处理页面请求;跨天 UV 用增量表 + 位图/布隆过滤器压缩;必要时按时间分区冷热分层。
Q6:服务端日志能算跳出率、时长吗?
A:能算近似值(单请求即跳出、无后续请求记 0 时长),但精度低于前端埋点;这类「会话级」指标建议由前端埋点补充。
核心价值与实施边界是什么?
服务端日志聚合 PV/UV 的价值在于「底座稳」:不依赖 JS、不怕广告拦截、天然覆盖所有请求,适合做流量大盘与异常监控的基准线。前端埋点负责「行为深」:点击、停留、转化这些日志给不出的数据。
实施边界要写清楚:服务端口径与前端口径允许存在系统性差异(缓存、爬虫、JS 未加载),关键是差异要稳定、可解释,而不是两套数据打架。建议把它输出的访客数/浏览量/跳出率当作「用户端真实口径」,与服务端日志口径定期对账,双向校准------真实口径管业务判断,日志口径管监控兜底,两条线各司其职。
**数据来源:**W3Techs 2026 年 8 月 Web 服务器使用率统计(Nginx/Apache 份额);Nginx 官方 access log 文档(combined 格式);《中华人民共和国个人信息保护法》(2021 年 8 月 20 日通过、2021 年 11 月 1 日施行,中国人大网全文)。以上数据均可在对应机构公开页面复核。