目录
[1 PIECEWISE、FULL、FULL_AND_PIECEWISE、FULL_DECODE_ONLY区别](#1 PIECEWISE、FULL、FULL_AND_PIECEWISE、FULL_DECODE_ONLY区别)
[2 CUDAGraphWrapper和BreakableCUDAGraphWrapper](#2 CUDAGraphWrapper和BreakableCUDAGraphWrapper)
[2.1 CUDAGraphWrapper backend](#2.1 CUDAGraphWrapper backend)
[2.2 BreakableCUDAGraphWrapper backend](#2.2 BreakableCUDAGraphWrapper backend)
[2.3 为什么kimi k3的piecewise必须用breakable的后端](#2.3 为什么kimi k3的piecewise必须用breakable的后端)
[3 cudagraph的步长和档位](#3 cudagraph的步长和档位)
1 PIECEWISE、FULL、FULL_AND_PIECEWISE、FULL_DECODE_ONLY区别
它们只决定一件事:decode 用哪种录像,prefill 或混合 batch 用哪种录像。
这里的「prefill」在代码里叫 mixed,包括纯 prefill,也包括一个 batch 里既有 prefill 又有 decode。纯 decode、每条请求 query 长度相同,才走 decode 那一列。
运行时真正只有三种录像:NONE(不录)、PIECEWISE(attention 在外)、FULL(attention 在内)。后面两个带下划线的名字,是把这三种分别派给 decode 和 prefill。
| 配置 | decode | prefill / 混合 batch |
|---|---|---|
PIECEWISE |
PIECEWISE:attention 在图外,eager;前后的计算是小图 | 同样是 PIECEWISE |
FULL |
FULL:整段 forward 一张图,attention 也在里面 | prefill 也要求整段 forward 进一张图;变长 attention 很多后端根本不支持放进 FULL,所以通常不用这个模式, |
FULL_DECODE_ONLY |
FULL | 不录,整段 eager |
FULL_AND_PIECEWISE |
FULL | FULL_AND_PIECEWISE。这是 vLLM 默认 |
2 CUDAGraphWrapper和BreakableCUDAGraphWrapper
2.1 CUDAGraphWrapper backend
CUDAGraphWrapper 是 018、021 里唯一的一套。切分发生在编译期。torch.compile 把 forward 追踪成一张 FX 图,在 splitting_ops 上剪开。
编译期先做一步,而且只为 prefill 做。torch.compile 把 forward 追踪成 FX 图,在 attention 上剪开。剪完之后,一层变成三截:左边的 norm、qkv 是一块子图,attention 自己留在剪口上,右边的 o_proj、MoE 是另一块子图。每块子图包一个标记为 PIECEWISE 的 CUDAGraphWrapper。prefill 时调度器宣布 PIECEWISE,就播这两块小图,attention 现场跑。
decode 不走这些剪口。已经剪开的模型最外面再套一个标记为 FULL 的 CUDAGraphWrapper。纯 decode 时调度器宣布 FULL,这个外层 wrapper 用一次 torch.cuda.graph() 把整段 forward 录成一张大图。里面的小图 wrapper 这次对不上模式,不再各自录像。它们的计算连同 attention 一起被外层这张大图录进去。所以 decode 的 attention 在图里。
编译期在 attention 上剪开,只给 prefill 的 PIECEWISE 用。decode 的 FULL 是外层另外一套录像,把剪口盖住,attention 也在那张大图里。两套开关,一次只用一套。
每个 wrapper 先看调度器这次宣布的运行模式。对不上就只把计算往下传,自己不录像。所以 prefill 和 decode 是两份已经录好的东西,一次请求只用一份。
Prefill 或混合 batch。 调度器宣布 PIECEWISE。外层那个标记为 FULL 的 wrapper 对不上,不录,只是调用 forward。里面的子图对得上,各自播一张小图。attention 落在剪刀上,哪张小图都不收它,所以现场发 kernel,这就是 eager。一次 prefill 的一层是:
小图(norm / qkv) → attention,eager → 小图(o_proj / MoE)
attention 必须留在外面,是因为 prefill 里每条请求的 query 长度、KV 读到哪都不一样。CUDA Graph 要求录像时 kernel 的启动次数和显存地址都固定,换一套长度不能重放。两边的矩阵乘可以把 token 数 pad 成固定大小,所以能录。
纯 decode。 每条请求的 query 长度相同,不开推测解码时就是 1 个 token,attention 的形状也能固定。调度器宣布 FULL。外层 wrapper 对得上,用一次 torch.cuda.graph() 把整段 forward 录成一张大图,attention 也在这张图里面。里面那些 PIECEWISE 的小 wrapper 对不上,不再单独录像,它们的计算被外层这张大图一起录走。一层是:
一张大图:norm / qkv → attention → o_proj / MoE
如果配置不是默认,而是整个服务都设成 PIECEWISE,那 decode 也走上面 prefill 那条,attention 仍然在图外。FULL_DECODE_ONLY 则是 decode 走这张大图,prefill 不录,整段 eager。两种后端都一样,因为这是模式决定的,不是后端决定的。
2.2 BreakableCUDAGraphWrapper backend
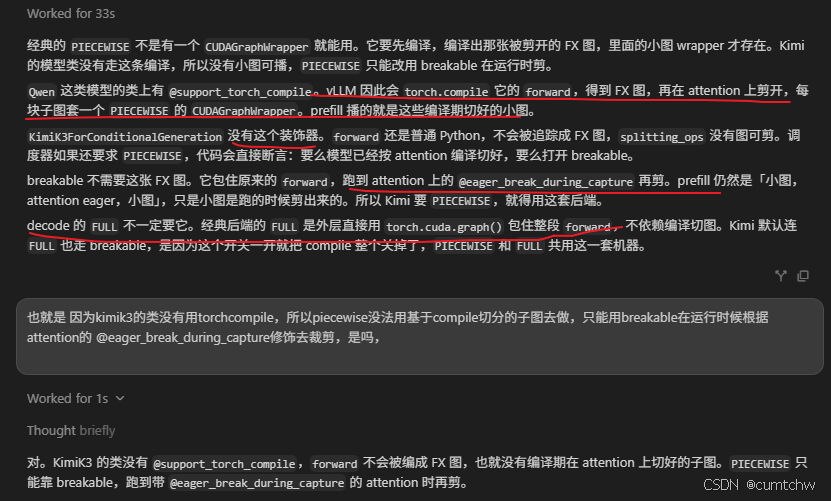
BreakableCUDAGraphWrapper 是这套 Kimi 代码新加的,018、021 里没有。KimiK3、KimiLinear、DeepSeek-V4、Inkling、MiniMax-M3 这些模型没有走原来的 @support_torch_compile,启动时如果没手动设置,就会自动 VLLM_USE_BREAKABLE_CUDAGRAPH=1,同时把 torch.compile 关掉。整个模型只在外面包一层,不在编译期切图。attention 上挂了 @eager_break_during_capture。第一次真正跑 forward 时,碰到这个装饰器才决定剪不剪。
一层都可以看成:
norm / qkv 投影 → attention → o_proj / MoE
没有编译,也没有事先切好的子图。录像发生在第一次跑某个 batch 形状的 forward 时。装饰器看的也是调度器这次宣布的运行模式。
Prefill 或混合 batch,模式是 PIECEWISE。 捕图过程中碰到 attention,就做三件事:结束当前这段 graph,attention 在 CPU 上 eager 跑,再开始下一段 graph。录出来的不是一张图,而是一条播放列表:
replay 第 1 段(norm / qkv) → eager 跑 attention → replay 第 2 段(o_proj / MoE)
以后每次同样形状的 prefill 就按这个顺序播。eager 那段必须写进捕图时固定的那块显存,后面的 graph 段读的才是同一块地址。效果和经典 PIECEWISE 一样,attention 在图外,只是小图不是编译切好的,是跑的时候剪出来的。
纯 decode,模式是 FULL。 同一个装饰器看到模式是 FULL,不剪。attention 的 GPU 操作留在当前这段 capture 里,和前后的计算录在一起。一层接近经典 FULL 的那张大图:
一段连续的 capture:norm / qkv → attention → o_proj / MoE
管线仍然是 breakable 自己的 capture_begin / capture_end,不是经典那种用 torch.cuda.graph() 把整个 forward 包一次。FULL_DECODE_ONLY 的 prefill 两边都不录。服务若整体设成 PIECEWISE,decode 在 breakable 里也会每层 attention 都剪一刀。
2.3 为什么kimi k3的piecewise必须用breakable的后端
3 cudagraph的步长和档位
CUDA Graph 要求一次录进去的 kernel 形状固定。vLLM 不会为每一种 token 数各录一张图,而是先定一组档位,启动时按这些档位各录一张。运行时把这一步的 token 数向上补到已经录过的、不小于它的那一档,再重放对应的图。
档位按 token 数计,不是按请求数。普通解码每个请求 1 个 token,两者一样。开了 MTP 之后每个请求带 1 + MTP步数 个 token,档位跟着变大。
不手写列表时,档位按固定步长铺到上限:
- 先放
1、2、4 - 从 8 到 256,步长 8
- 从 256 到上限,步长 16
上限由 --max-cudagraph-capture-size 决定。不传时是 min(max_num_seqs × 每个请求的解码 token 数 × 2, 512),再和 max_num_batched_tokens 取较小值。命令行里没有单独的步长参数,8 和 16 写在生成逻辑里。想改步长,用 --cudagraph-capture-sizes 把每一档都列出来,自动生成就不再用。
max_num_seqs=128、没开 MTP 时,上限是 256,整份列表 35 档。PIECEWISE 用这 35 档。FULL 解码只留不超过 请求数上限 × 每请求 token 数 的那些,也就是不超过 128,剩下 19 档:1, 2, 4, 8, 16, ..., 128。日志里的 FULL: 2/19 是从大到小的第二张,对应 120 个 token。
运行时只补到下一档。12 个 token、下一档是 16,就补到 16,不会一直补到最大那档。超过最大档位则这一步不用 CUDA Graph。
多 DP 时还有一次对齐。每个 DP 先按自己的 token 数升到档位上,再在 DP 之间取最大值,所有 DP 都补到这个最大值,这样各卡进同一张图,token 数也一致。