作者:来自 Elastic Peter Simkins
AI Partitioning 会读取你的数据并建议创建子数据流。然后,保留期限、丢弃和降采样都可以按数据流单独设置,因此噪声较多的数据流可以按照自己的时间计划自动过期。
保留你需要的数据,并为其实际价值付费。LogsDB、数据层级和 ILM 可以帮助优化存储和数据保留。开始免费云试用。
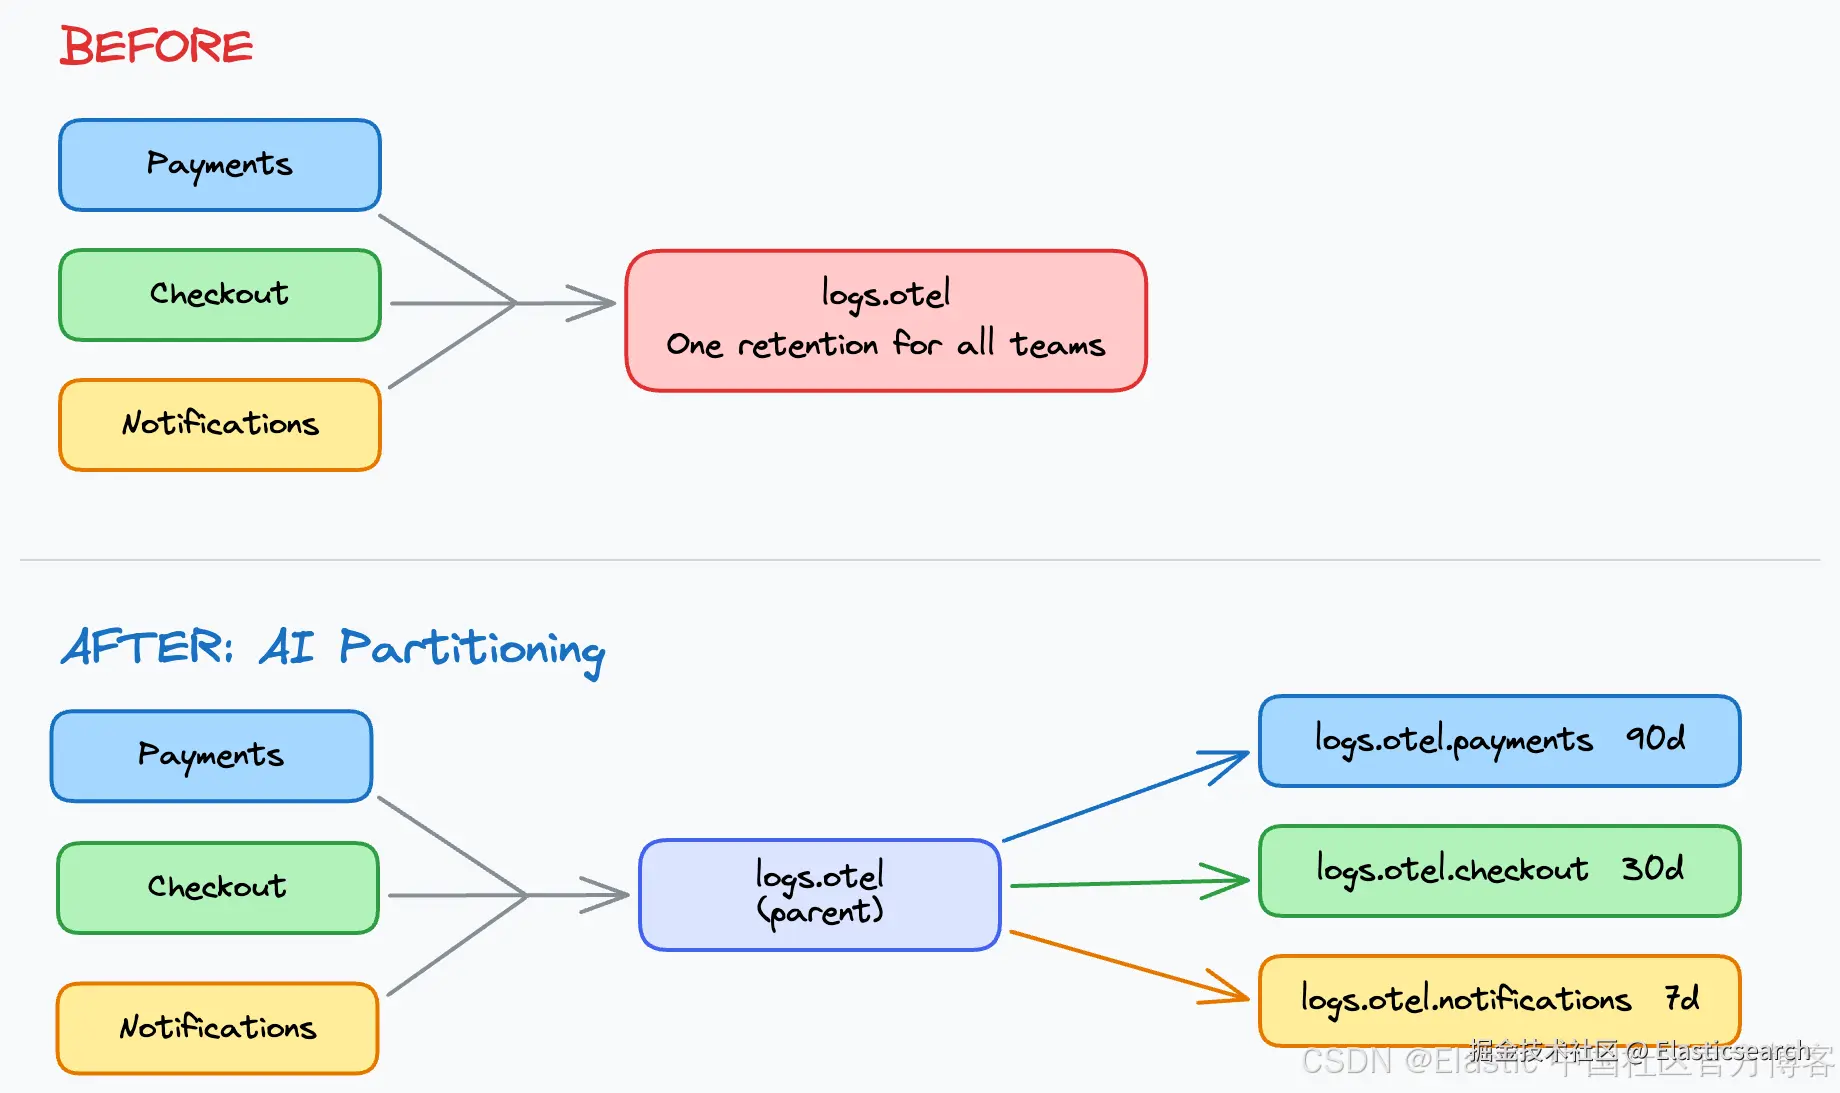
Elastic Streams 允许你按数据流设置可观测性数据的保留期限,因此支付 API 数据流可以保留 90 天,而通知工作器只保留 7 天。AI Partitioning 会读取不断流入的数据,并建议创建子数据流。之后,丢弃、保留和降采样都可以直接在 Streams UI 中设置,而无需在其他地方维护路由规则。通常,从单一的 30 天保留策略迁移后,团队可以在数据摄取时减少 20%--40% 的日志量,并在最初几天后对指标进行降采样。
这些控制在 Elastic Cloud Serverless、Elastic Cloud Hosted(ECH)和自管理集群上的工作方式相同。Elasticsearch 使用动态映射(写入时确定 schema,并自动检测 类 型),因此相同的 Streams 控制可以应用于日志、指标、追踪以及通过 OpenTelemetry 或原生采集器摄取的任何其他信号,无需预先定义固定 schema。
UI 注意事项(Stack 9.5+):*Streams 的 Retention 标签页已重命名为 Data lifecycle 。本文针对当前正式发布版本使用 Data lifecycle。在早期版本上截取的屏幕截图可能仍显示旧标签;但控制项本身没有变化。请参阅 使用 Streams 配置数据生命周期。*
为什么可观测性数据的存储成本会失控
大多数团队一开始会为所有数据使用一个保留策略。在以下情况下,这种方式就会变得复杂:
-
负载生成器产生的调试日志与支付审计事件位于同一个数据流中。
-
高基数指标持续增长,而一周后真正有用的只有少数几个维度。
-
部署期间追踪数据量激增,但你仍然需要为每个 span 以完整分辨率存储 90 天而付费。
通常的解决方法(全局对所有数据进行采样、关闭日志记录,或在摄取管道中维护脆弱的路由规则)都是以牺牲可见性来换取成本降低。Streams 采用了不同的方式:先 识别数据 模式,然后针对每种模式应用合适的存储策略。
Elastic Streams 中的可观测性数据保留控制
Streams 构建于 Elasticsearch 数据流之上。每个数据流都有自己的 Data lifecycle 标签页、处理管道,以及(对于已连接的数据流)在父子树中的位置。这种结构可以将通用的"降低可观测性支出"目标转化为可以进行审计的具体设置。
Streams 原生控制项(在 Streams UI 中配置):
| 控制项 | 作用 | 典型信号 |
|---|---|---|
| Drop | 在匹配的文档进入存储之前停止对其进行索引 | 噪声较多的调试日志、健康检查 |
| Retention(DSL 或 ILM) | 通过 Data lifecycle 标签页,在数据达到指定期限后删除数据或将其移动到其他层级 | 短期应用日志与合规日志 |
| Downsample | 将高分辨率指标替换为固定时间间隔的数据点(从 Elastic 9.4 开始) | 7 天后的基础设施指标 |
相邻的 Elasticsearch 功能会进一步叠加节省效果(不是单独的 Streams 操作,但对 TCO 很重要):
| 功能 | 作用 | 典型信号 |
|---|---|---|
| TSDS 存储效率 | 基于维度的路由、_tsid/@timestamp 排序以及合成 _source 可以改善压缩;具有相同 _tsid 和时间戳的数据点会被拒绝 |
OTel 或 Prometheus 指标 |
| 摄取处理器 / transforms | 处理器会在索引前重塑或丢弃单个文档;transforms 会按照计划将已经索引的数据转换到汇总目标中 | 高流量计数器、数据丰富 |
| ILM 分层 | 将较旧的数据移动到 warm、cold 或 frozen 存储(在 ECH/本地部署的 Streams Data lifecycle 中提供) | 长期保留的日志和指标 |
在 Elastic Cloud Serverless 上,你还可以受益于平台内置的存储优化(例如用于日志的 LogsDB 索引模式以及针对指标的高效 TSDB 存储)。Streams 可以通过在数据进入 Serverless 计费范围之前对数据进行路由和裁剪,帮助你减少实际存储的数据量。
在 ECH 和自管理部署中,你可以使用完整的 Elasticsearch 生命周期工具集:ILM 阶段、数据流生命周期(DSL)、可搜索快照以及降采样。Streams 会在 UI 中展示这些策略,因此你无需在 JSON 策略文件中到处查找。
应该使用哪个控制项
丢弃、保留和降采样解决的是不同的问题,而且每种方式的成本产生在不同的阶段。
| 控制项 | 你仍需支付什么费用 | 你放弃什么 | 最适合的场景 |
|---|---|---|---|
| Drop | 无。匹配的文档从未被索引。 | 永久丢失这些数据。无法重新索引,也无法恢复。 | 健康检查、负载生成器输出、调试命名空间 |
| Retention(DSL) | 在达到期限之前支付完整的存储费用,之后无需支付。 | 无法查询超出保留窗口的数据。 | 短期应用日志、任何具有合规最低保留期限的数据 |
| Retention(ILM 分层) | 随着数据移动到 warm、cold 或 frozen,单位 GB 的成本会降低。 | 较旧数据的查询速度。Frozen 需要可搜索快照。 | ECH 或自管理环境中的长期日志和指标 |
| Downsample | 每个时间间隔保留一个数据点,而不是每个采样点都保留。 | 分辨率。原始采样点会被替换,而不是与降采样后的数据同时保留。 | 基础设施指标以及第一周之后的其他高基数指标 |
步骤 1:使用 AI Partitioning 查找日志模式
在了解数据流中包含哪些数据之前,你无法合理设置保留期限。Streams AI Partitioning 会分析传入的文档,并根据字段模式、服务名称、日志结构或自然语言指令建议创建子数据流。
一个常见的起点是通过 Managed OTLP endpoint 将 OpenTelemetry 日志发送到之后创建的 wired logs.otel 数据流。当你的部署摄取指标和追踪数据时,同样的思路也适用于 wired 指标和追踪数据流。
如何运行 AI Partitioning
-
打开 Observability > Streams,然后选择一个父 wired 数据流。
-
针对具有代表性的时间范围运行 AI Partitioning。
-
查看建议的子数据流(例如按团队、服务或日志级别划分)。
-
如果第一次分析将你希望分开的内容合并在一起,可以使用自然语言进一步优化分区。
-
应用分区,使每个子数据流继承父数据流的处理和保留设置,同时支持针对每个子数据流进行覆盖设置。
完成分区后,支付 API 数据流可以保留 90 天,而通知工作器可以保留 7 天。你可以直接在 UI 中进行设置,而无需在 Logstash 或 OTel Collector 中维护重新路由处理器。
如需查看完整流程,请参阅 一个 OTLP endpoint、三个团队、零路由规则。
步骤 2:在 Streams 中进行日志过滤,而不是在遥测管道中进行
分区告诉你数据_属于谁_。处理则告诉你_需要保留什么_。
在 Streams 的 Processing 标签页中,你可以:
-
添加限定在某个子数据流或日志结构中的条件块。
-
使用 AI 生成的 Grok 模式解析样本,而无需手动编写正则表达式。
-
为不应被索引的文档添加 drop 处理器。
这种先预览再执行的工作流对 TCO 很重要。你可以在任何内容正式生效之前检查匹配、解析和丢弃的样本。这比修改管道更安全,因为后者可能会在不知情的情况下丢弃错误的字段。
例如:在 Kubernetes 容器数据流中丢弃负载生成器日志,同时保留应用程序错误。Kubernetes 日志处理流程展示了包含 Dropped 标签页预览的完整流程。
当数据完全没有长期价值时,丢弃是最直接的控制方式。对于从未被索引的数据,你无需支付任何存储费用。
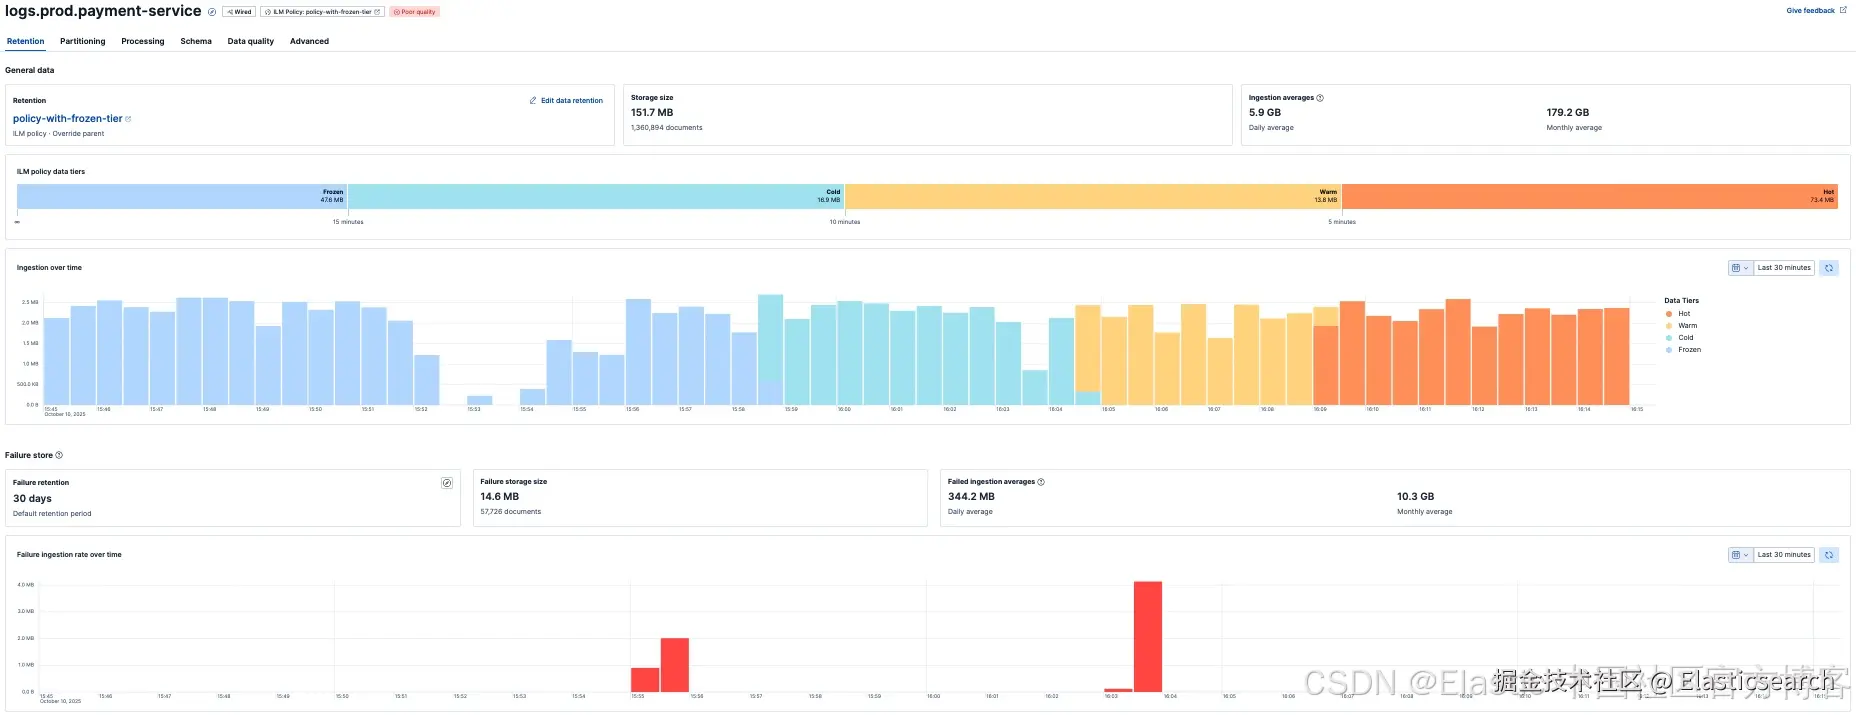
步骤 3:在 Data lifecycle 标签页中按数据流设置日志保留期限
完成分区后,在每个子数据流中打开 Data lifecycle 标签页(在 Stack 9.5 之前称为 Retention)。
你会看到:
-
当前的存储大小和预计摄取速率。
-
启用 ILM 后的生命周期阶段明细(hot、warm、cold、frozen)。
-
在 DSL (基于简单数据期限的保留)和 ILM(分层存储)之间切换的选项。
Wired 数据流支持继承:你可以在父数据流上设置保留期限,让子数据流继承该设置;也可以覆盖特定子数据流的设置,为其设置更长或更短的保留期限。Classic 数据流可以继续使用现有的索引模板策略,同时仍然可以在 Streams 中查看相关信息。
如需了解如何在 UI 中编辑 DSL 和 ILM,请参阅Streams 如何简化保留期限管理和使用 Streams 配置数据生命周期。
步骤 4:对高基数指标进行降采样并汇总 时间序列
日志通常关注保留期限和丢弃。指标则通常关注随时间变化的分辨率。
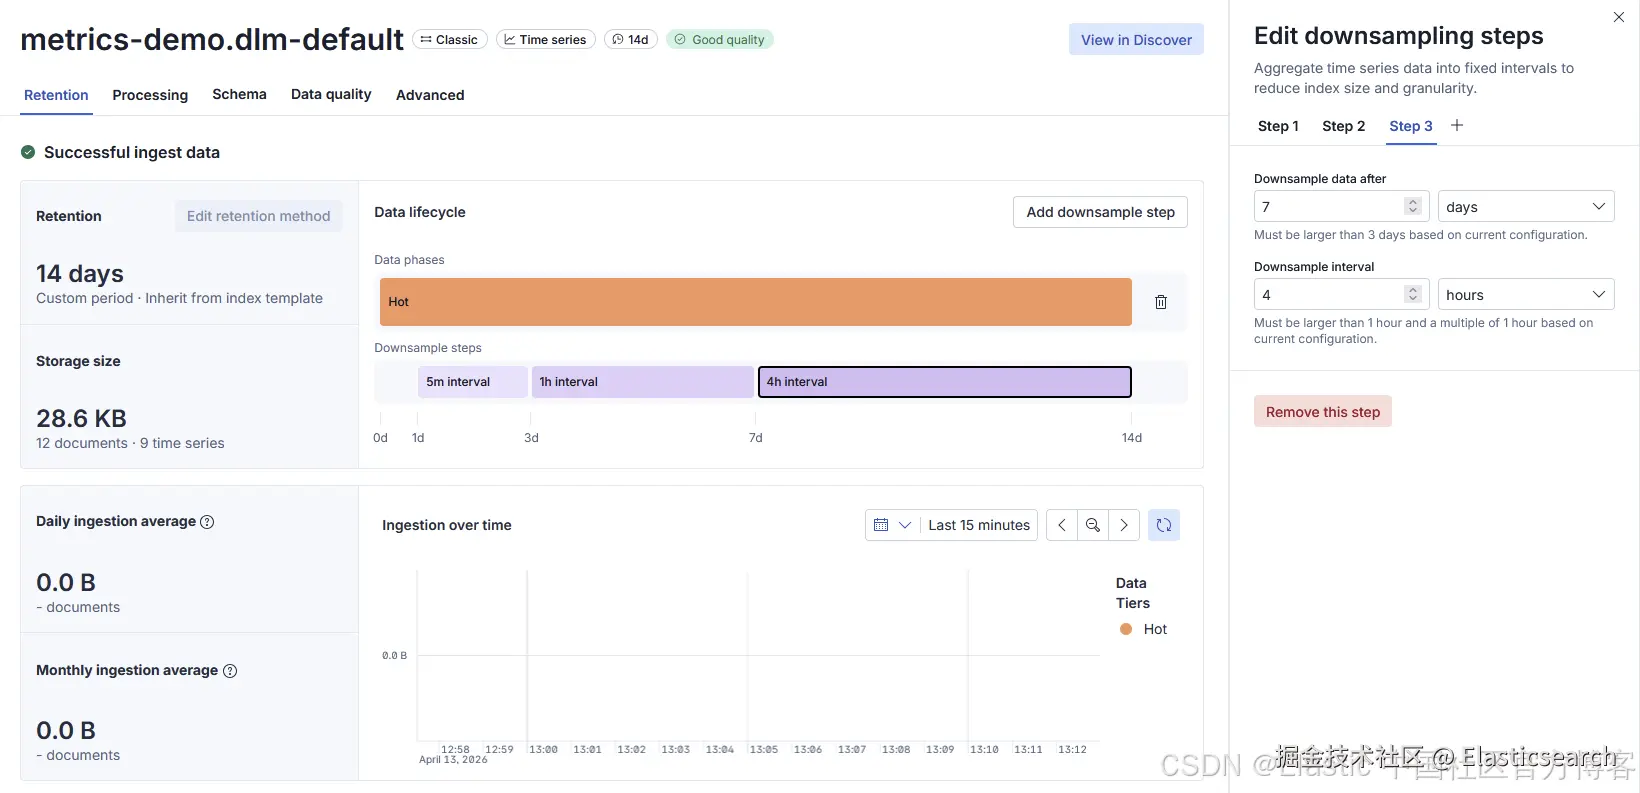
从 Elastic 9.4 开始,你可以直接在 Streams 的 Data lifecycle 标签页中为由 ILM 支持以及由 DSL 管理的数据流配置降采样。选择一个阶段,设置 fixed_interval,然后在保存之前预览时间线。
包含 hot 和 cold 降采样的 ILM 策略示例
bash
`
1. {
2. "phases": {
3. "hot": {
4. "min_age": "0ms",
5. "actions": {
6. "rollover": { "max_age": "1d" },
7. "downsample": {
8. "fixed_interval": "5m",
9. "wait_timeout": "1d"
10. }
11. }
12. },
13. "cold": {
14. "min_age": "4d",
15. "actions": {
16. "downsample": {
17. "fixed_interval": "10m",
18. "wait_timeout": "1d"
19. }
20. }
21. },
22. "delete": {
23. "min_age": "30d",
24. "actions": { "delete": {} }
25. }
26. }
27. }
`AI写代码TSDS 如何降低指标存储成本
Elasticsearch 时间序列数据流(TSDS) 通过基于维度的路由(每个时间序列都会进入一个分片)、按照 _tsid 和 @timestamp 进行索引排序以将重复值放置在一起从而改善压缩,以及使用合成 _source,来降低 OTel 和 Prometheus 指标的存储成本。TSDS 还会拒绝 _tsid 和时间戳完全相同的重复数据点。对于第一周之后只需要分钟级粒度的指标,可以将 TSDS 与降采样结合使用。
有关 UI 操作步骤以及共享策略警告,请参阅直接在 Elastic Streams 中配置降采样。
按部署类型划分的存储层级
Elastic Cloud Serverless 上的可观测性数据保留
Serverless 无需进行集群规模规划,但你仍然可以控制哪些数据进入存储。Streams 分区、丢弃和按数据流设置保留期限会直接影响摄取量和数据保留时长,而这些因素会影响 Serverless 可观测性成本。
平台级优化(用于日志的 LogsDB、用于指标的列式 TSDB 改进)会叠加在你在 Streams 中设置的策略之上。你可以同时获得高效的存储和有计划的数据生命周期管理。
如果你只需要以更低价格进行日志分析,Serverless 上的 Logs Essentials 是另一个选择。当你在 Complete 层级中需要按团队设置保留期限时,Streams 的 TCO 控制仍然适用。
Elastic Cloud Hosted 和自管理环境中的存储层级
ECH 和 本地部署 环境增加了存储分层:hot SSD、warm、cold、frozen 以及可搜索快照。ILM 会自动在这些层级之间移动数据流。当你不需要分层时,DSL 提供了更简单的"在 N 天后删除"模式。
相同的 Streams UI 和 API 都适用。区别在于,你还需要在这些策略背后选择硬件配置和快照存储库。
日志、指标和追踪数据的保留方式有何不同
Elasticsearch 不要求在摄取时使用固定 schema。OpenTelemetry 日志、指标和追踪数据可以进入 wired 数据流,根据数据中实际出现的字段通过 AI 进行分区,并应用针对数据流设置的保留期限。
这对 TCO 很重要,因为不同的可观测性信号并不是彼此独立的成本项:
-
日志:丢弃噪声数据,缩短日志量较大的服务的保留期限,更长时间保留审计记录。
-
指标:使用 TSDS 存储效率,在故障事件窗口结束后进行降采样。
-
追踪:按服务或环境进行分区,并根据采样策略设置相应的保留期限。
你无需维护三个不同的成本系统,而是将相同的 Streams 基础功能应用于每种信号类型。
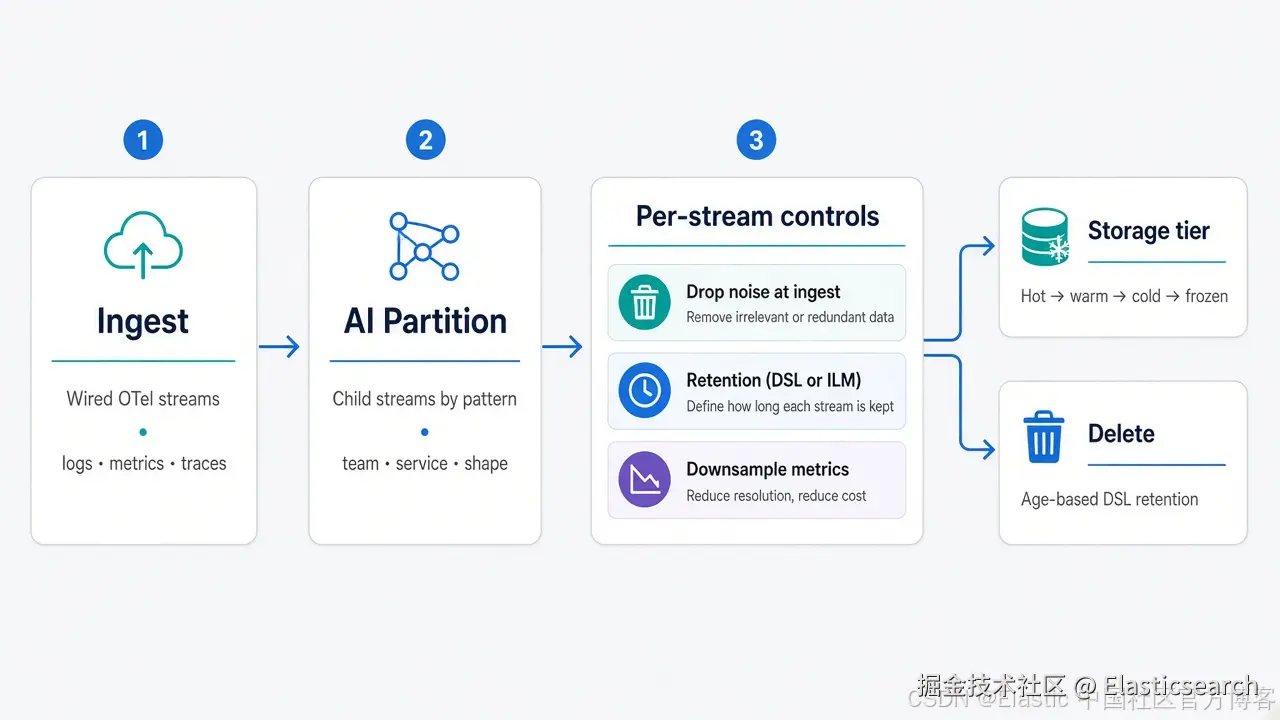
推荐的可观测性数据保留工作流
-
摄取到 wired 数据流 (例如
logs.otel、指标或追踪 OTel endpoint)。 -
使用 AI 进行分区,让每个团队或服务获得自己的数据流。
-
丢弃已知的噪声数据(健康检查、负载测试、调试命名空间)。
-
按数据流设置保留期限,根据合规性和调试需求进行配置。
-
对指标和高流量日志进行降采样或分层,适用于 ECH/本地部署环境。
-
每月检查 Data lifecycle 标签页,利用摄取量图表发现数据量变化。
实际可以节省多少存储空间?
确切的节省量取决于你的工作负载。对于之前将所有数据保留 30 天的团队,以下方式通常可以带来最大的收益:
-
在数据摄取时丢弃 20%--40% 的调试日志或重复日志。
-
缩短高流量、低价值数据流的保留期限。
-
在最初几天之后对指标进行降采样。
将这些控制措施与 Elasticsearch 存储模式(LogsDB、TSDS)结合使用,可以产生叠加的节省效果。在每个数据流的 Data lifecycle 标签页中使用存储大小指标进行前后对比;在你有权限访问的情况下,也可以使用集群级别的 _stats 进行测量。
在一个噪声较多的数据流上尝试按数据流设置保留期限
-
启用 wired 数据流,并将示例 OTel 数据发送到
logs.otel。 -
在繁忙的父数据流上运行 AI Partitioning。
-
在一个噪声较多的子数据流上设置一个较为激进的保留策略,并在 48 小时后比较存储量。
-
如果希望在 GitOps 中自动化策略,请阅读 Streams 文档,了解 API 选项(
Upsert stream、摄取设置)。
可观测性 TCO 并不是默认情况下少收集数据,而是要在正确的时间范围内存储正确的数据。Streams 为你提供了地图、剪刀和旋钮。
原文:Observability data retention with Elastic Streams | Elastic Observability Labs