慢接口定位实战:从应用日志一路追到 SQL 执行计划
用户说"接口慢",开发人员第一反应往往是看代码,运维人员第一反应往往是看数据库。但其实慢接口从来不是单纯属于某一端的问题,它是一条链路问题:请求进入应用,应用从连接池拿连接,执行 SQL,数据库生成执行计划,扫描数据,返回结果,应用再组装响应。任何一段变慢,用户看到的都是接口慢。
本文用一个可复现的排查路径,演示如何从 Spring Boot 应用日志一路追到金仓数据库侧的 SQL 和执行计划。 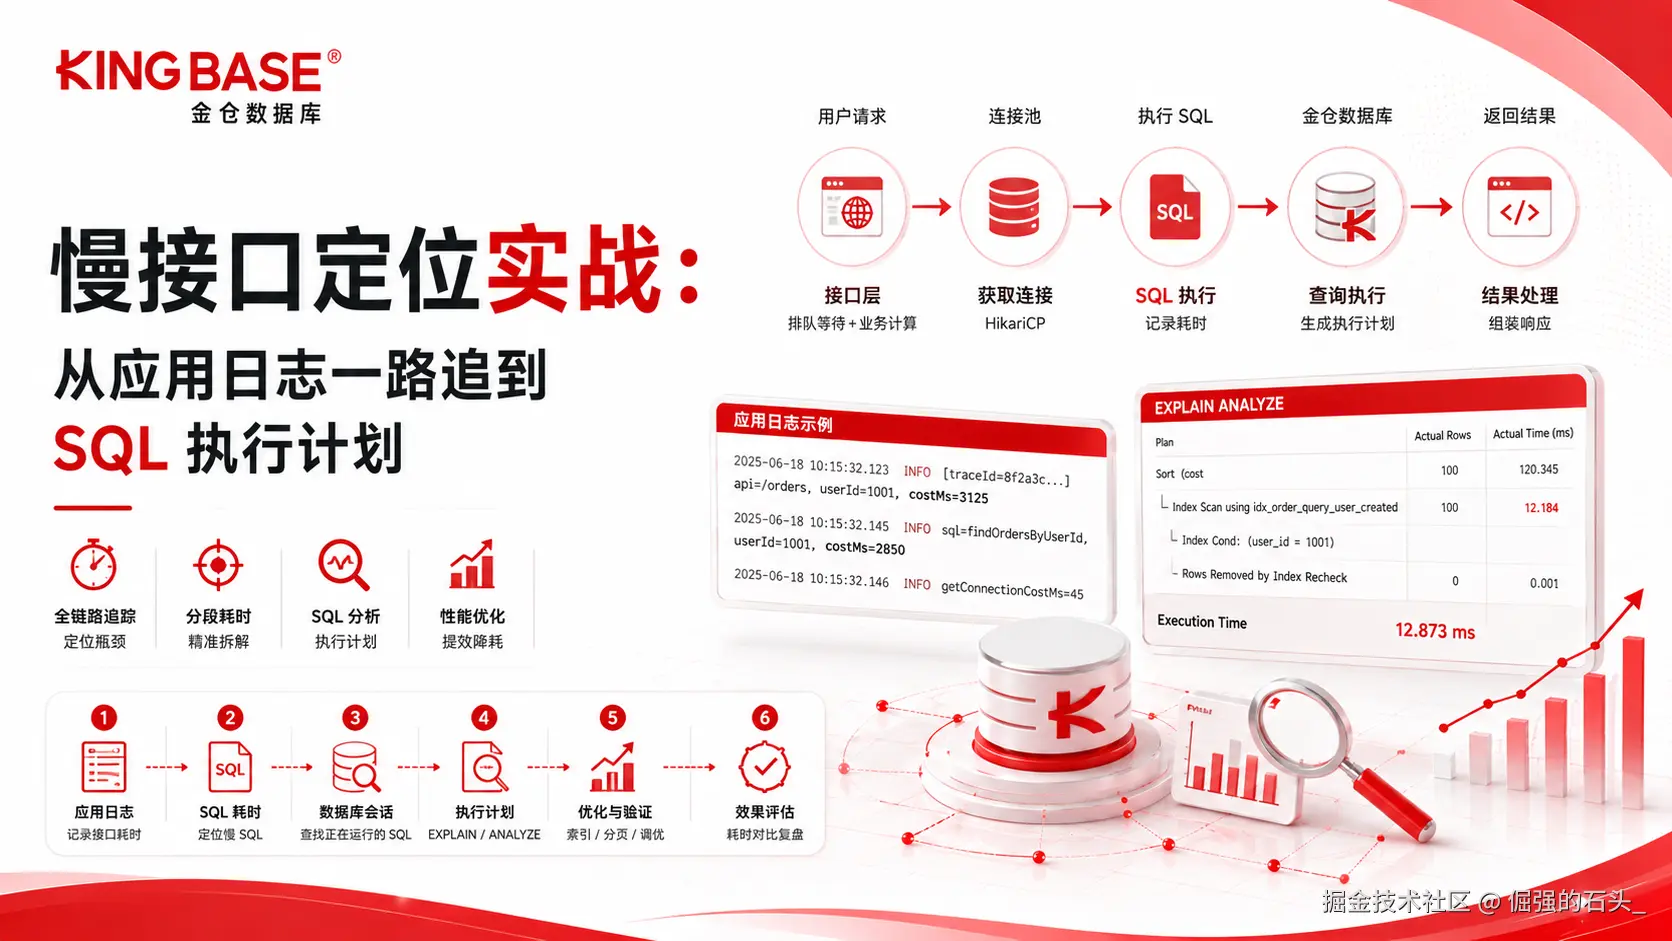
@toc
一、慢接口不要先猜
慢接口排查这个事儿,最忌讳的就是凭经验直接下结论。比如啥呢:
- 一看到接口慢,你就说这是数据库慢。
- 看到 SQL 慢,你就说是索引缺失了。
- 看到连接池在等待,你二话不说就直接加连接数。
- 看到 CPU 高了,那就先重启服务再说。
那更稳妥的方式是什么呢?我们得按链路把时间拆开来看:
text
接口总耗时 = 排队等待 + 业务计算 + 获取连接 + SQL 执行 + 结果处理 + 网络传输也就是说,只有把时间这么拆开,你才能真正知道瓶颈到底在哪里。
二、准备示例慢查询
那么这里呢,我们沿用第一篇里创建好的 kb_app、shop 和 app_user。接着我们先准备一张用来做慢查询演示的订单表:
sql
CREATE TABLE shop.t_order_query_demo (
    order_id       INT PRIMARY KEY,
    user_id        INT NOT NULL,
    order_status   VARCHAR(20) NOT NULL,
    amount         NUMERIC(12,2) NOT NULL,
    created_at     TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
然后给应用账号授个权:
sql
GRANT SELECT, INSERT, UPDATE, DELETE ON shop.t_order_query_demo TO app_user;通常来说,一个很常见的接口就是按用户去查订单,对吧:
sql
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = ?
ORDER BY created_at DESC;
这个查询要是数据量小,它肯定不会慢。但是当你的数据增长到几十万、几百万行以后,要是没有合适的索引,它往往就可能变慢了。
三、第一步:在应用日志里记录接口耗时
首先第一步,咱们得给接口加上耗时日志。最简单的做法,你可以在 Controller 或者拦截器里面去记:
java
long start = System.currentTimeMillis();
try {
    return orderService.findByUserId(userId);
} finally {
    long cost = System.currentTimeMillis() - start;
    log.info("api=/orders, userId={}, costMs={}", userId, cost);
}
那如果是生产环境的话,通常来说我建议你统一用过滤器或者 AOP 来记。记点啥呢?
- 请求的路径。
- 请求参数的摘要。
- TraceId。
- 总共花了多少时间。
- 响应状态是啥。
这里提醒一句,千万别在日志里打印敏感数据啊。
四、第二步:记录 SQL 执行耗时
那接口总耗时慢了,是不是就代表 SQL 一定慢呢?其实不是的。我们需要把 SQL 层的耗时单独记下来。
要是你用的是 JdbcTemplate,那可以在 Repository 层里面去记:
java
long start = System.currentTimeMillis();
try {
    return jdbcTemplate.query(sql, rowMapper, userId);
} finally {
    long cost = System.currentTimeMillis() - start;
    log.info("sql=findOrdersByUserId, userId={}, costMs={}", userId, cost);
}
那我们来分析一下。假如接口总耗时是 3 秒,但是 SQL 只用了 50 毫秒的话。这说明啥?说明瓶颈在业务计算、远程调用或者结果处理上。那反过来,接口总耗时 3 秒,SQL 就用了 2.8 秒。那这种情况的话,你就可以继续往数据库侧去查了。
五、第三步:数据库侧找正在运行的 SQL
赶上接口慢的时候,咱们进到数据库里去执行一下看看:
说明一下哈,运行状态视图的名称和字段,你得看当前 KingbaseES 环境是啥样的。正式发布前,我建议大家用自己的服务器先验证一遍。把示例 SQL 调整成当前版本能直接执行的排查脚本再去跑。
sql
SELECT pid,
       usename,
       client_addr,
       state,
       query_start,
       now() - query_start AS running_time,
       query
FROM sys_stat_activity
WHERE state = 'active'
ORDER BY running_time DESC;
要是你能看到对应的 SQL,那就说明它正在数据库里执行着呢。这时候你要记下几个东西:
- 执行的账号是哪个。
- 客户端地址是啥。
- 运行时长有多久。
- SQL 文本内容是啥。
那要是数据库侧看不到慢 SQL,但是应用侧记录的 SQL 耗时又很长呢?这时候你就要考虑了,是不是连接池等待啊,网络等待啊,或者驱动层处理有问题,也有可能是应用日志统计的位置不准确导致的。
六、第四步:查看执行计划
拿到 SQL 以后,咱们在测试环境里用执行计划来分析一下。看个示例:
sql
EXPLAIN
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = 1001
ORDER BY created_at DESC;
那要是环境允许的话,你可以进一步看看它实际的执行情况:
sql
EXPLAIN ANALYZE
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = 1001
ORDER BY created_at DESC;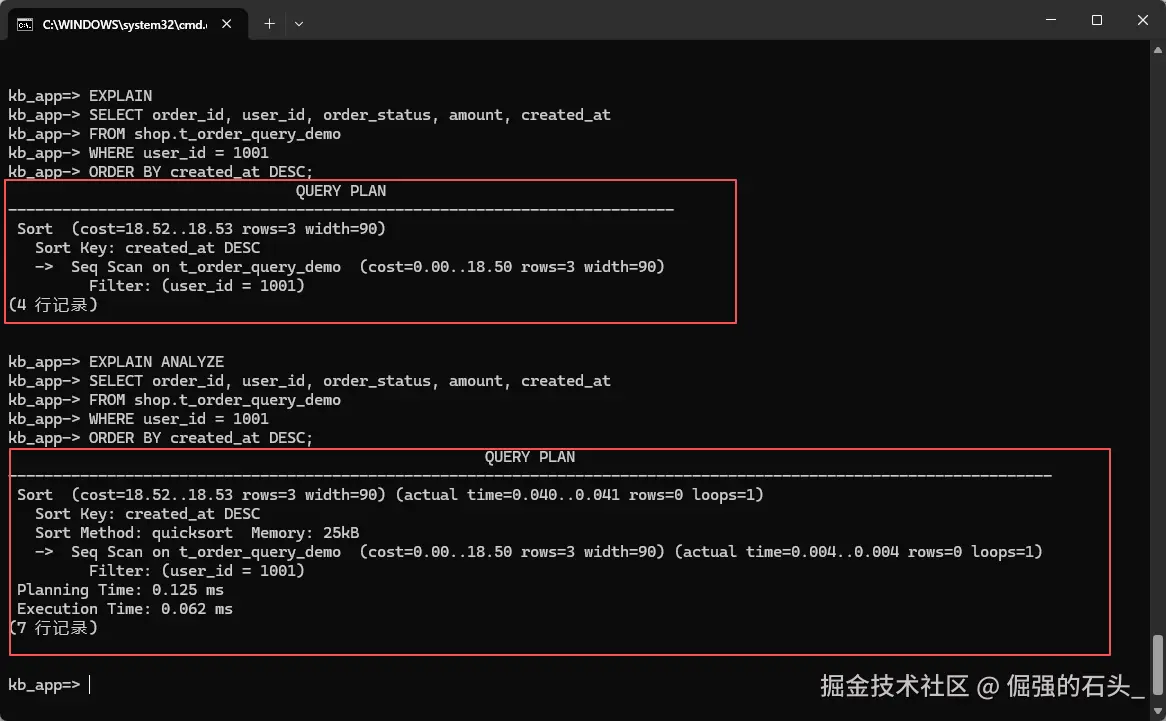
这里要注意哈,生产环境里一定要谨慎使用这种会实际执行 SQL 的分析方式。特别是涉及到写操作或者大查询的时候,我建议还是在测试环境里复现比较好。
七、第五步:判断是否需要索引
刚才那个查询,条件是 user_id,排序字段是 created_at。那我们其实可以考虑给它建个组合索引:
sql
CREATE INDEX idx_order_query_user_created
ON shop.t_order_query_demo(user_id, created_at DESC);
建好索引以后,咱们再来看一次执行计划:
sql
EXPLAIN
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = 1001
ORDER BY created_at DESC;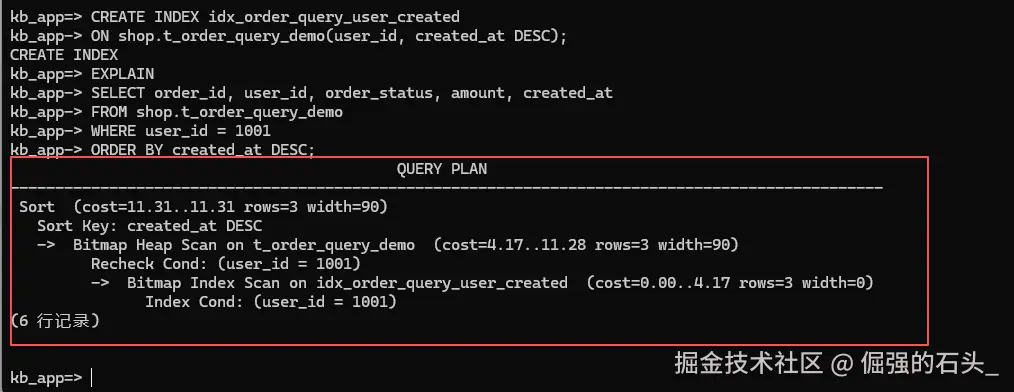
怎么判断索引有没有效呢?其实不是看你"有没有建索引"。而是看执行计划有没有走合适的路径,还有实际执行时间是不是真的降下来了。
八、第六步:控制返回数据量
很多慢接口出现的原因,其实并不是数据库不会查。而是啥呢?应用一次性查的数据太多了。
所以千万别这么写:
sql
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = ?
ORDER BY created_at DESC;
更合理的做法是分页,对吧:
sql
SELECT order_id, user_id, order_status, amount, created_at
FROM shop.t_order_query_demo
WHERE user_id = ?
ORDER BY created_at DESC
LIMIT 20 OFFSET 0;
那要是数据量特别大的话,你还得进一步考虑,用基于上一页边界值的分页方式。这样可以避免深分页带来那种很高的扫描成本。
九、第七步:排查连接池等待
接口慢还有另外一种情况。啥情况呢?SQL 本身跑得不慢,但是请求一直在那等连接。
当 HikariCP 出现连接等待的时候,应用日志里往往就会出现这种信息:
text
Connection is not available, request timed out那这个时候你就要同时看几个地方了:
- 看看当前的活跃连接是不是快到连接池上限了。
- 数据库那边有没有慢 SQL 或者长事务的情况。
- 应用这边有没有连接泄漏。
- Web 线程池是不是堆积了。
这时候不要光去改 maximum-pool-size。要是连接都被慢 SQL 给占住了,你去增加连接数的话,往往仅仅只是让更多的慢 SQL 同时压到数据库上而已。
十、慢接口排查模板
咱们可以把每次慢接口排查的过程,都按下面这个模板记下来:
text
接口路径:
请求时间:
请求参数摘要:
接口总耗时:
SQL 执行耗时:
是否等待连接:
数据库账号:
客户端地址:
SQL 文本:
执行计划摘要:
返回行数:
是否命中索引:
优化动作:
优化前耗时:
优化后耗时:
有了这个模板,优化过程就能复盘了。也就不会到最后只留下一个"加了个索引,快了"这种口头结论了。
十一、常见误区
1. 只看平均耗时
其实平均值这个东西,它是会掩盖毛刺的。接口性能好不好,你得看 P95、P99 还有那些最慢的请求。
2. 只在小数据量环境验证
数据量小的时候,就算全表扫描它也可能很快。所以调优的时候,你必须得考虑接近生产环境的数据规模才行。
3. 只加索引不看写入成本
索引这东西,虽然能加速查询,但它是会增加写入和维护成本的。那些高频写入的表,你加索引得谨慎评估一下。
4. SQL 返回字段过多
接口要是只需要 5 个字段,那你就别去 SELECT *。因为你查的字段越多,网络传输和对象组装的成本也就越高嘛。
十二、小结
那么小结一下。慢接口排查这个事儿,得从应用日志开始搞。用数据去证明时间到底花在哪了,然后再进到数据库里看会话和执行计划。连接池等待啊、慢 SQL 啊、返回数据过多啊、索引缺失或者长事务这些情况,往往表现出来的都是接口慢。所以说,只有把链路拆开,你才能避免盲目去调参。
那下一篇呢,我们就来看看多环境配置治理的事儿。重点解决一下开发、测试、生产配置混乱,还有连接信息串环境的这些问题。大家到时候看。